
单一样本中位数的符号检验例题.
单一样本中位数的符号检验例题
某钢厂生产的钢材,在正常情况下,中位数的长度为10米。
现随机地从生产线上抽取10根,测得长度(单位:米)如下:
9.8 10.1 9.7 9.9 10 10 9.8 9.7 9.8 9.9 试问:生产过程中对长度的控制是否需要适当调整。
解: 该例要解决的问题是:在生产过程中钢材的程度在中位数10米上下各占一半的情形下,就不需要调整生产过程。
否则,多数过长或多数过短均需要调整。
因而,假设可陈述为:
10:0=e M H 10:1≠e M H
进行正负符号检验时,可以将样本中每根的长度减去中位数,大者为正号(+),小者为负号(-),计算结果如表16.15。
从表16.15可以看出:10个样本单位中,除有两个与中位数相同外,余下的8个为1正7负。
如果进一步用精确的测量仪器进行测量,则与中位数相同的2个单位也可以区分为正号或负号。
现假定为1个正号1个负号。
这样,10个样本单位中就有2正8负。
如果总体的中位数为10,那么,理论上出现正号和负号应该各占一半。
现在,我们的问题是:出现2个或2个以下正号的概率是多少?我们用二项分布5.0=p 来计算:
()0547.05.02102
10
==
≤∑=x x C
x P
由于1H 是一个双尾检验,因此,也应包括负号在2个或2个以下的概率,因此,1094.00547.02=⨯=P 。
这就是说,当中位数为10时,出现上述结果的概率为0.1094,当05.0=α时,不能否定0H 。
决策人员可以据此,结合其他因素作出是否需要调整生产过程的决策。
在大样本情况下,用二项分布计算概率比较复杂,也可以用正态近似计算:
n
n s z 5.05
.05.0--=++,
n
n s z 5.05
.05.0--=
--
(16.6)
其中:+s 代表正号的数目,n 5.0表示在5.0=p 条件下正号或负号的平均数目(理论数目),0.5称作校正项,分母n 5.0为5.0=p ,样本容量为n 时的标准差。
当1α-≥z z 时否定0H 。
假如上例样本容量为36的大样本,各样本单元观察值与中位数之离差为正号有10个,此时,我们可以计算得到:
83.236
5.05
.0365.0105.05
.05.0-=-⨯-=
--=
++n
n s z
取绝对值为183.2α->z ,否定0H 。
5.236
5.05
.0365.0265.05
.05.0=-⨯-=
--=
--n
n s z
数值215.2α->z ,同样否定0H 。
《统计学》-第6章-习题答案
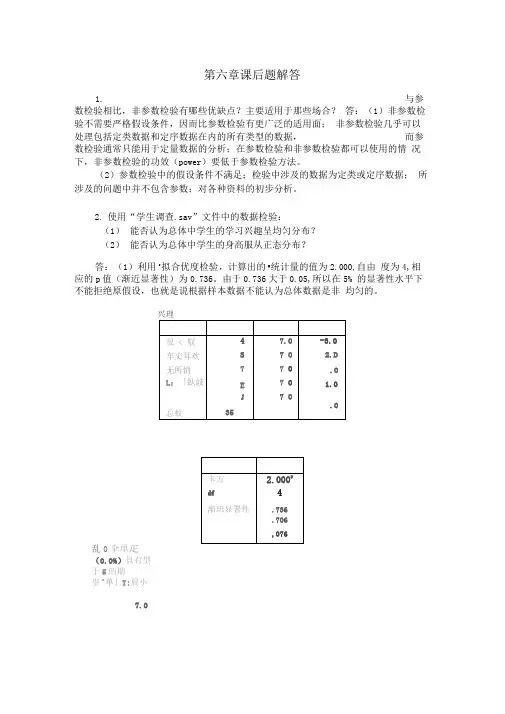
第六章课后题解答1.与参数检验相比,非参数检验有哪些优缺点?主要适用于那些场合?答:(1)非参数检验不需要严格假设条件,因而比参数检验有更广泛的适用面;非参数检验几乎可以处理包括定类数据和定序数据在内的所有类型的数据,而参数检验通常只能用于定量数据的分析;在参数检验和非参数检验都可以使用的情况下,非参数检验的功效(power)要低于参数检验方法。
(2)参数检验中的假设条件不满足;检验中涉及的数据为定类或定序数据;所涉及的问题中并不包含参数;对各种资料的初步分析。
2.使用“学生调查.sav”文件中的数据检验:(1)能否认为总体中学生的学习兴趣呈均匀分布?(2)能否认为总体中学生的身高服从正态分布?答:(1)利用2拟合优度检验,计算出的2统计量的值为2.000,自由度为4,相应的p值(渐近显著性)为0.736。
由于0.736大于0.05,所以在5% 的显著性水平下不能拒绝原假设,也就是说根据样本数据不能认为总体数据是非均匀的。
乱0伞单疋(0.0%)貝有型于5的期峑a单」T:晨小7.0(2)利用单样本K-S检验法,计算出的D max统计量的值为0.899,相应的p值(渐近显著性)为0.394。
由于0.394大于0.05,所以在5%的显著性水平下不能拒绝原假设,也就是说根据样本数据不能认为总体数据是非正态的。
单样進Kolmogor ov-Smirnov 攪腌亂检验分芜为正悲分布乱根据救摇计算得到*表2.23.某企业生产一种钢管,规定长度的中位数是10米。
现随机地从正在生产的生产线上选取10根进行测量,结果为:9.8,10.1,9.7,9.9, 9.8,10.0, 9.7, 10.0,9.9, 9.8。
问该企业的生产过程是否需要调整。
答:单样本中位数的符号检验法检验钢管长度的中位数是否为50,各个数值与中位数比较的结果,有7个值小于10, 1个值大于10, 2个等于10。
样本量较少,输出双侧检验的p值(精确显著性)为0.070。
统计学及应用资料 (8)
符号检验(sign test)是利用某假设下正号和负号的数目做出判定的非参数方法。符号 检验虽然是最简单的非参数检验,但它体现了非参数检验的一些基本思路。首先看一个例子。
例6.1 联合国人员在世界上66个大城市的生活花费指数(以纽约市为100)按自小至大的 次序排列如下(这里北京的指数为99):
率应该与取小于M的概率相等。所研究的问题,可以看作是只有两种可能“成功”或“失败”。
n
成功为“+”,即大于中位数M;失败为“-”,即小于中位数M。令 S I ((xi M) 0) i 1 n
为 xi - M 得正符号的数目,S- I ((xi M) 0) 为 xi - M 得负符号的数目,可以知道 S i 1
通常在正态总体分布的假设下,关于总体均值的假设检验和区间估计是用与t检验有关 的方法进行的。然而,在本例中,总体分布是未知的。为此首先看该数据的直方图,从图6-1-1 中很难说这是什么分布。在右边的两个点分别是东京和香港。
图6-1-1
假定用总体中位数M来表示中间位置,这着意味着样本点 X 1,, X n ,取大于M的的概
+
4
+
5
+
中央财经大学统计学院
中央财经大学统计学院版权所有。内部资料,请勿外传
统计学 第六章 非参数检验
104
5
+
104
5
+
105
6
+
106
7
+
109
10
+
109
10
+
110
11
+
110
11
+
非参数统计第二章 单样本检验
第二节 Wilcoxon符号秩检验
基本概念及性质 对称分布的中心一定是中位数,在非对称分布情况下,中
位数不唯一,研究对称中心比中位数更有意义。 例:下面的数据中,O是对称中心吗?
0
检验步骤
Ex.某公司为减少加工费用,决定若铸件重量的中位数超过 25公斤,就转包加工;若不超过25公斤则不转包。现从这 批铸件中随机抽取8件,每件的重量分别为:24.3,25.8, 25.4,24.8,25.2,25.1,25.0,25.5。使用这些数据,能 否作出这批铸件是否转包的决定。
在0.05的水平下,拒绝前面的两个假设.
中位数的置信区间
根据顺序统计量构造置信区间:
P(X(i) M X( j) ) 1 P(M X(i) ) P(M X( j) )
n ki
Ckn
1 n 2
n
Ckn
kj
1 n 2
1 i j n
由于得到的区域是以中位数对称的,
P
定义, s
n
I(xi M0 )
n
, s I(xi M0 ) ,则 s s
n , K min{s ,s}
i1
i1
在零假设情况下 K ~ B(n,0.5),在显著性水平为 的拒绝域为
Pbinom (K k | n, p 0.5)
其中k是满足上式最大的k值。
结果讨论
结果讨论
H0:M=84,H1:M≠84
按照传统的参数方法,假设房屋价格服从正态分布N(84, σ2),
则检验统计量为
,t其值X为1.384,结论呢? s/ n
第一节 符号检验和置信区间
假设总体 F(x) ,Me是总体的中位数,对于假设检验问题:
H0 : Me M0 H1 : Me M0
wilcoxon符号秩检验例题

Wilcoxon符号秩检验是一种非参数统计检验方法,它适用于样本不满足正态分布的情况,也适用于定序尺度或连续尺度变量的情况。
Wilcoxon符号秩检验的原假设是两组样本的中位数相等,备择假设是两组样本的中位数不相等。
在实际应用中,Wilcoxon符号秩检验常常用于两组样本之间的比较,或者用于检验一个样本的中位数是否等于特定值。
为了更清晰地理解Wilcoxon符号秩检验的原理和应用,我将通过一个具体的例题来进行解析和讨论。
假设我们有两组药物治疗的数据,分别是治疗组和对照组的疗效数据。
我们的目标是比较这两组数据是否存在显著差异,即是否有足够的证据支持治疗组的疗效优于对照组。
我们需要对数据进行初步的描述性统计分析,包括计算两组数据的中位数、四分位数、极差等指标,以及绘制盒图和散点图等图形来观察数据的分布情况。
通过初步的查看和分析,我们可以初步判断两组数据的差异性。
接下来,我们需要进行Wilcoxon符号秩检验。
在进行检验之前,我们需要明确的步骤和计算方法。
我们需要对两组数据进行合并,然后对合并后的数据进行排序,接着给每一个数据项赋予秩次,最后根据秩次求出Wilcoxon检验统计量W的值。
在文章中,我们重点从算法步骤、统计量的计算、Wilcoxon检验的拒绝域判断等方面进行详细讨论。
通过列出计算步骤和具体的计算示例,以及解释拒绝域的含义和确定方式,读者可以更清晰地了解Wilcoxon 符号秩检验的实际操作和推断过程。
在总结部分,我们将对Wilcoxon符号秩检验进行全面回顾,并就其特点、适用范围、优缺点以及应用注意事项进行总结和共享。
还可以结合真实的临床研究或案例数据,探讨Wilcoxon符号秩检验的实际应用和解释。
我将共享一些个人观点和理解:Wilcoxon符号秩检验作为一种非参数检验方法,在实际应用中具有一定的灵活性和鲁棒性,可以有效应对实验数据不满足正态分布、样本量较小等情况,是一种重要的统计推断方法。
非参数统计 符号检验

0
10 51 52
-
11 83 72
+
12 27 33
-
结论:不能拒绝原假设。
-Z0.05=-1.96 ,Z0.05=1.96,
Z=-0.9487不在拒绝域。
根据同样原理,可以将中位数符号检验推广为任意 分位点的符号检验。
例3.1. 假设某地16座预出售的楼盘均价,单位(百元/平方米) 36,32,31,25,28,36,40,32,41,26,35,35,32,87,33,35
H0 : 37 H1 : 37 H0 : M0.75 40 H1 : M0.75 40
36 32 31 25 28 36 40 32 41 26 35 35 32 87 33 35 - -- - -- 0- +- -- -+- -
S+=2, S-=13, Pbinom(15, 0.75){min{S+,S-}<2}=0 因此,拒绝H0。
这种检验被称为符号检验的理由是:它所关心的信息 只与两类观测值有关,用符号“+”“-”区分,符号 检验就是通过符号的个数来进行统计推断。
例3.1 假设某地16座预出售的楼盘均价,单位(百元/平方米)如 下:
36 32 31 25 28 36 40 32
41 26 35 35 32 87 33 35 该地平均楼盘价格是否与媒体公布的3700元/平方米的说法相符?
例3.4 如右表是某种商品在 12家超市促销活动前后的销
连 促销前 促销后 锁 销售额 销售额 符号 店
售额对比表,用符号检验分 1 42 40 +
析促销活动的效果如何?
2 57 60
-
3 38 38
0
6 单一样本的推断问题-符号检验
就用样本中位数. 二者的区别:
符号检验的基本原理:
符号检验的推断过程
规范过程:
1)提出假设
2)构造统计量
3)写出拒绝域(双边或单边)或求出p值
结论:
大样本计算及结论
正态性修正的讨论:
符号检验在配对样本比较中的应用
分位数检验------符号检验的推广
作业1 : 联合国人员在世界上66个大城市生活花费指 数(以纽约市1962年12为100)按自小至大的次序排 列如下(这里北京的指数为99):
补充: R中的t检验法的用法 Paired t-Test data: x and y t = 2.8312, df = 7, p-value = 0.9873 alternative hypothesis: mean of differences is less than 0 95 percent confidence interval: NA 534.1377 sample estimates: mean of x - y 320 接受H0, 认为两种轮胎无显著性差异.
名称的来源:
补充: R中的t检验法的用法
补充: R中的t检验法的用法
1) t-test(x) X1,X2,…,Xn~N(a, σ2), H0 : a=a0 , H1: a≠a0
例如, 某食品厂用自动装罐机装罐头食品,每罐质量为500g, 现从每天生产的罐头中随机抽测9罐,其质量分别为: 510, 505, 498, 503, 492, 502, 497, 506, 495(单位:g) 欲检验H0: a=500, H1: a≠500 > t.test(x-500) data: x - 500 t = 0.46, df = 8, p-value = 0.6578 alternative hypothesis: mean is not equal to 0 95 percent confidence interval: -3.567471 5.345249 sample estimates: mean of x 0.8888889
wilcoxon符号秩检验例题
wilcoxon符号秩检验例题(原创实用版)目录1.威尔科克森符号秩检验的概念和应用场景2.威尔科克森符号秩检验的步骤3.威尔科克森符号秩检验的案例分析4.威尔科克森符号秩检验的 SPSS 操作正文一、威尔科克森符号秩检验的概念和应用场景威尔科克森符号秩检验(Wilcoxon Symbol-Rank Test)是一种非参数检验方法,用于检验两个配对样本的中位数是否存在显著差异。
它适用于中小样本量、数据分布不对称或偏态分布的情况。
威尔科克森符号秩检验的主要应用场景包括:检验单一总体的中位数、检验配对样本的中位数和检验等级资料的符号测试等。
二、威尔科克森符号秩检验的步骤1.构建假设:H0:配对样本的中位数相同;H1:配对样本的中位数存在显著差异。
2.计算差值:将两个配对样本的数值相减,得到差值。
3.排序:对差值进行排序,并计算差值的符号。
4.计算统计量:根据符号和差值的排序,计算威尔科克森统计量。
5.假设检验:根据威尔科克森统计量和相应的概率分布,查找临界值,比较计算得到的统计量和临界值,判断是否拒绝原假设。
三、威尔科克森符号秩检验的案例分析以一项配对样本的鼻饲护理知识测试为例,研究者希望通过威尔科克森符号秩检验分析护士在培训前后的鼻饲护理知识得分是否存在显著差异。
首先,研究者需要对护士在培训前后的鼻饲护理知识得分进行差值计算和排序,然后计算威尔科克森统计量。
最后,根据威尔科克森统计量和临界值,判断培训前后护士的鼻饲护理知识得分是否存在显著差异。
四、威尔科克森符号秩检验的 SPSS 操作1.生成差值:在 SPSS 中,选择“计算变量”->“差值”,将培训后得分减去培训前得分,得到差值变量。
2.正态性检验:对差值进行正态性检验,选择“分析”->“正态性”->“正态性检验”,将差值放入因变量列表,点击“图”,勾选含检验的正态图;点击“继续”,确定。
若 P 值大于 0.05,则认为差值服从正态分布;若 P 值小于 0.05,则认为差值不服从正态分布。
2.1 符号检验
9.7 9.7 9.8 9.8 9.8 9.9 9.9 10.0 10.0 10.1
在显著性水平
下,样本数据个数为n,查到左尾的正好和右尾的负
号的数目为 ,因此中位数 的 置信区间为
故中位数 的0.05的置信区间为
k2 95%
X(21) Me X(102)
Me 95%
Me
9.8,10
第二章 单一样本的推断问题
2.1符号检验及分位数的 推断问题
(连续分布)
2. 1 符号检验及分位数的推断问题(连续分布)
例1:假设某城市16座预出售的楼盘均价(单位:百元/m2 )
如下表所示:
16座预出售的楼盘均价
36
32
31
25
28
36
40
32
41
26
35
35
32
87
33
35
问:该地区平均楼盘价格是否与媒体公布的3700元/ m2
40
4
0.1 Z 1.96 在给定显著性水平
下,
由于
,证据不足,不能拒绝零假设,没有证据1显示客户在品牌
A和B上Z存在显1著.差96异
2
而实际中,A品牌和B品牌固然存在差异,可能由于随机抽样产生, 并非本质差异.随机性是客观存在而无法避免的,检验中表现出来统计 量显著的差异则是本质差异.
4.置信区间
0.1
解:设 P( A), P(B)表示喜欢A,B品牌的客户比例
建立假设检验:
记 H表0示: 喜P(欢AA)品牌P的(客B户) 人数H,1 :为P喜( A欢)B品牌P的(B客)户人数
由于
S, 所以取正态分布正修正
n S S 22
18
T检验例题
T检验习题1.按规定苗木平均高达1.60m以上可以出圃,今在苗圃中随机抽取10株苗木,测定的苗木高度如下:1。
75 1。
58 1。
71 1。
64 1.55 1。
72 1.62 1.83 1.63 1。
65 假设苗高服从正态分布,试问苗木平均高是否达到出圃要求?(要求α=0.05)解:1)根据题意,提出:无效假设为:苗木的平均苗高为H0=1.6m;备择假设为:苗木的平均苗高H A>1.6m;2)定义变量:在spss软件中的“变量视图”中定义苗木苗高,之后在“数据视图”中输入苗高数据;3)分析过程在spss软件上操作分析过程如下:分析——比较均值——单样本T检验——将定义苗高导入检验变量——检验值定义为1。
6-—单击选项将置信区间设为95%——确定输出如下:表1.1:单个样本统计量表1。
2:单个样本检验4)输出结果分析由表1。
1数据分析可知,变量苗木苗高的平均值为1。
6680m,标准差为0.0843,说明样本的离散程度较小,标准误为0.0267,说明抽样误差较小。
由表1.3数据分析可知,T检验值为2.55,样本自由度为9,t检验的双尾检验值为0。
031〈0。
05,说明差异性显著,因此,否定无效假设H0,取备择假设H A。
根据题意,苗木的苗高服从正态分布,由以上分析知:在显著水平为0.05的水平上检验,苗木的平均苗高大于1.6m,符合出圃的要求。
习题2.从两个不同抚育措施育苗的苗圃中各以重复抽样的方式抽得样本如下:样本1苗高(CM):52 58 71 48 57 62 73 68 65 56样本2苗高(CM):56 75 69 82 74 63 58 64 78 77 66 73设苗高服从正态分布且两个总体苗高方差相等(齐性),试以显著水平α=0。
05检验两种抚育措施对苗高生长有无显著性影响。
解:1)根据题意提出:无效假设为H0:两种抚育措施对苗木生长没有显著的影响;备择假设H A:两种抚育措施对苗高生长影响显著;2)在spss中的“变量视图”中定义变量“苗高1",“抚育措施”,之后在“数据视图”中输入题中的苗高数据,及抚育措施,其中措施一定义为“1”措施二定义为“2”;3)分析过程在spss软件上操作分析过程如下:分析--比较变量——独立样本T检验-—将“苗高1变量"导入“检验变量”——将“抚育措施"导入“分组变量”—-定义组,其中:组一定义为“1”组二定义为“2"——单击选项将置信区间设为95%—-输出分析数据如下;表2。
(李晓松主编 第2版 高等教育出版社)附录 第12章思考与练习答案
第十二章 秩和检验【思考与练习】一、思考题1. 简述参数检验和非参数检验的区别。
2. 简述非参数检验的适用范围。
3. 同一资料,又出于同一研究目的,当参数检验和非参数检验所得结果不一致时,以何者为准,请简述理由。
二、案例辨析题某儿科医生比较甲、乙、丙三种药物治疗小儿腹泻的疗效,将379名小儿腹泻患者随机分为三组,分别采用甲、乙、丙三种药物治疗,结果见表12-1。
表12-1 三种药物治疗小儿腹泻的疗效比较疗效 甲药 乙药 丙药 合计 痊愈 175 5 1 181 显效 95 55 5 155 进步 64 6 30 100 无效 45 35 6 86 合计37910142522对于上述资料,该医生采用行×列表2χ检验,得2176.271χ=,0.01P <,故认为三种药物的疗效有差别。
该结论是否正确,为什么?三、最佳选择题1.以下方法中属于参数检验方法的是 A. t 检验 B. H 检验 C. M 检验D. Wilcoxon 符号秩和检验E. Wilcoxon 秩和检验2.进行两小样本定量资料比较的假设检验时,首先应考虑 A. t 检验 B. Z 检验C. 秩和检验D. 2χ检验E. 满足参数检验还是非参数检验的条件3.两组定量资料的比较,若已知1n 、2n 均小于30,总体方差不齐且呈极度偏态分布,宜采用 A. t 检验 B. t '检验 C. Z 检验 D. 方差分析 E. 秩和检验4. 欲比较三种药物治疗效果有无差异,如果治疗效果为有序分类变量,宜采用 A. t 检验 B. 方差分析 C. 2χ检验D .Wilcoxon 秩和检验 E. H 检验5. 成组设计两样本比较的秩和检验,检验统计量T 通常为 A. 较小的秩和 B. 较大的秩和C. 样本含量较小组的秩和D. 样本含量较大组的秩和E. 任取一组的秩和均可6. 配对设计秩和检验,若检验假设0H 成立,则 A. 差值为正的秩和与差值为负的秩和相差不会很大 B. 差值为正的秩和与差值为负的秩和可能相差很大 C. 差值为正的秩和与差值为负的秩和肯定相等 D. 正秩和的绝对值大于负秩和的绝对值 E. 正秩和的绝对值小于负秩和的绝对值7. 下列资料类型中,不宜采用秩和检验的是A. 正态分布资料B. 等级资料C. 分布类型未知资料D. 极度偏态分布资料E. 数据一端不确定的资料8. 某资料经配对秩和检验得34n查双侧T界值如下,则P值为==T,由20双侧概率0.10 0.05 0.02 0.01T界值60~150 52~158 43~167 37~173 A. 10>P.0B. 10<P.0<.005C. 05<P.0<02.0D. 02<P.0<01.0E. 01P.0<9. 下列关于非参数检验的叙述错误的是A. 非参数检验不依赖于总体的分布类型B. 非参数检验仅用于等级资料比较C. 适合参数检验的资料采用非参数检验会降低检验效能D. 非参数检验会损失部分样本信息E. 秩和检验是一种非参数检验方法四、综合分析题1. 已知某地正常人尿氟含量的中位数为2.15mmol/L。