
编译原理教程课后习题参考答案——
第二章 词法分析
2.1 完成下列选择题:
(1) 词法分析器的输出结果是 。
a. 单词的种别编码
b. 单词在符号表中的位置
c. 单词的种别编码和自身值
d. 单词自身值
(2) 正规式M1和M2等价是指 。
a. M1和M2的状态数相等
b. M1和M2的有向边条数相等
c. M1和M2所识别的语言集相等
d. M1和M2状态数和有向边条数相等
(3) DFA M(见图2-1)接受的字集为 。
a. 以0开头的二进制数组成的集合
b. 以0结尾的二进制数组成的集合
c. 含奇数个0的二进制数组成的集合
d. 含偶数个0的二进制数组成的集合
【解答】
(1) c (2) c (3) d
图2-1 习题2.1的DFA M
2.2 什么是扫描器?扫描器的功能是什么?
【解答】 扫描器就是词法分析器,它接受输入的源程序,对源程序进行词法分析并识别出一个个单词符号,其输出结果是单词符号,供语法分析器使用。
通常是把词法分析器作为一个子程序,每当词法分析器需要一个单词符号时就调用这个子程序。
每次调用时,词法分析器就从输入串中识别出一个单词符号交给语法分析器。
2.3 设M=({x,y}, {a,b}, f, x, {y})为一非确定的有限自动机,其中f 定义如下:
f(x,a)={x,y} f {x,b}={y}
f(y,a)=Φ f{y,b}={x,y}
试构造相应的确定有限自动机M ′。
【解答】 对照自动机的定义M=(S,Σ,f,So,Z),由f 的定义可知f(x,a)、f(y,b)均为多值函数,因此M 是一非确定有限自动机。
先画出NFA M 相应的状态图,如图2-2所示。
图2-2 习题2.3的NFA M 用子集法构造状态转换矩阵,如表表2-1 状态转换矩阵
1b
将转换矩阵中的所有子集重新命名,形成表2-2所示的状态转换矩阵,即得到 M ′=({0,1,2},{a,b},f,0,{1,2}),其状态转换图如图2-3所示。
表2-2 状态转换矩阵
将图2-3所示的DFA M ′最小化。
首先,将M ′的状态分成终态组{1,2}与非终态组{0}。
其次,考察{1,2},由于{1,2}a={1,2}b={2}⊂{1,2},所以不再将其划分了,也即整个划分只有两组:{0}和{1,2}。
令状态1代表{1,2},即把原来到达2的弧都导向1,并删除状态2。
最后,得到如图2-4所示的化简了的DFA M ′。
′
DFA M ′
2.4 正规式(ab)*a 与正规式a(ba)*是否等价?请说明理由。
【解答】 正规式(ab)*a 对应的NFA
如图2-5所示,正规式a(ba)*对应的NFA 如图2-6
图2-5 正规式(ab)*a 对应的NFA
图2-6 正规式a(ba)*对应的DFA
这两个正规式最终都可得到最简DFA ,如图2-7所示。
因此,这两个正规式等价。
a, b a a, b
图2-7 最简NFA
2.5 设有L(G)={a2n+1b2ma2p+1| n ≥0,p ≥0,m ≥1}。
(1) 给出描述该语言的正规表达式;
(2) 构造识别该语言的确定有限自动机(可直接用状态图形式给出)。
【解答】 该语言对应的正规表达式为a(aa)*bb(bb)*a(aa)*,正规表达式对应的NFA 如图2-8所示。
图2-8 习题2-5的NFA 用子集法将图2-8确定化,如图2-9所示。
由图2-9重新命名后的状态转换矩阵可化简为(也可由最小化方法得到) {0,2} {1} {3,5} {4,6} {7}
按顺序重新命名为0、1、2、3、4后得到最简的DFA ,如图2-10所示。
图2-9 习题2.5的状态转换矩阵
图2-10 习题2.5的最简DFA
2.6 有语言L={w|w ∈(0,1)+,并且w 中至少有两个1,又在任何两个1之间有偶数个0},试构造接受该语言的确定有限状态自动机(DFA)。
【解答】 对于语言L ,w 中至少有两个1,且任意两个1之间必须有偶数个0;也即在第一个1之前和最后一个1之后,对0的个数没有要求。
据此我们求出L 的正规式为0*1(00(00)*1)*00(00)*10*,画出与正规式对应的NFA ,如图2-11所示。
习题2.6的NFA
a a 重新命名a
b a
用子集法将图2-11的NFA确定化,如图2-12所示。
图
2-12 习题2.6的状态转换矩阵
由图2-12可看出非终态2和4的下一状态相同,终态6和8的下一状态相同,即得到最简状态为
{0}、{1}、{2,4}、{3}、{5}、{6,8}、{7}
按顺序重新命名为0、1、2、3、4、5、6,则得到最简DFA,如图2-13所示。
2.7 已知正规式((a|b)*|aa)*b和正规式(a|b)*b。
(1) 试用有限自动机的等价性证明这两个正规式是等价的;
(2) 给出相应的正规文法。
2-14所示。
对应的NFA 用子集法将图2-14所示的NFA确定化为DFA,如图2-15所示。
图2-15 图2-14确定化后的状态转换矩阵
重新命名
重新命名
由于对非终态的状态1、2来说,它们输入a 、b 的下一状态是一样的,故状态1和状态2可以合并,将合并后的终态3命名为2,则得到表2-3(注意,终态和非终态即使输入a 、b 的下一状态相同也不能合并)。
由此得到最简DFA ,如图2-16所示。
正规式(a|b)*b 对应的NFA 如图2-17所示。
表2-3 合并后的状态转换矩阵
图2-16 习题2.7的最简DFA
图2-17 正规式(a|b)*b 对应的NFA
用子集法将图2-17所示的NFA 确定化为如图2-18所示的状态转换矩阵。
图2-18 图2-17确定化后的状态转换矩阵
比较图2-18与图2-15,重新命名后的转换矩阵是完全一样的,也即正规式(a|b)*b 可以同样得到化简后的DFA 如图2-16所示。
因此,两个自动机完全一样,即两个正规文法等价。
(2) 对图2-16,令A 对应状态1,B 对应状态2,则相应的正规文法G[A]为 G[A]:A →aA|bB|b
B →aA|bB|b
G[A]可进一步化简为G[S]:S →aS|bS|b(非终结符B 对应的产生式与A 对应的产生式相同,故两非终结符等价,即可合并为一个产生式)。
2.8 下列程序段以B 表示循环体,A 表示初始化,I 表示增量,T 表示测试:
I=1;
while (I<=n)
{
sun=sun+a[I];
I=I+1;}
b
a
a b 重新命名
请用正规表达式表示这个程序段可能的执行序列。
【解答】 用正规表达式表示程序段可能的执行序列为A(TBI)*。
2.9 将图2-19所示的非确定有限自动机(NFA)变换成等价的确定有限自动机
(DFA)。
图2-19 习题2.9的NFA
其中,X 为初态,Y 为终态。
【解答】 用子集法将NFA 确定化,如图2-20所示。
图2-2习题2.9的状态转换矩阵
图2-20所对应的DFA 如图2-21所示。
习题2.9的DFA
习题2.9的最简DFA
对图2-21的DFA 进行最小化。
首先将状态分为非终态集和终态集两部分:{0,1,2,5}和
b 重新命名
{3,4,6,7}。
由终态集可知,对于状态3、6、7,无论输入字符是a还是b的下一状态均为终态集,而状态4在输入字符b的下一状态落入非终态集,故将其化为分
{0,1,2,5}, {4}, {3,6,7}
对于非终态集,在输入字符a、b后按其下一状态落入的状态集不同而最终划分为{0}, {1}, {2}, {5}, {4}, {3,6,7}
按顺序重新命名为0、1、2、3、4、5,得到最简DFA如图2-22所示。
2.10 有一台自动售货机,接收1分和2分硬币,出售3分钱一块的硬糖。
顾客每次向机器中投放≥3分的硬币,便可得到一块糖(注意:只给一块并且不找钱)。
(1) 写出售货机售糖的正规表达式;
(2) 构造识别上述正规式的最简DFA。
【解答】(1) 设a=1,b=2,则售货机售糖的正规表达式为a (b|a(a|b))|b(a|b)。
(2) 画出与正规表达式a(b|a(a|b))|b(a|b)对应的NFA,如图2-23所示。
图2-23 习题2.10的NFA
用子集法将图2-21的NFA确定化,如图2-24所示。
图2-24 习题
2.10的状态转换矩阵
由图2-24可看出,非终态2和非终态3面对输入符号a或b的下一状态相同,故合并为一个状态,即最简状态{0}、{1}、{2,3}、{4}。
按顺序重新命名为0、1、2、3,则得到最简DFA,如图2-25所示。
图2-25 习题2.10的最简DFA
重新命名。
编译原理课后习题答案

(a) 0 ( 0 | 1)* 0
由0和1组成且以0开始和结束的符号串全体. (b) ( ( | 0 ) 1* ) * 由0和1组成的符号串全体.
(c) ( 0 | 1 )* 0 ( 0 | 1) ( 0 | 1) 由0和1组成且以000,001,010或011结束的符号串全体. 长度大于等于3且倒数第3个字符为0的01符号串全体.
R R ‘|’ S | S S ST | T T U* | U U (R) | a | b
a
a
a
28
4.5 dangling-else文法: stmt if expr then stmt | matched-stmt matched-stmt if expr then matched-stmt else stmt | other 试说明此文法是二义性的。 句子 if e1 then if e2 then s1 else if e3 then s2 else s3 if e1 then if e2 then s1 else if e3 then s2 else s3
0|1 B 1 D E 0 ABDE ABDE ABCDE ABDE 1 ABCDE ABCDE
start
A
1
C
NFA 0
start A' 1
0
B'
0
1
start
A'
1
最小化DFA
24
DFA
3.8 给定右线性文法G: S 0S | 1S | 1A | 0B A 1C |1 B 0C | 1 C 0C | 1C | 0 | 1 试求一个等价的左线性文法G’.
20
3.6 给出接受下列在字母表{0,1}上的DFA。 (a)所有以00结束的符号串的集合; (1|0)*00
编译原理课后答案-第二版
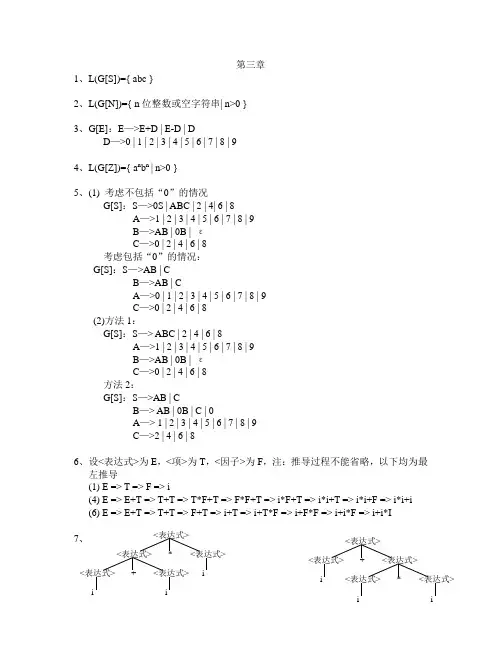
第三章1、L(G[S])={ abc }2、L(G[N])={ n位整数或空字符串| n>0 }3、G[E]:E—>E+D | E-D | DD—>0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 94、L(G[Z])={ a n b n | n>0 }5、(1) 考虑不包括“0”的情况G[S]:S—>0S | ABC | 2 | 4| 6 | 8A—>1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9B—>AB | 0B | εC—>0 | 2 | 4 | 6 | 8考虑包括“0”的情况:G[S]:S—>AB | CB—>AB | CA—>0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9C—>0 | 2 | 4 | 6 | 8(2)方法1:G[S]:S—> ABC | 2 | 4 | 6 | 8A—>1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9B—>AB | 0B | εC—>0 | 2 | 4 | 6 | 8方法2:G[S]:S—>AB | CB—> AB | 0B | C | 0A—> 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9C—>2 | 4 | 6 | 86、设<表达式>为E,<项>为T,<因子>为F,注:推导过程不能省略,以下均为最左推导(1) E => T => F => i(4) E => E+T => T+T => T*F+T => F*F+T => i*F+T => i*i+T => i*i+F => i*i+i(6) E => E+T => T+T => F+T => i+T => i+T*F => i+F*F => i+i*F => i+i*I7、<表达式><表达式>*<表达式><表达式>+<表达式>i i i<表达式><表达式>+<表达式>i <表达式>*<表达式>i i8、是有二义性的,因为句子abc 有两棵语法树(或称有两个最左推导或有两个最右推导)最左推导1:S => Ac => abc 最左推导2:S => aB => abc 9、(1)(2) 该文法描述了变量a 和运算符+、*组成的逆波兰表达式10、(1) 该文法描述了各种成对圆括号的语法结构(2) 是有二义性的,因为该文法的句子()()存在两种不同的最左推导: 最左推导1:S => S(S)S => (S)S => ()S => ()S(S)S => ()(S)S => ()()S => ()()最左推导2:S => S(S)S => S(S)S(S)S => (S)S(S)S=> ()S(S)S => ()(S)S => ()()S => ()()11、(1) 因为从文法的开始符E 出发可推导出E+T*F ,推导过程如下:E => E+T =>E+T*F ,所以E+T*F 是句型。
编译原理(龙书)课后习题解答(详细)

编译原理(龙书)课后习题解答(详细)编译原理(龙书)课后题解答第一章1.1.1 :翻译和编译的区别?答:翻译通常指自然语言的翻译,将一种自然语言的表述翻译成另一种自然语言的表述,而编译指的是将一种高级语言翻译为机器语言(或汇编语言)的过程。
1.1.2 :简述编译器的工作过程?答:编译器的工作过程包括以下三个阶段:(1) 词法分析:将输入的字符流分解成一个个的单词符号,构成一个单词符号序列;(2) 语法分析:根据语法规则分析单词符号序列中各个单词之间的关系,确定它们的语法结构,并生成抽象语法树;(3) 代码生成:根据抽象语法树生成目标程序(机器语言或汇编语言),并输出执行文件。
1.2.1 :解释器和编译器的区别?答:解释器和编译器的主要区别在于执行方式。
编译器将源程序编译成机器语言或汇编语言等,在运行时无需重新编译,程序会一次性运行完毕;而解释器则是边翻译边执行,每次执行都需要进行一次翻译,一次只执行一部分。
1.2.2 :Java语言采用的是解释执行还是编译执行?答:Java一般是编译成字节码的形式,然后由Java虚拟机(JVM)进行解释执行。
但是,Java也有JIT(即时编译器)的存在,当某一段代码被多次执行时,JIT会将其编译成机器语言,提升代码的执行效率。
第二章2.1.1 :使用BNF范式定义简单的加法表达式和乘法表达式答:<加法表达式> ::= <加法表达式> "+" <乘法表达式> | <乘法表达式><乘法表达式> ::= <乘法表达式> "*" <单项式> | <单项式><单项式> ::= <数字> | "(" <加法表达式> ")"2.2.3 :什么是自下而上分析?答:自下而上分析是指从输入字符串出发,自底向上构造推导过程,直到推导出起始符号。
编译原理(第2版)课后习题答案详解
第1 章引论第1 题解释下列术语:(1)编译程序(2)源程序(3)目标程序(4)编译程序的前端(5)后端(6)遍答案:(1)编译程序:如果源语言为高级语言,目标语言为某台计算机上的汇编语言或机器语言,则此翻译程序称为编译程序。
(2)源程序:源语言编写的程序称为源程序。
(3)目标程序:目标语言书写的程序称为目标程序。
(4)编译程序的前端:它由这样一些阶段组成:这些阶段的工作主要依赖于源语言而与目标机无关。
通常前端包括词法分析、语法分析、语义分析和中间代码生成这些阶段,某些优化工作也可在前端做,也包括与前端每个阶段相关的出错处理工作和符号表管理等工作。
(5)后端:指那些依赖于目标机而一般不依赖源语言,只与中间代码有关的那些阶段,即目标代码生成,以及相关出错处理和符号表操作。
(6)遍:是对源程序或其等价的中间语言程序从头到尾扫视并完成规定任务的过程。
第2 题一个典型的编译程序通常由哪些部分组成?各部分的主要功能是什么?并画出编译程序的总体结构图。
答案:一个典型的编译程序通常包含8 个组成部分,它们是词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、中间代码优化程序、目标代码生成程序、表格管理程序和错误处理程序。
其各部分的主要功能简述如下。
词法分析程序:输人源程序,拼单词、检查单词和分析单词,输出单词的机内表达形式。
语法分析程序:检查源程序中存在的形式语法错误,输出错误处理信息。
语义分析程序:进行语义检查和分析语义信息,并把分析的结果保存到各类语义信息表中。
中间代码生成程序:按照语义规则,将语法分析程序分析出的语法单位转换成一定形式的中间语言代码,如三元式或四元式。
中间代码优化程序:为了产生高质量的目标代码,对中间代码进行等价变换处理。
目标代码生成程序:将优化后的中间代码程序转换成目标代码程序。
表格管理程序:负责建立、填写和查找等一系列表格工作。
表格的作用是记录源程序的各类信息和编译各阶段的进展情况,编译的每个阶段所需信息多数都从表格中读取,产生的中间结果都记录在相应的表格中。
编译原理课后习题答案
编译原理课后习题答案编译原理习题答案习题11.1翻译程序:把⽤某种程序设计语⾔(源语⾔)编写的程序(源程序)翻译成与之等价的另⼀种语⾔(⽬标语⾔)的程序(⽬标程序)。
编译程序:⼀种翻译程序,将⾼级语⾔编写的源程序翻译成等价的机器语⾔或汇编语⾔的⽬标程序。
1.2词法分析、语法分析、语义分析和中间代码⽣成、代码优化、⽬标代码⽣成1.3词法分析:根据语⾔的词法规则对构成源程序的符号进⾏扫描和分解,识别出⼀个个的单词。
语法分析:根据语⾔的语法规则,把单词符号串分解成各类语法单位。
语义分析及中间代码⽣成:对语法分析识别出的语法单位分析其含义,并进⾏初步翻译。
代码优化:对中间代码进⾏加⼯变换,以产⽣更⾼效的⽬标代码。
⽬标代码⽣成:将中间代码变换成特定机器上的绝对指令代码、可重定位的指令代码或会变指令代码。
以上5个阶段依次执⾏。
习题22.1 (1)有穷⾮空的符号集合(2)利⽤产⽣是规则A->v将A替换为v时与A的上下⽂⽆关。
(3)略(4)推导是把句型中的⾮终结符⽤⼀个产⽣是规则的右部开替代的过程;直接推导是将⾮终结符的替代结果只⽤了⼀次产⽣式规则。
(5)略(6)⼀个句型的最左直接短语(7)如果⼀个⽂法存在某个句⼦对应两棵不同的语法树或有两个不同的最左(右)推导,则称这个⽂法是⼆义的。
2.2(1)VN ={Z,A,B} VT ={a,b,c,d,e}(2)abbcde,abbbcde是,acde不是。
2.3 (1)L[G]={d|n≥1,m≥0}(2)2.4 (1) A=>B=>c=>fAg=>fBg=>fCg=>feg(2)A=>AaB=>AaC=>Aae=>Bae=>BcCae=>Bceae=>Cceae=>eceae(3)A=>B=>BcC=>BcfAg=>BcfAaBg=>BcfAaCg=>BcfAaeg=>BcfBaeg =>BcfCaeg=>Bcfeaeg=>Ccfeaeg=>ecfeaeg(3)中题⽬有错应为C fCg|e2.5L[G]={a?b?c?|aab,n≥2}2.6 (1)Z→AB A→Aa|ε B→Bb|ε(2)Z→aZb|ab(3)Z→aAb A→aAb|b(4)Z→AB A→aAb|ab B→cB|ε(5)Z→aaAb|ab Z→aaBb|bb A→aaAb|ab B→aaBb|bb2.7 ⼀位数:Z→2|4|6|8两位数:Z→AB A→1|2|3|4|5|6|7|8|9 B→0|2|4|6|8三位以上:Z→ACB A→1|2|3|4|5|6|7|8|9 B→0|2|4|6|8 C→CDD→0|1|2|3|4|5|6|7|8|92.8证明:E=>E+T=>E+T*F短语:T*F E+T*F 直接短语:T*F 句柄:T*F2.9 语法树: E 短语:E*T , (E*T) , F↑(E*T) ,F ,E* F↑(E*T)E *F 直接短语:E*T , FT ↑ F 句柄:FF ( E )E * T2.10(1)语法树(2)直接短语:a , ZZ 句柄:Z( L )L , ZZ ( L )Za2.11最左推导:Z=>ZaB=>BaB=>B+AaB=>A+AaB=>(+)Z*aB=>(+)ZaB*aB =>(+)+aB*aB=>(+)+aA*aB=>(+)+a(*aB=>(+)+a(*aA=>(+)+a(*a(直接短语:(,+句柄:(2.12(1) S=>iSeS=>iiSeS=>iiIeS=>iiIeIS=>iS=>iiSeS=>iiIeS=>iiIeI(2) S=>SaS=>cSaS=>cfaS=>cfafS=>cS=>cSaS=>cfaS=>cfaf(3) E=>EOE=>EOEOE=>iOEOE=>i+EOE=>i+iOE=>i+i-E=>i+i-iE=>EOE=>iOE=>i+E=>i+EOE=>i+iOE=>i+i-E=>i+i-i2.13 Z→aABZ|cCACdA→bAB|aZA|cCCB→bAB|CzbC→cZ|c习题33.1(1)确定的有限⾃动机(2)不确定的有限⾃动机(3)正规集是⼀类特殊的单词集合,正规式是正规集的描述⼯具 3.2 (1) (1|2|3|4|5|6|7|8|9|0)*(1|3|5|7|9) (2) 11(0|1)*00 3.3 证明:b *(a|b)+={a,b,ab,ba,aa,bb …} (a|b)+={a,b,ab,ba,aa,bb …} 3.4 (1)(2)DDDD3.5(1) (2)(3)3.6(1) (01|10) *(01|10)(2) (0(1|00)*)|003.7(1) Z →1AB (2)Z →ABA →(0|1)A A →0A|εA →0|1B →(0|1)B|ε B →0B B →ε3.8 r=a(a|b )*bb3.9 Z →1BB →0Z|0 Z →0Z|ε3.10 3.11DDD习题44.1 (1)若⽂法G[Z]满⾜①⽂法不含左递归②③(2)4.2(1) First(S)={a,d} First(B)={a,d,c,ε}First(A)={a,d,e,c} First(D)={a,d,ε}Follow(S)={#,a,b,d,e} Follow(B)={a,d}Follow(A)={b} Follow(D)={e,a,d,b}(2) 不是4.3 (1) 证明: First(Z)={a,b,c} Follow(S)={#,a,b,c,d} First(A)={a,b,c,d} Follow(A)={ #,a,b,c,d }First(B)={a,d,c} Follow(B)={ a,b,c,d } 是LL(1)⽂法。
编译原理部分课后答案,仅供参考
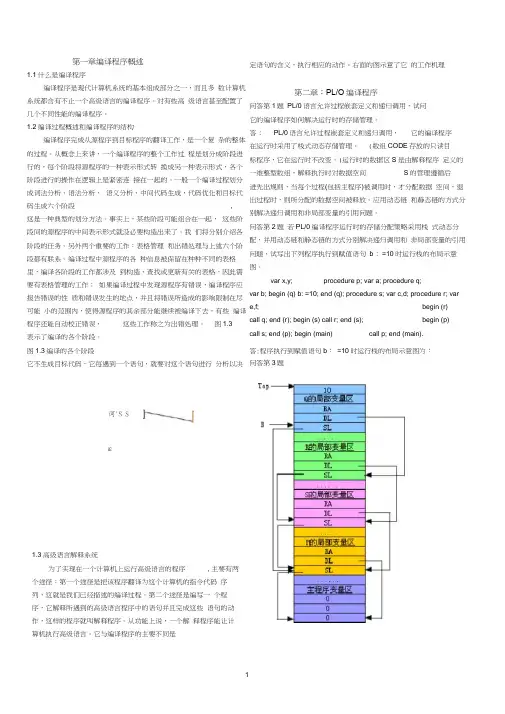
第一章编译程序概述1.1什么是编译程序编译程序是现代计算机系统的基本组成部分之一,而且多 数计算机系统都含有不止一个高级语言的编译程序。
对有些高 级语言甚至配置了几个不同性能的编译程序。
1.2编译过程概述和编译程序的结构编译程序完成从源程序到目标程序的翻译工作,是一个复 杂的整体的过程。
从概念上来讲,一个编译程序的整个工作过 程是划分成阶段进行的,每个阶段将源程序的一种表示形式转 换成另一种表示形式,各个阶段进行的操作在逻辑上是紧密连 接在一起的。
一般一个编译过程划分成词法分析、语法分析、 语义分析、中间代码生成,代码优化和目标代码生成六个阶段,这是一种典型的划分方法。
事实上,某些阶段可能组合在一起, 这些阶段间的源程序的中间表示形式就没必要构造岀来了。
我 们将分别介绍各阶段的任务。
另外两个重要的工作:表格管理 和岀错处理与上述六个阶段都有联系。
编译过程中源程序的各 种信息被保留在种种不同的表格里,编译各阶段的工作都涉及 到构造、查找或更新有关的表格,因此需要有表格管理的工作; 如果编译过程中发现源程序有错误,编译程序应报告错误的性 质和错误发生的地点,并且将错误所造成的影响限制在尽可能 小的范围内,使得源程序的其余部分能继续被编译下去,有些 编译程序还能自动校正错误, 这些工作称之为岀错处理。
图1.3表示了编译的各个阶段。
图1.3编译的各个阶段它不生成目标代码,它每遇到一个语句,就要对这个语句进行 分析以决定语句的含义,执行相应的动作。
右面的图示意了它 的工作机理第二章:PL/O 编译程序问答第1题 PL/0语言允许过程嵌套定义和递归调用,试问 它的编译程序如何解决运行时的存储管理。
答:PL/0语言允许过程嵌套定义和递归调用,它的编译程序在运行时采用了栈式动态存储管理。
(数组CODE 存放的只读目 标程序,它在运行时不改变。
)运行时的数据区S 是由解释程序 定义的一维整型数组,解释执行时对数据空间S 的管理遵循后进先岀规则,当每个过程(包括主程序)被调用时,才分配数据 空间,退出过程时,则所分配的数据空间被释放。
《编译原理教程》课后习题答案第三章语法分析
第三章 语法分析 来消除左递归。由此,将产生式B→Bb|d改造为
B→dB′ B′→bB′| ε
其次,应通过提取公共左因子的方法来消除G[A]中的回 溯,即将产生式A→aABl|a改造为 A→aA′ A′→ABl | ε
最后得到改造后的文法为 G[A′]:A→aA′ A′→ABl | ε B→dB′ B′→bB′| ε
S→(T) | aS′ S′→+S | ε T→ST′ T′→,ST′| ε 改造后的文法已经是LL(1)文法,不带回溯的递归子程序如下: void match (token t)
{ if ( lookahead==t) lookahead=nexttoken; else error ( ); }
第三章 语法分析 void S ( ) {
第三章 语法分析 3.3 已知文法G[S]为S→aSb|Sb|b,试证明文法
G[S]为二义文法。 【 解 答】 由 文 法G[S] :S→aSb|Sb|b ,对 句 子
aabbbb可对应如图3-1所示的两棵语法树。
第三章 语法分析
S aSb aSb
Sb b
S Sb aSb aSb b
图3-1 句子aabbbb对应的两棵不同语法树
第三章 语法分析
求得:
FIRST(A)={a}
FIRST(A′)={a, ε }
FIRST(B)={d}
FIRST(B′)={b, ε }
对文法开始符号A,有FOLLOW(A)={#}。
由 A′→ABl 得 FIRST(B)\{ ε }FOLLOW(A) , 即 FOLLOW(A)={#,d};
第三章 语法分析 【解答】 (1) 消除左递归后,文法G[D′]如下:
D→TL T→int|long|short L→idL
编译原理教程(第二版)胡元义课后答案第二章
第二章 词法分析 对图2-21的DFA进行最小化。首先将状态分为非终态 集和终态集两部分:{0,1,2,5}和{3,4,6,7}。由终态集 可知,对于状态3、6、7,无论输入字符是a还是b的下一 状态均为终态集,而状态4在输入字符b的下一状态落入 非终态集,故将其化为分 {0,1,2,5}, {4}, {3,6,7} 对于非终态集,在输入字符a、b后按其下一状态落 入的状态集不同而最终划分为
重新命名
图2-9 习题2.5的状态转换矩阵
第二章 词法分析
a 0 a 1 b 2
b b 3
a a 4
图2-10 习题2.5的最简DFA
第二章 词法分析 2.6 有语言L={w|w∈(0,1)+,并且w中至少有两个
1,又在任何两个1之间有偶数个0},试构造接受该语
言的确定有限状态自动机(DFA)。
M′=({0,1,2},{a,b},f,0,{1,2}),其状态转换图如图
2-3所示。
第二章 词法分析 表2-2 状态转换矩阵
f 状态 0 1 2 字符
a 2 — 2
b 1 2 2
第二章 词法分析 将图2-3所示的DFA M′最小化。首先,将M′的状 态分成终态组{1,2}与非终态组{0}。其次,考察{1,2},
0 0 0 1 1 0 2 0 3 1 4 0 5 1 0 0 6
图2-13 习题2.6的最简DFA
第二章 词法分析 2.7 已知正规式((a|b)*|aa)*b和正规式(a|b)*b。
(1) 试用有限自动机的等价性证明这两个正规式
是等价的;
(2) 给出相应的正规文法。 【解答】 图2-14所示。 (1) 正规式((a|b)*|aa)*b对应的NFA如
编译原理习题参考答案
编译原理习题参考答案第⼆章2.构造产⽣下列语⾔的⽂法(2){a n b m c p|n,m,p≥0}解: G(S) :S→aS|X,X→bX|Y,Y→cY|ε(3){a n # b n|n≥0}∪{cn # dn|n≥0}解: G(S):S→X,S→Y,X→aXb|#, Y→cYd|# }(5)任何不是以0 打头的所有奇整数所组成的集合解:G(S):S→J|IBJ,B→0B|IB|ε,I→J|2|4|6|8, J→1|3|5|7|9}(6)(思考题)所有偶数个0 和偶数个1 所组成的符号串集合解:对应⽂法为 S→0A|1B|ε,A→0S|1C B→0C|1S C→1A|0B3.描述语⾔特点(2)S→SS S→1A0 A→1A0 A→ε解:L(G)={1n10n11n20n2… 1nm0nm |n1,n2,…,nm≥0;且n1,n2,…nm 不全为零}该语⾔特点是:产⽣的句⼦中,0、1 个数相同,并且若⼲相接的1 后必然紧接数量相同连续的0。
(5)S→aSS S→a解:L(G)={a(2n-1)|n≥1}可知:奇数个a5. (1) 解:由于此⽂法包含以下规则:AA→ε,所以此⽂法是0 型⽂法。
7.解:(1)aacb 是⽂法G[S]中的句⼦,相应语法树是:最右推导:S=>aAcB=>aAcb=>aacb最左推导:S=>aAcB=>aacB=>aacb(3)aacbccb 不是⽂法G[S]中的句⼦aacbccb 不能从S推导得到时,它仅是⽂法G[S]的⼀个句型的⼀部分,⽽不是⼀个句⼦。
11.解:最右推导:(1) S=>AB=>AaSb=>Aacb=>bAacb=>bbAacb=>bbaacb上⾯推导中,下划线部分为当前句型的句柄。
对应的语法树为:3 假设M:⼈ W:载狐狸过河,G:载⼭⽺过河,C:载⽩菜过河6 根据⽂法知其产⽣的语⾔是L={a m b n c i| m,n,i≧1}可以构造如下的⽂法VN={S,A,B,C}, VT={a,b,c}P={ S →aA, A→aA, A→bB, B→bB, B→cC, C→cC, C→c} 其状态转换图如下:7 (1) 其对应的右线性⽂法是:A →0D, B→0A,B→1C,C→1|1F,C→1|0A,F→0|0E|1A,D→0B|1C,E→1C|0B(2) 最短输⼊串011(3) 任意接受的四个串: 011,0110,0011,000011(4) 任意以1 打头的串.9.对于矩阵(iii)(1) 状态转换图:(2) 3型⽂法(正规⽂法)S→aA|a|bB A→bA|b|aC|a B→aB|bC|b C→aC|a|bC|b(3)⽤⾃然语⾔描述输⼊串的特征以a 打头,中间有任意个(包括0个)b,再跟a,最后由⼀个a,b 所组成的任意串结尾或者以b 打头,中间有任意个(包括0个)a,再跟b,最后由⼀个a,b 所组成的任意串结尾。
编译原理部分课后答案,仅供参考
第一章编译程序概述1.1什么是编译程序编译程序是现代计算机系统的基本组成部分之一,而且多 数计算机系统都含有不止一个高级语言的编译程序。
对有些高 级语言甚至配置了几个不同性能的编译程序。
1.2编译过程概述和编译程序的结构编译程序完成从源程序到目标程序的翻译工作,是一个复 杂的整体的过程。
从概念上来讲,一个编译程序的整个工作过 程是划分成阶段进行的,每个阶段将源程序的一种表示形式转 换成另一种表示形式,各个阶段进行的操作在逻辑上是紧密连 接在一起的。
一般一个编译过程划分成词法分析、语法分析、 语义分析、中间代码生成,代码优化和目标代码生成六个阶段,这是一种典型的划分方法。
事实上,某些阶段可能组合在一起, 这些阶段间的源程序的中间表示形式就没必要构造岀来了。
我 们将分别介绍各阶段的任务。
另外两个重要的工作:表格管理 和岀错处理与上述六个阶段都有联系。
编译过程中源程序的各 种信息被保留在种种不同的表格里,编译各阶段的工作都涉及 到构造、查找或更新有关的表格,因此需要有表格管理的工作; 如果编译过程中发现源程序有错误,编译程序应报告错误的性 质和错误发生的地点,并且将错误所造成的影响限制在尽可能 小的范围内,使得源程序的其余部分能继续被编译下去,有些 编译程序还能自动校正错误, 这些工作称之为岀错处理。
图1.3表示了编译的各个阶段。
图1.3编译的各个阶段它不生成目标代码,它每遇到一个语句,就要对这个语句进行 分析以决定语句的含义,执行相应的动作。
右面的图示意了它 的工作机理第二章:PL/O 编译程序问答第1题 PL/0语言允许过程嵌套定义和递归调用,试问 它的编译程序如何解决运行时的存储管理。
答:PL/0语言允许过程嵌套定义和递归调用,它的编译程序在运行时采用了栈式动态存储管理。
(数组CODE 存放的只读目 标程序,它在运行时不改变。
)运行时的数据区S 是由解释程序 定义的一维整型数组,解释执行时对数据空间S 的管理遵循后进先岀规则,当每个过程(包括主程序)被调用时,才分配数据 空间,退出过程时,则所分配的数据空间被释放。