
分类属性层次聚类算法
– 首先通过构建CF-树对原数据集进行预聚类 – 在前面预聚类的基础上进行聚类
第8章 聚类分析
8.4.2 BIRCH:平衡迭代归约和聚类
C F1
C F2
……
C Fn
根层
C F11 C F12
……
C F1k
第8章 聚类分析
8.3 划分聚类方法
•k-medoids 不采用簇中对象的平均值作为参照点,可以选用簇中
位置最中心的对象,即medoid。这样划分方法仍然是基于最 小化所有对象与其参照点之间的相异度之和的原则来执行的。
Step1 随机选择k个对象作为初始的代表对象; Step2 repeat; Step3 指派每个剩余的对象给离它最近的代表对象所代表的簇; Step4 随意地选择一个非代表对象; Step5 计算用代替的总代价S; Step6 如果,则用替换,形成新的k个代表对象的集合; Step7 until 不发生变化。
第8章 聚类分析
8.4 层次聚类方法
•8.4.1凝聚的和分裂的层次聚类 •8.4.2 BIRCH:平衡迭代归约和聚类 •8.4.3 ROCK:分类属性层次聚类算法 •8.4.4 CURE:使用代表点聚类方法 •8.4.5 Chameleon:动态建模层次聚类
第8章 聚类分析
8.4.1 凝聚的和分裂的层次聚类
•分类变量
•序数型变量
第8章 聚类分析
8.1.6 向量对象
•夹角余弦
•相关系数
第8章 聚类分析
8.2 聚类分析常用算法分类
•划分方法 •层次方法 •基于密度的方法 •基于网格的方法 •基于模型的方法 •高维数据的聚类方法 •模糊聚类FCM
第8章 聚类分析
8.3 划分聚类方法
•k-means k-means算法是基于质心的算法。k-means算法以k为
第8章 聚类分析
8.1.1聚类分析介绍
•聚类就是按照事物的某些属性,把事物聚集成类, 使类间的相似性尽可能小,类内相似性尽可能大。
•数据挖掘对聚类的典型要求如下:
– 可伸缩性 – 处理不同类型属性的能力 – 发现任意形状的聚类 – 用于决定输入参数的领域知识最小化 – 处理噪声数据的能力
第8章 聚类分析
d n,1 d n, 2
0
第8章 聚类分析
8.1.3 区间标度变量
•计算均值绝对偏差
•计算标准化的度量值
– 欧几里德距离 – 曼哈顿距离 – 明考斯基距离
第8章 聚类分析
8.1.4 二元变量
•简单匹配系数 •Jaccard系数 •Rao系数
第8章 聚类分析
8.1.5 分类型、序数型变量
……
…… ……
……
CF树的结构
…… 第一层
第8章 聚类分析
8.4.2 BIRCH:平衡迭代归约和聚类
BIRCH共包含四个阶段: • 预聚类阶段:扫描整个数据库,构建初始聚类特征树,
该树保存在内存中,用简洁的汇总信息或者叶子节点中 的子聚类来代表数据点的密集区域。 • (可选阶段)重新扫描叶子节点项,来构建一个更小的 CF-树。 • 采用别的聚类算法,对CF-tree的叶子节点进行聚类。 • (可选阶段)把前一个阶段中找到的聚类的质心,用作 种子来创建最终的聚类。其它数据点根据到这些种子所 代表聚类的远近来重新分配到各个聚类中。
第8章 聚类分析
8.4.3 ROCK:分类属性层次聚类算法
• 分类属性的层次聚类算法针对具有分类属性的数 据使用了链接的概念。
– 对于聚类包含布尔或分类属性的数据,传统聚类算法 使用距离函数。
– 实验表明对分类数据聚类时,这些距离度量不能产生 高质量的簇。
– 大多数聚类算法在进行聚类时只估计点与点之间的相 似度;也就是说,在每一步中那些最相似的点合并到 一个簇中。这种局部方法很容易导致错误。
参数,把n个对象分为k个簇,以使簇内具有较高的相似度, 而簇间的相似度最低。相似度的计算根据一个簇中对象的平 均值(被看作簇的重心)来进行。
Step1 任意选择k个对象作为初始的簇中心; Step2 repeat; Step3 根据与每个中心的距离,将每个对象赋给最近的簇; Step4 重新计算每个簇的平均值; Step5 until 不再发生变化。
第8章 聚类分析
8.4.3 ROCK:分类属性层次聚类算法
• ROCK算法采用一种比较全局的观点,通过考虑 成对点的邻域情况进行聚类。如果两个相似的点
终止条件
第8章 聚类分析
8.4.1 凝聚的和分裂的层次聚类
凝聚的 初始
步骤1
步骤2
步骤3
分裂的
a b c d e f
步骤4
ab de 步骤3
cdef def
步骤2
步骤1
步骤4 abcdef
初始
第8章 聚类分析
8.4.2 BIRCH:平衡迭代归约和聚类
•BIRCH通过聚类特征(Clustering Feature,CF) 对簇的信息进行汇总描述,然后对簇进行聚类。 • BIRCH算法的主要目标是使I/0时间尽可能小,
数据挖掘原理与SPSS Clementine应用宝典
元昌安 主编 邓 松 李文敬 刘海涛 编著
电子工业出版社
第8章 聚类分析
第8章 聚类分析
由NordriDesign提供
主要内容
•聚类分析原理 •聚类分析常用算法分类 •划分聚类方法 •层次聚类方法 •基于密度的聚类方法 •基于网格的聚类方法 •基于模型的聚类方法 •高维数据的聚类方法 •模糊聚类FCM •应用实例分析
•凝聚的方法
– 首先将每个对象作为单独的一个原子簇 – 然后相继地合并相近的对象或原子簇 – 直到所有的原子簇合并为一个(层次的最上层),或
者达到一个终止条件
•分裂的方法
– 首先将所有的对象置于一个簇中 – 在迭代的每一步中,一个簇被分裂为更小的簇, – 直到最终每个对象在单独的一个簇中,或者达到一个
8.1.2聚类分析中的数据类型
•数据矩阵:用m个变量(也称为属性)来表现n个
对象
x11 x12
x21
x22
xn1
xn2
x1m x2m 来自xnm
•相异度矩阵:存储n个对象两两之间的近似度,通 常用一个维的矩阵表示
0
d 2,1 0
d 3,1 d 3, 2 0
人工智能中的聚类算法原理与应用

人工智能中的聚类算法原理与应用人工智能是当前科技领域备受关注的一个话题,其中聚类算法是人工智能领域的一个重要组成部分。
聚类算法通过将数据分为不同的簇或类别,从而有效地分析数据,而无需提前了解数据的属性或分类。
本文将介绍聚类算法的原理、常见算法以及在各行业中的应用。
一、聚类算法的原理聚类算法通过对数据进行分析和计算,将数据按照相似度或相异度进行分组,使得同一组内的数据更加相似,不同组之间的数据差异更加明显。
聚类算法主要包含两个步骤:初始化和迭代。
在初始化过程中,会随机选择一些数据点作为初始聚类中心,然后计算每个点到每个聚类中心的距离,将其分到距离最近的聚类中心所在的簇中。
在迭代过程中,会更新聚类中心的位置。
具体来说,对于每个簇,会计算其中所有点的均值,然后将该均值作为该簇的新中心点。
然后会重新计算每个点到每个聚类中心的距离,并将其重新分配到其距离最近的簇中。
整个过程将不断重复,直至收敛或到达设定的迭代次数。
二、常见聚类算法1. k-means算法k-means算法是目前应用较为广泛的一种聚类算法。
该算法将样本集分为k个簇,且每个样本只能归属到一个簇中。
k-means算法的优点是简单实用、速度快,适用于大规模数据集。
其缺点是对初始簇中心的选择非常敏感,可能得到局部最优解。
2. 层次聚类算法层次聚类算法将样本集合看作是一个层次结构,从一个簇开始递归地分裂为多个子簇,或从多个簇开始递归地合并为一个簇。
该算法能够自适应地选择簇的数量,但计算复杂度较高,不适用于大规模数据集。
3. 密度聚类算法密度聚类算法通过密度的概念来定义簇,将样本看作是位于高密度区域内的一组点,能够有效地发现任意形状的簇。
其缺点是需要事先设定一些参数,且对数据分布的假设较强。
三、聚类算法的应用聚类算法在各个行业中都得到了广泛的应用,例如:1. 金融行业:聚类算法能够对客户群体进行分析,帮助银行识别潜在的风险客户,从而有效地进行风险控制。
聚类算法和分类算法总结
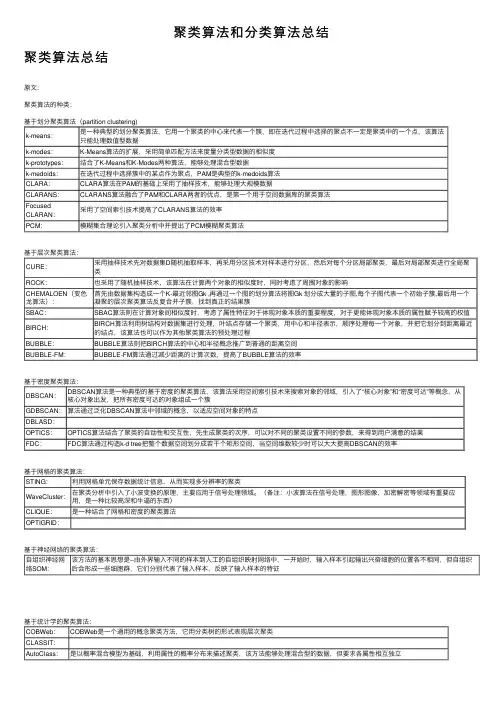
聚类算法和分类算法总结聚类算法总结原⽂:聚类算法的种类:基于划分聚类算法(partition clustering)k-means:是⼀种典型的划分聚类算法,它⽤⼀个聚类的中⼼来代表⼀个簇,即在迭代过程中选择的聚点不⼀定是聚类中的⼀个点,该算法只能处理数值型数据k-modes:K-Means算法的扩展,采⽤简单匹配⽅法来度量分类型数据的相似度k-prototypes:结合了K-Means和K-Modes两种算法,能够处理混合型数据k-medoids:在迭代过程中选择簇中的某点作为聚点,PAM是典型的k-medoids算法CLARA:CLARA算法在PAM的基础上采⽤了抽样技术,能够处理⼤规模数据CLARANS:CLARANS算法融合了PAM和CLARA两者的优点,是第⼀个⽤于空间数据库的聚类算法FocusedCLARAN:采⽤了空间索引技术提⾼了CLARANS算法的效率PCM:模糊集合理论引⼊聚类分析中并提出了PCM模糊聚类算法基于层次聚类算法:CURE:采⽤抽样技术先对数据集D随机抽取样本,再采⽤分区技术对样本进⾏分区,然后对每个分区局部聚类,最后对局部聚类进⾏全局聚类ROCK:也采⽤了随机抽样技术,该算法在计算两个对象的相似度时,同时考虑了周围对象的影响CHEMALOEN(变⾊龙算法):⾸先由数据集构造成⼀个K-最近邻图Gk ,再通过⼀个图的划分算法将图Gk 划分成⼤量的⼦图,每个⼦图代表⼀个初始⼦簇,最后⽤⼀个凝聚的层次聚类算法反复合并⼦簇,找到真正的结果簇SBAC:SBAC算法则在计算对象间相似度时,考虑了属性特征对于体现对象本质的重要程度,对于更能体现对象本质的属性赋予较⾼的权值BIRCH:BIRCH算法利⽤树结构对数据集进⾏处理,叶结点存储⼀个聚类,⽤中⼼和半径表⽰,顺序处理每⼀个对象,并把它划分到距离最近的结点,该算法也可以作为其他聚类算法的预处理过程BUBBLE:BUBBLE算法则把BIRCH算法的中⼼和半径概念推⼴到普通的距离空间BUBBLE-FM:BUBBLE-FM算法通过减少距离的计算次数,提⾼了BUBBLE算法的效率基于密度聚类算法:DBSCAN:DBSCAN算法是⼀种典型的基于密度的聚类算法,该算法采⽤空间索引技术来搜索对象的邻域,引⼊了“核⼼对象”和“密度可达”等概念,从核⼼对象出发,把所有密度可达的对象组成⼀个簇GDBSCAN:算法通过泛化DBSCAN算法中邻域的概念,以适应空间对象的特点DBLASD:OPTICS:OPTICS算法结合了聚类的⾃动性和交互性,先⽣成聚类的次序,可以对不同的聚类设置不同的参数,来得到⽤户满意的结果FDC:FDC算法通过构造k-d tree把整个数据空间划分成若⼲个矩形空间,当空间维数较少时可以⼤⼤提⾼DBSCAN的效率基于⽹格的聚类算法:STING:利⽤⽹格单元保存数据统计信息,从⽽实现多分辨率的聚类WaveCluster:在聚类分析中引⼊了⼩波变换的原理,主要应⽤于信号处理领域。
(完整版)聚类算法总结
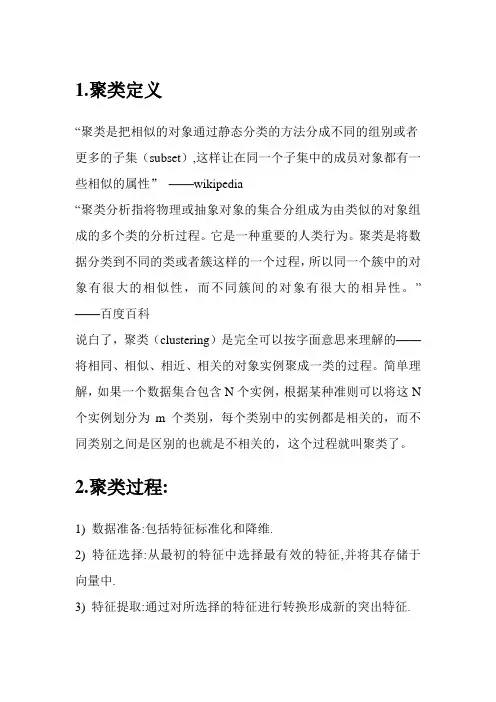
1.聚类定义“聚类是把相似的对象通过静态分类的方法分成不同的组别或者更多的子集(subset),这样让在同一个子集中的成员对象都有一些相似的属性”——wikipedia“聚类分析指将物理或抽象对象的集合分组成为由类似的对象组成的多个类的分析过程。
它是一种重要的人类行为。
聚类是将数据分类到不同的类或者簇这样的一个过程,所以同一个簇中的对象有很大的相似性,而不同簇间的对象有很大的相异性。
”——百度百科说白了,聚类(clustering)是完全可以按字面意思来理解的——将相同、相似、相近、相关的对象实例聚成一类的过程。
简单理解,如果一个数据集合包含N个实例,根据某种准则可以将这N 个实例划分为m个类别,每个类别中的实例都是相关的,而不同类别之间是区别的也就是不相关的,这个过程就叫聚类了。
2.聚类过程:1) 数据准备:包括特征标准化和降维.2) 特征选择:从最初的特征中选择最有效的特征,并将其存储于向量中.3) 特征提取:通过对所选择的特征进行转换形成新的突出特征.4) 聚类(或分组):首先选择合适特征类型的某种距离函数(或构造新的距离函数)进行接近程度的度量;而后执行聚类或分组.5) 聚类结果评估:是指对聚类结果进行评估.评估主要有3 种:外部有效性评估、内部有效性评估和相关性测试评估.3聚类算法的类别没有任何一种聚类技术(聚类算法)可以普遍适用于揭示各种多维数据集所呈现出来的多种多样的结构,根据数据在聚类中的积聚规则以及应用这些规则的方法,有多种聚类算法.聚类算法有多种分类方法将聚类算法大致分成层次化聚类算法、划分式聚类算法、基于密度和网格的聚类算法和其他聚类算法,如图1 所示的4 个类别.3.聚类算法基于层次聚类算法:基于划分聚类算法(partition clustering)基于密度聚类算法:基于网格的聚类算法:STING :利用网格单元保存数据统计信息,从而实现多分辨率的聚类WaveCluster:在聚类分析中引入了小波变换的原理,主要应用于信号处理领域。
数据挖掘中的聚类算法与分类算法的比较

数据挖掘中的聚类算法与分类算法的比较数据挖掘是应用于数据中的一种方法,目的是从数据中提取有用的信息。
在数据挖掘中,聚类和分类算法是应用较广泛的两种算法。
聚类算法是一种无监督学习方法,它通过对相似数据进行分类,从而将数据集分成不同的群组。
相比于分类算法,聚类算法更侧重于数据的相似性和分类。
常见的聚类算法包括K-means、DBSCAN、层次聚类等。
其中,K-means是最为经典的算法之一,它可以根据数据的相似性分成多个簇,每个簇中的数据都比较相似。
K-means算法的主要思想是通过不断的迭代,将数据集分成K个簇。
在每次迭代中,首先随机初始化K个簇心,然后将每个数据点分配到最近的簇心,最后重新计算簇心,直到迭代次数达到预设值或簇心不再改变。
相比于聚类算法,分类算法更侧重于确定数据所属的不同类别。
分类算法是一种有监督学习方法,它通过对已标注的数据进行训练,从而确定不同数据的分类。
常见的分类算法包括决策树、支持向量机、K-最近邻等。
其中,决策树是最为经典的算法之一,它可以根据不同属性特征将数据进行分类。
决策树算法的主要思想是通过将数据寻找属性进行分类,每次选择最具有区分度的属性作为划分标准,最终生成一棵决策树。
对比聚类算法和分类算法,它们在应用上各有优缺点。
聚类算法主要用于无监督学习场景,能够对数据进行分组,减少数据冗余和提高数据分析速度。
但是聚类算法对数据特征的不确定性较大,分类不太准确。
分类算法主要用于有监督学习场景,能够对数据进行分类,优点是分类精度较高,但缺点是需要手动标注数据,且对数据的预处理要求高。
在实际应用中,聚类算法和分类算法均有广泛应用。
比如在电商领域,可以使用聚类算法对用户进行分群,从而实现更精细化的营销策略;在医学领域,可以使用分类算法对疾病进行诊断,从而提高诊断准确率。
聚类算法和分类算法的使用需要根据具体场景进行选择,从而实现更好的数据挖掘效果。
总之,聚类算法通过对相似数据进行分类,从而将数据集分成不同的群组;分类算法则是通过对已标注的数据进行训练,从而确定不同数据的分类。
层次聚类算法课件

层次聚类形成的树状图能够直观地展示聚 类的过程和结果,便于理解和分析。
适用于任意形状的簇
对异常值敏感
层次聚类不受簇形状的限制,可以发现任 意形状的簇。
层次聚类对异常值比较敏感,异常值可能 会对聚类结果产生较大影响。
层次聚类算法的分类
01
根据是否进行分裂可以分为凝聚 层次聚类和分裂层次聚类。
02
根据距离度量方式可以分为最小 距离层次聚类、最大距离层次聚 类和平均距离层次聚类等。
对于具有非凸形状的簇,层次 聚类算法可能无法找到最优的 聚类结果。这是因为该算法基 于距离度量来构建簇,而距离 究
CHAPTER
案例一:社交网络用户群体的层次聚类
总结词
社交网络用户群体的层次聚类是利用层次聚类算法对社交网络中的用户进行分类的一种 应用。
特征选择
选择与聚类目标最相关的特征,去除冗余特征。
特征标准化
将特征值缩放到统一尺度,如归一化或标准化。
距离度量的选择
欧氏距离
适用于连续型数据,计算两点之间的直线距 离。
皮尔逊相关系数
适用于连续型数据,衡量两个变量之间的线 性关系。
余弦相似度
适用于连续型数据,衡量两个向量之间的夹 角大小。
Jaccard相似度
索、图像识别、目标检测等应用。
谢谢
THANKS
05 层次聚类算法的优缺点分析
CHAPTER
优点分析
灵活性
层次聚类算法能够处理各种形状和大小的簇,而 不仅仅是圆形或球形的簇。它能够识别出具有复 杂结构的簇,使得聚类结果更加符合实际情况。
稳健性
对于异常值和噪声数据,层次聚类算法通常具有 较好的稳健性。因为异常值和噪声数据对距离计 算的影响较小,所以它们不太可能对聚类结果产 生重大影响。
算法学习的聚类和分类算法性能比较

算法学习的聚类和分类算法性能比较在机器学习领域中,聚类和分类算法是两个常用的技术。
聚类算法是将数据集中的对象划分为不同的组,使得同一组内的对象相似度较高,不同组之间的相似度较低。
而分类算法则是将数据集中的对象划分为预定义的类别中的一个或多个。
本文将对聚类和分类算法的性能进行比较和评估。
首先,我们来讨论聚类算法。
聚类算法的目标是将数据集中的对象划分为不同的组,使得同一组内的对象具有较高的相似度。
常见的聚类算法包括K均值聚类、层次聚类和DBSCAN等。
K均值聚类是一种简单而有效的算法,它通过迭代的方式将数据集中的对象划分为K个簇。
层次聚类则是一种自底向上或自顶向下的聚类方法,它通过计算对象之间的相似度来构建聚类树。
DBSCAN算法则是一种基于密度的聚类算法,它通过确定对象的密度来划分簇。
接下来,我们来讨论分类算法。
分类算法的目标是将数据集中的对象划分为预定义的类别中的一个或多个。
常见的分类算法包括决策树、朴素贝叶斯和支持向量机等。
决策树是一种基于树结构的分类方法,它通过一系列的判断条件来将对象划分为不同的类别。
朴素贝叶斯算法则是一种基于贝叶斯定理的分类方法,它假设属性之间相互独立。
支持向量机是一种基于间隔最大化的分类方法,它通过找到一个最优的超平面来划分不同的类别。
在性能比较方面,聚类算法和分类算法有一些共同点和区别。
首先,它们都需要根据一定的准则来评估聚类或分类的质量。
对于聚类算法而言,常见的评估指标包括轮廓系数、DB指数和互信息等。
对于分类算法而言,常见的评估指标包括准确率、召回率和F1值等。
其次,聚类算法和分类算法在应用场景上有所不同。
聚类算法常用于无监督学习,即没有标签信息的情况下进行聚类。
而分类算法则常用于有监督学习,即有标签信息的情况下进行分类。
在具体的性能比较方面,聚类算法和分类算法各有优劣。
聚类算法在处理大规模数据集时具有较好的可扩展性,能够处理高维数据和噪声数据。
然而,聚类算法需要事先确定聚类的个数,对初始聚类中心的选择较为敏感。
层次聚类算法共35页
03.04.2020
簇间距离
平均距离
5
层次聚类
03.04.2020
簇间距离
均值距离
6
层次聚类
03.04.2020
AGNES算法
AGNES(AGglomerative NESting) 算法最初将每个对象作为一个簇, 然后这些簇根据某些准则被一步步 地合并。
两个簇间的相似度由这两个不同簇 中距离最近的数据点对的相似度来 确定。
13
层次聚类
03.04.2020
DIANA算法
DIANA(Divisive ANAlysis)算法是典型 的分裂聚类方法。
在聚类中,用户能定义希望得到的簇数 目作为一个结束条件。
14
层次聚类
03.04.2020
算法 DIANA(自顶向下分裂算法)
输入:n个对象,终止条件簇的数目k。
输出:k个簇,达到终止条件规定簇数目。
DIANA算法例题
序号
1
2
3
4
5
6
7
8
步骤 1 2 3 4 5
属性 1 1 1 2 2 3 3 4
属性 2 1 2 1 2 4 5 4
第1步,找到具有最大直径的簇,对簇中的每个点计算平均相异度(假定采用 是欧式距离)。
1的平均距离:(1+1+1.414+3.6+4.24+4.47+5)/7=2.96 类似地,2的平均距离为2.526;3的平均距离为2.68;4的平均距离为
第3步:重复第2步的工作,5,6点成为一簇。
第4步:重复第2步的工作,7,8点成为一簇。
第5步:合并{1,2},{3,4}成为一个包含四个点的簇。
知识点归纳 数据挖掘中的聚类分析与分类算法
知识点归纳数据挖掘中的聚类分析与分类算法数据挖掘中的聚类分析与分类算法数据挖掘是指从大量数据中自动发现有用的模式、关系或规律的过程。
在数据挖掘过程中,聚类分析和分类算法是两个常用且重要的技术。
本文将对这两个知识点进行归纳总结。
一、聚类分析聚类分析是将一组无标签的数据对象进行分组或聚类的数据挖掘技术。
其目标是通过对象之间的相似性将它们划分为若干个簇,使得同一簇内的对象相似度高,不同簇之间的相似度低。
聚类分析广泛应用于市场分割、社交网络分析、图像处理等领域。
常用的聚类算法有以下几种:1. K-means算法:K-means是一种基于距离度量的聚类算法。
它通过逐步迭代,将数据集分为K个簇,使得每个数据对象与本簇内的其他对象的相似度最高。
2. 层次聚类算法:层次聚类算法是一种通过计算不同类别之间的相似性,并逐步合并相似度高的类别的方式进行数据聚类的方法。
Hierarchical Agglomerative Clustering(HAC)是层次聚类的一种常见算法。
3. 密度聚类算法:密度聚类算法是一种通过计算对象的密度来确定簇的方法,常见的算法有DBSCAN和OPTICS算法。
这类算法可以有效地发现具有不同密度分布的聚类。
二、分类算法分类算法是将带有标签的数据集按照类别或标签进行划分的数据挖掘技术。
通过学习已有数据集的特征和类别标签,分类算法能够对新的未标记数据进行分类预测。
分类算法广泛应用于垃圾邮件过滤、文本分类、风险评估等领域。
常用的分类算法有以下几种:1. 决策树算法:决策树算法是一种基于树形结构的分类算法。
它通过对数据集进行递归分割,使得每个子节点具有最佳的纯度或信息增益,从而实现对数据的分类。
2. 朴素贝叶斯算法:朴素贝叶斯算法是一种基于条件概率的分类算法。
它假设特征之间相互独立,并通过计算条件概率来进行分类预测。
3. 支持向量机算法:支持向量机算法是一种通过寻找最优分割超平面将数据划分为不同类别的算法。
数据分析知识:数据挖掘中的分层聚类算法
数据分析知识:数据挖掘中的分层聚类算法数据挖掘是当今社会最热门的技术之一,它是一种通过分析大数据集来发现隐藏在其中有用信息的技术。
其中分层聚类算法是最常见的一种算法,本文将就其基本原理、优缺点、以及应用领域进行详细介绍。
一、分层聚类算法的基本原理分层聚类算法是指根据数据对象之间的相似性将数据对象分为不同的类别。
这种算法具有两种不同的方法,分别为自顶向下和自底向上的方法。
其中自顶向下的方法是从所有数据对象开始,逐渐将它们划分为不同的子集,使得最终得到的树形结构应该与所期望的分区结果相同。
自底向上的算法则是从单个对象开始,不断合并相似的对象,直到得到最终的划分结果。
基本的分层聚类算法包括三个步骤:距离计算、相邻矩阵的建立和层次聚类树的建立。
首先,在距离计算阶段,需要计算数据对象之间的距离。
距离计算的方式包括欧几里得距离、马哈拉诺比斯距离、曼哈顿距离等。
然后,在相邻矩阵的建立阶段,利用计算出的距离建立一个相邻矩阵。
最后,在层次聚类树的建立阶段,将相邻矩阵利用聚类方法构建成一棵树。
二、分层聚类算法的优缺点1.优点(1)相对于聚类算法中的K-means和EM算法,不需要先确定聚类的个数。
(2)聚类结果能够以一种直观的方式表现出来。
(3)对于分析特定属性的变化趋势时,分层聚类算法能够提供更详细的信息。
2.缺点(1)由于层次聚类的计算复杂度较高,所以对于大规模数据集的处理效率会很低。
(2)由于该算法是非实时的,所以对于实时查询不够友好。
(3)如果数据属性不够明显或者数据量过大,聚类结果会达到一种无意义的状态。
三、分层聚类算法的应用领域分层聚类算法在许多领域都有着广泛的应用,例如医学、商业、社交网络等。
以下是分层聚类算法在一些领域的应用:1.医学在医学领域中,分层聚类算法被用于疾病分类和诊断。
例如,在基因层面,一个人的基因表达水平可以展示出相似性,利用分层聚类算法能够自动性地将这些数据分类,然后,医生就能够以全新的方式进行疾病诊断。
大数据的聚类与分类算法
大数据的聚类与分类算法大数据时代的到来给我们带来了海量的数据,如何从这些数据中提取有价值的信息成为了一个重要的挑战。
在处理大数据时,聚类与分类算法是常用的技术手段之一。
本文将介绍大数据的聚类与分类算法,并分析它们的应用场景和优缺点。
一、聚类算法聚类算法是将数据分为若干个组,使得同一组内的数据相似度较高,不同组之间的数据相似度较低。
聚类算法主要有以下几种常见的方法:1. K均值算法K均值算法是一种基于距离的聚类算法,它将数据分为K个簇,每个簇内的数据点到该簇心的距离最小。
K均值算法的优势在于简单易实现,但是它对初始值的选择较为敏感,容易陷入局部最优解。
2. 层次聚类算法层次聚类算法是将数据点逐步合并为越来越大的类别,直到最终合并为一个簇或达到预设的终止条件。
层次聚类算法的好处在于不需要事先设定簇的个数,但是计算复杂度较高。
3. 密度聚类算法密度聚类算法是基于密度的聚类方法,它通过将密度较高的数据点划分为簇来实现聚类。
常见的密度聚类算法有DBSCAN和OPTICS算法。
密度聚类算法适用于具有复杂形状的数据集,但是对参数的选择较为敏感。
二、分类算法分类算法是将数据分为已知的类别,并根据一定的规则划分未知数据的类别。
常见的分类算法有以下几种:1. 决策树算法决策树算法是一种基于树形结构的分类方法,它通过一系列的问题对数据进行分类。
每个问题的答案将分割数据集,直到得到最终的分类结果。
决策树算法易于理解和解释,但是容易过拟合。
2. 朴素贝叶斯算法朴素贝叶斯算法基于贝叶斯定理,通过计算样本的属性值给定类别的条件概率来进行分类。
朴素贝叶斯算法简单快速,但是对于属性之间的依赖关系的处理较为简单。
3. 支持向量机算法支持向量机算法是一种基于统计学习理论的分类方法,它通过构建超平面将数据分为不同的类别。
支持向量机算法具有较高的学习能力和泛化能力,但是计算复杂度较高。
三、聚类与分类算法的应用场景聚类算法和分类算法在大数据处理中有广泛的应用场景。