
统计学原理重要公式
一.加权算术平均数和加权调和平均数的计算 加权算术平均数: ∑∑=fxf x 或 ∑∑=ffxx加权调和平均数: ∑∑∑∑==fxf x m m x频数也称次数。
在一组依大小顺序排列的测量值中,当按一定的组距将其分组时出现在各组内的测量值的数目,即落在各类别(分组)中的数据个数。
再如在3.14159265358979324中,…9‟出现的频数是3,出现的频率是3/18=16.7% 一般我们称落在不同小组中的数据个数为该组的频数,频数与总数的比为频率。
频数也称“次数”,对总数据按某种标准进行分组,统计出各个组内含个体的个数。
而频率则每个小组的频数与数据总数的比值。
在变量分配数列中,频数(频率)表明对应组标志值的作用程度。
频数(频率)数值越大表明该组标志值对于总体水平所起的作用也越大,反之,频数(频率)数值越小,表明该组标志值对于总体水平所起的作用越小。
掷硬币实验:在10次掷硬币中,有4次正面朝上,我们说这10次试验中…正面朝上‟的频数是4例题:我们经常掷硬币,在掷了一百次后,硬币有40次正面朝上,那么,硬币反面朝上的频数为____.解答,掷了硬币100次,40次朝上,则有100-40=60(次)反面朝上,所以硬币反面朝上的频数为60.一.加权算术平均数和加权调和平均数的计算 加权算术平均数: ∑∑=fxf x 或 ∑∑=ffxxx 代表算术平均数;∑是总和符合;f 为标志值出现的次数。
加权算术平均数是具有不同比重的数据(或平均数)的算术平均数。
比重也称为权重,数据的权重反映了该变量在总体中的相对重要性,每种变量的权重的确定与一定的理论经验或变量在总体中的比重有关。
依据各个数据的重要性系数(即权重)进行相乘后再相加求和,就是加权和。
加权和与所有权重之和的比等于加权算术平均数。
加权平均数 = 各组(变量值 × 次数)之和 / 各组次数之和 = ∑xf / ∑f加权调和平均数: ∑∑∑∑==fxf xm m x 加权算术平均数以各组单位数f 为权数,加权调和平均数以各组标志总量m 为权数但计算内容和结果都是相同的。
二.标准差和标准差系数的计算方法标准差: σ=()∑∑-ffx x2或公式标准差也被称为标准偏差,或者实验标准差,公式如图。
简单来说,标准差是一组数据平均值分散程度的一种度量。
一个较大的标准差,代表大部分数值和其平均值之间差异较大;一个较小的标准差,代表这些数值较接近平均值。
例如,两组数的集合 {0, 5, 9, 14} 和 {5, 6, 8, 9} 其平均值都是 7 ,但第二个集合具有较小的标准差。
标准差可以当作不确定性的一种测量。
例如在物理科学中,做重复性测量时,测量数值集合的标准差代表这些测量的精确度。
当要决定测量值是否符合预测值,测量值的标准差占有决定性重要角色:如果测量平均值与预测值相差太远(同时与标准差数值做比较),则认为测量值与预测值互相矛盾。
这很容易理解,因为如果测量值都落在一定数值范围之外,可以合理推论预测值是否正确。
标准差应用于投资上,可作为量度回报稳定性的指标。
标准差数值越大,代表回报远离过去平均数值,回报较不稳定故风险越高。
相反,标准差数值越细,代表回报较为稳定,风险亦较小。
例如,A 、B 两组各有6位学生参加同一次语文测验,A 组的分数为95、85、75、65、55、45,B 组的分数为73、72、71、69、68、67。
这两组的平均数都是70,但A 组的标准差为17.07分,B 组的标准差为2.37分(此数据时在R 统计软件中运行获得),说明A 组学生之间的差距要比B 组学生之间的差距大得多。
如是总体,标准差公式根号内除以n 如是样本,标准差公式根号内除以(n-1)因为我们大量接触的是样本,所以普遍使用根号内除以(n-1) 公式意义所有数减去其平均值的平方和,所得结果除以该组数之个数(或个数减一),再把所得值开根号,所得之数就是这组数据的标准差。
标准差的意义标准差越高,表示实验数据越离散,也就是说越不精确 反之,标准差越低,代表实验的数据越精确 离散度标准差是反应一组数据离散程度最常用的一种量化形式,是表示精密确的最要指标。
说起标准差首先得搞清楚它出现的目 的。
我们使用方法去检测它,但检测方法总是有误差的,所以检测值并不是其真实值。
检测值与真实值之间的差距就是评价检测方法最有决定性的指标。
但是真实值 是多少,不得而知。
因此怎样量化检测方法的准确性就成了难题。
这也是临床工作质控的目的:保证每批实验结果的准确可靠。
虽然样本的真实值是不可能知道的,但是每个样本总是会有一个真实值的,不管它究竟是多少。
可以想象,一个好的检测方法,基检测值应该很紧密的分散在真实值周围。
如何不紧密,那距真实值的就会大,准确性当然也就不好了,不可能想象离散度大的方法,会测出准确的结果。
因此,离散度是评价方法的好坏的 最重要也是最基本的指标。
标准差系数: xv σσ=标准差系数又均方差系数。
反映标志变动程度的相对指标。
式中:Vσ为标准差系数;σ为标准差;x 为平均数。
当以样本标准差系数(称变异系数/离散系数)估计总体标准差系数时,VS= 式中:VS 为变异系数;S 为样本标准差。
对于不同水平的总体不宜直接用标准差指标进行对比,标准差系数能更好的反映不同水平总体的标志变动度。
标准差变动系数为标志变异系数的一种。
标志变异系数指用标志变异指标与其相应的平均指标对比,来反应总体各单位标志值之间离散程度的相对指标,一般用v 表示。
标志变异指标有全距、平均差和标准差,相对应的,便有全距系数、平均差系数和标准差系数3种。
计算方法为:标志变异系数=标志变异值/相对应的平均值三.总体平均数和总体成数的区间估计。
抽样平均误差的计算公式: 1.总体平均数: 重复抽样:nx σμ=重复抽样又称放回式抽样。
每次从总体中抽取的样本单位,经检验之后又重新放回总体,参加下次抽样,这种抽样的特点是总体中每个样本单位被抽中的概率是相等的。
不重复抽样: )1(2Nn nx -=σμ不重复抽样亦称不放回式抽样。
每次从总体中抽取的样本单位,经检验之后不再放回总体,在下次抽样时不会再次抽到前面已抽中过的样品单位。
总体每经一次抽样,其样品单位数就减少一个,因此每个样品单位在各次抽样中被抽中的概率是不同的。
2.总体成数: 重复抽样: np p p )1(-=μ 不重复抽样: )1()1(Nn np p p --=μ抽样极限误差:抽样极限误差又称“置信区间和抽样允许误差范围”,是指在一定的把握程度(P )下保证样本指标与总体指标之间的抽样误差不超过某一给定的最大可能范围,记作△。
抽样极限误差是指用绝对值形式表示的 样本指标与总体指标偏差的可允许的最大范围。
它表明被估计的总体指标有希望落在一个以样本指标为基础的可能范围。
它是由抽样指标变动可允许的上限或下限与总体指标之差的绝对值求得的。
由于总体平均数和总体成数是未知的,它要靠实测的抽样平均数成数来估计。
因而抽样极限误差的实际意义是希望总体平均数落在抽样平均数的范围内,总体成数落在抽样成数的范围内。
基于理论上的要求,抽样极限误差需要用抽样平均误差μχ或μρ为标准单位来衡量。
即把极限误差△x 或△p 相应除以μχ或μρ,得出相对的误差程度t 倍,t 称为抽样误差的概率度。
于是有:1. 总体平均数: x x t μ=∆定义:总体中所有个体的平均数叫做总体平均数。
原理:考察的对象中的每一个考察对象的平均数叫做总体平均数。
2. 总体成数: △p =tμp总体成数。
它是指总体中具有某一相同标志表现的单位数占全部总体单位数的比重,一般用P 表示。
总体中具有相同标志表现的单位数用N1表示。
总体平均数和总体成数的区间估计:1. 总体平均数:x - tu x ≤ X ≤ x + tu x 2. 总体成数:p - tu p ≤ p ≤ p + tu p 样本单位数的确定: 1. 总体平均数:重复抽样: n = t 2σ2 /Δ2x不重复抽样:n = t 2σ2 N /( N Δ2x + t 2σ2 )2. 总体成数:重复抽样: n = t 2p(1-p) /Δ2p不重复抽样:n = t 2p(1-p) N /( N Δ2p + t 2p(1-p) )四.相关系数的计算、回归方程的建立和应用 相关系数的计算: [][]∑∑∑∑∑∑∑---=2222)()(y yn x xn yx xy n γ简单线性回归方程的建立: Y = a + bx其中: ∑∑∑∑∑--=22)(x x n yx xy n b x b y a -= 五.统计指数的编制和两因素分析1. 综合指数的计算 (1)数量指标指数:0001p qp q ∑∑ (01p q ∑ -00p q ∑)(2)质量指标指数:∑∑0111p qp q (11p q ∑-01p q ∑ )2.平均指数的计算 算术平均数指数:00p q ∑.K q / 00p q ∑ 00p q ∑.K q - 00p q ∑调和平均数指数:11p q∑ / (11p q ∑/K p ) 11p q ∑ - 11p q ∑/K p3.复杂现象总体总量指标变动的因素分析 相对数变动分析:0011p qp q ∑∑=001p qp q ∑∑×∑∑0111p qp q绝对值变动分析:11p q ∑-00p q ∑= (01p q ∑ -00p q ∑)×(11p q ∑-01p q ∑ )六.平均发展水平的计算1.由总量指标动态数列计算序时平均数(1)由时期数列计算序时平均数: naa ∑=(2)由间隔相等的时点数列计算序时平均数:12121121-++++=-n a a a a a n n(3)由间隔不相等的时点数列计算序时平均数:∑--++++++=ff a a f a a f a a a n nn 112321212222.由相对指标或平均指标动态数列计算序时平均数: ba c =七.现象发展的速度指标的计算1.环比发展速度的连乘积等于定基发展速度。
公式表示为:1231201a a a a a a a a a a n n n =⋅⋅⋅-2.逐期增长量之和等于累积增长量01231201)()()()(a a a a a a a a a a n n n -=-++-+-+--逐期增长量之和 累积增长量 平均增长量=────────=──────── 逐期增长量的个数 逐期增长量的个数 3.增长速度 = 发展速度 - 1 4.平均发展速度的计算 nx x ∏=5.平均增长速度的计算平均增长速度=平均发展速度-1(100%)。
统计学计算公式

《统计学原理》复习资料(计算公式)一、编制分配数列(次数分布表)统计整理公式a)组距=上限-下限b)组中值=(上限+下限)÷2 c)缺下限开口组组中值=上限-1/2邻组组距d)缺上限开口组组中值=下限+1/2邻组组距二、算术平均数和调和平均数的计算加权算术平均数公式xfx f (常用)fx x f(x 代表各组标志值,f 代表各组单位数,ff 代表各组的比重)加权调和平均数公式mx mx (x 代表各组标志值,m 代表各组标志总量)三、变异系数比较稳定性、均衡性、平均指标代表性(通常用标准差系数V x 来比较)公式:标准差: 简单σ= ;加权σ=四、总体参数区间估计(总体平均数区间估计、总体成数区间估计)具体步骤:①计算样本指标x 、;p③由给定的概率保证程度()F t 推算概率度t⑤估计总体参数区间范围x x x X x ;p pp P p 抽样估计公式1.平均误差:重复抽样:n x np p p )1(不重复抽样:)1(2Nn n x2.抽样极限误差xx t 3.重复抽样条件下:平均数抽样时必要的样本数目222x t n 成数抽样时必要的样本数目22)1(p p p t n4.不重复抽样条件下:平均数抽样时必要的样本数目22222t N Ntn x 五、相关分析和回归分析相关分析公式1.相关系数2222)()(y y n x x n y x xy n2.配合回归方程y=a+bx22)(x x ny x xy nb xb y a 3.估计标准误:22n xy b y a y s y 五、指数分析计算指数分析公式一、综合指数的计算与分析(1)数量指标指数0001p q p q 此公式的计算结果说明复杂现象总体数量指标综合变动的方向和程度。
(01p q -00p q )此差额说明由于数量指标的变动对价值量指标影响的绝对额。
(2)质量指标指数0111p q p q 此公式的计算结果说明复杂现象总体质量指标综合变动的方向和程度。
统计学原理重要公式
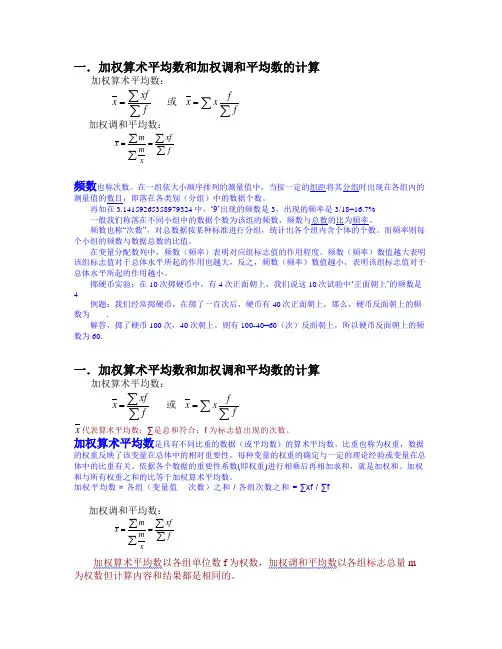
一.加权算术平均数和加权调和平均数的计算加权算术平均数: ∑∑=fxf x 或 ∑∑=ffxx加权调和平均数: ∑∑∑∑==fxf x m m x频数也称次数。
在一组依大小顺序排列的测量值中,当按一定的组距将其分组时出现在各组内的测量值的数目,即落在各类别(分组)中的数据个数。
再如在3.14159265358979324中,…9‟出现的频数是3,出现的频率是3/18=16.7% 一般我们称落在不同小组中的数据个数为该组的频数,频数与总数的比为频率。
频数也称“次数”,对总数据按某种标准进行分组,统计出各个组内含个体的个数。
而频率则每个小组的频数与数据总数的比值。
在变量分配数列中,频数(频率)表明对应组标志值的作用程度。
频数(频率)数值越大表明该组标志值对于总体水平所起的作用也越大,反之,频数(频率)数值越小,表明该组标志值对于总体水平所起的作用越小。
掷硬币实验:在10次掷硬币中,有4次正面朝上,我们说这10次试验中…正面朝上‟的频数是4例题:我们经常掷硬币,在掷了一百次后,硬币有40次正面朝上,那么,硬币反面朝上的频数为____.解答,掷了硬币100次,40次朝上,则有100-40=60(次)反面朝上,所以硬币反面朝上的频数为60.一.加权算术平均数和加权调和平均数的计算加权算术平均数: ∑∑=fxf x 或 ∑∑=ffxxx 代表算术平均数;∑是总和符合;f 为标志值出现的次数。
加权算术平均数是具有不同比重的数据(或平均数)的算术平均数。
比重也称为权重,数据的权重反映了该变量在总体中的相对重要性,每种变量的权重的确定与一定的理论经验或变量在总体中的比重有关。
依据各个数据的重要性系数(即权重)进行相乘后再相加求和,就是加权和。
加权和与所有权重之和的比等于加权算术平均数。
加权平均数 = 各组(变量值 × 次数)之和 / 各组次数之和 = ∑xf / ∑f加权调和平均数: ∑∑∑∑==fxf xm m x加权算术平均数以各组单位数f 为权数,加权调和平均数以各组标志总量m 为权数但计算内容和结果都是相同的。
统计学常用公式汇总

《统计学原理》常用公式汇总组距=上限-下限组中值=(上限+下限)÷2 缺下限开口组组中值=上限-1/2邻组组距缺上限开口组组中值=下限+1/2邻组组距111平均指标 1.简单算术平均数:2.加权算术平均数或iii.变异指标1.全距=最大标志值-最小标志值2.标准差: 简单σ=;加权σ= 3.标准差系数:第五章抽样估计1.平均误差:重复抽样:不重复抽样:2.抽样极限误差3.重复抽样条件下:平均数抽样时必要的样本数目成数抽样时必要的样本数目4.不重复抽样条件下:平均数抽样时必要的样本数目第七章相关分析 1.相关系数2.配合回归方程y=a+bx3.估计标准误:第八章指数分数一、综合指数的计算与分析(1)数量指标指数此公式的计算结果说明复杂现象总体数量指标综合变动的方向和程度。
(-)此差额说明由于数量指标的变动对价值量指标影响的绝对额。
(2)质量指标指数此公式的计算结果说明复杂现象总体质量指标综合变动的方向和程度。
(-)此差额说明由于质量指标的变动对价值量指标影响的绝对额。
加权算术平均数指数=加权调和平均数指数=(3)复杂现象总体总量指标变动的因素分析相对数变动分析:=×绝对值变动分析:-= (-)×(-)第九章动态数列分析一、平均发展水平的计算方法:(1)由总量指标动态数列计算序时平均数①由时期数列计算②由时点数列计算在间断时点数列的条件下计算:a.若间断的间隔相等,则采用“首末折半法”计算。
公式为:b.若间断的间隔不等,则应以间隔数为权数进行加权平均计算。
公式为:(2)由相对指标或平均指标动态数列计算序时平均数基本公式为:式中:代表相对指标或平均指标动态数列的序时平均数;代表分子数列的序时平均数;代表分母数列的序时平均数;逐期增长量之和累积增长量二. 平均增长量=─────────=─────────逐期增长量的个数逐期增长量的个数(1)计算平均发展速度的公式为:(2)平均增长速度的计算平均增长速度=平均发展速度-1(100%)。
统计学原理知识点公式整理

数。
)如:产量指数、销售量指数、生产指数、人数指数、运输量指数。
说明复杂现象总体的质量指标变动程度的相对数。
(说明总体内涵数量变动情况的相对数。
)例:价格指数、成本指数、工资水平指数、股票价格指数。
:平均数指数总体:即统计总体,是指客观存在的、在同一性质基础上结合起来的许多个别事物的整体。
总体单位:即构成统计总体的个别单位。
标志:即指表明总体单位特征的名称。
可分为品质标志和数量标志。
品质标志:说明总体单位质的特征,用属性表示(如:性别、民族、籍贯、工种) 数量标志:说明总体单位量的特征,用数值表示。
(如:年龄、工资额)数量标志的具体表现,统计上称为标志值(或变量值)指标(亦称统计指标):说明总体的综合数量特征。
包括指标名称和指标数值。
数量指标如:人口数、工业增加值、货运量等。
用绝对数表示。
质量指标如:人口的性别比例、单位产品成本、劳动生产率等。
用相对数或平均数表示。
:标志是说明总体单位特征的;指标是说明总体特征的。
标志中的品质标志不能用数量表示;而所有的指标都能用数量表示。
标志(指数量标志)不一定经过汇总,可直接取得;而指标(指数量指标)一定要经过汇总才能取得。
∑∑=pqpqK q1∑∑=111qpqpKpqkk kV qqσ=pkk kV ppσ=标志一般不具备时间、地点等条件;但完整的统计指标一定要讲明时间、地点、范围。
变异:标志在各总体单位具体表现的差异 —— 一般意义上的变异。
严格地说,变异仅指品质标志的不同具体表现。
如:性别为男或女。
变量:指可变的数量标志。
变量的具体数值表现即变量值。
按取值是否连续分—— 只能取整数的变量。
(如:人数,企业数,机器台数)—— 在整数之间可插入小数的变量。
(如:身高、体重、总产值、资金、利润等)例如:搜集国有及国有控股企业生产情况的资料时,每一个国有及国有控股企业是调查单位,也是填报单位;当搜集国有及国有控股企业中高精尖设备的使用情况的资料时,国有及国有控股企业中每一台高精尖设备是调查单位,而填报单位是每一个国有及国有控股企业。
统计学常用公式
统计学常用公式统计学是一门研究数据收集、整理、分析和解释的学科。
在统计学中,公式是非常重要的工具,用于计算和推导各种统计指标和结果。
下面是一些统计学中常用的公式,它们可以帮助我们理解和应用统计学的基本概念和方法。
1. 数据的中心趋势度量在统计分析中,我们经常需要了解数据的中心趋势,即数据的集中程度或平均水平。
以下是几个常用的中心趋势度量公式:- 平均值(Mean):一组数据中所有观测值的总和除以观测值的个数。
- 中位数(Median):将一组数据按照大小排序,位于中间位置的观测值。
- 众数(Mode):出现次数最多的观测值。
- 加权平均值(Weighted Mean):将每个观测值乘以相应的权重,然后求和并除以总的权重和。
2. 数据的离散程度度量除了了解数据集中在哪里,我们还需要了解数据的离散程度,即数据分散的程度。
以下是几个常用的离散程度度量公式:- 方差(Variance):一组数据与其平均值之差的平方的平均值。
- 标准差(Standard Deviation):方差的算术平方根。
- 平均绝对偏差(Mean Absolute Deviation):一组数据与其平均值之差的绝对值的平均值。
3. 数据的相关性度量在统计分析中,我们常常需要了解两个或多个变量之间的相关性。
以下是几个常用的相关性度量公式:- 协方差(Covariance):一组数据中两个变量之间的协方差。
协方差的正负表示两个变量是正相关还是负相关。
- 相关系数(Correlation Coefficient):协方差除以两个变量各自的标准差的乘积。
相关系数的取值范围为-1到1,越接近-1或1表示相关性越强。
4. 抽样误差估计在统计学中,我们通常只能对样本数据进行分析,从而推断总体的特征。
以下是几个常用的抽样误差估计公式:- 样本标准差(Sample Standard Deviation):类似于总体标准差,但在计算时使用样本数据。
- 样本均值(Sample Mean):类似于总体均值,但在计算时使用样本数据。
统计学原理常用公式
统计学原理常用公式1.样本均值公式:样本均值是用来估计总体均值的一种方法,公式为:\bar{x} = \frac{{\sum_{i=1}^n x_i}}{n}\]其中,\(\bar{x}\) 是样本均值,\(x_i\) 是第 \(i\) 个观察值,\(n\) 是样本容量。
2.样本方差公式:样本方差是用来估计总体方差的一种方法,公式为:s^2 = \frac{{\sum_{i=1}^n (x_i - \bar{x})^2}}{n-1}\]其中,\(s^2\) 是样本方差,\(x_i\) 是第 \(i\) 个观察值,\(\bar{x}\) 是样本均值,\(n\) 是样本容量。
计算样本方差时使用的是无偏估计公式。
3.标准差公式:标准差是样本方差的平方根,公式为:s = \sqrt{s^2}\]其中,\(s\)是样本标准差。
4.离差平方和公式:离差平方和是指每个观察值与均值之差的平方的总和,公式为:\sum_{i=1}^n (x_i - \bar{x})^2\]5.切比雪夫不等式:切比雪夫不等式给出了随机变量与其均值之间的关系,公式为:P(,X-\mu,\geq k\sigma) \leq \frac{1}{k^2}\]其中,\(X\) 是随机变量,\(\mu\) 是均值,\(\sigma\) 是标准差,\(k\) 是大于零的常数。
6.二项分布的期望值和方差公式:二项分布用于描述在\(n\)次独立重复试验中成功的次数的概率分布。
其期望值和方差分别为:E(X) = np\]Var(X) = np(1-p)\]其中,\(X\)是二项分布随机变量,\(n\)是试验次数,\(p\)是单次试验成功的概率。
7.正态分布的概率密度函数和累积分布函数公式:正态分布描述了大部分自然现象中的连续性随机变量的分布。
f(x) = \frac{1}{{\sqrt{2\pi}\sigma}}e^{-\frac{(x-\mu)^2}{2\sigma^2}}\]F(x) = \frac{1}{2}\left[1 + \text{erf}\left(\frac{x -\mu}{\sqrt{2}\sigma}\right)\right]\]其中,\(x\) 是正态分布的随机变量,\(\mu\) 是均值,\(\sigma\) 是标准差,\(\text{erf}\) 是误差函数。
统计学公式汇总
统计学公式汇总(1) αβδμσνπρυt u F X s 2χ(2) 均数(mean ):nX nX X X X n∑=+⋅⋅⋅++=21式中X 表示样本均数,X 1,X 2,Xn为各观察值。
(3) 几何均数(geometric mean, G ):)lg (lg )lg lg lg (lg 121121nX n X X X X X X G n nn ∑--=+⋅⋅⋅++=⋅⋅⋅∙=式中G 表示几何均数,X 1,X 2,X n 为各观察值。
(4) 中位数(median, M )n 为奇数时,)21(+=n X Mn 为偶数时,2/][)12()2(++=n n XX M式中n 为观察值的总个数。
(5) 百分位数 )%(L xx f x n f iL P ∑-⋅+= 式中L为Px 所在组段的下限,f x 为其频数,i 为其组距,L f ∑为小于L各组段的累计频数。
(6) 四分位数(quartile, Q ) 第25百分位数P 25,表示全部观察值中有25%(四分之一)的观察值比它小,为下四分位数,记作Q L;第75百分位数P 75,表示全部观察值中有25%(四分之一)的观察值比它大,为上四分位数,记作Q U。
(7) 四分位数间距 等于上、下四分位数之差。
(8) 总体方差 NX 22)(μσ-∑=(9) 总体标准差 NX 2)(μσ-∑=(10)样本标准差 1/)(1)(222-∑-∑=--∑=n nX X n X X s (11)变异系数(coefficient of variation, CV ) %100⨯=X sCV (12)样本均数的标准误 理论值nX σσ=估计值ns s X =式中σ为总体标准差,s为样本标准差,n 为样本含量。
(13)样本率的标准误 理论值np )1(ππσ-=估计值np p s p )1(-=式中π为总体率,p 为样本率,n 为样本含量。
(14)总体率的估计:正态分布法,(n p p u p n p p u p /)1(,/)1(-⋅+-⋅-αα) 式中p为样本均数,s 为样本标准差,n 为样本含量。
统计学原理计算公式
位值平均数计算公式1众数:是一组数据中出现次数最多的变量值L m o:代表众数组下限;丄1二fm 。
一 fm °—1 :代表众数组频数一众数组前一组频数dm 0 :代表组距; 2 ~ f m 0 一 f m 0 1 :代表众数组频数一众数组后一组频数2、中位数:是一组数据按顺序排序后,处于中间位置上的变量值。
n 十1中位数位置分组向上累计公式:2Sme-1Sme-1 :代表中位数所在组之前各组的累计频数;fm e 代表中位数组频数;d m e代表组距3、四分位数:也称四分位点,它是通过三个点将全部数据等分为四部分,其中每部分包含25%处在25唏口 75%分位点上的数值就是四分位数。
实例数据总量:7, 15, 36, 39, 40, 41 一共6项Q1 的位置=(6+1) /4=1.75 Q2 的位置=(6+1) /2=3.5 Q3 的位置=3( 6+1) /4=5.25Q1 = 7+ ( 15-7 ) X( 1.75-1 ) =13, Q2 = 36+ ( 39-36 )X( 3.5-3 ) =37.5 , Q3 = 40+ ( 41-40 ) X( 5.25-5 ) =40.25组距式分组下限公式:M 。
A 1 A + A 1 2dm om em em eLm e 代表中位数组下限;其公式为:Q1 = Q 2(中位数)3(n 1) 4数值平均数计算公式1、简单算术平均数:是将总体单位的某一数量标志值之和除以总体单位。
3、加权算术平均数的频率:其公式为:x = X i 」X 2;次「"X\f4、调和平均数:由于只掌握每组某个标志的数值总和(M )而缺少总体单位数(f )的资 料,不冃匕直接采用加权算术平均数法计算干均数,贝U 应采用加权调和平 均数。
H = P其公式为:「mL ---X5、简单几何平均数: 就是n 个变量值(Xn )连乘积的n 次方根:标志变异绝对指标及成数计算公式、标志变异绝对指标:1、异众比率(又称离异比率或变差比,它是指非众数组的频数占总频数的比率)公式即,Vr2、极差(也称全距,它是一组数据的最大值与最小值这差其公式为:乂 X 「X 2nX n2、加权算术平均数:受各组组中值及各组变量值出现的频数(即权数 f )大小的影响,其公式为:x 1 f 〔 x 2 f 2f l f 2X i f i f inX x 2 x 36、加权几何平均数: 如果变量值较多,其出现的次数不同,则应米用加权几何平均数,其公式为: TxJ X 2f 2X n其公式为:n公式即:R 二X max 一X min3、平均差(总体各单位标志值对算数平均数的绝对离差的算术平均数,平均差是反映各 标志值对平均数的平均距离,平均差越大,说明总体各标志值越分散,平均差越 小,说明各标志值越集中),方差简便算法的公式即为:二2= x 2 一(x )2、是非标志的平均数、方差、标准差:是非标志:将总体分成具有某种性质和不具有某种性质的两部分,我们所关心的标志表现称为“是”,另一标志标现称为“非”。
统计学原理必备公式
标准差:未分组:n x x 2)(-∑=σ分组:ff x x ∑-∑=2)(σ 标准差离散系数:%100⨯=x v σσ 几何平均数:n n n x x x x G∏== 21(简单) f f f f n f f x x x x G n ∑∑∏== 2121(加权) 众数:)(2110下限公式d L M ⨯∆+∆∆+= )(2120上限公式d U M ⨯∆+∆∆-= L :众数组的下限;U :众数组的上限;1∆:众数组次数与前一组次数之差;2∆:众数组次数与后一组次数之差;d :组距 中位数:)(21下限公式i f S f L M mm e ⨯-∑+=- (上限公式)i f S f U M m m e ⨯-∑-=+12 L :中位数所在组的下限;U :中位数所在组的上限;m f :中位数所在组的次数;1S -m :中位数所在组的下限以前各组的累计次数;1+m S :中位数所在组的上限以后各组的累计次数;f ∑:总次数定基发展速度=某一固定时期水平报告期水平;环比发展速度=前一期水平报告期水平;增长速度=基期水平增长量=基期水平基期水平报告期水平-=1-基期水平报告期水平=发展速度-1;定基增长速度=1-=定基发展速度某一固定时期水平累计增长速度;环比增长速度=1-=环比发展速度前一期水平逐期增长量; 增长1%的绝对值=100前期水平;平均增长速度=平均发展速度-1 个体指数⎪⎩⎪⎨⎧==0101q q K p p K q p 数量:质量:综合指数⎪⎩⎪⎨⎧∑∑=∑∑=00011011p q p q K q p q p K q p 数量:质量:加权算术平均数指数⎪⎩⎪⎨⎧∑∑=∑∑=00001010k p q p q K q p q p k K q q p p 数量:质量: 加权调和平均数指数⎪⎩⎪⎨⎧∑∑=∑∑=q q p p k q p q p K k q p q p K 10101111数量:质量:总量指标⎪⎩⎪⎨⎧∑∑⨯∑∑=∑∑∑-∑+∑-∑=∑-∑101100010011101100010011)()(q p q p p q p q q p q p q p q p p q p q q p q p 相对数:绝对数: 平均指标⎪⎩⎪⎨⎧⨯=-+-=-01010101)()(x x x x x x x x x x x x n n n n 相对数:绝对数: 可变K (可变构成指数)=00011101f f x f f x x x ∑∑∑∑=固定K (固定构成指数)=1101111f f x f f x x x n ∑∑∑∑=结构K (结构影响指数)=0001100f f x f f x x x n ∑∑∑∑=。
数理统计中的重要公式整理
数理统计中的重要公式整理正文:数理统计是一门研究统计学原理和方法的学科,其重要性不可忽视。
在数理统计中,有一些重要的公式被广泛应用于各类统计问题的求解和分析。
本文将对数理统计中的重要公式进行整理,以帮助读者更好地掌握和应用这些公式。
1. 概率论与数理统计基本公式1.1 概率论基本公式:(1) 加法法则:P(A ∪ B) = P(A) + P(B) − P(A ∩ B)(2) 乘法法则:P(A ∩ B) = P(A)P(B|A) = P(B)P(A|B)(3) 全概率公式:P(A) = ∑ P(A ∩ Bᵢ) = ∑ P(Bᵢ)P(A|Bᵢ)(4) 贝叶斯公式:P(A|B) = P(B|A)P(A) / P(B)1.2 数理统计基本公式:(1) 期望值公式:E(X) = ∑ XᵢP(Xᵢ)(2) 方差公式:Var(X) = E[(X - E(X))²] = E(X²) - [E(X)]²(3) 协方差公式:Cov(X, Y) = E[(X - E(X))(Y - E(Y))] = E(XY) -E(X)E(Y)(4) 相关系数公式:ρ(X, Y) = Cov(X, Y) / σ(X)σ(Y)2. 统计推断中的重要公式2.1 参数估计公式:(1) 矩估计:θ̂= ḡ(m₁, m₂, ..., mₖ)(2) 最大似然估计:θ̂= argmax[∏ f(x; θ)](3) 最小二乘估计:θ̂= argmin[∑ (yᵢ - g(xᵢ; θ))²]2.2 假设检验公式:(1) z检验:z = (x - μ) / (σ/√n)(2) t检验:t = (x - μ) / (s/√n)(3) 卡方检验:χ² = ∑ (Oᵢ - Eᵢ)² / Eᵢ3. 抽样理论中的重要公式3.1 随机变量公式:(1) 期望值公式:E(X) = μ(2) 方差公式:Var(X) = σ²/n(3) 中心极限定理:Z = (X - μ) / (σ/√n) 服从标准正态分布3.2 总体参数估计公式:(1) 基本抽样分布(z分布):z = (X - μ) / (σ/√n)(2) t分布:t = (X - μ) / (s/√n)(3) X²分布:χ² = ∑ (Xᵢ - Eᵢ)² / Eᵢ4. 方差分析中的重要公式4.1 单因素方差分析公式:(1) 总平方和公式:SST = ∑ (xᵢj - x)²(2) 因素平方和公式:SFA = n ∑ (xₖ - x)²(3) 误差平方和公式:SSE = ∑ (xᵢj - xₖ)²4.2 F检验公式:F = (SFA / (k - 1)) / (SSE / (n - k))5. 相关分析中的重要公式5.1 简单线性回归公式:(1) 回归模型:Y = β₀ + β₁X + ε(2) 最小二乘估计公式:β̂₁ = ∑((Xᵢ - X)(Yᵢ - Ȳ)) / ∑((Xᵢ - X)²)β̂₀ = Ȳ - β̂₁X(3) 相关系数公式:r = Cov(X, Y) / (σ(X)σ(Y))6. 抽样调查中的重要公式6.1 简单随机抽样公式:(1) 抽样率:p = n / N(2) 估计总量公式:T = N * (X / n)(3) 估计方差公式:Var(T) = N² * ((1 - p/n) / n) * σ²7. 时间序列分析中的重要公式7.1 平稳时间序列公式:(1) 自协方差公式:γ(h) = Cov(Xₖ, Xₖ₋ₖ) = γ(-h)(2) 自相关系数公式:ρ(h) = Cov(Xₖ, Xₖ₋ₖ) / (σ(Xₖ)σ(Xₖ₋ₖ))通过对这些数理统计中的重要公式的整理,我们可以更加方便地在实际问题中应用这些公式,进行数据分析、参数估计、假设检验等统计推断工作。