
第四章 离散信源编码
解: (1)
1 1 H ( X ) 0.2 Lb 0.8Lb 0.72 bit / 字符 0.2 0.8 b 0.2 1 0.8 1 1 bit / 字符
=H ( X ) / b 100% 72%
(2)二重扩展. 最佳编码原则
1 x x 111 B1 3 1 1 25 4 x x 110 B2 3 1 2 25 4 xx 10 B3 2 2 1 25 16 x2 x2 0 B4 1 25 1 4 4 16 39 B 3 3 2 1 25 25 25 25 25 39 39 B/K /2 25 50 H ( X ) 0.72 92% B / K 39 50 由72% 92%
6
7
0.10
0.01
(0.11) 1
(0.10) 0
(0.01) 1
1110
1111
4
4
R
H ( x) 2.61 0.953(bit / 码元) 2.74 b
=R C 95.3%
fano编码方法 > shannon编码方法
3.霍夫曼编码方法Huffman coding
1) 将信源消息的概率按大小顺序排队
3. 单义可译定理
信源消息集合 X {x , x ,..., x } 1 2 N 信道基本符号的种类为 D 码子集合为 码长集合为
S {s1 , s2 ,..., sN }
b {b 1, b 2 ,..., b N}
N i 1
即时码存在定理: D bi 1 Kraft不等式
即时码
2.即时码的构造(充分必要条件)
设 si (ai1ai 2 aik ) 是码 s 中的任一码字,
则 s 为即时码的充分必要条件为:
对于任意的 m < k, 任意的 s j (a j1a j 2 a jm ) 不是 si (ai1ai 2 aik ) 的前缀.
即 s 的任何一个码子不是另一个码子的前缀
第四章
消息集合
离散信源编码
编码器
X
代码集合
S
A 信道基本符号集合
第4.1节 信源编码的模型 ① X :消息集合,N个元素 ②
③
X x1 , x2 ,
, xn
A :信道基本符号集合, A a1 , a2 , , an
S
D种信道基本符号 :代码集合,个数为N S S , S , 1 2
, SN
2.信源编码器的主要任务:完成输入消息集合与输 出代码的集合之间的映射。
信源编码的 3 个基本要求
①选择合适的信道基本符号 使输出代码能适应于信道。 (考虑信道的信源编码: 如信源信道联合编码)
②有效的编码方法
③编码方法应满足:消息集合与代码组集合一一对应。
使得信源发出消息 输出代码组
最佳 (1)若R C , 100%, (2) R C , 100%, 有改进余地 (3) R C , ? , 失真.(丢失)
R 100% C
编码效率η
H(X ) / b 100% H max ( X ) / b
或 k重扩展
H(X k ) / B H max ( X ) / B
• 书上举例 X : x1 , x2 , x3 , x4 62页 例4.4 1 1 1 1 P( X ) : , , , {0,1}集 2 4 8 8 1 1 1 1 N bi 8 8 D 2 2 2 4 2 2 1 i 1
存在即时码. 简单地说
编码过程:是建立码地址和将编码消息序列分段的过程。
第4.7节 图像的信源编码
1. 图象消息的信息特征 信息量大: 352×288×3×25 VCD 768×576×3×25 DVD STV 1280×1024×3×60 HDTV 1920×1280×3×60 2. 一些编码压缩方法 • 压缩比: P Ls Ld 100%
k
100%
η
1:最佳编码
3.最佳编码的两原则
(1)对信源中出现概率大的消息(或符号),尽可能用短的代
码组来表示,即短码; 反之,用长码。
(2)不使用间隔, 采用可区分码字 信源: x 1 ,..., xN P( x 1 ),..., P( xN ) 输出代码组: s1 , ..., sN b 1 , ..., b N 若
③ 每一组再进一步分裂 => 赋 0,1 ④ 重复,到每组只剩下一个信源符号为止。 其特点:
1)最佳编码: 概率大的 => 分解的次数少
概率小的 => 分解的次数多 2)码字集合是唯一的
举例:书上P71页 表4.3
I 1 2 3 4 5 pi 0.20 0.19 0.18 0.17 0.15 1 (0.43) (0.26) 1 (0.57) (0.37) 1 0(0.17) (0.15) 0 1分解 0 2分解 (0.20) 0 (0.19) 0 (0.18) 1 3分解 4分解 编码 00 010 011 10 110 码长 2 3 3 2 3
对应的编码得到的
逗点码(comma code) (书上59页,例4.2) 即时码(instantaneous code) 译码时不需要考察 后续码元 单义可译码
• 逗点码: (例4.2) 1
s1
0 1 0 1 0
s2
s3
1
s4
0
1 0 1
s5
s6
•延长码(extended code)
•非延长码:
书上 P73 举例4.10 P74 4.11
Huffman coding 小结
① Huffman coding 总是以最小概率相加的方法来 “缩减”参与排队的概率个数: 概率越小→对缩减的贡献越大,码字也越大 ② 最小概率相加的方法 → 编码结果不具有唯一性。 ③ 尽管对同一信源存在着多种Huffman编码结果, 但其平均码长几乎都是相同的
k 对于 k 重扩展信源 . 熵 H ( X ).每个码字为B个码元 k R H ( X )/ B (bit / 码元)
(2)变长码的信息传输速率
x1 , x2 ,..., xN N 个单符号消息: b1 , b2 ,..., bN 变长码编码的代码组长度: 对应的概率为 : P(b ), P(b ),..., P(b ) 1 2 N
P( x1 ) P( x2 ) ... P( xN ) b 1 b 2 ... bN
则 b P ( xi )b i 最短!
第4.3节 单义可译定理
1.单义可译码: 对于一个有限长度的信源消息序列,若编码得 到的码字序列不与其他任何信源序列所对应的 码字相同
当信源消息序列不同 码字序列必然不同
2) 将两个最小的概率相加,形成新的概率,将和的 概率重新排队 3) 再重复 2),直到最后概率为1
4) 再次概率相加,将0,1按同一规律赋予相加的两 个概率(大概率赋1,小概率赋0)
• 举例:
b 2.5码元/ 符号 H ( x) P( xi )lbP( xi ) 2.471bit / 码元 R H ( x ) b 2.471/ 2.5 0.988bit / 码元
Ls
• 无失真编码 : Huffman、算法编码、VLC、轮廓编码法
若b bmin b bmin
不存在单义可译码 存在单义可译码
4.平均码长界定
H(X ) H(X ) b 1 LbD LbD
无失真信源编码. 单一可译码
bmin
H(X ) 下界 LbD
• 若 D 给定,给定信源 ( H ( X )),则 bmin 也确定
第4.4节 无失真信源编码定理
④
⑤
是最佳编码
先统计再编码
⑥
建立在编码器与译码器码树结构上的基础上
3. Lempel-ziv编码
概率分布未知
码树结构未知
① 独立于信源的统计特性,变长到定长的编码 ② 形成字典 code dictionary ③ 码字:(1)字典地址 (2)本码段需要源加的消息
④ 利用已编码信息进行当前的编码
4. 信源编码的目的
(1) 把信源发出的信息一一对应地变换维信道
基本符合构成的代码组 (2) 尽可能减小代码组的平均长度. 编码效率
第4.2节 信息传输速率和编码效率
1.信源编码的信息传输速率(信息率)R:
单位时间内所包含的信息量
(1) 等长码的信息传输速率 R
对于单符号信源. 熵H( X ).每个码字为b个码元 R H ( X ) / b (bit / 码元)
码元 / 字符
第4.5节
典型的信源方法
1. 香农编码 1 ① log D bi log D
P( xi )
1 1 P( xi )
b1 b2 ... bN
② ③
p( x1 ) p( x2 ) ... p( xN )
Pi pk
k 1
i 1
(前(i-1)个概率的累加)
香农编码方法
xi
pi
Pi
―lbpi
1 2 …
bi
1 2 …
代码组
0 10 …
x1 ½ 0 x2 ¼ ½+¼ … … …
xi 1 2 … …
i
1
2i 1
…
i …
i …
111…110 …
2.费诺编码(Fano coding)
①
p( x1 ) p( x2 ) ... p( xN )
② 将依次排列的信源符号按概率值分为“概率和接 近相同”的 2 组 => 赋 0,1
第四章4节离散平稳信源
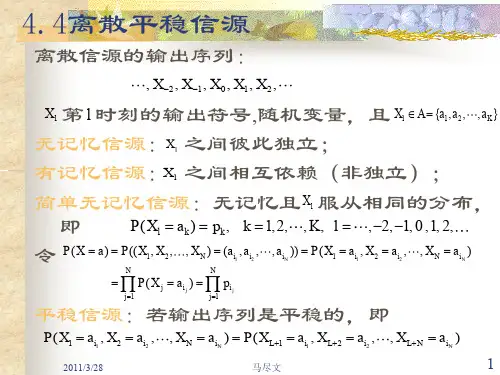
, XL) 1
n H (X1, X2, , X L ) 1 H (X ) 1 1
L log D
L log D log D L
2011/3/28
马尽文
11
4.4离散平稳信源
这时, 0 可取 1 ,使得
分大的 L ,满足 1 ,从而 L2
n H(X )
齐次马尔可夫信源的既约性(或不可约性): 任何两个状态之间,存在有限步路径使得从 一个状态转移到另一个状态的概率大于零。
稳态分布:状态(符号)的概率分布(若在 n
时刻)为 {Pn (aj )} j 1,
2011/3/28
马尽文
15
4.5 马尔可夫信源及其编码
经过转移后保持不变,即在 n 1 时刻有
2011/3/28
马尽文
4
4.4离散平稳信源
(2)
HN (X )
1 N
H ( X1,
, XN )
1 N [H ( X1) H ( X 2 | X1) H ( X N | X1,
1 N [NH ( X N | X1, , X N 1)]
H ( X N | X1, , X N 1)
(3)
HN
1 N
H (X1,
, XN)
lim
N
H(XN
|
X1,
, X N 1 )
lim
N
H(XN
|
X N 1 )
H ( X 2 | X1)
K
P( X1 a j )H ( X 2 | X1 a j ) j
H ( X | S ) H ( X )
注意:(1)马尔可夫信源的熵率是条件熵,与离 散无记忆信源相比,由于马尔可夫信源符号 前后的约束关系使其信息量更小。
信息论与编码2016(第4章)

§4.2 离散无记忆信道 对称DMC容量的计算
P的所有列都是第一列的一种置换,信 道是关于输出对称的
0 .8 0 .2 P 0 .5 0 .5 0 .2 0 .8
§4.2 离散无记忆信道
命题2 若DMC关于输出为对称的,则当输入分布等概时,输 出分布等概。 证明 此时{p(y|x),x=0~ K-1}与{p(0|x),x=0~ K-1}互为置换。 设q(x)=1/K,x∈{0, 1, …, K-1}。则
q( z ) p( y | z )
都取一个相同的值;对任何满足q(k)=0的k,I(X=k; Y)都 不大于此相同的值。 (2)此时此相同的值恰好就是信道容量C。
§4.2 离散无记忆信道
注解
如果对DMC信道没有任何简化,要计算最佳输 入分布并不容易。但是,通常使用的DMC是很简单 的(比如,以下的准对称信道和对称信道),最佳 输入分布很容易求出。
§4.2 ቤተ መጻሕፍቲ ባይዱ散无记忆信道
定理4.2.2(p91) (1)输入概率分布{x, q(x), x∈{0, 1, …, K-1}}是最佳输入分 布的充分必要条件为:对任何满足q(k)>0的k,
I ( X k ; Y ) p( y | k ) log K 1
y 0 z 0 J 1
p( y | k )
第四章:信道及其容量
§4.1 §4.2 §4.5 §4.6 §4.7 信道分类 离散无记忆信道 信道的组合 时间离散的无记忆连续信道 波形信道
5
§4.1 信道分类
所有信道都有一个输入集A,一个输出集B以及 两者之间的联系,如条件概率P(y│x),x∈A, y∈B。这些参量可用来规定一条信道。
chap4-信源编码3

0.5
0.514
0.52
A(cad)=A(ca)p(d)=0.006=p(cad)
0.514 0.5146 0.52
F(cadb)=F(cad)+p(cad)F(b)=0.5146
A(cadb)=A(cad)p(b)=0.0024=p(cadb)
算术编码--------------------递推公式
9
算术编码------------------基本思路
从整个符号序列出发,将各信源序列的概率映 射到[0,1)区间上,使每个符号序列对应于区 间内的一点,也就是一个二进制的小数。这些 点把[0,1)区间分成许多小段,每段的长度等 于某一信源序列的概率。再在段内取一个二进 制小数,其长度可与该序列的概率匹配,达到 高效率编码的目的。
我们可取该小区间内的一点来代表这个信源符号序 列,那么选取此点方法可以有多种,实际中常取小区 间的下界值。对信源符号序列的编码方法也可有多种, 下面介绍常用的一种算术编码方法。
13
算术编码--------------------二元码
14
算术编码---------------二元码递推公式
r=0,1,F(0)=0;F(1)=p(0)
区间宽度的递推公式 A( Sr ) A( S ) p( r ) p( S ) p( r ) p( Sr ) 累积概率的递推公式 F ( S 0) F ( S ) F ( S 1) F ( S ) p( S )F (1) F ( S ) p( S ) p(0) F ( S )为 符 号 序 列 的 累 积 概 率 , S p( S )为 符 号 序 列 的 联 合 概 率 S
该行经编码后只需用54位二元码元,而原 来一行共有1728个像素,如用“0”表示白,用 “l”表示黑,则共需1728位二元码元。可见, 这一行数据的压缩比为1728:54=32,因此压 缩效率很高。
差错控制编码第4章 离散信道

【在接收到Y=bj后,关于X的不确定性 的度量】
二、熵及平均互信息的物理 意义
3. 信道疑义度(损失熵):
H ( X | Y ) p(ai b j ) log p (ai | b j )
i 1 j 1 r s
【输出端收到全部符号Y后,对输入X 尚存在的平均不确定性的度量】
三种特殊的离散信道
• 无噪无损信道
•有损无噪信道
•无损有噪信道
1. 无损无噪信道
① 信道中没有随机性的干扰或者干 扰很小,输出信号Y与输入信号 X之间有确定的、一一对应的关 系,即: yn=f(xn)
1. 无损无噪信道
② 传递概率矩阵是单位矩阵,为:
1 y n f ( x n ) p( y n | xn ) ij 0 y n f ( x n )
当X=Y时,有I(X;X)=H(X)
【例4.1】
1 信源X的概率测度为 PX 4
过下图所示的二元信道,计算H(X) 、H(Y) 和H(X|Y)。
0ቤተ መጻሕፍቲ ባይዱ
H(X |Y) p (ai b j ) log p (ai | b j )
j 1 i 1 s r
3 ,通 4
1/2 1/2 1/3
1. 传递概率p(y|x) 描述了输入信号和 输出信号之间统计依赖关系,集中 体现了信道对输入符号X的传递作 用,反映了信道的统计特性。 2. 信道不同,传递概率不同。
补充内容:
1. 有损有噪信道
若信源发出ai有可能收到任意一 个bj;收到bj也有可能来自任意一个 ai,即yn与xn多多对应,传输矩阵中 所有的矩阵元素都有可能不为零。
2. 有噪无损信道
③ 【有噪无损信道的特点】传递概率矩 阵中每列有且仅有一个非零元素,即 具有一行多列的分块对角化形式。
信息论.第4章无失真信源编码

S N
1
P
p(1 )
2 ... p(2 ) ...
qN
p(qN )
扩展信源熵为H(SN),
5
用码符号集X=(x1,…,xr)对SN 编码,则总可以找到
一种编码方法,构成唯一可译码,使信源S中的一
个信源符号所需要的码字平均长度满足
H (S) 1 LN H (S) log r N N log r
N log r 则当N足够大时,译码错误概率趋于1。
3
信源编码效率 编码速率:对于定长编码,编码速率定义为
R L log r N
编码效率:
H(S)
R
4
变长无失真信源编码定理(香农第一定理)
设离散无记忆信源
S
P
s1 p( s1 )
s2 p(s2 )
... ...
sq
p(
sq
)
其信源熵为H(S),它的N次扩展信源SN为
l log q log r
2
定长信源编码定理
设有离散无记忆信源,熵为H(S) ,若对信源的长为N 的符号序列进行定长编码,设码字是从r个码符号集中选 取L个码元构成,对于 > 0 只要满足
L H(S)
N log r 则当N足够大时,可实现译码错误概率任意小的等长编
码,近似无失真编码。
反之,若 满足 L H (s) 2
i 1
克拉夫特证明不等式为即时码存在的充要条件; 麦克米伦证明不等式为唯一可译码存在的充要条件。
1
简单信源S存在唯一可译定长码的条件为:
q r l l log q
log r
N次扩展信源SN存在唯一可译定长码的条件为:
qN rL
L log r N log q来自L log q N log r
信息论 第4章(哈夫曼编码和游程编码)

游程编码的基本原理
很多信源产生的消息有一定相关性,往往 连续多次输出同样的消息,同一个消息连续输 出的个数称为游程(Run-Length).我们只需要 输出一个消息的样本和对应重复次数,就完全 可以恢复原来的消息系列.原始消息系列经过 这种方式编码后,就成为一个个编码单元(如下 图),其中标识码是一个能够和消息码区分的特 殊符号.
文件传真压缩方法具体流程
主要利用终止码和形成码(见书本P43-44), 一般A4的纸每行的像素为1728,具体编码规则 如下: (1)当游程长度小于64时,直接用一个对应 的终止码表示。 (2)当游程长度在64到1728之间时,用一个 形成码加一个终止码表示。 例如:白游程为662时用640形成码(白)加22终 止码(白)表示,即:01100111 0000011. 黑游程为256时用256形成码(黑)加0终止码(黑) 表示,即:000001011011 0000110111.
哈夫曼(Huffman) (3)哈夫曼(Huffman)编码
哈夫曼编码:将信源中的各个消息按概率排序, 不断将概率最小的两个消息进行合并,直到合 并为一个整体,然后根据合并的过程分配码字, 得到各个消息的编码。 该方法简单明了,并且可以保证最终的编 码方案一定是最优编码方案。
哈夫曼(Huffman) 哈夫曼(Huffman)编码的例子
香农编码的例子
第四章信源编码习题解答
第四章信源编码习题解答1种编码方法:1)哪些是非奇异码哪些是唯一可译码哪些是即时码2)分别计算每个唯一可译码的平均码长和编码效率。
解:1)A、B、C、D、E、F是非奇异码。
A、B、C、F是唯一可译码(E不满足克拉夫特不等式)。
A、C、F是即时码(B是续长码)。
3)编码A:平均码长:3AL=码元/消息信源熵:111111()lb lb4lb222441616H X=---⨯=比特/消息编码效率:max ()/2/366.7% lb21AH H X L Hη====码码编码B和C:平均码长:11111123456 2.1252416161616B CL L==+⨯+⨯+⨯+⨯+⨯=码元/消息编码效率:max ()/2/2.12594.1% lb21B CH H X L Hηη=====码码编码F:平均码长:111234 2.52416FL⎛⎫=⨯+⨯+⨯=⎪⎝⎭码元/消息编码效率:max ()/2/2.580%lb21F H H X L H η====码码2、离散无记忆信源X 的概率空间为:1234567()0.200.190.180.170.150.100.01X x x x x x x x p X ⎧⎫⎡⎤=⎨⎬⎢⎥⎩⎭⎣⎦ 1)对其进行费诺编码,并计算其编码效率;2)对其进行哈夫曼编码,并将其编码效率与费诺编码相比较。
解:1平均码长:()()()0.20.1720.190.180.1530.10.014 2.74L =+⨯+++⨯++⨯=码元/符号 信源熵:()0.20lb0.200.19lb0.190.18lb0.180.17lb0.170.15lb0.150.1lb0.10.01lb0.01 2.60/874H X =-------= 比特符号编码后平均码元熵:() 2.608740.95212.74H X H L===码比特/码元编码效率:max 0.952195.21%lb2H H η===码码2)哈夫曼编码: 码长码字 信源X (X )2 10 x 1 2 11 x 2 3000 x 33 001 x 43 010 x 54 0110 x 64 0111x 7平均码长:()()()0.20.1920.180.170.1530.10.014 2.72L =+⨯+++⨯++⨯=码元/符号 编码后平均码元熵:() 2.608740.95912.72H X H L===码比特/码元编码效率:max 0.959195.91%lb2H H η===码码与费诺编码相比,哈夫曼编码的编码效率要高于费诺编码。
信息论与编码理论-第4章无失真信源编码-习题解答-20071202
信息论与编码理论-第4章无失真信源编码-习题解答-20071202信息论与编码理论第4章无失真信源编码习题及其参考答案4-1 有一信源,它有六个可能的输出,其概率分布如下表所示,表中给出了对应的码A、B、C、D、E和F(1)求这些码中哪些是唯一可译码;(2)求哪些码是及时码;(3)对所有唯一可译码求出其平均码长。
?X??s14-2 设信源????p(s)P(X)???1s6?p(s2)?p(s6)???s2?p(s)?1。
对此次能源进行m元唯一ii?16可译编码,其对应的码长为(l1,l2,…,l6)=(1,1,2,3,2,3),求m值的最好下限。
(提示:用kraft不等式)?s?X??14-3设信源为??1??p(X)???2?(1)信源的符号熵;(2)这种码的编码效率;s214s3s411816s5132s6s7s8?,编成这样的码:(000,001,111???64128128?010,011,100,101,110,111)。
求(3)相应的仙农码和费诺码。
4-4求概率分布为(,11122信)源的二元霍夫曼编码。
讨论此码对于概率分布为355151511111(,,,,)的信源也是最佳二元码。
555554-5有两个信源X和Y如下:1信息论与编码理论s2s3s4s5s6s7??X??s1??p(X)??0.200.190.180.170.150.100.01?????s2s3s4s5s6s7s8s9??Y??s1??p(Y)??0.490.140.140.070.070.040.020.02 0.01?????(1)用二元霍夫曼编码、仙农编码以及费诺编码对信源X和Y进行编码,并计算其平均码长和编码效率;(2)从X,Y两种不同信源来比较三种编码方法的优缺点。
4-6设二元霍夫曼码为(00,01,10,11)和(0,10,110,111),求出可以编得这样霍夫曼码的信源的所有概率分布。
4-7设信源为?码。
第四章 移动通信中的信源编码
第四章移动通信中的信源编码在当今这个信息爆炸的时代,移动通信已经成为我们生活中不可或缺的一部分。
无论是与亲朋好友的语音通话,还是观看精彩的视频直播,亦或是随时随地获取各种信息,都离不开移动通信技术的支持。
而在移动通信系统中,信源编码是一个至关重要的环节,它直接影响着通信的质量和效率。
那么,什么是信源编码呢?简单来说,信源编码就是将信源输出的信号转换成适合在信道中传输的形式。
在移动通信中,信源通常是指语音、图像、视频等各种信息。
由于这些原始信息的数据量往往非常庞大,如果直接进行传输,将会占用大量的信道资源,导致传输效率低下,甚至无法实现实时通信。
因此,需要通过信源编码对原始信息进行压缩和处理,减少数据量,提高传输效率。
信源编码的主要目的有两个:一是减少冗余信息,二是提高编码效率。
冗余信息是指那些在传输过程中不必要或者可以通过其他方式恢复的信息。
例如,在语音信号中,相邻的语音样本之间往往存在很强的相关性,这就意味着存在大量的冗余信息。
通过对这些冗余信息进行分析和处理,可以大大减少数据量。
同时,信源编码还需要考虑如何在保证一定质量的前提下,尽可能地提高编码效率,也就是用更少的比特数来表示相同的信息。
在移动通信中,常用的信源编码技术包括语音编码和图像编码。
语音编码是将语音信号转换为数字信号的过程。
目前,广泛应用的语音编码标准有 GSM 语音编码、CDMA 语音编码和 3GPP 语音编码等。
这些编码技术通过采用不同的算法和策略,对语音信号进行分析、建模和编码,在保证语音质量的前提下,实现了较高的压缩比。
例如,GSM 语音编码采用了规则脉冲激励长期预测(RPELTP)编码算法,将语音信号分成若干个帧,对每一帧进行分析和编码。
CDMA 语音编码则采用了可变速率码激励线性预测(QCELP)编码算法,根据语音的特征动态调整编码速率,从而在不同的信道条件下都能提供较好的语音质量。
3GPP 语音编码则引入了自适应多速率(AMR)技术,能够根据网络状况和用户需求自适应地选择不同的编码速率,进一步提高了语音通信的灵活性和效率。
信息论--第四章第五节 变长码 第六节 变长信源编码定理
4.5 变长码
即时码
唯一可译码成为即时码的充要条件:
一个唯一可译码成为即时码的充要条件是其中任何一个
码字都不是其他码字的前缀。
所有的码 非奇异码 唯一可译码 即时码
4.5 变长码
即时码的构造方法
用树图法可以方便地构造即时码。树中每个中间节
点都伸出1至r个树枝,将所有的码字都安排在终端
节点上就可以得到即时码。
H H (S )
从而
LN H lim N N log r
4.6变长信源编码定理
对一般离散信源,无失真信源编码定理证 明
S S1S2 S N
H (S) H (S) LN 1 log r log r
H (S) LN H (S) 1 N log r N N log r N
H (S ) L logr 0
p(si ) log p( si ) p( si )li log r
i 1 i 1 q q
p( si ) log p( si ) p( si ) log r
i 1 i 1
q
q
li
4.6变长信源编码定理
紧致码平均码长界限定理证明
4.5 变长码
2. 变长唯一可译码判别方法(续)
例5.4 : C a c ad F1 d bb F2 eb cde F3 de F4 b F5 ad bcde
abb
bad deb bbcde 结论:F5中包含了C中的元素,因此该变长码不是唯一可译码。 问题: 判断 C={1,10,100,1000}是否是唯一可译码?
信道传信率
H (S ) H (S ) log r R H (S ) L log r