
数据结构课程设计二路归并排序说明书
前言1.1排序的重要性生活中,无时不刻不充满这排序,比如:班级同学的成绩排名问题,公司产值高低的问题等等,解决这些问题的过程中,都涉及到了一个数据结构的构造思想过程。
数据结构中的排序,也有很多种,如:插入排序、交换排序、选择排序等等,此时我们就要注意选择具有优解的算法,将一个数据元素(或记录)的任意序列,重新排列成一个有序的排列,便于我们查找。
假设含有n个记录的序列为{R1,R2,Rn},其相应的关键字序列为{K1,K2,…,Kn}需确定1,2…n的一种排序P1,P2…Pn,使其相应的关键字满足如下的非递减的关系:Kp1≤Kp2≤…≤Kpn,即按关键字{Rp1,Rp2,…,Rpn}有序的排列,这样的一种操作称为排序。
一般情况下,排序又分为内部排序和外部排序。
而在内部排序中又含有很多排序方法,就其全面性能而言,很难提出一种被认为是最好的方法,因为每一种方法都有它的优缺点,适合在不同的环境下使用。
我们学习的排序有:直接插入排序、折半插入排序、希尔排序、快速排序、基数排序、归并排序等。
本次课题研究中,我主要进行了二路归并排序的研究和学习。
1.2设计的背景和意义排序是计算机领域的一类非常重要的问题,计算机在出来数据的过程中,有25%的时间花在了排序上,有许多的计算机设备,排序用去计算机处理数据时间的一半以上,这对于提高计算机的运行速度有一定的影响。
此时排序算法的高效率显得尤为重要。
在排序算法汇中,归并排序(Merging sort)是与插入排序、交换排序、选择排序不同的另一类排序方法。
归并的含义是将两个或两个以上的有序表组合成一个新的有序表。
归并排序可分为多路归并排序,两路归并排序,既可用于内排序,也可以用于外排序。
这里仅对内排序的两路归并排序进行讨论。
而我们这里所探究学习的二路归并排序,设计思路更加清晰、明了,程序本身也不像堆结构那样复杂,同时时间复杂度仅为0(N),同时在处理大规模归并排序的时候,排序速度也明显优于冒泡法等一些排序算法,提高排序算法的效率。
正文2.1设计内容设计一个利用二路归并算法实现的排序算法,针对输入的一组无序的数,利用栈或者数组机芯存储,然后进行数据的两两分组、比较,构造新的栈或者数组,依次类推,直到得到一个有序数组或者栈,最后输出有序数据,得到有序数据。
2.2设计要求假设初始序列含有n 个数据(n是已经确定的数据个数),首先把n 个记录看成n个长度为1的有序序列,进行两两归并,得到[n/2]个长度为2的有序序列,再两两归并直到所有记录归并成一个长度为n的有序序列为止。
2.3设计思想对于任意一组数据,先利用栈或者数组将数据存储起来,其中,我们会用到线性表的顺序存储和链式存储两种存储方法。
然后对存储的数据进行查找和筛选、排序,在出栈的过程中,同时对所取数据进行分组、排列,再次构造新的存储栈或者数组,依次类推,直到得到一个有序的数据时,执行出栈命令,输出最后的排序结果。
为了更清晰地说清楚这里的思想,大家来看图1,我们将本是无序的数组序列{16,7,13,10,9,15,3,2,5,8,12,1,11,4,6,14},通过两两合并排序后,再合并,最终获得了一个有序的数组。
仔细观察它的形状,很像一棵倒置的完全二叉树,利用两两的比较,一次进行递归排序,最终得到一个从小到大的有序序列。
图 12.4 主要模块主要模块式有四个阶段,依次是:输入一组无序的数列,用数据结构或者链式结构进行存储,然后进行查找、分组,进行最后的归并排序。
(如图2所示)图 22.5排序设计内容此次操作要用到顺序结构的存储,顺序表的查找,以及二路归并排序。
2.5.1 顺序表的存储首先利用顺序存储结构,把所有学生的成绩按每个班,每个学校,每个县,每个市,用线性表的顺序存储机构分别存储起来。
顺序表的基本操作如下:Initlist(&L) 操作结果:构造一个空的线性表L; Destroylist(&L) 操作结果:销毁线性表L;Clearlist((&lL) 操作结果:将L重置为空表(线性表L已经存在);Iiselength(L) 操作结果:返回L中数据元素的个数;GetElem(L,I,&e) 操作结果:用e返回L中第i个数据元素的值;2.5.2 顺序表的查找Int Search-Sep(SSTable ST , KeyType key){//在顺序表ST中顺序查找其关键字等于Key的数据元素。
若找到,则函数值为该元素在表中的位置,否则为0ST.elem[0].Key=key; 哨兵;For(i=ST.length; !EQ(ST.elem[i].key.key)) 从后往前找;Return I; 找不到是i为0;}//Search-Sep2.5.3 归并排序代码:/* 对顺序表L作归并排序 */void MergeSort(SqList *L){MSort(L->r,L->r,1,L->length);}2.6算法设计本次设计主要用用到下面的算法:2.6.1归并排序算法的实现递归算法就是对n个数据进行两两归并,得到[n/2]个长度为2的有序序列,再两两归并直到所有记录归并成一个长度为n的有序序列为止。
递归算法实现中,最重要的就是对[n/2]进行很多次的归并递归排序算法的设计,调用函数MSort中采用了递归的算法思想,用较简短的语句,实现了多次递归排序。
假设现在要对数组{50,10,90,30,70,40,80,60,20}进行排序,L.length=9,一下就是MSort 主要代码及实现过程。
/* 将SR[s..t]归并排序为TR1[s..t] */1 void MSort(int SR[],int TR1[],int s, int t)2 {3int m;4int TR2[MAXSIZE+1];5if(s==t)6TR1[s]=SR[s];7Else8{9m=(s+t)/2; /* 将SR[s..t]平分为SR[s..m]和SR[m+1..t] */ 10MSort(SR,TR2,s,m); /* 递归地将SR[s..m]归并为有序的TR2[s..m] */11MSort(SR,TR2,m+1,t); /* 递归地将SR[m+1..t]归并为有序TR2[m+1..t] */12Merge(TR2,TR1,s,m,t); /* 将TR2[s..m]和TR2[m+1..t]归并到TR1[s..t] */13}14}1) MSort被调用时,SR与TR1都是{50,10,90,30,70,40,80,60,20},s=1,t=9,最终我们的目的就是要将TR1中的数组排好顺序。
2) 第5行,显然s不等于t,执行第8~13行语句块。
3) 第9行,m=(1+9)/2=5。
m就是序列的正中间下标4) 此时第10行,调用“MSort(SR,TR2,1,5);”的目标就是将数组SR中的第1~5的关键字归并到有序的TR2(调用前TR2为空数组),第11行,调用“MSort(SR,TR2,6,9);”的目标就是将数组SR中的第6~9的关键字归并到有序的TR2。
也就是说,在调用这两句代码之前,代码已经准备将数组分成两组。
如图4所示:图45) 第12行,函数Merge的代码细节一会再讲,调用“Merge(TR2,TR1,1,5,9);”的目标其实就是将第10和11行代码获得的数组TR2(注意它是下标为1~5和6~9的关键字分别有序)归并为TR1,此时相当于整个排序就已经完成了。
如图5所示:图56) 第10行递归调用进去后,s=1,t=5,m=(1+5)/2=3。
此时相当于将5个记录再为三个和两个。
继续递归进去,直到细分为一个记录填入TR2,此时s与t相等,递归返回,如图6的左图。
每次递归返回后都会执行当前递归函数的第12行,将TR2归并到TR1中。
如图6的右图。
最终使得当前序列有序。
图67) 同样的第11行也是类似方式,如图7。
图78) 此时也就是刚才所讲的最后一次执行第12行代码,将{10,30,50,70,90}与{20,40,60,80}归并为最终有序的序列。
以下是对此段递归算法程序的图示:(如图8)图82.6.2归并排序算法的整合在经过每个新的排序片段以后,程序产生新的数组,如何让新的数组依然按照一定顺序进行排序,即将SR[i..m]和SR[m+1..n]归并为有序的TR[i..n],此时就要进行Merge()函数的调用。
一下就是Merge()函数实现的详细过程:/* 将有序的SR[i..m]和SR[m+1..n]归并为有序的TR[i..n] */1 void Merge(int SR[],int TR[],int i,int m,int n)2 {3int j,k,l;4 4 for(j=m+1,k=i;i<=m && j<=n;k++) /* 将SR中记录由小到大归并入TR */5 {6 if (SR[i]<SR[j])7 TR[k]=SR[i++];8else99 TR[k]=SR[j++];10 }11 if(i<=m)12 {13 for(l=0;l<=m-i;l++)14 TR[k+l]=SR[i+l]; /* 将剩余的SR[i..m]复制到TR */15 }16 if(j<=n)17{1818 for(l=0;l<=n-j;l++)19 TR[k+l]=SR[j+l]; /* 将剩余的SR[j..n]复制到TR */20 }21 }1) 假设我们此时调用的Merge就是将{10,30,50,70,90}与{20,40,60,80}归并为最终有序的序列,因此数组SR为{10,30,50,70,90,20,40,60,80},i=1,m=5,n=9。
2) 第4行,for循环,j由m+1=6开始到9,i由1开始到5,k由1开始每次加1,k值用于目标数组TR的下标。
3) 第6行,SR[i]=SR[1]=10,SR[j]= SR[6]=20,SR[i]<SR[j],执行第7行,TR[k]=TR[1]=10,并且i++。
如图9。
图94) 再次循环,k++得到k=2,SR[i]=SR[2]=30,SR[j]= SR[6]=20,SR[i]>SR[j],执行第9行,TR[k]=TR[2]=20,并且j++,如图10。
图105) 再次循环,k++得到k=3,SR[i]=SR[2]=30,SR[j]= SR[7]=40,SR[i]<SR[j],执行第7行,TR[k]=TR[3]=30,并且i++,如图11。
图116) 接下来完全相同的操作,一直到j++后,j=10,大于9退出循环。
数据结构(C语言版清华大学出版社)-章课后部分答案
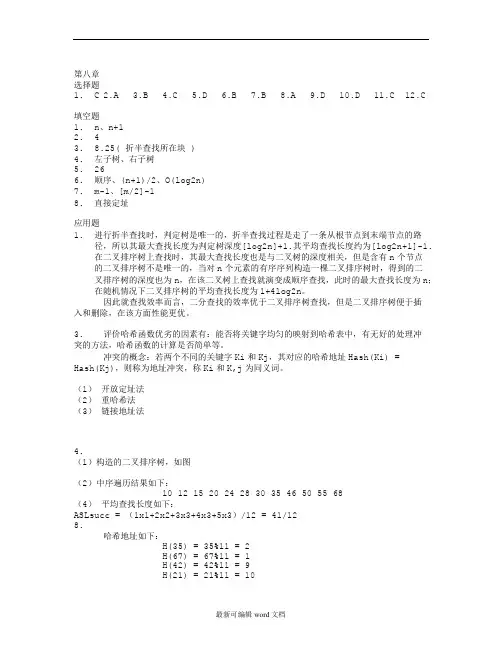
第八章选择题1. C2.A3.B4.C5.D6.B7.B8.A9.D 10.D 11.C 12.C填空题1.n、n+12. 43.8.25( 折半查找所在块 )4.左子树、右子树5.266.顺序、(n+1)/2、O(log2n)7.m-1、[m/2]-18.直接定址应用题1.进行折半查找时,判定树是唯一的,折半查找过程是走了一条从根节点到末端节点的路径,所以其最大查找长度为判定树深度[log2n]+1.其平均查找长度约为[log2n+1]-1.在二叉排序树上查找时,其最大查找长度也是与二叉树的深度相关,但是含有n个节点的二叉排序树不是唯一的,当对n个元素的有序序列构造一棵二叉排序树时,得到的二叉排序树的深度也为n,在该二叉树上查找就演变成顺序查找,此时的最大查找长度为n;在随机情况下二叉排序树的平均查找长度为1+4log2n。
因此就查找效率而言,二分查找的效率优于二叉排序树查找,但是二叉排序树便于插入和删除,在该方面性能更优。
3. 评价哈希函数优劣的因素有:能否将关键字均匀的映射到哈希表中,有无好的处理冲突的方法,哈希函数的计算是否简单等。
冲突的概念:若两个不同的关键字Ki和Kj,其对应的哈希地址Hash(Ki) =Hash(Kj),则称为地址冲突,称Ki和K,j为同义词。
(1)开放定址法(2)重哈希法(3)链接地址法4.(1)构造的二叉排序树,如图(2)中序遍历结果如下:10 12 15 20 24 28 30 35 46 50 55 68(4)平均查找长度如下:ASLsucc = (1x1+2x2+3x3+4x3+5x3)/12 = 41/128.哈希地址如下:H(35) = 35%11 = 2H(67) = 67%11 = 1H(42) = 42%11 = 9H(21) = 21%11 = 10H(29) = 29%11 = 7H(86) = 86%11 = 9H(95) = 95%11 = 7H(47) = 47%11 = 3H(50) = 50%11 = 6H(36) = 36%11 = 3H(91) = 91%11 = 3第九章选择题1. D2.C3.B4.D5.C6.B7.A8.A9.D 10.D填空题1.插入排序、交换排序、选择排序、归并排序2.移动(或者交换)3.归并排序、快速排序、堆排序4.保存当前要插入的记录,可以省去在查找插入位置时的对是否出界的判断5.O(n)、O(log2n)6.直接插入排序或者改进了的冒泡排序、快速排序7.Log2n、n8.完全二叉树、n/29.1510.{12 38 25 35 50 74 63 90}应用题11.(1)Shell排序(步长为5 3 1)每趟的排序结果初始序列为100 87 52 61 27 170 37 45 61 118 14 88 32步长为5的排序14 37 32 61 27 100 87 45 61 118 170 88 52步长为3的排序结果14 27 32 52 37 61 61 45 88 87 170 100 118步长为1的排序结果14 27 32 37 45 52 61 61 87 88 100 118最后结果14 27 32 37 45 52 61 61 87 88 100 118 170(2)快速排序每趟的排序结果如图初始序列100 87 52 61 27 170 37 45 61 118 14 88 32第一趟排序[32 87 52 61 27 88 37 45 61 14]100[118 170]第二趟排序[14 27]32[61 52 88 37 45 61 87]100 118[170]第三趟排序14[27]32[45 52 37]61[88 61 87]100 118[170]第四趟排序14[27]32[37]45[52]61[87 61]88 100 118[170]第五趟排序14[27]32[37]45[52]61[87 61]88 100 118[170]最后结果14[27]32[37]45[52]61[61]87 88 100 118[170](3)二路归并排序每趟的排序结果初始序列[100][87][52][61][27][170][37][45][61][118][14][88][32]第一趟归并[87 100][52 61][27 170][37 45][61 118][14 88][32]第二趟归并[52 61 87 100][27 37 45 170][14 61 88 118][32]第三趟归并排序[27 37 45 52 61 87 100 170][14 32 61 88 118]第四趟归并排序[14 27 32 37 45 52 61 61 87 88 100 118 170]最后结果14 27 32 37 45 52 61 61 87 88 100 118 17012.采用快速排序时,第一趟排序过程中的数据移动如图:算法设计题1.分析:为讨论方便,待排序记录的定义为(后面各算法都采用此定义):#define MAXSIZE 100 /* 顺序表的最大长度,假定顺序表的长度为100 */ typedef int KeyType; /* 假定关键字类型为整数类型 */typedef struct {KeyType key; /* 关键字项 */OtherType other; /* 其他项 */}DataType; /* 数据元素类型 */typedef struct {DataType R[MAXSIZE+1]; /* R[0]闲置或者充当哨站 */int length; /* 顺序表长度 */}sqList; /* 顺序表类型 */设n个整数存储在R[1..n]中,因为前n-2个元素有序,若采用直接插入算法,共要比较和移动n-2次,如果最后两个元素做一个批处理,那么比较次数和移动次数将大大减小。
二路归并排序算法

二路归并排序算法二路归并排序算法是一种基于归并的排序算法,它将一个无序的数列分成两个子数列,然后递归地对子数列进行排序,最后将两个有序的子数列合并成一个有序的完整数列。
这个算法的核心思想是将一个大问题分解成两个小问题,然后解决小问题并合并解的过程。
二路归并排序算法的基本思路如下:1.将待排序的数列均匀地分成两个子数列,分别称为左子数列和右子数列。
2.递归地对左子数列和右子数列进行排序,直到子数列只有一个元素时停止递归。
3.将两个有序的子数列合并成一个有序的完整数列。
从上述描述可以看出,二路归并排序算法主要包含两个步骤:拆分和合并。
拆分过程是通过递归实现的,首先将待排序的数列一分为二,然后对左右两个子数列分别再一分为二,直到子数列只有一个元素时停止递归。
这个过程可以用二叉树的形式来表示,树的每个节点表示一个子数列,节点的左子节点表示左子数列,右子节点表示右子数列。
拆分过程的时间复杂度是O(log n),其中n为待排序数列的长度。
合并过程是通过比较两个有序子数列的元素,并按照从小到大的顺序将它们合并成一个有序的完整数列。
具体实现中,可以使用两个指针分别指向左子数列和右子数列的头部,然后比较两个指针指向的元素大小,将较小的元素放入新的有序数列中,并将指针向后移动。
这个过程时间复杂度是O(n),其中n为待排序数列的长度。
总体来说,二路归并排序算法的时间复杂度是O(nlog n),其中n为待排序数列的长度。
因为在每一层递归中,合并过程需要比较n次,且递归的层数是log n,所以时间复杂度为n乘以log n。
空间复杂度是O(n),因为需要额外的空间来存储临时数列。
二路归并排序算法的优点是稳定,不受初始排序状态的影响,对于大规模的数据集合也适用。
缺点是需要额外的空间来存储临时数列,且递归的过程需要较多的函数调用,对于内存有限的设备可能会造成问题。
在实际应用中,二路归并排序算法被广泛应用于大规模数据的排序。
它的算法思想也可以用于其他排序算法的改进和优化。
《数据结构-c语言描述》教学大纲
教与学|数据结构一C语言描述(教学大纲)一、课程基本信息二、课程描述和目标1•课程描述本课程是高等院校计算机类相关专业一门重要的学科基础课,也是本校计算机科学与技术、软件工程、网络工程、大数据与科学技术等专业的计算机大类平台必修课。
本课程主要讨论各种数据的抽象表示、实现方法、处理数据的算法设计以及对算法性能的分析。
它的先修课程是:高级语言程序设计,后继课程是:数据库原理、操作系统等。
本课程的教学依赖于其先修课程,又能为其后续课程及进一步的软件开发奠定良好的理论与实践基础。
2.课程目标结合专业人才培养方案,并基于新工科专业OBE理念,力求通过本课程的系统学习促进学生在知识、能力和素质三方面得到一定程度的提升。
课程目标1:能够清楚表述数据结构和算法的基本概念,并能判断计算机处理不同数据时所采用的组织方法、操作原理和实现方法。
课程目标2:能够针对具体问题,运用数据结构课程相关知识和批判思维,分析计算机处理对象的结构特征,选择合适的数据存储结构,设计高效的操作算法。
课程目标3:能够综合运用数据结构的基本原理和设计方法,研究复杂问题的特征,自主设计可行的求解方案,并能运用高级语言编写实现问题求解的应用程序,再验证其正确性。
三、课程目标对毕业要求的支撑关系四、教学内容、基本要求及学时分配本课程教学内容主要包括线性表、栈和队列、串与数组、树和图等主要数据结构的特点、在计算机内部的表示和实现原理与方法分析,以及查找和排序两种主要操作的各种实线性表的应用奋斗一我自己励志的故事栈的应用奉献-开源技术背后的故事10分钟矩阵的压缩存储节约-提升资源复用水平、降低资源消耗的相关故事10分钟哈夫曼树与哈夫曼编码(压创新-工匠精神,余立平冒着巨大的危险雕刻火药的10分钟缩技术)航天人的故事拓扑排序、关键路径分布式-跨地域信息沟通水平,是升社会安全的故事10分钟二叉排序树上的查找快速排序效率-有关提升计算资源利用率以及社会生产效率10分钟的故事协作一有关专业分工、各司其职的螺丝钉精神的故10分钟五、课程重难点六、课程要求及成绩评定1.教学环节及其组织形式本课程采用线上线下相结合的混合式教学模式实施教学,整个教学分课前、课中、课后三个环节进行组织教学活动。
数据结构加强之排序算法讲解

3.1 直接插入排序
for j=1 to n-1
for i=1 to n-j
真 a[i]>a[i+1]
a[i]a[i+1]
输出a[1] 到 a[n]
#include <stdio.h> main() { int a[11],i,j,t; printf("Input 10 numbers:\n"); for(i=1;i<11;i++) scanf("%d",&a[i]); printf("\n"); 假 for(j=1;j<=9;j++) for(i=1;i<=10-j;i++) if(a[i]>a[i+1]) {t=a[i]; a[i]=a[i+1]; a[i+1]=t;} printf("The sorted numbers:\n"); for(i=1;i<11;i++) printf("%d ",a[i]); }
排序算法
常见的经典排序算法
冒泡排序 选择排序 插入排序 希尔排序 快速排序 归并排序
1 冒泡排序
算法描述 设待排序记录序列中的记录个数为n
一般地,第i趟起泡排序从1到n-i+1
依次比较相邻两个记录的关键字,如果发生逆序, 则交换之。 其结果是这n-i+1个记录中,关键字最大的记录被 交换到第n-i+1的位置上,最多作n-1趟。
数据结构课程设计
数据结构课程设计报告几种排序算法的演示班级:姓名:学号:完成日期:一需求分析1.运行环境Microsoft Visual Studio 20082.程序所实现的功能对直接插入排序、折半插入排序、冒泡排序、简单选择排序、快速排序、堆排序、归并排序算法的演示,并且输出每一趟的排序情况。
3.程序的输入(包含输入的数据格式和说明)<1>排序种类三输入<2>排序数的个数的输入<3>所需排序的所有数的输入4.程序的输出(程序输出的形式)<1>主菜单的输出<2>每一趟排序的输出,即排序过程的输出5.测试数据,如果程序输入的数据量比较大,需要给出测试数据。
二设计说明1.算法设计思想<1>交换排序(冒泡排序、快速排序)交换排序的基本思想是:对排序表中的数据元素按关键字进行两两比较,如果发生逆序(即排列顺序与排序后的次序正好相反),则两者交换位置,直到所有数据元素都排好序为止。
<2>插入排序(直接插入排序、折半插入排序)插入排序的基本思想是:每一次设法把一个数据元素插入到已经排序的部分序列的合适位置,使得插入后的序列仍然是有序的。
开始时建立一个初始的有序序列,它只包含一个数据元素。
然后,从这个初始序列出发不断插入数据元素,直到最后一个数据元素插到有序序列后,整个排序工作就完成了。
<3>选择排序(简单选择排序、堆排序)选择排序的基本思想是:第一趟在有n个数据元素的排序表中选出关键字最小的数据元素,然后在剩下的n-1个数据元素中再选出关键字最小(整个数据表中次小)的数据元素,依次重复,每一趟(例如第i趟,i=1,…,n-1)总是在当前剩下的n-i+1个待排序数据元素中选出关键字最小的数据元素,作为有序数据元素序列的第i个数据元素。
等到第n-1趟选择结束,待排序数据元素仅剩下一个时就不用再选了,按选出的先后次序所得到的数据元素序列即为有序序列,排序即告完成。
数据结构实验报告排序
数据结构实验报告排序数据结构实验报告:排序引言:排序是计算机科学中常见的算法问题之一,它的目标是将一组无序的数据按照特定的规则进行排列,以便于后续的查找、统计和分析。
在本次实验中,我们将学习和实现几种常见的排序算法,并对它们的性能进行比较和分析。
一、冒泡排序冒泡排序是最简单的排序算法之一,它通过不断交换相邻的元素,将较大(或较小)的元素逐渐“冒泡”到数组的一端。
具体实现时,我们可以使用两层循环来比较和交换元素,直到整个数组有序。
二、插入排序插入排序的思想是将数组分为两个部分:已排序部分和未排序部分。
每次从未排序部分中取出一个元素,插入到已排序部分的适当位置,以保持已排序部分的有序性。
插入排序的实现可以使用一层循环和适当的元素交换。
三、选择排序选择排序每次从未排序部分中选择最小(或最大)的元素,与未排序部分的第一个元素进行交换。
通过不断选择最小(或最大)的元素,将其放置到已排序部分的末尾,从而逐渐形成有序序列。
四、快速排序快速排序是一种分治的排序算法,它通过选择一个基准元素,将数组划分为两个子数组,其中一个子数组的所有元素都小于等于基准元素,另一个子数组的所有元素都大于基准元素。
然后对两个子数组分别递归地进行快速排序,最终将整个数组排序。
五、归并排序归并排序也是一种分治的排序算法,它将数组划分为多个子数组,对每个子数组进行排序,然后再将排好序的子数组合并成一个有序的数组。
归并排序的实现可以使用递归或迭代的方式。
六、性能比较与分析在本次实验中,我们对以上几种排序算法进行了实现,并通过对不同规模的随机数组进行排序,比较了它们的性能。
我们使用了计算排序时间的方式,并记录了每种算法在不同规模下的运行时间。
通过对比实验结果,我们可以得出以下结论:1. 冒泡排序和插入排序在处理小规模数据时表现较好,但在处理大规模数据时性能较差,因为它们的时间复杂度为O(n^2)。
2. 选择排序的时间复杂度也为O(n^2),与冒泡排序和插入排序相似,但相对而言,选择排序的性能稍好一些。
(完整word版)数据结构(c语言版)课后习题答案完整版资料
第1章绪论5.选择题:CCBDCA6.试分析下面各程序段的时间复杂度。
(1)O(1)(2)O(m*n)(3)O(n2)(4)O(log3n)(5)因为x++共执行了n—1+n—2+……+1= n(n—1)/2,所以执行时间为O(n2)(6)O(n)第2章线性表1.选择题babadbcabdcddac2.算法设计题(6)设计一个算法,通过一趟遍历在单链表中确定值最大的结点。
ElemType Max (LinkList L ){if(L—〉next==NULL) return NULL;pmax=L-〉next;//假定第一个结点中数据具有最大值p=L-〉next—>next;while(p != NULL ){//如果下一个结点存在if(p->data > pmax—>data) pmax=p;p=p->next;}return pmax-〉data;(7)设计一个算法,通过遍历一趟,将链表中所有结点的链接方向逆转,仍利用原表的存储空间.void inverse(LinkList &L) {// 逆置带头结点的单链表Lp=L-〉next;L->next=NULL;while (p){q=p—>next;// q指向*p的后继p->next=L—>next;L—>next=p; // *p插入在头结点之后p = q;}}(10)已知长度为n的线性表A采用顺序存储结构,请写一时间复杂度为O(n)、空间复杂度为O(1)的算法,该算法删除线性表中所有值为item的数据元素.[题目分析]在顺序存储的线性表上删除元素,通常要涉及到一系列元素的移动(删第i个元素,第i+1至第n个元素要依次前移)。
本题要求删除线性表中所有值为item的数据元素,并未要求元素间的相对位置不变。
因此可以考虑设头尾两个指针(i=1,j=n),从两端向中间移动,凡遇到值item的数据元素时,直接将右端元素左移至值为item的数据元素位置。
二路归并排序的链式实现方式
2 每 两 个 相 邻 的 有 序 序 列 合 并 成 一 个 有 序 序 列 , 并 后 ) 合 的 有序 序列 的 记 录数 是 合 并 前 两 个 相 邻 有 序 序 列 的记 录 数 之
3 如 果 第 二 个 子 表 的数 据 记 录 尚 未 归 并 完 毕 , 当 前 记 ) 且
前 记 录 的下 标 , 后 指 针 后 移 f 然
二 路 归 并 排 序 的基 本 过 程 如 下 :
1 对于 给定序列 中的每 一个记 录 , ) 被认 为是一 个有序 序
列。
2 将第 二个 子表 的当前记 录链接 在第一个 子表 当前 记录 ) 的前一个记 录之 后 。 如果第一个 子表所有记 录都 已归并 , 则转
即为我们所需的排序结果 。
2 二路 归 并排 序 的链 式 实现 方式 的思想
二 路归 并排序 的链 式实 现 方式 在 结构 上采 用 了静 态链
表 , 样 需 要 在 每 个 数 据 记 录 增 加 一 个 整 型 的 指 针 分 量 用 于 这 指 向下 一 个 记 录 的 下 标 , 将 两 个 有 序 子 区 间 合 并 成 一 个 有 在
学 习园地
微 型 电脑应 用
20 0 6年第 2 2卷第 1 2期
二 路 归 并 排 序 的链 式 实 现 方 式
张 济 础
摘 要 : 本文就《 数据 结构》 课程 中两路 归并排 序 的算 法的特点进行 了分析 , 并提 出 了一个 改进空 间复杂性和 时 间复 杂性 的
两路 归 并 排 序 的 算 法 。 关 键 词 : 并排 序 ; 法 ; 间复 杂性 ; 间复 杂性 归 算 空 时
和。 如果存 在奇数个有序序列 , 则最后一个有序 序列 不参加归 并, 但应复制 到 目标序列 。
数据结构二路归并排序代码
数据结构二路归并排序代码下面是一个使用 C++ 实现的二路归并排序的代码示例:```cpp#include <iostream>#include <vector>using namespace std;// 合并两个已排序的子数组为一个已排序的数组void merge(vector<int>& arr, vector<int>& temp, int l, int m, int r) { int n1 = m - l + 1;int n2 = r - m;// 复制数据到 temp 数组for (int i = 0; i < n1; i++)temp[i] = arr[l + i];for (int j = 0; j < n2; j++)temp[n1 + j] = arr[m + 1 + j];int i = 0, j = n1, k = l;// 合并 temp 中的两个子数组回到 arrwhile (i < n1 && j < n1 + n2) {if (temp[i] <= temp[j]) {arr[k++] = temp[i++];} else {arr[k++] = temp[j++];}}while (i < n1) {arr[k++] = temp[i++];}while (j < n1 + n2) {arr[k++] = temp[j++];}}// 二路归并排序函数void mergeSort(vector<int>& arr, vector<int>& temp, int l, int r) {if (l < r) {int m = l + (r - l) / 2;mergeSort(arr, temp, l, m);mergeSort(arr, temp, m + 1, r);merge(arr, temp, l, m, r);}}// 测试案例int main() {vector<int> arr = {12, 11, 13, 5, 6};int arr_size = arr.size();vector<int> temp(arr_size);std::cout << "排序前的数组为:\n";for (int i = 0; i < arr_size; i++)std::cout << arr[i] << " ";std::cout << "\n 执行二路归并排序...\n";mergeSort(arr, temp, 0, arr_size - 1);std::cout << "\n 排序后的数组为:\n";for (int i = 0; i < arr_size; i++)std::cout << arr[i] << " ";return 0;}```这段代码实现了二路归并排序的程序,其平均时间复杂度为 $O(nlogn)$ ,空间复杂度为 $O(n)$ 。
006402《数据结构》课程设计任务书 1
1006402《数据结构》课程设计任务书一、设计目的1.了解并掌握数据结构与算法的设计方法,具备初步的独立分析和设计能力;2.初步掌握软件开发过程的问题分析、系统设计、程序编码测试等基本方法和技能;3.提高综合运用所学的理论知识和方法独立分析和解决问题的能力;4.训练用系统的观点和软件开发一般规范进行软件开发,培养软件工作者所应具备的科学的工作方法和作风。
《数据结构》是一门实践性较强的软件基础课程,为了学好这门课程,必须在掌握理论知识的同时,加强上机实践。
本课程设计的目的就是要达到理论与实际应用相结合,使同学们能够根据数据对象的特性,学会数据组织的方法,能把现实世界中的实际问题在计算机内部表示出来,并培养基本的、良好的程序设计技能。
二、设计地点湖南城市学院实验楼计算机房407三、设计时间2012年6月4日——6月8日四、设计分组(54人)五、指导教师:陈强莫照六、设计课题:1.表达式翻译要求:编写完整程序,将不包含括号的算术中缀表达式翻译成后缀表达式.输入:中缀表达式,80个字符以内.输出:转换后的后缀表达式.要求:界面友好,函数功能要划分好2.超市选址问题设计要求:对于某一学校超市,其他各单位到其的距离不同,同时各单位人员去超市的频度也不同。
请为超市选址,要求实现总体最优。
3.串的查找和替换输入或打开一篇英文文章,在该文章中找出所有给定的单词,然后对所有给定的单词替换为另外一个单词。
4.地图着色问题设计要求:已知中国地图,对各省进行着色,要求相邻省所使用的颜色不同,并保证使用的颜色总数最少。
5.二叉排序树的实现用顺序和二叉链表作存储结构1)以回车('\n')为输入结束标志,输入数列L,生成一棵二叉排序树T;2)对二叉排序树T作中序遍历,输出结果;3)输入元素x,查找二叉排序树T,若存在含x的结点,则删除该结点,并作中序遍历(执行操作2);否则输出信息“无x”;6.二叉树的遍历问题二叉树的中序、前序、后序的递归、非递归遍历算法,层次序的非递归遍历算法的实现,应包含建树的实现。