
数理统计-回归分析
回归直线过 (0, ˆ0 ),(x, y)
两点。
10
(二) 估计量的分布及有关性质
定理7.1.1 在一元线性回归模型中,
ˆ0 与 ˆ1 是最小二乘估计量
1、ˆ1
~
N (1,
2
lxx
)
n
xi2
2、ˆ0
~
N (0 ,
i 1
nlxx
2)
3.cov(ˆ0 立
,
ˆ1
)
x lxx
2
,当x
0
时,ˆ0 与ˆ1
0.040092894 0.057263 0.040093 0.057263
RESIDUAL OUTPUT
PROBABILITY OUTPUT
观测值 预测
y 残差 标准残差
1 4.655145316 -0.72515 -0.72878
2 6.369575188 -0.40958 -0.41163
3 7.702371608 0.147628 0.148368
“回归”来源
• 统计史上归功于英国生物学家 F.Galton(1822~1911)
• 如人的身高具有一定的遗传性,当父代指标(X)增 加(减少)时,子代指标(Y)的平均值会增加(减少), 但未看到指标两极分化
• 存在一种力量把指标值“拉向中心”,子代指标 有“向中心回归”的现象
• Galton引进“回归”这个名词来描述X与Y的关 系.
0 , 1 的估计为 ˆ0 , ˆ1 ,回归方程为 yˆ ˆ0 ˆ1x
考虑⑴如何根据 (xi , yi ) i 1,2, , n 去估计 0 , 1 ;
⑵对回归方程的可信度作检验;
⑶回归方程的作用:预测,控制。
6
二、参数的最小二乘法估计 (least square estimate)(LSE)
(一) LSE的求法
n
^
n
1.准则:
( yi yi )2 ( yi 0 1xi )2
i 1
i 1
其中,
n
Q(0 , 1) ( yi 0 1xi )2 i 1
Q(ˆ0 , ˆ1) min Q(0 , 1)
(0 ,1 )
7
2.求法:
Q(0 , 1 ) 0 ,又 Q 是 0 , 1
X─自变量(一般变量,非随机变量) Y─随机变量
一、模型
①收集数据 (xi , yi ) i 1,2, , n
2
例7.1 我们知道营业税收总额与社会零售总额有关。 为了能从社会商品零售总额去预测税收总额,需要了 解两者的关系,现收集了如下几组数据(表7.1.1)
表7.1.1社会商品零售总额与税收总额 单位:亿元
随y随机x变因动素的及y趋随势x变, 动0 的其1x它部分, (r.v.)
各 (xi , yi ) 之间独立,可得一元线性回归的数学模型 :
yi 0 1xi i , i 1,2, , n
ii.i.d. ~ N (0, 2 )
5
回归函数:E( y) 0 1x 反映 y 与 x 的相关关系
代入得
ˆ1
xi yi nx y i xi2 nx 2
i
xi x yi ( xi x )2
lxy , lxx
i
i
lxy (xi x )( yi y ), lxx (xi x )2
i
i
0 , 1 得到的LSE为
ˆ1
lxy lxx
ˆ
0
y
ˆ1 x
9
回归方程有两种形式: yˆ ˆ0 ˆ1 x y ˆ1(x x)
• 统计中也沿用回归来描述变量之间的关系
1
第七章 回归分析
(analysis of regression)
§7.1 一元线性回归
有一类变量间有关系,但不能用函数形式来表示。 例如人的体重 y 与身高 x 有关,又如居民的储 蓄存款额 y 与的收入 x 有关,但同样的收入的 人储蓄存款额也不会相同。这样的变量间的关系 在统计上称为相关关系。
R Square 0.962520959
Adjusted R 0S.q9u5a7r1e6681
标准误差 1.063712271
观测值
9
方差分析
回归分析 残差 总计
df
SS
MS
F
Significance F
1 203.408 203.408 179.7711 3.01039E-06
7 7.920387 1.131484
序号
社会商品零售总额 x 营业税税收总额 y
1
142.08
3.93
2
177.30
5.96
3
204.68
7.85
4
242.88
9.82
5
316.24
12.50
6
341.99
15.55
7
332.69
15.79
8
389.29
16.39
9
45ห้องสมุดไป่ตู้.40
18.45
3
②画散点图
4
③观测散点图
如果n 个点在某直线附近波动,但不完全在一直线 上,认为 y由两部分构成,
~
N
(0
1x,[
1 n
(x
x)2 lxx
]
2
)
12
残差平方和
SE
n i1
yi
^
yi
2
定理7.1.2 在一元线性回归模型中
(1) SE 2 ~ 2 (n 2)
(2)SE 与 ˆ0 和 ˆ1 相互独立
^
(3) 2 SE n 2 是 2 无偏估计
13
回归统计
Multiple R0.981081525
4 9.561861134 0.258139 0.259433
5 13.13285987 -0.63286 -0.63603
独
11
4.yˆ ˆ0 ˆ1x 仍服从正态分布,
E( yˆ) 0 1x
D( yˆ) D(ˆ0 ) x2 D(ˆ1 ) 2x cov(ˆ0 , ˆ1 )
( 1 x 2 ) 2 x 2 1 2 2x( x ) 2
n lxx
lxx
lxx
[ 1 (x x)2 ] 2
n
lxx
yˆ
8 211.3284
Coefficients 标准误差 t Stat P-value Intercept-2.260987456 1.107344 -2.04181 0.080497
x 0.048677736 0.003631 13.40787 3.01E-06
Lower 95% Upper 95%下限 95.0上 % 限 95.0% -4.879438476 0.357464 -4.87944 0.357464
正规方程组:
Q
0
0 ˆ0
0
Q
1
1 ˆ1
0
的可微函数,有极值
2
i
( yi
ˆ0 ˆ1xi ) 0
2
( yi ˆ0 ˆ1xi )xi 0
i
nˆ0 i xi ˆ1 i yi
xi ˆ0 ˆ1
xi2
xi yi
i
i
i
8
从而 ˆ0 ˆ1x y ˆ0 y ˆ1x
概率论与数理统计-回归分析

第11章 回归分析设x 为普通变量,Y 为随机变量。
如果当x 变化时,Y 随着x 的变化大体上按某种趋势变化,则称x 与Y 之间存在相关关系,即),0(~,)(2σεεN x f Y +=例如,某地人均收入x 与某种商品的消费量Y 之间的关系;森林中树木的断面直径x 与高度Y 之间的关系;某种商品的价格x 与销售量Y 之间的关系;施用氮肥、磷肥、钾肥数量1x ,2x ,3x 与某种农作物产量Y 之间的关系。
在生产实践和科学研究中,常常有这样的问题:由实验或测量得到变量间的一批离散样点,要求由此建立变量之间的近似函数关系或得到样点之外的数据。
我们确定的函数要求在某种距离意义下的误差达到最小(通常用最小二乘法,即考虑使各数据点误差平方和最小)。
由一个(或几个)普通变量来估计或预测某个随机变量的取值时,所建立的数学模型及所进行的统计分析称为回归分析。
§11.1 一元线性回归假设有一批关于x 与Y 的离散样点),(,),,(),,(2211n n y x y x y x集中在一条直线附近,说明x 与Y 之间呈线性相关关系,即),0(~,2σεεN bx a Y ++=称为一元线性回归模型。
一、模型中的参数估计 1、b a ,的估计 首先引进记号∑∑∑∑∑=====-=-=-===ni i i xy ni i yy ni i xx ni ini iyx n y x S y n y S x n x S y n y x n x 11221221111按最小二乘法可得到xxxyS S b =ˆ x b y a ˆˆ-= 称x b a yˆˆˆ+=为Y 关于x 的一元线性回归方程。
2、2σ的估计)ˆ(21ˆ22xx yy S b S n --=σ求出关于的一元线性回归方程。
解:先画出散点图如下计算出 3985193282503.6714510======xy yy xx S S S y x n483.0ˆ==xxxyS S b 735.2ˆˆ-=-=x b y a所求的回归方程是x y483.0735.2ˆ+-=。
概率论与数理统计(回归分析)
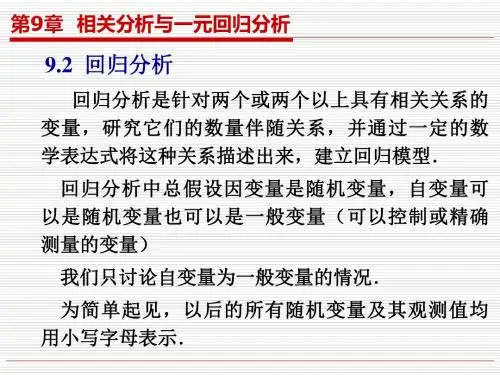
y 0 1 x , ~ N(0, 2)
由(9.1)式,不难算得y的数学期望:
(9.1)
E( y) 0 1x
(9.2)
该式表示当x已知时,可以精确地算出E(y).称方程
(9.2)为y关于x的回归方程.
现对变量x, y进行了n次独立观察,得样本(xi,yi) (i = 1,2,…,n).据(9.1)式,此样本可由方程
由 ~N(0,2)的假定,容易推出y ~N(0 + 1x, 2)
9.2 回归分析
本章主要讨论一元线性回归分析和可化为线性回 归的一元非线性回归分析.
它们是反映两个变量之间关系的简单模型,但从 中可以了解到回归分析的基本思想、方法和应用.
9.2 回归分析
9.2.1 一元线性回归分析
我们用一个例子来说明如何进行一元线性回归分 析
称(9.6)或(9.7)为正则方程.
(9.6) (9.7)
9.2.1 一元线性回归分析
1.参数0和1的最小二乘估计
解正则方程得
ˆ0
y
n
ˆ1 x
ˆ1
( xi x)( yi
i 1
n
( xi x)2
i 1
y)
l xy l xx
其中
1n x n i1 xi ,
为了研究合金钢的强度和合金中含碳量的关系, 序号专业1人员2收集3 了142组5数据6如表7 9.1所8 示9. 10 11 12
含 碳 量 0.10 0.11 0.12 0.13 0.14 0.15 0.16 0.17 0.18 0.20 0.21 0.23 x(%) 合 金 钢 42.0 43.0 45.0 45.0 45.0 47.5 49.0 53.0 50.0 55.0 55.0 60.0 的强度 y(107Pa)
概率论与数理统计(回归分析)

调整R方值 考虑到自变量数量的R方值,用 于比较不同模型之间的拟合优度。 调整R方值越接近于1,说明模型 拟合优度越好。
残差图 通过观察残差与实际观测值之间 的关系,判断模型是否符合线性 关系、是否存在异方差性等。
05
逻辑回归分析
逻辑回归模型
01
逻辑回归模型是一种用于解决 二分类问题的统计方法,基于 逻辑函数将线性回归的预测值 转换为概率形式。
多元非线性回归模型
在多个自变量X1, X2, ..., Xp的条件下,预测因变量Y的非线性数 学模型。模型形式为Y = f(β0, β1*X1, β2*X2, ... , βp*Xp),其
中f表示非线性函数。
多元逻辑回归模型
用于预测分类结果的多元回归模型,适用于因变量Y为二分 类或多分类的情况。
多重共线性问题
非线性回归模型是指因变量和自 变量之间的关系不是线性的,需 要通过变换或参数调整来拟合数 据。
形式
非线性回归模型通常采用指数函 数对数函数、多项式函数等形 式来表达。
适用范围
非线性回归模型适用于因变量和 自变量之间存在非线性关系的情 况,例如生物医学、经济学、社 会学等领域。
常用非线性回归模型
指数回归模型
线性回归模型假设因变量和自变 量之间存在一种线性关系,即当 一个自变量增加或减少时,因变 量也会以一种恒定的方式增加或 减少。
最小二乘法
01
02
03
最小二乘法是一种数学 优化技术,用于估计线
性回归模型的参数。
最小二乘法的目标是找 到一组参数,使得因变 量的观测值与预测值之
间的平方和最小。
最小二乘法的数学公式为: β=(XTX)^(-1)XTY,其中 X是自变量的数据矩阵,Y 是因变量的数据向量,β
概率论与数理统计第十章回归分析
第十章回归分析回归分析方法是数理统计中的常用方法之一,是处理多个变量之间相关关系的一种数学方法.第一节回归分析的概述在客观世界中变量之间的关系有两类,一类是确定性关系,例如欧姆定律中电压U 与电阻R、电流I之间的关系为U=IR,如果已知这三个变量中的任意两个,则另一个就可精确地求出.另一类是非确定性关系即所谓相关关系.例如,正常人的血压与年龄有一定的关系,一般来讲年龄大的人血压相对地高一些,但是年龄大小与血压高低之间的关系不能用一个确定的函数关系表达出来.又如施肥量与农作物产量之间的关系,树的高度与径粗之间的关系也是这样.另一方面,即便是具有确定关系的变量,由于试验误差的影响,其表现形式也具有某种程度的不确定性.具有相关关系的变量之间虽然具有某种不确定性,但通过对它们的不断观察,可以探索出它们之间的统计规律,回归分析就是研究这种统计规律的一种数学方法.它主要解决以下几方面问题.(1)从一组观察数据出发,确定这些变量之间的回归方程.(2)对回归方程进行假设检验.(3) 利用回归方程进行预测和控制.实用文档回归方程最简单的也是最完善的一种情况,就是线性回归方程.许多实际问题,当自变量局限于一定范围时,可以满意地取这种模型作为真实模型的近似,其误差从实用的观点看无关紧要.因此,本章重点讨论有关线性回归的问题.现在有许多数学软件如Matlab,SAS等都有非常有效的线性回归方面的计算程序,使用者只要把数据按程序要求输入到计算机,就可很快得到所要的各种计算结果和相应的图形,用起来十分方便.我们先考虑两个变量的情形.设随机变量y与x之间存在着某种相关关系.这里x是可以控制或可精确观察的变量,如在施肥量与产量的关系中,施肥量是能控制的,可以随意指定几个值x1,x2,…,x n,故可将它看成普通变量,称为自变量,而产量y是随机变量,无法预先作出产量是多少的准确判断,称为因变量.本章只讨论这种情况.由x可以在一定程度上决定y,但由x的值不能准确地确定y的值.为了研究它们的这种关系,我们对(x,y)进行一系列观测,得到一个容量为n的样本(x取一组不完全相同的值):(x1,y1),(x2,y2),…,(x n,y n),其中y i是x=x i处对随机变量y观察的结果.每对(x i,y i)在直角坐标系中对应一个点,把它们都标在平面直角坐标系中,称所得到的图为散点图.如图10-1.图10-1由图10-1a可看出散点大致地围绕一条直线散布,而图10-1b中的散点大致围绕实用文档一条抛物线散布,这就是变量间统计规律性的一种表现.如果图中的点像图10-1a中那样呈直线状,则表明y与x之间有线性相关关系,我们可建立数学模型y=a+bx+ε(10.1)来描述它们之间的关系.因为x不能严格地确定y,故带有一误差项ε,假设ε~N(0,σ2),相当于对y作这样的正态假设,对于x的每一个值有y~N(a+bx,σ2),其中未知数a,b,σ2不依赖于x,(10.1)式称为一元线性回归模型(Univariable linear regression model).在(10.1)式中,a,b,σ2是待估计参数.估计它们的最基本方法是最小二乘法,这将在下节讨论.记和是用最小二乘法获得的估计,则对于给定的x,方程ˆˆˆ=+(10.2)y a bx称为y关于x的线性回归方程或回归方程,其图形称为回归直线.(10.2)式是否真正描述了变量y与x客观存在的关系,还需进一步检验.实际问题中,随机变量y有时与多个普通变量x1,x2,…,x p(p>1)有关,可类似地建立数学模型y=b0+b1x1+…+b p x p+ε, ε~N(0,σ2),(10.3)其中b0,b1,…,b p,σ2都是与x1,x2,…,x p无关的未知参数.(10.3)式称为多元线性回归模型,和前面一个自变量的情形一样,进行n次独立观测,得样本:(x11,x12,…,x1p,y1),…,(x n1,x n2,…,x np,y n )实用文档实用文档有了这些数据之后,我们可用最小二乘法获得未知参数的最小二乘估计,记为0,1,…,p ,得多元线性回归方程ˆy =011ˆˆˆp pb b x b x +++ (10.4)同理,(10.4)式是否真正描述了变量y 与x 1,x 2,…,x p 客观存在的关系,还需进一步检验.第二节 参数估计1.一元线性回归最小二乘法是估计未知参数的一种重要方法,现用它来求一元线性回归模型(10.1)式中a 和b 的估计.最小二乘法的基本思想是:对一组观察值(x 1,y 1),(x 2,y 2),…,(x n ,y n ),使误差εi =y i -(a +bx i )的平方和Q (a , b ) =()2211n ni i i i i y a bx ε===-+⎡⎤⎣⎦∑∑ (10.5)达到最小的a 和b 作为a 和b 的估计,称其为最小二乘估计(Least squares estimates).直观地说,平面上直线很多,选取哪一条最佳呢?很自然的一个想法是,当点(x i ,y i ),i =1,2,…,n ,与某条直线的偏差平方和比它们与任何其他直线的偏差平方和都要小时,这条直线便能最佳地反映这些点的分布状况,并且可以证明,在某些假设下,和实用文档是所有线性无偏估计中最好的.根据微分学的极值原理,可将Q (a ,b )分别对a ,b 求偏导数,并令它们等于零,得到方程组:()()1120,20.ni i i ni i ii Qy a bx a Q y a bx x b==∂⎧=---=⎪∂⎪⎨∂⎪=---=⎪∂⎩∑∑ (10.6) 即112111,.n n i i i i nn ni i i i i i i na x b y x a x b x y =====⎧⎛⎫+=⎪ ⎪⎪⎝⎭⎨⎛⎫⎛⎫⎪+= ⎪ ⎪⎪⎝⎭⎝⎭⎩∑∑∑∑∑ (10.7) (10.7)式称为正规方程组.由于x i 不全相同,正规方程组的参数行列式2122111211()ninn ni i i i nni i i ii i i nxn x x n x x xx ======⎛⎫=-=- ⎪⎝⎭∑∑∑∑∑∑≠0. 故(10.7)式有惟一解11()()ˆ,()2ˆˆˆ.ni i i nii x x y y b x x ay bx ==⎧--⎪⎪=⎪⎨-⎪⎪=-⎪⎩∑∑ (10.8) 于是,所求的线性回归方程为ˆˆˆ.ya bx =+ (10.9)实用文档若将ˆˆˆay bx =-代入上式,则线性回归方程亦可表为 ˆˆ().yy b x x =+- (10.10) (10.10)式表明,对于样本观察值(x 1,y 1),(x 2,y 2),…,(x n ,y n ),回归直线通过散点图的几何中心(,x y ).回归直线是一条过点(,x y ),斜率为ˆb的直线. 上述确定回归直线所依据的原则是使所有观测数据的偏差平方和达到最小值.按照这个原理确定回归直线的方法称为最小二乘法.“二乘”是指Q 是二乘方(平方)的和.如果y 是正态变量,也可用极大似然估计法得出相同的结果.为了计算上的方便,引入下述记号:22211122211111111(),1(),1()().n n n xx i i i i i i n n nyy i i i i i i n n n n xy i i i i i i i i i i S x x x x n S y y y y n S x x y y x y x y n ==========⎧⎛⎫=-=-⎪ ⎪⎝⎭⎪⎪⎛⎫⎪=-=-⎨ ⎪⎝⎭⎪⎪⎛⎫⎛⎫⎪=--=- ⎪⎪⎪⎝⎭⎝⎭⎩∑∑∑∑∑∑∑∑∑∑ (10.11) 这样,a ,b 的估计可写成:11ˆ,11ˆˆ.xyxx n n i ii i S b S a y x b n n ==⎧=⎪⎪⎨⎛⎫⎪=- ⎪⎪⎝⎭⎩∑∑ (10.12)例10.1 某企业生产一种毛毯,1~10月份的产量x 与生产费用支出y 的统计资料如表10-1.求y 关于x 的线性回归方程.表10-1实用文档解 为求线性回归方程,将有关计算结果列表如表10-2所示表10-2S xx =1421.89-110(117.3)2=45.961,S xy =1352.15-110×117.3×112.6=31.352, ˆb = xy xxS S =0.6821, ˆa = 112.610-0.6821×117.310=3.2585,故回归方程:ˆy=3.2585+0.6821x . 2.多元线性回归多元线性回归(Multiple linear regression)分析原理与一元线性回归分析相同,但在计算上要复杂些.若(x 11,x 12,…,x 1p ,y 1),…,(x n 1,x n 2,…,x np ,y n )为一样本,根据最小二乘法原理,多元线性实用文档回归中未知参数b 0,b 1,…,b p 应满足Q =20111()ni i p ip i y b b x b x =----∑达到最小.对Q 分别关于b 0,b 1,…,b p 求偏导数,并令它们等于零,得0111001112()0,2()0,1,2,,.ni i p ip i ni i p ip ij i jQy b b x b x b Q y b b x b x x j p b ==∂⎧=-----=⎪∂⎪⎨∂⎪=-----==⎪∂⎩∑∑即01122111120111212111111120112211111,,.n n n ni i p ip i i i i i n n n n ni i i i p i ip i i i i i i i n n n n nip i ip i ip p ip ip i i i i i i b n b x b x b x y b x b x b x x b x x x y b x b x x b x x b x x y ==============⎧++++=⎪⎪⎪++++=⎪⎨⎪⎪⎪++++=⎪⎩∑∑∑∑∑∑∑∑∑∑∑∑∑∑ (10.13) (10.13)式称为正规方程组,引入矩阵X =11121212221211,1p p n n np x x x x x x xx x ⎛⎫⎪ ⎪ ⎪ ⎪ ⎪⎝⎭Y =12,n y y y ⎛⎫⎪ ⎪ ⎪⎪⎝⎭ B =01,p b b b ⎛⎫ ⎪ ⎪ ⎪ ⎪ ⎪⎝⎭ 于是(10.13)式可写成X ′XB =X ′Y . (10.13)′(10.13)′式为正规方程组的矩阵形式.若(X ′X )-1存在,则实用文档011ˆˆˆ()ˆp b b b -⎛⎫ ⎪ ⎪'= ⎪ ⎪ ⎪⎝⎭B=X X XY. (10.14) 方程011ˆˆˆˆp py b b x b x =+++为p 元线性回归方程. 例10.2 见表10-3,某一种特定的合金铸品,x 和z 表示合金中所含的A 及B 两种元素的百分数,现x 及z 各选4种,共有4×4=16种不同组合,y 表示各种不同成分的铸品数,根据表中资料求二元线性回归方程.表10-3解 由(10.13)式,根据表中数据,得正规方程组0120120121620040560,20030005006110,405001201580.b b b b b b b b b ++=⎧⎪++=⎨⎪++=⎩ 解 之得:b 0=34.75, b 1=-1.78,b 2=9. 于是所求回归方程为:y =34.75-1.78x +9z .实用文档第三节 假设检验用最小二乘法求出的回归直线并不需要y 与x 一定具有线性相关关系.从上述求回归直线的过程看,对任何一组试验数据(x i ,y i )(i =1,2,…,n )都可用最小二乘法形式地求出一条y 关于x 的回归直线.若y 与x 间不存在某种线性相关关系,那么这种直线是没有意义的,这就需要对y 与x 的线性回归方程进行假设检验,即检验x 的变化对变量y 的影响是否显著.这个问题可利用线性相关的显著性检验来解决.因为当且仅当b ≠0时,变量y 与x 之间存在线性相关关系.因此我们需要检验假设:H 0:b =0;H 1:b ≠0 (10.15)若拒绝H 0,则认为y 与x 之间存在线性关系,所求得的线性回归方程有意义;若接受H 0,则认为y 与x 的关系不能用一元线性回归模型来表示,所求得的线性回归方程无意义.关于上述假设的检验,我们介绍3种常用的检验法.1.方差分析法(F 检验法)当x 取值x 1,x 2,…,x n 时,得y 的一组观测值y 1,y 2,…,y n ,Q 总=S yy =21()ni i y y =-∑称为y 1,y 2,…,y n 的总偏差平方和(Total sum of squares),它的大小反映了观测值实用文档y 1,y 2,…,y n 的分散程度.对Q 总进行分析:Q 总=[]2211ˆˆ()()()n ni i i i i i y y y yy y ==-=-+-∑∑ =2211ˆ()()n niiii i y yy y ==-+-∑∑=Q 剩+Q 回, (10.16)其中Q 剩=21ˆ()ni i i y y=-∑, Q 回=2222111ˆˆˆˆˆˆ()()()().n nni i ii i i y y a bx a bx bx x ===⎡⎤-=+-+=-⎣⎦∑∑∑Q 剩称为剩余平方和(Residual sum of squares),它反映了观测值y i 偏离回归直线的程度,这种偏离是由试验误差及其他未加控制的因素引起的.可证明2ˆ2Q n σ=-剩是σ2的无偏估计.Q 回为回归平方和(Regression sum of squares),它反映了回归值ˆi y(i =1,2,…,n )的分散程度,它的分散性是因x 的变化而引起的.并通过x 对y 的线性影响反映出来.因此1,2,…,n 的分散性来源于x 1,x 2,…,x n 的分散性.通过对Q 剩、Q 回的分析,y 1,y 2,…,y n 的分散程度Q 总的两种影响可以从数量上区分开来.因而Q 回与Q 剩的比值反映了这种线性相关关系与随机因素对y 的影响的大小;比值越大,线性相关性越强.可证明统计量实用文档F =012~H Q Q n -真剩回F (1,n -2) (10.17)给定显著性水平α,若F ≥F α,则拒绝假设H 0,即认为在显著性水平α下,y 对x 的线性相关关系是显著的.反之,则认为y 对x 没有线性相关关系,即所求线性回归方程无实际意义.检验时,可使用方差分析表10-4.表10-4方差来源 平方和 自由度 均方 F 比回归 剩余 Q 回 Q 剩 1n -2 Q 回/1Q 剩/(n -2)F=(2)Q Q n -回剩总计 Q 总n -1其中:⎪⎩⎪⎨⎧-=-===-=∑=.,ˆ)ˆ(212222xx xy yy ni xx xy xx i S S S Q Q Q S S S b y y Q 回总剩 (10.18)例10.3 在显著性水平α=0.05,检验例10.1中的回归效果是否显著? 解 由例10.1知S xx =45.961, S xy =31.352, S yy =22.124, Q 回=S xy 2/S xx =21.3866, Q 剩=Q 总-Q 回=22.124-21.3866=0.7374,实用文档F =2Q Q n -剩回=232.0102>F 0.05(1,8)=5.32. 故拒绝H 0,即两变量的线性相关关系是显著的.2.相关系数法(t 检验法)为了检验线性回归直线是否显著,还可用x 与y 之间的相关系数来检验.相关系数的定义是:r =xy xx yyS S S ⋅. (10.19)由于Q 回/Q 总=2xy xx yyS S S =r 2(|r |≤1), ˆxy xxS b S =,则r =ˆxx xx yyS S .显然r 和ˆb的符号是一致的,它的值反映了x 和y 的内在联系. 提出检验假设: H 0: r =0; H 1: r ≠0. (10.20) 可以证明,当H 0为真时,t =221r n r-- ~t (n -2). (10.21)故H 0的拒绝域为t ≥t α/2(n -2) (10.22)由上例的数据可算出实用文档r =xx yyS S S =0.9832,t =221r n r-- =15.2319>t 0.025(8)=2.3060.故拒绝H 0,即两变量的线性相关性显著.在一元线性回归预测中,相关系数检验,F 检验法等价,在实际中只需作其中一种检验即可.与一元线性回归显著性检验原理相同,为考察多元线性回归这一假定是否符合实际观察结果,还需进行以下假设检验:H 0: b 1=b 2=…=b p =0; H 1: b i 不全为零.可以证明统计量F =01~H UQp n p --真F (p ,n -p -1).其中 U =Y ′X (X ′X )-1X ′Y -n 2ˆy, Q =Y ′Y -Y ′X (X ′X )-1X ′Y . 给定水平α,若F ≥F α,则拒绝H 0.即认为回归效果是显著的.第四节 预测与控制1.预测由于x 与y 并非确定性关系,因此对于任意给定的x =x 0,无法精确知道相应的y 0实用文档值,但可由回归方程计算出一个回归值0ˆy=ˆb +x 0,可以以一定的置信度预测对应的y 的观察值的取值范围,也即对y 0作区间估计,即对于给定的置信度1-α,求出y 0的置信区间(称为预测区间(Prediction interval)),这就是所谓的预测问题.对于给定的置信度1-α,可证明y 0的1-α预测区间为2200()1ˆˆ(2)1.xx x x y t n n S ασ⎛⎫-±-++ ⎪ ⎪⎝⎭(10.24)给定样本观察值,作出曲线22201202()1ˆˆ()()(2)1,()1ˆˆ()()(2)1.xxxxx x y x yx t n n S x x y x y x t n n S αασσ⎧-=--++⎪⎪⎨-⎪=+-++⎪⎩(10.25)这两条曲线形成包含回归直线=+x 的带形域,如图10-2所示,这一带形域在x =x 处最窄,说明越靠近,预测就越精确.而当x 0远离时,置信区域逐渐加宽,此时精度逐渐下降.在实际的回归问题中,若样本容量n 很大,在附近的x 可得到较短的预测区间,又可简化计算20()11xxx x n S -++≈1,2(2)t n α-≈2z α,图10-2故y 0的置信度为1-α的预测区间近似地等于实用文档()22ˆˆˆˆ,.y z y z αασσ-+(10.26)特别地,取1-α=0.95,y 0的置信度为0.95的预测区间为()00ˆˆˆˆ1.96, 1.96yy σσ-+ 取1-α=0.997,y 0的置信度为0.997的预测区间为()00ˆˆˆˆ2.97, 2.97yy σσ-+图10-3可以预料,在全部可能出现的y 值中,大约有99.7%的观测点落在直线L 1:y =ˆa-2.97ˆσ+ˆb x 与直线L 2:y =ˆa +2.97ˆσ+ˆb x 所夹的带形区域内.如图10-3所示. 可见,预测区间意义与置信区间的意义相似,只是后者对未知参数而言,前者是对随机变量而言.例10.4 给定α=0.05,x 0=13.5,问例10.1中生产费用将会在什么范围. 解 当x 0=13.5,y 0的预测值为:0ˆy=3.2585+0.6821×13.5=12.4674给定α=0.05,t 0.025(8)=2.306,21ˆ()0.7374ˆ28niii y yn σ=-==-∑=0.3036, 220()11(13.511.73)111045.961xx x x n S --++=++=1.0808,故实用文档220()1ˆ(2)1xxx x t n n S ασ--++=2.306×0.3036×1.0808=0.7567.即y 0将以95%的概率落在(12.4674±0.7567)区间,即预报生产费用在(11.7107,13.2241)万元之间.2.控制控制实际上是预测的反问题,即要求观察值y 在一定范围内y1<y <y 2内取值,应考虑把自变量x 控制在什么范围,即对于给定的置信度1-α,求出相应的x 1,x 2,使x 1<x <x 2时,x 所对应的观察值y 落在(y 1′,y 2′)之内的概率不小于1-α.当n 很大时,从方程222212ˆˆˆˆˆ,ˆˆˆˆˆ.y y z a bx z y y z a bx z αααασσσσ⎧=-=+-⎪⎨=+=++⎪⎩ (10.27) 分别解出x 来作为控制x 的上、下限:221122ˆˆˆ(),ˆˆˆ().x y a z b x y a z bαασσ⎧=-+⎪⎨=--⎪⎩ (10.28)当ˆb>0时,控制区间为(x 1,x 2);当ˆb <0时,控制区间为(x 2,x 1).如图10-4,图10-4注意,为了实现控制,我们必须使区间(y 1,y 2)的长度不小于22z ασ,即:实用文档y 2-y 1>2σ2z α.第五节 非线性回归的线性化处理前面讨论了线性回归问题,对线性情形我们有了一整套的理论与方法.在实际中常会遇见更为复杂的非线性回归问题,此时一般是采用变量代换法将非线性模型线性化,再按照线性回归方法进行处理.举例如下:模型 y =a +b sin t +ε, ε~N (0,σ2), (10.29) 其中a ,b ,σ2为与t 无关的未知参数,只要令x =sin t ,即可将(10.29)化为(10.1).模型 y =a +bt +ct 2+ε, ε~N (0,σ2), (10.30) 其中a ,b ,c ,σ2为与t 无关的未知参数.令x 1=t ,x 2=t 2,得y =a +bx 1+cx 2+ε, ε~N (0,σ2), (10.31)它为多元线性回归的情形.模型1y=a +b /x +ε, ε~N (0,σ2), 令y ′=1y , x ′=1x,则有 y ′=a +bx ′+ε,ε~N (0,σ2), 化为(10.1)式.模型 y =a +b ln x +ε, ε~N (0,σ2),令x ′=ln x ,则有 y =a +bx ′+ε,ε~N (0,σ2), 又可化为(10.1)式.另外,还有下述模型Q(y)=a+bx+ε, ε~N(0,σ2),其中Q为已知函数,且设Q(y)存在单值的反函数,a,b,σ2为与x无关的未知参数.这时,令z=Q(y),得z=a+bx+ε, ε~N(0,σ2).在求得z的回归方程和预测区间后,再按z=Q(y)的逆变换,变回原变量y.我们就分别称它们为关于y的回归方程和预测区间.此时y的回归方程的图形是曲线,故又称为曲线回归方程.例10.5某钢厂出钢时所用的盛钢水的钢包,由于钢水对耐火材料的侵蚀,容积不断扩大.通过试验,得到了使用次数x和钢包增大的容积y之间的17组数据如表10-5,求使用次数x与增大容积y的回归方程.表10-5实用文档解散点图如图10-5.看起来y与x呈倒指数关系ln y=a+b1x +ε,记y′=ln y,1xx'=,求出x′,y′的值(表10-6).表10-6作(x′,y′)的散点图,如图10-6.实用文档实用文档图10-5 图10-6可见各点基本上在一直线上,故可设y ′=a +bx ′+ε,ε~(0,σ2),经计算,得x '=0.1464, y '=2.2963,21()nii x ='∑=0.5902,21()nii y ='∑=89.9311,1niii x y =''∑=5.4627.ˆb=-1.1183, ˆa =2.4600. 于是x ′对于y ′的线性回归方程为y ′=-1.1183x ′+2.4600,换回原变量得1.1183ˆ11.7046xy-=e .现对x ′与y ′的线性相关关系的显著性用F 检验法进行检验,得F (1,15)=379.3115>F 0.01(1,15)=8.68.实用文档检验结论表明,此线性回归方程的效果是显著的.小 结本章介绍了在实际中应用非常广泛的数理统计方法之一——回归分析,并对线性回归作了参数估计、相关性检验、预测与控制及非线性回归的线性化处理.1. 一元线性回归模型y =a +bx +ε的最小二乘估计为ˆˆˆ,xy xxS ba y xb S ==-. 其中 11n i i x x n ==∑, 11ni i y y n ==∑, S xx =221ni i y ny =-∑,S xy =1ni i i x y nxy =-∑, S yy =221ni i y ny =-∑.2. 变量y 与x 的线性相关性假设检验有: (1) 方差分析法(F 检验法)H 0: b =0; H 1: b ≠0. F =02~H Q Q n -真剩回F α(1,n -2).其中Q 回=S xy 2/S xx , Q 剩=Q 总-Q 回=S yy -S xy 2/S xx .给定显著性水平α,若F ≥F α,则拒绝H 0,即认为y 对x 具有线性相关关系.(2) 相关系数法(t 检验法)实用文档H 0: r =0; H 1: r ≠0.其中r =xx yyS S S , t =0222(2)1~H r n tn rα---真.若t ≥2(2)t n α-则拒绝H 0.即认为两变量的线性相关性显著.3. 给定x =x 0时,y 的置信水平为1-α的预测区间2200()1ˆˆˆ(2)1xxx x abx t n n S ασ⎛⎫-+±-++ ⎪ ⎪⎝⎭. 重要术语及主题线性回归,最小二乘估计,预测与控制,非线性回归.习 题 十1.在硝酸钠(NaNO 3)的溶解度试验中,测得在不同温度x (℃)下,溶解于100份水中的硝酸钠份数y 的数据如下,试求y 关于x 的线性回归方程.x i 0 4 10 15 21 29 36 51 68 y i66.7 71.0 76.3 80.6 85.7 92.9 99.4 113.6 125.12.测量了9对父子的身高,所得数据如下(单位:英寸). 父亲身高x i 60 62 64 66 67 68 70 72 74 儿子身高y i63.6 65.2 66 66.9 67.1 67.4 68.3 70.1 70求(1) 儿子身高y 关于父亲身高x 的回归方程.(2)取α=0.05,检验儿子的身高y与父亲身高x之间的线性相关关系是否显著.(3)若父亲身高70英寸,求其儿子的身高的置信度为95%的预测区间.3.随机抽取了10个家庭,调查了他们的家庭月收入x(单位:百元)和月支出y(单位:百元),记录于下表:求:(1)在直角坐标系下作x与y的散点图,判断y与x是否存在线性关系.(2)求y与x的一元线性回归方程.(3)对所得的回归方程作显著性检验.(α=0.025)4.设y为树干的体积,x1为离地面一定高度的树干直径,x2为树干高度,一共测量了31棵树,数据列于下表,作出y对x1,x2的二元线性回归方程,以便能用简单分法从x1和x2估计一棵树的体积,进而估计一片森林的木材储量.实用文档5.一家从事市场研究的公司,希望能预测每日出版的报纸在各种不同居民区内的周末发行量,两个独立变量,即总零售额和人口密度被选作自变量.由n=25个居民区组成的随机样本所给出的结果列表如下,求日报周末发行量y关于总零售额x1和人口密度x2的线性回归方程.实用文档实用文档实用文档6.一种合金在某种添加剂的不同浓度之下,各做3次试验,得数据如下:(1) 作散点图.(2) 以模型y =b 0+b 1x 1+b 2x 2+ε,ε~N (0,σ2)拟合数据,其中b 0,b 1,b 2,σ2与x 无关,求回归方程ˆy =0ˆb +1ˆb x +2ˆb x 2.。
回归分析法精选全文
可编辑修改精选全文完整版回归分析法用相关系来表示变量x和y线性相关密切程度,那么r数值为多大时才能说明它们之间线性关系是密切的?这需要数理统计中的显著性检验给予证明。
三、显著性检验是来用以说明变量之间线性相关的密切程度如何,或是用以说明所求得的回归模型有无实用价值。
为说明相关系数的概念,先观察图2-3。
回归分析的检验包括:相关系数的显著性检验、回归方程的显著性检验、回归系数的显著性检等,它们是从不同角度对回归方程的预测效能进行验证的。
关于显著性检验这涉及有关数理统计的内容,为此我们作一下简要回顾。
数理统计的主要内容包括:·参数估计;·假设检验;·方差分析等。
(1)相关系数检验。
相关系数的检验,需要借助于相关系数检验表来进行,这种表是统计学家按照有关的数学理论制定出的。
在相关系数检验表中,有两个参数需要说明。
1)f —称为自由度。
其含义为:如果有n个变量 x1,x2,...x n相互独立,且无任何线性约束条件,则变量的自由度个数为 f=n ,一般情况下有:f=n —约束条件式数对于一元线性回归,参数a,b要通过观测数据求出,有两个约束式,则失去两个自由度,因此 f=n-2 ,n为散点(观测点或统计数据点)个数。
2) a —称为显著性水平。
取值为0.01或0.05。
而1-a 称为置信度或置信概率,即表示对某种结论的可信程度。
当 a 取值为0.05时,则1-a 为0.95,这表示在100次试验中,约有5次犯错误(小概率事件发生)。
判断两个随机变量x,y间有无线性相关关系的方法是:首先根据要求确定某一显著性水平 a ,由散点数n计算出 f ,然后根据 a , f 利用相关系数检验表查出相关系数的临界值 r a,最后将计算出的相关系数r的绝对值与临界值 r a相比较。
r a表示在一定的置信概率下,所要求的相关系数起码值。
若,表示这两个随机变量之间存在线性相关关系;若,表示这两个随机变量之间线性相关程度不够密切。
《数理统计》第五章回归分析

随机性的一种“趋势”。即对自变量x的同一值, 在不同的观测中,因变量Y可以取不同的值,而 且取值是随机的,但对应x在一定范围的不同值, 对Y进行观测时,可以观察到Y随x的变化而呈现 有一定趋势的变化。
如:身高与体重,不存在这样的函数可以由
身高计算出体重,但从统计意义上来说,身高者,
体也重。
再如:父亲的身高与儿子的身高之间也有一
在误差为正态分布假定下,最小二乘估计等价于 极大似然估计。
事实上,似然函数
La,b 1
22
n 2exp 12i n1yiabxi2
n
对 La,b最 大 化 等 价 于 对 yi abxi2 i1
最 小 化 , 即 最 小 二 乘 估 计 。
10
a ,b 的 最 小 二 乘 估 计 : a ˆ y x b ˆ ,b ˆ S x y /S x x .
定联系,通常父亲高,儿子也高。
回归分析——研究相关性关系的最基本,应用最
广泛的方法。
3
(一)一元线性回归
设 随 机 变 量 Y与 x之 间 存 在 某 种 相 关 关 系 。 这 里 , x是 可 以 控 制 或 精 确 观 测 的 变 量 ( 不 是 随 机 变 量 ) , 如 年 龄 、 试 验 时 的 温 度 、 施 加 的 压 力 、 电 压 与 时 间 等 。
4
在实际问题中,回归函数μ(x)一般是未知的, 需要根据试验数据去估计。
对 于 x取 定 一 组 不 完 全 相 同 的 值 x1,x2,...,xn,设 分 别 在 xi处 对 Y作 独 立 观 察 得 到 样 本 (xi,Yi), i1,2,...,n, 对 应 的 样 本 观 察 值 (x1,y1),(x2,y2),...,(xn,yn).
数理统计CH回归分析课件
2024/10/4
21
回归最小二乘估计
(2)最小二乘思想
n
n
| i |
2 i
i 1
i 1
残差计算:
yi a bxi i
i yi a bxi
➢用残差(误差)平 方和代表试验点与 回归直线旳总距离
2024/10/4
➢回归方程旳最小二乘
估计可归结为求解下
面旳优化模型:
n
Min a,b
n i 1
yi
a
bxi
2
n i 1
b
yi a bxi
2
n
2 yi a bxi xi i 1
2024/10/4
24
回归最小二乘估计
(3)回归最小二乘估计
x
1 n
n i 1
xi
y
1 n
n i 1
yi
Q 0 a aˆ,b bˆ a
n
即 2 yi aˆ bˆxi 0 i 1
2024/10/4
40
回归明显性检验
(3)模型和假设
线性回归模型 线性有关假设
➢由线性回归模型可推论:
E yi E a bxi i a bxi
Var yi Var a bxi i Var i 2
2024/10/4
10
7.2 一元线性回归
(1)案例和问题
x称作自变量 y称作响应变量
案例:某特种钢抗拉强度试 抗拉强度试验成果 验,控制某稀有金属含量x
x(%) y(MPa) 测得不同抗拉强度y,试验
2.07 128 成果如表所示。
3.10 194 4.14 273 5.17 372 6.20 454
yi
数理统计中的回归分析与方差分析
数理统计中的回归分析与方差分析回归分析是数理统计中常用的一种分析方法,旨在研究两个或多个变量之间的关系,并通过建立回归模型来预测或解释因变量的值。
方差分析则是一种用于比较两个或多个样本均值之间差异的统计方法。
本文将详细介绍回归分析和方差分析的原理和应用。
一、回归分析回归分析是研究自变量与因变量之间的关系的统计方法。
在回归分析中,我们通常通过建立回归模型来描述自变量与因变量之间的线性关系。
回归模型可以用以下一般形式表示:Y = β0 + β1X1 + β2X2 + ... + βnXn + ε其中,Y表示因变量,X1、X2、...、Xn表示自变量,β0、β1、β2、...、βn表示回归系数,ε表示误差项。
回归分析可以分为简单线性回归和多元线性回归两种类型。
简单线性回归是指只有一个自变量的情况,多元线性回归是指有两个或多个自变量的情况。
回归分析的应用十分广泛。
例如,在经济学领域,回归分析可以用来研究GDP与消费水平之间的关系;在医学研究中,回归分析可以用来预测某种疾病的发生率与患者年龄的相关性。
通过回归分析,我们可以得到回归系数的估计值,并检验各个回归系数是否显著。
二、方差分析方差分析是一种用于比较两个或多个样本均值之间差异的统计方法。
方差分析的基本思想是将总体方差分解为组间方差和组内方差两部分,通过检验组间方差和组内方差的比值来确定多个样本均值是否有显著差异。
在方差分析中,我们通常将数据分为一个因变量和一个或多个自变量。
其中,因变量是我们希望比较的量,自变量则是影响因变量的因素。
方差分析可以用于不同条件下的均值比较,例如,不同药物对治疗效果的比较、不同肥料对农作物产量的影响等。
方差分析可以分为单因素方差分析和多因素方差分析。
单因素方差分析是指只有一个自变量的情况,多因素方差分析是指有两个或多个自变量的情况。
方差分析的结果通常可以通过F检验来判断是否存在显著差异。
如果F值大于临界值,就说明组间存在显著差异。
数理统计CH回归分析00002
试验观测记作x和y 预测变量记作x0和yˆ0
yˆ 0 aˆ bˆx 0 点预测公式
yˆ 0
y
1 n
bˆ x y
bˆx 0 y bˆ x x 0
x x
SSx
y
x
x0
bˆ
x x y
SSx
y
1 n
x
x
x
y
1 n
x
x0 SSx
2
2
Eyˆ0 E aˆ bˆx0
a bx0
山西农业大学
应用数理统计 第7章
6
7.2.3 回归预测 响应模型 y0 a bx0 e
(4)响应统计量分布 E y0 a bx0
y0~Nabx0,2 Var y0 Var e 2
山西农业大学
应用数理统计 第7章
15
7.2.4 可线性化非线性回归
(1)问题的提出
0<R<1
变量y与x不线性相关 但可能非线性相关
R=0
R=0
R=0
山西农业大学
应用数理统计 第7章
16
7.2.4 可线性化非线性回归
(1)问题的提出
变量y与x是非线性相 关做线性回归无意义
试验观测本是非线性相关,虽然也能拟 合一条直线(线性回归),但对变量间关系的 描述是错误的,用于预测将会导致有害的结 论。因此,对于具有非线性相关趋势的试验 观测,应在其散点图的点云“中间”拟合一 条曲线(非线性回归),该曲线方程的参数应 使残差平方和达最小,即曲线与试验观测点 的总距离为最小,用最小二乘法解决问题。
第四章回归分析-数理统计汇总
而且b偏离0越远,即b的绝对值越大,F也越大. • 相关性检验的一般程序: (1)计算SR,SE,再计算F; (2)对于给定的显著性水平α,查Fα(1,n-2); (3)若F> Fα(1,n-2),则否定H0:b=0,即认为x与Y之间具 有线性相关关系;否则,就认为x与Y之间不具有线性 相关关系.
试作出期末分数与期中分数的回归方程.并作线 性相关性检验.
• 解:为了简化计算,令
x x 400, y y 480,得
编号 1 2 3 4 5 6 7 合计
x -40 -80 0 -28 -100 115 205 72 y -50 -39 2 -100 -27 33 130 -51 xy 2000 3120 0 2800 2700 3795 26650 41065
7
xt)(
t 1
yt)
41589.571
bˆ Sxy 0.57 Sxx
aˆ y bˆx 13.12
§1.2 经验公式与最小二乘法
• 设给定n个点 (x1,y1),(x2,y2),……,(xn,yn)
那么对于平面上任意一条直线l: y=a+bx
• 我们用数量 [yt-(a+bxt)]2
来刻画点(xt,yt)到直线l的远近程度(利用解析几何知 识不难看出,|yt-(a+bxt)|的几何意义是点(xt,yt)沿着 平行于y轴的方向到l的最短距离,而不是沿着垂直于l 的方向到l的最短距离).
计算得:
7
(xt)2 74034
t 1
7
( yt)2 32743
t 1
Sxx
S xx
7 t 1
( xt ) 2