
建模基本步骤与非线性回归分析
第二讲建模基本步骤和非线性回归分析
建模基本步骤
用一个例子来讲解建模的基本步骤和软件的基本操作。
例:下表是1950—1987年间美国机动车汽油消费量和影响消费量的变量数值。
各变量表示:QMG—机动车汽油消费量,CAR—汽车保有量,PMG—汽油价格,POP—人口数,RGNP—按1982年美元计算的国民生产总值,PGNP—GNP 指数(1982年为100)。
以汽油消费量为因变量,其他为自变量,建立回归模型。
一数据的预处理
预处理是指在正式建模之前运用一些初等方法探讨变量之间的关系,为正式建模做些准备。
常用的预处理方法包括绘制动态曲线、绘制散点图、计算变量之间的相关系数等。
二最小二乘估计
三各统计量的解释
四预测
预测是建模的目的之一,预测效果的好坏也是评价模型优劣的标准之一。
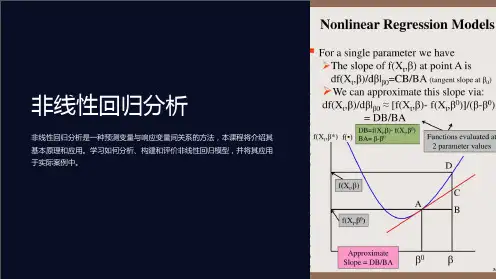
非线性回归分析
非线性模型指的是关于参数或自变量是非线性函数的模型。
在某些情形,可以通过一定的线性变化将这些非线性模型作为线性模型处理。
这类模型称为可线性化的非线性模型。
但并不是所有的非线性模型都可做线性化处理,对这类模型怎样分析和估计呢?
无法线性化模型的一般形式为:(,)
f x是非线性函数。
y f x。
其中(,)
需要说明:上述函数的误差为加性误差,即在非线性函数后加上一个误差,这不是说所有非线性模型的误差都以加性误差形式出现,一些可线性化的模型采用了乘性误差,或其他误差形式。
比如CD生产函数的两种设法:
Y AK L e
Y AK L
非线性最小二乘法(NLS)是非线性模型的常用估计方法。
这个方法的Eviews操作与普通最小二乘法基本相同,只是在方程估计窗口或命令行中,模型必须以方程式的形式出现,没有简化形式。
在这个估计中还要注意初始值的设置。
初始值是Eviews进行第一次迭代计算时参数所取的数值,这个值保存在于回归函数有关的系数向量中。
有时回归函数必须定义
初始值。
在NLS中,Eviews用开始估计的系数向量中对应的值作为初始值。
《非线性回归分析》课件
封装式
• 基于模型的错误率和复 杂性进行特征选择。
• 常用的封装方法包括递 归特征消除法和遗传算 法等。
嵌入式
• 特征选择和模型训练同 时进行。
• 与算法结合在一起的特 征选择方法,例如正则 化(Lasso、Ridge)。
数据处理方法:缺失值填充、异常值 处理等
1
网格搜索
通过预定义的参数空间中的方格进行搜
随机搜索
2
索。
在预定义的参数空间中进行随机搜索。
3
贝叶斯调参
使用贝叶斯优化方法对超参数进行优化。
集成学习在非线性回归中的应用
集成学习是一种将若干个基学习器集成在一起以获得更好分类效果的方法,也可以用于非线性回归建模中。
1 堆叠
使用多层模型来组成一个 超级学习器,每个模型继 承前一模型的输出做为自 己的输入。
不可避免地存在数据缺失、异常值等问题,需要使用相应的方法对其进行处理。这是非线性回归 分析中至关重要的一环。
1 缺失值填充
常见的方法包括插值法、代入法和主成分分析等。
2 异常值处理
常见的方法包括删除、截尾、平滑等。
3 特征缩放和标准化
为了提高模型的计算速度和准确性,需要对特征进行缩放和标准化。
偏差-方差平衡与模型复杂度
一种广泛用于图像识别和计算机 视觉领域的神经网络。
循环神经网络
一种用于处理序列数据的神经网 络,如自然语言处理。
sklearn库在非线性回归中的应用
scikit-learn是Python中最受欢迎的机器学习库之一,可以用于非线性回归的建模、评估和调参。
1 模型建立
scikit-learn提供各种非线 性回归算法的实现,如 KNN回归、决策树回归和 支持向量机回归等。
数学建模之回归分析

实际帐目数——x2 同类商品竞争数——x3 地区销售潜力——x4
第二十九页,共56页。
X= x1
11
5.5
2
2.5
31
8.0
41
3.0
51
3.0
6
2.9
7.
8.0
8.
9.0
9 10
.
4.0 6.5
11 1
5.5
12 13
1
5.0 6.0
14 1
5.0
15 16
1
3.5 8.0
17 1
问题分析:
钢材消费量--------试验指标(因变量)Y; 国民收入-----------自变量 x;
建立数据拟合函数 y = E(Y | x)= f(x); 作拟合曲线图形分析。
第四页,共56页。
y=a+bx
钢材消费量y与国民收入x的散点图
第五页,共56页。
回归分析是研究变量间相关关系的一种统计分析。
输入:[Y,delta]=polyconf(p,x,S);Y
结果: Y= 22.5243
28.3186 27.0450 22.5243 26.0582 27.0450 24.1689
26.0582 24.1689 27.9896 19.6904
27.9896 19.6904 28.3186
拟合效果图:
假设:
1、因变量Y是随机变量,并且它服从正态分布; 2、f(x1,x2,x3,x4)是线性函数(非线性);
模型: Y 0 1 x1 2 x2 3 x3 4 x4 ~ N (0, 2 )
第三十一页,共56页。
知识介绍
2、多元线性回归模型
非线性回归分析的入门知识

非线性回归分析的入门知识在统计学和机器学习领域,回归分析是一种重要的数据分析方法,用于研究自变量和因变量之间的关系。
在实际问题中,很多情况下自变量和因变量之间的关系并不是简单的线性关系,而是呈现出一种复杂的非线性关系。
因此,非线性回归分析就应运而生,用于描述和预测这种非线性关系。
本文将介绍非线性回归分析的入门知识,包括非线性回归模型的基本概念、常见的非线性回归模型以及参数估计方法等内容。
一、非线性回归模型的基本概念在回归分析中,线性回归模型是最简单和最常用的模型之一,其数学表达式为:$$Y = \beta_0 + \beta_1X_1 + \beta_2X_2 + ... + \beta_pX_p +\varepsilon$$其中,$Y$表示因变量,$X_1, X_2, ..., X_p$表示自变量,$\beta_0, \beta_1, \beta_2, ..., \beta_p$表示模型的参数,$\varepsilon$表示误差项。
线性回归模型的关键特点是因变量$Y$与自变量$X$之间呈线性关系。
而非线性回归模型则允许因变量$Y$与自变量$X$之间呈现非线性关系,其数学表达式可以是各种形式的非线性函数,例如指数函数、对数函数、多项式函数等。
一般来说,非线性回归模型可以表示为:$$Y = f(X, \beta) + \varepsilon$$其中,$f(X, \beta)$表示非线性函数,$\beta$表示模型的参数。
非线性回归模型的关键在于确定合适的非线性函数形式$f(X,\beta)$以及估计参数$\beta$。
二、常见的非线性回归模型1. 多项式回归模型多项式回归模型是一种简单且常见的非线性回归模型,其形式为: $$Y = \beta_0 + \beta_1X + \beta_2X^2 + ... + \beta_nX^n +\varepsilon$$其中,$X^2, X^3, ..., X^n$表示自变量$X$的高次项,$\beta_0, \beta_1, \beta_2, ..., \beta_n$表示模型的参数。
回归分析非线性回归
回归分析非线性回归回归分析是用于探究自变量和因变量之间关系的一种统计方法,在实际应用中,所研究的问题往往并不是简单地呈线性关系。
为了更准确地描述变量之间的复杂关系,我们需要使用非线性回归模型。
非线性回归指的是自变量与因变量之间的关系不是简单的线性关系,而是可以用其他非线性函数更好地拟合的情况。
这样的非线性函数可以是多项式函数、指数函数、对数函数等等。
非线性回归可以更好地反映实际问题的实际情况,并且通常能够提供更准确的预测结果。
在非线性回归分析中,我们需要确定非线性函数的形式以及确定函数中的参数。
对于确定非线性函数的形式,一般来说,可以通过观察数据的散点图、经验和理论分析来选择。
根据选择的非线性函数形式,我们可以使用最小二乘法等方法来确定函数中的参数。
以一个简单的例子来说明非线性回归的具体步骤。
假设我们想要研究一个人的年龄和体重之间的关系,我们可以选择一个二次多项式模型来描述这个关系。
我们的非线性回归模型可以写作:体重=β₀+β₁×年龄+β₂×年龄²+ε其中,体重是因变量,年龄是自变量,ε是误差项。
我们的目标是确定模型中的参数β₀、β₁和β₂的值,使得模型最好地拟合观察到的数据。
为了实现这个目标,我们可以使用最小二乘法来估计参数的值。
最小二乘法是一种常用的参数估计方法,它通过最小化观测值与模型预测值之间的离差平方和来确定参数的值。
通过最小二乘法估计出的参数值,可以用于建立非线性回归模型,从而对未来的数据进行预测。
除了使用最小二乘法估计参数值之外,我们还可以使用其他的优化算法如牛顿法或梯度下降法来估计参数的值。
这些方法的选择通常取决于模型形式的复杂程度、参数数量以及数据量等因素。
需要注意的是,非线性回归模型的参数估计和预测结果都受到初始值的选择和模型形式的选择的影响。
因此,在进行非线性回归分析时,我们需要注意选择合适的初始值和合适的模型形式,以获得更准确的结果。
在实际应用中,非线性回归可以用于多个领域,比如医学、经济学、工程学等。
非线性回归模型的拟合与评估

非线性回归模型的拟合与评估非线性回归是统计学中常用的一种回归分析方法,用于描述自变量与因变量之间的非线性关系。
本文将介绍非线性回归模型的拟合与评估方法。
一、非线性回归模型的拟合方法1. 数据收集与准备拟合非线性回归模型首先需要收集与问题相关的数据。
数据的准备包括数据清洗、变量选择和数据变换等步骤,以确保数据的质量和适应非线性回归模型的要求。
2. 模型选择在准备好数据后,需要选择适合问题的非线性回归模型。
常见的非线性回归模型包括多项式回归模型、指数回归模型、对数回归模型等。
选择合适的模型需要根据问题的特点和理论的支持进行判断。
3. 模型拟合模型拟合是指通过最小化残差平方和或最大似然估计等方法,估计模型的参数。
对于非线性回归模型,常用的拟合方法有最小二乘法、非线性最小二乘法、广义最小二乘法等。
4. 拟合效果评估拟合效果评估是判断非线性回归模型拟合程度好坏的指标。
常用的评估方法有残差分析、决定系数、AIC和BIC等。
残差分析可以检验模型的拟合效果和残差的独立性、常数方差和正态性假设。
二、非线性回归模型的评估方法1. 决定系数(R-squared)决定系数是衡量模型拟合程度的指标,其取值范围为0到1之间。
决定系数越接近1,表示模型对观测数据的解释能力越强。
但需要注意,决定系数无法判断模型是否过拟合。
2. 调整决定系数(Adjusted R-squared)调整决定系数是对决定系数进行修正,考虑了自变量数目的影响。
调整决定系数比决定系数更能有效地评估模型的拟合效果。
3. Akaike信息准则(AIC)和贝叶斯信息准则(BIC)AIC和BIC是用于比较不同模型的拟合效果的统计准则。
AIC和BIC数值越小,表示模型越好。
这两个指标在非线性回归模型的选择和评估中广泛应用。
4. 拟合图形分析通过绘制拟合曲线与实际观测数据的对比图,可以直观地评估非线性回归模型的拟合效果。
拟合图形分析可以帮助发现模型的不足之处,从而进行进一步的改进。
回归分析非线性回归
回归分析非线性回归回归分析是一种用于研究自变量与因变量之间关系的统计分析方法。
在回归分析中,我们使用自变量来解释因变量的变化,并建立一个数学模型来描述这种关系。
通常情况下,我们假设自变量与因变量之间是线性关系。
因此,在大多数回归分析应用中,我们使用线性回归模型。
然而,有时候我们可能会发现实际数据不符合线性关系的假设。
这时,我们就需要使用非线性回归模型来更好地解释数据。
非线性回归分析是一种通过建立非线性模型来描述自变量和因变量之间关系的方法。
在这种情况下,模型可以是各种形式的非线性函数,如指数函数、对数函数、多项式函数等。
非线性回归模型的形式取决于实际数据。
非线性回归模型的建立通常包括以下几个步骤:1.数据收集:首先需要收集与自变量和因变量相关的数据。
这些数据应该能够反映出二者之间的关系。
2.模型选择:根据实际情况选择合适的非线性模型。
常见的非线性模型有指数模型、对数模型、幂函数等。
3.参数估计:使用最小二乘法或其他拟合方法来估计模型中的参数。
这些参数描述了自变量和因变量之间的关系。
4.模型检验:对估计得到的模型进行检验,评估模型的拟合程度。
常见的检验方法有残差分析、F检验、t检验等。
5.模型解释与预测:解释模型的参数和拟合程度,根据模型进行预测和分析。
非线性回归分析的主要优点是可以更准确地描述自变量和因变量之间的关系。
与线性回归不同,非线性回归可以拟合一些复杂的实际情况,并提供更准确的预测。
此外,非线性回归还可以帮助发现自变量和因变量之间的非线性效应。
然而,非线性回归模型的建立和分析相对复杂。
首先,选择适当的非线性模型需要一定的经验和专业知识。
其次,参数估计和模型检验也可能更加困难。
因此,在进行非线性回归分析时,需要谨慎选择合适的模型和方法。
最后,非线性回归分析还需要考虑共线性、异方差性、多重共线性等统计问题。
这些问题可能影响到模型的稳定性和可靠性,需要在分析过程中加以注意。
总之,非线性回归分析是一种用于解释自变量和因变量之间非线性关系的方法。
新教材高中数学第8章第2课时回归分析及非线性回归模型pptx课件新人教A版选择性必修第三册
2.在两个变量y与x的回归模型中,分别选择了4个不同的模型,它
们的决定系数R2如下,其中拟合效果最好的模型是(
2为0.98
A.模型1的决定系数R
√
B.模型2的决定系数R2为0.80
C.模型3的决定系数R2为0.50
D.模型4的决定系数R2为0.25
A
[R2越大拟合效果越好.]
)
3.从某省“双一流”大学中随机选出8名女大学生,得到其身高
残差图
观测值等,这样作出的图形称为______.在残差图中,残差点比较
均匀地落在水平的带状区域中,说明选用的模型比较合适,这样的
带状区域的宽度____,说明模型拟合精度越高.
越窄
残差
(3)残差分析:____是随机误差的估计结果,通过对残差的分析可以
判断模型刻画数据的效果,以及判断原始数据中是否存在可疑数据
建立两个变量间的非线性经验回归方程.
1.思考辨析(正确的画“√”,错误的画“×”)
(1)残差平方和越接近0,线性回归模型的拟合效果越好.
(√ )
(2)在画两个变量的散点图时,响应变量在x轴上,解释变量在y轴
上.
( × )
(3)R2越小,线性回归模型的拟合效果越好.
( × )
(4)在残差图中,纵坐标为残差,横坐标可以选为样本编号.( √ )
和幂函数模型的求解过程.(数学运算、数学建模)
01
必备知识·
情境导学探新知
设某幼苗从观察之日起,第x天的高度为y cm,测得的一些数据如表
所示:
第x天
1
4
9
16
25
36
49
高度y/cm
0
4
7
9
数学软件与建模4.2 一元非线性回归
实验4.2 一元非线性回归模型实验目的熟练掌握参数初始值的数值计算以及非线性拟合的Matlab 命令,并能根据输出结果计算均方误差及可决系数,并能据此进行拟合效果分析。
实验内容解决一元非线性回归模型有以下几个步骤: (1)首先作出散点图,确定函数)(x f 的类别。
对非线性拟合,下面的图形给出了常见曲线与方程的对应关系: 幂函数:bax y =指数函数:bxae y =双曲线函数:bax xy +=对数函数:x b a y ln +=指数函数:xb ae y =S 形曲线:xbea y -+=1具有S 形曲线的常见方程有: 罗杰斯蒂(logistic )模型:xey γβα-+=1 龚帕兹(Gomperty )模型:)ex p(xk e y --=βα理查德(Richards )模型:δγβα/1)]ex p(1/[x y -+=威布尔(Weibull)模型:)ex p(δγβαt y --=(2)①根据已知数据确定待定参数的初始值。
②正确输入函数。
③利用非线性拟合命令计算最佳参数。
(3)根据可决系数,比较拟合效果。
在Matlab 中进行非线性拟合的命令如下:[b,r,J] = nlinfit(x,y,fun,b0)其中,x,y 为原始数据,fun 是在M 文件中定义的函数,b0是函数中参数的初始值;b 为参数的最优值,r 是各点处的拟合残差,J 为雅克比矩阵的数值.注意:在6.1版本中输入x 是列向量,y 是行向量,而在7.0以上版本要求x ,y 要一致. 【例题4.2】炼钢厂出钢时所用盛钢水的钢包,由于钢水对耐火材料的侵蚀,容积不断增大,我们希望找出使用次数与增大容积之间的函数关系.实验数据如表4.2:表4.2 钢包使用次数与增大容积(1)分别选择函数bax x y +=、)1(cx be a y +=、c bx ax y 2++=、x bae y =拟合钢包容积与使用次数的关系,在同一坐标系内作出函数图形;(2)计算四种拟合曲线的均方差,并以此作为判别标准确定最佳拟合曲线 (3)二次多项式拟合的效果如何?分析内在原因 解:x1=[2:16];y1=[6.42,8.2,9.58,9.5,9.7,10,9.93,9.99,10.49,10.59,10.6,10.8,10.6,10.9,10.76]; b01=[0.1435,0.084]; %初始参数值 fun1=inline('x ./(b(1)+b(2)*x)','b','x'); [b1,r1,j1]=nlinfit(x1',y1,fun1,b01); y=x1./(0.1152+0.0845*x1); subplot(221)plot(x1,y1,'*',x1,y,'-or'); legend('原始数据','y=x/(ax+b)') b02=[112,0.4,0.2]; %初始参数值fun2=inline('b(1)*(1-b(2)*exp(-b(3)*x))','b','x'); [b2,r2,j2]=nlinfit(x1',y1,fun2,b02); f=10.5975*(1-0.9287*exp(-0.4531*x1)); subplot(222)plot(x1,y1,'*',x1,f,'-or');legend('原始数据','y=a(1+bexp(cx)') p=polyfit(x1,y1,2);g= -0.0290*x1.^2+0.7408*x1+6.0927; subplot(223)plot(x1,y1,'*',x1,g,'-or'); legend('原始数据','二次函数') b04=[112,-0.11]; %初始参数值 fun4=inline('b(1)*exp(b(2)./x)','b','x'); [b4,r4,j4]=nlinfit(x1',y1,fun4,b04); h=11.6037*exp(-1.0641./x1); subplot(224)plot(x1,y1,'*',x1,h,'-or'); legend('原始数据','y=aexp(b/x)')51015206810125101520510152068101205101520图4.3 原始数据与四种拟合曲线图为了比较上述四条曲线拟合的效果,我们首先确定如下的评价准则:均方残差)/()ˆ(1512p n y y MSE i i i --=∑=越小越好 其中i y 是原始数据,i yˆ是拟合曲线在i x 处的函数值,n 是原始数据的个数,p 是拟合曲线中参数个数.我们计算均方残差程序如下:[sum(r1.^2)/(15-2),sum(r2.^2)/(15-3),sum((y1-g).^2)/(15-3),sum(r4.^2)/(15-2)]ans = 0.0921 0.0875 0.2306 0.0664由此可知选择函数xbae y 进行拟合效果最好,而多项式的拟合效果最差.其原因在于多项式没有任何渐近线,而从实际问题可知钢包使用的年龄是有限的,因此选择函数应该考虑到其右上方有一条水平渐近线.结果说明:(1)在Matlab6.1版本中输入x 是列向量,y 是行向量,而在7.0以上版本要求x ,y 应同为行向量(或同为列向量).(2)如果确定初始参数值时遇到复杂的方程组,我们可以根据第三章中介绍的计算方程零点的方法,利用Matlab 计算初始值.【例4.3】表4.3给出了淮南市从1978年到20001年国民生产总值、第一产业、第二产业以及第三产业的数据,根据数据分析解决以下问题:(1)将各指标进行标准化,即减去各自的均值再比上标准差,计算各指标之间的相关系数矩阵;哪两个指标之间具有高度线性关系?(2)利用原始数据建立第一产业与第二产业之间的函数关系,在同一坐标系内作出原始数据与拟合曲线的散点图,计算均方误差、决定系数并预测2002年的第二产业生产总值.(3)利用标准化后的数据解决(2)中的问题,结果是否比用原始数据要好?为什么?表4.3淮南市部分经济指标题目分析:本题的第一问是解决大样本数据的处理问题,利用zscore命令即可解决,而计算指标之间的相关系数矩阵以后,可以获知那些指标之间有较强的线性相关性,若有两个非平稳的经济指标,随着时间的推移各自变化比较复杂,但是两者之间存在长期的均衡关系则可以利用回归分析建立两者之间的函数关系.从相关系数矩阵(表 4.4)和散点图(图4.4)可以看出国民生产总值与各产业都具有较强的线性关系,第一产业与第二产业以及第三产业之间也具有较大的线性相关.计算程序:首先将原始数据输入a=[78258 9230 51827 1720181785 10007 52274 1950487645 10751 55502 2139299072 17263 58182 23627105386 17282 62020 26084118832 20961 66988 30883148277 25755 86215 36307166410 30103 93586 42721189776 35906 101085 52785208477 43335 104604 60538258354 45125 146327 66902284792 52227 164217 68348306605 57351 169721 79533275928 27740 173600 74588351233 55847 200975 94411532686 80047 324491 128148683059 124984 392063 166012834994 135121 472819 2270541063871 154935 603812 3051241187782 169629 644155 3739981203396 178378 603230 4217881238310 187165 595097 4560481259965 174217 586677 4990711348558 170622 638398 539538];z=zscore(a); % 将原始数据标准化corrcoef(a); % 计算各指标的相关系数,得到如下结果表4.4 国民生产总值与各产业的相关系数[b,bint,r,rint,s]=regress(a(1:24,3),[ones(24,1),a(1:24,2)]);作图程序subplot(221),plot(a(1:24,2),a(1:24,3),'x'),legend('一产与二产')subplot(222),plot(a(1:24,1),'-*'),legend('第一产业')subplot(223),plot(a(1:24,3),'-o'),legend('第二产业')t=1:24;y= a(1:24,3);x=a(1:24,2);subplot(224),plot(t,y, '-*',t,3.5*x+2819.4,'-or'),legend('原始','拟合')均方差与可决系数计算程序sum(r.^2)/22,1- sum(r.^2)/sum((y-mean(y)).^2)利用2002年第一产业的产值187438,代入拟合曲线计算出2002年淮南市第二产业生产总值为658850实际数值为740059,相对误差为0.1097图4.4 国民生产总值与第二产业关系结果说明:(1)建立一次函数可以利用多项式回归的命令,本题我们利用了多元线性回归的命令;(2)我们用第一产业的一次函数近似计算第二产业生产总值,得到的绝对误差较大,其中的原因可以从第一产业与第二产业的图形中看出,第一产业在1991年处有一个异常点这是由于该年淮河洪灾造成淮南地区严重减产,而第二产业从1997年开始逐年下降直到2001年才出现上升,因此如果我们选取虚拟变量纠正异常点,或者分段拟合就可以进一步缩小误差。
非线性回归分析
非线性回归分析随着数据科学和机器学习的发展,回归分析成为了数据分析领域中一种常用的统计分析方法。
线性回归和非线性回归是回归分析的两种主要方法,本文将重点探讨非线性回归分析的原理、应用以及实现方法。
一、非线性回归分析原理非线性回归是指因变量和自变量之间的关系不能用线性方程来描述的情况。
在非线性回归分析中,自变量可以是任意类型的变量,包括数值型变量和分类变量。
而因变量的关系通常通过非线性函数来建模,例如指数函数、对数函数、幂函数等。
非线性回归模型的一般形式如下:Y = f(X, β) + ε其中,Y表示因变量,X表示自变量,β表示回归系数,f表示非线性函数,ε表示误差。
二、非线性回归分析的应用非线性回归分析在实际应用中非常广泛,以下是几个常见的应用领域:1. 生物科学领域:非线性回归可用于研究生物学中的生长过程、药物剂量与效应之间的关系等。
2. 经济学领域:非线性回归可用于经济学中的生产函数、消费函数等的建模与分析。
3. 医学领域:非线性回归可用于医学中的病理学研究、药物研发等方面。
4. 金融领域:非线性回归可用于金融学中的股票价格预测、风险控制等问题。
三、非线性回归分析的实现方法非线性回归分析的实现通常涉及到模型选择、参数估计和模型诊断等步骤。
1. 模型选择:在进行非线性回归分析前,首先需选择适合的非线性模型来拟合数据。
可以根据领域知识或者采用试错法进行模型选择。
2. 参数估计:参数估计是非线性回归分析的核心步骤。
常用的参数估计方法有最小二乘法、最大似然估计法等。
3. 模型诊断:模型诊断主要用于评估拟合模型的质量。
通过分析残差、偏差、方差等指标来评估模型的拟合程度,进而判断模型是否适合。
四、总结非线性回归分析是一种常用的统计分析方法,可应用于各个领域的数据分析任务中。
通过选择适合的非线性模型,进行参数估计和模型诊断,可以有效地拟合和分析非线性关系。
在实际应用中,需要根据具体领域和问题的特点来选择合适的非线性回归方法,以提高分析结果的准确性和可解释性。
回归建模的思路和方法
回归建模的思路和方法摘要:一、回归建模的概述1.回归分析的概念2.回归建模的目的3.回归建模的应用场景二、回归建模的步骤1.数据收集与处理2.变量选择与构建3.模型选择与评估4.模型优化与调整5.结果解释与应用三、常见回归建模方法1.线性回归2.多项式回归3.广义线性模型4.非线性回归5.时间序列回归四、回归建模的注意事项1.数据质量与完整性2.变量关系的合理性3.模型复杂性与稳定性4.模型泛化能力与过拟合防范5.结果的可解释性与实用性正文:一、回归建模的概述1.回归分析的概念回归分析是一种研究两个或多个变量之间关系的统计方法。
它旨在探讨因变量(响应变量)与自变量(预测变量)之间的依赖关系,从而为预测和控制因变量提供依据。
2.回归建模的目的回归建模的主要目的是揭示变量间的内在规律,对未来的数据进行预测,评估自变量对因变量的影响程度,以及分析变量间的相关性。
3.回归建模的应用场景回归建模广泛应用于经济学、金融学、社会学、医学等领域。
例如,在金融领域,可以通过回归建模预测股票价格、评估投资风险;在社会学领域,可以分析教育程度、家庭收入等因素对就业的影响。
二、回归建模的步骤1.数据收集与处理进行回归建模的第一步是收集相关数据。
数据来源可以包括官方统计数据、问卷调查、实验数据等。
在收集数据后,需要对数据进行清洗、处理,包括去除异常值、缺失值处理、数据转换等。
2.变量选择与构建在数据处理完成后,需要选择与建模目标相关的自变量和因变量。
自变量可以是连续型或离散型变量,而因变量通常是连续型变量。
在选择变量时,要考虑变量间的相关性、共线性等问题。
此外,还需要根据数据特点构建合适的变量,如对连续变量进行离散化处理、创建时间变量等。
3.模型选择与评估回归建模过程中,需要根据数据特点和建模目标选择合适的模型。
常见的回归模型包括线性回归、多项式回归、广义线性模型等。
在选择模型后,要对模型进行拟合,并对模型的预测性能进行评估。