
一种广义的线性回归分析模型-逻辑回归
一种广义的线性回归分析模型:逻辑回归
逻辑回归又称逻辑回归分析,是一种广义的线性回归分析模型,常用于数据挖掘、疾病自动诊断、经济预测等领域。
逻辑回归是始于输出结果为实际意义的连续值的线性回归,因此与多重性线性回归分析有很多的相同之处。
逻辑回归模型
逻辑回归是一种极易理解的模型,就相当于y=f(x),表明自变量x与因变量y的关系。
最常见的问题如:医生治病时的望闻问切,之后判断病人是否生病或生了什幺病,其中的望闻问切就是获取自变量x,即特征数据,判断是否生病就相当于获取因变量y,及预测分类。
图1 线性回归示例
最简单的回归就是线性回归,借用Andrew NG的讲义来说,如图1.a所示,x为数据点---肿瘤的大小,y为观测值---是否有恶性肿瘤。
通过构建线性。
二元logistics回归霍斯曼检验拟合度差原因

二元logistics回归霍斯曼检验拟合度差原因二元logistics回归是一种常用的分类分析方法,通过建立逻辑回归模型,对二分类问题进行预测和判断。
在进行二元logistics回归时,我们经常会使用霍斯曼检验(Hosmer-Lemeshow test)来评估模型的拟合程度。
然而,当发现模型的拟合度差时,我们需要深入分析,找出造成拟合度差的原因。
本文将围绕这一问题展开讨论。
一、二元logistics回归模型回顾在开始讨论拟合度差的原因之前,我们先回顾一下二元logistics回归模型的基本原理。
二元logistics回归模型是一种广义线性回归模型。
它基于Logistic 函数,将自变量与因变量之间的关系映射为一个概率值。
该模型的数学表达式如下:P(Y=1|X) = 1 / (1 + e^-(β0 + β1X1 + β2X2 + ... + βnXn))其中,Y为因变量的取值,X为自变量的取值,β为模型的回归系数。
通过最大似然估计等方法,我们可以得到回归系数的估计值,从而建立模型。
二、霍斯曼检验的原理霍斯曼检验是一种用于评估二元logistics回归模型拟合度的统计检验方法。
该检验通过将样本按照预测概率值进行分组,然后计算预测值与实际值之间的残差来衡量模型的拟合程度。
具体而言,霍斯曼检验的步骤如下:1. 将样本按照预测概率值进行分组,通常将预测概率分为10个组。
2. 对每个组内的样本,计算实际值与预测值之间的残差,可以使用对数似然残差(log-likelihood residual)或分位数残差(quantile residual)。
3. 计算每个组内的残差平均值,得到每个组的平均残差。
4. 使用卡方检验或其它拟合优度检验方法,比较实际值与预测值之间的残差平均值是否存在显著差异。
如果在拟合度检验中发现存在显著差异,即拒绝原假设,说明模型的拟合不理想。
三、拟合度差的可能原因在进行霍斯曼检验时,如果发现模型的拟合度较差,我们需要深入分析,找出可能的原因。
Python逻辑回归原理及实际案例应用
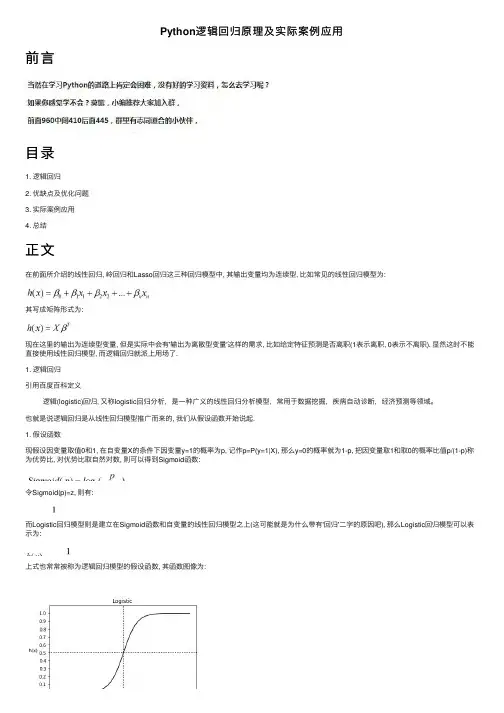
Python逻辑回归原理及实际案例应⽤前⾔⽬录1. 逻辑回归2. 优缺点及优化问题3. 实际案例应⽤4. 总结正⽂在前⾯所介绍的线性回归, 岭回归和Lasso回归这三种回归模型中, 其输出变量均为连续型, ⽐如常见的线性回归模型为:其写成矩阵形式为:现在这⾥的输出为连续型变量, 但是实际中会有'输出为离散型变量'这样的需求, ⽐如给定特征预测是否离职(1表⽰离职, 0表⽰不离职). 显然这时不能直接使⽤线性回归模型, ⽽逻辑回归就派上⽤场了.1. 逻辑回归引⽤百度百科定义逻辑(logistic)回归, ⼜称logistic回归分析,是⼀种⼴义的线性回归分析模型,常⽤于数据挖掘,疾病⾃动诊断,经济预测等领域。
也就是说逻辑回归是从线性回归模型推⼴⽽来的, 我们从假设函数开始说起.1. 假设函数现假设因变量取值0和1, 在⾃变量X的条件下因变量y=1的概率为p, 记作p=P(y=1|X), 那么y=0的概率就为1-p, 把因变量取1和取0的概率⽐值p/(1-p)称为优势⽐, 对优势⽐取⾃然对数, 则可以得到Sigmoid函数:令Sigmoid(p)=z, 则有:⽽Logistic回归模型则是建⽴在Sigmoid函数和⾃变量的线性回归模型之上(这可能就是为什么带有'回归'⼆字的原因吧), 那么Logistic回归模型可以表⽰为:上式也常常被称为逻辑回归模型的假设函数, 其函数图像为:通过图像可以看出的取值范围为, h(x)的取值范围为[0, 1], 对于⼆分类问题来说, h(x)>=0.5则y=1, h(x)<0.5则y=0, ⽽且通过图像得知:="">时, h(x)>=0.5, 因此时y=1, 否则y=0.模型的假设函数知道了, 接下来看看损失函数.2. 损失函数既然逻辑回归是建⽴在线性回归模型之上, 那么我们先来回顾线性回归的损失函数:如果将我们逻辑回归的假设函数代⼊上式损失函数, 绘制出来的图像则是⾮凸函数, 其很容易产⽣局部最优解, ⽽⾮全局最优解, 为了找到使得全局最优解, 我们需要构造⼀个凸函数.由于对数函数能够简化计算过程, 因此这⾥也是通过对数函数来构建, 先来回归下对数函数的图像(原图来⾃百度百科):通过上图可以发现绿线部分与我们要构造的凸函数较接近. 当a=e时, 绿线部分可以分别表⽰为: -log e(x)和-log e(1-x). 现将x替换为h(x)并同时加⼊输出变量y (取值为1或0), 则有:当上式中的y=1时, 其结果为-log e h(x); 当y=0时, 其结果-log e[1-h(x)].最后, 将上式代⼊我们的损失函数中, 则有:当然, 也可以⽤统计学中的极⼤似然法构造出上式损失函数. 损失函数有了, 下⼀步则是求解损失函数最⼩的算法了.3. 算法常⽤的求解算法有梯度下降法, 坐标轴下降法, 拟⽜顿法. 下⾯只介绍梯度下降法(其他⽅法还未涉及)你也许会有疑问, 既然是线性回归模型推⼴⽽来, 那么为什么没有最⼩⼆乘法呢? 最⼩⼆乘法是⽤来求解最⼩误差平⽅和的算法, ⽽误差的平⽅和正是我们上⾯提到的线性回归的损失函数, 通过其构造出来的逻辑回归的损失函数是⾮凸的不容易找到全局最优解, 故不选⽤最⼩⼆乘法, ⽽通过极⼤似然法则可以构造出凸函数, 进⽽可以使⽤梯度下降法进⾏求解.对于梯度下降法的理解在这节, 这⾥直接给出其表⽰:具体的求解过程:因此, 我们的梯度下降法可以写成(其中, x0=1):上式也被称为批量梯度下降法, 另外两种: 随机梯度下降法和⼩批量梯度下降法分别表⽰为:2. 优缺点及优化问题1. 优点1) 模型简单, 训练速度快, 且对于输出变量有很好的概率解释2) 可以适⽤连续型和离散型⾃变量.3) 可以根据实际需求设定具体的阀值2. 缺点1) 只能处理⼆分类问题.2) 适⽤较⼤样本量, 这是由于极⼤似然估计在较⼩样本量中表现较差.3) 由于其是基于线性回归模型之上, 因此其同样会出现多重共线性问题.4) 很难处理数据不均衡问题3. 优化1) 可以在⼆分类上进⾏推⼴, 将其推⼴到多分类回归模型2) 对于多重共线性问题, 也可以通过删除⾃变量, 进⾏数据变换, 正则化, 逐步回归, 主成分分析等⽅法改善, 对于正则化逻辑回归同样有两种: L1和L2,其分别表⽰为:L1正则化L2正则化3. 实际案例应⽤1. 数据来源及背景数据来源: https:///jiangzuo/hr-comma-sep/version/1该数据集包含14999个样本以及10个特征, 通过现有员⼯是否离职的数据, 建⽴模型预测有可能离职的员⼯.2. 数据概览1) 查看前2⾏和后2⾏数据import pandas as pddf = pd.read_csv(r'D:\Data\HR_comma_sep.csv')pd.set_option('display.max_rows', 4)df10个字段分别是: 员⼯对公司满意度, 最新考核评估, 项⽬数, 平均每⽉⼯作时长, ⼯作年限, 是否出现⼯作事故, 是否离职, 过去5年是否升职, 岗位, 薪资⽔平.员⼯岗位有10种, 其中最多的是销售, 多达4140.薪资⽔平共有3个等级, 最多的是低等, 多达7316.2. 对公司满意度与是否离职的关系3. 最新考核评估与是否离职的关系boxplot = Boxplot('最新评估与是否离职关系图', title_pos='center')x_axis = ['在职', '离职']y_axis = [df[df.left == 0].evaluation.values, df[df.left == 1].evaluation.values]boxplot.add('', x_axis, boxplot.prepare_data(y_axis))boxplot.render()5. 平均每⽉⼯作时长和是否离职的关系boxplot = Boxplot('平均每⽉⼯作时长与是否离职关系图', title_pos='center')x_axis = ['在职', '离职6. ⼯作年限和是否离职的关系7. 是否发⽣⼯作事故与是否离职的关系8. 5年内是否升职与是否离职的关系promotion_left = pd.crosstab(df.promotion, df.left)attr = promotion_left.indexbar = Bar('5年内是否升职与是否离职的关系图title_pos='center')bar.add('离职', attr, promotion_left[1], is_stack=True)bar.add('在职', attr, promotion_left[0], is_stack=True, legend_pos='left' ,10. 薪资⽔平和是否离职的关系5. 特征⼯程1. 离散型数据处理离散型数据可分为两种: ⼀种是定序, ⼀种是定类.1) 定序薪资⽔平其含有顺序意义, 因此将其字符型转化为数值型df['salary'] = df.salary.map({'low': 0, 'medium': 1, 'high': 2})df.salary.unique()array([0, 1, 2], dtype=int64)2) 定类岗位是定类型变量, 对其进⾏one-hot编码, 这⾥直接利⽤pandas的get_dummies⽅法.df_one_hot = pd.get_dummies(df, prefix='dep')df_one_hot.shape(14999, 19)2. 连续型数据处理逻辑回归模型能够适应连续型变量, 因此可以不⽤进⾏离散化处理, ⼜由于多个特征之间差异差异较⼤会造成梯度下降算法收敛速度变慢, 故进⾏归⼀化处理#采⽤max-min归⼀化⽅法hours = df_one_hot['hours']df_one_hot['hours'] = df_one_hot.hours.apply(lambda x: (x-hours.min()) / (hours.max()-hours.min()))3. 相关系数两个变量均是连续型且具有线性关系, 则可以使⽤⽪尔逊相关系数, 否则使⽤斯⽪尔曼相关系数, 这⾥采⽤斯⽪尔曼相关系数#计算相关系数correlation = df_one_hot.corr(method = 'spearman')plt.figure(figsize=(18, 10))#绘制热⼒图sns.heatmap(correlation, linewidths=0.2, vmax=1, vmin=-1, linecolor='w',fmt='.2f', annot=True,annot_kws={'size':10},square=True)6. 逻辑回归模型1. 划分数据集from sklearn.model_selection import train_test_split#划分训练集和测试集X = df_one_hot.drop(['left'], axis=1)y = df_one_hot['left']X_train, X_test,y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=1)2. 训练模型from sklearn.linear_model import LogisticRegressionLR = LogisticRegression()print(LR.fit(X_train, y_train))print('训练集准确率: ', LR.score(X_train, y_train))print('测试集准确率: ', LR.score(X_test, y_test))LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,intercept_scaling=1, max_iter=100, multi_class='warn', n_jobs=None, penalty='l2', random_state=None, solver='warn', tol=0.0001, verbose=0, warm_start=False)训练集准确率: 0.7978998249854155测试集准确率: 0.7966666666666666参考官⽅⽂档说明, 参数C是正则化项参数的倒数, C的数值越⼩, 惩罚的⼒度越⼤. penalty可选L1, L2正则化项, 默认是L2正则化.参数solver可选{‘newton-cg’, ‘lbfgs’, ‘liblinear’, ‘sag’, ‘saga’}这5个优化算法:newton-cg, lbfgs是拟⽜顿法, liblinear是坐标轴下降法, sag, saga是随机梯度下降法, saga可以适⽤于L1和L2正则化项, ⽽sag只能⽤于L2正则化项. #指定随机梯度下降优化算法LR = LogisticRegression(solver='saga')print(LR.fit(X_train, y_train))print('训练集准确率: ', LR.score(X_train,y_train))print('测试集准确率: ', LR.score(X_test, y_test))LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,intercept_scaling=1, max_iter=100, multi_class='warn', n_jobs=None, penalty='l2', random_state=None, solver='saga', tol=0.0001, verbose=0, warm_start=False)训练集准确率: 0.7980665055421285测试集准确率: 0.7973333333333333在选择随机梯度下降法后, 训练集和测试集准确率均略有提升.3. 调参#⽤准确率进⾏10折交叉验证选择合适的参数Cfrom sklearn.linear_model import LogisticRegressionCVCs = 10**np.linspace(-10, 10, 400)lr_cv = LogisticRegressionCV(Cs=Cs, cv=10, penalty='l2', solver='saga', max_iter=10000, scoring='accuracy')lr_cv.fit(X_train,y_train)lr_cv.C_array([25.52908068])⽤该参数进⾏预测LR = LogisticRegression(solver='saga', penalty='l2', C=25.52908068)print('训练集准确率: ', LR.score(X_train, y_train))print('测试集准确率: ',LR.score(X_test, y_test))训练集准确率: 0.7984832069339112测试集准确率: 0.798训练集和测试集准确率均有所提升, 对于⼆分类问题, 准确率有时不是很好的评估⽅法, 这时需要⽤到混淆矩阵4. 混淆矩阵from sklearn import metricsX_train_pred = LR.predict(X_train)X_test_pred = LR.predict(X_test)print('训练集混淆矩阵:')print(metrics.confusion_matrix(y_train, X_train_pred))print('测试集混淆矩阵:')print(metrics.confusion_matrix(y_test, X_test_pred))训练集混淆矩阵:[[8494 647] [1771 1087]]测试集混淆矩阵:[[2112 175] [ 431 282]]from sklearn.metrics import classification_reportprint('训练集:')print(classification_report(y_train, X_train_pred))print('测试集:')print(classification_report(y_test, X_test_pred))训练集: precision recall f1-score support 0 0.83 0.93 0.88 9141 1 0.63 0.38 0.47 2858 micro avg 0.80 0.80 0.80 11999 macro avg 0.73 0.65 0.67 11999weighted avg 0.78 0.80 0.78 11999测试集: precision recall f1-score support 0 0.83 0.92 0.87 2287 1 0.62 0.40 0.48 713 micro avg 0.80 0.80 0.80 3000 macro avg 0.72 0.66 0.68 3000weighted avg 0.78 0.80 0.78 3000在训练集有0.83的精准率和0.93的召回率, 在测试集上有0.83的精准率和0.92的召回率.7. 朴素贝叶斯模型朴素贝叶斯模型是基于特征条件独⽴假设和贝叶斯理论.from sklearn.naive_bayes import GaussianNBfrom sklearn.model_selection import cross_val_score#构建⾼斯朴素贝叶斯模型gnb = GaussianNB()gnb.fit(X_train, y_train)print('训练集准确率: ', gnb.score(X_train, y_train))print('测试集准确率: ', gnb.score(X_test, y_test))X_train_pred =gnb.predict(X_train)X_test_pred = gnb.predict(X_test)print('训练集混淆矩阵:')print(metrics.confusion_matrix(y_train, X_train_pred))print('测试集混淆矩阵:')print(metrics.confusion_matrix(y_test, X_test_pred))print('训练集:')print(classification_report(y_train, X_train_pred))print('测试集:')print(classification_report(y_test, X_test_pred))训练集准确率: 0.7440620051670973测试集准确率: 0.741训练集混淆矩阵:[[6791 2350] [ 721 2137]]测试集混淆矩阵:[[1680 607] [ 170 543]]训练集: precision recall f1-score support 0 0.90 0.74 0.82 9141 1 0.48 0.75 0.58 2858 micro avg 0.74 0.74 0.74 11999 macro avg 0.69 0.75 0.7011999weighted avg 0.80 0.74 0.76 11999测试集: precision recall f1-score support 0 0.91 0.73 0.81 2287 1 0.47 0.76 0.58 713 micro avg 0.74 0.74 0.74 3000 macro avg 0.69 0.75 0.70 3000weighted avg 0.80 0.74 0.76 3000可以看到其准确率较逻辑回归低, 但是精准率⾼于逻辑回归.8. ROC曲线from sklearn import metricsfrom sklearn.metrics import roc_curve#将逻辑回归模型和⾼斯朴素贝叶斯模型预测出的概率均与实际值通过roc_curve⽐ROC曲线越靠近左上⾓说明分类效果越好, 与之对应的auc的值就越⼤. 对于该数据集来说总结。
数据分析技术中常用的多元回归分析方法简介
数据分析技术中常用的多元回归分析方法简介多元回归分析是一种常用的数据分析技术,用于建立解释一个或多个自变量与一个或多个因变量之间关系的数学模型。
在实际应用中,多元回归分析可以帮助我们理解和预测因变量的变化情况,同时揭示自变量对因变量的影响程度和方向。
在多元回归分析中,我们通常会考虑多个自变量对一个因变量的影响。
这些自变量可以是连续变量,也可以是分类变量。
为了进行多元回归分析,我们需要收集包含自变量和因变量数据的样本,并建立一个数学模型来描述它们之间的关系。
常用的多元回归分析方法有以下几种:1. 线性回归分析:线性回归是最基本的多元回归分析方法之一。
它假设自变量和因变量之间的关系是线性的,即可以通过一条直线来描述。
线性回归可以用于预测新的因变量值或者探究自变量对因变量的影响程度和方向。
2. 多项式回归分析:多项式回归是线性回归的扩展形式,它允许通过非线性方程来描述自变量和因变量之间的关系。
多项式回归可以用于处理具有非线性关系的数据,通过增加自变量的幂次项,可以更好地拟合数据。
3. 逐步回归分析:逐步回归是一种渐进式的回归分析方法,它通过不断添加或删除自变量来选择最优的模型。
逐步回归可以帮助我们识别对因变量影响最显著的自变量,并且去除对模型没有贡献的自变量,以减少复杂度和提高预测准确性。
4. 岭回归分析:岭回归是一种用于处理共线性问题的回归方法。
共线性指的是自变量之间存在高度相关性,这会导致模型参数估计不稳定。
岭回归通过添加一个正则化项来缩小模型参数的值,从而减少共线性的影响。
5. 主成分回归分析:主成分回归结合了主成分分析和回归分析的方法,用于处理多重共线性问题。
主成分分析通过将自变量转换为一组无关的主成分来降维,然后进行回归分析。
这样可以减少自变量之间的相关性,并提高模型的解释力。
6. 逻辑回归分析:逻辑回归是一种广义线性回归,常用于处理二分类问题。
它通过对因变量进行逻辑变换,将线性回归的结果映射到一个[0, 1]的区间,表示某事件发生的概率。
逻辑曲线(Logistic回归)
逻辑回归的参数解释
β0
截距,表示当所有解释变量x都为0时, logit P的估计值。
β1, β2, ..., βp
斜率,表示各解释变量对logit P的影 响程度。
逻辑回归的假设条件
线性关系
假设自变量与因变量之间存在线性关系,即因变 量的变化可以被自变量的线性组合所解释。
误差项同分布
假设误差项服从同一分布,通常是正态分布。
评估指标
根据任务类型选择合适的评估指标,如准确率、召回率、F1分数等。
模型比较
将新模型与其他同类模型进行比较,了解其性能优劣。
04 逻辑回归的优缺点
优点
分类性能好
逻辑回归模型在二分类问题上 表现优秀,分类准确率高。
易于理解和实现
逻辑回归模型形式简单,参数 意义明确,方便理解和实现。
无数据分布假设
总结词
在某些情况下,逻辑回归可能不是解决回归问题的最佳选择,此时可以考虑其他替代方 案。
详细描述
当因变量是连续变量,且自变量和因变量之间的关系非线性时,线性回归可能不是最佳 选择。此时可以考虑使用其他回归模型,如多项式回归、岭回归、套索回归等。另外, 当自变量和因变量之间的关系不确定时,可以考虑使用支持向量回归等模型进行预测。
06 总结与展望
总结
应用广泛
逻辑回归模型在许多领域都有广泛的应用,如医学、金融、市场 营销等,用于预测和解释二元分类结果。
理论基础坚实
基于概率和统计理论,逻辑回归模型能够提供可靠的预测和解释, 尤其是在处理小样本数据时。
灵活性和可解释性
模型参数可以解释为对结果概率的影响程度,这使得逻辑回归成为 一种强大且易于理解的工具。
在二分类问题中,逻辑回归通过将线性回归的输出经过逻辑函数转换,将连续的预测值转换为概率形式,从而实 现对因变量的二分类预测。逻辑函数的形式为1 / (1 + e ^ (-z)),其中z为线性回归的输出。
回归分析的基本知识点及习题
模型评估:线性 回归模型的评估 通常使用R方值、 调整R方值、残 差图等指标进行
评估。
参数估计与求解
最小二乘法:通过最小化误差的平 方和来估计线性回归模型的参数
梯度下降法:通过迭代更新参数, 使得损失函数最小化,从而得到最 优解
添加标题
添加标题
添加标题
添加标题
最大似然估计法:基于似然函数的 最大值来估计参数,使得观测到的 数据出现的概率最大
原理:通过引入 一个小的正则化 项来改进最小二 乘法的估计,以 减少过拟合和增 加模型的稳定性。
目的:在回归分析 中,岭回归分析用 于处理自变量之间 高度相关的情况, 通过加入正则化项 来减少过拟合,提 高模型的预测精度。
应用场景:岭回 归分析广泛应用 于统计学、机器 学习和数据分析 等领域,尤其在 处理共线性数据 问题时表现出色。
感谢您的观看
汇报人:
梯度下降法:通过 迭代更新参数来最 小化损失函数
牛顿-拉夫森方法 :利用泰勒级数展 开来求解参数
模型评估与优化
模型的准确性评估:通过比较实际值与预测值来评估模型的预测能力。
模型的可靠性评估:检查模型是否具有足够的稳定性和可靠性。
模型的优化方法:通过调整模型参数或改变模型结构来提高模型的预测能力和可 靠性。
假设:满足线性关系、误差项独立同分布、误差项无偏、误差项无自相关等假设。 模型建立:基于历史数据,通过最小二乘法等估计方法确定自变量和因变量的关系。 模型评估:通过残差分析、决定系数、调整决定系数等方法评估模型的拟合优度。
参数估计与求解
最小二乘法:通过 最小化误差的平方 和来估计参数
最大似然估计法: 基于似然函数的最 大值来估计参数
模型的适用性:确定模型是否适用于特定的数据集和问题类型。
二元逻辑回归和有序逻辑回归r语言

一、概述逻辑回归是统计学中一种常用的回归分析方法,它主要用于解决二分变量的分类问题。
在实际的数据分析中,我们经常会遇到分类不仅仅是二元的情况,而是有多个有序的分类,这时有序逻辑回归就成为了一种重要的工具。
而R语言作为一种非常流行的统计计算和数据分析工具,自然而然地成为了实现逻辑回归的首选语言之一。
本文将从二元逻辑回归和有序逻辑回归两个方面,结合R语言进行详细介绍和案例分析。
二、二元逻辑回归1. 逻辑回归简介逻辑回归是一种广义线性回归模型,适用于因变量为二元变量的情况。
逻辑回归的主要思想是将线性回归的结果通过一个非线性函数映射到[0,1]区间,从而得到一个概率值,进而判断样本属于哪一类。
在R语言中,可以使用glm函数进行逻辑回归模型的拟合。
2. 二元逻辑回归的实现在R语言中,利用glm函数可以轻松实现二元逻辑回归。
首先需要准备好数据,然后使用glm函数拟合出模型,并通过summary函数查看模型的拟合结果和显著性检验。
R语言还提供了一系列的函数和包,如caret包和pROC包,可以用于模型的评估和预测。
3. 二元逻辑回归的案例分析以某医院病人的生存情况数据为例,我们可以用二元逻辑回归来探究各个属性对患者生存率的影响。
通过建立适当的模型,我们可以对不同因素的影响进行分析,并做出预测。
在R语言环境下,我们可以方便地进行数据清洗、变量选择、模型拟合和结果评估。
三、有序逻辑回归1. 有序逻辑回归简介有序逻辑回归是逻辑回归的一种推广形式,适用于因变量为有序多元变量的情况。
有序逻辑回归在分析有序分类变量时非常有用,它能够提供比普通分类更多的信息。
在R语言中,使用ordinal包可以很方便地实现有序逻辑回归。
2. 有序逻辑回归的实现在R语言中,使用ordinal包可以轻松实现有序逻辑回归。
首先需要对数据进行预处理,然后使用clm函数拟合出模型,通过summary 函数查看模型的拟合结果和显著性检验。
R语言还提供了一些可视化和评估的工具,如woe和pROC包,可以对模型进行更深入的分析和评估。
如何使用逻辑回归模型进行情感分析(九)
情感分析是一种通过对文本中的情感色彩和情感倾向进行识别和分析的技术。
它可以帮助人们了解大众对某一事件、产品或话题的态度和情绪,对于企业的市场调研、舆情监控、产品改进等方面有着重要的应用价值。
在情感分析中,逻辑回归模型是一种常用且效果较好的方法。
本文将介绍如何使用逻辑回归模型进行情感分析。
一、数据准备在使用逻辑回归模型进行情感分析之前,首先需要准备好相应的数据。
情感分析的数据通常是文本数据,可以是用户评论、社交媒体上的帖子、新闻文章等。
这些数据需要经过清洗和预处理,去除无关信息、标点符号、停用词等,保留文本的实质内容。
然后,需要对文本数据进行标记,即给每条文本打上情感极性标签,比如正面情绪为1,负面情绪为0,中性情绪为。
这样的标记有利于构建监督学习模型,比如逻辑回归模型。
二、特征提取在准备好标记的文本数据之后,接下来需要进行特征提取。
逻辑回归模型的输入是特征向量,因此需要将文本数据转化为特征向量。
常用的特征提取方法包括词袋模型、TF-IDF模型、词嵌入模型等。
其中,词袋模型将每个文本表示为一个向量,向量的每个元素对应一个词语,表示该词在文本中的出现次数或频率。
TF-IDF模型考虑了词语在整个语料库中的重要程度,可以更好地反映单词的重要性。
词嵌入模型则将每个词映射到一个低维语义空间中的向量表示,能够更好地捕捉词语之间的语义关系。
三、模型训练有了特征向量之后,就可以开始训练逻辑回归模型了。
逻辑回归模型是一种广义线性模型,可以用于处理二分类问题。
在情感分析中,可以将文本的情感极性视为一个二分类问题,利用逻辑回归模型来预测文本的情感极性。
在训练模型之前,需要将数据集划分为训练集和测试集,用训练集来训练模型,用测试集来评估模型的性能。
训练模型时,可以利用交叉验证等方法来调参,找到最优的模型参数。
四、模型评估训练好逻辑回归模型之后,需要对模型进行评估。
常用的评估指标包括准确率、精确率、召回率、F1值等。
这些指标可以衡量模型对正负样本的分类能力、预测准确性等。
回归分析线性回归Logistic回归对数线性模型
逻辑回归的模型为 (P(Y=1) = frac{1}{1+e^{-z}}),其中 (z = beta_0 + beta_1X_1 + beta_2X_2 + ... + beta_nX_n)。
逻辑斯蒂函数
பைடு நூலகம்
定义
逻辑斯蒂函数是逻辑回归模型中用来描述自变量与因变量之 间关系的函数,其形式为 (f(x) = frac{1}{1+e^{-x}})。
。
在样本量较小的情况下, logistic回归的预测精度可能高 于线性回归。
线性回归的系数解释较为直观 ,而logistic回归的系数解释相 对较为复杂。
对数线性模型与其他模型的比较
对数线性模型假设因变量和自变量之间存在对 数关系,而其他模型的假设条件各不相同。
对数线性模型的解释性较强,可以用于探索自变量之 间的交互作用和效应大小。
THANKS
感谢您的观看
预测市场细分中的消费者行为等。
对数线性模型还可以用于探索性数据分析,以发现数 据中的模式和关联。
Part
04
比较与选择
线性回归与logistic回归的比较
线性回归适用于因变量和自变 量之间存在线性关系的场景, 而logistic回归适用于因变量为
二分类或多分类的场景。
线性回归的假设条件较为严格 ,要求因变量和自变量之间存 在严格的线性关系,而logistic 回归的假设条件相对较为宽松
最小二乘法
最小二乘法是一种数学优化技术,用于最小化预测值与实际观测值之间的平方误差总和。
通过最小二乘法,可以估计回归系数,使得预测值与实际观测值之间的差距最小化。
最小二乘法的数学公式为:最小化 Σ(Yi - (β0 + β1X1i + β2X2i + ...))^2,其中Yi是实际观 测值,X1i, X2i, ...是自变量的观测值。
线性模型知识点总结
线性模型知识点总结一、线性模型概述线性模型是统计学中一类简单而又常用的模型。
在线性模型中,因变量和自变量之间的关系被描述为一个线性方程式。
线性模型被广泛应用于各种领域,如经济学、医学、社会科学等。
线性模型的简单和普适性使得它成为数据分析中的一种重要工具。
线性模型可以用来建立预测模型、对变量之间的关系进行建模和推断、进行变量选择和模型比较等。
在实际应用中,线性模型有多种形式,包括简单线性回归、多元线性回归、广义线性模型、岭回归、逻辑回归等。
这些模型在不同的情况下可以更好地满足数据的特点和要求。
二、线性回归模型1. 简单线性回归简单线性回归是最基本的线性模型之一,它描述了一个因变量和一个自变量之间的线性关系。
简单线性回归模型可以用如下的方程式来表示:Y = β0 + β1X + ε其中,Y是因变量,X是自变量,β0和β1分别是截距项和斜率项,ε是误差项。
简单线性回归模型基于最小二乘法估计参数,从而得到最优拟合直线,使得观测值和拟合值的离差平方和最小。
简单线性回归模型可以用来分析一个自变量对因变量的影响,比如身高和体重的关系、学习时间和考试成绩的关系等。
2. 多元线性回归多元线性回归是在简单线性回归的基础上发展而来的模型,它能够同时描述多个自变量对因变量的影响。
多元线性回归模型可以用如下的方程式来表示:Y = β0 + β1X1 + β2X2 + ... + βpXp + ε其中,X1、X2、...、Xp是p个自变量,β0、β1、β2、...、βp分别是截距项和各自变量的系数,ε是误差项。
多元线性回归模型通过估计各系数的值,可以得到各自变量对因变量的影响情况,以及各自变量之间的相关关系。
3. 岭回归岭回归是一种用来处理多重共线性问题的线性回归方法。
在多元线性回归中,如果自变量之间存在较强的相关性,会导致参数估计不准确,岭回归通过对参数加上一个惩罚项来避免过拟合,从而提高模型的稳定性和泛化能力。
岭回归模型可以用如下的方程式来表示:Y = β0 + β1X1 + β2X2 + ... + βpXp + ε - λ∑(β^2)其中,λ是岭参数,用来平衡参数估计和惩罚项之间的关系。
统计模型资料
统计模型统计模型是统计学中的重要概念,用于描述和分析数据之间的关系,从而进行推断和预测。
统计模型可以帮助我们理解数据背后的规律和趋势,为决策提供依据。
在统计学中,有各种各样的统计模型,包括线性回归模型、逻辑斯蒂回归模型、时间序列模型等。
线性回归模型线性回归模型是最简单、最常用的统计模型之一。
在线性回归模型中,我们假设自变量和因变量之间存在线性关系,通过最小化残差平方和来估计模型参数。
线性回归模型可以用来预测连续型变量,例如房价、销售额等。
通过线性回归模型,我们可以探索变量之间的相关性,判断变量对因变量的影响程度。
逻辑斯蒂回归模型逻辑斯蒂回归模型是一种广义线性模型,常用于解决二分类问题。
逻辑斯蒂回归模型通过逻辑斯蒂函数将线性回归的输出映射到0和1之间,从而进行分类预测。
逻辑斯蒂回归模型在实际应用中被广泛使用,例如预测客户流失、判断疾病患病风险等。
时间序列模型时间序列模型是用于分析时间序列数据的统计模型。
时间序列数据是按时间顺序排列的数据序列,例如股票价格、气温变化等。
时间序列模型可以帮助我们理解时间序列数据的趋势、季节性和周期性变化,进而进行预测和决策。
常见的时间序列模型包括自回归模型、移动平均模型和ARIMA模型等。
总结统计模型在统计学和数据分析中扮演着重要角色,通过建立合适的统计模型,我们可以深入分析数据,发现数据背后的规律,为决策提供科学依据。
不同的统计模型适用于不同的问题和数据类型,正确选择和应用统计模型可以提升数据分析的效率和准确性。
希望通过本文对统计模型的简要介绍,读者能对统计模型有一个初步的了解,能够在实际应用中灵活运用各种统计模型进行数据分析和决策。