
hadoop大数据平台分布式集群环境搭建安装规划
hadoop大数据平台分布式集群环境搭建安装规划Hadoop分布式集群环境搭建是每个入门级新手都非常头疼的事情,因为你可能花费了很久的时间在搭建运行环境,最终却不知道什么原因无法创建成功。
但对新手来说,运行环境搭建不成功的概率还蛮高的。
在之前的分享文章中给hadoop新手入门推荐的大快搜索DKHadoop发行版,在运行环境安装方面的确要比其他的发行版hadoop要简单的多,毕竟DKHadoop是对底层重新集成封装的,对与研究hadoop尤其是入门级新手来说是非常友好的一个发行版!关于DKHadoop的安装留在后面再给大家分享,本篇就跟大家聊一聊关于【hadoop分布式集群环境搭建规划】。
1、分布式机器架构图:
其中机器1主节点,机器2从节点,机器3、机器4等都是计算节点。
当主节点宕机后从节点代替主节点工作,正常状态是从节点和计算节点一样工作。
这种架构设计保证数据完整性。
首先我们保证每台计算节点上分别有一个DataNode节点和NodeManager节点。
因为都是计算节点,真正干活的。
在数量上我们要保证。
那么NameNode和ResourceManager是两个非常重要的管理者,我们客户端的请求,第一时间与NameNode 和ResourceManager打交道。
NameNode负责管理HDFS文件系统的元数据,客户端不管是读文件还是写文件,都要首先找到NameNode获取文件的元数据,再进行文件的操作。
ResourceManager也是如此,它负责管理集群中的资源和任务调度,你也可以把它视为“大数据操作系统”。
客户端能否提交应用并运行,就看你的ResourceManager是否正常。
2、达到多大规模的数据,才值得用大数据的方式来处理?
第一,从数据量角度,但是并无确定的答案,一般定性角度来说,你觉得这个数据量单机处理不了,比如内存限制,时间过久等,就用集群,但是要降低时间,你的处理逻辑必须能分布式处理,定量就是一般数据或者未来的数据量会达到PB级别(可能GB)或以上就要用分布式,当然前提也是你的处理逻辑可以进行分布式。
第二,从算法角度,或者处理逻辑的时间复杂度来说,比如虽然你的数据记录不是很多,但是你的算法或者处理逻辑的时间复杂度是n的平方,甚至更高,同时你的算法可以进行分布式设计,那么就考虑用分布式,比如你的记录虽然只有1w, 但是时间复杂度确是n的平方,那么你想想单机要多久,要是你的算法可以进行分布式处理,那么就考虑用分布式。
3、制约大数据处理能力的几个问题
a、网络带宽
网络是联接计算机的纽带,这个纽带当然越宽越好,这样可以在计算机资源许可的情况
下,在单位时间内传输更多的数据,让计算机处理更多的数据。
现在企业网络中,普遍采用的多是百兆网络,也有千兆,万兆虽然有,但是用得不多。
b、磁盘
所有数据,不管它从哪里来,最终都要存进不同的硬盘里面,或者闪存盘。
闪存盘的读写效率比硬盘高得多,但是缺点也明显:价格贵、容量小。
现在的存储介质主要还是硬盘,硬盘有顺序读写和随机读写两种模型。
顺序读写是磁头沿着磁道,好象流水线一样,有规律的向前滚动进行。
随机读写是磁头跳跃着,找到磁道上留空的地方,把数据写进去。
很明显,顺序读写比随机读写效率高,所以系统架构师在设计大数据存储方案时,都是以顺序读写为主要选择。
c、计算机的数量
分布式的集群环境下,计算机的规模当然越大越好。
这样在数据等量的情况下,计算机数量越多,分配给每台计算机的数据越少,处理效率自然就高了。
但是计算机的数量也不是可以无限增加,集群对计算机规模的容纳有一个峰值,超过这个峰值,再提升就很困难,处理不好还会下降。
原因主要来自木桶短板效应、边界效应、规模放大效应。
根据多年前的一个测试,当时以Pentium 3和Pentium 4芯片为基础平台,配合100M网络,在上面运行LAXCUS大数据系统。
当达到千台计算机的规模时,瓶颈开始显露出来。
如果现在用新的X86芯片,加上更高速的网络,应该是能够容纳更多的计算机。
d、代码质量
这不是关键问题,但是是企业必须关注的一个问题。
这和程序员编写的计算机代码质量有关。
实际上,每个大数据产品都是半成品,它们只是提供了一个计算框架,要实际应用到企业生产中,里面还有大量业务编码需要程序员来实现。
要使大数据应用达到高质量,技术负责人要做好前期设计,清楚和规范业务流程,程序员拿到方案后,用统一格式编写代码。
这是双方互相配合的过程。
或者说,要做好协同和协调的事情。
hadoop环境配置以及hadoop伪分布式安装实训目的

Hadoop环境配置以及Hadoop伪分布式安装是用于学习和实践大数据处理和分析的重要步骤。
下面将详细解释配置Hadoop环境以及安装Hadoop伪分布式的目的。
一、Hadoop环境配置配置Hadoop环境是为了在实际的硬件或虚拟机环境中搭建Hadoop集群,包括安装和配置Hadoop的各个组件,如HDFS(Hadoop分布式文件系统)、MapReduce(一种编程模型和运行环境)等。
这个过程涉及到网络设置、操作系统配置、软件安装和配置等步骤。
通过这个过程,用户可以了解Hadoop的基本架构和工作原理,为后续的学习和实践打下基础。
二、Hadoop伪分布式安装Hadoop伪分布式安装是一种模拟分布式环境的方法,它可以在一台或多台机器上模拟多个节点,从而在单机上测试Hadoop的各个组件。
通过这种方式,用户可以更好地理解Hadoop 如何在多台机器上协同工作,以及如何处理大规模数据。
安装Hadoop伪分布式的主要目的如下:1. 理解Hadoop的工作原理:通过在单机上模拟多个节点,用户可以更好地理解Hadoop如何在多台机器上处理数据,以及如何使用MapReduce模型进行数据处理。
2. 练习Hadoop编程:通过在单机上模拟多个节点,用户可以编写和测试Hadoop的MapReduce程序,并理解这些程序如何在单机上运行,从而更好地理解和学习Hadoop编程模型。
3. 开发和调试Hadoop应用程序:通过在单机上模拟分布式环境,用户可以在没有真实数据的情况下开发和调试Hadoop应用程序,从而提高开发和调试效率。
4. 为真实环境做准备:一旦熟悉了Hadoop的伪分布式环境,用户就可以逐渐将知识应用到真实环境中,例如添加更多的实际节点,并开始处理实际的大规模数据。
总的来说,学习和实践Hadoop环境配置以及Hadoop伪分布式安装,对于学习和实践大数据处理和分析具有重要意义。
它可以帮助用户更好地理解和学习Hadoop的工作原理和编程模型,为将来在实际环境中应用和优化Hadoop打下坚实的基础。
Hadoop的安装与配置

Hadoop的安装与配置建立一个三台电脑的群组,操作系统均为Ubuntu,三个主机名分别为wjs1、wjs2、wjs3。
1、环境准备:所需要的软件及我使用的版本分别为:Hadoop版本为0.19.2,JDK版本为jdk-6u13-linux-i586.bin。
由于Hadoop要求所有机器上hadoop的部署目录结构要相同,并且都有一个相同的用户名的帐户。
所以在三台主机上都设置一个用户名为“wjs”的账户,主目录为/home/wjs。
a、配置三台机器的网络文件分别在三台机器上执行:sudo gedit /etc/network/interfaceswjs1机器上执行:在文件尾添加:auto eth0iface eth0 inet staticaddress 192.168.137.2gateway 192.168.137.1netmask 255.255.255.0wjs2和wjs3机器上分别执行:在文件尾添加:auto eth1iface eth1 inet staticaddress 192.168.137.3(wjs3上是address 192.168.137.4)gateway 192.168.137.1netmask 255.255.255.0b、重启网络:sudo /etc/init.d/networking restart查看ip是否配置成功:ifconfig{注:为了便于“wjs”用户能够修改系统设置访问系统文件,最好把“wjs”用户设为sudoers(有root权限的用户),具体做法:用已有的sudoer登录系统,执行sudo visudo -f /etc/sudoers,并在此文件中添加以下一行:wjsALL=(ALL)ALL,保存并退出。
}c、修改三台机器的/etc/hosts,让彼此的主机名称和ip都能顺利解析,在/etc/hosts中添加:192.168.137.2 wjs1192.168.137.3 wjs2192.168.137.4 wjs3d、由于Hadoop需要通过ssh服务在各个节点之间登陆并运行服务,因此必须确保安装Hadoop的各个节点之间网络的畅通,网络畅通的标准是每台机器的主机名和IP地址能够被所有机器正确解析(包括它自己)。
技能竞赛中职组ZZ052-大数据应用与服务赛项赛题第01套

一、背景描述随着中国数字化转型战略的推进,传统通信行业正面临着数字化转型的挑战和机遇;用户对通信服务的需求已经发生了根本性的变化,通信运营商正在通过技术创新和服务升级来满足这些需求;数字化转型涉及到网络建设、数据管理、服务创新等方面,大数据技术成为关键驱动力之一。
为了应对这一转型,我们要求参赛者搭建通信行业大数据分析平台,并利用Hive数仓技术和Spark计算引擎对通信用户行为数据进行操作和分析;通过这样的平台,可以快速处理和挖掘海量数据,得出有价值的洞察和分析结果。
同时,在展示数据分析结果方面,我们要求参赛者结合前端可视化框架ECharts和Python可视化库pyecharts,创建交互式的数据可视化图表;这些图表能够直观地展示数据分析结果,帮助管理者更好地决策企业的发展战略,并对销售、营销、客服和技术等部门的目标策略进行全面部署;通过数据可视化,销售部门可以了解产品销售趋势和市场份额;营销部门可以优化营销活动和广告投放策略;客服部门可以提供更好的客户服务;技术部门可以进行网络优化和故障排查。
二、模块一:平台搭建与运维(一)任务一:大数据平台搭建本模块需要使用root用户完成相关配置;所有组件均在/root/software目录下。
1.子任务一:基础环境准备master、slave1、slave2三台节点都需要安装JDK(1)将JDK安装包解压到/root/software目录下;(2)在“/etc/profile”文件中配置JDK环境变量JAVA_HOME和PATH的值,并让配置文件立即生效;(3)查看JDK版本,检测JDK是否安装成功。
在master节点操作(1)在master上生成SSH密钥对;(2)将master上的公钥拷贝到slave1和slave2上;在master上通过SSH连接slave1和slave2来验证。
2.子任务二:Hadoop 完全分布式安装配置master、slave1、slave2三台节点都需要安装Hadoop (1)在主节点将Hadoop安装包解压到/root/software目录下;(2)依次配置hadoop-env.sh、core-site.xml、hdfs-site.xml、mapred-site.xml、yarn-site.xml和workers配置文件;Hadoop集群部署规划如下表;表1 Hadoop集群部署规划(3)在master节点的Hadoop安装目录下依次创建hadoopDatas/tempDatas、hadoopDatas/namenodeDatas、hadoopDatas/datanodeDatas、hadoopDatas/dfs/nn/edits、hadoopDatas/dfs/snn/name和hadoopDatas/dfs/nn/snn/edits目录;(4)在master节点上使用scp命令将配置完的Hadoop 安装目录直接拷贝至slave1和slave2;(5)三台节点的“/etc/profile”文件中配置Hadoop 环境变量HADOOP_HOME和PATH的值,并让配置文件立即生效;(6)在主节点格式化集群;(7)在主节点依次启动HDFS、YARN集群和历史服务3.子任务三:MySQL安装配置只在master节点操作(1)将MySQL 5.7.25安装包解压到/root/software 目录下;(2)使用rpm -ivh依次安装mysql-community-common、mysql-community- libs、mysql-community-libs-compat、mysql-community-client和mysql-community-server包;(3)安装好MySQL后,使用mysql用户初始化和启动数据库;(4)使用root用户无密码登录MySQL,然后将root用户的密码修改为123456,修改完成退出MySQL,重新登录验证密码是否修改成功;更改“mysql”数据库里的user表里的host项,从localhost改成%即可实现用户远程登录;设置完成刷新配置信息,让其生效。
大数据集群部署方案

八、风险与应对措施
1.技术风险:关注技术动态,及时更新和升级相关软件。
2.数据安全风险:加强数据安全防护措施,定期进行合规性检查。
3.人才短缺:加强团队培训,提高技能水平。
4.成本控制:合理规划项目预算,控制成本。
九、总结
本方案为企业提供了一套完整、科学的大数据集群部署方案,旨在实现高效、稳定的数据处理和分析。通过严谨的技术选型和部署架构设计,确保数据安全、合规性。同时,注重运维保障和人才培养,提高大数据应用能力。在项目实施过程中,积极应对各类风险,确保项目顺利推进,为企业创造持续的业务价值。
二、项目目标
1.搭建一套完整的大数据集群环境,满足业务部门对数据处理、分析、挖掘的需求。
2.确保集群系统的高可用性、高性能、易扩展性,降低运维成本。
3.遵循国家相关法律法规,确保数据安全与合规性。
三、技术选型
1.分布式存储:采用Hadoop分布式文件系统(HDFS)进行数据存储,确保数据的高可靠性和高可用性。
- Kafka集群:用于收集和传输实时数据,支持实时数据处理。
五、数据安全与合规性
1.数据加密:对存储在HDFS上的数据进行加密,防止数据泄露。
2.访问控制:采用Kerberos进行身份认证,结合HDFS权限管理,实现数据访问控制。
3.数据脱敏:对敏感数据进行脱敏处理,确保数据合规使用。
4.审计日志:开启Hadoop审计日志,记录用户操作行为,便于审计和监控。
- ZooKeeper集群:负责集群的分布式协调服务,确保集群的高可用性。
- Kafka集群:用于收集和传输实时数据,为实时数据处理提供支持。
五、数据安全与合规性
1.数据加密:对存储在HDFS上的数据进行加密处理,防止数据泄露。
Hadoop集群的搭建方法与步骤

Hadoop集群的搭建方法与步骤随着大数据时代的到来,Hadoop作为一种分布式计算框架,被广泛应用于数据处理和分析领域。
搭建一个高效稳定的Hadoop集群对于数据科学家和工程师来说至关重要。
本文将介绍Hadoop集群的搭建方法与步骤。
一、硬件准备在搭建Hadoop集群之前,首先要准备好适合的硬件设备。
Hadoop集群通常需要至少三台服务器,一台用于NameNode,两台用于DataNode。
每台服务器的配置应该具备足够的内存和存储空间,以及稳定的网络连接。
二、操作系统安装在选择操作系统时,通常推荐使用Linux发行版,如Ubuntu、CentOS等。
这些操作系统具有良好的稳定性和兼容性,并且有大量的Hadoop安装和配置文档可供参考。
安装操作系统后,确保所有服务器上的软件包都是最新的。
三、Java环境配置Hadoop是基于Java开发的,因此在搭建Hadoop集群之前,需要在所有服务器上配置Java环境。
下载最新版本的Java Development Kit(JDK),并按照官方文档的指引进行安装和配置。
确保JAVA_HOME环境变量已正确设置,并且可以在所有服务器上运行Java命令。
四、Hadoop安装与配置1. 下载Hadoop从Hadoop官方网站上下载最新的稳定版本,并将其解压到一个合适的目录下,例如/opt/hadoop。
2. 编辑配置文件进入Hadoop的安装目录,编辑conf目录下的hadoop-env.sh文件,设置JAVA_HOME环境变量为Java的安装路径。
然后,编辑core-site.xml文件,配置Hadoop的核心参数,如文件系统的默认URI和临时目录。
接下来,编辑hdfs-site.xml文件,配置Hadoop分布式文件系统(HDFS)的相关参数,如副本数量和数据块大小。
最后,编辑mapred-site.xml文件,配置MapReduce框架的相关参数,如任务调度器和本地任务运行模式。
1.Hadoop集群搭建(单机伪分布式)
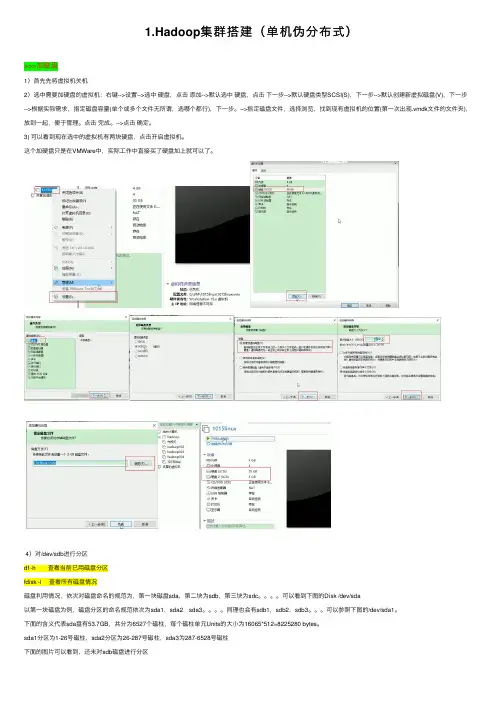
1.Hadoop集群搭建(单机伪分布式)>>>加磁盘1)⾸先先将虚拟机关机2)选中需要加硬盘的虚拟机:右键-->设置-->选中硬盘,点击添加-->默认选中硬盘,点击下⼀步-->默认硬盘类型SCSI(S),下⼀步-->默认创建新虚拟磁盘(V),下⼀步-->根据实际需求,指定磁盘容量(单个或多个⽂件⽆所谓,选哪个都⾏),下⼀步。
-->指定磁盘⽂件,选择浏览,找到现有虚拟机的位置(第⼀次出现.vmdk⽂件的⽂件夹),放到⼀起,便于管理。
点击完成。
-->点击确定。
3) 可以看到现在选中的虚拟机有两块硬盘,点击开启虚拟机。
这个加硬盘只是在VMWare中,实际⼯作中直接买了硬盘加上就可以了。
4)对/dev/sdb进⾏分区df -h 查看当前已⽤磁盘分区fdisk -l 查看所有磁盘情况磁盘利⽤情况,依次对磁盘命名的规范为,第⼀块磁盘sda,第⼆块为sdb,第三块为sdc。
可以看到下图的Disk /dev/sda以第⼀块磁盘为例,磁盘分区的命名规范依次为sda1,sda2,sda3。
同理也会有sdb1,sdb2,sdb3。
可以参照下图的/dev/sda1。
下⾯的含义代表sda盘有53.7GB,共分为6527个磁柱,每个磁柱单元Units的⼤⼩为16065*512=8225280 bytes。
sda1分区为1-26号磁柱,sda2分区为26-287号磁柱,sda3为287-6528号磁柱下⾯的图⽚可以看到,还未对sdb磁盘进⾏分区fdisk /dev/sdb 分区命令可以选择m查看帮助,显⽰命令列表p 显⽰磁盘分区,同fdisk -ln 新增分区d 删除分区w 写⼊并退出选w直接将分区表写⼊保存,并退出。
mkfs -t ext4 /dev/sdb1 格式化分区,ext4是⼀种格式mkdir /newdisk 在根⽬录下创建⼀个⽤于挂载的⽂件mount /dev/sdb1 /newdisk 挂载sdb1到/newdisk⽂件(这只是临时挂载的解决⽅案,重启机器就会发现失去挂载)blkid /dev/sdb1 通过blkid命令⽣成UUIDvi /etc/fstab 编辑fstab挂载⽂件,新建⼀⾏挂载记录,将上⾯⽣成的UUID替换muount -a 执⾏后⽴即⽣效,不然的话是重启以后才⽣效。
Hadoop集群搭建步骤
Hadoop集群搭建步骤1.先建⽴⼀台虚拟机,分配内存2G,硬盘20G,⽹络为nat 模式,设置⼀个静态的ip 地址: 例如设定3台机器的ip 为192.168.63.167(master) 192.16863.168(slave1) 192.168.63.169 (slave2)2.修改第⼀台主机的⽤户名3.复制master⽂件两次,重命名为slave1和slave2,打开虚拟机⽂件,然后按照同样的⽅法设置两个节点的ip和主机名4.建⽴主机名和ip的映射5.查看是否能ping通,关闭防⽕墙和selinux 配置6.配置ssh免密码登录在root⽤户下输⼊ssh-keygen -t rsa ⼀路回车秘钥⽣成后在~/.ssh/⽬录下,有两个⽂件id_rsa(私钥)和id_rsa.pub(公钥),将公钥复制到authorized_keys并赋予authorized_keys600权限同理在slave1和slave2节点上进⾏相同的操作,然后将公钥复制到master节点上的authoized_keys检查是否免密登录(第⼀次登录会有提⽰)7..安装JDK(省去)三个节点安装java并配置java环境变量8.安装MySQL(master 节点省去)9.安装SecureCRT或者xshell 客户端⼯具,然后分别链接上 3台服务器12.搭建集群12.1 集群结构三个结点:⼀个主节点master两个从节点内存2GB 磁盘20GB12.2 新建hadoop⽤户及其⽤户组⽤adduser新建⽤户并设置密码将新建的hadoop⽤户添加到hadoop⽤户组前⾯hadoop指的是⽤户组名,后⼀个指的是⽤户名赋予hadoop⽤户root权限12.3 安装hadoop并配置环境变量由于hadoop集群需要在每⼀个节点上进⾏相同的配置,因此先在master节点上配置,然后再复制到其他节点上即可。
将hadoop包放在/usr/⽬录下并解压配置环境变量在/etc/profile⽂件中添加如下命令12.4 搭建集群的准备⼯作在master节点上创建以下⽂件夹/usr/hadoop-2.6.5/dfs/name/usr/hadoop-2.6.5/dfs/data/usr/hadoop-2.6.5/temp12.5 配置hadoop⽂件接下来配置/usr/hadoop-2.6.5/etc//hadoop/⽬录下的七个⽂件slaves core-site.xml hdfs-site.xml mapred-site.xml yarn-site.xml hadoop-env.sh yarn-env.sh配置hadoop-env.sh配置yarn-env.sh配置slaves⽂件,删除localhost配置core-site.xml配置hdfs-site.xml配置mapred-site.xml配置yarn-site.xml将配置好的hadoop⽂件复制到其他节点上12.6 运⾏hadoop格式化Namenodesource /etc/profile13. 启动集群。
hadoop分布式环境搭建实验总结
hadoop分布式环境搭建实验总结Hadoop分布式环境搭建实验总结一、引言Hadoop是目前最流行的分布式计算框架之一,它具有高可靠性、高扩展性和高效性的特点。
在本次实验中,我们成功搭建了Hadoop分布式环境,并进行了相关测试和验证。
本文将对实验过程进行总结和归纳,以供参考。
二、实验准备在开始实验之前,我们需要准备好以下几个方面的内容:1. 硬件环境:至少两台具备相同配置的服务器,用于搭建Hadoop 集群。
2. 软件环境:安装好操作系统和Java开发环境,并下载Hadoop 的安装包。
三、实验步骤1. 安装Hadoop:解压Hadoop安装包,并根据官方文档进行相应的配置,包括修改配置文件、设置环境变量等。
2. 配置SSH无密码登录:为了实现集群间的通信,需要配置各个节点之间的SSH无密码登录。
具体步骤包括生成密钥对、将公钥分发到各个节点等。
3. 配置Hadoop集群:修改Hadoop配置文件,包括core-site.xml、hdfs-site.xml和mapred-site.xml等,设置集群的基本参数,如文件系统地址、数据存储路径等。
4. 启动Hadoop集群:通过启动NameNode、DataNode和ResourceManager等守护进程,使得集群开始正常运行。
可以通过jps命令来验证各个进程是否成功启动。
5. 测试Hadoop集群:可以使用Hadoop自带的例子程序进行测试,如WordCount、Sort等。
通过执行这些程序,可以验证集群的正常运行和计算能力。
四、实验结果经过以上步骤的操作,我们成功搭建了Hadoop分布式环境,并进行了相关测试。
以下是我们得到的一些实验结果:1. Hadoop集群的各个节点正常运行,并且能够相互通信。
2. Hadoop集群能够正确地处理输入数据,并生成期望的输出结果。
3. 集群的负载均衡和容错能力较强,即使某个节点出现故障,也能够继续运行和处理任务。
基于Hadoop的大数据处理与分析平台搭建与优化
基于Hadoop的大数据处理与分析平台搭建与优化一、引言随着互联网和物联网技术的快速发展,大数据已经成为当今社会中不可或缺的一部分。
大数据处理与分析平台的搭建与优化对于企业来说至关重要。
Hadoop作为目前最流行的大数据处理框架之一,其在大数据领域有着广泛的应用。
本文将重点介绍基于Hadoop的大数据处理与分析平台的搭建与优化。
二、Hadoop简介Hadoop是一个开源的分布式计算平台,可以对大规模数据进行存储和处理。
它包括Hadoop Distributed File System(HDFS)和MapReduce两个核心组件。
HDFS用于存储数据,而MapReduce用于处理数据。
除此之外,Hadoop生态系统还包括Hive、Pig、HBase、Spark等工具和框架,为用户提供了丰富的功能和工具。
三、大数据处理与分析平台搭建1. 硬件环境准备在搭建大数据处理与分析平台之前,首先需要准备适当的硬件环境。
通常情况下,需要考虑服务器数量、内存大小、存储容量等因素。
同时,为了保证系统的稳定性和性能,建议采用高可靠性的硬件设备。
2. 软件环境准备在硬件环境准备完成后,接下来需要安装和配置Hadoop及其相关组件。
可以选择使用Apache Hadoop或者Cloudera、Hortonworks等发行版。
在安装过程中,需要注意版本兼容性以及各组件之间的依赖关系。
3. 配置Hadoop集群配置Hadoop集群是搭建大数据处理与分析平台的关键步骤之一。
需要配置主节点(NameNode、ResourceManager)和从节点(DataNode、NodeManager),并确保集群中各节点之间可以正常通信。
4. 数据导入与处理在搭建好Hadoop集群后,可以开始导入数据并进行处理。
可以通过Sqoop将关系型数据库中的数据导入到HDFS中,也可以通过Flume实时收集日志数据。
同时,可以编写MapReduce程序或使用Spark进行数据处理和分析。
大数据--Hadoop集群环境搭建
⼤数据--Hadoop集群环境搭建⾸先我们来认识⼀下HDFS, HDFS(Hadoop Distributed File System )Hadoop分布式⽂件系统。
它其实是将⼀个⼤⽂件分成若⼲块保存在不同服务器的多个节点中。
通过联⽹让⽤户感觉像是在本地⼀样查看⽂件,为了降低⽂件丢失造成的错误,它会为每个⼩⽂件复制多个副本(默认为三个),以此来实现多机器上的多⽤户分享⽂件和存储空间。
Hadoop主要包含三个模块:HDFS模块:HDFS负责⼤数据的存储,通过将⼤⽂件分块后进⾏分布式存储⽅式,突破了服务器硬盘⼤⼩的限制,解决了单台机器⽆法存储⼤⽂件的问题,HDFS是个相对独⽴的模块,可以为YARN提供服务,也可以为HBase等其他模块提供服务。
YARN模块:YARN是⼀个通⽤的资源协同和任务调度框架,是为了解决Hadoop中MapReduce⾥NameNode负载太⼤和其他问题⽽创建的⼀个框架。
YARN是个通⽤框架,不⽌可以运⾏MapReduce,还可以运⾏Spark、Storm等其他计算框架。
MapReduce模块:MapReduce是⼀个计算框架,它给出了⼀种数据处理的⽅式,即通过Map阶段、Reduce阶段来分布式地流式处理数据。
它只适⽤于⼤数据的离线处理,对实时性要求很⾼的应⽤不适⽤。
多相关信息可以参考博客:。
本节将会介绍Hadoop集群的配置,⽬标主机我们可以选择虚拟机中的多台主机或者多台阿⾥云服务器。
注意:以下所有操作都是在root⽤户下执⾏的,因此基本不会出现权限错误问题。
⼀、Vmware安装VMware虚拟机有三种⽹络模式,分别是Bridged(桥接模式)、NAT(⽹络地址转换模式)、Host-only(主机模式):桥接:选择桥接模式的话虚拟机和宿主机在⽹络上就是平级的关系,相当于连接在同⼀交换机上;NAT:NAT模式就是虚拟机要联⽹得先通过宿主机才能和外⾯进⾏通信;仅主机:虚拟机与宿主机直接连起来。