
spss 聚类分析例题
1.打开数据文件后,在数据编辑窗口中,从菜单栏中选择“分析”—“分类”—“k-均值
聚类”命令。
2.在该对话框中选择变量城市进入“个案标记依据”文本框,作为标签变量。
把聚类数标
记为4次。
3.选择变量一至十二月份的日照时数进入“变量”列表框作为观测变量。
4.单击“迭代”按钮,迭代次数为10次,收敛性标准为0.
5.单击“保存”按钮,选择“聚类成员”。
6.单击“选项”按钮,选择“初始聚类中心”和“ANOVA表”,要求输出方差分析表,单
击“继续”。
7.单击“确定”按钮,执行快速聚类分析。
[数据集1] C:\Documents and Settings\Administrator\桌面\ch9\主要城市日照时数.sav
初始聚类中心
聚类
1 2 3 4
一月日照时数89.10 9.00 230.10 121.70
二月日照时数145.40 45.00 215.30 104.40
三月日照时数153.20 49.20 234.20 55.30
四月日照时数258.50 150.50 207.10 83.40
五月日照时数284.00 99.60 196.80 125.00
六月日照时数309.70 99.10 122.60 176.50
七月日照时数320.80 190.90 151.10 155.80
八月日照时数292.80 175.40 151.30 167.10
九月日照时数266.10 80.20 127.10 185.00
十月日照时数223.70 33.00 146.70 246.50
十一月日照时数95.00 38.50 148.70 165.10
十二月日照时数57.30 4.30 173.10 181.60
聚类成员
案例号城市聚类距离
1 北京 3 71.891
2 天津
3 58.065
3 石家庄 3 75.011
4 太原 3 79.367
5 呼和浩特 1 93.126
6 沈阳 3 103.571
7 大连 3 84.560
8 长春 1 104.478
9 哈尔滨 1 109.339
10 上海 4 83.421
11 南京 4 93.132
12 杭州 4 106.768
13 合肥 4 114.034
14 福州 4 77.960
15 南昌 4 106.546
16 济南 3 68.849
17 青岛 3 73.287
18 郑州 3 163.495
19 武汉 4 83.593
20 长沙 4 106.264
21 广州 4 153.706
22 南宁 4 141.699
23 海口 4 121.824
24 桂林 4 129.268
25 重庆 2 77.363
26 温江 2 45.340
27 贵阳 2 70.612
28 昆明 3 144.631
29 拉萨 3 222.401
30 西安 3 150.920
31 兰州 1 88.706
32 西宁 3 118.960
33 银川 1 74.972
34 乌鲁木齐 1 159.286
二月日照时数178.92 61.10 202.01 132.88 三月日照时数219.43 57.43 205.88 109.94 四月日照时数259.28 138.13 233.58 160.83 五月日照时数266.65 103.57 239.65 165.79 六月日照时数272.83 85.03 193.83 170.65 七月日照时数262.23 152.23 178.07 222.88 八月日照时数254.73 138.80 161.74 198.18 九月日照时数227.52 84.93 185.39 172.68 十月日照时数218.63 44.53 199.05 203.21 十一月日照时数151.55 48.13 178.74 147.01 十二月日照时数121.30 50.37 136.94 127.51
每个聚类中的案例数
聚类 1 6.000
2 3.000
3 13.000
4 12.000 有效34.000 缺失.000。
SPSS聚类分析加具体案例
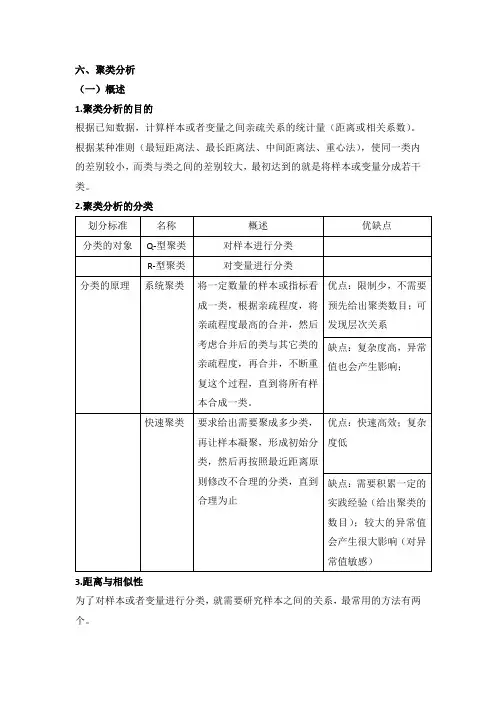
六、聚类分析(一)概述1.聚类分析的目的根据已知数据,计算样本或者变量之间亲疏关系的统计量(距离或相关系数)。
根据某种准则(最短距离法、最长距离法、中间距离法、重心法),使同一类内的差别较小,而类与类之间的差别较大,最初达到的就是将样本或变量分成若干类。
2.聚类分析的分类3.距离与相似性为了对样本或者变量进行分类,就需要研究样本之间的关系,最常用的方法有两个。
(二)系统聚类1.系统聚类的步骤距离的具体定义及计算方式计算n各样本两两之间的距离将距离接近的数据依次合并为一类,再计算,再合并 画聚类图,解释类与类之间的关系2.亲疏程度度量方法3.系统聚类的分类4.SPSS操作及实例SPSS采用的是凝聚法。
案例:根据30个省的23个主要行业的平均工资情况,通过聚类分析来判断哪些地区平均工资水平高。
SPSS操作及结果:打开SPSS上方菜单栏中的分析->分类->系统聚类选择变量->勾选统计量->在绘制里选择树状图和冰柱图勾选方法(通常使用组间联接)->度量区间->选择标准化方式(全距从0到1)下图为近似矩阵表,标注了相关系数,数值越大,距离越接近下图为聚类分析结果表,第一类表示这是聚类分析的第几步,第二三列表示该步中那几个样本或者小类聚成一类,第四列表示距离,第五六列表示本步骤中参与的是个体还是小类(0表示样本,非0表示第n步生成的小类),第七列表示本步骤的聚类结果将在以下第几步中用到。
下面是冰柱图和树状图的结果,根据树状图可以看出,如果分为三类的话,第一类包括北京上海,第二类包括天津、广东、浙江、江苏、西藏,剩下的归为一类。
(三)快速聚类(适合大样本聚类)1.快速聚类的步骤指定聚类数目K确定K个初始类的中心(自定义或者根据数据中心初步确定)根据距离最近的原则进行分类根据新的中心位置,重新计算每一记录距离新的类别中心的的距离,并重新分类重复步骤4,直到达到标准2.SPSS操作及实例打开SPSS上方菜单栏中的分析->分类->K-均值聚类选择变量->勾选统计量->定义变量值选择迭代次数->选项(勾选初始聚类中心、每个个案的聚类信息)->定义变量值->保存(勾选聚类成员、聚类中心距离)下图为输出的初始聚类中心下图为最终距离中心,第一类平均工资最高,第二类次之,第三类最低下图为每个聚类中的案例数和聚类成员。
spss聚类分析案例
spss聚类分析案例在进行SPSS聚类分析时,我们通常会遵循一系列步骤来确保分析的准确性和有效性。
以下是一个典型的聚类分析案例,展示了如何使用SPSS软件进行数据分析。
首先,我们需要收集数据。
数据可以是定量的,也可以是定性的,但必须与研究问题相关。
例如,如果我们正在研究消费者购买行为,我们可能会收集关于消费者年龄、收入、购买频率和偏好的数据。
接下来,我们将数据导入SPSS。
这可以通过直接输入数据、从Excel文件导入或使用SPSS的数据导入向导来完成。
一旦数据在SPSS中,我们需要检查数据的准确性和完整性,确保没有缺失值或异常值。
在进行聚类分析之前,我们通常需要对数据进行预处理。
这可能包括标准化变量、处理缺失值和异常值,以及可能的变量转换。
标准化是重要的,因为它确保了所有变量在聚类分析中具有相同的权重。
然后,我们选择聚类方法。
SPSS提供了几种聚类方法,包括K-means聚类、层次聚类和双向聚类。
选择哪种方法取决于数据的特性和研究目的。
例如,如果我们有明确的类别数量,K-means聚类可能是合适的;如果我们希望看到数据的层次结构,层次聚类可能更合适。
在选择了聚类方法后,我们需要确定聚类的数量。
这可以通过多种方法来确定,包括肘部方法、轮廓系数或基于信息准则的方法。
确定聚类数量后,我们可以运行聚类算法,并将数据点分配到不同的聚类中。
聚类完成后,我们需要评估聚类的质量。
这可以通过查看聚类的内部一致性和聚类之间的差异来完成。
我们还可以进行统计测试,如ANOVA或卡方检验,来检验聚类是否在统计上显著。
最后,我们解释聚类结果。
这包括识别每个聚类的特征,以及这些特征如何与研究问题相关。
例如,如果我们发现一个聚类主要由高收入、频繁购买的消费者组成,这可能表明这是一个高价值的市场细分。
在整个聚类分析过程中,我们可能会进行多次迭代,调整聚类方法、聚类数量或数据预处理步骤,以获得最佳的聚类结果。
聚类分析是一个动态的过程,需要根据数据和研究目的进行调整。
聚类分析 spss
聚类分析聚类分析的目的是将资料按相似程度进行分类。
分类的对象可以是指标(变量)也可以是观测数据。
分类方法大致可分为两类:系统聚类法和非系统聚类法。
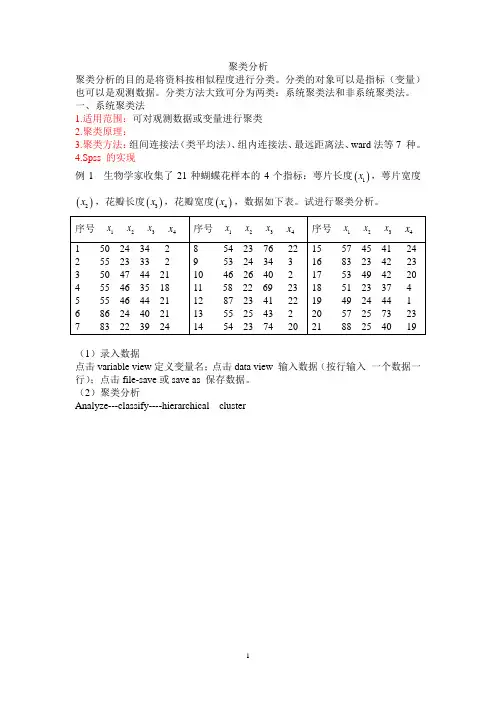
一、系统聚类法1.适用范围:可对观测数据或变量进行聚类2.聚类原理:3.聚类方法:组间连接法(类平均法)、组内连接法、最远距离法、ward 法等7 种。
4.Spss 的实现例1 生物学家收集了21种蝴蝶花样本的4个指标:萼片长度()1x ,萼片宽度()2x ,花瓣长度()3x ,花瓣宽度()4x ,数据如下表。
试进行聚类分析。
序号 1x 2x 3x 4x序号 1x 2x 3x 4x序号 1x 2x 3x 4x1 50 24 342 2 55 23 33 2 3 50 47 44 21 4 55 46 35 18 5 55 46 44 21 6 86 24 40 217 83 22 39 248 54 23 76 229 53 24 34 3 10 46 26 40 2 11 58 22 69 23 12 87 23 41 22 13 55 25 43 2 14 54 23 74 20 15 57 45 41 24 16 83 23 42 23 17 53 49 42 20 18 51 23 37 4 19 49 24 44 1 20 57 25 73 23 21 88 25 40 19(1)录入数据点击variable view 定义变量名;点击data view 输入数据(按行输入 一个数据一行);点击file-save 或save as 保存数据。
(2)聚类分析Analyze---classify----hierarchical cluster主对话框界面说明:Variables 框:用于选入进行聚类分析的变量。
Label cases by框:选入标签变量,如果选入,该变量的取值将在分析结果中取代记录号出现。
该框只在样品聚类时可用。
Cluster框:用于选择是进行样品聚类还是变量聚类,默认前者。
《SPSS数据分析与应用》第6章 聚类分析
• 当纵坐标为13时,15个样本被12个白色 间隙分隔为13类。
系统聚类的结果解读
冰柱图聚类进程(最后一步)
依次类推,直到将15个样本全部 聚为一类,在15个样本之间没有 白色间隙,表示系统聚类结束。
• 测度观测点之间“亲疏”程度的方法与K-means聚类相同。 • 观测点与小类、小类与小类之间“亲疏”程度的测度,常用的方法有以下几种:
(1)重心法 (2)最近邻元素法 (3)组间平均联接法 (4)组间平均联接法 (5)离差平方和法
系统聚类的基本操作
第一步:用SPSS打开数据文件“移动通信客户_样本15.sav”。 第二步:在菜单栏中选择【分析(A)】→【描述统计(E)】→【描述(D)】,在弹出的 “描述”对话框的左下 角勾选【将标准化值另存为变量(Z)】,将已有的 6 个连续性变量都选到【变量(V)】列表框中,单击【确定】 按钮。
第四步:在“K均值聚类分析”对话框中单击右上角的【迭代(I)】按钮,在弹出的“K-均值聚类分析:迭代” 对话框中将【最大迭代次数(M)】修改为“50”,【收敛准则(C)】暂时不做修改。单击【继续(C)】按钮, 回到“K 均值聚类分析” 对话框。
K-Means聚类的基本操作
第五步:在“K均值聚类分析”对话框中单击右上角的【保存 (S)】按钮,在弹出的“K-均值聚类:保存新 变量”对话框中勾选【聚类成员(C)】和【与聚类中心的距离(D)】。单击【继续(C)】按钮,回到“K均 值聚类分析”对话框。
第一,如何测度样本的“亲疏程度”; 第二,如何进行聚类
K-means聚类对“亲疏程度”的测度
第九章SPSS的聚类分析PPT课件

中心位置变化较小.其中最大的变化率小于2%.
29
K-means快速聚类
(三)基本操作步骤
A.菜单选项:analyze->classify->k means cluster B.选定参加快速聚类分析的变量到variables框 C.确定快速聚类的类数(number of clusters).类数应小
第九章 SPSS的聚类分析
1
聚类分析概述
• 概念:
– 聚类分析是统计学中研究“物以类聚”的一种方法,属多元统计分析方法. – 例如:细分市场、消费行为划分
• 聚类分析是建立一种分类,是将一批样本(或变量)按照在性质上的“亲疏” 程度,在没有先验知识的情况下自动进行分类的方法.其中:类内个体具有 较高的相似性,类间的差异性较大.
•(张三,李四) 2: a=0 b=0 c=1 d=2 J(x,y)=1/1=1 (不相同)
11
聚类分析概述
• 品质型个体间的距离
– Jaccard系数举例:根据临床表现研究病人是否有类似的病
•姓名 性别 发烧 咳嗽 检查1 检查2 检查3 检查4
•张三 男 1 0 1 0 0
0
•李四 女 1 0 1 0 1
•姓名 授课方式 上机时间 选某门课程
•张三
1
1
1
•李四
1
1
0
•王五
0
0
1
•(张三,李四):a=2 b=1 c=0 d=0 d(x,y)=1/(1+2)=1/3
•(张三,王五):a=1 b=2 c=0 d=0 d(x,y)=2/(1+2)=2/3
SPSS案例-因子分析结果聚类
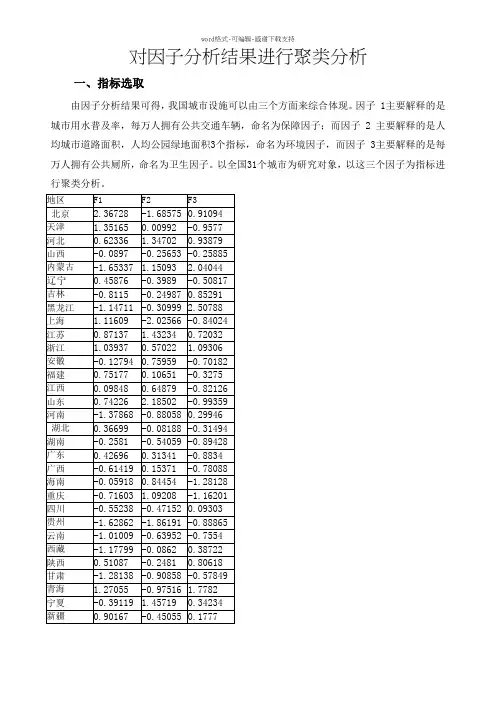
对因子分析结果进行聚类分析
一、指标选取
由因子分析结果可得,我国城市设施可以由三个方面来综合体现。
因子 1主要解释的是城市用水普及率,每万人拥有公共交通车辆,命名为保障因子;而因子 2 主要解释的是人均城市道路面积,人均公园绿地面积3个指标,命名为环境因子,而因子 3主要解释的是每万人拥有公共厕所,命名为卫生因子。
以全国31个城市为研究对象,以这三个因子为指标进行聚类分析。
二、对数据进行系统聚类分析
三、快速聚类结果
四、得出结论
根据系统聚类法的输出结果,可以看出,第一类城市包括北京与上海,第三类包括黑龙江与内蒙古,其他城市为第二类。
显然,第一类城市设施较好,第二类次之,第三类最差。
SPSS教程-聚类分析-附实例操作
各地区各行业工资水平的分析(2009年数据)小组成员:张艺伟、赵月、陈媛、邹莉、朱海龙、曾磊、胡瑛、候银萍1.研究背景及意义1.1 研究背景工资水平是指一定区域和一定时间内劳动者平均收入的高低程度。
生产决定分配,只有经济发展才能提供更多的可分配的社会产品,因此一个地区的工资水平在一定程度上反映了其经济发展的水平。
1.2 研究意义1. 通过多元统计分析方法,探究一个地区的工资水平与其经济发展水平之间的内在联系。
2. 将平均工资水平划分为3类,分析哪些地区、哪些行业的工资水平较高,可以为大学生就业提供宏观上的方向指引。
2.数据来源与描述2.1 数据来源——《中国劳动统计年鉴─2010》(URL:/Navi/YearBook.aspx?id=N2011010069&floor=1###)主编单位:国家统计局人口和就业统计司,人力资源和社会保障部规划财务司出版社:中国统计出版社简介:《中国劳动统计年鉴─2010》是一部全面反映中华人民共和国劳动经济情况的资料性年刊。
本刊收集了2009年全国和各省、自治区、直辖市、香港特别行政区、澳门特别行政区的有关劳动统计数据。
本书资料的取得形式主要有国家和部门的报表统计、行政记录和抽样调查。
2.2 数据描述本数据集记录了全国31个省市(港、澳、台除外)的工资状况,各省市分别记录了其23个主要行业的平均工资水平,这23个主要行业包括:企业、事业、机关、金融业、制造业、建筑业、房地产业、农林牧渔业等等,具体数据格式参见图-0。
图-03.分析方法及原理3.1 通过描述统计分析方法,判断哪些行业平均工资水平较高描述统计分析方法主要是从基本统计量(诸如均值、方差、标准差、极大/小值、偏度、峰度等)的计算和描述开始的,并辅助于SPSS提供的图形功能,能够把握数据的基本特征和整体的分布特征。
在本案例中,通过比较不同行业(诸如企业、事业、机关、建筑业、制造业……)工资的均值、极大/小值,可以从总体上判断哪些行业的平均工资水平较高,哪些行业的较低。
spss软件聚类分析案例
spss软件聚类分析案例案例一:选择那些变量进行聚类?——采用“R型聚类”1、现在我们有4个变量用来对啤酒分类,是否有必要将4个变量都纳入作为分类变量呢?热量、钠含量、酒精含量这3个指标是要通过化验员的辛苦努力来测定,而且还有花费不少成本,如果都纳入分析的话,岂不太麻烦太浪费?所以,有必要对4个变量进行降维处理,这里采用spss R型聚类(变量聚类),对4个变量进行降维处理。
输出“相似性矩阵”有助于我们理解降维的过程。
2、4个分类变量量纲各自不同,这一次我们先确定用相似性来测度,度量标准选用pearson系数,聚类方法选最远元素,此时,涉及到相关,4个变量可不用标准化处理,将来的相似性矩阵里的数字为相关系数。
若果有某两个变量的相关系数接近1或-1,说明两个变量可互相替代。
只输出“树状图”就可以了,个人觉得冰柱图很复杂,看起来没有树状图清晰明了。
从proximity matrix表中可以看出热量和酒精含量两个变量相关系数0.903,最大,二者选其一即可,没有必要都作为聚类变量,导致成本增加。
至于热量和酒精含量选择哪一个作为典型指标来代替原来的两个变量,可以根据专业知识或测定的难易程度决定。
(与因子分析不同,是完全踢掉其中一个变量以达到降维的目的。
)这里选用酒精含量,至此,确定出用于聚类的变量为:酒精含量,钠含量,价格。
案例二:20中啤酒能分为几类?——采用“Q型聚类”现在开始对20中啤酒进行聚类。
开始不确定应该分为几类,暂时用一个3-5类范围来试探。
Q型聚类要求量纲相同,所以我们需要对数据标准化,这一回用欧式距离平方进行测度。
2、主要通过树状图和冰柱图来理解类别。
最终是分为4类还是3类,这是个复杂的过程,需要专业知识和最初的目的来识别。
我这里试着确定分为4类。
选择“保存”,则在数据区域内会自动生成聚类结果。
案例三:用于聚类的变量对聚类过程、结果又贡献么,有用么?——采用“单因素方差分析”1、聚类分析除了对类别的确定需讨论外,还有一个比较关键的问题就是分类变量到底对聚类有没有作用有没有贡献,如果有个别变量对分类没有作用的话,应该剔除。
spss聚类分析例题
1.打开数据文件后,在数据编辑窗口中,从菜单栏中选择“分析”—“分类”—“k-均值
聚类”命令。
2.在该对话框中选择变量城市进入“个案标记依据”文本框,作为标签变量。
把聚类数标
记为4次。
3.选择变量一至十二月份的日照时数进入“变量”列表框作为观测变量。
4.单击“迭代”按钮,迭代次数为10次,收敛性标准为0.
5.单击“保存”按钮,选择“聚类成员”。
6.单击“选项”按钮,选择“初始聚类中心”和“ANOVA表”,要求输出方差分析表,单
击“继续”。
7.单击“确定”按钮,执行快速聚类分析。
[数据集1] C:\Documents and Settings\Administrator\桌面\ch9\主要城市日照时数.sav
每个聚类中的案例数。
聚类判别分析SPSS练习题
聚类判别分析SPSS练习题1. 现有22名⽩⾎病病⼈的九种基因表达的cDNA微阵列扫描数据(X1~X9),根据X1~X9 的变量信息,对该22名⽩⾎病病⼈予以分类。
(具体数据见下表1)采⽤SPSS软件进⾏操作并回答以下问题:(个体聚类。
变量聚类)此题为个体聚类(1)采⽤什么分析⽅法?写出该⽅法在SPSS软件中的路径;聚类分析classify——hierarchical(2)该分析⽅法中采⽤什么统计指标进⾏度量的?个体聚类⽤⽤欧式距离平⽅。
距离越远就不可能聚类。
指标聚类⽤相关系数⼤⼩(3)根据结果中的什么图从⽽将该22名⽩⾎病病⼈分成3类?同时写出归为同⼀类的个体序号。
第⼀类8、21、1、4.第⼆类6、11 第三类剩下的《资料的表现形式是⽆序的、》聚类之后可以判别、、表1 ⽩⾎病⼈的九种基因表达序号X1X2X3X4X5X6X7X8X91 2.57403 2.53782 2.53403 2.12710 2.00000 2.00000 2.00000 2.53656 2.445602 2.87448 2.80686 2.88366 2.74036 2.00000 2.00000 2.30320 3.26623 3.432813 2.55991 2.00000 2.56820 2.00000 2.56348 2.00000 2.45637 2.98543 3.386504 2.65031 2.27646 2.37291 2.01703 2.00000 2.10721 2.00000 2.45637 2.586595 3.12352 2.53656 2.65128 2.34830 2.26482 2.17026 2.43775 3.15746 3.808956 3.14551 2.72263 3.02857 2.00000 3.18724 2.00000 2.85248 3.11327 3.178987 2.77452 2.01703 2.52504 2.22011 2.77452 2.00000 2.00000 2.83442 3.786118 3.05231 2.60097 2.43297 2.16435 2.31597 2.22789 2.65992 2.95182 2.000009 2.97497 2.34044 2.77452 2.35025 2.00000 2.00000 2.00000 2.87448 3.3163910 3.00817 2.81291 2.65992 2.00000 2.03743 2.00000 2.57519 3.02078 3.2195811 2.95617 2.88138 2.61700 2.00000 2.71600 2.00000 2.51188 3.00689 3.3442012 3.01578 2.41996 2.59879 2.22789 2.00000 2.29226 2.34439 2.80209 3.7668613 2.72263 2.41664 2.16137 2.00000 2.60314 2.00000 2.44716 2.87622 3.0751814 2.98046 2.99211 2.69810 2.00000 2.00000 2.16435 2.55751 2.96379 3.3546815 2.95665 2.41996 2.48430 2.00000 2.13354 2.00000 2.00000 2.72916 3.1711416 3.04297 2.37658 2.29885 2.36736 2.30750 2.00860 2.10380 2.78319 3.4026117 2.62221 2.54033 2.54777 2.00000 2.70329 2.00000 2.00000 2.65896 3.1309818 3.13481 2.00000 2.47129 2.08279 2.04139 2.46687 2.66087 2.79029 3.2953519 2.98767 2.47129 2.78032 2.00000 2.09691 2.00000 2.68931 2.77232 2.8561220 2.92993 2.30103 2.58659 2.03743 2.00000 2.02119 2.00000 2.79518 3.2372921 3.05231 2.60097 2.43297 2.16435 2.31597 2.22789 2.65992 2.95182 2.0000022 3.02325 2.83569 2.77525 2.61490 2.00000 2.00000 2.47857 3.46419 3.51322 2. 为明确诊断出⼩⼉肺炎三种类型, 某研究单位测得30名结核性、12名化脓性和18细菌性肺炎患⼉共60名的6项⽣理、⽣化指标(具体数据见下表2), 试进⾏判别分析。