
匈牙利算法简介
匈牙利算法
匈牙利算法是由匈牙利数学家Edmonds于1965年提出,因而得名。
匈牙利算法是基于Hall定理中充分性证明的思想,它是部图匹配最常见的算法,该算法的核心就是寻找增广路径,它是一种用增广路径求二分图最大匹配的算法。
设G=(V,E)是一个无向图。
如顶点集V可分割为两个互不相交的子集V1,V2之并,并且图中每条边依附的两个顶点都分属于这两个不同的子集。
则称图G 为二分图。
二分图也可记为G=(V1,V2,E)。
给定一个二分图G,在G的一个子图M中,M的边集{E}中的任意两条边都不依附于同一个顶点,则称M是一个匹配。
选择这样的子集中边数最大的子集称为图的最大匹配问题(maximal matching problem)
如果一个匹配中,图中的每个顶点都和图中某条边相关联,则称此匹配为完全匹配,也称作完备,完美匹配。
编辑本段
算法描述
求最大匹配的一种显而易见的算法是:先找出全部匹配,然后保留匹配数最多的。
但是这个算法的时间复杂度为边数的指数级函数。
因此,需要寻求一种更加高效的算法。
下面介绍用增广路求最大匹配的方法(称作匈牙利算法,匈牙利数学家Edmonds于1965年提出)。
增广路的定义(也称增广轨或交错轨):
若P是图G中一条连通两个未匹配顶点的路径,并且属于M的边和不属于
M的边(即已匹配和待匹配的边)在P上交替出现,则称P为相对于M的一条增广路径。
由增广路的定义可以推出下述三个结论:
1-P的路径个数必定为奇数,第一条边和最后一条边都不属于M。
2-将M和P进行取反操作可以得到一个更大的匹配M’。
3-M为G的最大匹配当且仅当不存在M的增广路径。
算法轮廓:
(1)置M为空
(2)找出一条增广路径P,通过异或操作获得更大的匹配M’代替M
(3)重复(2)操作直到找不出增广路径为止
编辑本段
时间空间复杂度
时间复杂度邻接矩阵:最坏为O(n^3) 邻接表:O(mn)
空间复杂度邻接矩阵:O(n^2) 邻接表:O(m+n)
邻接表-C++
#include <iostream>
#include <cstring>
using namespace std;
//定义链表
struct link
{
int data; //存放数据
link* next; //指向下一个节点
link(int=0);
};
link::link(int n)
{
data=n;
next=NULL;
}
int n1,n2,m,ans=0;
int result[101]; //记录n1中的点匹配的点的编号//?????????????????????????????????pass 一一对应保存结果
bool state [101]; //记录n1中的每个点是否被搜索过
link *head [101]; //记录n2中的点的邻接节点
link *last [101]; //邻接表的终止位置记录
//判断能否找到从节点n开始的增广路
bool find(const int n)
{
link* t=head[n];
while (t!=NULL) //n仍有未查找的邻接节点时
{
if (!(state[t->data])) //如果邻接点t->data未被查找过
{
state[t->data]=true; //标记t->data为已经被找过
if ((result[t->data]==0) || //如果t->data不属于前一个匹配M
(find(result[t->data]))) //如果t->data匹配到的节点可以寻找到增广路????????????????????pass
{
result[t->data]=n; //那么可以更新匹配M',其中n1中的点t->data匹配n return true; //返回匹配成功的标志
}
}
t=t->next; //继续查找下一个n的邻接节点
}
return false;
}
int main()
{
int t1=0, t2=0;
cin>>n1>>n2>>m;
for (int i=0; i<m; i++)
{
cin>>t1>>t2;
if (last[t1]==NULL)
last[t1]=head[t1]
=new link(t2);
else
last[t1]=last[t1]->next
=new link(t2);
}
for (int i=1; i<=n1; i++)
{
memset(state, 0, sizeof(state));
if (find(i)) ans++;
}
cout<<ans<<endl;
return 0;
}
邻接矩阵——C++
第一个节点的flag不就一直是零了吗#include<iostream>
#include<cstring>
using namespace std;
int map[105][105];
int visit[105],flag[105];
int n,m;
bool dfs(int a)
{
for(int i=1;i<=n;i++)
{
if(map[a][i] && !visit[i])
{
visit[i]=1;//设置visit标识保证不出现1匹配2的情况?还是为了省事,这个节点如果可以增广,下面就把它增广了,不能的话,以后也就别费劲,把它忽略吧。
if(flag[i]==0 || dfs(flag[i]))//i节点没有匹配||延伸下去又未匹配的
如果i没有父亲,或者它有父亲,但是父亲可以找到其它没父亲的还是,就把a当作i的父亲
{
flag[i]=a;
return true;
}
}
}
return false;
}
int main()
{
while(cin>>n>>m)
{
memset(map,0,sizeof(map));
for(int i=1;i<=m;i++)
{
int x,y;
cin>>x>>y;
map[x][y]=1;
}
memset(flag,0,sizeof(flag));
int result=0;
for(i=1;i<=n;i++)//为什么要全部循环一边,因为这样省事,即便是饱和度节点,如果与它相邻的节点中有未饱和的,饱和之,如果与它相邻的节点可以增广,增广之。
{
memset(visit,0,sizeof(visit));
if(dfs(i))
result++;
}
cout<<result<<endl;
}
return 0; }。
匈牙利算法公式

匈牙利算法公式《深入浅出讲解匈牙利算法在任务分配问题中的公式及应用》。
一、啥是匈牙利算法呀?匈牙利算法呢,简单来说,就是一种专门用来解决任务分配问题的巧妙方法。
比如说,有一群工人,还有一堆不同的工作任务,每个工人做不同任务的效率不一样,那怎么安排这些工人去做任务,能让整体的效率最高呢?这时候匈牙利算法就派上用场啦。
举个例子哈,假设有3个工人甲、乙、丙,有3项任务A、B、C。
甲做任务A能得到5分的效益(这里的分数代表效益高低哈),做任务B能得3分,做任务C能得4分;乙做任务A得4分,做任务B得6分,做任务C得2分;丙做任务A得3分,做任务B得5分,做任务C得7分。
那怎么安排这三个人去做这三项任务,能让总效益最高呢?这就是匈牙利算法要解决的问题啦。
二、匈牙利算法的基本公式和原理。
匈牙利算法的核心原理就是不断地找增广路径来调整任务分配,让效益越来越好。
不过呢,要完全理解它的公式可能有点复杂,咱就用简单的方式来说说关键的几步哈。
第一步,咱得有一个效益矩阵。
就像刚才那个例子,把每个人做每个任务的效益写出来,形成一个矩阵:任务A 任务B 任务C。
甲 5 3 4。
乙 4 6 2。
丙 3 5 7。
第二步呢,要进行行变换。
就是在每行里找出最小的数,然后用这行的每个数都减去这个最小数。
比如第一行最小数是3,那这行就变成:任务A 任务B 任务C。
甲 2 0 1。
第二行最小数是2,变换后:任务A 任务B 任务C。
乙 2 4 0。
第三行最小数是3,变换后:任务A 任务B 任务C。
丙 0 2 4。
第三步,进行列变换。
在每列里找出最小的数,然后这列的每个数都减去这个最小数。
这时候得到的新矩阵,就更有利于我们找最优分配啦。
通过这样一步步的操作,最后就能找到一个比较好的分配方案。
就像这个例子,经过变换和分析,最后可能会得出甲做任务B,乙做任务A,丙做任务C ,这样总效益就是3 + 4 + 7 = 14分,是一种比较好的安排啦。
三、匈牙利算法在实际生活中的应用案例。
匈牙利算法

匈牙利算法本文讲述的是匈牙利算法,即图论中寻找最大匹配的算法,暂不考虑加权的最大匹配(用KM 算法实现),文章整体结构如下:1.基础概念介绍2.算法的实现一. 部分基础概念的介绍概念点1. 图G的一个匹配是由一组没有公共端点的不是圈的边构成的集合。
这里,我们用一个图来表示下匹配的概念:如图所示,其中的三条边即该图的一个匹配;所以,匹配的两个重点:1. 匹配是边的集合;2. 在该集合中,任意两条边不能有共同的顶点。
那么,我们自然而然就会有一个想法,一个图会有多少匹配?有没有最大的匹配(即边最多的匹配呢)?我们顺着这个思路,继续往下走。
概念点2. 完美匹配:考虑部集为X={x1 ,x2, ...}和Y={y1, y2, ...}的二部图,一个完美匹配就是定义从X-Y的一个双射,依次为x1, x2, ... xn找到配对的顶点,最后能够得到 n!个完美匹配。
这里有一个概念,有点陌生,即什么是二部图,这个其实很好理解,给定两组顶点,但是组内的任意两个顶点间没有边相连,只有两个集合之间存在边,即组1内的点可以和组2内的点相连,这样构建出来的图就叫做二部图(更好理解就是n个男人,n个女人,在不考虑同性恋的情况下,组成配偶)。
这样是不是简单多了?既然说到了双双组成配偶,那我们干的就是月老做的活了,古话说得好,宁拆一座庙,不毁一桩婚,如果真的给出n个帅气的男孩,n个漂亮的女孩,他们之间互相有好感,但一个男孩可以对多个女孩有感觉,一个女孩也可能觉得多个男孩看起来都不错,在这种情况下,我们怎么让他们都能成双成对呢?将这个问题抽象出来,互有好感就是一条条无向边(单相思我们先不考虑),而男孩和女孩就是一个个节点,我们构建出这么一个图,而完美匹配就是让所有看对眼的男孩和女孩都能够在一起。
完美匹配是最好的情况,也是我们想要的情况。
当然,有些情况下我们做不到完美匹配,只能尽可能实现最多的配对,这个就叫做最大匹配。
可以看出来,完美匹配一定是最大匹配,而最大匹配不一定是完美匹配。
匈牙利算法离散数学

匈牙利算法离散数学
匈牙利算法是一种用于解决二分图最大匹配问题的算法,属于离散数学中图论的内容。
在二分图中,顶点集被分为左右两个部分,边连接两个部分的顶点。
最大匹配问题就是要找到一种最大的匹配方案,使得尽可能多的顶点能够被匹配。
匈牙利算法的基本思想是通过寻找增广路径来不断增加匹配的顶点数。
增广路径是指从左边的未匹配顶点出发,交替经过未匹配边和已匹配边,最终到达右边的未匹配顶点的路径。
通过不断寻找增广路径,并将路径上的边进行匹配和取消匹配,最终可以得到一个最大匹配。
具体实现时,匈牙利算法采用了深度优先搜索的方式来寻找增广路径。
首先从左边的每个未匹配顶点出发,依次进行深度优先搜索,尝试与右边的未匹配顶点进行匹配。
如果找到了增广路径,则将路径上的边进行匹配和取消匹配,继续寻找下一个增广路径。
如果无法找到增广路径,则返回当前匹配的顶点数,即为最大匹配数。
匈牙利算法的时间复杂度为O(VE),其中V是顶点数,E是边数。
通
过优化算法,如路径压缩和交替路径优化,可以进一步提高算法的效率。
匈牙利算法在实际应用中有广泛的应用,比如在求解任务分配问题、
婚姻匹配问题等方面都可以使用。
其应用领域还包括网络流问题、图像处理、人工智能等。
总之,匈牙利算法是离散数学中图论领域一个重要的算法,用于解决二分图最大匹配问题。
其基本思想是通过寻找增广路径来不断增加匹配的顶点数,从而得到一个最大匹配。
通过优化算法,可以提高算法的效率。
该算法在实际应用中有广泛的应用。
匈牙利算法
匈牙利算法是一种在多项式时间内求解任务分配问题的组合优化算法,并推动了后来的原始对偶方法。
美国数学家哈罗德·库恩于1955年提出该算法。
此算法之所以被称作匈牙利算法,是因为算法很大一部分是基于以前匈牙利数学家Dénes Kőnig和Jenő Egerváry的工作之上创建起来的。
匈牙利算法是由匈牙利数学家Edmonds于1965年提出,因而得名。
匈牙利算法是基于Hall定理中充分性证明的思想,它是部图匹配最常见的算法,该算法的核心就是寻找增广路径,它是一种用增广路径求二分图最大匹配的算法。
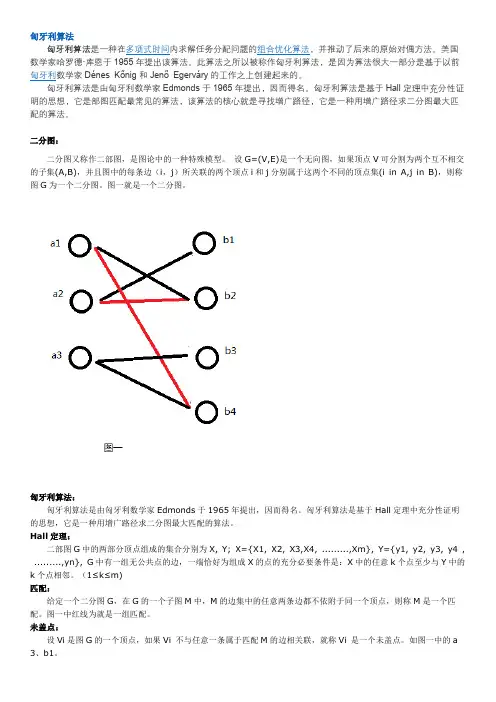
二分图:二分图又称作二部图,是图论中的一种特殊模型。
设G=(V,E)是一个无向图,如果顶点V可分割为两个互不相交的子集(A,B),并且图中的每条边(i,j)所关联的两个顶点i和j分别属于这两个不同的顶点集(i in A,j in B),则称图G为一个二分图。
图一就是一个二分图。
匈牙利算法:匈牙利算法是由匈牙利数学家Edmonds于1965年提出,因而得名。
匈牙利算法是基于Hall定理中充分性证明的思想,它是一种用增广路径求二分图最大匹配的算法。
Hall定理:二部图G中的两部分顶点组成的集合分别为X, Y; X={X1, X2, X3,X4, .........,Xm}, Y={y1, y2, y3, y4 , .........,yn}, G中有一组无公共点的边,一端恰好为组成X的点的充分必要条件是:X中的任意k个点至少与Y中的k个点相邻。
(1≤k≤m)匹配:给定一个二分图G,在G的一个子图M中,M的边集中的任意两条边都不依附于同一个顶点,则称M是一个匹配。
图一中红线为就是一组匹配。
未盖点:设Vi是图G的一个顶点,如果Vi 不与任意一条属于匹配M的边相关联,就称Vi 是一个未盖点。
如图一中的a 3、b1。
设P是图G的一条路,如果P的任意两条相邻的边一定是一条属于M而另一条不属于M,就称P是一条交错路。
匈牙利算法和KM算法简介

KM算法
❖ 穷举旳效率-n!,我们需要愈加优异旳算法。 ❖ 定理: ❖ 设M是一种带权完全二分图G旳一种完备匹配,给
每个顶点一种可行顶标(第i个x顶点旳可行标用lx[i] 表达,第j个y顶点旳可行标用ly[j]表达),假如对全 部旳边(i,j) in G,都有lx[i]+ly[j]>=w[i,j]成立(w[i,j]表达 边旳权),且对全部旳边(i,j) in M,都有lx[i]+ly[j]=w[i,j] 成立,则M是图G旳一种最佳匹配。证明很轻易。
KM算法
❖ 对于任意旳G和M,可行顶标都是存在旳:
❖ l(x) = maxw(x,y)
❖ l(y) = 0 ❖ 欲求完全二分图旳最佳匹配,只要用匈牙利算法求
其相等子图旳完备匹配;问题是当标号之后旳Gl无 完备匹配时怎么办?1957年(居然比匈牙利算法 早???),Kuhn和Munkras给出了一种处理该问 题旳有效算法,用逐次修改可行顶标l(v)旳方法使相 应旳相等子图之最大匹配逐次增广,最终出现完备 匹配。
KM算法
❖ 修改措施如下:
❖ 先将一种未被匹配旳顶点u(u in {x})做一次增广路, 记下哪些结点被访问那些结点没有被访问。求出 d=min{lx[i]+ly[j]-w[i,j]}其中i结点被访问,j结点没有 被访问。然后调整lx和ly:对于访问过旳x顶点,将 它旳可行标减去d,对于全部访问过旳y顶点,将它 旳可行标增长d。修改后旳顶标仍是可行顶标,原 来旳匹配M依然存在,相等子图中至少出现了一条 不属于M旳边,所以造成M旳逐渐增广。
Empty Grass Wall
例题1 Place the Robots(ZOJ)
模型一
在问题旳原型中,草地,墙这些信 息不是我们所关心旳,我们关心旳 只是空地和空地之间旳联络。所以, 我们很自然想到了下面这种简朴旳 模型:
匈牙利算法
匈牙利算法是一种组合优化算法,用于解决多项式时间内的任务分配问题,并推广了后来的原始对偶方法。
美国数学家Harold Kuhn在1955年提出了该算法。
之所以将该算法称为匈牙利算法,是因为该算法的很大一部分是基于匈牙利数学家DénesKőnig和JenőEgerv áry的先前工作。
匈牙利算法是一种组合优化算法,用于解决多项式时间内的任务分配问题,并推广了后来的原始对偶方法。
美国数学家Harold Kuhn在1955年提出了该算法。
之所以将该算法称为匈牙利算法,是因为该算法的很大一部分是基于匈牙利数学家DénesKőnig和JenőEgerv áry的先前工作。
众所周知,匈牙利是一个国家的名称,与算法的发明者有关。
匈牙利算法的发明者埃德蒙兹(Edmonds)于1965年提出了匈牙利算法。
我不知道为什么匈牙利算法的发明者是匈牙利算法,而且我从未见过其他以国家命名的算法。
是因为匈牙利人提出的算法太少了吗?
匈牙利算法的核心原理非常简单,即找到增强路径以实现最大匹配。
我们将匈牙利算法与Gale-Shapley算法的原理进行了比较,您发现了什么?实际上,这两种算法的核心原理是相同的。
在GS算法中,我们首先开始追求男孩,并尽可能地进行匹配。
然后,单身男孩一次又一次地认罪,如果有更好的比赛,以前的比赛将被打破。
在稳定婚
姻的问题中,我们定义了匹配的质量,而在本地二分匹配的问题中,匹配既不是好事也不是坏事。
如果我们抛开匹配的好坏,而把高品质男生抓住劣等男生的过程当作匹配调整的过程,那么这两种算法的核心几乎是相同的。
数学建模匈牙利算法
数学建模匈牙利算法数学建模是一门重要的学科,它将数学方法应用于实际问题的解决。
匈牙利算法是一种经典的组合优化算法,常用于解决二分图最大匹配问题。
下面将介绍匈牙利算法的原理和应用,并探讨其在数学建模中的重要性。
匈牙利算法是二分图匹配问题的经典算法之一,它可用于解决寻找最大匹配的问题。
二分图是指一个图的顶点可以分为两个不相交的集合,并且图中的每条边都连接一对不同集合中的顶点。
在匈牙利算法中,我们需要找到一个最大的匹配,即找到尽可能多的边,使得这些边两端的顶点都不是同一个顶点的匹配。
匈牙利算法的基本思路是通过不断增加匹配的大小来找到最大匹配。
算法不断尝试将未匹配的顶点与相邻的未匹配的顶点相连,直到无法再增加匹配为止。
其核心思想是通过交替路径来增加匹配的大小,直到找到一个最大匹配。
具体来说,匈牙利算法的实现主要包括以下几个步骤:1. 初始化:将所有的匹配边置为0,标记顶点为未访问状态。
2. 从未匹配的左侧顶点开始,尝试匹配:对于每个未匹配的左侧顶点,开始一次深度优先搜索,尝试将其与相邻的未匹配的右侧顶点进行匹配。
如果找到一条匹配路径,则将路径上的所有边都进行匹配。
3. 如果存在未匹配的左侧顶点,则继续查找增广路径;否则算法结束,匹配完成。
匈牙利算法的时间复杂度为O(n^3),其中n为顶点数。
虽然在理论上其时间复杂度较高,但在实际应用中,匈牙利算法通常能够在较短的时间内找到最大匹配。
在数学建模中,匈牙利算法常被应用于解决资源分配、作业调度、人员安排等问题。
在作业调度中,我们需要找到最优的作业分配方案,以最大化效率或最小化成本。
匈牙利算法可以帮助我们找到最优的作业调度方案,从而有效地利用资源和提高效率。
匈牙利算法是一种重要的组合优化算法,常用于解决二分图最大匹配等问题。
在数学建模中,它可以帮助我们解决各种资源分配和调度问题,提高效率和降低成本。
深入理解和掌握匈牙利算法对于数学建模领域具有重要意义。
匈牙利算法和数据关联的关系
匈牙利算法和数据关联的关系匈牙利算法是一种用于解决二分图最大匹配问题的常见算法,它的核心思想是通过增广路径来找到完美匹配。
在解决最大匹配问题时,数据关联起着至关重要的作用。
本文将从匈牙利算法的原理、步骤以及与数据关联的关系三个方面进行阐述。
一、匈牙利算法的原理匈牙利算法是基于增广路径的思想,通过扩展原有的匹配,不断增加匹配的边,直到无法继续增广为止。
算法的核心思想是通过找到增广路径,来使匹配数增加。
增广路径是指一条起点和终点不在匹配中的交替出现的路径。
具体步骤如下:1.从一个未匹配的顶点开始,如果找到增广路径,就让该路径中的边成为匹配边;2.如果无法找到增广路径,则认为当前的匹配是最大匹配。
二、匈牙利算法的步骤1. 初始化:首先给每个顶点一个默认的匹配标记(例如-1),表示该顶点尚未匹配。
同时初始化一个数组match[],用以存储匹配结果。
2.DFS遍历:对每个未匹配的顶点进行深度优先,如果找到增广路径,则将该路径上交替的边进行匹配,同时将其它与该路径相关的边解除匹配。
3.增广路径的寻找:通过DFS遍历,找到一条由未匹配顶点和匹配顶点交替组成的路径,该路径的起点和终点均不在当前的匹配边中。
如果能找到增广路径,则按该路径进行匹配,否则认为当前的匹配是最大匹配。
匈牙利算法中的数据关联主要体现在对图的建模和路径的信息存储上。
在匈牙利算法中,二分图通常用二维数组进行表示,一维代表顶点的标号,二维代表边是否相连。
通过这种方式,可以将图的结构和顶点之间的关系具体地表示出来。
在匈牙利算法的实现中,一般会使用一个匹配数组match[]来存储当前匹配的结果。
这个数组的下标代表顶点的标号,存储的值代表该顶点的匹配对象。
通过这种数据关联的方式,可以方便地查找一些顶点的匹配对象,同时也可以更新匹配关系。
匈牙利算法还可以通过路径的信息进行数据关联。
在寻找增广路径的过程中,除了更新匹配关系外,还需要记录路径信息,例如通过一个代表路径的数组path[]来存储当前路径的信息,这样可以很方便地获取路径上交替出现的边,从而进行匹配操作。
指派问题与匈牙利算法
当人数m小于工作数n时,加上n-m个人,例如
7 0 C ′= 8 4
0 19 2 8 17 0 7 11 0 0 10 2
0 9 2 8 7 0 7 1 0 0 0 2
1 1 最优解: 最优解: X= 1 1
即甲安排做第二项工作、乙做第三项、丙做第四项、丁做第三项。 总分为: = + + + = 总分为:Z=92+95+90+80=357
§5.5 指派问题 Assignment Problem
Ch5 Integer Programming
2011年5月9日星期一 Page 6 of 12
用匈牙利法求解:
10 3 22 0 8 17 C ′= 13 12 16 9 5 15 7 0 C ′= 8 4
5 0 5 7
则 与
′ m w = ∑∑cij xij in
i j
m z = ∑∑cij xij ax
i j
的最优解相同。
§5.5 指派问题 Assignment Problem
Ch5 Integer Programming
2011年5月9日星期一 Page 5 of 12
【例】某人事部门拟招聘4人任职4项工作,对他们综合考评的 例 得分如下表(满分100分),如何安排工作使总分最多。
2011年5月9日星期一 Page 4 of 12
求最大值的指派问题 匈牙利法的条件是:模型求最小值、效率cij≥0 设C=(cij)m×m 对应的模型是求最大值 将其变换为求最小值 令
运筹学指派问题的匈牙利法
运筹学课程设计指派问题的匈牙利法专业:姓名:学号:1.算法思想:匈牙利算法的基本思想是修改效益矩阵的行或列,使得每一行或列中至少有一个为零的元素,经过修正后,直至在不同行、不同列中至少有一个零元素,从而得到与这些零元素相对应的一个完全分配方案。
当它用于效益矩阵时,这个完全分配方案就是一个最优分配,它使总的效益为最小。
这种方法总是在有限步內收敛于一个最优解。
该方法的理论基础是:在效益矩阵的任何行或列中,加上或减去一个常数后不会改变最优分配。
2.算法流程或步骤:1.将原始效益矩阵C的每行、每列各元素都依次减去该行、该列的最小元素,使每行、每列都至少出现一个0元素,以构成等价的效益矩阵C’。
2.圈0元素。
在C’中未被直线通过的含0元素最少的行(或列)中圈出一个0元素,通过这个0元素作一条竖(或横)线。
重复此步,若这样能圈出不同行不同列的n个0元素,转第四步,否则转第三步。
3.调整效益矩阵。
在C’中未被直线穿过的数集D中,找出最小的数d,D中所有数都减去d,C’中两条直线相交处的数都加的d。
去掉直线,组成新的等价效益矩阵仍叫C’,返回第二步。
X=0,这就是一种最优分配。
最低总4.令被圈0元素对应位置的X ij=1,其余ij耗费是C中使X=1的各位置上各元素的和。
ij算法流程图:3.算法源程序:#include<iostream.h>typedef struct matrix{float cost[101][101];int zeroelem[101][101];float costforout[101][101];int matrixsize;int personnumber;int jobnumber;}matrix;matrix sb;int result[501][2];void twozero(matrix &sb);void judge(matrix &sb,int result[501][2]);void refresh(matrix &sb);void circlezero(matrix &sb);matrix input();void output(int result[501][2],matrix sb);void zeroout(matrix &sb);matrix input(){matrix sb;int m;int pnumber,jnumber;int i,j;float k;char w;cout<<"指派问题的匈牙利解法:"<<endl;cout<<"求最大值,请输入1;求最小值,请输入0:"<<endl;cin>>m;while(m!=1&&m!=0){cout<<"请输入1或0:"<<endl;cin>>m;}cout<<"请输入人数(人数介于1和100之间):"<<endl;cin>>pnumber;while(pnumber<1||pnumber>100){cout<<"请输入合法数据:"<<endl;cin>>pnumber;}cout<<"请输入工作数(介于1和100之间):"<<endl;cin>>jnumber;while(jnumber<1||jnumber>100){cout<<"请输入合法数据:"<<endl;cin>>jnumber;}cout<<"请输入"<<pnumber<<"行"<<jnumber<<"列的矩阵,同一行内以空格间隔,不同行间以回车分隔,以$结束输入:\n";for(i=1;i<=pnumber;i++)for(j=1;j<=jnumber;j++){cin>>sb.cost[i][j];sb.costforout[i][j]=sb.cost[i][j];}cin>>w;if(jnumber>pnumber)for(i=pnumber+1;i<=jnumber;i++)for(j=1;j<=jnumber;j++){sb.cost[i][j]=0;sb.costforout[i][j]=0;}else{if(pnumber>jnumber)for(i=1;i<=pnumber;i++)for(j=jnumber+1;j<=pnumber;j++){sb.cost[i][j]=0;sb.costforout[i][j]=0;}}sb.matrixsize=pnumber;if(pnumber<jnumber)sb.matrixsize=jnumber;sb.personnumber=pnumber;sb.jobnumber=jnumber;if(m==1){k=0;for(i=1;i<=sb.matrixsize;i++)for(j=1;j<=sb.matrixsize;j++)if(sb.cost[i][j]>k)k=sb.cost[i][j];for(i=1;i<=sb.matrixsize;i++)for(j=1;j<=sb.matrixsize;j++)sb.cost[i][j]=k-sb.cost[i][j];}return sb;}void circlezero(matrix &sb){int i,j;float k;int p;for(i=0;i<=sb.matrixsize;i++)sb.cost[i][0]=0;for(j=1;j<=sb.matrixsize;j++)sb.cost[0][j]=0;for(i=1;i<=sb.matrixsize;i++)for(j=1;j<=sb.matrixsize;j++)if(sb.cost[i][j]==0){sb.cost[i][0]++;sb.cost[0][j]++;sb.cost[0][0]++;}for(i=0;i<=sb.matrixsize;i++)for(j=0;j<=sb.matrixsize;j++)sb.zeroelem[i][j]=0;k=sb.cost[0][0]+1;while(sb.cost[0][0]<k){k=sb.cost[0][0];for(i=1;i<=sb.matrixsize;i++){if(sb.cost[i][0]==1){for(j=1;j<=sb.matrixsize;j++)if(sb.cost[i][j]==0&&sb.zeroelem[i][j]==0)break;sb.zeroelem[i][j]=1;sb.cost[i][0]--;sb.cost[0][j]--;sb.cost[0][0]--;if(sb.cost[0][j]>0)for(p=1;p<=sb.matrixsize;p++)if(sb.cost[p][j]==0&&sb.zeroelem[p][j]==0){sb.zeroelem[p][j]=2;sb.cost[p][0]--;sb.cost[0][j]--;sb.cost[0][0]--;}}}for(j=1;j<=sb.matrixsize;j++){if(sb.cost[0][j]==1){for(i=1;i<=sb.matrixsize;i++)if(sb.cost[i][j]==0&&sb.zeroelem[i][j]==0)break;sb.zeroelem[i][j]=1;sb.cost[i][0]--;sb.cost[0][j]--;sb.cost[0][0]--;if(sb.cost[i][0]>0)for(p=1;p<=sb.matrixsize;p++)if(sb.cost[i][p]==0&&sb.zeroelem[i][p]==0){sb.zeroelem[i][p]=2;sb.cost[i][0]--;sb.cost[0][p]--;sb.cost[0][0]--;}}}}if(sb.cost[0][0]>0)twozero(sb);elsejudge(sb,result);}void twozero(matrix &sb){int i,j;int p,q;int m,n;float k;matrix st;for(i=1;i<=sb.matrixsize;i++)if(sb.cost[i][0]>0)break;if(i<=sb.matrixsize){for(j=1;j<=sb.matrixsize;j++){st=sb;if(sb.cost[i][j]==0&&sb.zeroelem[i][j]==0){sb.zeroelem[i][j]=1;sb.cost[i][0]--;sb.cost[0][j]--;sb.cost[0][0]--;for(q=1;q<=sb.matrixsize;q++)if(sb.cost[i][q]==0&&sb.zeroelem[i][q]==0){sb.zeroelem[i][q]=2;sb.cost[i][0]--;sb.cost[0][q]--;sb.cost[0][0]--;}for(p=1;p<=sb.matrixsize;p++)if(sb.cost[p][j]==0&&sb.zeroelem[p][j]==0){sb.zeroelem[p][j]=2;sb.cost[p][0]--;sb.cost[0][j]--;sb.cost[0][0]--;}k=sb.cost[0][0]+1;while(sb.cost[0][0]<k){k=sb.cost[0][0];for(p=i+1;p<=sb.matrixsize;p++){if(sb.cost[p][0]==1){for(q=1;q<=sb.matrixsize;q++)if(sb.cost[p][q]==0&&sb.zeroelem[p][q]==0)break;sb.zeroelem[p][q]=1;sb.cost[p][0]--;sb.cost[0][q]--;sb.cost[0][0]--;for(m=1;m<=sb.matrixsize;m++)if(sb.cost[m][q]=0&&sb.zeroelem[m][q]==0){sb.zeroelem[m][q]=2;sb.cost[m][0]--;sb.cost[0][q]--;sb.cost[0][0]--;}}}for(q=1;q<=sb.matrixsize;q++){if(sb.cost[0][q]==1){for(p=1;p<=sb.matrixsize;p++)if(sb.cost[p][q]==0&&sb.zeroelem[p][q]==0)break;sb.zeroelem[p][q]=1;sb.cost[p][q]--;sb.cost[0][q]--;sb.cost[0][0]--;for(n=1;n<=sb.matrixsize;n++)if(sb.cost[p][n]==0&&sb.zeroelem[p][n]==0){sb.zeroelem[p][n]=2;sb.cost[p][0]--;sb.cost[0][n]--;sb.cost[0][0]--;}}}}if(sb.cost[0][0]>0)twozero(sb);elsejudge(sb,result);}sb=st;}}}void judge(matrix &sb,int result[501][2]){int i,j;int m;int n;int k;m=0;for(i=1;i<=sb.matrixsize;i++)for(j=1;j<=sb.matrixsize;j++)if(sb.zeroelem[i][j]==1)m++;if(m==sb.matrixsize){k=1;for(n=1;n<=result[0][0];n++){for(i=1;i<=sb.matrixsize;i++){for(j=1;j<=sb.matrixsize;j++)if(sb.zeroelem[i][j]==1)break;if(i<=sb.personnumber&&j<=sb.jobnumber)if(j!=result[k][1])break;k++;}if(i==sb.matrixsize+1)break;elsek=n*sb.matrixsize+1;}if(n>result[0][0]){k=result[0][0]*sb.matrixsize+1;for(i=1;i<=sb.matrixsize;i++)for(j=1;j<=sb.matrixsize;j++)if(sb.zeroelem[i][j]==1){result[k][0]=i;result[k++][1]=j;}result[0][0]++;}}else{refresh(sb);}}void refresh(matrix &sb){int i,j;float k;int p;k=0;for(i=1;i<=sb.matrixsize;i++){for(j=1;j<=sb.matrixsize;j++)if(sb.zeroelem[i][j]==1){sb.zeroelem[i][0]=1;break;}}while(k==0){k=1;for(i=1;i<=sb.matrixsize;i++)if(sb.zeroelem[i][0]==0){sb.zeroelem[i][0]=2;for(j=1;j<=sb.matrixsize;j++)if(sb.zeroelem[i][j]==2){sb.zeroelem[0][j]=1;}}for(j=1;j<=sb.matrixsize;j++){if(sb.zeroelem[0][j]==1){sb.zeroelem[0][j]=2;for(i=1;i<=sb.matrixsize;i++)if(sb.zeroelem[i][j]==1){sb.zeroelem[i][0]=0;k=0;}}}}p=0;k=0;for(i=1;i<=sb.matrixsize;i++){if(sb.zeroelem[i][0]==2){for(j=1;j<=sb.matrixsize;j++){if(sb.zeroelem[0][j]!=2)if(p==0){k=sb.cost[i][j];p=1;}else{if(sb.cost[i][j]<k)k=sb.cost[i][j];}}}}for(i=1;i<=sb.matrixsize;i++){if(sb.zeroelem[i][0]==2)for(j=1;j<=sb.matrixsize;j++)sb.cost[i][j]=sb.cost[i][j]-k;}for(j=1;j<=sb.matrixsize;j++){if(sb.zeroelem[0][j]==2)for(i=1;i<=sb.matrixsize;i++)sb.cost[i][j]=sb.cost[i][j]+k;}for(i=0;i<=sb.matrixsize;i++)for(j=0;j<=sb.matrixsize;j++)sb.zeroelem[i][j]=0;circlezero(sb);}void zeroout(matrix &sb){int i,j;float k;for(i=1;i<=sb.matrixsize;i++){k=sb.cost[i][1];for(j=2;j<=sb.matrixsize;j++)if(sb.cost[i][j]<k)k=sb.cost[i][j];for(j=1;j<=sb.matrixsize;j++)sb.cost[i][j]=sb.cost[i][j]-k;}for(j=1;j<=sb.matrixsize;j++){k=sb.cost[1][j];for(i=2;i<=sb.matrixsize;i++)if(sb.cost[i][j]<k)k=sb.cost[i][j];for(i=1;i<=sb.matrixsize;i++)sb.cost[i][j]=sb.cost[i][j]-k;}}void output(int result[501][2],matrix sb) {int k;int i;int j;int p;char w;float v;v=0;for(i=1;i<=sb.matrixsize;i++){v=v+sb.costforout[i][result[i][1]];}cout<<"最优解的目标函数值为"<<v;k=result[0][0];if(k>5){cout<<"解的个数超过了限制."<<endl;k=5;}for(i=1;i<=k;i++){cout<<"输入任意字符后输出第"<<i<<"种解."<<endl;cin>>w;p=(i-1)*sb.matrixsize+1;for(j=p;j<p+sb.matrixsize;j++)if(result[j][0]<=sb.personnumber&&result[j][1]<=sb.jobnumber)cout<<"第"<<result[j][0]<<"个人做第"<<result[j][1]<<"件工作."<<endl;}}void main(){result[0][0]=0;sb=input();zeroout(sb);circlezero(sb);output(result,sb);}4. 算例和结果:自己运算结果为:->⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎣⎡3302102512010321->⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎣⎡330110241200032034526635546967562543----⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎣⎡可以看出:第1人做第4件工作;第2人做第1件工作;第3人做第3件工作;第4人做第2件工作。