
SPSS学习系列10.数据分类归纳
10. 数据分类汇总
分类汇总,是分割数据和统计分析的综合,即按指定的分类变量对个案进行分组,并按分组对变量做描述统计。
有关教师的某数据文件:
性别:1=男生,2=女生
学校规模:1=大型学校,2=中型学校,3=小型学校
问题1. 按不同性别与学校规模,统计“年龄”在30岁以下的人数的百分比;
问题2. 按不同性别与学校规模,统计“工作压力”在28以上的人数的百分比;
问题3. 按不同性别与学校规模,统计“工作满意”的平均值;
问题4. 按不同性别与学校规模,统计“组织承诺”的标准差。
操作步骤:
1.【数据】——【分类汇总】,打开“汇总数据”窗口,将分类变量“性别”和“学校规模”选入【分组变量】框;将变量“年龄”、“工作压力”、“工作满意”、“组织承诺”选入【汇总变量】的“变量摘要”框;
注意:默认是汇总各变量的“平均数”;
2.针对问题1:选中【变量摘要】框中的“年龄_mean=MEAN(年龄)”,点【函数】,打开“汇总函数”子窗口,在【百分比】框,勾选【下方】,【值】框填入“30”,表示“年龄在30岁以下”,点【继续】
针对问题2:类似地选中“工作压力_mean=MEAN(工作压力)”,点【函数】,在【百分比】框,勾选【上】,【值】框填入“28”,表示“工作压力在28以上”,点【继续】
问题3已经是平均值,不用改动。
针对问题4:选中“组织承诺_mean=MEAN(组织承诺)”,点【函数】,勾选【标准差】,点【继续】
3.【变量名与标签】按钮,可以设置新变量名和变量标签;
注意:为了能显示各分组中的个案数,需要勾选【个案数】,【名称】框填入变量名“人次”;
4.【保存】方式有三种选项:
(1)将新变量添加到活动数据集——直接在原数据集中增加列;
(2)创建只包含汇总变量的新数据集;
(3)写入只包含汇总变量的新数据文件aggr.sav;
注意:最好选(2)或(3),若直接在原数据集中增加列将出现大量重复的汇总数据。
5.实际中最好勾选【适用于大型数据集的选项】下的“在汇总之前排序文件”。
点【确定】,得到运行结果:
说明:按“性别”和“学校规模”的不同水平值组合,分为2×3=6组分别进行统计。
例如,“性别=1,学校规模=1”的分组,共15人,年龄30岁以上的有73.3%.。
《SPSS统计分析》第10章 相关分析
12.990 16.290 17.990 19.290
12.500 15.800 17.500 18.800
11.500 14.800 16.500 17.800
2.200 5.500 7.200 8.500
3.300 5.000 6.300
3.300
1.700 3.000
5.000 1.700
1.300
3.分析两个变量间线性关系的程度。往往因为第三个变量的作用,使相关系数不能真正反映两个 变量间的线性程度。 这是应该控制一个变量的变化求另两个变量间的相关系数,也就是说, 在第三个变量不变的情况下,两个变量的线性程度。
CORRELATIONS /VARIABLES=VCP with HEIGHT WEIGHT /PRINT=TWOTAIL NOSIG /MISSING=PAIRWISE .
6.300 3.000 1.300
1.800 1.500 3.200 4.500
2.700 6.000 7.700 9.000
5.000 8.300 10.000 11.300
12.000 15.300 17.000 18.300
9: 9 14.790 14.300 13.300
4.000 1.800 1.500 3.200 4.500
返回
典型相关分析
返回
典型相关分析概念
典型相关分析是用来描述两组随机变量间关 系的统计分析方法。
通过线性组合,可以将一组变量组合成一个 新的综合变量。虽然每组变量间的线性组合有无 数多个,但通过对其施加一些条件约束,能使其 具有确定性。
典型相关分析就是要找到使得这两个由线性 组合生成的变量之间的相关系数最大的系数。
学习通过编程解决偏相关问题
spss中分类汇总教程

spss中分类汇总教程
spss教程:分类汇总
按照某种分类变量进⾏分类计算,对原始数据分类,做出表格形式,便于直观地观察数据⼤致分布情况。
⽅法/步骤
1.调出相关窗⼝,分类变量是“户⼝状况”,汇总变量为“⼈均⾯积”、“计划
⾯积”。
分类变量可以多个,称为“多重分类汇总”,第⼀个分类变量称为“主分类变量”,依次称为“第⼆、第三分类变量”。
2.按钮“函数”表⽰计算哪些汇总变量,系统默认均值,⽤户可⾃⼰定义。
3.“变量名与标签”:重新命名汇总结果中的变量名和标签,系统有默认的命名,
见图⽚。
“保存”:将最后的汇总结果保存在何处。
我此处选择的是第⼆种,即“将汇总结果保存在⼀个数据编辑窗⼝中”。
“个案数”:保存各分类组的个案数,系统默认变量名“N_BREAK”。
4.选择第⼆种保存⽅式,结果展⽰见图⽚。
“个案数”分别是2825、168。
对
于系统缺失值,spss⾃动剔除含缺失值的样本,所以平均值的计算不受缺失样本量的影响。
END
经验内容仅供参考,如果您需解决具体问题(尤其法律、医学等领域),建议您详细咨询相关领域专业⼈⼠。
第十章 spss教程之分类分析

第十章分类分析第一节 K-Means Cluster过程10.1.1 主要功能10.1.2 实例操作第二节 Hierarchical Cluster过程10.2.1 主要功能10.2.2 实例操作第三节 Discriminant过程10.3.1 主要功能10.3.2 实例操作人们认识事物时往往先把被认识的对象进行分类,以便寻找其中同与不同的特征,因而分类学是人们认识世界的基础科学。
在医学实践中也经常需要做分类的工作,如根据病人的一系列症状、体征和生化检查的结果,判断病人所患疾病的类型;或对一系列检查方法及其结果,将之划分成某几种方法适合用于甲类病的检查,另几种方法适合用于乙类病的检查;等等。
统计学中常用的分类统计方法主要是聚类分析与判别分析。
聚类分析是直接比较各事物之间的性质,将性质相近的归为一类,将性质差别较大的归入不同的类。
判别分析则先根据已知类别的事物的性质,利用某种技术建立函数式,然后对未知类别的新事物进行判断以将之归入已知的类别中。
聚类分析与判别分析有很大的不同,聚类分析事先并不知道对象类别的面貌,甚至连共有几个类别也不确定;判别分析事先已知对象的类别和类别数,它正是从这样的情形下总结出分类方法,用于对新对象的分类。
第一节 K-Means Cluster过程10.1.1 主要功能调用此过程可完成由用户指定类别数的大样本资料的逐步聚类分析。
所谓逐步聚类分析就是先把被聚对象进行初始分类,然后逐步调整,得到最终分类。
返回目录返回全书目录10.1.2 实例操作[例10.1]为研究儿童生长发育的分期,调查1253名1月至7岁儿童的身高(cm)、体重(kg)、胸围(cm)和坐高(cm)资料。
资料作如下整理:先把1月至7岁划成19个月份段,分月份算出各指标的平均值,将第1月的各指标平均值与出生时的各指标平均值比较,求出月平均增长率(%),然后第2月起的各月份指标平均值均与前一月比较,亦求出月平均增长率(%),结果见下表。
SPSS数据的整理与分析

数据的整理与分析chy一、数据收集-问卷星1、检查与剔除不合格问卷,比如答题时间太短、年龄不符合、问卷填写不完整等。
2、应答率/回收率:是指定的或者抽中的需要作答的对象中,最终完成作答的百分比。
3、合格率:合格数量/作答数量。
4、一般的,访问问卷的回收率最高,回收率一般要求在90%以上;邮寄问卷的回收率低,回收率在50%左右就可以了;发送式自填问卷的回收率一般,回收率要求在67%以上。
5、如果不高尽量不要写入,反而起反作用。
6、可以运用问卷星中的图与表描述,直观描述。
二、数据整理-Excel1、结果导出方式:文本、数字、分数,保存excel原版。
2、再另存一版你用于SPSS分析的表格。
3、注意反向计分的题目。
4、如果量表分为几个维度,可以单独列出来进行分析。
(如我发到群里的表格,可以用总分与其他条目分析,也可以用这个量表包括的几个维度分别与其他条目分析,观察其关联)。
5、如果分不清楚,可以标注一下变量的类型,如分类变量还是数据变量(如我的Excel的第二行,但是导入到SPSS中时需要删除)。
三、数据录入-SPSSSPSS中“变量视图”输入各变量如下:1、“类型”尽量都转换为“数字”;(选中右边的…)(点击“数字”即可)3、“值”的标记:(用于计数资料的标记,在结果中易于观察)点击…,分别输入对应的值和代表的标签,点击“添加”和确定即可4、“测量”分为三类:(1)标度:指计数资料,如年龄、108总分等;(2)有序:指等级资料,如年级等;(3)名义:指计数资料,如性别、性格等。
5、如何把计数资料转换为计量资料,即赋值(以“拖延总分为例”)步骤:(注意填写名称和标签,点击“变化量”) ----点击“旧值和新值”进行赋值:0-20赋值为1:--添加--20.1-40赋值为2:--添加--40.1-60赋值为3:--添加--然后“变量视图”最后一行就会出现新的变量“拖延分数三分类”,可以把“名义”改为“有序”,也可不改。
SPSS分类汇总
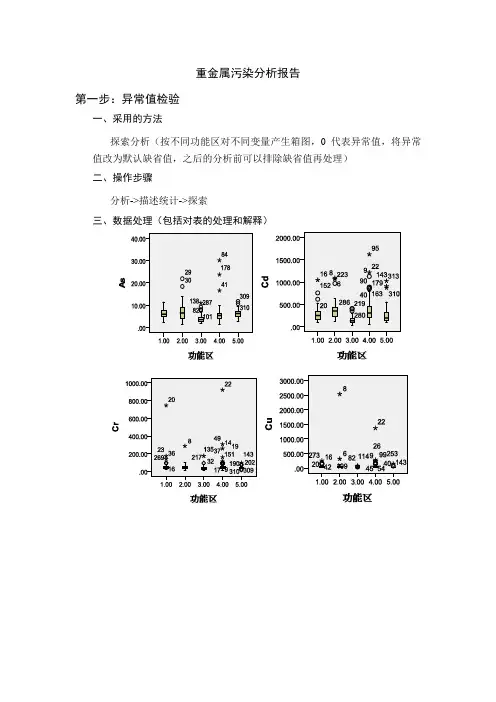
重金属污染分析报告第一步:异常值检验一、采用的方法探索分析(按不同功能区对不同变量产生箱图,0代表异常值,将异常值改为默认缺省值,之后的分析前可以排除缺省值再处理)二、操作步骤分析->描述统计->探索三、数据处理(包括对表的处理和解释)对于箱图中有0的序列号,找到该序列号,将异常值改为默认缺省值,在对缺省值进行均值替换。
As:29,30,82,138,309;Cd:6,20,152,280;Cr:32,309;Cu:20;Hg:157;Ni:20,138,319;Pb:144,221;Zn:23,31。
第二步:异常值替换一、采用的方法替换缺失值二、操作步骤转换->替换缺失值三、结果分析表格 1 结果变量结果变量被替换的缺失值数非缺失值的个案数有效个案数创建函数第一个最后一个1 Cd_1 4 1 319 319 SMEAN(Cd)2 Cr_1 2 1 319 319 SMEAN(Cr)3 Cu_1 1 1 319 319 SMEAN(Cu)4 Hg_1 1 1 319 319 SMEAN(Hg)5 Ni_1 3 1 319 319 SMEAN(Ni)6 Pb_1 2 1 319 319 SMEAN(Pb)7 Zn_1 2 1 319 319 SMEAN(Zn)8 As_1 5 1 319 319 SMEAN(As) 第三步:不同功能区的污染程度(法一:分类汇总)一采用的方法分类汇总(统计不同功能区不在金属标准范围的百分比)二、操作步骤数据->分类汇总三、结果分析表格 2 不同区域重金属污染程度As Cd Cr Cu Hg Ni Pb Zn生活区68.272.745.577.365.92559.161.4工业区63.986.141.794.47544.480.677.8山区18.231.822.727.336.418.221.218.2交通区51.47936.282.658.719.666.772.5公园绿地区74.354.325.768.66011.44051.4从表二可以看出在山区重金属污染程度都是最少的,其中在工业区的Cd,Cu,Hg,Ni,Pb,Zn含量最多。
SPSS数据整理
率(0-100%);
• (14)Percentage outside:先确定1个下 限,再确定1个上限,求数值在该区间外的 例数占总例数的比率(0-100%);
• (15)Fraction inside:先确定1个下限, 再确定1个上限,求数值在该区间内的例数 占总例数的比率(0-1);
结果
• 原文件中的行变成新文件中的列,原文件中 的列变成新文件中的行;
• 原文件中的变量变成新文件中的个案,原文 件中的个案变成新文件中的变量
• 原文件中未被选定的变量将在新文件中丢失
3 数据的分组汇总
选Data菜单的Aggregate...命令项
• 类组(Break Group): 分类变量的不同取值 将原始数据分成若干组.如: origin=1、2、3 分别代表美国、欧洲和日本,分成三个类 组
例6 :在cars.sav文件
• 标出美国产的汽车马力在135以下的
• 注意:
– Count 在标示数据的过程中,不能对同时满足 多个取值条件的记录进行标示,只能对满足某 一个条件的变量进行标示。
四、变量的重新赋值
• 选Transform菜单的Recode命令项, • 该过程用于将原变量按照某种一一对应的
(7)Number of cases:合计类组的观察例数; (8)Sum of values :求类组所有观察值的和。 (9)Percentage above:先确定1个数值,求大于该
数值的所有例数占总例数的百分比(0-100%); (10)Percentage below:先确定1个数值,求小于
• 选Data菜单的Select Cases...命令项,
(1)All cases:表示所有的观察例数都被选择,该 选项可用于解除先前的选择;
学习SPSS数据分析?先弄懂SPSS的基础知识吧
学习SPSS数据分析?先弄懂SPSS的基础知识吧学习数据分析之spss分析工具,可真的不是一般的功夫,真的要很认真和很细心才能做得好spss。
下面我来和大家分享一下关于SPSS数据分析的基础知识,希望大家从这篇SPSS 数据分析基础知识中对SPSS有更清楚的认识。
1、SPSS数据分析的流程⏹易用性强操作界面极为友好,操作简单良好的帮助系统和自学功能为高级用户提高编程功能⏹功能强大成熟的统计过程完美的图形处理能力提供多种数据准备技术兼容性好数据输入:Excel,Lotus,Oracle,SQL Server,Acess,dBASE,文本数据输出:Word,HTML,XML,Excel,Powerpoint,PDF3、数据的编辑常量∙数值型常量:除了普通写法外还可以用科学计数法,如:1.3E18;∙字符型常量:用单引号或双引号括起来如果字符中包含单引号,则必须使用双引号;∙日期常量:日期个数的数据,一般需要使用日期函数进行转换;变量∙变量名长度不能超过8;∙三种基本的类型:数值、字符和日期;∙可以在variable view界面设定变量的长度及小数位、变量的描述、变量值的描述、missing 值、显示宽度、对齐方式和变量的测度方式;变量的测试方式∙Scale:定距变量,如:身高、体重等;∙Ordinal:定序变量,如:教育程度、级别等;∙Nominal:定类变量,如:性别、民族等;操作符与表达式∙三种基本的运算:数学、关系和逻辑∙数学运算符:+ – * / ** ()∙关系运算符:>>= <<= = ~=∙逻辑运算符:&(AND) |(OR) ~(NOT)∙三种运算对应三种表达式常用的数据操作命令Data->Sort CasesTransform->Rank CasesTransform->CountTransform->RecodeTransform->Automatic RecodeTransform->ComputeData->TransposeData->Split FilesData->Merge FilesCompute∙数值型:compute num1=value.∙字符型:String A(a11).compute a=’hello world’.∙日期型:compute data1=date.mdy(month,day, year).Rocode∙recode variable name(old value=new value).∙recode variable name(old value=new value) into new variable name.∙字符型变量使用auto recodeSplit file∙有的时候需要对变量做些分组的分析,但一些分析方法并不提供分组变量的设置选项这就需要用到Split file命令;∙例如使用Descriptives做描述性分析,如果想分年龄做分析,这样就可以用年龄变量做为分组变量;∙可以看到这里的Split其实是分组,而不是拆分文件;analyze all case分析所有的样本,不产生分组;compare groups产生对比分析组;output by groups分组输入分析结果;Merge File∙add cases 合并变量相同,但是case不同的文件;∙add variables合并变量不同,case相同的文件这里的变量不同可以是部分的变量不同,case 相同也可以是一个文件的case是另外一个文件的子集;数据的分类汇总∙使用Aggregate命令∙指定分类变量对观测量进行分组,对每组观测量的各变量求描述统计量;检查重复的数据∙使用identify duplicate cases数据的加权∙使用weight case选取一定的case进行分析∙使用select cases:在对数据的子集进行分析的时候需要用到这个命令;常用的数学函∙取绝对值:abs(数字型表达式)∙求余数函数:mod(数字型表达式,模数),模数不能为0该函数在需要对某一变量求模数的余数时使用,如果对一个顺序编号或自然数序列求模数的余数,可将该序列按模数等距分类,从而实行等距抽样;∙四舍五入函数:rnd(数字型表达式)∙开方函数:sqrt(数字型表达式)SPSS统计分析概述:∙针对不同类型的数据选取不同的分析方法,正确的分析方法是得到正确结果的关键;∙spss提供数字分析和图形分析两种分析形式;∙高级分析之前一般都需要做描述性统计分析,把握数据的规律对分析解释数据有很好的引导和帮助作用;Descriptive Statistics– Frequencies:频数分析– Descriptives:描述统计– Explore:探索分析– Crosstabs:列联表分析– Ratio:比率分析Descriptives–可以对变量进行标准化;Explore– Explore是对连续性变量进行探索性分析最有效的工具;–考察数据的奇异性和分布特征;–箱盒图、茎叶图、正态检验图及方差齐次性检验;Crosstabs–数据类型要求为分类变量;–二维或多维交叉频数表(列联表),分析事物(变量)之间的相互影响和关系;–可以做卡方检验,来分析行列变量之间是否存在相关性;分类变量统计描述常用指标–统计量:• 频数、频率、累计频数、累计频率、众数• 比:任意两个变量之比性别比,货物/销售人员比构成比:部分占总体的比例• 率:事件的发生强度–图形:• 条图、饼图Spss操作–单个变量的分析• Analyze…Descriptive Statistics…Frequcencies–多个变量的分析• Analyze…Descriptive Statistics…Crosstabs–条图• Graph…(interactive…)bar–饼图• Graph…(interactive…)pie连续变量的描述指标–频数表Frequency• 直观的方法:分布类型分布特征–集中趋势Central tendency• 均数mean 中位数median 众数mode–离散趋势Dispersion tendency• 全距Range• 方差Variance 标准差std.deviation如何计算各个描述统计量– Analyze->Descriptive Statistics->Frequcencies…– Analyze->Descriptive Statistics->Descriptives…– Analyze->compare means->means…• 如何用图形描述连续变量–Graph…Interactive…Histogram• 如何应用Explore对连续变量进行探索性分析– Analyze->Descriptive Statistics->Explore…Basic Tables过程:对分类/定量资料进行各种复杂格式的描述;• General Tables过程:在同一张表格内同时对分类资料、连续资料和多选题数据进行汇总功能非常强大,但使用上相对复杂;• Custom Tables过程:含有表格预览窗口,并可在制表过程中控制结果;• Multiple Response Sets/Tables过程:专门为多选题数据设计的制表过程;• Tables of Frequencies过程:在同一张表格中对多个分类变量同时输出频数表;怎么样,对SPSS还一知半解的你看完这篇文章,是不是收获颇多,还想了解更多SPSS数据分析知识,来免费报名SPSS数据分析课程吧。
SPSS操作归纳总结(全)
SPSS操作归纳总结一、成绩分析(集中量和差异量)如:某校高一甲板40名学生的化学测验分数操作:Analyze——Descriptive Statistics—Frequencies(频数)二、相关量1、积差相关系数如:40名学生的数学和化学成绩操作:Analyze——Correlate(相关)——BIvariate(双变量)结论:在0.01水平上学生的化学成绩与生物成绩相关,也就是说我们有99%的把握说学生的化学成绩与生物成绩密切相关。
分析:若Sig.(2-tailed)的值<0.05,则相关程度密切若Sig.(2-tailed)的值<0.01,则相关程度非常密切若Sig.(2-tailed)的值>0.05,则相关程度不密切2、点双列相关系数如:求若干名考生的生物成绩与性别之间的相关系数,并判断他们之间有无相关关系?操作:Analyze——Correlate(相关)——BIvariate(双变量)分析:Sig.(2-tailed)的值>0.05,则相关程度不密切。
结论:在0.05水平上学生的生物成绩与性别无密切相关,也就是说我们没有95%的把握说学生的生物成绩与性别密切相关,或者说学生的生物成绩和性别无密切关系。
3、等级相关系数如:高考总分与生物等级、化学等级的相关操作:Analyze ——Correlate (相关)——BIvariate (双变量)注:相关系数为负值,说明为负相关,正值为正相关,而且绝对值越大,相关性越大。
该题中男表示为1,女表示为0,该结果为负值,说明女的成绩好,而男的成绩不好。
分析:Sig.(2-tailed)的值>0.05,则相关程度不密切。
结论:在0.05水平上学生的三科总分与物理等级无密切相关,也就是说我们没有95%的把握说学生的三科总分与物理等级密切相关,或者说学生的三科总分与物理等级无密切关系。
补充:“物理等级”转换成“等级数”操作:Transform——Recode——Into different variables三、考试质量的分析1、难度分析(P)Analyze——Descriptive Statistics—Frequencies结论:客观题的难度P ——直接看得分的valid percent主观题的难度P——mean 除以该题的总分值2、区分度分析(1)用相关系数法求试题的区分度某一题的得分与该生总分的相关程度作为该题的区分度。
SPSS数据处理小结:T检验、相关、二分类、散点图、箱图
!!!!图1-‐12 !! 图1-‐13
!二二.相关性
!(一一).双变量相关分析(Bivariate)
!当分析两个变量之间是否存在相关关系时,使用用双变量相关分析。
这个结果就是r=0.022,p等于0.603. 要在r大大于0.5的情况下,表示示两组的关系密切;而而p值要小小于0.05相关才成
!!立立。
接下来我们看一一下这一一组数据:NLR和HbA1c的相关性
! 图2-‐4
首首先r=0.509,说明他们的相关是很密切的,而而p<0.001,说明相关是成立立 的。然后在“.509”右上角角现在是有两个*号,说明是显著相关的,假如说是一一
!!!!!个*号,说明只是p值小小于0.05,相关成立立,但是没有0.000显著。
!
!三. 回归分析(regression)
! 图1-‐8 图1-‐9
!!!!!!!
!图1-‐2
3.弹出的主对话框:
!!!!!!!
图1-‐3
!
4.如果你想设置99的可信区间就去“选项里里面面设置”,系统默认95%的可信区
间。
5!!!!!!!!!!!!!!.接着就是开始做数据了:
!
图1-‐4
6.得到结果:
图1-‐5 首首 先 我 们 在 图 5 中 可 以 看 到 样 本 数 目目 是 N = 5 8 2 个 , 均 数 ± 标 准 差 是 62.69±9.669。 (PS:高高中统计学知识忘记了的我就不再这里里意义赘述了,自自行行补脑吧) 下面面的那个t我不是很了解是什么意思,一一般的文文章里里面面也没有用用到。重要 的是Sig.(双侧)值,就是在常在文文献中看到的p value,它要小小于0.05才是 有意义的。而而后面面的“差分的95%置信区间”的上下限,只要均值差值在可信 区间里里面面,并且置信区间没有包含0,就说明样本均数和总体均数的差异是
SPSS学习笔记-图文
SPSS学习笔记---------------------------------------1. SPSS学习笔记之——常用统计方法的选择汇总2. SPSS学习笔记之——多因素方差分析3. SPSS学习笔记之——协方差分析4. SPSS学习笔记之——重复测量的多因素方差分析5.SPSS学习笔记之——二项Logistic回归分析6.SPSS学习笔记之——两配对样本的非参数检验(Wilcoxon符号秩检验)7.SPSS学习笔记之——两独立样本的非参数检验(Mann-Whitney U秩和检验)8.SPSS学习笔记之——多个独立样本的非参数检验(Cruskal-Wallis秩和检验)9.SPSS学习笔记之——生存分析的Cox回归模型(比例风险模型)10.SPSS学习笔记之——相关分析(Pearson、Spearman、卡方检验)11.SPSS学习笔记之——配对logistic回归分析12.SPSS学习笔记之——单样本非参数检验13.SPSS学习笔记之——ROC曲线14.SPSS学习笔记之——Kaplan-Meier生存分析15.SPSS学习笔记之——多相关样本的非参数检验(Friedman检验)16.R×C列联表(分类数据)的统计分析方法选择与SPSS实现17.SPSS学习笔记之——OR值与RR值----------------------------------------价SPSS学习笔记之——多因素方差分析问题:对小白鼠喂以三种不同的营养素,目的是了解不同营养素增重的效果。
采用随机区组设计方法,以窝别作为划分区组的特征,以消除遗传因素对体重增长的影响。
现将同品系同体重的24只小白鼠分为8个区组,每个区组3只小白鼠。
三周后体重增量结果(克)列于下表,问小白鼠经三种不同营养素喂养后所增体重有无差别?区组号营养素1营养素2营养素3150.1058.2064.50247.8048.5062.40353.1053.8058.60463.5064.2072.50571.2068.4079.30641.4045.7038.40761.9053.0051.20842.2039.8046.20SPSS软件版本:18.0中文版。