
4位乘法器设计开题报告
中国海洋大学青岛学院
毕业设计
开题报告
题 目 4位乘法器的设计
系(中心) 信息工程系
年 级 2008级
专 业 电子信息工程
姓 名 高吉
学 号 200802305331
指导教师 王学玲
一、选题依据
课题来源、选题依据和背景情况;课题研究目的、学术价值或实际应
用价值
现代社会在飞速发展,科学技术的发展越来越快。4位二进制乘法器在十几
种的应用相当广泛,是一些计算器的基本组成部分,其远离适用于很多计算器和
大型计算机,他涉及到实训逻辑电路如何设计。分析和工作等方面。通过次电路
更深刻的了解时许逻辑不见的工作原理,从而掌握如何根据需要设计满足要求的
各种电路图,解决生活中的实际问题,将知识应用于实践中。
根据课题研究的目地是,绘制出电路的原理图,并且诠释每部分的功能;根
据设计的电路图分析所需要的元器件种类和个数;根据技术指标指定实验反感,
验证所设计的电路;进行实验数据处理和分析。
研究此课题,目地在于使我们了解4位乘法器在实际中的应用,了解它的具
体工作原理以及它的基本电路图,使我们以后可以应用它解决一些实际问题。通
过对4位乘法器的设计,让我们懂得了理论与实际相结合是很重要的,只有理论
知识是远远不够的,只有把所学的理论知识与实践相结合起来,从理论中得出结
论,才能真正为社会服务,从而提高自己的实际动手能力和独立思考的能力。
二、文献综述
国内外研究现状、发展动态;查阅的主要文献
研究现状
乘法器由于它的应用十分广泛,是一些计算器的基本组成部分,被广泛应用于大
型计算机中,所以各国科学家对其都进行了积极的研究,现在超级计算机的出现,
使的最基本的乘法器又有了更大的发展。发展前景广阔。
查阅主要文献:
1. 《VHDL应用与开发实践》著译者: 甘历 出版者:科学出版社
2. 《VHDL与数字电路设计》卢毅 赖杰 科学出版社 2001年4月
3. 《VHDL编程与仿真》 王毅平 张振荣 人民邮电出版社 2000年7月
4. 《数字电路设计与Verllog HDL》张亮 人民邮电出版社 2000年10月
5. 《VHDL简明教程》王小军 清华大学出版社
6. 《用 VHDL 设计电子线路》边计年等翻译 清华大学出版社
7. 《可编程逻辑器件原理、开发与应用》赵曙光 西安电子科技大学出版社
8. 《数字电路设计与Verllog HDL》张亮 人民邮电出版社 2000年10月
9. 《FPGA设计及应用》褚振勇 翁木云 西安电子科技大学出版社2002年7月
10. 江国强编著。EDA技术习题与实验。电子工业出版社,2005.
11. 潘松,黄继业编著。EDA技术与VHDL。清华大学出版社,2005.
12. 刘明业主编。数字系统自动设计实用教程。高等教育出版社,2004.
13. 谭会生,张昌凡编著。EDA技术及应用。西安电子科技大学出版社,2004.
14. 江国强编著。PLD在电子电路设计中的应用。清华大学出版社,2006.
15. 江国强等编著。数字系统的VHDL设计。机械工业出版社,2009.
三、研究内容
1.学术构想与思路;主要研究内容及拟解决的关键问题(或技术)
在设计过程中,电路图的分析与设计是课题设计中的关键问题,主要研究内
容是试设计一4位二进制乘法器
输入信号:4位被乘数A(A3 A2 A1 A0),4位乘数B(B3 B2 B1 B0),启动
信号START。
输出信号:8位乘积P(P7 P6 P5 P4 P3 P2 P1 P0),结束信号END。
当发出一个高电平的START信号以后,乘法器开始乘法运算,运算完成以后发出
高电平的END信号。
2.拟采取的研究方法、技术路线、实施方案及可行性分析
移向-加法器数混合乘法器实现框图如图所示,主体包括寄存序列、与逻辑
和加法器等三部分。
MUL
END
P
8
4
4
A
B
START
1 0 1 1
1 1 0 1
×
1 0 1 1
0 0 0 0
1 0 1 1
1 0 1 1
11011001
启动信号
寄存序列
与逻辑 加法器
积
被乘数
乘数
清零信号
通过实现框图看出其原理就是:被乘数与乘数进入寄存序列,然后通过与逻
辑和加法器的运算后得到被乘数与乘数的乘积。其中启动信号用来启动乘法运
算,而清零信号则为积存器和计数器的清零信号。可以确定乘法器的表达式为:
BAIIBAIBAIIAIY222)2(
移向-加法器树混合乘法器算法方案框图设计出的移向-加法器树混合乘法器框。
移向-加法器数混合乘法结构框图
从结构框图中可以看出:被乘数与4位二进制乘数的低二位通过寄存器相乘
得到的6位的2进制数部分积,然后被乘数与4位二进制的高二位在通过寄存器
阵列相乘后也得到了6位2进制数部分积。2个部分积通过加法器后得可以得到
8位2进制乘积了。
被乘数
乘数
(低二位)
寄存器阵列
寄存器阵列
加法器 积
4
8
2
乘数
被乘数
(高二位)
寄存器阵列
寄存器阵列
与
6
6
与
4
2
也就是说,乘法运算可分解为移位和相加两种子运算,而且是多种相加运算,
所以是一个累加的过程。实现这一累加过程的方法是,把每次相加的结果用部分
积P表示,若B中某一位iB=1,则部分积P右移1位后与A相加;若B中某一
位iB=0,则部分积P右移1位后与0相加。通过四次移位和累加,最后得到的
部分积就是A与B的乘积。前面的算法原理可以用如图所示的算法流程图来描述。
乘法器的算法流程图
四、论文(设计)进度安排
起止时间 主要内容 预期目标
END=1
0i
,0P
输入A、B
ii+1
PP+A
右移P
N
START=1? 开始 I=4? iB=1? Y Y Y N N
2012.9.30-2012.10.15 2012.10.16-2012.10.30 2012.11.1-2012.11.15 2012.11.16-2012.11.30 课题准备阶段: 主要是进行有关本课题的相关资料的查询和收集,并详细阅读和学习;与此同时,针对拟解决的问题进行开发平台和应用系统的可行性分析,完成应用系统的初步设计和总体规划 课题研究与系统开发阶段: 本阶段将进行4位乘法器电路图的设计,并对转化电路,电源电路等进行总体规划,形成较为完整有效的整体解决方案,为毕业论文的撰写作好充分准备。 论文撰写阶段: 对本课题的工作进行总结、提炼,归集资料、确定大纲、完成草稿,并最终形成系统的完整的学位论文。 论文完善阶段 对论文进行有针对性的调整修改,进一步完善课题的体系结构,丰富课题的内容,并最终完稿,为毕业答辩做好充分的准备。 系统分析和算法
理解
软件设计和软件
测试文档
论文初稿
论文定稿
PIC16F877A简单计算器设计报告 汇编语言 四位无符号整数加减乘除

课程设计报告课程名称:单片机原理与接口技术课程设计设计题目:简单计算器院系:机电工程学院班级:2010级电气工程及其自动化专业姓名:学号:指导教师:史丽萍,闫广明,张波,张扬,王冠然设计时间:2013年12月一、设计方案描述与论证我们所设计的是一个简单计算器,它具有四位数以内的整数加减乘除运算。
可以在输入错误的时候退格,也可以初始化。
在初始化的状态下可以进行关机以减少耗能。
显示使用的数码管扫描显示的方法来显示数字,所以我们每一次运算前我们都需要将个位、十位、百位和千位相结合。
我们使用的是4×4的键盘,检测的时候是进行键盘扫描来完成确定哪一个键被摁下,然后是否释放。
键盘被摁下后,先判断是什么键。
如果是数字键,则进行数的输入,首先先把百位的数值赋给千位,十位赋给百位,个位赋给十位,然后把摁下键的对应数赋给个位。
如果是算法键,则将对应的算法寄存地址赋上相应算法的值,并且在下一次输入数字时把十位、百位和千位清零以完成下一次的赋值,而这一次的值将转换为一个数储存在相应的地址中。
当按下的是退格键,则将十位赋值给个位,百位赋值给十位,千位赋值给百位然后千位清零。
当按下的是等号键的时候,将前一次储存的数取出与这一次的数进行相应的运算然后将得到的二进制数拆分为个位、十位、百位和千位然后扫描显示就可以。
复位键是使用的中断,当个位、十位、百位和千位都不为零的时候按下将会初始化计算器的所有数据,如果个位、十位、百位和千位均为零这进入休眠状态等待下一次中断的唤醒。
二、硬件设计部分我们使用的是PIC16F877A单片机,使用四位的八段数码管,4×4的键盘和一个独立的中断键。
八段数码管我们使用的是共基极的接法,所以当给出低电平的时候导通,给出高电平的时候关断。
我们以RD端口来控制段选,分别以RB0控制a、RB1控制b、RB2控制c、RB3控制d、RB4控制e、RB5控制f、RB6控制g和RB7控制dp。
以RD1、RD2、RD3和RD4端口分别控制位选的千位、百位、十位和个位。
4位乘法器

一、概述利用四位二进制寄存器、全加器以及D触发器等元器件,实现四位二进制乘法器的控制部分和乘法的实现部分。
成法是加法的简便运算乘法运算只能通过加法运算以及移位运算来实现。
在控制端用四个触发器产生四个控制信号来控制实现的加法移位功能,实现端在控制端信号作用下依次执行置零、加法、移位和循环操作。
二、方案说明设计一个4位二进制乘法器,可以存储其乘积。
电路原理框图如图1所示。
乘法器可以利用家发起和寄存器实现。
图1 乘法器原理框图寄存器B存放被乘数,寄存器Q存放乘数,两个乘积长度可能是原来的2倍,故计算完成后将累加和高位放入寄存器A,而Q放寄存器的低位,P 记录乘数的位数,每形成一个部分P加1,当P=4时,乘法结束,两数之积放在AQ寄存器中。
控制端产生四个控制信号分别为T0、T1、T2、T3。
在初态T0时,被乘数和乘数已分别存于寄存器B和Q中,等待启动信号S的到来,当S=1时控制器进入状态T1,在此状态下A、E、P清零,准备乘法操作。
从状态T2开始,控制器进入累计部分积的循环操作过程。
首先检验乘数的最低有效位Q1。
如Q1=1,A和B相加结果存于A和E之中;如果Q1=0,不做加法运算。
无论Q1为何值,都要将计数器P加1。
在状态T3,合成寄存器EAQ右移一位得到累计的部分积,时检测P之值,如果P不等于4,状态返回T2,继续累计部分积的过程。
如果P=4,停止循环,系统返回初始状态T0。
三、电路设计1、控制器设计根据图2所示的ASM图表,可以设计二进制乘法器的控制器。
图2 二进制乘法器ASM图表四个D触发器的驱动方程为:D0=T0S’+T3Z=((T0S’)’·(T3Z)’)’D1=T0S=((T0S)’)’D2=T1+T3Z’=(T1’·(T3Z’)’)’D3=T2控制器仿真电路如图2所示。
控制器中S为启动信号,高电平有效,系统开始工作时应使T0=1,T1=T2=T3=0,故图中设置了Reset信号(负脉冲)图2 二进制乘法器的控制逻辑图2. 二进制乘法器数据处理器(1) A寄存器A寄存器具有并入、移位、同步清0和保持功能。
EDA技术之高速四位乘法器设计

实验二高速四位乘法器设计
一、实验目的
1.熟悉利用MAX-plusⅡ的原理图输入方法设计简单的组合电路
2.掌握层次化设计的方法
3.掌握高速乘法器的设计方法
二、实验原理
根据乘法的运算规则,不难得出下图所示的乘法器的原理框图。
4位加法器可以选择74283,b0*a,b1*a, b2*a,b3*a实际就是1位和4位的与运算,如下图所示。
由原理框图不难得出高速四位乘法器电路图。
三、实验内容
按以上原理实现一个高速4位乘法器
四、实验步骤
1.如上图所示,利用MAX-plusⅡ中的图形编辑器设计1-4的二进制乘法器,进行编译、仿真,并将其设置成为一元件(可根据需要对元件符号进行调整)。
注意:编译之前必须将文件设为当前文件。
2.建立一个更高得原理图设计层次,利用前面生成的1-4的二进制乘法器和调用库中的74283元件设计一高速4位乘法器
3.选择器件“Assign”|“Device”|“MAX7000S”|“EPM7128SLC84-6”,并根据下载板上的标识对管脚进行配置。
然后下载,进行硬件测试,检验结果是否正确。
五、实验报告:
先设计一个4位加法器,如下图:
高速4位乘法器元件图如下:
4位乘法器仿真波形:。
EDA乘法器实验报告
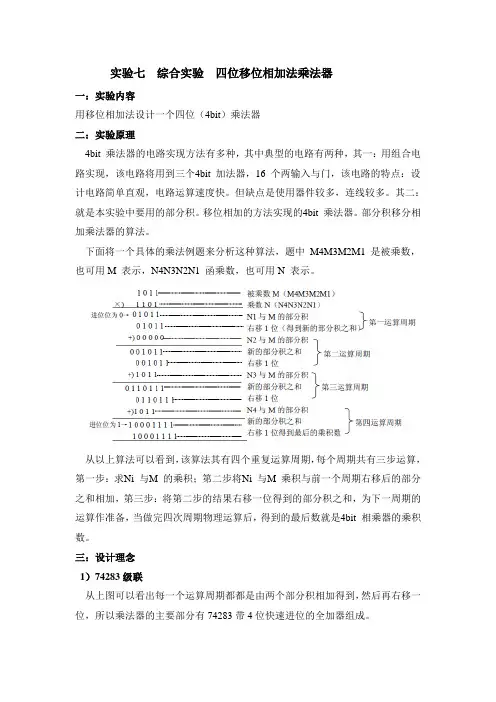
实验七综合实验四位移位相加法乘法器一:实验内容用移位相加法设计一个四位(4bit)乘法器二:实验原理4bit 乘法器的电路实现方法有多种,其中典型的电路有两种,其一:用组合电路实现,该电路将用到三个4bit 加法器,16 个两输入与门,该电路的特点:设计电路简单直观,电路运算速度快。
但缺点是使用器件较多,连线较多。
其二:就是本实验中要用的部分积。
移位相加的方法实现的4bit 乘法器。
部分积移分相加乘法器的算法。
下面将一个具体的乘法例题来分析这种算法,题中M4M3M2M1 是被乘数,也可用M 表示,N4N3N2N1 函乘数,也可用N 表示。
从以上算法可以看到,该算法其有四个重复运算周期,每个周期共有三步运算,第一步:求Ni 与M 的乘积;第二步将Ni 与M 乘积与前一个周期右移后的部分之和相加,第三步:将第二步的结果右移一位得到的部分积之和,为下一周期的运算作准备,当做完四次周期物理运算后,得到的最后数就是4bit 相乘器的乘积数。
三:设计理念1)74283级联从上图可以看出每一个运算周期都都是由两个部分积相加得到,然后再右移一位,所以乘法器的主要部分有74283带4位快速进位的全加器组成。
将乘法器打包成如下形式波形图:在时钟的每一个上升沿的时候,乘法器进行运算。
2)将二进制转换为10进制但是由于要在七段LED数码管中显示,所以原始的输出形式不能满足,因为上边的器件输出的是二进制,所以要将输入的乘数被乘数和结果转化为10进制,最大四位二进制即十进制的15,将被乘数A【3..0】和乘数B【3..0】除以10,余数即为个位,同理输出的结果最大为225,连续两次除以10,分别得到个位,十位的数,这样就将二进制的乘数,被乘数和结果转化为了10进制的数,从而方便了数码管的显示。
如图:rl rm rn个位,q4 q5 rh十位,q2百位。
3)选择器下面是将输出结果用7449译码器译码到数码管中,但是一个译码器不能同时译码(最多7个)数据,所以要用时钟信号以及多选器。
数电— 4位并行乘法器的电路设计与仿真
# 155reset=0,a=15,b=14,y=162
# 170reset=0,a=15,b=14,y=178
# 185reset=0,a=15,b=14,y=210
# 200reset=0,a= 0,b= 0,y=210
# 225reset=0,a= 0,b= 0,y=156
reg a,b,ci;
wire s,co;
fulladder add0(s,co,a,b,ci);
initial
begin
a=1'b0;b=1'b0;ci=1'b1;
#15 a=1'b0;b=1'b0;ci=1'b0;
$monitor($time,"a=%d,b=%d,ci=%d,s=%d,co=%d",a,b,ci,s,co);
文档:分析文档、设计文档、测试文档、代码和总结。
设要有完整的组合逻辑电路设计步骤;
每一步骤完成要正确合理;
设计电路时分模块测试。
时间安排
分析设计阶段:周一至周二上午;
代码编写阶段:周二下午至周三;
代码测试优化阶段:周四;
仿真分析及总结:周五上午;
验收:周五下午。
验收标准
文档齐全(20分)。
注:无文档不可以进行下一步。
#15 a=1'b1;b=1'b1;ci=1'b1;
end
endmodule
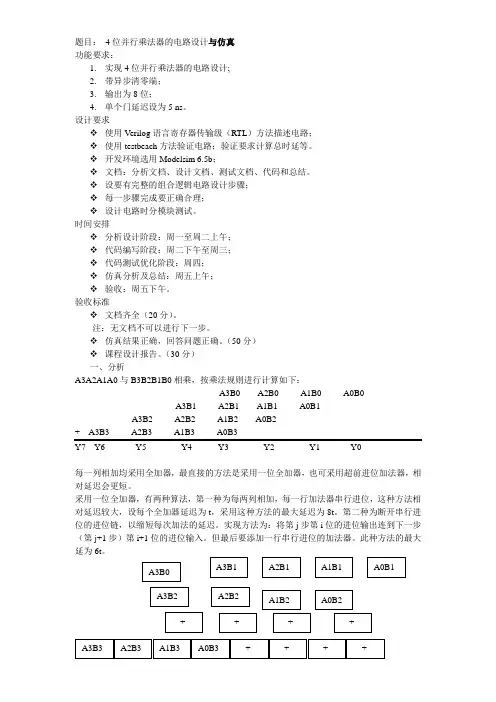
//一位全加器加上最大延迟15ns,分析乘法器最大延时为90ns(六个全加器),
//实际测得乘法器延时75ns,即可输出正确结果。测试结果如下:
# 0reset=1,a= 1,b= 4,y= 0
计算机组成原理实验_乘法器
学院计算机组成原理实验报告年级学号姓名成绩专业实验地点指导教师实验项目乘法器实验日期一.实验目的:理解并掌握乘法器的原理二.实验步骤(1)打开QuartusII。
(2)将子板上的JTAG端口与PC机的并行口用下载电缆连接。
打开实验台电源。
(3)执行Tools—Programmer命令,将shifter.sof下载到FPGA中。
注意在执行Programmer命令中应在Programmer/configure下的方框中打勾,然后下载。
(4)在实验台上通过模式开关选择FPGA-CPU独立调试模式010.(5)将短路子DZ3短接且短路子DZ4 断路。
使FPGA-CPU所需要的时钟使用正单脉冲时钟。
三.实验代码--实验6.6 Booth乘法器LIBRARY IEEE;USE IEEE.Std_logic_1164.ALL;ENTITY booth_multiplier ISGENERIC(k : POSITIVE := 3); --input number word length less onePORT( multiplicand : IN BIT_VECTOR(k DOWNTO 0);multiplier : IN BIT_VECTOR(k DOWNTO 0);clock : IN BIT;product : INOUT BIT_VECTOR((2*k + 2) DOWNTO 0);final : OUT BIT);END booth_multiplier;ARCHITECTURE structural OF booth_multiplier ISSIGNAL mdreg : BIT_VECTOR(k DOWNTO 0);SIGNAL adderout : BIT_VECTOR(k DOWNTO 0);SIGNAL carries : BIT_VECTOR(k DOWNTO 0);SIGNAL augend : BIT_VECTOR(k DOWNTO 0);SIGNAL tcbuffout : BIT_VECTOR(k DOWNTO 0);SIGNAL adder_ovfl : BIT;SIGNAL comp : BIT;SIGNAL clr_md : BIT;SIGNAL load_md : BIT;SIGNAL clr_pp : BIT;SIGNAL load_pp : BIT;SIGNAL shift_pp : BIT;SIGNAL boostate : NATURAL RANGE 0 TO 2*(k + 1) :=0;BEGINPROCESS --main clocked process containing all sequential elementsBEGINWAIT UNTIL (clock'EVENT AND clock = '1');--register to hold multiplicand during multiplicationIF clr_md = '1' THENmdreg<= (OTHERS => '0');ELSIF load_md = '1' THENmdreg<= multiplicand;ELSEmdreg<= mdreg;END IF;--register/shifter accumulates partial product valuesIF clr_pp = '1' THENproduct<= (OTHERS => '0');product((k+1) downto 1) <= multiplier;ELSIF load_pp = '1' THENproduct((2*k + 2) DOWNTO (k + 2)) <= adderout; --add to top halfproduct((k+1) DOWNTO 0) <= product((k+1) DOWNTO 0); --refresh bootm half ELSIF shift_pp = '1' THENproduct<= product SRA 1; --shift right with sign extendELSEproduct<= product;END IF;END PROCESS;--adder adds/subtracts partial product to multiplicandaugend<= product((2*k+2) DOWNTO (k+2));addgen : FOR i IN adderout'RANGEGENERATElsadder : IF i = 0 GENERATEadderout(i) <= tcbuffout(i) XOR augend(i) XOR product(1);carries(i) <= (tcbuffout(i) AND augend(i)) OR(tcbuffout(i) AND product(1)) OR(product(1) AND augend(i)); END GENERATE;otheradder : IF i /= 0 GENERATEadderout(i) <= tcbuffout(i) XOR augend(i) XOR carries(i-1);carries(i) <= (tcbuffout(i) AND augend(i)) OR(tcbuffout(i) AND carries(i-1)) OR(carries(i-1) AND augend(i)); END GENERATE;END GENERATE;--twos comp overflow bitadder_ovfl<= carries(k-1) XOR carries(k);--true/complement buffer to generate two's comp of mdregtcbuffout<= NOT mdreg WHEN (product(1)='1') ELSE mdreg;--booth multiplier state counterPROCESS BEGINWAIT UNTIL (clock'EVENT AND clock = '1');IF boostate< 2*(k + 1) THENboostate<= boostate + 1;final<='0';ELSEfinal<='1';boostate<= 0;END IF;END PROCESS;--assign control signal values based on statePROCESS(boostate)BEGIN--assign defaults, all registers refreshclr_md<= '0';load_md<= '0';clr_pp<= '0';load_pp<= '0';shift_pp<= '0';--boostate<=0;IF boostate = 0 THENload_md<= '1';clr_pp<= '1';ELSIF boostate MOD 2 = 0 THEN --boostate = 2,4,6,8 ....shift_pp<= '1';ELSE --boostate = 1,3,5,7......IF product(1) = product(0) THENNULL; --refresh ppELSEload_pp<= '1'; --update productEND IF;END IF;END PROCESS;END structural;四.实验现象本实验实现4位数Booth乘法(有符号的乘除法)。
实验一4位运算器设计
实验⼀4位运算器设计实验⼆ 4 位运算器设计⼀、实验名称:4 位运算器设计⼆、实验学时:5 学时三、实验⽬的:1. 利⽤Verilog建⽴4位运算器模型2. 对所设计的运算器进⾏功能验证四、实验内容:设计⼀个四位算术逻辑运算器电路,并测试其功能。
具体要求如下:1. 设计运算器,实验加减乘、逻辑与、或等功能和⾃⾏设计记录表格2. 输⼊端的0,1 可由拨码开关模拟3. 输出端接Led 灯显⽰输出数据4. 观察输出结果,记录输⼊、输出数据。
五、实验原理:1. ALU原理算术逻辑单元 (Arithmetic-Logic Unit, ALU)是中央处理器的执⾏单元,是所有中央处理器的核⼼组成部分,由"And Gate" 和"Or Gate"构成的算术逻辑单元,主要功能是进⾏⼆位元的算术运算,如加减乘(不包括整数除法)。
2. ⽤拨码开关来模拟 0、1 输⼊3. led指⽰灯显⽰输出4. ⽤按钮来模拟 0、1的低位进位输⼊六、实验步骤:1.根据实验要求作预习报告。
2.建⽴⼯程,设计程序:1)新建⼯程;2)新建verilog HDL⽂件(注:⽂件名和模块名称要和⼯程名保持⼀致)。
3)调试程序:3. 配置管脚:参照实验指导中的管脚图,配置管脚。
4.下载到开发板,观察实验结果,尝试创造⾃⼰的实验⽅案:七、实验报告要求:1. 说明实验⽬的、原理、步骤2. 实验程序及程序分析3. 给出试验结果(显⽰的结果,如照⽚或计算机绘制图⽚)4. 给出实验记录,并对记录进⾏分析。
5. 总结分析实验中所出现的问题,有何收获和体会。
河南工业大学EDA技术 实验报告实验五 用LPM设计8位数控分频器和4位乘法器
河南工业大学EDA技术实验报告专业电科班级姓名学号 2 实验地点6526+ 6215 实验日期-11-4 成绩评定一、实验项目实验五用LPM设计8位数控分频器和4位乘法器二、实验目的掌握LPM模块的参数设置方法以及设计和应用方法。
三、实验原理对于高速测控系统,影响测控速度最大的因素可能是,在测得必要的数据并经过复杂的运算后,才能发出控制指令。
因此数据的运算速度决定了此系统的工作速度。
为了提高运算速度,可以用多种方法来解决,如高速计算机、纯硬件电路、ROM查表式运算器等。
用高速计算机属于软件解决方案,用纯硬件运算器属于硬件解决方案,而ROM属于查表式运算解决方案。
数控分频器的功能要求为:若在其输入端给定不同的数据,其输出脉冲具有相应的对输入时钟的分频比。
设计流程是首先按照原理图输入的设计步骤,通过元件输入窗在原理图编辑窗中调入兆功能块,并按图连接起来,其中计数器LPM-COUNTER模块的参数设置可按照以下介绍的方法进行。
硬件乘法器有多种实现方法,相比之下,由高速RAM构成乘法表方式的乘法表方式的乘法器的运算速度最快。
8位数控分频器电路原理图用LPM_ROM设计的4位乘法器原理图DFF的VHDL代码:(1)8位数控分频器数控分频器的功能要求为:若在其输入端给定不同的数据,其输出脉冲具有相应的对输入时钟的分频比。
(2)4位乘法器硬件乘法器有多种实现方法,相比之下,由高速RAM构成乘法表方式的乘法表方式的乘法器的运算速度最快。
一个4×4bit查表式乘法器乘法表文件如下图所示;四、仿真结果及分析下图即为8位数控分频器的仿真结果,仿真参数设置时具体设置界面如下图所示,波形图如图;下图即为乘法器的仿真结果,仿真参数设置时具体设置界面如下图所示;五、硬件验证过程及结果分析数控分频器的硬件验证时通过数码管来观察分频器的数据变化情况。
4位乘法器的硬件测试引脚并连接至插槽,通过数码管来观察数据相乘后的结果。
vhdl 四位流水线乘法器
实验二四位流水线乘法器一、实验目的1.了解四位并行乘法器的原理。
2.了解四位并行乘法器的设计思想和流水线的实现方法。
3.掌握用VHDL 语言实现基本二进制运算的方法。
二、实验内容与要求通过开关和键盘输入两组4BIT的二进制数据,按照二进制加法器原理进行加和,求出和及进位,并通过LED显示灯输出显示,完成编译、综合、适配、仿真、实验箱上的硬件测试。
三、实验原理流水线结构的并行乘法器的最大有点就是速度快,尤其实在连续输入的乘法器中,可以达到近乎单周期的运算速度。
流水线乘法器是组合逻辑电路实现无符号数乘法的方法上发展而来的。
其关键是在组合逻辑电路的基础上插入寄存器。
假如有被乘数A 和乘数B,首先用A 与B 的最低位相乘得到S1,然后再把A 左移1 位与B 的第2 位相乘得到S2,再将A 左移3 位与B 的第三位相乘得到S3,依此类推,直到把B 的所有位都乘完为止,然后再把乘得的结果S1、S2、S3……相加即得到相乘的结果。
需要注意的是,具体实现乘法器是,并不是真正的去乘,而是利用简单的判断去实现,举个简单的例子。
假如A 左移n 位后与B 的第n 位相乘,如果B 的这位为‘1’,那么相乘的中间结果就是A 左移n 位后的结果,否则如果B 的这位为‘0’,那么就直接让相乘的中间结果为0 即可。
带B 的所有位相乘结束后,把所有的中间结果相加即得到A 与B 相乘的结果。
在此基础上插入寄存器即可实现流水线乘法器。
四、实验平台(1)硬件:计算机、GX-SOC/SOPC-DEV-LABCycloneII EP2C35F672C8核心板(2)软件:Quartus II软件PIN_AF8 DATAOUT[4] LED4PIN_AE7 DATAOUT[5] LED5PIN_AF7 DATAOUT[6] LED6PIN_AA11 DATAOUT[7] LED7PIN_AE21 BCD[0] 数码管DP4BPIN_AB20 BCD[1]PIN_AC20 BCD[2]PIN_AF20 BCD[3]PIN_AE20 BCD[4] 数码管DP5BPIN_AD19 BCD[5]PIN_AC19 BCD[6]PIN_AA17 BCD[7]PIN_AA18 BCD[8] 数码管DP6BPIN_W17 BCD[9]PIN_V17 BCD[10]PIN_AB18 BCD[11]六、仿真截图七、硬件实现八、程序代码1---clkgen.vhdlibrary IEEE;-- 1HZuse IEEE.std_logic_1164.all;use ieee.std_logic_unsigned.all;entity clkgen isport (CLK : in std_logic;CLK1HZ: out std_logic);end entity;architecture clk_arch of clkgen issignal COUNT : integer range 0 to 50000000; --50MHZ -->1hz begin -- 50M/1=50000000 PROCESS(CLK)BEGINif clk'event and clk='1' thenIF COUNT= 50000000 thenCOUNT<=0;ELSE COUNT<=COUNT+1;END IF;END IF;END PROCESS;PROCESS(COUNT)BEGINIF COUNT= 5000000 THEN -- 1HZCLK1HZ<='1';ELSE CLK1HZ<='0';END IF;END PROCESS;end architecture;2—BCD-- 输出控制模块,把乘法器的输出转换成BCD码在数码管上显示、-- SCKZ.VHDlibrary IEEE;use IEEE.STD_LOGIC_1164.ALL;use IEEE.STD_LOGIC_ARITH.ALL;use IEEE.STD_LOGIC_UNSIGNED.ALL;entity BIN2BCD isport ( DIN: in std_logic_vector(7 downto 0); ---The input 8bit binaryBCDOUT: out std_logic_vector(11 downto 0)--输出显示, 已转换成BCD码);end entity;architecture arch of BIN2BCD issignal data2,data3,data4 :std_logic_vector(9 downto 0);-- 输出数据缓存signal hundred,ten,unit:std_logic_vector(3 downto 0);--signal bcdbuffer:std_logic_vector(11 downto 0);---2'1111_1001_11=999beginBCDOUT<= bcdbuffer;bcdbuffer(11 downto 8)<=hundred;bcdbuffer(7 downto 4)<=ten;bcdbuffer(3 downto 0)<=unit;get_hundred_value:process(data2)beginDA TA2<="00"&DIN;---get hundred valueif data2>=900 thenhundred<="1001";--9data3<=data2-900;elsif data2>=800 thenhundred<="1000";--8data3<=data2-500;elsif data2>=700 thenhundred<="0111";--7data3<=data2-700;elsif data2>=600 thenhundred<="0110";--6data3<=data2-600;elsif data2>=500 thenhundred<="0101";--5data3<=data2-500;elsif data2>=400 thenhundred<="0100";--4data3<=data2-400;elsif data2>=300 thenhundred<="0011";--3data3<=data2-300;elsif data2>=200 thenhundred<="0010";--2data3<=data2-200;elsif data2>=100 thenhundred<="0001";--1data3<=data2-100;else data3<=data2;hundred<="0000";end if;end process; ---get_thousand_valueget_tens_value:process(data3) begin---get tens placeif data3>=90 thenten<="1001";--9data4<=data3-90;elsif data3>=80 thenten<="1000";--8data4<=data3-50;elsif data3>=70 thenten<="0111";--7data4<=data3-70;elsif data3>=60 thenten<="0110";--6data4<=data3-60;elsif data3>=50 thenten<="0101";--5data4<=data3-50;elsif data3>=40 thenten<="0100";--4data4<=data3-40;elsif data3>=30 thenten<="0011";--3data4<=data3-30;elsif data3>=20 thenten<="0010";--2data4<=data3-20;elsif data3>=10 thenten<="0001";--1data4<=data3-10;else data4<=data3;ten<="0000";end if;end process; ---get_ten_valueget_unit_value:process(data4)begin--unit's orderif (data4>0) thenunit<=data4(3 downto 0);else unit<="0000";end if;end process;end arch;3 multi4b --------------------------------------------------------------------------------/ -- DESCRIPTION : Signed mulitplier:-- AIN (A) input width : 4-- BIN (B) input width : 4-- Q (data_out) output width : 8-- 并行流水乘法器--------------------------------------------------------------------------------/--10 × 9 = 90-- 1 0 1 0-- 1 0 0 1 =-- --------------- 1 0 1 0-- 0 0 0 0 --partial products-- 0 0 0 0-- 1 0 1 0-- -------------------- 1 0 1 1 0 1 0--parallel : process all the inputs at the same time--pipeline : use several stages with registers to implement it----关键思想,插入寄存器library IEEE;use IEEE.STD_LOGIC_1164.ALL;use IEEE.STD_LOGIC_ARITH.ALL;use IEEE.STD_LOGIC_UNSIGNED.ALL;entity multi4b isport ( CLK: in STD_LOGIC; ---system clockAIN: in STD_LOGIC_VECTOR (3 downto 0); ---one inputBIN: in STD_LOGIC_VECTOR (3 downto 0);-- the other inputdata_out: out STD_LOGIC_VECTOR (7 downto 0)---the result ---make sure the biggest value ,i,e. 1111x1111=1110_0001 can be held in the register );end multi4b;architecture multi_arch of multi4b issignal A,B :std_logic_vector(3 downto 0); --input register---registers to hold the result of the first processing---registers added to make use of pipeline, the 1st stagesignal A_MULT_B0: STD_LOGIC_VECTOR (3 downto 0);signal A_MULT_B1: STD_LOGIC_VECTOR (3 downto 0);signal A_MULT_B2: STD_LOGIC_VECTOR (3 downto 0);signal A_MULT_B3: STD_LOGIC_VECTOR (3 downto 0);---register to hold the result of the multipliersignal C_TEMP : STD_LOGIC_VECTOR (7 downto 0);beginPROCESS(CLK,AIN,BIN)beginif CLK'EVENT AND CLK='1' THEN-- multiplier operand inputs are registeredA<= AIN;B<= BIN;-----------------Fist stage of the multiplier------------------here we get the axb(0),axb(1),axb(2),axb(3),i.e.partial products---put them into the responding registersA_MULT_B0(0) <= A (0) and B (0);----- multi 1 , get the a(0) and b(0), & put it into the register A_MULT_B0(0)A_MULT_B0(1) <= A (1) and B (0);A_MULT_B0(2) <= A (2) and B (0);A_MULT_B0(3) <= A (3) and B (0);--10 × 9 = 90-- 1 0 1 0-- 1 0 0 1 =-- --------------- 0 0 0 0 1 0 1 0-- 0 0 0 0 0 0 0 0 --partial products-- 0 0 0 0-- 1 0 1 0-- -------------------- 1 0 1 1 0 1 0A_MULT_B1(0) <= A (0) and B (1);A_MULT_B1(1) <= A (1) and B (1);A_MULT_B1(2) <= A (2) and B (1);A_MULT_B1(3) <= A (3) and B (1);A_MULT_B2(0) <= A (0) and B (2);A_MULT_B2(1) <= A (1) and B (2);A_MULT_B2(2) <= A (2) and B (2);A_MULT_B2(3) <= A (3) and B (2);A_MULT_B3(0) <= A (0) and B (3);A_MULT_B3(1) <= A (1) and B (3);A_MULT_B3(2) <= A (2) and B (3);A_MULT_B3(3) <= A (3) and B (3);end if;end process;--------------------Second stage of the multiplier---------------add the all the partial products ,then get the result of the multiplier C_TEMP<=( "0000" & A_MULT_B0 )+( "000"& A_MULT_B1 &'0' )+( "00" & A_MULT_B2 & "00" )+( '0'&A_MULT_B3 & "000" );--build a signal register output---输出寄存,利于实现流水data_out <= C_TEMP; --output registerend multi_arch;九、实验总结。
乘法器实验报告
实验报告实验题目:乘法器姓名:闫盼蛟学号:2009432017一.实验目的理解并掌握乘法器的原理二.实验原理1.有符号数乘法——Booth乘法器Booth算法是一个更有效的计算有符号数乘法的算法,算法的新颖之处在于减法也可以用于计算乘积。
假定2(10)×6(10),或者说0010B×0110B:Booth发现加法和减法可以得到同样的结果。
Booth算法的关键在于把1分类为开始、中间、结束3种。
如图:1的结束1的中间1的开始当然一串0的时候加法减法都不做。
因此,总结1的分类情况有4种。
如下表:Booth算法是根据乘数的相邻2位来决定操作,第一步根据相邻2为的4中情况来进行加或减操作,第二步仍然是将积寄存器右移。
算法描述如下:(1)根据当前位和其右边的位,做如下操作。
00:0的中间,无任何操作01:1的结束,将被乘数加到积的左半部分10:1的开始,积的左半部分减去被乘数11:1的中间,无任何操作(2)将积寄存器右移一位。
需要注意的是,因为Booth乘法器实有符号数的乘法,因此积寄存器移位的时候,为了保留符号位,进行算术右移,不像前面的算法逻辑右移就可以了。
三.实验代码LIBRARY IEEE;USE IEEE.Std_logic_1164.ALL;ENTITY booth_multiplier ISGENERIC(k : POSITIVE := 3); --input number word length less onePORT( multiplicand : IN BIT_VECTOR(k DOWNTO 0);multiplier : IN BIT_VECTOR(k DOWNTO 0);clock : IN BIT;product : INOUT BIT_VECTOR((2*k + 2) DOWNTO 0);final : OUT BIT);END booth_multiplier;ARCHITECTURE structural OF booth_multiplier ISSIGNAL mdreg : BIT_VECTOR(k DOWNTO 0);SIGNAL adderout : BIT_VECTOR(k DOWNTO 0);SIGNAL carries : BIT_VECTOR(k DOWNTO 0);SIGNAL augend : BIT_VECTOR(k DOWNTO 0);SIGNAL tcbuffout : BIT_VECTOR(k DOWNTO 0);SIGNAL adder_ovfl : BIT;SIGNAL comp : BIT;SIGNAL clr_md : BIT;SIGNAL load_md : BIT;SIGNAL clr_pp : BIT;SIGNAL load_pp : BIT;SIGNAL shift_pp : BIT;SIGNAL boostate : NATURAL RANGE 0 TO 2*(k + 1) :=0;BEGINPROCESS --main clocked process containing all sequential elementsBEGINW AIT UNTIL (clock'EVENT AND clock = '1');--register to hold multiplicand during multiplicationIF clr_md = '1' THENmdreg <= (OTHERS => '0');ELSIF load_md = '1' THENmdreg <= multiplicand;ELSEmdreg <= mdreg;END IF;--register/shifter accumulates partial product valuesIF clr_pp = '1' THENproduct <= (OTHERS => '0');product((k+1) downto 1) <= multiplier;ELSIF load_pp = '1' THENproduct((2*k + 2) DOWNTO (k + 2)) <= adderout; --add to top halfproduct((k+1) DOWNTO 0) <= product((k+1) DOWNTO 0); --refresh bootm halfELSIF shift_pp = '1' THENproduct <= product SRA 1; --shift right with sign extendELSEproduct <= product;END IF;END PROCESS;--adder adds/subtracts partial product to multiplicandaugend <= product((2*k+2) DOWNTO (k+2));addgen : FOR i IN adderout'RANGEGENERATElsadder : IF i = 0 GENERATEadderout(i) <= tcbuffout(i) XOR augend(i) XOR product(1);carries(i) <= (tcbuffout(i) AND augend(i)) OR(tcbuffout(i) AND product(1)) OR(product(1) AND augend(i));END GENERATE;otheradder : IF i /= 0 GENERATEadderout(i) <= tcbuffout(i) XOR augend(i) XOR carries(i-1);carries(i) <= (tcbuffout(i) AND augend(i)) OR(tcbuffout(i) AND carries(i-1)) OR(carries(i-1) AND augend(i));END GENERATE;END GENERA TE;--twos comp overflow bitadder_ovfl <= carries(k-1) XOR carries(k);--true/complement buffer to generate two's comp of mdregtcbuffout <= NOT mdreg WHEN (product(1)='1') ELSE mdreg;--booth multiplier state counterPROCESS BEGINW AIT UNTIL (clock'EVENT AND clock = '1');IF boostate < 2*(k + 1) THENboostate <= boostate + 1;final <='0';ELSEfinal <='1';boostate <= 0;END IF;END PROCESS;--assign control signal values based on statePROCESS(boostate)BEGIN--assign defaults, all registers refreshclr_md <= '0';load_md <= '0';clr_pp <= '0';load_pp <= '0';shift_pp <= '0';--boostate <=0;IF boostate = 0 THENload_md <= '1';clr_pp <= '1';ELSIF boostate MOD 2 = 0 THEN --boostate = 2,4,6,8 ....shift_pp <= '1';ELSE --boostate = 1,3,5,7......IF product(1) = product(0) THENNULL; --refresh ppELSEload_pp <= '1'; --update productEND IF;END IF;END PROCESS;END structural;四.实验步骤(1)打开Quartus Ⅱ。