
7.1 选择性样本模型
第7章说明
• 这些模型与方法,无论在计量经济学理论方面还是在实际 应用方面,都具有重要意义。但是,这些模型都形成了各 自丰富的内容体系,甚至是计量经济学的新分支学科,模 型方法的数学过程较为复杂。 • 本章只介绍其中最简单的模型,以了解这些模型理论与方 法的概念与思路。
§7.1 选择性样本模型
Selective Samples Model
i 1,2, ,57
R2 0.9775
• 由于被解释变量数据的截断问题,使得原模型变 换为包含一个非线性项模型。
• 如果采用OLS直接估计原模型:
– 实际上忽略了一个非线性项; – 忽略了随机误差项实际上的异方差性。 – 这就造成参数估计量的偏误,而且如果不了解解释变 量的分布,要估计该偏误的严重性也是很困难的。
4、例7.1.1:城镇居民消费模型
人均收入 1120 1310 1300 1430 1500 1670 2100 2370 2530 2790 2980 3200 3460 3630 3880 4040 4210 4390 4520 人均消费 1020 1150 1145 1230 1275 1385 1660 1840 1950 2110 2240 2380 2550 2660 2700 2730 2720 2850 2800 人均收入 4640 4750 4800 4810 4990 5070 5130 5210 5300 5390 5450 5500 5570 5630 5690 5770 5860 5930 6000 人均消费 2900 2980 2970 3050 3200 3100 3175 3200 2450 3230 3310 3500 3510 3590 3600 3650 3720 3850 3800 人均收入 6090 6200 6330 6450 6570 6700 6840 7010 7170 7350 7500 7670 7840 8000 8190 8350 8500 8690 8830 人均消费 3900 3950 4000 4030 4080 4130 4000 4200 4160 4210 4325 4385 4450 4500 4865 4880 4890 4920 4970
Censored(11000) 估计
Dependent Variable: CONS Method: ML - Censored Normal (TOBIT) Date: 11/29/04 Sample: 1 31 Included observations: 31 Right censoring (value) series: 11000 Convergence achieved after 8 iterations Covariance matrix computed using second derivatives Coefficient C INCOM 25.62933 0.775212 Std. Error 306.6661 0.036891 Time: 17:25
• 如果样本观测值不是以0为界,而是以某一个数值 a为界,则有
ya y y* 当y * a 当y * a
y * ~ N ( , 2 )
估计原理与方法相同。
4、例7.1.2:城镇居民消费模型
人均收入 1000 1120 1310 1300 1430 1500 1670 2100 2370 2530 2790 2980 3200 3460 3630 3880 4040 4210 4390 4520 人均消费 1000 1020 1150 1145 1230 1275 1385 1660 1840 1950 2110 2240 2380 2550 2660 2700 2730 2720 2850 2800 人均收入 1040 4640 4750 4800 4810 4990 5070 5130 5210 5300 5390 5450 5500 5570 5630 5690 5770 5860 5930 6000 人均消费 1000 2900 2980 2970 3050 3200 3100 3175 3200 2450 3230 3310 3500 3510 3590 3600 3650 3720 3850 3800 人均收入 1080 6090 6200 6330 6450 6570 6700 6840 7010 7170 7350 7500 7670 7840 8000 8190 8350 8500 8690 8830 人均消费 1000 3900 3950 4000 4030 4080 4130 4000 4200 4160 4210 4325 4385 4450 4500 4865 4880 4890 4920 4970
三、“归并”问题的计量经济学模型
1、思路
• 以一种简单的情况为例,讨论“归并”问题的计 量经济学模型。即假设被解释变量服从正态分布, 其样本观测值以0为界,凡小于0的都归并为0, 大于0的则取实际值。如果y*以表示原始被解释变 量,y以表示归并后的被解释变量,那么则有:
y0 yy
*
当y * 0 当y 0
– 例如消费函数模型:由于抽样原因,被解释变 量样本观测值最低200元、最高10000元。
2、“归并” (censoring)问题
• 将被解释变量的处于某一范围的样本观测值都用 一个相同的值代替。
– 经常出现在“检查”、“调查”活动中,因此也称为 “检查”(censoring) 问题。 – 例如需求函数模型:用实际消费量作为需求量的观测 值,如果存在供给限制,就出现“归并”问题。 – 被解释变量观测值存在最高和最低的限制。例如考试 成绩,最高100,最低0,出现“归并”问题。
一、经济生活中的选择性样本问题 二、“截断”问题的计量经济学模型
三、“归并”问题的计量经济学模型
一、经济生活中的选择性样本问题
1、“截断”(truncation)问题 • 由于条件限制,样本不能随机抽取,即不 能从全部个体,而只能从一部分个体中随 机抽取被解释变量的样本观测值,而这部 分个体的观测值都大于或者小于某个确定 值。 “掐头”或者“去尾”。
OLS估计:将样本看为不受任何限制下随机抽取的样本
Yi 604.93 0.5083X i
i 1,2, ,57
R2 0.9777
ML估计:将样本看为在消费水平大于1000元、小于5000元
的特定人群中随机抽取的样本
截断点 选择
样本类 型选择
估计方法选择
Yi 556.70 0.5194 X i
二、“截断”问题的计量经济学模型
1、ห้องสมุดไป่ตู้路
• 如果一个单方程计量经济学模型,只能从“掐头” 或者“去尾”的连续区间随机抽取被解释变量的 样本观测值,那么很显然,抽取每一个样本观测 值的概率以及抽取一组样本观测值的联合概率, 与被解释变量的样本观测值不受限制的情况是不 同的。
• 如果能够知道在这种情况下抽取一组样本观测值 的联合概率函数,那么就可以通过该函数极大化 求得模型的参数估计量。
Mean dependent var S.D. dependent var Akaike info criterion Schwarz criterion Hannan-Quinn criter.
Censored(12000) 估计—与OLS相同
Dependent Variable: CONS Method: ML - Censored Normal (TOBIT) Date: 11/30/04 Sample: 1 31 Included observations: 31 Right censoring (value) series: 12000 Convergence achieved after 4 iterations Covariance matrix computed using second derivatives Coefficient C INCOM 283.3025 0.740774 Std. Error 264.2754 0.030739 z-Statistic 1.071998 24.09852 Prob. 0.2837 0.0000 Time: 09:05
参数估计结果、似然函数值都 与OLS估计差异较大。为什么 似然函数值大于OLS估计?
z-Statistic 0.083574 21.01348
Prob. 0.9334 0.0000
Error Distribution SCALE:C(3) R-squared Adjusted R-squared S.E. of regression Sum squared resid Log likelihood Avg. log likelihood Left censored obs Uncensored obs 396.7539 0.949968 0.946394 404.4725 4580745. -215.7708 -6.960348 0 29 Right censored obs Total obs 2 31 52.22918 7.596403 0.0000 6427.886 1746.959 14.11425 14.25302 14.15948
Error Distribution SCALE:C(3) R-squared Adjusted R-squared S.E. of regression Sum squared resid Log likelihood Avg. log likelihood Left censored obs Uncensored obs 386.8636 0.949359 0.945742 406.9253 4636469. -228.6873 -7.377011 0 31 Right censored obs Total obs 0 31 49.13244 7.873893 0.0000 6427.886 1746.959 14.94757 15.08634 14.99281
计量经济学模型类型选择

本章内容
• 第1节是关于计量经济学应用模型的模型类型设定,讨论如 何针对研究对象选择计量经济学模型类型。
• 第2节是关于总体回归模型设定中的变量选择问题,讨论在 模型类型确定之后,应该按照什么原则选择进入模型的变 量。
• 第3节是关于模型函数关系设定,讨论如何在经济学理论和 在统计分析的指导下,设定模型中解释变量和被解释变量 之间的关系,即模型的函数形式。
• 第4节是关于模型变量性质设定,讨论如何确定被选择进入 模型的变量的性质,重点讨论了变量性质设定的相对性。
§9.1 计量经济学应用模型类型设定
一、问题的提出 二、单方程应用模型类型对被解释 变量数据类型的依赖性 三、单方程模型和联立方程模型的 选择对经济行为的依赖性
• 变与不变 •变
– 截面个体变化、时点变化 – 变截距、变系数 – 固定效应、随机效应
三、单方程模型和联立方程模型的选择 对经济行为的依赖性
1、一般原则
• 计量经济学应用模型应该是研究对象的经济行为 的客观描述。
• 如果研究对象是相对独立的经济活动,其中存在 着清晰的单向因果关系,那么可以将该应用模型 设定为单方程模型。
n
( I qi pi )
极值的一阶条件:
i 1
L
qi L
u qi
n
I qi
i 1
pi pi
0 0
求解即得到需求函数模型。
⑵ 从间接效用函数到需求函数
• 间接效用函数为:
V v( p1 , p2 , , pn , I )
统计模型:样本模型-什么是样本模型

统计模型:样本模型-什么是样本模型统计模型是用来描述和分析数据的一种工具。
它通过使用概率和数学原理来帮助我们理解数据背后的规律和关系。
在统计学中,样本模型是其中一种常见的模型类型。
样本模型的定义样本模型是指根据已有的数据样本来推断总体的模型。
总体是指我们感兴趣的整体数据集,而样本则是从总体中抽取的一部分数据。
样本模型通过对样本数据的分析和推断,帮助我们了解总体的特征和属性。
样本模型的作用样本模型在统计学中扮演着重要的角色。
它可以帮助我们从有限的数据样本中推断总体的性质和规律,从而作出更广泛的结论和决策。
通过样本模型,我们可以进行各种统计分析,例如估计总体均值、推断总体比例等。
构建样本模型的步骤构建样本模型通常需要以下步骤:1. 数据收集:从总体中抽取样本数据,并收集相关的观测变量。
2. 数据清洗:对收集到的数据进行清洗和处理,确保数据的可靠性和准确性。
3. 数据探索:通过统计图表、描述性统计量等方式对数据进行探索性分析,获取数据的基本特征和分布情况。
4. 模型选择:根据数据的特征和分析目的,选择适当的样本模型来描述数据。
5. 模型拟合:使用统计方法和算法对样本模型进行拟合,得到模型的参数估计值。
6. 模型评估:通过各种统计指标和检验方法对拟合得到的模型进行评估,检验模型的有效性和拟合程度。
7. 结果解释:根据样本模型的参数估计值和推断结果,解释数据的特征和总体的属性。
总结样本模型是统计学中常用的模型类型,它通过对样本数据的分析和推断来帮助我们了解总体的特征和属性。
构建样本模型需要进行数据收集、数据清洗、数据探索、模型选择、模型拟合、模型评估和结果解释等步骤。
通过使用样本模型,我们可以进行各种统计分析,并作出更广泛的结论和决策。
新人教版高中数学选择性必修第三册7.1 条件概率与全概率公式

.
解析 (1)从这批产品中随便地取一件,则这件产品恰好是次品的概率是 81 = 27 .
1 200 400
(2)设A:取出的产品是甲厂生产的,B:取出的产品为次品,
则由已知可得P(A)= 500 ,P(AB)= 25 ,所以这件产品恰好是甲厂生产的次品的概
1 200
1 200
率是P(B|A)= P(AB) = 1 .
第七章 随机变量及其散布
1 |利用定义求条件概率 农历五月初五是我国的传统节日——端午节,这一天,馨馨的妈妈煮了9个粽子,其 中4个大枣馅、3个腊肉馅、2个豆沙馅,馨馨随机选取两个粽子.
第七章 随机变量及其散布
1.若已知馨馨取到的两个粽子的馅不同,则取到的两个粽子分别是大枣馅和豆沙馅
的概率是多少?
P(A) P(D)
+
P(B) P(D)
=
C620 12 180
+
C620 12 180
=
13 58
.
C620
C620
所以他获得优秀的概率是 13 .
58
第七章 随机变量及其散布
4 |乘法公式及其应用 乘法公式的特点及注意事项 1.知二求一:若P(A)>0,则已知P(A),P(B|A),P(AB)中的两个值就可以求得第三个值; 若P(B)>0,则已知P(B),P(A|B),P(AB)中的两个值就可以求得第三个值. 2.P(B)与P(B|A)的区分在于两者产生的条件不同,它们是两个不同的概念,在数值上 一般也不同.
多少?
提示:用C表示事件“取到的两个粽子为同一种馅”,D表示事件“取到的两个粽子
都为腊肉馅”,
则P(C)=
C24
C32 C92
第四讲选择性模型
)
ρi = corr(ε1i ,ωi )
人民大学,2010 年秋,赵忠
16
E[ y0i | Ii = 0] = x0iβ0 + E[ε0i | ωi ≤ −wiγ ]
= x0i β0 − ρiσ λ0 0i
λ0i
=
φ(−wiγ ) Φ(−wiσ )
ρi = corr(ε0i ,ωi )
有偏:如果 ρi ≠ 0, ρi ≠ 0,并且wi与xi相关。
人民大学,2010 年秋,赵忠
3
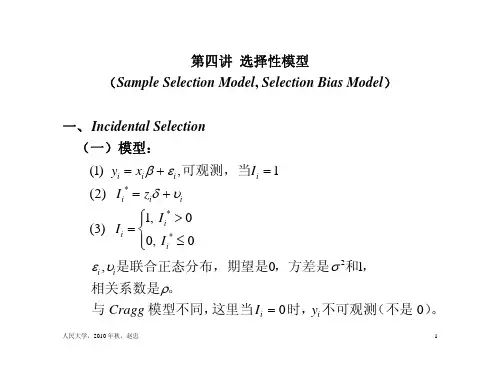
数据:假设只有当 Ii = 1时,才有 yi 和 xi 的数据;但是 Ii 和 zi 对所有的人都可以观测到。
对(1)OLS,可以吗?有偏还是无偏?
E[ yi | Ii = 1] = xiβ + E[εi |υi > −ziδ ]
= xiβ + ρσλi ,
其中λi
= xiβ − ρσλ0i
λ0i
=
φ(−ziδ ) Φ(−ziδ )
E[ yi | Ii ] = xiβ + α Ii + ρσ [Iiλ1i + (Ii −1)λ0i ]
人民大学,2010 年秋,赵忠
22
(二)估计
1、MLE 2、2-Step 3、I.V.
I.V.
y = xβ + ε, 如果E[x 'ε ] ≠ 0 ⇒ βl OLS有偏如果有一工具变量z,满足:
用 probit 估计(2),得到δ
用 OLS 估计(1)中 Ii = 1的部分,
其中,λ i
=
φ (− zi δ ) 1− Φ(−ziδ)
可估计出βl和ρmσ 。
“Heckman Lambda Technique”
tobit与选择性样本

0(
xi
)xi
(
xi
)
.
17
3、 x k对于y的边际影响
E(y| xk
x)(x/)k
结论:在数据存在截取的情况下,x k 对于y的
边际影响通过两个渠道产生作用:首先影
响 ( x ),即观测值是否被截取的概率,其次 是通过 影响y*的大小,从而影响被观察到
的y值的大小。当
于
k
时(x,) 边1 际影响等
由于我们面对的是断尾数据,因此考虑 E(y2|y11,x) 是有意义的。
E(y2| y1 1,x)E(y2*| y1* 0,x)
E(x222| x111 0) x22E(2|1 x11)
因为 21
.
37
所以
E(y2| y11,x)x22E(1|1x11) x22E(1|1x11)x22 ((xx1111)) x2212(x11)
i~N (0,2) Pri (xi)P ri (x i)1 (x i) (x i)
即 P ri(y0|xi)(xi) P ryi(0|xi)1(xi)
.
14
(2)当 yi 0 时的条件期望
其中, (.) Ratio)
(.)
(.)
为逆米尔斯比(Inverse Mills
.
15
E(yi | yi 0,xi) E(xii | yi 0,xi)
我们可以对截取数据进行tobit回归,得到系数 的一致估计结果。步骤:
第一,用全部数据采用probit模型,估计 ,, 代 入得到 的估计值。
第二,用y>0的数据,进行y对x和 的OLS估计,
得到系数的一致估计。
.
23
+ 如果样本观测值不是以0为界,而是以某一个数值 a为界,则有
高中数学选择性必修三 数7 1 1 条件概率教学设计

7.1.1 条件概率本节课选自《2019人教A 版高中数学选择性必修第三册》,第七章《随机变量及其分布列》,本节课主本节课主要学习条件概率.学生已经学习了有关概率的一些基础知识,对一些简单的概率模型(如古典概型、几何概型)已经有所了解。
条件概率是学生接触到的又一个全新的概率模型。
一方面,它是对古典概型计算方法的巩固,另一方面,为后续研究独立事件打下良好基础。
这一概念比较抽象,学生较难理解。
遇到具体问题时,学生常因分不清是P (B |A )还是P (AB )而导致出错。
基于此,在本节的教学中,应特别注意对于条件概率概念的生成,借助图示形象直观地展现条件概率概念的生成过程。
重点:运用条件概率的公式解决简单的问题 难点:条件概率的概念多媒体AB ,包含了样本点数n (AB )=16.根据古典概型知识可知:P (B|A ) =n(AB)n(A)=1630=815.问题2. 假定生男孩和生女孩是等可能的,现考虑有两个小孩的家庭,随机选一个家庭,那么(1)该家庭中两个小孩都是女孩的概率是多大?(2)如果已经知道这个家庭有女孩,那么两个小孩都是女孩的概率又是多大?观察两个小孩的性别,用b 表示男孩,g 表示女孩,则样本空间Ω={bb,bg,gb,gg },且所有样本点是等可能的.用A 表示事件“选择家庭中有女孩” ,B 表示事件“选择家庭中两个孩子都是女孩” ,A ={bg,gb,gg }, B ={gg }.(1) 根据古典概型知识可知,该家庭中两个小孩都是女孩的概率 P(B) =n(B)n(Ω)=14.(2)“在选择的家庭有女孩的条件下,两个小孩都是女孩” 的概率就是在“事件A 发生的条件下,事件B 发生” 的概率,记为P (B|A ) ,此时A 成为样本空间,事件B 就是积事件AB ,根据古典概型知识可知 P (B|A ) =n(AB)n(A)=13.分析:求P (B|A )的一般思想因为已经知道事件A 必然发生,所以只需在A 发生的范围内考虑问题,即现在的样本空间为A.因为在事件A 发生的情况下事件B 发生,等价于事件A 和事件 B 同时发生,即AB 发生.所以事件A 发生的条件下,事件B 发生的概率 P (B|A ) =n(AB)n(A).为了把这个式子推广到一般情形,不妨记原来的样本空间为W ,则有A A B问题1. 如何判断条件概率?题目中出现“在已知……前提下关键词,表明这个前提已成立或条件已发生问题2. P(B|A)与P(A|B)的区别是什么P(AB)=P(A)P(B|A).我们称上式为概率的乘法公式(multiplication formula).条件概率的性质条件概率只是缩小了样本空间,因此条件概率同样具有概率的性质. 设P(A)>0,则(1)P(Ω|A)=1;(2)如果B和C是两个互斥事件,则P(BUC |A)=P(B | A)+P (C | A);(3)设B和B̅互为对立事件,则P(B̅|A)=1−P(B|A).三、典例解析例1.在5道试题中有3道代数题和2道几何题,每次从中随机抽出1道题,抽出的题不再放回.求:(1)第1次抽到代数题且第2次抽到几何题的概率;(2)在第1次抽到代数题的条件下,第2次抽到几何题的概率.分析:如果把“第1次抽到代数题”和“第2次抽到几何题”作为两个事件,那么问题(1)就是积事件的概率,问题(2)就是条件概率.可以先求积事件的概率,再用条件概率公式求条件概率;也可以先求条件概率,再用乘法公式求积事件的概率.解法1:设A=“第1次抽到代数题”,B=“第2次抽到几何题”。
李子奈《计量经济学》课后习题详解(计量经济学应用模型)【圣才出品】
第7章计量经济学应用模型1.分析教材例7.1.1中的问题,回答:为什么按照(1)、(2)、(3)的方法建立的农户借贷因素分析模型都是不正确的?答:(1)若仅利用2820户发生借贷的农户为样本,以他们的借贷额为被解释变量,各种影响因素为解释变量建立的农户借贷因素分析模型是不正确的。
在损失大量样本(丢弃的样本占总样本的44.7%)导致回归精度下降的同时,如果再对其进行经典的截面数据模型分析,将会出现样本选择性问题,应该建立“选择性样本”模型,而不是经典回归模型,属于模型类型选择错误。
(2)若选用所有的5100户作为样本,以其借贷额为被解释变量,将没有发生借贷行为的农户的借贷额记为0(约占总样本的45%),进行经典的截面数据模型分析,这将会在模型中包含实际上并不满足要求的样本数据,属于“选择性样本”数据,仍然应该建立“选择性样本,模型,而不是经典回归模型,属于模型类型选择错误。
故此方法建立的农户借贷因素分析模型是不正确的。
(3)若将没有发生借贷的农户的借贷额视为小于等于0,建立Tobit模型进行回归分析,考虑了样本的选择性。
因此,从模型类型选择的角度,是正确的。
但这种处理方式同样会导致回归结果的精度下降,这主要是因为将有发生借贷的农户的借贷额视为小于等于0的数据处理方式有失偏颇,其中可能存在有借贷需求,但出于某种原因(例如提出借贷被拒绝,担心借不到而不敢提出借贷要求)没有发生借贷的农户。
故此方法建立的农户借贷因素分析模型仍是不正确的。
2.分析教材例7.1.2中的问题,回答:如果建立某类商品的单方程需求函数模型,该模型在什么情况下是可以应用的?答:在计量经济学应用研究中,单方程模型和联立方程模型的选择对经济行为具有依赖性。
根据对需求行为的分析发现,人们对各种商品的需求量,是在预算约束下,由效用函数在效用最大化下导出的。
人们在决定对某种商品的需求量时,肯定会同时考虑对其他商品的需求量。
所以,从理论上讲,不能建立某类商品的单方程需求函数模型。
高中数学选择性必修一《7.1.1条件概率》教学设计
《7.1.1条件概率》教学设计本节课内容选自普通高中教科书人教A 版数学选择性必修第三册第七章第一节《条件概率与全概率公式》,共2个课时,《7.1.1条件概率》是第一课时.通过本单元的学习,学生需要用数学的眼光看待随机事件的概率,能用概率的一般概念解释具体现象,并通过条件概率和独立性等数学概念分析复杂问题,寻找解决复杂问题的方法.学习过程中蕴含着数学抽象、逻辑推理和数学运算素养.以下从内容与内容解析、目标与目标解析、教学问题诊断解析、教学过程分析四个方面说明这节课的理解和设计。
一、内容与内容解析1. 内容:条件概率,概率的乘法公式.2. 内容解析:随机事件的条件概率是概率论的重要概念之一.由条件概率得到两个不独立 事件的概率乘法公式、全概率公式,它们是求很多复杂事件概率的有用工具.结合古典概型,研究随机事件的条件概率,并用它们计算较复杂事件的概率是概率学习的深入和提高.条件概率顾名思义是指一个事件A 已经发生的条件下另一个事件B 发生的概率.已知事件A 发生,试验的样本点属于A ,因此A 成为新的样本空间,所以条件概率(|)P B A 本质上是在缩减的样本空间A 上事件AB 的概率.条件概率同样具有概率的三条基本性质.通过古典概型得到的条件概率的概念及公式,对于一般随机事件的条件概率都适用,具有普遍意义.3. 教学重点:条件概率的概念及计算,概率的乘法公式及应用.二、目标与目标解析1. 目标:结合古典概型,了解条件概率与概率的乘法公式,了解条件概率与独立性的关系;能计算简单的随机事件的条件概率。
2. 目标解析:1)通过实例引导学生探究发现,由特殊到一般,得到条件概率的定义式 ()(|)()P AB P B A P A 并简单应用. 2)在验证条件概率定义的过程中,体会条件概率的思想,感受其本质为基本事件范围的缩小,并简单应用.3)通过条件概率的发现过程提升学生的数学抽象素养,通过对条件概率定义的验证以及模型的应用提升逻辑推理和数学建模素养.三、教学问题诊断解析1. 问题诊断:由于具体问题中的许多条件概率问题与我们的直觉相悖,因此往往很难迅速得到正确的答案,这就是概率问题不同于其他数学问题之处.因此,学生在学习条件概率概念时可能会产生困惑,对条件概率定义的理解会存在偏差.由于古典概型的条件概率计算总可以通过缩小样本空间转化为非条件概率的计算,因此学生在学习心理上可能会不自觉地拒绝接受条件概率的概念.另外,独立性是概率论中极其重要的概念,独立性的概念可以用条件概率描述,但在实际操作中两个随机独立性的判断往往是基于学生的经验,所以学生容易忽视独立性与条件概率之间的关系.2. 方法策略:认识论告诉我们,认识就是在实践—认识—再实践—再认识的过程中不断深化的。
高中数学7-1条件概率与全概率公式7-1-1条件概率新人教A版选择性必修第三册
第七章 随机变量及其分布
7.1 条件概率与全概率公式 7.1.1 条件概率
素养目标•定方向 必备知识•探新知 关键能力•攻重难 课堂检测•固双基
素养目标•定方向
1.结合古典概型,了解条件概率,能计算简单随机事件的条件概 率.
2.结合古典概型,了解条件概率与独立性的关系. 3.结合古典概型,会利用乘法公式计算概率. 4.能利用条件概率公式解决一些简单的实际问题.
易|错|警|示
混淆条件概率P(A|B)与积事件的概率P(AB) 典例 4 一个盒子中有6支铅笔,4支钢笔,任取两次,每次取一
支,第一次取后不放回,若已知第一支是铅笔,则第二支也是铅笔的概 5
率为__9____. [错解] P=160×59=13,即所求概率为13,故填13.
[辨析] 导致上述错误解法的原因: (1)该事件不是相互独立事件,不能套用概率乘法公式; (2)该试验为条件概率模型,应用条件概率公式计算; (3)要正确理解条件概率公式的意义,P(AB)为事件A,B同时发生的 概率,P(A|B)表示在B发生的前提下,A发生的概率.
[规律方法] 应用乘法公式的关注点 1.功能:已知事件A发生的概率和事件A发生的条件下事件B发生的 概率,求事件A与B同时发生的概率. 2 . 推 广 : 设 A , B , C 为 三 个 事 件 , 且 P(AB) > 0 , 则 有 P(ABC) = P(C|AB)P(AB)=P(C|AB)P(B|A)P(A).
计量经济学_7.1_选择性样本模型
第7章说明•经典的单方程计量经济学模型理论与方法,限于常参数、线性、揭示变量之间因果关系的单方程模型,被解释变量是连续的随机变量,其抽样是随机和不受限制的,在模型估计过程中或者只利用时间序列样本,或者只利用截面数据样本,主要依靠对经济理论和行为规律的理解确定模型的结构形式。
•本章中,将讨论几种扩展模型,主要包括将被解释变量抽样由完全随机扩展为受到限制的选择性样本模型,将被解释变量是连续的扩展为离散的离散选择模型,将单一种类的样本扩展为同时包含截面数据和时间序列数据的平行数据样本(Panel Data)等。
2013-5-15计量经济学第7章说明•这些模型与方法,无论在计量经济学理论方面还是在实际应用方面,都具有重要意义。
但是,这些模型都形成了各自丰富的内容体系,甚至是计量经济学的新分支学科,模型方法的数学过程较为复杂。
•本章只介绍其中最简单的模型,以了解这些模型理论与方法的概念与思路。
2013-5-15计量经济学§7.1 选择性样本模型Selective Samples Model一、经济生活中的选择性样本问题二、“截断”问题的计量经济学模型三、“归并”问题的计量经济学模型2013-5-15计量经济学The Bank of Sweden Prize in EconomicSciences in Memory of Alfred Nobel 2000"for his development of theory and methods for analyzing selective samples”James J HeckmanUSA2013-5-15计量经济学•“Shadow Prices, Market Wages and Labour Supply”, Econometrica42 (4), 1974, P679-694发现并提出“选择性样本”问题。
•“Sample Selection Bias as a Specification Error”, Econometrica47(1), 1979, P153-161证明了偏误的存在并提出了Heckman两步修正法。