
基于EViews 6的面板数据计量分析
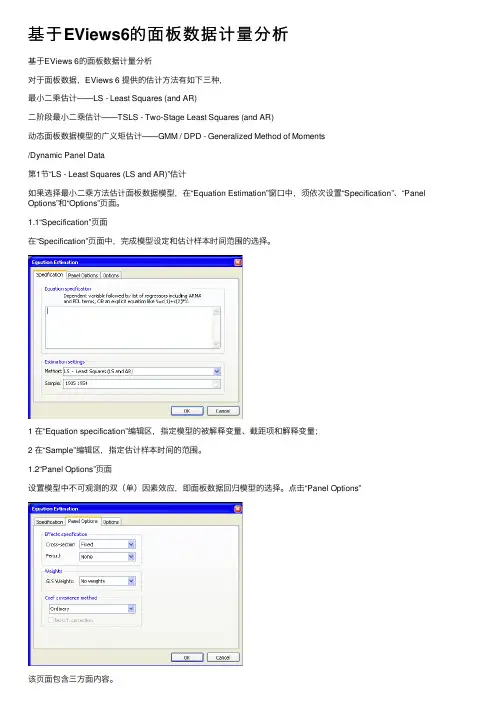
基于EViews 6的面板数据计量分析对于面板数据,EViews 6 提供的估计方法有如下三种,最小二乘估计——LS - Least Squares (and AR)二阶段最小二乘估计——TSLS - Two-Stage Least Squares (and AR)动态面板数据模型的广义矩估计——GMM / DPD - Generalized Method of Moments/Dynamic Panel Data第1节“LS - Least Squares (LS and AR)”估计如果选择最小二乘方法估计面板数据模型,在“Equation Estimation”窗口中,须依次设置“Specification”、“Panel Options”和“Options”页面。
1.1“Specification”页面在“Specification”页面中,完成模型设定和估计样本时间范围的选择。
1 在“Equation specification”编辑区,指定模型的被解释变量、截距项和解释变量;2 在“Sample”编辑区,指定估计样本时间的范围。
1.2“Panel Options”页面设置模型中不可观测的双(单)因素效应,即面板数据回归模型的选择。
点击“Panel Options”该页面包含三方面内容。
1 效应设置在“Effects specification”选择区,设定面板数据模型的个体效应和时间效应,可选择的选项有“None”、“Fixed”和“Random”,分别表示“无效应”、“固定效应”和“随机效应”。
如果选择了“Fixed”或“Random”,EViews在输出结果中自动添加一个共同常数,即截距项,以保证效应之和为零。
否则,截距项必要时,须在“Specification”页面的“Equation specification”编辑区设定模型截距项。
2 GLS加权设置“GLS Weights”可以在下拉框中选择如下选项之一。
其选择标准为:面板数据不存在异方差和自相关性时,选择“No weights”;面板数据在个体间存在异方差时,选择“Cross-section weights”;面板数据的个体间存在同期相关性和异方差时,选择“Cross-section SUR”;对于给定的个体,存在时间上的异方差时,选择“Period weights”。
对于给定的个体残差,存在时间上的序列相关性和异方差时,选择“Period SUR”;当选择了GLS加权(后四项),EViews采用FGLS估计模型。
特别,选择了两种SUR选项的FGLS估计也称为Parks估计。
3 系数协方差估计方法通过选择“Coef covariance method”选项,确定计算系数标准差的各种稳健估计方法。
可选择的选项有其选择标准为:对于不存在(个体间的和时间上的)异方差和时间上的序列相关性时,选择“Ordinary”;模型残差存在个体间的异方差和同期相关性时,可选择“White cross-section”;这时也可选择“Cross-section SUR”选项,最常见的选择是White的截面加权法(Whitecross-section)对于模型残差,只存在时间上的异方差时,选择“White Period”选项模型残差存在个体间的异方差时,可选择“White[Diagonal]”模型残差存在个体间的异方差和同期相关性时,可选择“Cross-section SUR”选项;对于模型残差,只存在个体间的异方差时,选择“Cross-section weights”选项;对于指定的个体,观测数据存在时间上的异方差和序列相关性时,选择“Period SUR”选项;对于模型残差,只存在时间上的异方差时,选择“Period weights”选项。
选择“No d.f. correction”,计算时不进行自由度修正。
注意:(1) 模型设定和估计方法的一些组合EViews 6不支持,例如,对于个体随机效应模型,设置AR项,或者,选择GLS加权,EViews 6不支持。
(2) 对于双因素随机效应模型,不支持非平衡面板数据。
1.3“Options”页面“Options”页面包括系数导数的计算方法选项“Derivatives”、GLS估计的加权选项“Weighting Options”、回归系数重命名“Coefficient Name”和迭代算法选项“Iteration Control”四方面的选项。
除回归系数重命名“Coefficient Name”编辑窗口外,该页面的其它选项依赖于“Panel Options”页面的设置。
对于随机效应模型,可选择“Weighting Options”确定随机效应方差的估计方法;对于固定效应模型,可选择“Iteration Control”确定迭代估计方法的收敛和迭代选择;如果“Panel Options”页面选择了GLS加权,在“Options”页面可选择“Weighting Options”、“Coefficient Name”和“Iteration Control”三方面的选项,1 系数导数的计算方法在EViews 6中,可以设置均值方程的(非线性)函数形式,并提供两种计算系数导数的计算方法。
选择“Use numeric only”,EViews 6采用有限差分法计算系数的数值导数。
否则,采用Newton-Raphson方法和Gauss-Newton/BHHH等方法对计算系数的解析导数。
对于线性模型,该选项无效。
2 加权选项在估计随机效应模型时,EViews 提供了计算随机效应方差的三种估计方法,分别是Swamy-Arora, Wallace-Hussain和Wansbeek-Kapteyn方法。
缺省选择是“Swamy-Arora”方法,详细内容参考Baltagi (2008).另外,“Keep GLS weights”选项决定是否保存该模型GLS估计的权重。
3 回归系数重命名缺省时,EViews 6使用向量C保存系数和效应的估计值。
如果使用其他变量名保存它们,在编辑栏输入变量名。
4 迭代算法选择“Max Iterations Convergence ”选项供选择系数和GLS 权重的迭代次数和收敛检验。
如果模型设定中含AR ,设置有AR 项模型系数的初始值,可分别选择无AR 项模型系数的OLS 估计分数、0或者用户自定义值。
“Display Settings ”决定在输出结果中是否显示收敛设置和系数的初始值。
最后的两个单项选择用于确定系数向量和加权矩阵收敛迭代设置,可选择“Simultaneous updating ”和“Sequential updating ”,选择前者EViews 同时对系数向量和GLS 加权矩阵迭代;如果选择“Sequential updating ”,系数向量迭代后,EViews 更新GLS 加权矩阵,再迭代系数向量。
但是对于无AR 项的GLS 模型,两种设置是相同的。
如果选择了“Update coefs to convergence ”和“ Update coefs once ”之一,GLS 加权矩阵只更新一次,前者对系数向量迭代计算直至收敛。
选择后者,系数向量也仅迭代一次。
同样,对于无AR 项的GLS 模型,两种设置也是相同的。
1.4“LS - Least Squares (LS and AR)”估计结果案例:Grunfeld(1958)建立了下面的投资方程:12it it it i t it I F C u αββξλ=+++++这里,I it 表示对第i 个企业在t 年的实际总投资,F it 表示企业的实际价值(即公开出售的股份),C it 表示资本存量的实际价值。
案例中的数据是来源于10个大型的美国制造业公司1935-1954共20年的面板数据。
利用EViews6 估计双因素固定效应和随机效应模型1 双因素固定效应模型的EViews6输出结果2 双因素随机效应模型的EViews6输出结果1.5 面板数据模型的检验1 固定效应的检验EViews 检验过程:View/Fixed/Random Effects Testing/Redundant Fixed Effects – Likelihood Ratio.检验结果:0表示估计值为负H02下有约束模型的估计H03下有约束模型的估计H01下有约束模型的估计2 随机效应 / 固定效应检验-Hausman检验EViews6的检验过程:View/Fixed/Random Effects Testing/Correlated Random Effects- Hausman Test检验结果:(1)基于双随机效应和双固定效应的Hausman 检验统计量 m 1 = 8.842,其p = 0.012,在5%的显著性水平下,Hausman 检验拒绝了零假设50H ;(2) EViews 还给报告了其他两种Hausman 检验。
最终,应选择个体随机时间固定的双因素效应模型。
第2节 “TSLS - Two-Stage Least Squares (and AR)”估计如果选择二阶段最小二乘估计方法(“TSLS - Two-Stage Least Squares (and AR)”)面板数据模型,在“Equation Estimation ”窗口中,须依次设置“Specification ”、“Panel Options ”、“Instruments ”和“Options ”页面。
其中,“Specification ”、“Panel Options ”和“Options ”页面的设置与最小二乘估计方法相同,下面主要介绍“Instruments ”页面设置。
在使用二阶段最小二乘估计方法时,需要设置“Instruments ”页面,以确定工具变量。
该页面有两部分。
在“Instrument list ”编辑框指定工具变量,列示所使用的工具变量序列。
“Instruments list ”页面缺省时,EViews6选择的工具变量是解释变量自身。
如果模型设定时,AR 项作为解释变量,可选择“Include lagged regressors for equations with AR terms ”选项,自动设定模型设定中的变量作为工具变量,并且,EViews6 采用非线性OLS 估计模型。
注意:在“Instruments ” 编辑框无需指定常数项。
第3节“GMM / DPD - Generalized Method of Moments/Dynamic Panel Data”估计在EViews6中,使用GMM方法估计面板数据模型,也需要设置“Specification”、“Panel Options”、“Instruments”和“Options”四个页面。
计量经济面板数据模型及EVIEWs软件的实现

面板数据模型的分析及Eviews实现一、面板数据和模型概述在经济学研究和实际应用中,我们经常需要同时分析和比较横截面观察值和时间序列观察值结合起来的数据,即:数据集中的变量同时含有横截面和时间序列的信息。
这种数据被称为面板数据(panel data),它与我们以前分析过的纯粹的横截面数据和时间序列数据有着不同的特点。
简单地讲,面板数据因同时含有时间序列数据和截面数据,所以其统计质既带有时间序列的性质,又包含一定的横截面特点。
因而,以往采用的计量模型和估计方法就需要有所调整。
例1 表1中展示的数据就是一个面板数据的例子。
其他类似的例子还有:历次人口普查中有关不同年龄段的受教育状况;同行业不同公司在不同时间节点上的产值等。
这里,不同的年龄段和公司代表不同的截面,而不同时间节点数据反映了数据的时间序列性。
研究和分析面板数据的模型被称为面板数据模型(panel data model)。
它的变量取值都带有时间序列和横截面的两重性。
一般的线性模型只单独处理横截面数据或时间序列数据,而不能同时分析和对比它们。
面板数据模型,相对于一般的线性回归模型,其长处在于它既考虑到了横截面数据存在的共性,又能分析模型中横截面因素的个体特殊效应。
当然,我们也可以将横截面数据简单地堆积起来用回归模型来处理,但这样做就丧失了分析个体特殊效应的机会。
二、一般面板数据模型介绍 符号介绍:ity ——因变量在横截面i 和时间t 上的数值;j it x ——第j 个解释变量在横截面i 和时间t 上的数值;假设:有K 个解释变量,即K j ,,2,1 =;有N 个横截面,即N i ,,2,1 =; 时间指标T t ,,2,1 =。
记第i 个横截面的数据为⎪⎪⎪⎪⎪⎭⎫⎝⎛=iT i i i y y y y21; ⎪⎪⎪⎪⎪⎭⎫⎝⎛=K iT iT iT Ki i i K i i i i x x x x x x x x x X 212221212111;⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=iT i i i μμμμ 21 其中对应的i μ是横截面i 和时间t 时随机误差项。
详细的EVIEWS面板数据分析操作39页PPT
40、人类法律,事物有规律,这是不 容忽视 的❖ 丰富你的人生
71、既然我已经踏上这条道路,那么,任何东西都不应妨碍我沿着这条路走下去。——康德 72、家庭成为快乐的种子在外也不致成为障碍物但在旅行之际却是夜间的伴侣。——西塞罗 73、坚持意志伟大的事业需要始终不渝的精神。——伏尔泰 74、路漫漫其修道远,吾将上下而求索。——屈原 75、内外相应,言行相称。——韩非
详细的EVIEWS面板数据分析操作
36、如果我们国家的法律中只有某种 神灵, 而不是 殚精竭 虑将神 灵揉进 宪法, 总体上 来说, 法律就 会更好 。—— 马克·吐 温 37、纲纪废弃之日,便是暴政兴起之 时。— —威·皮 物特
38、若是没有公众舆论的支持,法律 是丝毫 没有力 量的。 ——菲 力普斯 39、一个判例造出另一个判例,它们 迅速累 聚,进 而变成 法律。 ——朱 尼厄斯
EVIEWS面板数据分析操作教程及实例解析

模型选择对分析结果影响
模型适用性
根据研究目的和数据特征选择合 适的面板数据模型,如固定效应 模型、随机效应模型等。
模型假设
确保所选模型满足基本假设,如 线性关系、误差项独立同分布等 ,否则可能导致结果不准确。
模型比较与选择
通过比较不同模型的拟合优度、 参数显著性等指标,选择最优模 型进行分析。
操作规范性与结果可靠性保障措施
操作步骤规范
结果验证与解读
对分析结果进行验证,确保结果的合理性和准确性 ;同时,正确解读分析结果,避免误导读者。
严格按照EVIEWS软件的操作步骤进行分析 ,避免操作失误或遗漏关键步骤。
数据分析报告
编写详细的数据分析报告,包括数据来源、 处理方法、模型选择、分析结果及解读等, 以便读者全面了解分析过程。
方和来估计模型参数。
广义最小二乘法(GLS)
02
当存在异方差性或自相关性时,采用广义最小二乘法进行参数
估计,以提高估计效率。
最大似然法(ML)
03
适用于随机效应模型等复杂面板数据模型,通过最大化似然函
数来估计模型参数。
模型诊断与检验
残差分析
检查残差是否满足独立同分布等假设条件, 以评估模型的拟合效果。
07 EVIEWS面板数 据分析操作注意 事项
数据质量对分析结果影响
数据来源
确保数据来自可靠、权威的来源,避免使用不准确或存在偏见的数 据。
数据完整性
检查数据是否存在缺失值、异常值或重复值,这些问题可能导致分 析结果失真。
数据处理
对数据进行适当的预处理,如清洗、转换和标准化,以提高数据质量 和一致性。
增强了解决实际问题的能力
通过实例解析和操作演示,学员们学会了如何运用所学知识解决实际问题,提高了分析 问题和解决问题的能力。
详细的EVIEWS面板数据分析操作 LN

形式一:变系数模型
yi ixiβiui
形式二:固定影响模型 yi mxiβi*ui
形式二:不变参数模型 yi xiβui
(2)根据F检验确定上述三种形式之一
请点(确定模型形式的F检验)
25
确定模型形式的F检验
原假设:两个如下
H1:
β 1 β 2 β N
H2:
12 N
β 1 β 2 β N
View/Spreadsheet View:i? m? k?
4
第二步 分析数据的平稳性(单位根检验) 请点 说明 请点 软件操作 结果 点检验结果1 结果2
5
分析数据的平稳性(单位根检验)说明 注:所有序列者要检验
原:不稳定(Hadri 除外, Hadri 中 原:稳定)
目的:防止虚假回归或伪回归
10
思路一:变量之间是非同阶单整 :序列变换
◎变量之间是非同阶单整的指即面板数据中有些序列平稳而有些序列不平稳,
此时不能进行协整检验与直接对原序列进行回归。
◎对序列进行差分或取对数使之变成同阶序列
若变换序列后均为平稳序列可用变换后的序列直接进行回归
思路二 若变换序列后均为同阶非平稳序列,则请点
11
详细的EVIEWS面板数据分析操作
第一步 录入数据 一 请点 实例数据 二 请点 录入数据软件操作
2
实例数据
录入企业投资需求模型数据:五家企业和三个变量的20个年度 (1935-1954年)观测值的时间序列 (数据略)
5家企业: GM:通用汽车公司 CH:克莱斯勒公司 GE:通用电器公司
3个变量: I :总投资 M :前一年企业的市场价值 (反映企业的检验
请点协整检验说明 请点 软件操作 结果判定请点 1 2 3 协整检验通过:
详细的EVIEWS面板数据分析操作39页PPT
谢谢!
详细的EVIEWS面板数据分析操作
•
46、寓形宇内复几时,曷不委心任去 留。
•
47、采菊东篱下,悠然见南山。
•
48、啸傲东轩下,聊复得此生。
•
49、勤学如春起之苗,不见其增,日 有所长 。
•
Байду номын сангаас
50、环堵萧然,不蔽风日;短褐穿结 ,箪瓢 屡空, 晏如也 。
61、奢侈是舒适的,否则就不是奢侈 。——CocoCha nel 62、少而好学,如日出之阳;壮而好学 ,如日 中之光 ;志而 好学, 如炳烛 之光。 ——刘 向 63、三军可夺帅也,匹夫不可夺志也。 ——孔 丘 64、人生就是学校。在那里,与其说好 的教师 是幸福 ,不如 说好的 教师是 不幸。 ——海 贝尔 65、接受挑战,就可以享受胜利的喜悦 。——杰纳勒 尔·乔治·S·巴顿
基于EViews6的面板数据计量分析
基于EViews6的⾯板数据计量分析基于EViews 6的⾯板数据计量分析对于⾯板数据,EViews 6 提供的估计⽅法有如下三种,最⼩⼆乘估计——LS - Least Squares (and AR)⼆阶段最⼩⼆乘估计——TSLS - Two-Stage Least Squares (and AR)动态⾯板数据模型的⼴义矩估计——GMM / DPD - Generalized Method of Moments/Dynamic Panel Data第1节“LS - Least Squares (LS and AR)”估计如果选择最⼩⼆乘⽅法估计⾯板数据模型,在“Equation Estimation”窗⼝中,须依次设置“Specification”、“Panel Options”和“Options”页⾯。
1.1“Specification”页⾯在“Specification”页⾯中,完成模型设定和估计样本时间范围的选择。
1 在“Equation specification”编辑区,指定模型的被解释变量、截距项和解释变量;2 在“Sample”编辑区,指定估计样本时间的范围。
1.2“Panel Options”页⾯设置模型中不可观测的双(单)因素效应,即⾯板数据回归模型的选择。
点击“Panel Options”该页⾯包含三⽅⾯内容。
1 效应设置在“Effects specification”选择区,设定⾯板数据模型的个体效应和时间效应,可选择的选项有“None”、“Fixed”和“Random”,分别表⽰“⽆效应”、“固定效应”和“随机效应”。
如果选择了“Fixed”或“Random”,EViews在输出结果中⾃动添加⼀个共同常数,即截距项,以保证效应之和为零。
否则,截距项必要时,须在“Specification”页⾯的“Equation specification”编辑区设定模型截距项。
2 GLS加权设置“GLS Weights”可以在下拉框中选择如下选项之⼀。
EViews6.0在面板数据模型估量中的实验操作
EViews 在面板数据模型估量中的实验操作1、进入工作目录cd d:\nklx3,在指定的路径下工作是一个良好的适应二、成立面板数据工作文件workfile(1)最好不要选择EViews默许的blanaced panel 类型Moren_panel(2)依照要求成立简单的知足时期周期和长度要求的时期型工作文件3、成立pool对象(1)新建对象(2)选择新建对象类型并命名(3)为新建pool对象设置截面单元的表示名称,在此提示下(Cross SectionIdentifiers: (Enter identifiers below this line )输入截面单元名称。
建议采用汉语拼音,例如29个省市区的汉语拼音,建议在拼音名前加一个下划线“_”,如图关闭成立的pool对象,它就出此刻当前工作文件中。
4、在pool对象中成立面板数据序列双击pool对象,打开pool对象窗口,在菜单view的下拉项当选择spreedsheet (展开表)在打开的序列列表窗口中输入你要成立的序列名称,若是是面板数据序列必需在序列名后添加“?”。
例如,输入GDP?,在GDP后的?的作用是各个截面单元的占位符,生成了29个省市区的GDP的序列名,即GDP后接截面单元名,再在接时期,就表示出面板数据的3维数据结构(1变量2截面单元3时期)了。
请看工作文件窗口中的序列名。
展开表(类似excel )中等待你输入、贴入数据。
五、贴入数据(1)打开编辑(edit)窗口(2)贴入数据(3)关闭pool窗口,赶快存盘见好就收六、在pool窗口对各个序列进行单位根查验选择单位根查验设置单位根查验单位根查验结果注意查验方式和两种查验的零假设:Null: Unit root (assumes common unit root process)各截面有相同的单位根Null: Unit root (assumes individual unit root process)允许各截面有不同单位根其中,Levin, Lin & Chu t*查验拒绝含有单位根的零假设,即拒绝非平稳7、在pool窗口对面板数据组合进行协整查验选择进行协整查验协整查验设置对话框,注意有3种查验方式(test type)协整查验结果,一样要注意两种假定(含有AR,即含有单位根,非协整),两种零假设都是非协整,小概率事件发生拒绝非协整。
计量学教程及eviews实现面板数据模型的分析
二、一般面板数据模型介绍
符 号 介 绍 : yit — — 因 变 量 在 横 截 面 i 和 时 间 t 上 的 数 值 ;
x
j it
——第 j 个解释变量在横截面 i 和时间 t 上的数值;
假设:有 K 个解释变量,即 j 1,2,, K ;
有 N 个横截面,即i 1,2,, N ;
时间指标 t 1,2,,T 。
ˆ
2 ˆ w
s 2 ( X P D X ) 1
s2
ˆ
2 ˆ
i
s2 T
X iˆ ˆw X i
其中 是对误差项方差的估计量:
( y it ˆ i x it ˆ w ) 2
s2 i t
NT ቤተ መጻሕፍቲ ባይዱN K
注意:在对误差项方差的估计量中,分母(NT-N-K)反映了整个
模型的自由度。有了这些方差的估计量,就可以用传统的t-统计量 对估计系数的显著性进行检验。同时,还可以运用下列F-统计量对
;
(7
)
2
E
(
2 i
),
i
。
给定这些假设,随机效应面板数据模型也可同样写为:
其中
(In
i )
y=X β +μ
, α 的 向 量 形 式 与 以 前 相 同 。
是 Kronecker 乘法 符 号。
例 2 Kronecker 乘 法 :
I2
i 21
i
21
0
0 i 21
例 3 前 面 的 矩 阵 D 也 可 用 Kronecker 乘 法 表 示 : D I N iT 1
记第 i 个横截面的数据为
yi1
yi
yi2
详细的EVIEWS面板数据分析操作
至少1个协整向量 65.74 (0.2266)
65.74 (0.2266)
注:加“*”表示在5%的显著性水平下拒绝原假设而接受备择假设。
上述检验结果检验的样本区间为1991-2003年,从表10.8和 表10.9的检验结果可以看出,我国29个省市的城镇居民消费和 收入的面板数据之间存在协整关系。
详细的EVIEWS面板数据分析操作
View/Spreadsheet View:i? m? k?
详细的EVIEWS面板数据分析操作
第二步 分析数据的平稳性(单位根检验) 请点 说明 请点 软件操作 结果 点检验结果1 结果2
详细的EVIEWS面板数据分析操作
分析数据的平稳性(单位根检验)说明 注:所有序列者要检验
原:不稳定(Hadri 除外, Hadri 中 原:稳定)
除此项 外均支 持协整
详细的EVIEWS面板数据分析操作
表10.8 Johansen面板协整检验结果
(选择序列有确定性趋势而协整方程只有截距的情况)
原假设
支
Fisher联合迹统计量 Fisher联合-max统计
持
(p值)
量(p值)
协Leabharlann 整0个协整向量133.4 (0.0000)*
128.7 (0.0000)*
此时不能进行协整检验与直接对原序列进行回归。
◎对序列进行差分或取对数使之变成同阶序列
若变换序列后均为平稳序列可用变换后的序列直接进行回归
思路二 若变换序列后均为同阶非平稳序列,则请点
详细的EVIEWS面板数据分析操作
思路二 变量之间是同阶单整:协整检验
请点协整检验说明 请点 软件操作 结果判定请点 1 2 3 协整检验通过:
面板数据模型计量经济学EVIEWS建模课件
下载EViews安装程序后,按照提示进行安装,选择 合适的安装路径和组件。
03
安装完成后,需要配置EViews的环境变量和启动选 项。
EViews软件界面与操作
EViews的界面包括菜单栏、工具栏、工作区、状态栏等部分,用户可以通 过菜单栏选择需要的命令和功能。
工作区是用户进行数据分析和模型估计的主要区域,可以显示数据表格、 图形、方程等。
固定效应模型
在固定效应模型中,个体固定效应被包括在内,这意 味着模型将考虑每个个体特有的不随时间变化的特征 对因变量的影响。在EViews中,可以通过在`xtreg`命 令后加上`fe`来指定固定效应模型。解读固定效应模型 的估计结果时,应注意观察固定效应的系数和显著性 水平,以了解不同个体的固定效应对因变量的影响程 度和显著性。
提高估计精度
相对于单一时间序列或横截面数据模型,面板数据模型能够利用更多的信息,提高估计 的精度。
面板数据模型在经济学研究中的挑战与展望
数据质量和可获得性
高质量的面板数据是进行面板数据分 析的前提,但获取高质量的面板数据 存在一定的难度。
动态面板数据分析
模型选择和设定
在应用面板数据模型时,需要合理选 择和设定模型,以避免模型误设导致 的估计偏误。
社会学研究 面板数据模型在社会学研究中用 于分析社会现象和趋势,如人口 变化、教育发展、犯罪率等。
医学研究 面板数据模型在医学研究中用于 分析疾病发病率、流行趋势、治 疗效果等,为医学研究和公共卫 生政策提供依据。
02
EViews软件介绍
EViews软件概述
EViews是一款专门用于计量经济学和时 间序列分析的软件,提供了一系列强大 的统计分析工具和图形化界面,方便用 户进行数据分析和模型估计。