
第六章 动态回归与误差修正模型
第6章 动态回归与误差修正模型本章假定时间序列是平稳的。
6.1 均衡与误差修正机制1 均衡均衡指一种状态,达到均衡时将不存在破坏均衡的内在机制。
这里只考虑平稳的均衡状态,即当系统受到干扰后会偏离均衡点,而内在均衡机制将努力使系统重新回到均衡状态。
下面通过一个例子说明系统均衡概念。
以两个地区某种商品的价格为例,假设地区A 中该商品物价由于某种原因上升时,该商品就会通过批发商从价格低的B地区向价格高的A 地区流动。
从而使批发商从中获利。
这种活动将直接导致该商品在B地区的需求增加,从而使该商品在B地区的价格上涨。
从A地区看,由于增加了该商品的供给,则导致价格下降,反之依然,从而使两各地区的该商品价格趋同。
若称价格A = 价格B的直线表示均衡价格。
如上所述,当价格离开这条均衡价格直线后,市场机制这只无形之“手”就会把偏离均衡点的状态重新拉回到均衡状态。
随着时间推移,无论价格怎样变化,两个地区的价格都具有向均衡价格调整的趋势。
若两个变量x t , y t永远处于均衡状态,则偏差为零。
然而由于各种因素的影响,x t , y t并不是永远处于均衡位置上,从而使u t≠ 0,称u t为非均衡误差。
当系统偏离均衡点时,平均来说,系统将在下一期移向均衡点。
这是一个动态均衡过程。
t期非均衡误差u t是y t下一期取值的重要解释变量。
当u t > 0时,说明y t相对于x t取值高出均衡位置。
平均来说,变量y t 在t+1期的取值y t+1将有所回落。
所以,u t= f (y t , x t) 具有一种误差修正机制。
6.2 分布滞后模型如果回归模型中不仅包括解释变量的本期值,而且包括解释变量的滞后(过去)值,则这种回归模型称为分布滞后模型。
例y t = α0 + ∑=−niitixβ+ u t,u t∼ IID (0, σ2 ) (6.1)上述模型的一个明显问题是x t 与x t -1 , x t -2, …, x t - n 高度相关,从而使 βj 的OLS 估计值存在严重偏倚。
实际上,对于分布滞后模型,这并不是一个严重问题,因为人们的注意力并不在单个回归系数上,而是在这些回归系数的和式,∑=ni i 0β上。
通过这个和式可以了解当x t 变化时,对y t 产生的长期影响。
尽管对每个βj 的估计量不是很准确,但这些估计值的和却是相当精确的。
Var(∑=n i i 0ˆβ) = ∑=n i i 0)ˆ(Var β+ 2∑∑=−=n i i k k i 010)ˆ,ˆ(Cov ββ, (6.2) 若x t - i 与x t - k , (i ≠ k ) 是正相关的(实际中常常如此),则(6.2)式中的协方差项通常是负的。
当这些项的值很大(绝对值)且为负时,Var (∑=n i i 0ˆβ) 比 0ˆ()n ii Var β=∑小,甚至比每个Var (iβˆ) 还小。
分布滞后模型中的解释变量存在高度相关,克服高度相关的一个方法是在等号右侧加一个被解释变量的滞后项。
于是,得到动态模型。
动态模型(自回归模型):如果在回归模型的解释变量中包括被解释变量的一个或几个滞后值,则称这种回归模型为动态模型(或自回归模型)。
例如,y t = α0 + α1 y t -1 + β1 x t + u t6.3 动态分布滞后模型如果在分布滞后模型中包括被解释变量的若干个滞后值作解释变量,则称之为动态分布滞后模型或自回归分布滞后模型。
例y t = α0 + ∑=−m i i t iy 1α+10p n ji jt i j i x β−==∑∑+ u t , u t ∼ IID (0, σ 2 ) (6.3)用ADL (m , n , p ) 表示,其中m 是自回归阶数,p 是分布滞后阶数, n 是外生变量个数。
对ADL (m , n , p ) 模型可采用OLS 法估计,尽管,参数估计量是有偏的,但是,它们是参数的一致估计。
例如,对于AR(1)模型y t = β y t -1 + u t , | β | < 1, u t ∼ IID(0, σ 2) , (6.5) 如果y t ∼I(0);y t 具有非零的有限的4阶矩;则β 的OLS 估计量计算公式是βˆ = ⎟⎟⎠⎞⎜⎜⎝⎛∑∑=−=−Tt t T t t t y y y 22121. (6.6) 把 (6.5) 式代入 (6.6) 式得βˆ = ∑∑∑=−==−−+T t t T t T t t t t yu y y 22122121β= β +⎟⎟⎠⎞⎜⎜⎝⎛∑∑=−=−Tt t Tt t t y u y 22121. (6.7) y t -1与u t 是相关的。
上式右侧第二项的期望不为零。
所以,用OLS 法得到的回归系数估计量是有偏估计量。
若对 (6.7) 式右侧第二项的分子分母分别除以(T -1)(样本容量)并求概率极限,lim p ∞→T βˆ = β +∑∑=−−∞→=−−∞→−−T t t T T t t t T y T u y T 2211211])1[(lim p ])1[(lim p = β (6.8)可见βˆ也是一致估计量。
最常见的是ADL (1, 1,1) 和ADL (2,1, 2) 模型,y t = α0 + α1 y t -1 + β0 x t + β1 x t -1 + u t , u t ∼ IID (0, σ 2 ), (6.9) 和y t = α0 + α1 y t -1 + α2 y t -2 + β0 x t + β1 x t -1 + β2 x t -2 + u t , u t ∼ IID (0, σ 2 )对于ADL (1, 1,1) 模型 (6.9),x t 和 y t 的长期关系是y t = 101αα−+1101αββ−+x t = θ0 + θ1 x t , (6.10) 其中,式(6.10)被称为静态模型,参数被称为静态参数或长期参数。
长期参数描述了变量之间的均衡关系。
动态模型 (6.9) 中的参数称作动态参数或短期参数。
短期参数描述了变量通向均衡状态过程中的非均衡关系。
通过对α0 , β0 和 β1 施加约束条件,从ADL 模型(6.9)可以得到许多特殊的经济模型。
下面以9种约束条件为例,给出特定模型如下:(1) 当 α1 = β1 = 0 成立,模型(6.9)变为y t = α0 + β0 x t + u t . (6.11) 即,静态回归模型。
(2) 当 β0= β1= 0时,由模型(6.9)得y t = α0 + α1 y t -1 + u t . (6.12) 即,一阶自回归模型。
(3) 当 α1 = β0 = 0 时,则有y t = α0 + β1 x t -1 + u t . (6.13) x t -1是y t 的超前指示变量。
此模型称为前导模型。
(4) 当约束条件是α1 =1,β1 = - β0时,(6.9)式变为Δ y t = α0 + β0 Δ x t+ u t . (6.14) 这是一个一阶差分模型。
当x t与y t为对数形式时,上述模型为增长率模型。
(5) 若α1 = 0成立,模型(6.9)则变为一阶分布滞后模型。
y t = α0 + β0 x t+β1 x t - 1 + u t. (6.15) (6) 取β1 = 0,则模型(6.9)变为标准的局部调整模型(偏调整模型)。
y t = α0 + α1 y t -1 + β0x t+ u t.(6.16) (7) 当β0 = 0 时,由模型(6.9)得y t = α0 + α1 y t -1 + β1 x t -1 + u t . (6.17) 模型中的解释变量只有变量的滞后值,y t的值仅依靠滞后信息。
这种模型称为“盲始”模型。
(8)给定β1 = - α1 ,模型(6.9)化简为y t = α0 + α1 ( y t-1 - x t-1 ) + β0 x t+ u t(6.18) 此模型称为比例响应模型。
解释变量为x t与 ( y t-1- x t-1)。
6.4“一般到特殊”建模方法以上所列举的例子说明实际上许多有特殊经济意义的模型都是由一个一般的ADL模型化简得到的。
这种建立模型的方法是首先从一个包括了尽可能多解释变量的“一般”ADL 模型开始,通过检验回归系数的约束条件逐步剔除那些无显著性变量,压缩模型规模,(在这个过程中要始终保持模型随机误差项的非自相关性。
)最终得到一个简化(或“特殊”)的模型。
这种方法称为“一般到特殊”建模法。
也称作亨德里(Hendry)建模法。
关于检验约束条件是否成立的方法将在后面讨论。
众所周知,模型若丢失重要解释变量将导致回归系数的OLS估计量丧失无偏性和一致性。
“一般到特殊”建模法的主要优点是能够把由于选择变量所带来的设定误差减到最小。
因为在初始模型中包括了许多变量,所以不会使回归系数的OLS估计量存在丢失变量误差。
虽然因为在初始模型中包括了许多非重要解释变量,从而使回归参数估计量缺乏有效性,但随着检验约束条件的继续,那些非重要的解释变量被逐步剔除掉,从而使估计量缺乏有效性的问题得到解决。
6.5 动态模型的若干检验方法在用“一般到特殊”方法建立模型时的,首先应对初始模型(即对回归参数不加任何约束的动态分布滞后模型)的随机误差项进行异方差和自相关检验。
对模型的其他检验都应建立在随机误差项是一个白噪声序列的基础之上。
在检验约束条件是否成立的过程中逐步剔除不显著变量,化简模型,同时还要保持模型随机误差项的非自相关性和同方差性不被破坏。
在这个过程中要用到许多统计量。
下面介绍一些常用的检验方法。
1.F检验把样本数据取对数后建立回归模型,随机误差项一般不会存在异方差。
对于随机误差项的一阶自相关检验可用DW 统计量完成。
对于ADL 模型(6.9),约束条件(5),(6),(7)和(10),即 α1 = 0,β1 = 0,β0 = 0 和 α1 + β0 + β1 - 1 = 0(见6.2和6.3节)的是否成立可用t 检验完成。
如果t 统计量的绝对值大于临界值,则相应约束条件不成立,相应解释变量不能轻易地从模型中剔除掉。
否则接受相应约束条件,从模型中剔除相应解释变量。
对于联合线性约束条件(1),(2),(3)和(4)(见6.2节)可用F 检验完成。
假定模型误差项服从正态分布,共有m 个线性约束条件,则所用统计量是F = )/(/)(k T SSE m SSE SSE u u r −− (6.45) 其中SSE r 表示施加约束条件后估计模型的残差平方和,SSE u 表示未施加约束条件的估计模型的残差平方和,m 表示约束条件个数,T 表示样本容量,k 表示未加约束的模型中被估参数的个数。
计量经济学中的误差修正模型及其预测精度研究

计量经济学中的误差修正模型及其预测精度研究计量经济学是对经济现象进行测量和分析的一门学科。
在计量经济学中,误差修正模型是一种广泛应用的方法,它可以帮助我们解决许多实际问题。
本文将对误差修正模型进行探讨,并重点研究误差修正模型的预测精度。
一、误差修正模型的定义和原理误差修正模型是计量经济学中一种描述时间序列数据的模型。
它假设当前时期的因变量值与前一时期的因变量值之间存在一个误差修正机制。
这个机制是通过当前时期的因变量偏离其长期均衡水平来激发的,从而使得因变量在下一时期回归其长期均衡水平。
以价格和需求量为例,如果价格上涨导致需求量下降,那么在下一个时期,价格会相应下降,从而使得需求量回归到其长期均衡水平。
这个机制就是误差修正机制。
误差修正模型的核心是一个误差修正项,它表示当前时间趋向于恢复到长期均衡水平所需的时间。
当模型中存在这个项时,就意味着模型具有趋势回归的性质,即当因变量偏离其长期均衡水平时,它会回归到这个水平。
二、误差修正模型的建立和检验误差修正模型的建立需要通过数据的时间序列分析得到。
对于一个时间序列,需要检验它是否存在单位根,从而确定其是否为稳态序列。
如果不存在单位根,则需要进行差分处理,将它转化为一个稳态序列。
接下来,可以使用广义最小二乘法(GLS)或者约束最小二乘法(CLS)的方法,将误差修正项引入模型中进行建立。
误差修正项的系数反映了因变量向长期均衡水平回归的速度。
对于误差修正模型的检验,可以使用单位根检验和协整检验。
单位根检验用于判断时间序列是否存在单位根,如果存在,就需要进行差分处理;而协整检验则用于检验多个时间序列之间是否具有长期均衡关系。
只有在这种关系存在时,误差修正模型才能够建立。
三、误差修正模型的预测精度误差修正模型可以用来预测未来的时间序列,但是它的预测精度并不总是稳定的。
因为误差修正项的系数反映了因变量向长期均衡水平回归的速度,如果这个速度过慢或者过快,就会导致预测精度的下降。
误差修正模型

脉冲响应函数
假定扰动项
恩格尔和格兰杰所提出的协整理论,协整理论的宗旨在 于对于那些建模较为困难的非平稳序列 ,通过引入协整
的差分变量,达到是模型成立并提高模型精度的目的。
并将经济变量之间存在的长期稳定关系称为协整关系, 可以说经济变量的协整性是对非平稳经济变量长期均衡 关系的统计描述,
当且仅当若干个平稳变量具有协整性时 ,由这些变量建 立的回归模型才有意义。所以协整性检验也是区别真实 回归和虚假回归的有效方法。
此被称为“误差修正模型”。误差修正模型的自动调整 机制类似于适应性预期模型。若误差修正项的系数α 在统计上是显著的,它将告诉我们 Y 在一个时期里的 失衡有多大一个比例部分可在下一期得到纠正,或者更 应该说“失衡”对下一期Y 水平变化的影响的大小。
脉冲响应函数
VAR模型中某一个内生变量的冲击或扰动会对其他变量 产生影响,其他变量又会反过来影响该变量本身,用来描 述这样一个传导及影响机制的方法 ,我们称之为脉冲响 应函数法。 脉冲响应函数的基本思想可以解释为:
若把该模型变形成Yt 的一阶差分的如下形式,即
若令
则模型变为 式中:∆Yt 代表被解释变量的短期波动,∆Xt 为解释变
量的短期波动,ecmt−1 代表的则是两个变量之间关系 对长期均衡的偏离,即上一期变量偏离均衡水平的误差, 称为误差修正项。α 称为修正系数,反映 Y 对均衡偏 离的修正速度。
因此被解释变量的短期波动可以分解成两个部分: 一部 分为解释变量的短期波动影响,另一部分为长期均衡的 调节效应。模型中β2 通常小于 1 ,所以 ecmt−1 的系数 α 通常小于 0。
这意味着前一期 X 对 Y 解释不足,有正的误差时,会 减少 Y 的正向波动或增加其负向波动,反之则反是。
第六章 Johanson协整检验与VEC模型
还有一些需要注意的细节: (1) Johansen协整检验的临界值对 k =10 的序列都是有 效的。而且临界值依赖于趋势假设,对于包含其他确定性 回归量的模型可能是不适合。 (2) 迹统计量和最大特征值统计量的结论可能产生冲突。 对这样的情况,建议检验估计得到的协整向量(产生协整向 量并检验其平稳性),并将选择建立在协整关系的解释能力 上。
Γi Φ j j i 1
i1
п称之为压缩矩阵或影响矩阵(impact matrix)
先假定y是向量单位根过程----I(1)
由于I(1)过程经过差分变换将变成I(0)过程,即上式中的
Δyt–j (j=1,2,…,p) 都是I(0)变量构成的向量,那么只要 yt-1 是
I(0)的向量,即 y1,t-1,y2,t-1,…,yk,t-1 之间具有协整关系,就 能保证Δyt是平稳过程。可以证明变量y1,t-1,y2,t-1, …,yk,t-1 之
Π αβ
其中rk ( )= r,rk ( )= r。
如果变量间存在协整关系,则无法通过差分形式的有限阶VAR模型进 行表示(hamilton 699)
将式п的表达式带入模型(1),即
p 1
yt αβyt1 Γiyti εt i 1
向量误差修正模型的表达式VECM
上式要求 yt-1 的每一行为一个 I(0) 向量,其每一行都 是 I(0) 组合变量(yt-1元素的线性组合),矩阵 决定了y1,t-1,
下面介绍JJ检验的基本思想。任意一个VAR(p)模型
yt Φ1yt1先给出上式的一种等价形式(hamilton,667)
Φ j j 1, p 为k×k维矩阵
p 1
误差修正模型
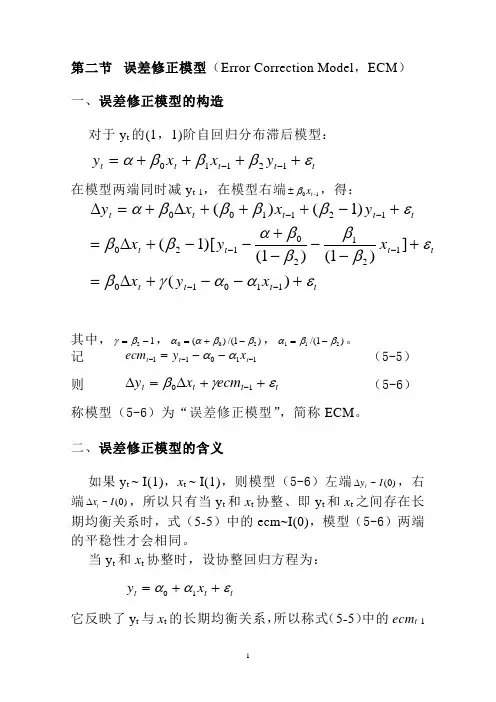
第二节 误差修正模型(Error Correction Model ,ECM )一、误差修正模型的构造对于y t 的(1,1)阶自回归分布滞后模型:t t t t t y x x y εβββα++++=--12110在模型两端同时减y t-1,在模型右端10-±t x β,得:tt t t tt t t t t t t t x y x x y x y x x y εααγβεββββαββεββββα+--+∆=+---+--+∆=+-+++∆+=∆------)(])1()1()[1()1()(1101012120120121100其中,12-=βγ,)1/()(2ββαα-+=,)1/(211ββα-=。
记 11011-----=t t t x y ecm αα(5-5) 则t t t t ecmx y εγβ++∆=∆-1(5-6)称模型(5-6)为“误差修正模型”,简称ECM 。
二、误差修正模型的含义如果y t ~ I(1),x t ~ I(1),则模型(5-6)左端)0(~I y t∆,右端)0(~I x t∆,所以只有当y t 和x t 协整、即y t 和x t 之间存在长期均衡关系时,式(5-5)中的ecm~I(0),模型(5-6)两端的平稳性才会相同。
当y t 和x t 协整时,设协整回归方程为:t t t x y εαα++=10它反映了y t 与x t 的长期均衡关系,所以称式(5-5)中的ecm t -1是前一期的“非均衡误差”,称误差修正模型(5-6)中的1-t ecmγ是误差修正项,12-=βγ是修正系数,由于通常1||2<β,这样0<γ;当ecm t -1 >0时(即出现正误差),误差修正项1-t ecm γ< 0,而ecm t -1 < 0时(即出现负误差),1-t ecm γ> 0,两者的方向恰好相反,所以,误差修正是一个反向调整过程(负反馈机制)。
计量经济学第三版部分答案(第六章之后的)
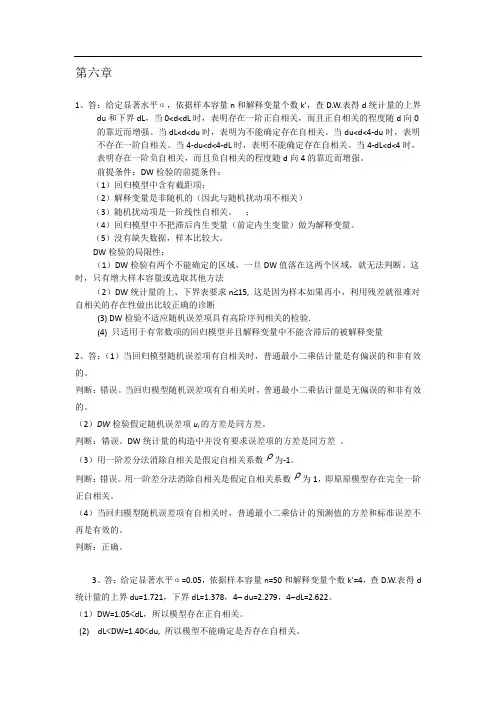
第六章1、答:给定显著水平α,依据样本容量n 和解释变量个数k’,查D.W.表得d 统计量的上界du 和下界dL ,当0<d<dL 时,表明存在一阶正自相关,而且正自相关的程度随d 向0的靠近而增强。
当dL<d<du 时,表明为不能确定存在自相关。
当du<d<4-du 时,表明不存在一阶自相关。
当4-du<d<4-dL 时,表明不能确定存在自相关。
当4-dL<d<4时,表明存在一阶负自相关,而且负自相关的程度随d 向4的靠近而增强。
前提条件:DW 检验的前提条件:(1)回归模型中含有截距项;(2)解释变量是非随机的(因此与随机扰动项不相关)(3)随机扰动项是一阶线性自相关。
;(4)回归模型中不把滞后内生变量(前定内生变量)做为解释变量。
(5)没有缺失数据,样本比较大。
DW 检验的局限性:(1)DW 检验有两个不能确定的区域,一旦DW 值落在这两个区域,就无法判断。
这时,只有增大样本容量或选取其他方法(2)DW 统计量的上、下界表要求n ≥15, 这是因为样本如果再小,利用残差就很难对自相关的存在性做出比较正确的诊断(3) DW 检验不适应随机误差项具有高阶序列相关的检验.(4) 只适用于有常数项的回归模型并且解释变量中不能含滞后的被解释变量2、答:(1)当回归模型随机误差项有自相关时,普通最小二乘估计量是有偏误的和非有效的。
判断:错误。
当回归模型随机误差项有自相关时,普通最小二乘估计量是无偏误的和非有效的。
(2)DW 检验假定随机误差项u i 的方差是同方差。
判断:错误。
DW 统计量的构造中并没有要求误差项的方差是同方差 。
(3)用一阶差分法消除自相关是假定自相关系数为-1。
判断:错误。
用一阶差分法消除自相关是假定自相关系数为1,即原原模型存在完全一阶正自相关。
(4)当回归模型随机误差项有自相关时,普通最小二乘估计的预测值的方差和标准误差不再是有效的。
误差修正模型课件

Error Correction Model,简记为ECM,是 一种具有特定形式的计量经济学模型
产生原因:经济数据一般情况下都是非平 稳的,对于非稳定时间序列,可通过差 分的方法将其化为稳定序列,然后才可 建立经典的回归分析模型。
误差修正模型
误差修正模型建立的作用 为了增强模型的精度,将协整回归中的
误差修正模型
2. 最优滞后阶数的选择
1. AIC信息准则 2. SC准则
误差修正模型
AIC信息准则
AIC值最小 AIC信息准则,又称赤池信息量准则
Akaike information criterion、简称AIC,是衡
量统计模型拟合优良性的一种标准,是由日本 统计学家赤池弘次创立和发展的。 AIC鼓励数据拟合的优良性但是尽量避免出现 过度拟合(Overfitting)的情况。所以优先考虑 的模型应是AIC值最小的那一个。
误差修正模型
目的:查看常数项和时间趋势项是否显著
误差修正模型
第二步:上图结果显示常数项显著,因 此对原始数据单位根检验中同时加入常 数项
误差修正模型
SC信息准则
SC值最小 SC信息准则,又称施瓦兹准则,即
Schwarz Criterion 其检验思想也是通过比较不同分布滞后模
型的拟合优度来确定合适的滞后期长度。 检验过程是:在模型中逐期添加滞后变量 ,直到SC值不再降低时为止,即选择使SC 值达到最小的滞后期k。
误差修正模型
得出图形
误差修正模型
结论
由GDP的时间序列图初步判断序列是不 平稳的
可以看出该序列可能存在趋势项,若需 要单位根检验,则选择第三种模型进行 检验
误差修正模型
方法2:用自相关系数图判断
我国消费与收入关系的实证研究——基于动态分布回归与误差修正模型
Ab t a t T h ou he e t b i h e od l y usng yn m i s rbu i n of r gr s i n a s r c : r gh t s a ls m nt of m e ,b i d a c dit i to e e so nd
消 费水平 。 关 键词 : 费 ; 消 收入 ; 态分布 回归; 差 修 正模 型 动 误 中图分类 号 : 1 6 F 2 文 献标 识码 : A
A Em p r c lS u y o h l to s p be we n Ch nas Co u pto n n o e i i a t d f t e Re a i n hi t e i ns m i n a d I c m
20 0 9年 6月
河北科技大学学报 ( 会科学版) 社
J u n l f He e i e st fS i n e a d Te h o o y S ca ce c s o r a b i o Un v r i o ce c n c n lg ( o i 1 i n e ) y S
to hi e we n Ch nas o umpton a n o h s be n d e The t dy f und ha n t o i ns p b t e i ' c ns i nd i c me a e on . s u o t t i he l ng
J n2 0 u . 09
Vo19 NO. . 2
第 9卷 第 2期
文章编号 :6 1 6 3 2 0 ) 2 0 6 4 1 7 —1 5 (0 9 0 —0 0 —0
我 国 费 与 收 入 关 系 的 实 证 研 究 消
基 于 动 态分 布 回 归与误 差修 正模 型
协整与误差修正模型
协整与误差修正模型第六讲协整与误差修正模型一、非平稳过程与单位根检验二、长期均衡关系与协整三、误差修正模型一、非平稳过程与单位根检验1、非平稳过程1)随机游走过程(random walk)。
y t = y t-1 + u t, u t~ IID(0, σ2)10y=y(-1)+u5-5-10204060140160差分平稳过程(difference- stationary process)。
2)有漂移项的非平稳过程(non-stationary process with drift )或随机趋势非平稳过程(stochastic trend process )。
y t = μ + y t -1 + u t , u t ~ IID(0, σ2)迭代变换:y t = μ + (μ + y t -2 + u t -1) + u t = … = y 0 + μ t +∑-t i i u 1= μ t +∑-ti i u 120406080100-80-60-40-2020差分平稳过程3)趋势平稳过程(trend-stationary process)或退势平稳过程。
y t = μ+ α t + u t, u t~ IID(0, σ2)2520151055101520253035404550趋势平稳过程的差分过程是过度差分过程:?y t = α + u t - u t-1。
所以应该用退势的方法获得平稳过程。
y t - α t = μ+ u t。
4)确定性趋势非平稳过程(non-stationary process with deterministic trend)y t = μ+ α t + y t-1+ u t, u t~ IID(0, σ2) 1801601401201008060400450500550600650700750800确定性趋势非平稳过程的差分过程是退势平稳过程,?yt = μ + α t + ut。
误差修正模型课件
单方程误差修正模型是针对单个经济变量进行建模的方法,主要目的是检验和估计长期均衡关系及其短期调整机 制。
详细描述
单方程误差修正模型基于经济理论,通过一个经济变量对它的长期均衡关系及其短期调整机制进行建模。它通常 采用一阶差分法或协整法来处理非平稳时间序列数据,以识别和估计变量的长期均衡关系及其短期调整机制。
通常用长期均衡方程来描述。
在长期均衡方程中,变量的系数 映了其在长期均衡关系中的贡
献程度。
长期均衡关系通常是在市场机制 的作用下,通过供求关系自发调
节而形成的。
短期调整机制
短期调整机制是指当经济变量受到外 部冲击或其他因素的影响,导致其偏 离长期均衡状态时,系统会自动调整 以重新回到均衡状态的过程。
与
06
误差修正模型在经济学中的地位与作用
经济学的核心工具
误差修正模型(ECM)是现代经 济学中用于研究长期均衡关系和 短期调整机制的重要工具,尤其 在宏观和微观经济学中占据核心 地位。
揭示经济规律
通过ECM,研究者可以深入探究 经济变量之间的内在关系,揭示 其背后的经济规律和动态机制, 为政策制定提供科学依据。
外汇市场汇率调整的误差修正模型
总结词
该模型用于研究外汇市场汇率的调整机制, 通过分析汇率的短期波动和长期均衡趋势来 预测汇率变化。
详细描述
外汇市场汇率调整的误差修正模型关注汇率 的动态变化,并考虑国内外经济基本面的差 异对汇率的影响。它利用误差项来衡量短期 非均衡程度,并通过调整机制预测长期均衡 汇率的回归,有助于分析汇率的稳定性和波 动性。
短期调整机制通常是通过误差修正机 制来实现的,即系统会根据误差的大 小和方向,自动调整变量的取值,以 使其重新回到长期均衡状态。
误差修正模型公式
误差修正模型公式
误差修正模型(Error Correction Model, ECM)是一个著名的非平稳时间序列分析方法,其基本思想是建立一个包括误差修正项的向量自回归模型(Vector Autoregressive Model, VAR),以捕捉长期和短期之间的非平稳关系。
其公式如下:
$∆y_t = α_0 + β_0 y_{t-1} + Σ_{i=1}^{p-1} β_i ∆y_{t-i} + γ_1 EC_{t-1} + Σ_{i=1}^{p-1} γ_{i+1} EC_{t-i} + ɛ_t$
其中,$y_t$ 表示要研究的非平稳时间序列,$EC_t$ 表示误差修正项,$p$ 表示自回归项的阶数,$α_0$、$β_0$,$β_i$ 和 $γ_i$ 表示回归系数,$ɛ_t$ 表示误差。
误差修正项可以看作是一个调整参数,用来使得模型在长期和短期之间保持平衡。
当向量误差达到稳态时,误差修正项为0。
而在误差修正模型中,模型的原始变量和误差修正项是彼此相关的,从而使得该模型可以同时捕捉短期和长期非平稳关系的特点。
当我们使用 ECM 模型进行非平稳时间序列数据的分析时,首先需要检验变量之间是否存在协整关系,然后再进行特征提取和模型建立。
获得模型后,我们可以利用模型进行预测和分析,以帮助我们更好地理解非平稳时间序列数据的动态特性和规律。