
2015重庆大学数理统计大作业综述
研究生课程考核试卷(适用于课程论文、提交报告)科目:数理统计教师:刘琼荪姓名:xxx 学号:20150702xxx 专业:机械工程类别:学术上课时间:2016 年 3 月至2016 年 4 月考生成绩:卷面成绩平时成绩课程综合成绩阅卷评语:阅卷教师(签名)我国上世纪70-90年代民航客运量回归分析摘要:中国民航从上实际50年代发展至今已有60多年的历史,这期间中国民航经历了曲折的发展。
随着改革开发以来,中国人民的生活水平日渐提高,出行坐乘飞机逐渐人们可选的交通方式。
我国民航客运量逐年提高,为了研究其历史变化趋势及其成因,现以民航客运量作为因变量y,假设以国民收入x1、消费额x2、铁路客运量x3、民航航线里程x4、来华旅游入境人数x5为影响民航客运量的主要因素。
利用SPSS和excel软件通过建立回归模型分析我国民航客运量主要受到其中哪些因素的影响,并就回归模型分析具体可能的成因。
关键词:民航客运量影响因素回归模型一、问题提出及问题分析2004年,民航行业完成运输总周转量230亿吨公里、旅客运输量1.2亿人、货邮运输量273万吨、通用航空作业7.7万小时。
截止2004年底,我国定期航班航线达到1200条,其中国内航线(包括香港、澳门航线)975条,国际航线225条,境内民航定期航班通航机场133个(不含香港、澳门),形成了以北京、上海、广州机场为中心,以省会、旅游城市机场为枢纽,其它城市机场为支干,联结国内127个城市,联结38个国家80个城市的航空运输网络。
民航机队规模不断扩大,截止至2004年底,中国民航拥有运输飞机754架,其中大中型飞机680架,均为世界上最先进的飞机。
2004年中国民航运输总周转量达到230亿吨公里(不包括香港、澳门特别行政区以及台湾省),在国际民航组织188个缔约国中名列第3位。
从上述事实可以看出我国民航的发展所取得的成果显著。
当前我国民航客运量相当巨大,而影响我国航运客运量的因素有很多,例如第三产业增加值(亿元),城市居民消费水平(绝对元),定期航班航线里程(万千里)等[1]。
为了研究过去的情况,从中国统计年鉴[2]得到1994年统计摘要,分析类似因素对我国航空客运量的影响。
二、数据描述如下为所得统计数据:表1 1978-1993年统计数据年份y民航客运量(万人)x1国民收入(亿元)x2消费额(亿元)x3铁路客运量(万人)x4民航航线里程(万公里)x5来华旅游入境人数(万人)1978231 301018888149114.89180.92 1979298 335021958638916420.39 1980343 368825319220419.53570.25 1981401 394127999530021.82776.71 1982445 425830549992223.27792.43 1983391 4736335810604422.91947.7 1984554 5652390511035326.021285.22 1985744 7020487911211027.721783.3 1986997 7859555210857932.432281.95 19871310 9313638611242938.912690.23 19881442 11738803812264537.383169.48 19891283 13176900511380747.192450.14 19901660 1438496639571250.682746.2 19912178 16557109699508155.913335.65 19922886 20223129859969383.663311.5 19933383 248821594910545896.084152.7三、模型建立:(1)提出假设条件,明确概念,引进参数;参考相关书籍[3],设随机变量民航客运量为Y (万人),解释变量1X ,2X ,3X ,4X ,5X 分别为国民收入(亿元),消费额(亿元),铁路客运量(万人),民航航线里程(万公里),来华旅游入境人数(万人),且回归函数11225501155(|,,,)E Y X x X x X x x x βββ==⋅⋅⋅==++⋅⋅⋅+,称201155,0,Y x x E D DY βββεεεσ=++⋅⋅⋅++===,为多元线性回归模型,015,,,βββ⋅⋅⋅为回归系数,ε为随机误差。
125(,,,,),1,2,,5i i i i x x x y i ⋅⋅⋅=⋅⋅⋅为上述来自多元线性回归模型的样本值,满足:201155125,0,,1,2,,5,,,,i i i i i i y x x E D i βββεεεσεεε⎧=++⋅⋅⋅++===⋅⋅⋅⎨⋅⋅⋅⎩相互独立为了便于对模型进行参数估计、模型检验、变量选择等,有必要对模型作如下一些基本假定。
1. 解释变量1X ,2X ,3X ,4X ,5X 是可控制的、非随机变量,互不相关。
2. 随机误差项具有零均值和同方差的性质,即2,1,2,,5i D i εσ==⋅⋅⋅,并且125,,,εεε⋅⋅⋅相互独立,则有(),0,,,1,2,5i j Cov i j i j =≠=…,εε。
3. 随机变量误差项服从正态分布,即()2~0,,1,2,5i N i =…εσ (2)模型构建:由表1通过EXCEL 绘制变量,1,2,,5i X i =⋅⋅⋅对因变量Y 的关系散点图如下:图1 民航客运量与国民收入关系图图2 民航客运量与消费额关系图图3 民航客运量与铁路客运量关系图图4 民航客运量与民航航线里程关系图图5 民航客运量与来华旅游入境人数关系图由以上的散点图看出:y 与3x 存在非线性关系,但与其它几个变量基本是线性相关的。
所以首先考虑回归模型为多元线性模型。
四、模型求解。
采用最小二乘估计法求解模型参数,采用SPSS 软件计算,得到如下结果:表2 拟合过程小结RR 平方调整后的 R 平方标准估算的错误Durbin-Watson(U)1.999a.998.99749.492401.993模型摘要b模型a. 预测变量:(常量),x5, x3, x4, x2, x1b. 因变量:y表3 方差分析平方和自由度均方F显著性回归13818876.76952763775.3541128.303.000b残差24494.981102449.498总计13843371.75015b. 预测变量:(常量),x5, x3, x4, x2, x1ANOVA a模型1a. 因变量:y表4 回归过程统计量标准系数B标准错误贝塔容许VIF (常量)450.909178.0782.532.030x2-.561.125-2.485-4.478.001.0011740.508x1.354.085 2.447 4.152.002.0011963.337x3-.007.002-.083-3.510.006.315 3.171x421.5784.030.5315.354.000.01855.488x5.435.052.5648.440.000.04025.1931a. 因变量:y系数a模型非标准化系数t 显著性共线性统计图6 残差图则回归方程为12345450.9090.3540.5610.00721.5780.435y x x x x x =+--++五、模型分析检验(1)决定系数由决定系数2R =0.998看出回归方程高度显著。
(2)方差分析表123451128.303=0.000,,,y F P x x x x x =,值,这说明,整体上对有高度显著的影响。
(3)回归系数的显著性检验(t 检验):回归系数的显著性检验由显著性一列看出自变量的回归系数都通过了t 检验(即收尾概率小于规定的显著性水平0.05),说明5个自变量对y 的影响显著。
其中3x 铁路客运量的显著性为0.006最大,但仍小于5%。
(4)检验残差序列的自相关性(D-W 检验):D-W=1.993≈2,所以认为模型不存在序列的自相关性。
(6)异方差检验从残差图看出所有点落在±2之间,没有明显变化趋势,所以认为()2~0,,1,2,5i N i =…εσ综上,认为用最小二乘估计的方法估计的模型理论上是有效的。
(7) 模型进一步分析虽然,模型通过了检验,但是由之前的图可知2x 与y 正相关,但2x (国民消费额)的回归系数是负值,显然是矛盾的,同时1x 和2x 的VIF 很大,4x ,5x 的VIF 也大于10,其原因是自变量之间的共线性,因而回归模型还要就共线性问题进行谈论。
如下表是各变量之间的相关系数:表5 相关系数表yx1x2x3x4x5相关系数 1.000.933**.933**.367*.933**.933**显著性(双尾).000.000.048.000.000N161616161616相关系数.933**1.0001.000**.400*.967**.933**显著性(双尾).000.031.000.000N161616161616相关系数.933**1.000**1.000.400*.967**.933**显著性(双尾).000.031.000.000N161616161616相关系数.367*.400*.400*1.000.367*.400*显著性(双尾).048.031.031.048.031N161616161616相关系数.933**.967**.967**.367*1.000.900**显著性(双尾).000.000.000.048.000N161616161616相关系数.933**.933**.933**.400*.900**1.000显著性(双尾).000.000.000.031.000N161616161616**. 相关性在 0.01 级别显著(双尾)。
*. 相关性在 0.05 级别显著(双尾)。
相关性肯德尔tau_byx1x2x3x4x5可以看出, y 与1x ,2x ,4x ,5x 的相关系数都在0.9以上,说明所选自变量与y 高度线性相关,验证之前的散点图。
用y 与自变量作多元线性回归是适合的。
另一方面,3x 与各变量的相关系数均小于0.5,而1x ,2x ,4x ,5x 之间的相关系数均达到0.9以上,所以应尝试解决它们之间的共线性。
首先剔除VIF 最大的1x ,计算剩余变量参与的回归方程。
结果如下:表6 统计量表标准系数B标准错误贝塔容许VIF (常量)695.039264.5252.627.024x2-.053.042-.233-1.262.233.01377.546x3-.012.003-.134-4.207.001.431 2.319x432.037 4.951.788 6.471.000.03033.812x5.399.080.5174.988.000.04124.4691a. 因变量:y系数a模型非标准化系数t 显著性共线性统计可以看出,当前2x 的VIF 最大,同时2x 也没通过t 检验,其显著性0.233远大于0.05,故继续剔除2x 。
数理统计中期报告
研究生课程考核试卷(适用于课程论文、提交报告)科目:数理统计教师:李曼曼姓名:XXX学号:XXXXXXX专业:XXXXXXXXX类别:学术型硕士上课时间:2016年2月至2016年4月考生成绩:阅卷评语:阅卷教师(签名)重庆大学研究生《数理统计》课程考核要求注:1、要有明确的课程考核要求:如课程论文(报告)题目(范围)、篇幅(字数)、必须的参考资料、提交时间等。
并提前将课程考核试卷发给学生。
2、提交课程论文撰写格式参考《重庆大学博士、硕士学位论文撰写格式标准》。
基于多元线性回归对河北省GDP影响因素的研究摘要:经济发展是社会稳定的重要前提,是改善民生的需要。
河北省作为实现京津冀一体化的重要省份,其经济状况一直以来是国家关注的焦点。
众所周知,投资、消费、出口比喻为拉动GDP增长的“三驾马车”,对拉动经济发展起到至关重要的作用。
研究投资、消费、出口与GDP的关系可以有效地指导政府制定经济政策,促进经济快速增长。
本文采用多元线性回归的分析方法,分析投资、消费、出口与GDP的线性关系,用居民最终消费支出表示消费,城镇固定资产投资额表示投资,货物和服务净出口表示出口,得到模型,采用F检验的方法检验投资、消费、出口与GDP线性关系的显著性,得出结论消费、出口与GDP有显著的线性关系,最后根据投资、消费、出口与GDP的线性关系为政府制定经济政策提出合理化建议。
关键字:GDP 多元线性回归影响因素线性关系1 问题提出,问题分析一个国家的经济状况是一个国家生存发展的支柱,提高国家的经济水平是每个国家的首要任务。
我国共有34个省级行政区域,其中包括23个省、5个自治区、4个直辖市、2个特别行政区,国家的经济发展是靠各个省的经济发展带动起来的,所以,对于一个省来说,提高经济水平也是省的首要任务。
在34个省中,河北省作为京津冀一体化的重要参与者,其经济发展水平一直是国家关注的对象,研究河北省经济发展的影响因素可以有效地指导河北省制定经济发展政策,发展河北省经济,故本研究具有很强的实践意义。
重庆大学研究生数理统计习题答案
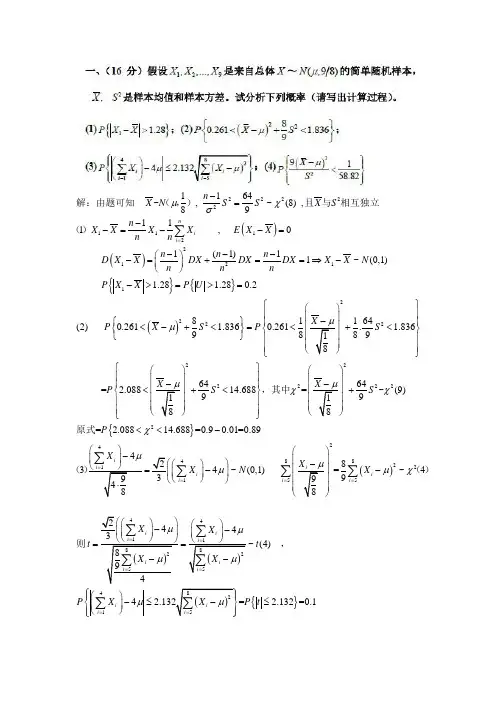
()(){}{}()22222111221121221164~,~(8),89111,01(1)11~(0,1)1.28 1.280.281(2)0.261 1.8360.2619818ni i n X N S S X S n X X X X E X X n n n n n D X X DX DX DX X X N n n n P X X P U X P X S P μχσμ=-=--=--=---⎛⎫-=+==⇒- ⎪⎝⎭->=>=⎛ -⎧⎫ <-+<=<⎨⎬ ⎩⎭⎝∑解:由题可知(,)且与相互独立(){}22222222241164. 1.836896464 = 2.08814.688=~(9)991188= 2.08814.688=0.90.01=0.89423948i i i S X X P S S P X X χχχμ=⎧⎫⎫⎪⎪⎪⎪⎪⎪+<⎨⎬⎪⎪⎪⎪⎪⎪⎭⎩⎭⎧⎫⎛⎫⎛⎫⎪⎪ ⎪ ⎪--⎪⎪⎪ ⎪<+<+⎨⎬ ⎪ ⎪⎪⎪⎪ ⎪⎪⎪⎝⎭⎝⎭⎩⎭<<-⎛⎫- ⎪⎝⎭=⋅∑,其中原式()()()()(){}24882255448822554821584~(0,1)=~4998244~(4)8944 2.132= 2.132=0.1i ii i i i i i i i i ii i N X X X t t X XP X XP t μμχμμμμμμ======⎛⎫ ⎪⎛⎫⎛⎫ ⎪-- ⎪ ⎪ ⎪⎝⎭⎝⎭ ⎪⎝⎭⎛⎫⎛⎫⎛⎫-- ⎪⎪⎪⎝⎭⎝⎭==--⎧⎫⎛⎫⎪⎪-≤-≤⎨⎬ ⎪⎝⎭⎪⎪⎩⎭∑∑∑∑∑∑∑∑∑()则,()()()(){}222222222891(4)=8~1~(1,8)6498911=(1,8)58.82(8,1)10.90.158.8258.82XXX F FSSXP P F P FSμμμχμ-⎛⎫⎪--==⎧⎫-⎪⎪⎧⎫<<=<=-=⎨⎬⎨⎬⎩⎭⎪⎪⎩⎭(),则也可以用T分布与F分布的关系.0020001111()()1ln(1)11,,ˆˆˆ1ln(1),,ln(1)ln(1)2(;,...,)(;)ln (;,...,)=01ˆ=()()似然方程:得到参数的极大似然估计,再由i A nnx n n xn i i i n P X A F A e p p A EX DX A EX p EX X A EX p X p L x x f x e e d L x x nnx d Xλλλλλλλλλλλλλλλ---==<==-=-=-===--=∴=--=--====-∏∏ 0000010000ln(1)ˆln(1)ˆln(1)ˆ(3)=ln(1)=ln(1)==ˆln (;,...,)ln(1){[ln(1)][]}ln(1)ˆ()ln(1)ˆˆ极大似然估计的不变性,推出的极大似然估计为是的无偏估计且是的无偏估计是有效n A p A X p p EA E X p p EX A AA d L x x p n n nx X p d p n AA p AA A λλλλλλ-=-=----⎡⎤----⎣⎦∴-=-=-----=--∴ ()202ˆlim ln(1)ˆlim lim 0ˆ估计又是相合估计量n n n EA A p DA n Aλ→∞→∞→∞⎧=⎪⎨-⎪==⎩∴221212121222122222222221222121.422,2~222(1)(1)~01~(2) (1)(1)(1)(1)2=222X YX Y X YX X X X Nn mX X n S m SU N n mn S m S n S m S X X Sn mX Xtωσσμμμμμμχχσσσσ+++++-+--==++----+-+++-+-+==的无偏估计为且(,+)(,)又且与独立,记则()()()()()()()121212212121211221212122222=22=22222=12122t n mP t t n mX XP t n m t n mP X X t n m S X X t n m SX X t n m Sαααααωαμμμμαμμα-----+-⎧⎫≤+-⎨⎬⎩⎭⎧⎫⎪⎪+-+⎪⎪+-≤≤+-⎨⎬⎪⎪⎪⎪⎩⎭⎧⎪+-+-≤+≤+++-⎨⎪⎩-+-+±+-因此构造的置信区间为{}{}121201212120121212121212.222=022,22=02=02=0=的无偏估计为,在:成立的条件下,大于某个常数应该是小概率事件,因此构造拒绝域:以下确定常数由X X H X X c K X X c cP X X c P P t t μμμμμμμμμμα+++++>+>+⎧⎫⎪⎪⎪=>+⎬⎪⎪⎭⎧⎫⎪⎪⎪⎪=>+=⎨⎬⎪⎪⎪⎪⎩⎭()()122n m c t n m S ααω--+-⇒=+-拒绝域为:3133011331122333333111~(1,).~(3)220.220.230.20.20.80.20.104220.4因为所以,类错误(弃真):为真类错误(纳伪):为真i i i i i i i i i i i i i i X B p X B p P X H P X p P X p P X p C C P X H P X p αβ=======I ⎧⎫⎧⎫=≥=≥=⎨⎬⎨⎬⎩⎭⎩⎭⎧⎫⎧⎫===+==⎨⎬⎨⎬⎩⎭⎩⎭=+=II ⎧⎫⎧=<=<=⎨⎬⎨⎩⎭⎩∑∑∑∑∑∑∑313311223333120.4120.430.410.40.60.40.648i i i i i i P X p P X p P X p C C ===⎫⎬⎭⎧⎫=-≥=⎨⎬⎩⎭⎧⎫⎧⎫=-==-==⎨⎬⎨⎬⎩⎭⎩⎭=--=∑∑∑()()221221111211=200ˆnE i i i n n nEi i i i i i i i i ni ii nii S y x dS y x x y x x d x yxββββββ======-=--=⇒-==∑∑∑∑∑∑解:()利用最小二乘估计使残差平方和最小参数的最小二乘估计量为2211222111111221111ˆ2=~(,)ˆˆˆ~(,)111ˆ===11ˆ(),由正态分布的性质推知服从正态分布ni ii i i i ni ii nnni i iiiinnni i i i i ii i i ni i nn i i i i i x YY x N x xN E D E E x Y x EY x x x x xD D x Y x x ββεβσβββββββ============+⎛⎫ ⎪ ⎪= ⎪ ⎪⎝⎭⎛⎫⎛ ⎪ ⎪ == ⎪ ⎪⎝⎭⎝∑∑∑∑∑∑∑∑∑∑∑()()()()()222211221222111112211ˆ~(,)ˆˆˆ3=ˆˆˆ2(,)ˆ(,)(,)因此,()nii ni ii n i i nnE i iiiiii i nni i i i i ii i ni ii ii i i i nniii i xDY xN x ES E Y x D Y x E Y x D Y x DY D x Cov Y x x Yx Cov Y x Cov Y x C xxσσβββββββββ==========⎫⎪⎪=⎪ ⎪⎭⎡⎤-=-+-⎣⎦⎡⎤=-=+-⎣⎦==∑∑∑∑∑∑∑∑∑∑()222221112222222222221111(,)(,)221则ni i i i i i i nni iii i nni i Enni i iii i x x ov Y x Y Cov Y Y xxx x ESn n n xxσσσσσσσσ==========+-=+-=-∑∑∑∑∑∑∑因素:车型水平:3种不同的车型A,B,C方差分析前提假设:正态性,方差齐次性,独立性对比分位数:0.95(2,9) 4.26F F >=,拒绝原假设0123:H μμμ==,认为这三种车型耗油量有显著差异。
重庆大学数理统计试题3
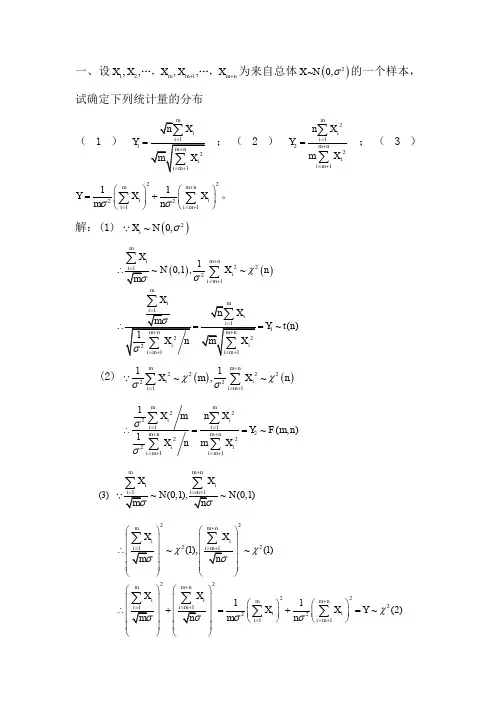
n Xi
i 1 m n m
( 1 ) Y1
m
2
i m 1
X
; ( 2 ) Y2
2 i
n X i 2 m Xi
i m 1 i 1 mn 2
n n 2 i 1 2 1 e 2 ) ( 2 2 ) 2 e 2 2 n xi2
xi2
n
L( 2 , X 1 , X 2 ,
Xn) (
i 1
ln( L( 2 , X 1 , X 2 , ln( L( 2 , X 1 , X 2 , d 2
xi2 n X n )) ln( 2 ) ln 2 i 1 2 2 2 X n )) n 1 n 1 n 2 i 1 ( xi 2 ) 2 2 2 4 2 2( ) 2 n i 1
s
2
c1
1 1 2 (n 1), c2 2 (n 1) n 1 2 n 1 1 2 s2
k0 :{
2
c2或
s2
2
c1}
(2) H0 : 2 1, H1 : 2 2
2 拒绝域 k0 : (n 1)s 2 12 (n 1);22s 2 0.95 (22) 33.92; :
m
2 i m1
X
n X i 2 m Xi
i m 1 i 1 mn 2
Y2 ~ F (m, n)
2 i
n
Xi
(3)
i 1
m
m n
m
~ N (0,1),
重庆大学研究生数理统计大作业
NBA球员科比单场总得分与上场时间的线性回归分析摘要篮球运动中,球员的上场时间与球员的场上得分的数学关系将影响到教练对每位球员上场时间的把握,若能得到某位球员的上场时间与场上得分的数据关系,将能更好的把握该名球员的场上时间分配。
本次作业将针对现役NBA球员中影响力最大的球员科比布莱恩特进行研究,对其2012-2013年赛季常规赛的每场得分与出场时间进行线性回归,得到得分与出场时间的一元线性回归直线,并对显著性进行评估和进行区间预测。
正文一、问题描述随着2002年姚明加入NBA,越来越多的中国人开始关注篮球这一项体育运动,并使得篮球运动大范围的普及开来,尤其是青年学生。
本着学以致用的原则,希望将所学理论知识与现实生活与个人兴趣相结合,若能通过建立相应的数理统计模型来做相应的分析,并且从另外一个角度解析篮球,并用以指导篮球这一项运动的更好发展,这也将是一项不同寻常的探索。
篮球运动中,得分是取胜的决定因素,若要赢得比赛,必须将得分超出对手,而影响一位球员的得分的因素是多样的,例如:情绪,状态,体力,伤病,上场时间,防守队员等诸多因素,而上场时间作为最直接最关键的因素,其对球员总得分的影响方式有着重要的研究意义。
倘若知道了其分布规律,则可从数量上掌握得分与上场时间复杂关系的大趋势,就可以利用这种趋势研究球员效率最优化与上场时间的控制问题。
因此,本文针对湖人当家球星科比布莱恩特在2012-2013年赛季常规赛的每场得分与上场时间进行线性回归分析,并对显著性进行评估,以巩固所学知识,并发现自己的不足。
二、数据描述抽出科比布莱恩特2012-2013年常规赛所有82场的数据记录(原始数据见附录),剔除掉其中没有上场的部分数据,得到有参考实用价值的数据如表2.1所示:以上数据由腾讯篮球中心提供,特此说明。
三、模型建立(1)假设条件假定球员每场的发挥均为独立同分布事件, (2)模型构建以上场时间为自变量Xi ,单场得分为应变量Yi ,建立正态线性模型式:()012,1,2,,;0,,,,,i i i ii i i Y x i n N ββεεσεεε=++=⎧⎪⎨⎪⎩且相互独立 其中β0、β1为模型参数。
数理统计第一次大作业

2010 29723.12 27279.79 21870
70073 216961
39.46 27745.38
2011
39692
35239
24747
88604 230920
39.87
34552.1
2012
47339.6 42266
28344 109870 244395
39.87 41557.15
2013 56894.4 48966 32777.2 137239 261239 40.24 51043.71
中央政府为了缓解钢铁行业面临的巨大压力,将巨额“救市”资金投向钢铁 行业,另外政府还通过大力发展用钢量较大的行业 如铁路、房地产行业等 间接 拉动钢铁行业的“复苏”。基于目前特殊的经济背景和钢铁行业的重要地位,对 钢铁行业的发展水平、与其他产业的关联特征以及影响钢铁行业发展的因素进行 再认识具有重要的理论和实际意义。
X5
26.57372 92.71114 0.286629 0.7793
X6
0.015459 0.125003 0.123667 0.9036
R-squared Adjusted R-squared S.E. of regression Sum squared resid Log likelihood Durbin-Watson stat
《钢铁产业调整和振兴规划》阐明,我国是钢铁生产和消费大国,粗钢产量 连续 13 年居世界第一。进入 21 世纪以来,我国钢铁产业快速发展,粗钢产量年 均增长 21.1%。2008 年,粗钢产量达到 5 亿吨,占全球产量的 38%,国内粗钢表 观消费量 4.53 亿吨,直接出口折合粗钢 6000 万吨,占世界钢铁贸易量的 15%。 2007 年,规模以上钢铁企业完成工业增加值 9936 亿元,占全国 GDP 的 4%,实现 利润 2436 亿元,占工业企业利润总额的 9%,直接从事钢铁生产的就业人数 358 万。钢铁产品基本满足国内需要,部分关键品种达到国际先进水平。钢铁产业有 力支撑和带动了相关产业的发展,促进了社会就业,对保障国民经济又好又快发 展做出了重要贡献。
重庆大学概率与数理统计课后答案第二章
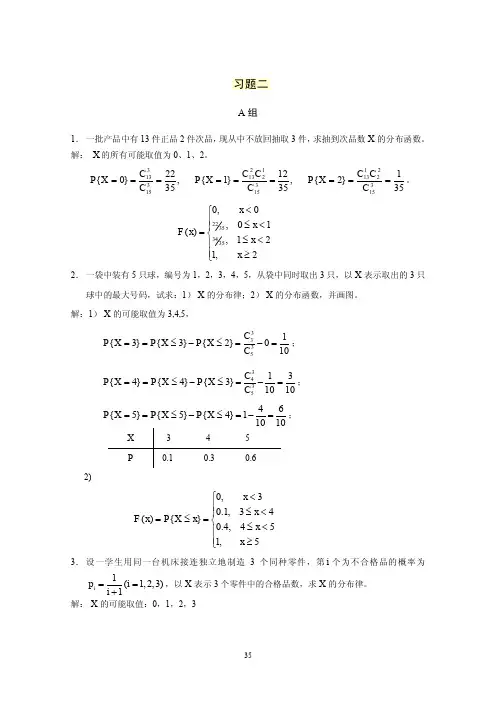
3 0.1 4 0.3 5
4 6 ; 10 10
P
2)
0.6
x3 0, 0.1, 3 x 4 F ( x) P{ X x} 0.4, 4 x 5 x5 1,
3. 设一学生用同一台机床接连独立地制造 3 个同种零件,第 i 个为不合格品的概率为
1 ,以 X 表示汽车停下时通过的交通岗个数,求 X 的分布律。 2
X 的可能取值:0,1,2,3,4 1 P( X 0) 2 1 1 P( X 1) ( ) 2 2 4 1 1 P( X 2) ( )3 2 8 1 1 P( X 3) ( ) 4 2 16 1 1 2 1 3 1 4 1 P( X 4) 1 ( ) ( ) ( ) 2 2 2 2 16
1
所以 A (2)
f x dx Ae|x|dx 2 Ae x dx 2 A
0
1 ; 2 P 0 X 1 f x dx
0 1 11 1 | x| e dx e x dx 0.316 0 2 0 2 1
解:设 X 为同一时刻使用的设备数,可能取值为:0,1,2,3,4,5, 则 X ~ B(5, 0.2) , (1) P{ X 2}
P{ X k} C
k 0 k 0
2
2
k 5
0.2 k 0.85 k 0.9421 ;
(2) P{X 2} 1 P{X 0,1} 1 0.85 5 0.2 0.84 0.2627 6.一电话总机每分钟收到呼唤次数 X 服从参数为 4 的泊松分布。求(1)某一分钟恰有 8 次 呼唤的概率; (2)某一分钟的呼唤次数大于 3 的概率。 解: (1) X ~ P(4)
重庆大学硕士研究生《数理统计》课程大作业(论文)
一、问题提出和问题分析今天的重庆,肩负着中央赋予的历史重任——着力打造西部地区的重要增长极、长江上游地区的经济中心、成为统筹城乡发展的试验者、在西部地区率先实现全面建设小康社会的目标。
2010年初,又一重要规划将重庆发展提升到国家战略——重庆被确定为国家五大中心城市之一,是中西部地区唯一入选的城市。
这说明,重庆未来的发展不可限量。
自1997年直辖以来,重庆市的经济社会发展极为迅猛。
全市的GDP由1997年的1360.24亿元增长至2010年的7894.2亿元,而整个社会的发展进步也有目共睹。
在重庆过去、现在和未来的发展进程中,在重庆的各种发展规划的要求下,建设必将成为山城的另一个符号。
过去十多年中的大规模、大范围的建设成就了现在的重庆,而重庆未来的发展将需要更多的建设。
作为重庆建设中最重要的一环,建筑业在重庆显然有着重要的地位。
建筑业这种专门从事土木工程、房屋建设和设备安装以及工程勘察设计工作的生产部门,为重庆的发展建设提供着众多的基础设施,满足着居住、工业、商业、办公等各种城市需求。
数据显示,在过去的数年中,重庆市建筑业的总产值占全市GDP的7%-8%,是名副其实的支柱产业。
因此建筑业的发展情况,可以从侧面反映出整个重庆社会经济的发展情况,对重庆建筑业的研究就有了很大的现实意义。
建筑企业是建筑业的主体。
众多的建筑企业的良好发展构成了建筑业的良好发展。
对于建筑企业来说,要实现企业的良好经营和发展,必须要有良好的收入来支撑。
在建筑企业收入的众多影响因素中,企业的劳动生产率无疑是值得关注的一个。
企业都在致力于提高自身的劳动生产效率,而不断提高的劳动生产率,可使得企业的生产经营行为更具效率,因而获得更多的收入,实现更好的发展。
所以,研究重庆市建筑企业劳动生产率与企业收入的关系,可从一个角度来了解重庆市建筑企业的发展情况,从而了解到了重庆建筑业的发展以至于重庆市的经济发展情况。
为了找出二者之间的关系或者规律性,本文采用2001-2010这十年中重庆建筑企业劳动生产率和企业平均收入的数据,通过数学分析,找出二者关系。
2015重庆大学数理统计大作业
研究生课程考核试卷(适用于课程论文、提交报告)科目:数理统计教师:刘琼荪姓名:xxx 学号:20150702xxx 专业:机械工程类别:学术上课时间:2016 年 3 月至2016 年 4 月考生成绩:卷面成绩平时成绩课程综合成绩阅卷评语:阅卷教师(签名)我国上世纪70-90年代民航客运量回归分析摘要:中国民航从上实际50年代发展至今已有60多年的历史,这期间中国民航经历了曲折的发展。
随着改革开发以来,中国人民的生活水平日渐提高,出行坐乘飞机逐渐人们可选的交通方式。
我国民航客运量逐年提高,为了研究其历史变化趋势及其成因,现以民航客运量作为因变量y,假设以国民收入x1、消费额x2、铁路客运量x3、民航航线里程x4、来华旅游入境人数x5为影响民航客运量的主要因素。
利用SPSS和excel软件通过建立回归模型分析我国民航客运量主要受到其中哪些因素的影响,并就回归模型分析具体可能的成因。
关键词:民航客运量影响因素回归模型一、问题提出及问题分析2004年,民航行业完成运输总周转量230亿吨公里、旅客运输量1.2亿人、货邮运输量273万吨、通用航空作业7.7万小时。
截止2004年底,我国定期航班航线达到1200条,其中国内航线(包括香港、澳门航线)975条,国际航线225条,境内民航定期航班通航机场133个(不含香港、澳门),形成了以北京、上海、广州机场为中心,以省会、旅游城市机场为枢纽,其它城市机场为支干,联结国内127个城市,联结38个国家80个城市的航空运输网络。
民航机队规模不断扩大,截止至2004年底,中国民航拥有运输飞机754架,其中大中型飞机680架,均为世界上最先进的飞机。
2004年中国民航运输总周转量达到230亿吨公里(不包括香港、澳门特别行政区以及台湾省),在国际民航组织188个缔约国中名列第3位。
从上述事实可以看出我国民航的发展所取得的成果显著。
当前我国民航客运量相当巨大,而影响我国航运客运量的因素有很多,例如第三产业增加值(亿元),城市居民消费水平(绝对元),定期航班航线里程(万千里)等[1]。
重庆大学2013-2014学年(上)数理统计试题及参考答案
重庆大学全日制学术型硕士研究生 《数理统计》(A )课程试卷2013-2014学年第一学期(秋)请保留四位小数,部分下侧分位数为:0.95 1.65u =,0.99 2.33u =,20.95(1) 3.841χ=,0.95(3,6)9.78f =一、(18分)设1X ,2X ,…,64X 是来自总体N (0,2σ)的样本,X ,2S 分别是样本均值和样本方差:(1)求参数c 满足{}0.1P X S c >⋅=;(2)求概率22122234{1}X X P X X +>+;(3)求322321(2)i i i D X X X +=⎡⎤+-⎢⎥⎣⎦∑。
(请写出计算过程) 解:(1)~(1)t n-{}}0.1P X S c P c ∴>⋅=>=得0.95(63)c t = 故 1.650.20638c ==(2)2~(0,)X N σ22212(/)(/)~(2)X X σσχ∴+ 同理22234(/)(/)~(2)X X σσχ+2222223412122234(/)(/)(/)(/)/~(2,2)22X X X X X X F X X σσσσ+++∴=+ 22122234{1}{(2,2)1}X X P P F X X +>=>+ 且0.50.50.51(2,2)(2,2)1(2,2)F F F =⇒= 得2222121222223434{1}1{1}0.5X X X X P P X X X X ++>=-≤=++ (3)令2~(2,2)i i n i Y X X N μσ+=+,112n i i Y Y X n ===∑ 221()(1)ni Y i T Y Y n S =∴=-=-∑3232223211(2)[()]i i i i i D X X X DT D Y Y +==⎡⎤+-==-⎢⎥⎣⎦∑∑2~(0,2(11/))i Y Y N n σ-+~(0,1)Y N=3222422421[2(11/)4(11/)((32))256(11/32)i Y D n n D σσχσ=+=+=+∑二、(26分)设1X ,2X ,…,n X 是来自总体2~(2,)(0)X N σσ>的样本,{}0.95P X A <=。
(完整word版)数理统计大作业1
研究生课程考核试卷科目:数理统计教师: 李寒宇姓名: 蔡亚楠学号:20131102015t 专业:高电压与绝缘技术类别:学术型上课时间: 2014年3月至2014年5月考生成绩:卷面成绩平时成绩课程综合成绩阅卷评语:阅卷教师(签名)相对地过电压数据的统计分析摘要:过电压是指超过正常运行电压并可使电力系统绝缘或保护设备损坏的电压升高。
电力系统的过电压分布情况决定了电气设备的绝缘水平。
变电站过电压由于影响因素的随机性,使得过电压数据复杂且具有随机性。
本文结合电气工程专业的背景,分析了相对地过电压数据的分布规律。
首先对三相的过电压数据分别进行双样本同分布检验,采用两总体分布比较的假设检验方法。
检验结果显示三相的样本具有相同的分布规律,因此将三相的过电压数据合并进行总体的分布规律检验。
文中运用拟合优度2 检验法检验总体分布是否福才能够正态分布。
检验结果表明样本总体分布不服从正态分布,而是服从切断正态分布.针对相对地过电压数据的统计分析有助于确定设备的绝缘水平,具有一定的研究价值.关键词:过电压;假设检验;统计分布一、问题提出过电压是指超过正常运行电压并可使电力系统绝缘或保护设备损坏的电压升高。
电力系统的过电压分布情况决定了电气设备的绝缘水平.由于过电压数据出现的随机性较大,且有明显的统计特征,因此在对单次过电压数据进行统计分析的同时,还可以用数理统计的方法对系统采集的多次样本进行统计分析研究,并预测过电压的概率分布规律,以便将所得结论用于确定设备及线路的绝缘水平,合理解决绝缘配合问题,使设备绝缘故障率或停电故障率降低到经济上和安全运行上可以接受的水平.二、数据描述本次研究以TR2000过电压在线监测装置在某变电站实地运行所采集的过电压数据进行分析。
该变电站的等级为110kV/38.5kV/10。
5kV,以往的运行经验发现,35kV侧事故频繁,属第一、二类等级符合用户较集中,故在35kV侧安装了一台TR2000过电压在线监测装置.通过对监测装置中导出的数据进行进制转换、图形显示、统计分析等手段,分析变电战过电压的规律,由此可以对电力系统设计、改造和故障分析等工作提供可靠的依据.根据现场情况,将暂态过电压记录倍率设定为1。