
第12章 列联表和对应分析
第十二章 列联表和对应分析我们前面介绍的相关分析可以用来分析定量变量之间的关系,但不能用于定性变量的分析。
本章介绍的列联表检验和对应分析方法则可以用来分析定性变量之间的关系。
第一节 列联表与独立性检验【例12.1】美国的一般社会调查(General Social Survey )是由美国芝加哥大学的民意调查中心进行的一项随机抽样调查,调查对象为18岁以上的成年人。
调查中获得了居民的婚姻状况和幸福状况方面的数据。
下面我们根据1996年的调查结果来分析两个变量之间的关系(数据文件gss96.sav )。
在调查中,婚姻状况的取值为已婚、丧偶、离异、分居和未婚(分别用1-5表示);幸福状况的取值为:非常幸福、比较幸福和不太幸福(分别用1-3表示)。
在SPSS 软件中打开数据文件,选择“分析”→“描述统计”→“交叉表”,把“婚姻状况”设为行变量,把“幸福状况”设为列变量,可以得到表12-1所示的列联表。
从表中我们可以看出,从婚姻状况看,已婚人员的比重最高;从幸福状况看,比较幸福的人员比重最高。
但从表中我们很难直观地看出两个变量之间的内在联系。
表12-1 婚姻状况和幸福状况列联表幸福状况合计非常幸福 比较幸福 不太幸福婚姻状况 已婚574 726 82 1382 丧偶 70 149 59 278 离异 83 292 79 454 分居 14 73 30 117 未婚136 419 99 654 合计87716593492885要研究二维列联表中的两个变量是否相互独立,可以使用我们在非参数检验中讲过χ2检验。
检验的零假设和备择假设为H 0:婚姻状况和幸福状况这两个变量相互独立;H 1:婚姻状况和幸福状况不相互独立。
假定样本量为n ,列联表有r 行、s 列,表中各行的合计值分别为r i R i ,,2,1,Λ=,各列的合计值分别为s j C j ,2,1,Λ=。
每个单元格中的频数为j i O ,。
在零假设成立,即行变量和列变量相互独立时,每个单元格频数的期望值可以按照式(12-1)计算:nC R n n C n R E j i ji ij ⨯=⨯⨯= (12-1) 显然,如果期望频数ij E 和观测频数ij O 相差不大,则零假设可能是正确的;如果二者差别很大,则零假设可能不成立。
按照式(12-2)构造检验统计量:∑∑==-=r i sj ijij ij E E O 1122)(χ (12-2)在零假设成立时,该统计量近似服从自由度为)1)(1(--s r 的χ2分布。
当该统计量的值很大(或p 值很小)时,就可以拒绝零假设,认为这两个变量不相互独立。
下面我们用SPSS 软件来检验婚姻状况与幸福状况的独立性。
首先重复绘制列联表的步骤,在SPSS 软件中打开数据文件,选择“分析”→“描述统计”→“交叉表”,把“婚姻状况”设为行变量,把“幸福状况”设为列变量。
接下来单击“统计量”,在弹出的对话框中选中“卡方”,单击“继续”;选择“单元格”,选中弹出对话框中的“期望值”,单击“继续”返回前一个是对话框,单击“确定”(相关操作参见图12-1)。
输出结果见表12-2、表12-3。
表12-2列出了婚姻状况和幸福状况列联表中各单元格的实际值和期望值。
从表中可以看出,部分单元格的实际值和期望值差异较大。
从表12-3的第一行可以看出,在这个例子中χ2统计量的值为225.274,相应的p 值为0.000。
由于p 值远远小于通常使用的显著性水平,因此检验的结论是拒绝原假设,不能认为婚姻状况和幸福状况相互独立。
图12-1 SPSS 列联表检验的相关操作当每个单元格的期望频数都大于5时检验统计量近似服从χ2分布。
在不满足这一条件时,需要把部分单元格合并,或者使用精确检验:在图12-1的对话框中选择“精确…”,进行相应的设置后可以得出精确检验的结果。
在精确检验中所涉及的不是χ2分布,而是超几何分布。
由于样本很大时超几何分布计算比较慢甚至无法计算,因此在大样本时通常使用χ2统计量。
表12-2 婚姻状况和幸福状况列联表中各单元格的实际值和期望值幸福状况合计非常幸福 比较幸福 不太幸福婚姻状况 已婚 计数574 726 82 1382 期望的计数420.1794.7167.21382.0表12-3 婚姻状况和幸福状况间独立性的 2检验结果值df 渐进Sig. (双侧)Pearson 卡方225.274a8 .000似然比230.166 8 .000线性和线性组合137.494 1 .000有效案例中的N 2885a. 0单元格(.0%)的期望计数少于5。
最小期望计数为14.15。
第二节对应分析一、对应分析的基本思想对应分析是一种描述性、探索性的数据分析方法,通常用于列联表的分析,以便用图形的方法观察行变量和列变量取值之间的对应关系。
与因子分析类似,对应分析也是一种数据降维技术。
在因子分析中我们可以对变量进行降维,根据因子分析的结果分析各个变量之间的接近程度,也可以对样品(观测)进行降维,根据因子分析的结果分析样品之间的接近程度。
而对应分析则可以按照相同的刻度同时对列联表中的行变量和列变量进行降维,用较少的维度(一般选用二维或三维)来代表数据表中的行变量和列变量,从而在同一个空间中用图形方法显示行变量和列变量类别之间的关系。
在表12-1的列联表中,把3个幸福状况的取值看作3维空间中的坐标,我们可以把5个幸福状况在3维空间中表示出来。
如果使用因子分析的方法对3个幸福状况进行降维(同时最大限度地保留原始信息),则我们能够在2维甚至1维空间上把5个点表示出来。
类似的,把表中婚姻状况的取值看作5维空间的坐标值,使用因子分析的方法进行降维,也可以把3个幸福状况在低维空间中表示出来。
这样,如果能够保证两个因子分析中采用相同的刻度,则可以在同一个坐标系中把幸福状况的3个点和婚姻状况的5个点绘制出来,通过图形观察两个变量取值之间的关系。
按上述方法得到的图形称为对应分析图。
在对应分析图中,如果同一变量的不同类别在某个方向上靠得较近,则说明这些类别在该维度上区别不大;落在图形中大致相同区域的不同变量的分类点彼此之间有联系。
当然,为了保证对行和列进行因子分析的结果之间的对应关系,在进行对应分析时并不是根据列联表中的频数直接进行因子分析的,而是先计算相应的频率,再进行必要的变量变换,之后再用与因子分析类似的方法进行降维。
二、对应分析的软件操作和结果的解释下面我们通过一个例子说明对应分析的软件操作和结果的解释。
【例12-2】根据美国的一般社会调查(General Social Survey)1996年的调查结果分析婚姻状况和幸福状况列两个变量之间的对应关系(数据文件gss96.sav)。
在SPSS软件中打开数据文件,选择“分析”→“降维”→“对应分析”,把“婚姻状况”设为行变量;在弹出的对话框中单击“定义范围”,最小值设为1,最大值设为5,单击“更新”、“继续”;然后把“幸福状况”设为列变量,再通过“定义范围”对话框定义其取值范围为1-3;最后单击“确定”,就可以得到相关输出结果了(相关软件操作参见图12-2)。
图12-2 SPSS对应分析的相关操作表12-4是SPSS对应分析的摘要表。
在表12-4中,“惯量”类似于因子分析中特征值对应的方差;“惯量比例”一栏中,“解释”的惯量比例类似于因子分析中的方差贡献率,“累积”的惯量比例类似于因子分析中的累积方差贡献率,这几个指标反映了每个维度的因子重要性和解释能力。
表中的“卡方”是关于列联表行列独立性检验的 2统计量的值,和前面表中的相同。
其后面的Sig为在行列独立的零假设下的p值,注释表明统计量对应的自由度为(5-1)×(3-1)=8。
p值很小说明列联表的行与列之间有较强的相关性。
表12-4 对应分析的摘要表维数惯量比例置信奇异值相关奇异值惯量卡方Sig. 解释累积标准差 21 .272 .074 .944 .944 .017 .0642 .066 .004 .056 1.000 .021总计.078 225.274 .000a 1.000 1.000a. 8 自由度在SPSS的输出中还有12-5和12-6两个表。
这两个表分别给出了绘制对应分析图所需要的两套坐标。
表12-5中的“质量”对应的英文为“Mass”,译为“密度”更为确切,反映的是每种婚姻状况的人数比例。
表中给出了婚姻状况5个水平的坐标:已婚(-0.531, -0.016),丧偶(0.437, -0.660),离异(0.535, 0.168),丧偶(0.041, 0.979),未婚(0.389, 0.257)。
表12-6给出了幸福状况三个水平的坐标:非常幸福(-0.684, -0.193),比较幸福(0.157, 0.207),不太幸福(0.975, -0.498)。
表12-6 列变量(幸福状况)的坐标根据表12-5、12-6可以得到图12-3所示的对应分析图。
这个图是在SPSS默认输出结果的基础上进行编辑得到的。
从图中我们可以很直观地看出“婚姻状况”和“幸福状况”取值之间的对应关系:“已婚”和“非常幸福”最接近;“离异”、“未婚”和“比较幸福”比较接近;而“丧偶”、“分居”和“不太幸福”比较接近。
两个变量取值之间的这种对应关系是单独用 2检验所无法看出的。
当然,如前所述,对应分析是一种探索性的描述统计方法,并不能保证所有的对应分析结果中两个变量的取值之间都有如此明确的对应关系。
图12-3 对于婚姻状况和幸福状况关系的对应分析图小结本章首先介绍了列联表中两个定性变量独立性的检验方法(χ2检验),然后介绍了对应分析方法。
对应分析方法可以让我们通过图形直观地观察两个定性变量取值之间的对应关系。
在基于列联表的独立性检验中,如果行变量和列变量相互独立,则每个单元格中观测到的频数与其期望频数应该比较接近。
如果二者之间悬殊较大,则说明零假设是不成立的。
基于这种思想可以构造χ2检验统计量进行相应的假设检验。
对应分析是一种描述性、探索性的数据分析方法,通常用于列联表的分析,以便用图形的方法观察行变量和列变量取值之间的对应关系。
与因子分析类似,对应分析也是一种数据降维技术。
对应分析则可以按照相同的刻度同时对列联表中的行变量和列变量进行降维,用较少的维度(一般选用二维或三维)来代表数据表中的行变量和列变量,从而在同一个空间中用图形方法显示行变量和列变量类别之间的关系。
思考与练习1. 表12-7的数据是592个人头发和眼睛颜色的列联表,请检验着两个变量是否相互独立。
提示:在SPSS软件中录入数据时,数据文件中应该有三个变量:头发颜色、眼睛颜色和频数,并在SPSS中选择“数据” “加权个案”,把“频数”变量指定为权数;合计值不需要录入到数据表中。
社会统计学第十二章 相关与回归分析

2. 相关方向:正相关和负相关 所谓正相关关系是指一个变量的值增加时,另一变
量的值也增加。例如,受教育水平越高找到高薪水工作的 机会也越大。而负相关关系是指一个变量的值增加时,另 一变量的值却减少。例如,受教育水平越高,理想子女数 目越少。要强调的是,只有定序以上测量层次的变量才分 析相关方向,因为只有这些变量的值有高低或多少之分。 至于定类变量,由于变量的值并无大小、高低之分,故定 类变量与其他变量相关时就没有正负方向了。
父母智力 组合
优+优
优+劣 一般+一般
劣+劣
子女智力 子女智力
优秀
一般
71.6 25.4
33.6 42.7
18.6 66.9
5.4 34.4
子女智力 低下
3.0 23.7 14.5 60.2
通过列联表研究定类变量之间的关联性,这 实际上是通过相对频数条件分布的比较进行的。 如果对不同的X,Y的相对频数条件分布不同,且 和Y的相对频数边际分布不同,则两变量之间是 相关的。而如果变量间是相互独立的话,必然存 在着Y的相对频数条件分布相同,且和它的相对 频数边际分布相同。后者用数学式表示就是
r×c相对频数联合分布列联表
控制X,Y相对频数条件分布列联表
控制Y,X相对频数条件分布列联表
[例A1]试把下表所示的频数分布列联表,转 化为自变量受到控制的相对频数条件分布列联 表,并加以相关分析。
投票行为
受教育程度X
Y
大学以 大学以
FY
上
下
投票
160
129
289
弃权
7
61
68
合计:FX 167
r×c相对频数分布列联表的一般形式
在相对频数分布列联表中,各数据为各分类
12第一部分 板块二 专题四 概率与统计 第1讲 概率与统计(小题)
第1讲概率与统计(小题)热点一随机抽样1.随机抽样的各种方法中,每个个体被抽到的概率都是相等的.2.系统抽样又称“等距”抽样,被抽到的各个号码间隔相同.3.分层抽样满足:各层抽取的比例都等于样本容量在总体容量中的比例.例1(1)(2019·汉中联考)某机构对青年观众是否喜欢跨年晚会进行了调查,人数如下表所示:不喜欢喜欢男性青年观众3010女性青年观众3050现要在所有参与调查的人中用分层抽样的方法抽取n人做进一步的调研,若在“不喜欢的男性青年观众”的人中抽取了6人,则n等于()A.12 B.16 C.20 D.24(2)(2019·上饶联考)某校高三科创班共48人,班主任为了解学生高考前的心理状况,将学生按1至48的学号用系统抽样方法抽取8人进行调查,若抽到的最大学号为48,则抽到的最小学号为________.跟踪演练1(1)(2019·漳州质检)某工厂利用随机数表对生产的600个零件进行抽样测试,先将600个零件进行编号,编号分别为001,002,…,599,600从中抽取60个样本,如下提供随机数表的第4行到第6行:32 21 18 34 29 78 64 54 07 32 52 42 06 44 38 12 23 43 56 77 35 78 90 56 4284 42 12 53 31 34 57 86 07 36 25 30 07 32 86 23 45 78 89 07 23 68 96 08 0432 56 78 08 43 67 89 53 55 77 34 89 94 83 75 22 53 55 78 32 45 77 89 23 45若从表中第6行第6列开始向右依次读取3个数据,则得到的第6个样本编号为()A .522B .324C .535D .578(2)(2019·合肥质检)某工厂生产的A ,B ,C 三种不同型号的产品数量之比为2∶3∶5,为研究这三种产品的质量,现用分层抽样的方法从该工厂生产的A ,B ,C 三种产品中抽出样本容量为n 的样本,若样本中A 型产品有10件,则n 的值为( ) A .15 B .25 C .50 D .60 热点二 用样本估计总体1.频率分布直方图中横坐标表示组距,纵坐标表示频率组距,频率=组距×频率组距.2.频率分布直方图中各小长方形的面积之和为1. 3.利用频率分布直方图求众数、中位数与平均数 频率分布直方图中:(1)最高的小长方形底边中点的横坐标即众数. (2)中位数左边和右边的小长方形的面积和相等.(3)平均数是频率分布直方图的“重心”,等于频率分布直方图中每个小长方形的面积乘以小长方形底边中点的横坐标之和.4.对于其他的统计图表,要注意结合问题背景分析其所表达的意思,进而解决所给问题. 例2 (1)(2019·厦门质检)下图是某公司2018年1月至12月空调销售任务及完成情况的气泡图,气泡的大小表示完成率的高低,如10月份销售任务是400台,完成率为90%,则下列叙述不正确的是( )A .2018年3月的销售任务是400台B .2018年月销售任务的平均值不超过600台C .2018年第一季度总销售量为830台D .2018年月销售量最大的是6月份(2)(2019·临沂质检)已知8位学生的某次数学测试成绩的茎叶图如图,则下列说法正确的是( )A .众数为7B .极差为19C.中位数为64.5 D.平均数为64跟踪演练2(1)已知某高中的一次测验中,甲、乙两个班级的九科平均分的雷达图如图所示,下列判断错误的是()A.乙班的理科综合成绩强于甲班B.甲班的文科综合成绩强于乙班C.两班的英语平均分分差最大D.两班的语文平均分分差最小(2)(2019·黄冈模拟)学校为了了解新课程标准提升阅读要求对学生阅读兴趣的影响情况,随机抽取了100名学生进行调查.根据调查结果绘制学生周末阅读时间的频率分布直方图如图所示:将阅读时间不低于30分钟的学生称为“阅读霸”,则下列命题正确的是()A.抽样表明,该校约有一半学生为阅读霸B.该校只有50名学生不喜欢阅读C.该校只有50名学生喜欢阅读D.抽样表明,该校有50名学生为阅读霸热点三变量间的相关关系、统计案例高考中解决变量间的相关关系问题时需注意:(1)回归直线一定过样本点的中心(x,y).(2)随机变量K2的观测值k越大,说明“两个变量有关系”的可能性越大.例3(1)(2019·皖江联考)某单位为了了解用电量y(度)与气温x(℃)之间的关系,随机统计了某4天的用电量与当天气温,并制作了对照表:气温x (℃) 18 13 10 -1 用电量y (度)24343864由表中数据得线性回归方程y ^=b ^x +a ^中b ^=-2,预测当温度为-5 ℃时,用电量的度数约为( )A .64B .66C .68D .70(2)某研究型学习小组调查研究学生使用智能手机对学习的影响,部分统计数据如下表:使用智能手机不使用智能手机总计 学习成绩优秀 4 8 12 学习成绩不优秀16 2 18 总计201030附表:P (K 2≥k 0)0.15 0.10 0.05 0.025 0.010 0.005 0.001 k 02.0722.7063.8415.0246.6357.87910.828经计算K 2的观测值k =10,则下列选项正确的是( ) A .有99.5%的把握认为使用智能手机对学习有影响 B .有99.5%的把握认为使用智能手机对学习无影响 C .有99.9%的把握认为使用智能手机对学习有影响 D .有99.9%的把握认为使用智能手机对学习无影响跟踪演练3 (1)(2019·长春质检)某运动制衣品牌为了成衣尺寸更精准,现选择15名志愿者,对其身高和臂展进行测量(单位:厘米),上图为选取的15名志愿者身高与臂展的折线图,下图为身高与臂展所对应的散点图,并求得其回归方程为y ^=1.16x -30.75,以下结论中不正确的为( )A .15名志愿者身高的极差小于臂展的极差B .15名志愿者身高和臂展成正相关关系C .可估计身高为190厘米的人臂展大约为189.65厘米D .身高相差10厘米的两人臂展都相差11.6厘米(2)(2019·泸州模拟)随着国家二胎政策的全面放开,为了调查一线城市和非一线城市的二胎生育意愿,某机构用简单随机抽样方法从不同地区调查了100位育龄妇女,结果如下表.非一线城市一线城市 总计 愿生 45 20 65 不愿生 13 22 35 总计5842100附表:P (K 2≥k 0)0.100 0.050 0.010 0.001 k 02.7063.8416.63510.828由K 2=n (ad -bc )2(a +b )(c +d )(a +c )(b +d )计算得,K 2的观测值k =100×(45×22-20×13)258×42×35×65≈9.616,参照附表,得到的正确结论是( )A .在犯错误的概率不超过0.1%的前提下,认为“生育意愿与城市级别有关”B .在犯错误的概率不超过0.1%的前提下,认为“生育意愿与城市级别无关”C .有99%以上的把握认为“生育意愿与城市级别有关”D .有99%以上的把握认为“生育意愿与城市级别无关”真题体验1.(2019·全国Ⅰ,文,6)某学校为了解1 000名新生的身体素质,将这些学生编号为1,2,…,1 000,从这些新生中用系统抽样方法等距抽取100名学生进行体质测验.若46号学生被抽到,则下面4名学生中被抽到的是()A.8号学生B.200号学生C.616号学生D.815号学生2.(2018·全国Ⅰ,文,3)某地区经过一年的新农村建设,农村的经济收入增加了一倍,实现翻番.为更好地了解该地区农村的经济收入变化情况,统计了该地区新农村建设前后农村的经济收入构成比例,得到如下饼图:则下面结论中不正确的是()A.新农村建设后,种植收入减少B.新农村建设后,其他收入增加了一倍以上C.新农村建设后,养殖收入增加了一倍D.新农村建设后,养殖收入与第三产业收入的总和超过了经济收入的一半3.(2018·全国Ⅲ,文,14)某公司有大量客户,且不同年龄段客户对其服务的评价有较大差异.为了解客户的评价,该公司准备进行抽样调查,可供选择的抽样方法有简单随机抽样、分层抽样和系统抽样,则最合适的抽样方法是________.押题预测1.某市气象部门根据2018年各月的每天最高气温平均值与最低气温平均值(单位:℃)数据,绘制如下折线图:那么,下列叙述错误的是( )A .各月最高气温平均值与最低气温平均值总体呈正相关B .全年中,2月份的最高气温平均值与最低气温平均值的差值最大C .全年中各月最低气温平均值不高于10 ℃的月份有5个D .从2018年7月至12月该市每天最高气温平均值与最低气温平均值都呈下降趋势 2.给出如下列联表患心脏病 患其他病 总 计 高血压 20 10 30 非高血压 30 50 80 总 计5060110P (K 2≥10.828)≈0.001,P (K 2≥6.635)≈0.010,参照公式k =n (ad -bc )2(a +b )(c +d )(a +c )(b +d ),得到的正确结论是( )A .有99%以上的把握认为“高血压与患心脏病无关”B .有99%以上的把握认为“高血压与患心脏病有关”C .在犯错误的概率不超过0.1%的前提下,认为“高血压与患心脏病无关”D .在犯错误的概率不超过0.1%的前提下,认为“高血压与患心脏病有关” 3.某设备的使用年数x 与所支出的维修总费用y 的统计数据如下表:使用年数x (单位:年) 2 3 4 5 6 维修总费用y (单位:万元)1.54.55.56.57.5根据上表可得线性回归方程为y ^=1.4x +a ^.若该设备维修总费用超过12万元就报废,据此模型预测该设备最多可使用________年.A 组 专题通关1.(2019·河北省五个一名校联盟联考)经调查,某市骑行共享单车的老年人、中年人、青年人的比例为1∶3∶6,用分层抽样的方法抽取了一个容量为n 的样本进行调查,其中中年人数为12人,则n 等于( ) A .30 B .40 C .60D .802.某校李老师本学期负责高一甲、乙两个班的数学课,两个班都是50个学生,如图反映的是两个班的本学期5次数学测试中的班级平均分对比情况,根据图中信息,下列结论不正确的是( )A .甲班的数学平均成绩高于乙班B .乙班的数学成绩没有甲班稳定C .下次测试乙班的数学平均分高于甲班D .在第1次测试中,甲、乙两个班总平均分为783.(2019·全国Ⅲ)《西游记》《三国演义》《水浒传》和《红楼梦》是中国古典文学瑰宝,并称为中国古典小说四大名著.某中学为了解本校学生阅读四大名著的情况,随机调查了100位学生,其中阅读过《西游记》或《红楼梦》的学生共有90位,阅读过《红楼梦》的学生共有80位,阅读过《西游记》且阅读过《红楼梦》的学生共有60位,则该校阅读过《西游记》的学生人数与该校学生总数比值的估计值为( ) A .0.5 B .0.6 C .0.7 D .0.84.某学校为落实学生掌握社会主义核心价值观的情况,用系统抽样的方法从全校2 400名学生中抽取30人进行调查.现将2 400名学生随机地从1~2 400编号,按编号顺序平均分成30组(1~80号,81~160号,…,2 321~2 400号),若第3组与第4组抽出的号码之和为432,则第6组抽到的号码是( ) A .416 B .432 C .448 D .4645.(2019·郑州质检)若1,2,3,4,m (m ∈R )这五个数的平均数等于其中位数,则m 等于( ) A .0或5 B .0或52 C .5或52 D .0或5或526.(2019·长春质检)下列命题:①在线性回归模型中,相关指数R 2表示解释变量x 对于预报变量y 的贡献率,R 2越接近于1,表示回归效果越好;②两个变量相关性越强,则相关系数的绝对值就越接近于1;③在线性回归方程y ^=-0.5x +2中,当解释变量x 每增加一个单位时,预报变量y ^平均减少0.5个单位;④对分类变量X 与Y ,它们的随机变量K 2的观测值k 来说,k 越小,“X 与Y 有关系”的把握程度越大.其中正确命题的个数是( ) A .1 B .2 C .3 D .47.(2019·衡水质检)某校进行了一次创新作文大赛,共有100名同学参赛,经过评判,这100名参赛者的得分都在[40,90]之间,其得分的频率分布直方图如图所示,则下列结论错误的是( )A .得分在[40,60)之间的共有40人B .从这100名参赛者中随机选取1人,其得分在[60,80)的概率为0.5C .估计得分的众数为55D .这100名参赛者得分的中位数为658.(2019·济宁模拟)如图为某市国庆节7天假期的楼房认购量与成交量的折线图,小明同学根据折线图对这7天的认购量(单位:套)与成交量(单位:套)作出如下判断:①日成交量的中位数是16;②日成交量超过日平均成交量的有2天;③认购量与日期正相关;④10月7日认购量的增幅大于10月7日成交量的增幅.则上述判断正确的个数为( )A .0B .1C .2D .39.(2019·广东天河区普通高中测试)为保证树苗的质量,林业管理部门在每年3月12日植树节前都对树苗进行检测,现从甲、乙两种树苗中各抽测了10株树苗的高度(单位:cm),其茎叶图如图所示,则下列描述正确的是( )A .甲种树苗的平均高度大于乙种树苗的平均高度,甲种树苗比乙种树苗长得整齐B .甲种树苗的平均高度大于乙种树苗的平均高度,乙种树苗比甲种树苗长得整齐C .乙种树苗的平均高度大于甲种树苗的平均高度,乙种树苗比甲种树苗长得整齐D .乙种树苗的平均高度大于甲种树苗的平均高度,甲种树苗比乙种树苗长得整齐10.利用独立性检验的方法调查大学生的性别与爱好某项运动是否有关,通过随机询问110名不同的大学生是否爱好该项运动,得出2×2列联表,由计算可得K 2≈8.806.P (K 2≥k 0)0.10 0.05 0.025 0.010 0.005 0.001 k 02.7063.8415.0246.6357.87910.828参照附表,得到的正确结论是( )A .有99.5%以上的把握认为“爱好该项运动与性别无关”B .有99.5%以上的把握认为“爱好该项运动与性别有关”C .在犯错误的概率不超过0.05%的前提下,认为“爱好该项运动与性别有关”D .在犯错误的概率不超过0.05%的前提下,认为“爱好该项运动与性别无关”11.已知变量x ,y 之间的线性回归方程为y ^=-0.7x +10.3,且变量x ,y 之间的一组数据如下表所示,则下列说法中错误的是( )x 6 8 10 12 y6m32A.变量x ,y 之间呈现负相关关系 B .可以预测当x =20时,y ^=-3.7 C .m =4D .由表格数据知,该回归直线必过点(9,4)12.(2019·江淮质检)为了了解户籍、性别对生育二胎选择倾向的影响,某地从育龄人群中随机抽取了容量为100的调查样本,其中城镇户籍与农村户籍各50人;男性60人,女性40人,绘制不同群体中倾向选择生育二胎与倾向选择不生育二胎的人数比例图(如图所示),其中阴影部分表示倾向选择生育二胎的对应比例,则下列叙述中错误的是( )A .是否倾向选择生育二胎与户籍有关B .是否倾向选择生育二胎与性别有关C .倾向选择生育二胎的人员中,男性人数与女性人数相同D .倾向选择不生育二胎的人员中,农村户籍人数少于城镇户籍人数13.(2019·河南省九师联盟质检)为了了解世界各国的早餐饮食习惯,现从由中国人、美国人、英国人组成的总体中用分层抽样的方法抽取一个容量为m 的样本进行分析.若总体中的中国人有400人、美国人有300人、英国人有300人,且所抽取的样本中,中国人比美国人多10人,则样本容量m =________.14.某班40名学生参加普法知识竞赛,成绩都在区间[40,100]内,其频率分布直方图如图所示,则成绩不低于60分的人数为________.15.(2019·成都模拟)节能降耗是企业的生存之本,树立一种“点点滴滴降成本,分分秒秒增效益”的节能意识,以最好的管理,来实现节能效益的最大化.为此某国企进行节能降耗技术改造,下面是该国企节能降耗技术改造后连续五年的生产利润:年号1 2 3 4 5 年生产利润y (单位:千万元)0.70.811.11.4预测第8年该国企的生产利润约为________千万元.参考公式及数据:b ^=∑i =1n(x i -x )(y i -y )∑i =1n(x i -x )2=∑i =1nx i y i -n x y∑i =1nx 2i -n x2;a ^=y -b ^x ,∑i =15(x i -x )(y i-y )=1.7, i =15(x i -x )2=10.根据该折线图,下列结论正确的是________(填序号). ①月接待游客量逐月增加;②年接待游客量逐年增加; ③各年的月接待游客量髙峰期大致在7,8月份;④各年1月至6月的月接待游客量相对7月至12月,波动性更小,变化比较平稳.B 组 能力提高17.(2019·葫芦岛模拟)近日,据媒体报道称,“杂交水稻之父”袁隆平及其团队培育的超级杂交稻品种“湘两优900(超优千号)”再创亩产世界纪录,经第三方专家测产,该品种的水稻在实验田内亩产1 203.36公斤.中国工程院院士袁隆平在1973年率领科研团队开启了杂交水稻王国的大门,在数年的时间内就解决了十多亿人的吃饭问题,有力回答了世界“谁来养活中国”的疑问.2012年,在袁隆平的实验田内种植了A ,B 两个品种的水稻,为了筛选出更优的品种,在A ,B 两个品种的实验田中分别抽取7块实验田,如图所示的茎叶图记录了这14块实验田的亩产量(单位:10 kg),通过茎叶图比较两个品种的平均数及方差,并从中挑选一个品种进行以后的推广,有如下结论:①A 品种水稻的平均产量高于B 品种水稻,推广A 品种水稻;②B 品种水稻的平均产量高于A 品种水稻,推广B 品种水稻;③A 品种水稻的产量比B 品种水稻更稳定,推广A 品种水稻;④B 品种水稻的产量比A 品种水稻更稳定,推广B 品种水稻;其中正确结论的编号为( )A .①②B .①③C .②④D .①④18.(2019·南昌模拟)已知具有线性相关的五个样本点A 1(0,0),A 2(2,2),A 3(3,2),A 4(4,2),A 5(6,4),用最小二乘法得到回归直线l 1:y ^=b ^x +a ^,过点A 1,A 2的直线l 2:y =mx +n ,那么下列说法中,正确的有________.(填序号) ①m >b ^,a ^>n ; ②直线l 1过点A 3;③∑i =15(y i -b ^x i -a ^)2≥∑i =15 (y i -mx i -n )2; ④∑i =15|y i -b ^x i -a ^|≥∑i =15|y i -mx i -n |.⎝ ⎛⎭⎪⎪⎫参考公式:b ^=∑i =1nx i y i-n x y ∑i =1nx 2i-n x 2= ∑i =1n(x i-x )(y i-y )∑i =1n(x i-x )2,a ^=y -b ^x。
对应分析

p12 / p1. p22 / p2. p n 2 / pn .
p1 p / p1. p 2 p / p 2. pnp / pn.
pij n pij E ( ) = ∑ . pi. = p. j , j = 1,2,, p pi. i =1 pi.
因为原始变量的数量等级可能不同,所以为了尽 量减少各变量尺度差异,将行轮廓中的(各列元素) 均除以其期望的平方根.得矩阵D(R)
32 6
15 1
62 8
11 1
40 8
58 6
35 10
58 67
21 23
70 95
17 25
70 71
62 89
83 91
American European Japanese Large Medium Small Family Sporty Work 1 Income 2 Incomes Own Rent Married Married with Kids Single
变量的叉积矩阵
∑ R = (X* )′X* ( p × p)
样品的叉积矩阵
∑ Q = X* ( X* )′ ( n × n)
显而易见,变量和样品的叉积矩阵的阶数不同,一般来说, 显而易见,变量和样品的叉积矩阵的阶数不同,一般来说, 他们的非零特征根也不一样,那么能否将观测值做变换. 他们的非零特征根也不一样,那么能否将观测值做变换.
含义 雪糕 纯水 碳酸饮料 果汁饮料 保健食品 空调 洗衣机 毛毯
代码 Feel1 Feel2 Feel3 Feel4 Feel5 Feel6 Feel7 Feel8
含义 清爽 甘甜 欢快 纯净 安闲 个性 兴奋 高档
name1
product1 product2 product3 product4 product5 product6 product7 product8 feel1 feel2 feel3 feel4 feel5 feel6 feel7 feel8 50 508 55 109 34 11 30 2 368 217 19 142 16 2 4 3
多元统计分析-对应分析
03
列联表检验的零假设是两变量 X和Y 相互独立,计算一个卡方统计量,与列联表中频数取值 和零假设下期望取值之差有关,当卡方 很大时否定零假设。
BA
患慢性支 未患慢性 气管炎 支气管炎
吸烟
43
162
不吸烟
13
121
为了探讨吸烟与慢性支气管炎有无关系, 调查了339人,情况如表所示:
设想有两个随机变量A,B:A:1表示吸 烟,
对应分析
对应分析基本步骤: 建立列联表
利用对应图解释结 果。
1
2
3
一.获取对应分析 数据 确定研究目的, 选择对应分析 所需数据,应 该包括的背景 资料。
对应分析
4
5
二、对应分析 的原理
01
由于R型因子分析和 02
设原始数据矩阵为:
Q型因子分析是反映
一个整体的不同侧面,
R型因子分析是从列
来讨论(对变量),
k
特征根。
Zu k
设 1 2…
三、对应图u 1u 11u 21 A和l(0Bu <的p 1 i<非m零in特(n征,p根)),为其矩相阵应 u 2u 12u 22 的特征u p 向2量为
v 1 v 1 1v 2 1 v n 1 v 2 v 1 2 v 2 2 v n 2
我们知道因子载荷矩阵的含义是原始变量与公共因子之间的 相关系数,所以如果我们构造一个平面直角坐标系,将第一 公共因子的载荷与第二个公共因子的载荷看成平面上的点, 在坐标系中绘制散点图,则构成对应图。
Q型因子分析是从行
来讨论(对样品),
因此 在的
他们之
联 x系1。1
间
存在
x12
内
对应分析方法与对应图解读方法
对应分析方法与对应图解读方法——七种分析角度对应分析是一种多元统计分析技术,主要分析定性数据Category Data方法,也是强有力的数据图示化技术,当然也是强有力的市场研究分析技术。
这里主要介绍大家了解对应分析的基本方法,如何帮助探索数据,分析列联表和卡方的独立性检验,如何解释对应图,当然大家也可以看到如何用SPSS操作对应分析和对数据格式的要求!对应分析是一种数据分析技术,它能够帮助我们研究由定性变量构成的交互汇总表来揭示变量间的联系。
交互表的信息以图形的方式展示。
主要适用于有多个类别的定类变量,可以揭示同一个变量的各个类别之间的差异,以及不同变量各个类别之间的对应关系。
适用于两个或多个定类变量。
主要应用领域:概念发展(Concept Development)新产品开发 (New Product Development)市场细分 (Market Segmentation)竞争分析 (Competitive Analysis)广告研究 (Advertisement Research)主要回答以下问题:谁是我的用户?还有谁是我的用户?谁是我竞争对手的用户?相对于我的竞争对手的产品,我的产品的定位如何?与竞争对手有何差异?我还应该开发哪些新产品?对于我的新产品,我应该将目标指向哪些消费者?数据的格式要求对应分析数据的典型格式是列联表或交叉频数表。
常表示不同背景的消费者对若干产品或产品的属性的选择频率。
背景变量或属性变量可以并列使用或单独使用。
两个变量间——简单对应分析。
多个变量间——多元对应分析。
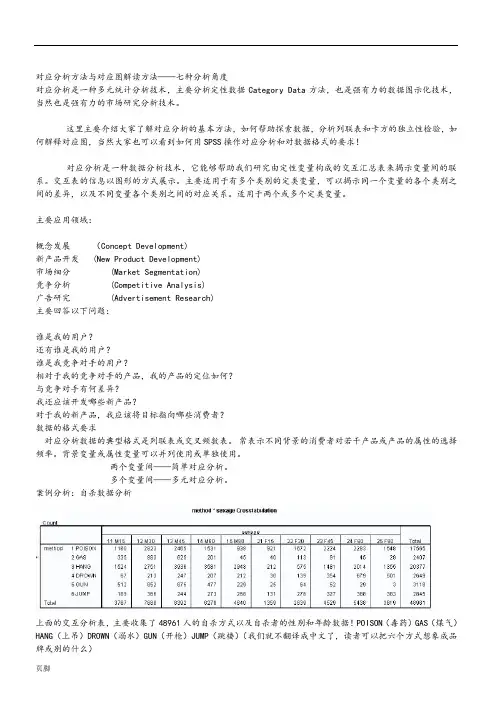
案例分析:自杀数据分析上面的交互分析表,主要收集了48961人的自杀方式以及自杀者的性别和年龄数据!POISON(毒药)GAS(煤气)HANG(上吊)DROWN(溺水)GUN(开枪)JUMP(跳楼)(我们就不翻译成中文了,读者可以把六个方式想象成品牌或别的什么)当然,我们拿到的最初原始数据可能是SPSS数据格式记录表,其中,性别取值1-male 2-female,年龄取值1-5,分别表示不同年龄段。
对应分析与典型相关分析

17
对应分析基本思想
v λ ... v λ 1m m 11 1 O M = ( λ1 v1 ,..., λm vm ), AR = M v λ L v p1 1 pm λm
u11 λ1 ... u1m λm AQ = M O M = ( λ1 u1,..., λm um ), un1 λ1 L unm λm
由于SR和 具有相同的非零特征值 具有相同的非零特征值, 由于 和SQ具有相同的非零特征值,而这些特征值又正好是各个 公共因子的方差,因此可以用相同的因子轴 相同的因子轴同时表示变量点和样品 公共因子的方差,因此可以用相同的因子轴同时表示变量点和样品 即把变量点和样品点同时反映在具有相同坐标轴的因子平面上, 点,即把变量点和样品点同时反映在具有相同坐标轴的因子平面上, 以便对变量点和样品点一起考虑进行分类。 以便对变量点和样品点一起考虑进行分类。
如果SR的特征值 如果 的特征值 λ i 对应的标准化特征向量为 vi , 则SQ的特征值 λi 对应的标准化特征向量: 的特征值 对应的标准化特征向量: 1 ui = Zv i
λi
由此可以方便地由R型因子分析而得到 型因子分析的结果 由此可以方便地由 型因子分析而得到Q型因子分析的结果。由SR的特征值和 型因子分析而得到 型因子分析的结果。 的特征值和 特征向量即可以写出R型因子分析的因子载荷矩阵 记为AR) 型因子分析的因子载荷矩阵( 特征向量即可以写出 型因子分析的因子载荷矩阵(记为 )和Q型因子分析的 型因子分析的 因子载荷矩阵(记为AQ): 因子载荷矩阵(记为 ):
3
引例1. 引例1.
下表为2006年年底我国 个省市按照行业(这里仅列出12 年年底我国31个省市按照行业 这里仅列出12 下表为 年年底我国 个省市按照行业( 个行业)城镇单位就业人数, 个行业)城镇单位就业人数,在一定程度上可以反映该地 区的经济结构。 区的经济结构。 我国地域辽阔,东西南北发展不平衡,是否按照地域划分 我国地域辽阔,东西南北发展不平衡,是否按照地域划分 就合理了呢? 就合理了呢? 自然地理位置对经济结构的影响固然重要,但是数据分析 自然地理位置对经济结构的影响固然重要,但是数据分析 显然更有说服力。 显然更有说服力。
对应分析
对应分析法一、简介对应分析(Correspondence analysis)也称关联分析、R-Q型因子分析,是近年新发展起来的一种多元相依变量统计分析技术,是一种多元统计分析技术,主要分析定性数据的方法,也是强有力的数据图示化技术。
对应分析是一种数据分析技术,它能够帮助我们研究由定性变量构成的交互汇总表来揭示变量间的联系。
交互表的信息以图形的方式展示。
主要适用于有多个类别的定类变量,可以揭示同一个变量的各个类别之间的差异,以及不同变量各个类别之间的对应关系,适用于两个或多个定类变量。
对应分析是由法国人Benzenci于1970年提出的,起初在法国和日本最为流行,然后引入到美国。
对应分析法是在R型和Q型因子分析的基础上发展起来的一种多元统计分析方法,因此对应分析又称为R-Q型因子分析。
在因子分析中,如果研究的对象是样品,则需采用Q型因子分析;如果研究的对象是变量,则需采用R型因子分析。
但是,这两种分析方法往往是相互对立的,必须分别对样品和变量进行处理。
因此,因子分析对于分析样品的属性和样品之间的内在联系,就比较困难,因为样品的属性是变值,而样品却是固定的。
于是就产生了对应分析法。
对应分析就克服了上述缺点,它综合了R型和Q型因子分析的优点,并将它们统一起来使得由R型的分析结果很容易得到Q型的分析结果,这就克服了Q 型分析计算量大的困难;更重要的是可以把变量和样品的载荷反映在相同的公因子轴上,这样就把变量和样品联系起来便于解释和推断。
对应分析数据的典型格式是列联表或交叉频数表。
常表示不同背景的消费者对若干产品或产品的属性的选择频率。
背景变量或属性变量可以并列使用或单独使用。
两个变量间——简单对应分析;多个变量间——多元对应分析。
对应分析的基本思想是将一个联列表的行和列中各元素的比例结构以点的形式在较低维的空间中表示出来。
它最大特点是能把众多的样品和众多的变量同时作到同一张图解上,将样品的大类及其属性在图上直观而又明了地表示出来,具有直观性。
对应分析 课件讲解
行记分(row score) xi和列记分yj的加权均值成 比例, 而列记分yj和行记分xi的加权均值成比 例. 数值r为行列记分的相关(在典型相关的意 义上).
记R=diag(ai.), C=diag(a.i), R1/2= diag(a.i1/2), 则上面式子为
rx=R-1Ay; ry=C-1A’x 或
例子(数据ChMath.txt )
该数据关于汉字读写能力的变量有三个水 平:
“纯汉字”意味着可以完全自由使用纯汉 字读写,
“半汉字”意味着读写中只有部分汉字 (比如日文),
而“纯英文”意味着只能够读写英文而不 会汉字。而数学成绩有4个水平(A、B、C、 D)。
人们可以对这个列联表进行前面所说的c2检验来考 察行变量和列变量是否独立。结果在下面表中 (通过Analyze-Descriptive Statistics-Crosstabs)
类似地,点击Continue之后,把“数学成绩” 选入Column (列),并以同样方式定义其范围 为1到4。
由于其他选项可以用默认值,就可以直接点击 OK来运行了。这样就得到上述表格和点图。
附录 对应分析的数学
因子分析对变量和对样品要分别对待. 对应分 析把变量和样本同时反映到相同坐标轴(因子 轴)的一张图形上. 数学上, 令A=[aij]为n×p矩阵, x=[xi] 为n-(列) 向量, y=[yj] 为p-(列)向量. 那么(r,x,y)称为对 应分析问题C0(A)的解, 如果
Z’Z的特征根为l1≥l2≥…≥lp; Z’Z相应的特征 向量为u1,u2…,up. ZZ’相应的特征向量为 v1,v2…,vn.对最大的m个特征值得因子载荷阵
u11
l1
F
对应分析
对应分析问题1:分析列联表中属性之间的相关关系。
对应分析是列联表的一类加权主分量分析,用于寻求列联表的行于列之间的低维图形表示法。
看一个例子:我们从生物学中的一个“梯度分析”问题谈起。
设我们需要了解若干地区的干湿度和若干草类的喜湿性。
现对某n个地区是否生长p种不同草类的情况作了调查,得到一个列联表K,希望通过这一调查表对着各个地区的干湿度和各草类的喜湿性作一估计。
设列联表为其中j i j i k ij 不生长草类在地区生长草类在地区⎩⎨⎧=01经典的梯度分析方法是:先对p 种草类喜湿性作出估计p r r r ,,,21 ,然后用加权平均的方法得到关于各个地区干湿度的估计n i k r k s pj i j ij i ,,2,1,1 =∝∑=⋅反之,如果先对各个地区的干湿度作出估计n s s s ,,,21 ,然后用同样的方法得到关于各种草类喜湿性的估计p j k s k r ni j i ij j ,,2,1,1 =∝∑=⋅但是,如何先对草类的喜湿性或先对地区的干湿性进行估计就是一个难题,除非根据其他资料,否则无法仅从这个列联表出发,无论先估计那一个都会带有主观性,这就是经典梯度分析存在的一个问题。
是否有一个办法,从这张列联表出发能客观地同时把两者估计出来?应该是可能的,因为各个地区的干湿度是由各种喜湿性草类是否在该地区生长反映出来,而且草的喜湿性又是通过它在什么样的干湿度的地区生长反应出来,两者相互依赖,应从两者相互依赖中求解出各种量的估计。
为此我们来注意上述两式及它们之间的联系。
先引进一些矩阵的记号:)()(ij p n k K =⨯,{}⋅⋅=n n k k diag D ,,1 ,{}p p k k diag D ⋅⋅=,,1又记向量)',,(1n s s s =,)',,(1p r r r =,则前面的两式可表示为Kr D s n1-∝, s K D r p'1-∝其中∝表示“成比例于”。
对应分析
对应分析对应分析的基本思想对应分析(Correspondence Analysis)又称为相应分析,是由法国统计学家于1970提出的,是在R型和Q型因子分析基础上,发展起来的一种多元相依的变量统计分析技术。
它通过分析由定性变量构成的交互汇总表来揭示变量间的关系。
当以变量的一系列类别以及这些类别的分布图来描述变量之间的联系时,使用这一分析技术可以揭示同一变量的各个类别之间的差异以及不同变量各个类别之间的对应关系。
汇总表中分值,1(点))2.主成分(principal components):通过主成分分析,可以在以两个主成分为坐标的空间中,标出行轮廓或列轮廓,或同时标出行、列轮廓,从而探索它们之间的关系。
这种近似的表示行轮廓和列轮廓的图形叫对应图。
3.惯量(inertials)和特征值(eigenvalues):惯量是度量行轮廓和列轮廓的变差的统计量。
总惯量表示轮廓点的全部变差,作图用的前两个维度分别对应于两个主惯量(principal inertias),表示在坐标方向上的变差;主惯量就是对行轮廓和列轮廓作主成分分析时得到的特征值,特征值的平方根叫奇异值(singular values)。
4.卡方(Chi-square)、似然比卡方(likelihood ratio Chi-square)、曼图—汉斯泽鲁卡方(Mantel-Haenszel Chi-square)、法系数(phi-coefficient)、列联系数(contingency coefficient),这些均是检验对应分析显着性或近似效果的统计量。
实例分析[例11-1]某公司进行一次市场调查,得到轿车特征与一些用户特征的数据。
如有:轿车大小(大、中、小)、轿车类型(家用型、跑车、商用车)、收入(一份收入、双份收入)、状态(已婚、已婚有孩子、未婚、未婚有孩子)、房子(租房、买房)等数据。
现请分析它们之间的联系。
以下是spss11.0作出的对应图:从对应图可以推断出下面一些结论:1.已婚有孩子、家用车和中型车相关性较大。