
SPSS1人口的预测分析
用SPSS软件进行预测该立体城市2023年的人口基数的分析可知,其准确性低,却这能预测未来短时间的人口变化,而不能预测十年后的人口数量,因此我们采用最小二乘法您合并采用MATLAB 软件得出了该立体城市2023年的人口基数为3690万(包括外来人口)GDP达58500亿元;
交叉相关性
序列对:带有 V1 的北京
滞后交叉相关标准误差a
-10 -.239 .707
-9 -.338 .577
-8 -.287 .500
-7 .024 .447
-6 .161 .408
-5 .171 .378
-4 .566 .354
-3 .968 .333
-2 .551 .354
-1 .287 .378
0 .257 .408
1 -.028 .447
2 -.23
3 .500
3 -.253 .577
4 -.307 .707
5 .000 .000
6 .000 .000
7 .000 .000
8 .000 .000
9 .000 .000
10 .000 .000
a. 基于以下假设:序列不具有交叉
相关性,并且其中一个序列是白噪
音。
以下是用MATLAB 做进行运算的程序;
function f=fun1(a,t)
f=exp(a(1)*x+a(2));
t=2004:1:2013;
x=[1356 4095 6060 4283 7720 13698 11865.9 13777.94 17801 19500.6]; plot(t,x,'*',t,x);
a0=[0.001,1];
a=curvefit('fun1',a0,t,x)
ti=1790:5:2020;
xi=fun1(a,ti);
hold on
plot(ti,xi);
t1=2010;
x1=fun1(a,t1)
hold off
图如下;
空气污染指数为0-50,空气质量级别为I 级,空气质量状况属于优。
此时不存在空气污染问题,对公众的健康没有任何危害。
空气污染指数为51-100,空气质量级别为Ⅱ级,空气质量状况属于良。
此时空气质量被认为是可以接受的,除极少数对某种污染物特别敏感的人以外,对公众健康没有危害。
空气污染指数为101-150,空气质量级别为Ⅲ⑴级,空气质量状况属于轻微污染。
此时,对污染物比较敏感的人群,例如儿童和老年人、呼吸道疾病或心脏病患者,以及喜爱户外活动的人,他们的健康状况会受到影响,但对健康人群基本没有影响。
空气污染指数为151-200,空气质量级别为Ⅲ⑵级,空气质量状况属于轻度污染。
此时,几乎每个人的健康都会受到影响,对敏感人群的不利影响尤为明显。
空气污染指数为201-300,空气质量级别为Ⅳ级,空气质量状况属于中度重污染。
此时,每个人的健康都会受到比较严重的影响。
空气污染指数大于300,空气质量级别为V 级,空气质量状况属于重度污染。
此时,所有人的健康都会受到严重影响。
空气污染指数的预测可以在严重的空气污染情况出现前,提醒市民大众,特别是那些对空气污染敏感的人士,如患有心脏病或呼吸系统毛病者,在必要时采取预防措施。
4
观测年份
人口变化
人口增长趋势图
立体城市的土地面积为;16410.5平方公里来自土地的收益为195006亿元。
183305.64
项间相关性矩阵
立体城市车辆的数目4983万辆,道路宽度48米(双向8车道),道路数目468条,信号灯的数量258盏,
二氧化硫浓度(毫克/立方米)当空气污染状况为II级时,二氧化硫的浓度为(0.150mg/m3);氮氧化和物的浓度为(0.120mg/m3);悬浮颗粒物的浓度为(35mg/m3)。
基于SPSS的社会调查数据分析与预测

基于SPSS的社会调查数据分析与预测社会调查是一项非常重要的研究方法,它可以用来了解人们对特定话题的看法、态度、习惯和行为等信息,并通过对这些信息进行分析和解读来提供有益的洞察和预测。
SPSS(统计分析系统)则是一款功能强大的统计分析软件,它被广泛应用于社会科学、商业、教育和公共卫生等领域,被许多研究人员和学生用来进行定量分析和数据可视化。
在本文中,我将探讨如何使用SPSS进行社会调查数据的分析和预测。
一、数据预处理在进行数据分析之前,需要先进行数据预处理,包括数据清洗、变量选择和缺失数据处理等。
数据清洗是指在数据集中删除或修复错误或不完整的数据。
变量选择则是指选择对分析目标最具影响力的变量。
缺失数据处理则是指使用填充值、插值或删除等方法来处理缺失数据。
二、描述性分析描述性分析是指对数据集中每个变量的分布和分散进行描述和汇总。
其中,中心趋势和离散程度是描述一个数据集的重要统计量。
中心趋势包括平均值、中位数和众数等,而离散程度则包括方差、标准偏差和范围等。
此外,还可以计算每个变量的简单频数和百分比来了解每种回答选项的相对比例。
三、相关性分析相关性分析是指检验不同变量之间是否存在相关性的统计方法。
在SPSS中,可以用相关矩阵或散点图来分析两个变量之间的相关性。
此外,还可以通过克拉姆的V系数来衡量两个分类变量之间的关联程度。
四、回归分析回归分析是指通过建立一个线性或非线性模型来预测因变量与自变量之间的关系。
在SPSS中,可以使用多元回归分析来预测因变量的取值,同时考虑多个自变量之间的相互作用和影响。
在回归建模之前,需要对数据进行变换或调整,以使其符合线性回归的前提条件,例如正态分布、同方差性和线性相关性。
五、因子分析因子分析是指对数据集中的多个变量进行分类,以确定哪些变量对同一概念或构念具有类似的影响力。
在SPSS中,可以使用因子分析来缩减变量的数量,同时识别可能存在的潜在因素或维度。
因子分析的结果可以帮助研究人员了解调查数据中存在的复合概念或潜在动机。
spss分析第六次人口普查部分分析

专业:课程: 学号:姓名:成绩:评语:经过一学期的学习,本人对spss的了解由初步到较为深入,这次采用的数据均为第五、六次人口普查的部分数据,由于有的数据不全,有的省份在统计局网站找不到,于是不得不费点劲找缺省的数据,最后又经过筛选、验证环节,保证了数据的可靠真实,光是这几个环节就用去一天。
开始的时候,看到整个数据较为庞大,不知道要做些什么,后来开用一一比较的方法,逐步去发现两两变量间是否有联系,是否可以做模型分析等等。
但是,最终体现出来的数据只用到了第六次普查数据,原本设想的用第五次普查数据与第六次普查数据进行对比,但觉得做出来意义不大或者其他原因,这次就先不做,以后有机会在体现出来。
总的来说,这次的分析能够很好的体现个人的努力与心血,分析结果也比较有价值,共得出了十一个分析结果,分析报告以图文方式构架,直观清晰,当然,由于技术不足,在难度方面并没有做高水平的分析,这是很可惜的,希望日后通过努力可以提高自己的水平,把之前不会做的分析都补上。
最后,要感谢张学军老师一直以来提供的帮助,能够给予较长时间来完成这次的数据分析。
前言 (1)分析报告描述性分析 (3)箱图 (4)列联表分析 (5)配对T检验相关性 (6)单因素方差分析表 (7)相关分析 (9)回归分析 (10)一、描述性分析表分析:从上面的表可以看出,东部人口分布最不均匀,标准差大于其他两个地区,中部是分布最均匀的,西部人口分布居中。
细细分析可知,东部虽然总人口多,但集中于特大城市,造成了人口分布不均的现状。
家庭人口平均的均值数的排序为东部<中部<西部,这可以从经济发达程度来解释,东部经济繁华,人们的思想较为开放,计划生育工作也执行的较好。
东部的GDP总量与其他两个地区高了很多,约是中部的3倍,而西部虽然GDP总量大于中部,但那是因为西部省份多余中部,要是比均值,西部远落后中、东地区。
在人均GDP排名上,可以发现,前10的几乎都是东部的省份,这也印证了东部经济远比中、西部发达,而中部的排名也总体高于西部,所以说,我国人均GDP的分布呈现由东到西递减的趋势。
SPSS1人口的预测分析

用SPSS软件进行预测该立体城市2023年的人口基数的分析可知,其准确性低,却这能预测未来短时间的人口变化,而不能预测十年后的人口数量,因此我们采用最小二乘法您合并采用MATLAB 软件得出了该立体城市2023年的人口基数为3690万(包括外来人口)GDP达58500亿元;交叉相关性序列对:带有 V1 的北京滞后交叉相关标准误差a-10 -.239 .707-9 -.338 .577-8 -.287 .500-7 .024 .447-6 .161 .408-5 .171 .378-4 .566 .354-3 .968 .333-2 .551 .354-1 .287 .3780 .257 .4081 -.028 .4472 -.233 .5003 -.253 .5774 -.307 .7075 .000 .0006 .000 .0007 .000 .0008 .000 .0009 .000 .00010 .000 .000a. 基于以下假设:序列不具有交叉相关性,并且其中一个序列是白噪音。
以下是用MATLAB 做进行运算的程序;function f=fun1(a,t)f=exp(a(1)*x+a(2));t=2004:1:2013;x=[1356 4095 6060 4283 7720 13698 11865.9 13777.94 17801 19500.6]; plot(t,x,'*',t,x);a0=[0.001,1];a=curvefit('fun1',a0,t,x)ti=1790:5:2020;xi=fun1(a,ti);hold onplot(ti,xi);t1=2010;x1=fun1(a,t1)hold off图如下;空气污染指数为0-50,空气质量级别为I 级,空气质量状况属于优。
此时不存在空气污染问题,对公众的健康没有任何危害。
空气污染指数为51-100,空气质量级别为Ⅱ级,空气质量状况属于良。
人口预测中线性回归分析简单步骤

人口预测中线性回归分析简单步骤:
一、进行回归分析
SPSS-regression-linear
Dependent ——因变量这里应该为人口
Independent ——自变量这里可以为年份,也可以为GDP或其他认为可以引起人口变动的自变量
用箭头添加到相应的框中,然后点击ok,生成结果。
二、结果检验
Model Summary
a Predictors: (Constant), V1
R2=0.11,模型拟合效果不好(此数应该越接近1越好,如果在0.7以上均可认为模型拟合效果较好)
ANOVA(b)
a Predictors: (Constant), V1
b Dependent Variable: V2
sig=0.771,模型线性特征不显著(如果该值小于0.05,可认为线性关系较为显著)
Coefficients(a)
a Dependent Variable: V2
每个参数的sig分别为0.772和0.771,表示参数也不显著(如果该值小于0.05,可认为线性关系较为显著)
列出的一元一次方程为y=88.709x-176626.982。
将x=??带入方程,得到y=??,则??年人口为??。
但由于未通过显著性检验,模型拟合效果也不好,所以该方法预测的结果应当去掉。
(这里如果前面的拟合度和显著性检验效果均较好的话,就应当保留该方法预测的结果。
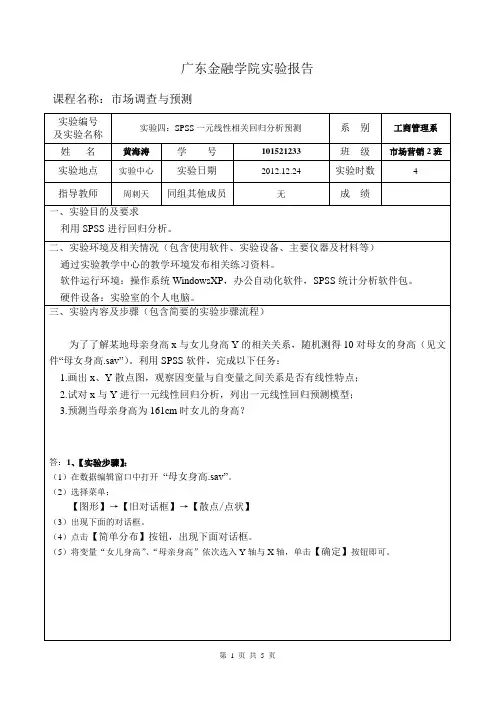
SPSS一元线性相关回归分析预测
t
Sig.
Bபைடு நூலகம்
Std. Error
Beta
1
(Constant)
34.996
42.932
.815
.439
母亲身高
.782
.270
.715
2.891
.020
a. Dependent Variable:女儿身高
女儿身高=34.995798+母亲身高*0.781513
答:1.画出x、Y散点图,观察因变量与自变量之间关系是否有线性特点;
散点图:
有线性关系。由上图可看出,因变量与自变量总体上存在正相关关系,图形大致呈向右上方上升的趋势。
2.试对x与Y进行一元线性回归分析,列出一元线性回归预测模型;
Coefficientsa
Model
Unstandardized Coefficients
六、教师评语
1.□优秀(90~100分):完成所有规定实验内容,实验步骤正确,结果正确;
2.□良好(80~89分):完成绝大部分规定实验内容,实验步骤正确,结果正确;
3.□中等(70~79分):完成绝大部分规定实验内容,实验步骤基本正确,结果基本正确;
4.□及格(60~69分):基本完成规定实验内容,实验步骤基本正确,完成结果基本正确;
硬件设备:实验室的个人电脑。
三、实验内容及步骤(包含简要的实验步骤流程)
为了了解某地母亲身高x与女儿身高Y的相关关系,随机测得10对母女的身高(见文件“母女身高.sav”)。利用SPSS软件,完成以下任务:
1.画出x、Y散点图,观察因变量与自变量之间关系是否有线性特点;
2.试对x与Y进行一元线性回归分析,列出一元线性回归预测模型;
第七讲 spss 人口统计

24
2.年龄别死亡率
概念:也称年龄组死亡率,是指一年内某年龄组死亡 人数与相应的平均人口数之比。通常多以5岁为一组来 计算。 计算公式: 同年该年龄组的死亡人数 ×1000‰ 某年某年龄组平均人口数 年龄别死亡率消除了人口年龄构成不同对死亡水平的 影响,故不同地区同一年龄组死亡率可以进行比较。 对年龄别死亡率进行分析可以明确卫生工作的重点人 群。年龄别死亡率有其自身的规律,一般0岁组死亡率 较高,以后随着年龄的增长迅速下降,至10~14岁时 (在发达国家为5~9岁)死亡率降至最低值,以后虽 略有上升,但在40岁前一直处于低水平,40岁以后, 死亡率随年龄的增长而增高。
4. 5岁以下儿童死亡率
意义:是指某年5岁以下儿童死亡数(包括婴儿死 亡数)与同年活产数的比值。 计算公式: ×1000‰ 同年 5岁以下儿童死亡数
某年活产数
意义:许多发展中国家,由于婴儿死亡率的资料不 易准确,而5岁以下儿童死亡又很高,故联合国儿 童基金会常用5岁以下儿童死亡率作为综合反映婴 幼儿死亡水平及儿童生存大小的指标。
3.年龄别生育率(ASFR )
概念:也称年龄组生育率,是指某年每千名某年龄育龄 妇女的活产数。 同年该年龄组妇女的活 产数 某年龄组生育率= 某年某年龄组妇女数 ×1000‰ 意义:年龄别生育率消除了育龄妇女内部年龄构成对生 育水平的影响,故比总生育率又进了一步,它能反映不 同年龄(组)育龄妇女的生育水平,不同地区不同时期 同一年龄别生育率可以直接比较。通常年龄别生育率多 以5岁一个年龄组计算,所以要想得到这一指标,必须要 有育龄妇女各年龄组的妇女数和活产数,但在不少发展 17 中国家很难获得这一资料。
人口性别年龄构成
1.性别比:男性人口与女性人口的比值。其算式为:
基于SPSS的小城镇人口预测研究
小城镇建设 35
Urbanization 城镇化研究
表1 镇区规划期内人口分类预测
人口类别
统计范围
户籍人口 常住人口
寄住人口
户籍在镇区规划用地范围内的人口 居住半年以上的外来人口;寄宿在规划用地范围内的学生。
通勤人口
劳动、学习在镇区内,住在规划范围外的职工、学生等。
流动人口
出差、探亲、旅游、赶集等临时参与镇区活动的人员
二指标的选取与主成分分析本文选取反映小城镇社会经济发展的48项指标进行社会统计分析以期为小城镇人口预测探寻具有普适图1张集镇历年镇区人口自然增长率与机械增长率趋势图表3小城镇人口预测指标体系一级指标二级指标一级指标二级指标城镇人口常住人口factor2经济水平集贸市场成交额通勤人口建成区固定资产投资完成额流动人口factor3生活水平住楼房户比重factor1城镇规模行政区域面积参加养老保险人数建成区面积参加农村新型合作医疗人数工业园区面积享受居民最低生活保障人数公共绿地面积互联网上网用户城镇总户数factor4基础设施通自来水村数城镇从业人员数量通有线电视村数factor2经济水平gdp农业机械总动力人均gdp农村用电量第一产业产值本乡镇公路里程第二产业产值固定电话装机数量第三产业产值移动电话拥有数量农民人均纯收入自来水普及率企业营业收入总额生活用燃气普及率企业年净利润总额排水管道覆盖率企业实交税金总额有线电视入户率固定资产投资完成额污水处理率财政收入年末道路已铺装面积可用财政收入人均住房面积工业年投资总额人均日生活用水量工业年销售总额factor5生态环境农户享有卫生厕所比重年末各项存款余额绿化覆盖率其中居民储蓄存款余额垃圾无害化处理率38小城镇建设urbanization城镇化研究性的方法
陈国燕 孙 昊
摘要:本文以徐州市张集镇为例,结合实际情 况,对人口规模预测的方式方法进行归纳总结,采用多 重社会统计分析方法,对城镇人口尤其是城镇常住人口 进行分析预测,探讨城镇人口的预测方法与应用。
spss bp神经网络模型预测另一组数据
spss bp神经网络模型预测另一组数据神经网络模型是数据分析常用的模型,它广泛应用于众多领域,比如:医疗、人工智能、深度学习、语音、机器人等。
它能通过现有数据经过神经网络模型训练得到训练模型,再将模型运用于预测数据集,进而得到预测结果,并且将预测趋势应用于各个领域。
IBM SPSS Statistics同样具备神经网络模型,直接将需要分析数据导入IBMSPSSStatistics,然后进行简单配置即可使用神经网络模型。
接下来就来看下如何使用SPSS神经网络模型预测结果。
数据集准备打开SPSS软件,如果预测的数据集是事先准备好的,则直接点击左上角“文件”-“导入数据”;如果预测的数据集需要自己制作,则通过SPSS软件设置变量以及完成数据输入。
二、神经网络模型预测结果1、点击顶部菜单栏“转换”-“计算变量”,打开计算变量窗口。
然后我们需要设计名为incress的目标变量,并且将其标签设计为“促销前后消费额变化率”,最后设计该变量的数字表达式。
2、完成上述操作之后,我们可以看到数据集中增加了该变量,并且自动生成数据集。
然后我们需要将该变量角色改为目标。
3、点击SPSS软件顶部菜单栏“分析”-“神经网络”-“径向基函数”。
打开径向基函数窗口,我们可以看到顶部包括变量、分区、体系结构、输出、保存、导出、选项。
其中“体系结构”和“选项”默认即可,下面将对其他五个菜单进行设计。
4、设计变量菜单。
将incress(目标变量)加载到因变量选项框,将Class、Cost、Promotion、Before加载到协变量,并且协变量重新标度选择为标准差。
5、设计分区菜单和输出菜单。
分区一般默认是训练数据为70%,检验数据为30%,当然你可以自己配置比率。
6、输出一般把所有选项都选中,这样有利于我们观看分析结果。
7、保存和导出菜单。
保存需要勾选“保存每个因变量的预测或类别”,这样将会把预测值添加到数据集中。
导出需要勾选“将突触权重估算值导出到XML文件,并且点击浏览将xml文件导出到本地。
基于SPSS分析的对云南省人口预测
云南大学滇池学院 经济学院经济学专业2014~2015学年SPSS 应用统计软件实验论文基于spss 分析的云南省人口预测模型摘要本文利用云南省2011年统计年鉴中云南总人口数的历史数据,借助统计软件SPSS 分别建立了线性回归模型和Logistic 人口模型,根据模型首先对云南省2008—2009年总人口数进行了预测,并与实际值进行了对比,结果显示模型拟合效果很好,然后运用模型对2012—2014年云南省总人口数进行了预测,两个模型得到的预测结果分别为(10192.27,10252.615,10312.96)和(10007.86,10058.41,10120.73),最后结合预测结果对云南省人口增长和经济建设协调发展提出建议。
关键字:线性回归 Logistic 人口模型 协调发展AbstractIn this paper, the use of historical data Yunnan 2011 Statistical Yearbook of the total population in Yunnan, with the statistical software SPSS linear regression models were established and Logistic population model, the first of a total population of Yunnan Province in 2008-2009 were predicted based on models and values were compared with the actual results show that the model works well fitted, and then use the model of the total population in Yunnan Province in 2012-2014 were predicted, predicted results were obtained in two models (10192.27,10252.615,10312.96) and(10007.86,10058.41,10120.73), the final results of the combined forecasts of population growth and economic development of Yunnan coordinated development proposals.Keywords: Logistic regression model for the coordinated development of population 一、问题的提出云南是少数民族的重要集聚地,自古以来人口密集。
spss人口预测-二次函数模型预测
2. 用曲线估算预测
3.根据曲线估算结果,决定采用二次函数模型,
4.根据列表,列出数学公式
5.根据人均建设用地占地面积计算 建设用地需求总量
6.根据比例计算各类型的建设用地所需面积
end 。
网络错误3请刷新页面重试持续报错请尝试更换浏览器或网络环境
spss人口预测 -二次函数模型预测
总体思路:根据00-20年的人口数据 预测2025年的人口数量 根据预测结果和人居建设用地面积计算2025年预测所需的建设用地面积 根据各类型占比分配用地 (注意:人口预测方法不止这一种) 步骤如下: 1. 建立散点图查看趋势