
2.4 正规表达式到有限自动机的构造
2014-9-28
30
于是得到DFA 如下: a a 1 0 b b 化简: 因{0,1}a={1}, 故不划分。 因{0,1}b={1}, 故不划分。 因此, 最简DFA如下: a 0 b
2014-9-28 31
(2) (a*b*)*对应的NFA如图2-20所示, 用子集法将NFA确定化得下述转换表:
2014-9-28 18
两个状态相互等价是指: 对于给定的 DFA M, 假定状态s1,s2∈S且s1≠s2, 若从s1 出发能识别字符串而停于终态 , 从s2出 发也能识别而停于终态; 反之, 若从s2出 发能识别 而停于终态 , 从 s1 出发也能识 别而停于终态, 则称s1和s2等价, 否则称 s1和s2是可区分的。 假定状态s1,s2∈S且s1≠s2, 若s1和s2 通过同一字符(串)到达了可区分的状态, 则s1和s2也是可区分的。
2.4.1 由正规式构造等价的NFA M 由正规式构造等价的NFA M的方法 (Thompson构造法): (1) 将正规式R表示为拓广转换图。
X R Y 2
2014-9-28
4
(2) 采用下述三条转换规则构造NFA
1. s i 2. s i
3. s i r1| r2 r1r2 r1* r1 sj
2014-9-28
Ia {1,2,3} {1,2,3,5,6,Y} {1,2,3} {1,2,3,5,6,Y} {1,2,3,6,Y} {1,2,3,6,Y} {1,2,3,5,6,Y}
Ib {1,2,4} {1,2,4} {1,2,4,5,6,Y} {1,2,4,6,Y} {1,2,4,5,6,Y} {1,2,4,5,6,Y} {1,2,4,6,Y}
DFA M的化简方法 (Hopcroft算法) : (1)首先将DFA M的状态集S中的终态与非终 态分开,形成两个子集,得到基本划分。 (2) 对当前已划分出的 I(1),I(2),…,I(m) 子集, 看每 个 I 是 否 能 进 一 步 划 分 。 对 某 个 I(i)= {s1,s2,…,sk}, 若存在输入字符a∈Σ使得Ia(i)不 全包含在当前划分的某个子集 I(j) 中 , 即跨 越两个子集, 则将I(i)一分为二(下页)。 (3)重复(2), 直到每个子集均不能再分。 不能再分是指子集要么仅有一个状态,要 么有多个状态但这些状态不可区分。
2014-9-28 24
例2.9 化简由例2.8得到的DFA。
a 0 b 1 a 2 b b 4 2 a a a 3 2 b b a a 6 2 5 2 b
b
解: (1)先将状态集S={0,1,2,3,4,5,6}划分为 终态集{3,4,5,6}和非终态集{0,1,2}。 (2)考察{0,1,2}a:因{0,2,1}a={1,3}不属于 {3,4,5,6}和{0,1,2},故将{0,1,2}划分为 {0,2}和{1}。 2014-9-28 25
r1*
的转换规则可不可以改为?
e r1 e sj
si
例:(11+)*
2014-9-28
8
2.4.2 NFA M的确定化 --子集构造法(Subset Construction) 首先 定义FA M的任一状态子集 I 的 e_CLOSURE(I): (1)若si∈I, 则si∈e_CLOSURE(I); (2)若si∈I, 则从 si 出发经过e所能到达的 状态 sj 属于e_CLOSURE(I)。 其次 定义Ia: 对FA M的任一状态子集 I , 若a是Σ中的 一个字符,则定义 Ia=e_CLOSURE(J), 其中 J 是从 I 中某一状态出发经过a所能 到达的所有状态的集合。 J=move(I,a)
编 译 原 理 Principle of Compiling
郭 一 晶
厦门大学嘉庚学院
动机的构造
2.4.1由正规式构造等价的NFA M 2.4.2 NFA M的确定化
2.4.3 DFA M的化简
2.4.4 正规式到有限自动机构造示例
2.4.5 从NFA M到正规表达式的转换
2014-9-28 6
X
b*(d|ad)(b|ab)(b|ab)* 2 b|ab 3
Y
X Xε
b* 1 d|ad b
4 b ε 1 ad
(b|ab)*
Y
d
2
b
3 ab b 2
b|ab ε 5 ε b 3 ε Y
X
ε
4 ε
d 1
a
6
d a
7
b
5 ε a b 8
Y
2014-9-28
7
Thompson方法构造的NFA有下列性质: 只有一个开始状态和一个接受状态,接 受状态没有向外的转换。
M。
si
si
r2
r1 e
sj sk
r2
sj
sj
sj
sj
si
sk e r1
2014-9-28
5
对于正规式R,首先将其表示为拓广 转换图,其中X为初态,Y为终态,然后逐步 运用三条转换规则不断加入新结点,直至 每条有向边上仅标识Σ的一个字母或ε为 止,至此 NFA M构造完成。 例2.6 构造 b*(d|ad)(b|ab)+对应的NFA。 解: 首先用R+=RR*把正规式改造为 b*(d|ad) (b|ab) (b|ab)* 然后构造其NFA M,如下图所示:
2014-9-28 21
s1 s2
a a
s
3 s 4
s 1 s2
a
s 3
a s 4
(a)无需划分
(b)需划分
2014-9-28
22
如何进行子集的划分呢?
假定当前子集I(i)={s1,s2,…},其中s1和s2经 过有向边a分别到达状态t1和t2, 而t1和t2分属于 当前已划出的两个不同子集I(j)和I(k),则应将I(i) 分为两部分: I(i1)= {s | s∈I(i)且s经有向边a到达t1} I(i2)= I(i) −I(i1) (由于t1和t2是可区分的, 因此I(i1)中的状态与I(i2)中的状态可区分)
2014-9-28 23
划分结束后, 子集个数不再增加, 从每 个子集中选一个状态形成新的DFA。
例如, I(i)={s1, s2, s3} 若挑选s1作为I(i)的代表,则原来指向s2 和s3的有向边均改为指向新DFA中的s1。 若I(i)中含原来的初态,则s1为新初态;
若I(i)中含原来的终态,则s1为新终态。
2014-9-28
2
有限自动机和正规表达式的等价性:
1.对于∑上的一个NFA M,可以构造一 个∑上的正规式R,使得L(R)=L(M)。 2.对于∑上的一个正规式R,可以构造一 个∑上的NFA M,使得L(M)=L(R)。
注意:与某一NFA等价的DFA不一定唯 一。
3
2014-9-28
2.4 正规式到有限自动机的构造
2014-9-28 11
例2.8 正规式(a|b)*(aa|bb)(a|b)*的NFA M如下: 试将其确定化为DFA M'。
a X e 1 b e 2 b
a
3
a
5 e
a 6 b e Y 2
4
b
2014-9-28
12
解: 用子集法将上述NFA M 确定化为
I {X,1,2} {1,2,3} {1,2,4} {1,2,3,5,6,Y} {1,2,4,5,6,Y} {1,2,4,6,Y} {1,2,3,6,Y}
2014-9-28 17
2.4.3 DFA M的化简 (DFA Minimization) NFA确定化所得的DFA可能含有多余 的状态, 需化简。所谓DFA M的化简,是 指寻找一个状态数比M少的DFA M',使得 L(M) = L(M')。 化简后的DFA M' 满足下述条件: (1) 无多余状态 (死状态); (2) 状态集中无相互等价(不可区别) 的状态。
2014-9-28 10
用子集法对NFA确定化的方法: (1)构造一张转换表, 该表的第1列为状态 子集I, 不同输入符a 对应表中一列Ia。 (2)表的首行首列为e_CLOSURE(s0)。 (3)根据首行首列中的状态集, 为每个输 入符a求其Ia并记入相应的Ia列中。 若此Ia不同于第1列已存在的所有状态 子集, 则将其顺序列入空行中的第1列。 (4)重复(3)直至对每个I及a均已求得Ia, 且 无新的状态子集Ia加入第1列为止。 (5)重命名第1列的每个状态集, 所得状态 转换矩阵即为与NFA M等价的DFA M'。
DFA的一个状态是NFA的一个状态集合。 读了输入a1a2…an后,NFA能到达的所有状 态:s1, s2, …, sk,则DFA到达状态{s1, s2, …, sk}。
16
2014-9-28
算法描述:
– 1 开始,假定所构造的子集族为C,令e-
closure(K0)为C中唯一成员,并且它是未被标 记的。 – 2 while (C中存在尚未被标记的子集T)do { 标记T; for 每个输入字母a do { U:= e-closure(move(T,a)); if U不在C中 then 将U作为未标记的子集加在C中 } }
2014-9-28 26
a 0 b b
1
a a b 3 b
a
2
S 0 1 2 3
2014-9-28
a 1 3 1 3
b 2 2 3 3
27
结论
– 接受L的最小状态有穷自动机,若不计同构
则是唯一的。
另一种等价的构造方法:填表算法,参考本节 最后的附加ppt。
【编译原理】词法分析:正则表达式与有限自动机基础

【编译原理】词法分析:正则表达式与有限⾃动机基础引⾔: 编译语⾔设计的精髓在于⾃动化过程,即如果要设计⼀门编程语⾔,那么⼀定要设计⼀个⾃动化系统,能够⾃⾏读⼊分析程序员写⼊的程序,将其翻译为机器能够识别的指令等信息。
当然⾼级语⾔的编译不是⼀蹴⽽就的,⽽是通过若⼲步的分解、规约、转换、优化,最后得到⽬标程序。
具体的编译步骤如下: 源程序就是我们写⼊的⾼级语⾔,编译的第⼀步叫做“词法分析”。
词法分析的本质,就是要拆解出语句的每⼀个单词,然后对这个单词的类型进⾏辨识。
⾸先拿中⽂来举例。
⽐如有⼀句话是“我喜欢你”,那么⾸先我们要把这句话拆成“我”、“喜欢”、“你”,然后再逐个分析他们的类型,得到“我”->主语;“喜欢”->谓语;“你”->宾语。
这样我们就把这句话每个单词都分析出来了,也就完成了中⽂的“词法分析”。
那么回到编程语⾔,它的词法分析就是将字符序列转换为单词(Token)序列的过程。
翻译成俗话,就是把我们写的⼤⽚语⾔⽂本分解为⼀个⼀个单词,再输出每个单词的类型。
举⼀个例⼦:int p = 3 + a; 这个语句⾮常简单,即定义⼀个变量p,它的初值为变量a与3的加和。
那么接下来我们要对这个语句进⾏词法分析,⾸先我们要把这段⽂本拆解成单词,拆出来就是'int'、'p'、'='、'3'、'+'、'a'、';'。
对这些单词再进⾏类型的辨识,那么就得到以下结果:语素语⾔类型int关键字p标识符=运算符3数字+运算符a标识符 这样我们就把这段⽂本中的每个单词的类型都分析出来了。
乍⼀看⾮常简单对不对,对于⼈类⽽⾔你只需要⽤⾁眼就可以轻松观察出来每个单词的类型,但对于计算机⽽⾔,它可没有⼈类那样的智能。
如果想要计算机能够识别并分析语素的类型,那就需要我们⼈类来为它构造⼀个⾃动化输⼊和分析的系统。
正规式转化为有限自动机的算法综述
正规式转化为有限自动机的算法综述网络工程04379024 刘伟莉[摘要]本文从正规表达式的广阔应用开始,阐述引入有限自动机的必要性与可行性。
详细列举了几种将正规表达式转换为有限自动机的算法,并对它们的特点进行了比较。
[关键词]:正规表达式;有限自动机;Thompson算法0 引言在编译原理的词法分析理论中,从正规表达式到有限自动机的转换是词法分析器自动生成理论研究的重要内容。
其中,正规表达式(Regular Expressions)在编译程序中用来描述程序设计语言中某种单词的词法结构。
而有限自动机(Finite Automata,简称为FA)则用来识别某些字符串是否符合某种词法规则。
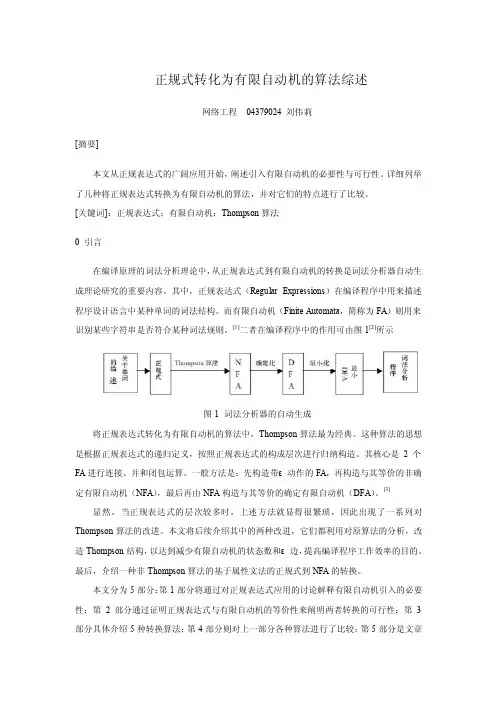
[1]二者在编译程序中的作用可由图1[2]所示图1 词法分析器的自动生成将正规表达式转化为有限自动机的算法中,Thompson算法最为经典。
这种算法的思想是根据正规表达式的递归定义,按照正规表达式的构成层次进行归纳构造。
其核心是2个FA进行连接、并和闭包运算。
一般方法是:先构造带ε动作的FA,再构造与其等价的非确定有限自动机(NFA),最后再由NFA构造与其等价的确定有限自动机(DFA)。
[3]显然,当正规表达式的层次较多时,上述方法就显得很繁琐,因此出现了一系列对Thompson算法的改进。
本文将后续介绍其中的两种改进,它们都利用对原算法的分析,改造Thompson结构,以达到减少有限自动机的状态数和ε边,提高编译程序工作效率的目的。
最后,介绍一种非Thompson算法的基于属性文法的正规式到NFA的转换。
本文分为5部分:第1部分将通过对正规表达式应用的讨论解释有限自动机引入的必要性;第2部分通过证明正规表达式与有限自动机的等价性来阐明两者转换的可行性;第3部分具体介绍5种转换算法;第4部分则对上一部分各种算法进行了比较;第5部分是文章小结。
1 正规表达式的应用与有限自动机的引入除了在编译程序构造与设计外,正规表达式还被应用于其他领域,比如字处理软件中的文本检索、数据库查询语言、文件处理语言以及遗传序列的研究等。
第2章词法分析

2.3 正规表达式与有限自动机简介
2.3.1 正规表达式与正规集
状态转换图对构造词法分析器非常 有效,为便于词法分析器的自动生成, 需将状态转换图的概念形式化。正规表 达式就是一种形式化表示法,它可以表 示单词符号的结构,从而精确定义单词 符号集。正规表达式简称正规式,它表 示的集合称为正规集。
下面以标识符为例来说明正规式与正规集: 标识符是以字母开头的字母数字串。
第2章 词法分析
2.1 词法分析器设计方法 2.2 一个简单的词法分析器示例 2.3 正规表达式与有限自动机简介 2.4 正规表达式到有限自动机的构造 2.5 词法分析器的自动生成
词法分析的任务: 从左至右逐个字符 地对源程序进行扫描, 产生一个个单词符 号, 把字符串形式的源程序改造成为单词 符号串形式的中间程序。
…
case 'z':
while (letter ( )‖digit ( )) { concatenation ( ); /*将当前读入
的字符送入token数组*/
getchar ( );
}
retract ( ); /*扫描指针回退一个字符*/ c=reserve ( ); if (c==0) {
buildlist ( ); /*将标识符登录到符号表*/ return (id, id在符号表中的入口指针); } else return (保留字码, null) ; break;
(5)letter( )和digit( ): 判断character中的字 符是否为字母和数字的布尔函数,若是 则返回true, 否则返回false。
(6)reserve( ): 按token数组中的字符串查 保留字表, 若是保留字则返回其编码, 否则返回0。
编译原理之有限自动机解析PPT课件
return( install_num( ) )
第10页/共75页
2.2 词法记号的描述与识别
• 空白的转换图
delim blank | tab | newline ws delim+
开始
delim
delim
other
*
20
21
22
第11页/共75页
2.3 有 限 自 动 机
? 正规式
状态转换图
a
0
b
1
2
1 b 2b
a
a
C
b
a
b
开始 A a B
开始 0
a
2
3
1 b
4
6 5
第39页/共75页
a
a
7
8
b bD a
b 9
的化简
• DFA化简的途径 • 根据状态是否可以区分,将状态划分成若干个集合,每个集合内的状态之间都不可区分,而任意两个 集合中的元素都是可以互相区分的。 • 依据原始的DFA,在合并后的状态基础上,建立新的状态转换关系。
1
>
3 return(relop, NE)
<
开始 0
=
other
* return(relop, LT) 4
5 return(relop, EQ)
>
=
6
other
第8页/共75页
7 return(relop, GE) 8 * return(relop, GT)
2.2 词法记号的描述与识别
• 标识符和保留字的转换图
a
识别语言 (a|b)*ab
开始 0
a
1b
第2章 词法分析-sxw

正规表达式是典型的词法规则描述工具.
正规式也称正则表达式. 正规表达式(regular expression)是说明单词的模 式(pattern)的一种重要的表示法(记号),是定义正 规集的数学工具.我们用以描述单词符号.下面是 正规式和它所表示的正规集的递归定义.
第2章 词法分析
程序语言中使用的标识符是一个以字母开头的字 母数字串,如果字母用letter表示,数字用digit表示, 则标识符可表示为 letter (letter∣digit)* 其中,letter与 (letter∣digit)*的并置表示两者的连 接;括号中的"∣"表示letter或digit两者选一;"*" 表示零次或多次引用由"*"标记的表达式; (letter∣digit)*是letter∣digit的零次或多次并置,即表 示 一 长 度 为 0 , 1 , 2 , … 的 字 母 数 字 串 ; letter (letter∣digit)*表示以字母开头的字母数字串,也即标 识符集.letter (letter∣digit)*就是表示标识符的正规式, 而标识符集就是这个正规式所表示的正规集.
第2章 词法分析
retract ( ); c=reserve ( ); if (c==0) { buildlist ( );
/*扫描指针回退一个字符*/
/*将标识符登录到符号表中*/
return (id,指向id的符号表入口指针); } else return (保留字码,null); break;
第2章 词法分析
x i y
j
k
图2–2 不同输入字符的状态转换
第2章 词法分析
编译原理课后答案2010

2.4 为下列语言写正规定义
C 语言的注释,即以 /* 开始和以 */ 结束的任意字符串,但它的任何前缀
(本身除外)不以 */ 结尾。
[解答]
other → a | b | …
other 指除了*以外 C 语言中的其它字符
other1 → a | b | …
other1指除了*和/以外C语言中的其它字符
=> S0 = ((00|11)|(01|10) (00|11)*(01|10))*((00|11) + (01|10) (00|11)* (01|10)) => S0 = ((00|11)|(01|10) (00|11)* (01|10))+
因为S0→ε所以由偶数个 0 和偶数个 1 构成的所有 0 和 1 的串的正规定义为: S0 → ((00|11)|(01|10) (00|11)* (01|10))*
标记状态S1 S3 = ε-closure(move(S1, a)) = ε-closure({5, 8, 12}) = {1, 2, 4, 5, 6, 7, 8, 9, 11,
12, 13, 14, 16} S4 = ε-closure(move(S1, b)) = ε-closure({3, 10}) = {1, 2, 4, 5, 6, 7, 10, 13, 14,
S0 = 1S1 + 0S2
S1 = 1S0 + 0S3 + 1
S2 = 1S3 + 0S0 + 0 S3 = 1S2 + 0S1
所以:
S0 = (00|11) S0 + (01|10) S3 + 11 + 00
(1)
S3 = (00|11) S3 + (01|10) S0 + 01 + 10
2.4 正规表达式到有限自动机的构造
2.4.3 DFA M的化简 (DFA Minimization) NFA确定化所得的DFA可能含有多余 的状态, 需化简。所谓DFA M的化简,是 指寻找一个状态数比M少的DFA M',使得 L(M) = L(M')。 化简后的DFA M' 满足下述条件: (1) 无多余状态 (死状态); (2) 状态集中无相互等价(不可区别) 的状态。
2014-9-28 9
例2.7 对下图,取 I=e_CLOSURE{1}={1,2}, 求从状态I出发经一条有向边a所能 到达的状态集J和e_CLOSURE(J)。
a 5 e e a e 6
1
e
a
2 4
3 7
e
8
J={5, 3, 4} e_CLOSURE(J)={5, 6, 2, 3, 8, 4, 7}
S 0 1 a 1 1 b 1 1
2014-9-28
30
于是得到DFA 如下: a a 1 0 b b 化简: 因{0,1}a={1}, 故不划分。 因{0,1}b={1}, 故不划分。 因此, 最简DFA如下: a 0 b
2014-9-28 31
(2) (a*b*)*对应的NFA如图2-20所示, 用子集法将NFA确定化得下述转换表:
r1*
的转换规则可不可以改为?
e r1 e sj
si
例:(11+)*
2014-9-28
8
2.4.2 NFA M的确定化 --子集构造法(Subset Construction) 首先 定义FA M的任一状态子集 I 的 e_CLOSURE(I): (1)若si∈I, 则si∈e_CLOSURE(I); (2)若si∈I, 则从 si 出发经过e所能到达的 状态 sj 属于e_CLOSURE(I)。 其次 定义Ia: 对FA M的任一状态子集 I , 若a是Σ中的 一个字符,则定义 Ia=e_CLOSURE(J), 其中 J 是从 I 中某一状态出发经过a所能 到达的所有状态的集合。 J=move(I,a)
正规文法与有限自动机的相互转换.
正规文法与有限自动机的相互转换二零一五年十二月二十七日目录摘要 (1)关键词 (1)1课题综述 (1)1.1目的 (1)1.2设计内容 (1)1.3设计原则 (1)2系统分析 (2)2.1正规式 (2)2.2有限自动机(有穷自动机) (2)2.3NFA向DFA的转换 (3)2.4正规式与有限自动机之间的转换 (3)3系统设计 (4)3.1从正规文法到有限自动机 (4)3.11正规文法到有限自动机的等价性证明 (4)3.12 正规文法到有限自动机的构造方法 (5)3.2从有限自动机到正规文法 (6)3.21 有限自动机到正规文法的等价性证明 (6)3.22 有限自动机到正规文法的构造方法 (7)4 运行与测试 (7)总结 (9)参考文献 (9)附录 (10)摘要:正规文法包括左线性文法和右线性文法。
由于正规文法和正规表达式在描述语言的能力上是等价的,而正规表达式和有限自动机在描述语言的能力上也是等价的,因此,正规文法和有限自动机之间也存在着等价性。
通常,对于正规文法G和有限自动机M,G所定义的语言记作L(G),M所能识别的语言记作L(M),如果有L(G)=L(M),则称G和M是等价的。
关键词:正规文法;有限自动机;等价性;构造方法1课题综述1.1目的1.理解正规文法与有限自动机(FA)的本质联系;2.掌握正规文法与有限自动机之间相互转化的算法原理;3.学会使用Visual C++等编程工具实现正规文法与有限自动机之间的相互转化;1.2设计内容使用Visual C++/Visual C#等工具,设计软件MySoft_3,可以实现以下功能:1.根据用户输入的文本文件(*.txt)的名称,打开文件,并从文件中获取文法的产生式、非终结符、终结符、开始符等基本信息;2.判断该文法是否为正规文法,若是,则将其转化为有限自动机;3.根据用户输入的文本文件(*.txt)的名称,打开文件,并从文件中获取有限自动机的状态集、字母表、初态、终态集、转移函数等基本信息;4.判断该自动机是否合法,若合法,则将其转化为正规文法;1.3设计原则正规文法与有穷自动机有着特殊的关系,采用下面的规则可从正规文法G直接构造一个有穷自动机NFA M;使得L(M)=L(G):(1)M的字母表与G的终结符相同;(2)为G中的每一个非终结符生成M的一个状态,G的开始符S是开始状态;(3)增加一个新状态Z,作为NFA的终态;(4)对G中的形如A->tB的规则(其中T为终结符或,A为非终结符的产生式),构造M的一个转换函数f(A,t)=B;(5)对G中形如A->t的产生式,构造M的一个转换函数f(A,t)=Z。
形式语言自动机——有限自动机
形式语言自动机——有限自动机有限自动机是形式语言自动机中最简单的一种类型,它具有有限个状态和一定的转移规则。
一个有限自动机包含以下几个要素:1.状态集合:有限自动机通过状态集合来描述它的内部状态。
每个状态代表了自动机所处的一些特定状态,例如开始状态、结束状态等。
2.输入字母表:输入字母表是指自动机能够接受的输入符号的集合。
每个输入符号在自动机的状态转移中起着关键的作用,它触发了状态的变化。
3.转移函数:转移函数定义了自动机状态之间的转移规则。
它接受来自输入字母表的输入符号和当前状态作为输入,返回下一个状态作为输出。
4.初始状态和接受状态:初始状态是自动机的起始状态,它是自动机开始处理输入时的初始状态。
接受状态是自动机达到的一种终止状态,它表示自动机已经接受了整个输入。
有限自动机的工作原理可以简述为以下几个步骤:1.从初始状态开始,根据输入符号进行状态转移。
2.在每次状态转移后,根据转移函数返回的下一个状态继续进行状态转移,直到达到接受状态或输入用尽。
3.如果最终达到了接受状态,则自动机接受了整个输入;否则,自动机拒绝该输入。
有限自动机可以描述和识别各种不同的形式语言。
它能够处理的语言包括正则语言、上下文无关语言和上下文相关语言等。
通过对有限自动机的状态和转移规则的定义和设计,可以将输入串按照预期的形式语言规则进行解析和处理,是编程语言编译器、字符串模式匹配等领域的基本技术。
有限自动机具有简单、易于实现和高效的特点。
它的状态转移规则可以通过转移表或状态转移图直观地表示出来,便于对自动机进行设计和分析。
虽然有限自动机的能力有限,无法处理具有复杂语法和上下文依赖的语言,但它在很多实际应用中能够提供有效的解决方案。
总而言之,有限自动机作为形式语言自动机的一种基本形式,具有较简单的结构和规则,广泛应用于形式语言的表示、识别和处理中。
通过对有限自动机的理论和实践研究,可以深入理解形式语言的本质和特性,为计算机科学中的语言处理和编程技术提供基础支持。
第6讲 词法分析3--正规式与有限自动机的等价性
视频区域
为正规式构造NFA
(a|b)*(aa|bb)(a|b)*
(a|b)*(aa|bb)(a|b)*
X
Y
a a5a
ε
ε
X
1
2
3ε
b6 b b
视频区域
a
4εY b
为正规式构造NFA
a
a
a
aa
Xε 1 ε 2
3ε 4 ε Y
b
bb
b
M’
为NFA构造正规式
假定NFA M=<S, Σ, δ, S0, F>,我们对M的状 态转换图进行以下改造:
在M的转换图上加进两个状态X和Y,从X用ε弧连接 到M的所有初态结点,从M的所有终态结点用视ε频弧区连域 接到Y,从而形成一个新的NFA,记为M’,它只有一 个初态X和一个终态Y,显然L(M)=L(M’)。
构造Σ上的NFA M’ 使得 L(r)=L(M’)
首先,把r表示成
视频区域
Xr Y
为正规式构造NFA
按下面的三条规则对r进行分裂
i r1r2 k 代之为 i r1 j r2 k
r1
视频区域
i r1|r2 j 代之为
i
j
i
r1*
r2 k 代之为 i ε j ε k
r1
为正规式构造NFA
正规式 -> FA
对任何正规式r,都存在一个FA M,使得L(M)=L(r)。
编译原理
正规式与有限自动机的等价性 ——为NFA构造正规式
为NFA构造正规式
对转换图概念拓广,令每条弧可用一个正规式 作标记。