
典型相关分析
武夷学院实验报告
课程名称:
多元统计分析
项目名称:
典型相关分析
姓名: 专业:14信计 班级:1班 学号: 同组成员:无
一、 实验目的
1.对典型相关分析问题的思路、理论和方法认识;
2.SPSS软件相应计算结果确认与应用;
3.SPSS软件相应过程命令。
二、 实验内容
这里通过典型相关分析来反映我国财政收入与财政支出之间的关系。第一组反映财政收入的指标有国内增值税、营业税、企业所得税、个人所得税、专项收入及行政事业性收费收入等,分别用X1-X6来表示。第二组反映财政支出的指标有一般公共服务、国防、公共安全、教育、科学技术、社会保障和就业、医疗卫生与计划生育及节能环保等,分别用Y1-Y8来表示。原始数据如下:
三、 实验步骤
在SPSS中没有提供典型相关分析的专门菜单项,必须采用canonical correlation.sps宏来实现。把canonical
correlation.sps安装在SPSS子目录下。
(1) 按文件-新建-语法打开语法窗口,输入下图中的语句:
(2)点击语句窗口“运行”菜单中的“全部”子菜单项。运行典型相关宏命令,得出结果。
四、实验结果
表1(第一组变量的自相关系数阵)
表2(第二组变量的自相关系数阵)
表1和表2分别为两组变量的自相关系数阵。反映了各组内变量间的相关系数。
表3(两组变量间的相关系数阵)
表3为两组变量间的相关系数。从表中可以看出,第一组变量中的X1,X2,X3与第二组变量中的Y3,Y4,Y5之间相关系数较高,这进一步说明需要提取典型变量来代表这种相关性。
值得注意的是,由于变量间的交互作用,这个简单相关系数阵只能作为参考,不能真正反映两组变量间的实质联系。
表4(典型相关系数)
表4为典型相关系数。从表中可以看出,第一对典型变量相关系数为0.991,第二对典型变量相关系数为0.838,以此类推共有6对典型变量的典型相关系数。由于此处的典型相关系数是从样本数据算得的,和简单相关系数一样,有必要进行总体系数是否为0的检验(见表5)。
表5(典型相关系数的显著性检验)
表5为典型相关系数的显著性检验。该表从左至右分别为Wilks统计量、卡方统计量、自由度和伴随概率。从表中伴随概率可以看出,第一对和第二对典型变量的典型相关系数显著不为0;从第三对典型变量开始,典型相关系数的p值都比较大,均相关性不显著。因此需要第一对和第二对典型变量。
表6(第一组典型变量的标准化系数)
表7(第一组典型变量的为标准化系数)
表8(第二组典型变量的标准系数)
表9(第二组典型变量的未标准系数)
表6-表9为各典型变量标准化与未标准化的系数列表。从表6和表8中第一列和第二列数据可以得到第一对典型变量的线性函数,分别为
表10(第一组的典型载荷系数)
表11(第一组的交叉载荷系数)
表12(第二组的典型载荷系数)
表13(第二组的交叉载荷系数)
表10-表13为典型载荷系数与交叉载荷系数的输出结果。其中,典型载荷系数是典型变量与本组观测变量之间的两两简单相关系数。交叉载荷系数是指某一典型变量与另外一组中的观测量之间的两两简单相关。
表14
表15
表16
表17
表14-表17为冗余分析的输出结果。它说明了各典型变量对各变量组方差解释的比例。冗余分析包括组内代表比例和交叉解释比例,是典型相关分析中很重要的部分。
(1) 组内代表比例是指本组所有观测变量的总标准方差中由本组形成的各个典型变量所分别代表的比例。从表中可以看到第一组变量被自身的第一个变量揭示了73.3%,被自身的第二个典型变量揭示了10.1%,以此类推;第二组变量被自身的第一个典型变量揭示了72%,自身的第二个典型变量揭示了7.1%。
(2) 交叉解释比例是指一组变量形成的典型变量对另一组观测变量的总标准方差所解释的比例,是一种组间交叉共享比例。从表中可以看到第一组变量被第二组变量的第一个典型变量揭示了60.3%,被第二个典型变量揭示了23.8%;第二组变量被第一组变量的第一个典型变量揭示了59.2%,被第二个典型变量揭示了16.7%。
五、实验总结
典型相关分析是一种采用类似主成分分析的做法,在每一组变量中都选择若干个有代表性的综合指标(变量的线性组合),通过研究两组的综合指标之间的关系来反映两组变量之间的相关关系.在实际中,只须着重研究相关关系较大的那几对典型相关变量.通过实例分析,我们进一步明确了典型相关分析是研究两组变量之间相关性的一种降维技术的统计分析方法.而复相关是典型相关的一个特例,简单相关是复相关的一个特例.第一对典型相关包含有最多的有关两组变量间相关的信息,第二对其次,其他对依次递减.各对典型相关变量所含的信息互不重复.并且经标准化的两组变量之间的典型相关系数与原始的两组变量间的相应典型相关系数是相同的. 通过实验,能够进一步对SPSS软件更熟悉应用。
实验报告成绩(百分制)__________ 实验指导教师签字:__________
应用多元统计分析之典型相关分析(doc 6页)
应用多元统计分析之典型相关分析(doc 6页)
联系与区别。
答:一组变量的典型变量和其主成分都是经过线性变换计算矩阵特征值与特征向量得出的。主成分分析只涉及一组变量的相互依赖关系而典型相关则扩展到两组变量之间的相互依赖关系之中,度量了这两组变量之间联系的强度。
9.4 简述典型相关分析中载荷分析的内容及作用。
答:作用:进行典型载荷分析有助于更好解释分析已提取的p对典型变量。分析原始变量与典型变量之间相关性。
内容:
令 (1)(2)*()paaAa (1)(2)*()pbbBb 12pUUUU 12pVVVV
*(1)*(2)UAXVBX
其中*A,*B为p对典型变量系数向量组成的矩阵,U和V为p对典型变量组成的向量。则(1)*(1)(1)*11(,)(,)CovCovUXAXXAΣ
(1)(1)(1)(1)1/2(1)(1)(,)(,)()()(,)(,)()ikikikikikkkkCovUXCorrUXDUDXCovUXCovUXDX
这里()1iDU,(1)1/2()kkkDX。记1/211V为对角元素是1/2kk的对角阵,所以有
(1)(1)1/2(1)11,*(1)1/2(1)*1/2111111(,)(,)(,)UXCorrCovCovRUXUVXAXVXAΣV
类似可得:
(2)*1/22222,VXRBΣV (2)*1/21222,UXRAΣV (1)*1/22111,VXRBΣV
对于经过标准化处理后得到的典型变量有:
(1)*11,ZUZRAR; (2)*22,ZVZRBR (2)*12,ZUZRAR;(1)*21,ZVZRBR
对于样本典型相关分析,上述结果中的数量关系同样成立。
典型相关分析
多元数据处理(典型相关分析)
1 引言
在一元统计分析中,用相关系数来衡量两个随机变量之间的线性相关关系;用复相关系数研究一个随机变量和多个随机变量的线性相关关系。然而,这些统计方法在研究两组变量之间的相关关系时却无能为力。比如要研究生理指标与训练指标的关系,居民生活环境与健康状况的关系,人口统计变量与消费变量(之间是否具有相关关系。阅读能力变量(阅读速度、阅读才能)与数学运算能力变量(数学运算速度、数学运算才能)是否相关。典型相关分析(Canonical Correlation)是研究两组变量之间相关关系的一种多元统计方法。它能够揭示出两组变量之间的内在联系。
1936年霍特林(Hotelling)最早就“大学表现”和“入学前成绩”的关系、政府政策变量与经济目标变量的关系等问题进行了研究,提出了典型相关分析技术。之后,Cooley和Hohnes(1971),Tatsuoka(1971)及Mardia,Kent和Bibby(1979)等人对典型相关分析的应用进行了讨论,Kshirsagar(1972)则从理论上给出了最好的分析。
典型相关分析的目的是识别并量化两组变量之间的联系,将两组变量相关关系的分析,转化为一组变量的线性组合与另一组变量线性组合之间的相关关系分析。目前,典型相关分析已被应用于心理学、市场营销等领域。如用于研究个人性格与职业兴趣的关系,市场促销活动与消费者响应之间的关系等问题的分析研究。
第一章、典型相关的基本理论
1.1 典型相关分析的基本概念
典型相关分析由Hotelling提出,其基本思想和主成分分析非常相似。首先在每组变量中找出变量的线性组合,使得两组的线性组合之间具有最大的相关系数。然后选取和最初挑选的这对线性组合不相关的线性组合,使其配对,并选取相关系数最大的一对,如此继续下去,直到两组变量之间的相关性被提取完毕为此。被选出的线性组合配对称为典型变量,它们的相关系数称为典型相关系数。典型相关系数度量了这两组变量之间联系的强度。
典型相关分析 2

典型相关分析
典型相关分析(canonicalcorrelationanalysis)就是利用综合变量对之间的相关关系来反映两组指标之间的整体相关性的多元统计分析方法。它的基本原理是:为了从总体上把握两组指标之间的相关关系,分别在两组变量中提取有代表性的两个综合变量1U和1V(分别为两个变量组中各变量的线性组合),利用这两个综合变量之间的相关关系来反映两组指标之间的整体相关性。
通常情况下,为了研究两组变量
12122,,,,,,,pqxxxyyyw
的相关系数,可以用最原始的方法,分别计算两组变量之间的全部相关系数,一共有pq个简单相关系数,这样既繁琐又不能抓住问题的本质。
首先分别在每组变量中找出第一对线性组合,使其具有最大相关性,即
1111212111112121ppqquxxxvyyy
然后在每组变量中找出第二对线性组合,使其分别与本组内的第一对线性组合不相关,第二对线性组合本身具有次大的相关性,有
2121222221212222ppqquxxxvyyy
2u与1u,2v与1v不相关,但2u与2v相关。如此继续下去,直至进行到r步,两组变量的相关性被提取完为止,可以得到r组变量,这里min(,)rpq。
步骤:
假设两组随机变量1212,,,,,,,pqXxxxYyyy,C为pq维总体的n次标准化观测数据阵,有
11111121221211()pqpqnnpnnqnpqaabbaabbCaabb
第一步,计算相关系数矩阵R,并将R剖分为11122122RRRRR,其中11R和22R分别为第一组变量和第二组变量的相关系数阵,T1221RR为第一组与第二组变量的相关系数阵。
第二步,求典型相关系数及典型变量。首先求11111122221MRRRR的特征根2i特征向量11222211112;iMRRRR的特征根2j,特征向量j.则典型变量为
典型相关分析 3

当我们分析两个变量间的线性相关关系时,可以用简单相关系数;分析一个变量与多个变量间的线性相关关系时,可以用复相关系数;但是当分析多个变量与多个变量间的相关关系时,并没有一个确切的指标加以反映,虽然可以两两计算简单相关系数,形成一个相关矩阵,但是这样做有两个问题:1.计算繁琐,当变量较多时矩阵庞大,不易解释。2.简单相关系数只是孤立的单个变量间的相关,当分析两组变量时,由于交互作用的存在,简单相关系数并不能真实反映变量间的相关性。多个变量与多个变量间的分析,可以看成是组与组之间的相关分析,此时可以使用典型相关分析(Canonical Correlation Analysis),也是一种多元分析方法。
======================================================
一、典型相关分析的基本原理
我们知道在回归分析中,为了预测一个因变量Y,要寻找n个自变量,这n个自变量的最佳线性组合,就是预测Y的回归模型。在面对两组变量时,我们也可以按照同样的做法,在每组中寻找等个数的线性组合,分析这些线性组合的相关性,并以此来反映两组变量之前的相关性。可以看出,典型相关分析和主成分分析思路是一致的,因此也是一种降维方法。
典型相关分析首先将每组变量转换为用线性组合表示,然后两两计算每对组合之间的简单相关系数,取最大值,即在两个变量组各自的总变化中先寻求他们之间最大的一部分共变关系,这个最大值就是两组变量的第一典型相关系数,具有最大值的这两个线性组合称为第一典型变量。接下来在余下的线性组合中计算第二典型相关系数,并要求与第一对线性组合不相关,如此反复,直至提取出两组变量的全部信息,并可以得到若干个典型相关系数和典型变量。可以看出,当两组变量均只有一个变量时,典型相关系数就是简单相关系数;当其中一组只有一个变量时,典型相关系数就是复相关系数。
======================================================
典型相关分析(CCA)——快速分析多变量的相关关系
前言:
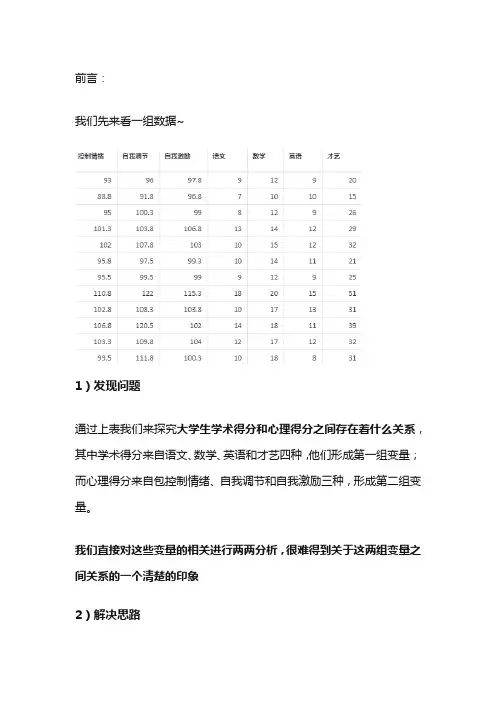
我们先来看一组数据~
1)发现问题
通过上表我们来探究大学生学术得分和心理得分之间存在着什么关系,其中学术得分来自语文、数学、英语和才艺四种,他们形成第一组变量;而心理得分来自包控制情绪、自我调节和自我激励三种,形成第二组变量。
我们直接对这些变量的相关进行两两分析,很难得到关于这两组变量之间关系的一个清楚的印象
2)解决思路 因此,我们需要把多个变量与多个变量之间的相关化为两个具有代表性的变量之间的相关
3)选出代表
代表:能较为综合、全面的衡量所在组的内在规律
一组变量最简单的综合形式就是该组变量的线性组合
1 典型相关分析
1.1 定义
典型相关分析是研究两个多变量(向量)之间之间的线性相关关系,能够揭示出两组变量之间的内在联系。
在一元统计分析中,用相关系数来衡量两个随机变量的线性相关关系,用复相关系数研究一个随机变量与多个随机变量的线性相关关系。然而,这些方法均无法用于研究两组变量之间的相关关系,于是提出了CCA
一般有两个典型的目的:
1. 数据简化:用少量的线性组合来解释两组变量之间的相关作用。
2.
数据解释:寻找特征值,这些特征值对于解释两个变量集合之间的相互作用十分关键。
. 与主成分分析(PCA)之间的关系:
典型相关分析的基本思想和主成分分析的基本思想相似,它将一组变量与另一组变量之间单变量的多重线性相关性研究,转换为少数几对综合变量之间的简单线性相关性的研究,并且这少数几对变量所包含的线性相关性的信息几乎覆盖了原变量组所包含的全部相应信息。
联系:无论是典型相关分析还是主成分分析,都是线性分析的范畴,一组变量的典型变量和其主成分都是经过线性变换,通过计算矩阵的特征值与特征向量得出的。
区别:主成分分析中只涉及一组变量的相互依赖关系,而典型相关则扩展到了两组变量之间的相互依赖的关系之中,度量了这两组变量之间联系的强度。
1.2 分析步骤
1.
首先在每组变量中找到变量的线性组合,使得两组的线性组合之间具有最大的相关系数。
典型相关分析报告
典型相关分析报告
典型相关分析是一种统计分析方法,用于探索两个变量集之间的关联性。典型相关分析报告通常包含以下内容:
1. 研究目的和背景:介绍研究目的、问题背景和研究假设。
2. 数据收集和描述统计分析:描述数据收集过程,包括样本选择、数据收集方式等。给出变量的描述统计指标,如均值、标准差等。
3. 相关性分析:使用Pearson相关系数或Spearman相关系数等方法,计算两个变量集之间的相关性。分析结果包括相关系数大小和统计显著性。
4. 典型相关方程:使用典型相关分析方法,建立典型相关方程,给出典型相关系数和解释方程的意义。
5. 判定系数:给出典型相关方程的判定系数,用于评估模型的拟合程度。
6. 解释和讨论:解释典型相关方程的结果,讨论两个变量集之间的关系和影响因素。分析结果可以结合相关文献进行解释和比较。
7. 结论和建议:总结研究结果,给出结论并提出进一步研究的建议。
需要注意的是,在编写典型相关分析报告时,应注意结果的客观性和准确性,同时要遵循科学研究的规范和方法。
典型相关分析 4
未知驱动探索,专注成就专业
1
典型相关分析
简介
典型相关分析(canonical correlation analysis, CCA)是一种多变量统计分析方法,用于研究两组观测变量之间的相关性。该方法可以帮助我们理解两组变量之间的线性关系,并找出两组变量中最相关的部分。在机器学习、数据挖掘以及统计学中,典型相关分析被广泛应用于特征选择、降维和模式识别等领域。
方法
典型相关分析是基于矩阵分解的方法,通过将两组变量转化成低秩的典型变量来寻找相关性。典型相关分析的基本思想是找出两组变量的线性组合,使得这两个组合能够达到最大的相关性。具体而言,给定两组变量X和Y,我们可以得到X的线性组合u和Y的线性组合v,使得cor(u,v)达到最大。其中cor(u,v)表示两个向量u和v的相关系数。典型相关分析的目标即是求解出使得cor(u,v)最大的u和v。
下面是典型相关分析的数学表示形式:
max cor(u,v)
subject to u = Xa, v = Yb 未知驱动探索,专注成就专业
2
其中,X和Y分别是两组变量的矩阵,u和v是X和Y的线性组合,a和b是权重向量。通过求解最优化问题,我们可以得到最相关的线性组合u和v,从而得到最相关的部分。
应用
典型相关分析广泛应用于多个领域,下面列举了几个常见的应用场景:
特征选择
在特征选择中,我们经常面临着从大量的特征中选取最相关的特征集合。典型相关分析可以帮助我们通过寻找两组变量之间的相关性,筛选出对目标变量有着较强相关性的特征。通过选择最相关的特征,我们可以提高模型的泛化能力,并降低过拟合的风险。
降维
在大数据时代,数据维度高维且复杂。降维可以帮助我们减少计算负担,并去除冗余信息。典型相关分析可以通过找出两组变量最相关的部分,将原始多维数据降到低维空间。这样做可以减少计算复杂度,提高模型的训练速度,并帮助我们更好地理解数据之间的关系。 未知驱动探索,专注成就专业
典型相关分析(CCA)简介
典型相关分析(CCA)简介
在现代统计学和数据分析领域,典型相关分析(Canonical
Correlation Analysis,CCA)是一种重要的方法,用于研究和揭示多变量之间的关系。当我们面对多组变量时,传统的相关性分析往往无法完全捕捉不同变量之间的复杂关联。典型相关分析为解决这一问题提供了一种有效的工具,尤其适用于社会科学、心理学、医学和市场研究等领域。本文将对典型相关分析的基本概念、原理、计算方法及其应用进行详细介绍。
典型相关分析的基本概念
典型相关分析是一种多变量统计技术,它旨在找出两组变量之间的关系结构。具体而言,假设我们有两组变量,分别为 (X) 和 (Y),其中 (X) 包含(p)个变量,(Y)包含(q)个变量。典型相关分析的目标是通过线性组合找出两个线性组合使得这两个组合之间的相关性最大化。
更具体地说,我们希望找到以下形式的线性组合: - (U =
a_1X_1 + a_2X_2 + … + a_pX_p) - (V = b_1Y_1 + b_2Y_2 + … +
b_qY_q)
使得 (U) 和 (V) 之间的相关系数达到最大值,继而进一步探索
(U) 和 (V) 与原始变量之间的联系。 CCA 的基本原理
典型相关分析建立在协方差矩阵基础上。在进行 CCA 前,我们通常会首先计算 (X) 和 (Y) 的协方差矩阵。然后,我们需要解一个特征值问题,通过特征根和特征向量来捕捉到不同线性组合下变量间的典型相关性。
整个过程可以分为以下几个步骤:
计算协方差矩阵:首先计算系列变数X与Y的样本均值,然后构建对应的协方差矩阵。
求解特征值问题:通过构造一个标准特征值问题 ((X,Y){}(Y)b
= (X,X){}a),来得到特征值与特征向量。
提取典型相关系数:根据特征值计算出对应的典型相关系数,通过这些系数可以判断两个组变量之间关系强度。
解释结果:通过不同组合下所得到的典型变量,进一步理解各组变量间更深层次的联系和相互影响.
典型相关分析 5
博学笃行 自强不息
1
典型相关分析
典型相关分析是一种统计学方法,用于研究两组变量之间的关系。典型相关分析可以帮助我们了解这两组变量之间的相互关系以及它们是否能够彼此预测。在本文中,我们将探讨典型相关分析的基本概念、应用场景、计算方法以及结果的解释和解读。
典型相关分析,又称为典型相关系数分析,是一种多变量统计技术,它可以在两组变量之间寻找最具相关性的线性组合,这个线性组合被称为典型变量。典型相关分析的核心思想是将两组变量转化为一组最具相关性的综合变量,以便探索和解释它们之间的关系。
典型相关分析通常用于探索两组变量之间的关系,并确定是否存在一个或多个典型相关系数。在许多实际应用中,这些变量可能代表相互关联的特征或维度,比如市场规模和销售额、学习时间和考试成绩等。
典型相关分析可以用于许多领域的研究。例如,在市场研究中,我们可以使用典型相关分析来研究不同市场因素之间的关系,并确定市场的发展趋势。在教育研究中,我们可以使用典型相关分析来研究学生的学习习惯和学术成绩之间的关系,以帮助教育者改进教学方法和学习环境。
博学笃行 自强不息
2
接下来,我们将介绍典型相关分析的计算方法。假设我们有两组变量X和Y,其中X包含p个变量,Y包含q个变量。首先,我们计算X和Y的样本协方差矩阵SXX和SYY,以及它们之间的协方差矩阵SXY。然后,我们对SXX和SYY进行特征值分解,得到它们的特征向量和特征值。接下来,我们选择最大的r个特征值和对应的特征向量。最后,我们计算典型相关系数以及典型变量。
结果的解释和解读是典型相关分析的最后一步。典型相关系数的取值范围为-1到1,其中取值为1表示两组变量之间存在完全正相关的关系,取值为-1表示存在完全负相关的关系,取值为0表示两组变量之间不存在相关性。此外,我们还可以通过检验统计量来判断典型相关系数是否显著。
总结起来,典型相关分析是一种统计学方法,用于研究两组变量之间的关系。它可以帮助我们了解这两组变量之间的相互关系以及它们是否能够彼此预测。典型相关分析常用于市场研究、教育研究等领域。计算典型相关系数需要进行计算和特征值分解等步骤。最后,通过解释和解读典型相关系数,我们可以得出结论并判断其是否显著。
典型相关分析(CCA)简介 2
典型相关分析(CCA)简介
典型相关分析(Canonical Correlation Analysis,CCA)是一种多变量统计分析方法,用于研究两组变量之间的关系。它可以帮助我们理解两组变量之间的相关性,并找到它们之间的最大相关方向。本文将对CCA的原理、应用和计算方法进行简要介绍。
一、CCA的原理
CCA的基本思想是将两组变量进行线性组合,使得两组变量的相关性最大化。具体来说,假设我们有两组变量X和Y,其中X包含p个变量,Y包含q个变量。我们可以将X和Y分别表示为X = [X1, X2, ...,
Xp]和Y = [Y1, Y2, ..., Yq],其中Xi和Yi分别表示X和Y的第i个变量。
CCA的目标是找到两个线性组合,分别为U和V,使得它们之间的相关性最大化。我们可以将U和V表示为U = a1X + a2X + ... + apX和V = b1Y + b2Y + ... + bqY,其中ai和bi是系数。通过最大化U和V之间的相关性,我们可以得到最大的典型相关系数。
二、CCA的应用
CCA在多个领域中都有广泛的应用。以下是一些常见的应用领域:
1. 生物医学研究:CCA可以用于分析基因表达数据和临床数据之间的关系,帮助研究人员理解基因与疾病之间的关联。
2. 金融领域:CCA可以用于分析不同金融指标之间的关系,帮助投资者进行资产配置和风险管理。 3. 语音识别:CCA可以用于分析语音信号和语音特征之间的关系,帮助改进语音识别系统的性能。
4. 图像处理:CCA可以用于分析图像特征和图像内容之间的关系,帮助改进图像检索和图像分类算法。
三、CCA的计算方法
CCA的计算方法可以分为两个步骤:特征提取和典型相关分析。
1. 特征提取:在CCA中,我们需要对原始数据进行特征提取,以便得到更具代表性的特征。常用的特征提取方法包括主成分分析(PCA)和线性判别分析(LDA)等。