
统计学第四版第七章答案
第四章 抽样分布与参数估计
某快餐店想要估计每位顾客午餐的平均花费金额。在为期3周的时间里选取49名顾客组成了一个简单随机样本。
(1)假定总体标准差为15元,求样本均值的抽样标准误差。
xn1549=
(2)在95%的置信水平下,求边际误差。
xxt,由于是大样本抽样,因此样本均值服从正态分布,因此概率度t=2z
因此,xxt2xz0.025xz=×=
(3)如果样本均值为120元,求总体均值 的95%的置信区间。
置信区间为:
,xxxx=1204.2,1204.2=(,)
从总体中抽取一个n=100的简单随机样本,得到x=81,s=12。
要求:
大样本,样本均值服从正态分布:2,xNn:或2,sxNn:
置信区间为:22,ssxzxznn,sn=12100=
(1)构建的90%的置信区间。
2z=0.05z=,置信区间为:811.6451.2,811.6451.2=(,)
(2)构建的95%的置信区间。
2z=0.025z=,置信区间为:811.961.2,811.961.2=(,)
(3)构建的99%的置信区间。
2z=0.005z=,置信区间为:812.5761.2,812.5761.2=(,)
某大学为了解学生每天上网的时间,在全校7 500名学生中采取重复抽样方法随机抽取36人,调查他们每天上网的时间,得到下面的数据(单位:小时):
求该校大学生平均上网时间的置信区间,置信水平分别为90%,95%和99%。
解: (1)样本均值x=,样本标准差s=;
(2)抽样平均误差:
重复抽样:x=nsn=6=
不重复抽样:x=1NnNn1sNnNn=1.617500367500136
=×0.995=×=
(3)置信水平下的概率度:
1=,t=2z=0.05z=
1=,t=2z=0.025z=
1=,t=2z=0.005z=
(4)边际误差(极限误差):
2xxxtz
1=,2xxxtz=0.05xz
重复抽样:2xxz=0.05xz=×=
不重复抽样:2xxz=0.05xz=×=
1=,2xxxtz=0.025xz
重复抽样:2xxz=0.025xz=×=
不重复抽样:2xxz=0.025xz=×=
1=,2xxxtz=0.005xz
重复抽样:2xxz=0.005xz=×=
不重复抽样:2xxz=0.005xz=×=
(5)置信区间:
,xxxx
1=,
重复抽样:,xxxx=3.320.441,3.320.441=(,) 不重复抽样:,xxxx=3.320.439,3.320.439=(,)
1=,
重复抽样:,xxxx=3.320.525,3.320.525=(,)
不重复抽样:,xxxx=3.320.441,3.320.441=(,)
1=,
重复抽样:,xxxx=3.320.69,3.320.69=(,)
不重复抽样:,xxxx=3.320.688,3.320.688=(,)
某居民小区为研究职工上班从家里到单位的距离,抽取了由16个人组成的一个随机样本,他们到单位的距离(单位:km)分别是:
10 3 14 8 6 9 12 11 7 5 10 15 9 16 13 2
假定总体服从正态分布,求职工上班从家里到单位平均距离的95%的置信区间。
解:小样本,总体方差未知,用t统计量
xtsn1tn:
均值=,样本标准差s=
置信区间:
221,1ssxtnxtnnn
1=,n=16,21tn=0.02515t=
221,1ssxtnxtnnn
=4.114.119.3752.13,9.3752.131616=(,)
7.11 某企业生产的袋装食品采用自动打包机包装,每袋标准重量为l00g。现从某天生产的一批产品中按重复抽样随机抽取50包进行检查,测得每包重量(单位:g)如下:
每包重量(g) 包数
96~98
98~100
100~102
102~104
104~106 2
3
34
7
4
合计 50 已知食品包重量服从正态分布,要求:
(1)确定该种食品平均重量的95%的置信区间。
解:大样本,总体方差未知,用z统计量
xzsn0,1N:
样本均值=,样本标准差s=
置信区间:
22,ssxzxznn
1=,2z=0.025z=
22,ssxzxznn
=1.8291.829101.41.96,101.41.965050=(,)
(2)如果规定食品重量低于l00g属于不合格,确定该批食品合格率的95%的置信区间。
解:总体比率的估计
大样本,总体方差未知,用z统计量
1pzppn0,1N:
样本比率=(50-5)/50=
置信区间:
2211,pppppzpznn
1=,2z=0.025z=
2211,pppppzpznn
=0.910.90.910.90.91.96,0.91.965050=(,)
7.13 一家研究机构想估计在网络公司工作的员工每周加班的平均时间,为此随机抽取了18个员工。得到他们每周加班的时间数据如下(单位:小时):
6
3 21
8 17
12 20
11 7
9 0
21 8
25 16
15 29
16 假定员工每周加班的时间服从正态分布。估计网络公司员工平均每周加班时间的90%的置信区间。
解:小样本,总体方差未知,用t统计量
xtsn1tn:
均值=,样本标准差s=
置信区间:
221,1ssxtnxtnnn
1=,n=18,21tn=0.0517t=
221,1ssxtnxtnnn
=7.8017.80113.561.7369,13.561.73691818=(,)
7.15 在一项家电市场调查中.随机抽取了200个居民户,调查他们是否拥有某一品牌的电视机。其中拥有该品牌电视机的家庭占23%。求总体比例的置信区间,置信水平分别为90%和95%。
解:总体比率的估计
大样本,总体方差未知,用z统计量
1pzppn0,1N:
样本比率=
置信区间:
2211,pppppzpznn
1=,2z=0.025z=
2211,pppppzpznn
=0.2310.230.2310.230.231.645,0.231.645200200
=(,)
1=,2z=0.025z= 2211,pppppzpznn
=0.2310.230.2310.230.231.96,0.231.96200200=(,)
7.20 顾客到银行办理业务时往往需要等待一段时间,而等待时间的长短与许多因素有关,比如,银行业务员办理业务的速度,顾客等待排队的方式等。为此,某银行准备采取两种排队方式进行试验,第一种排队方式是:所有顾客都进入一个等待队列;第二种排队方式是:顾客在三个业务窗口处列队三排等待。为比较哪种排队方式使顾客等待的时间更短,银行各随机抽取10名顾客,他们在办理业务时所等待的时间(单位:分钟)如下:
方式1
方式2 10
要求:
(1)构建第一种排队方式等待时间标准差的95%的置信区间。
解:估计统计量
2221~1nSn
经计算得样本标准差22s=
置信区间:
222222121111nSnSnn
1=,n=10,221n=20.0259=,2121n=20.9759=
222221211,11nSnSnn=90.227290.2272,19.022.7=(,)
因此,标准差的置信区间为(,)
(2)构建第二种排队方式等待时间标准差的95%的置信区间。
解:估计统计量
2221~1nSn
经计算得样本标准差21s=
置信区间:
222222121111nSnSnn
《统计学》-第7章-习题答案
第七章思考与练习参考答案
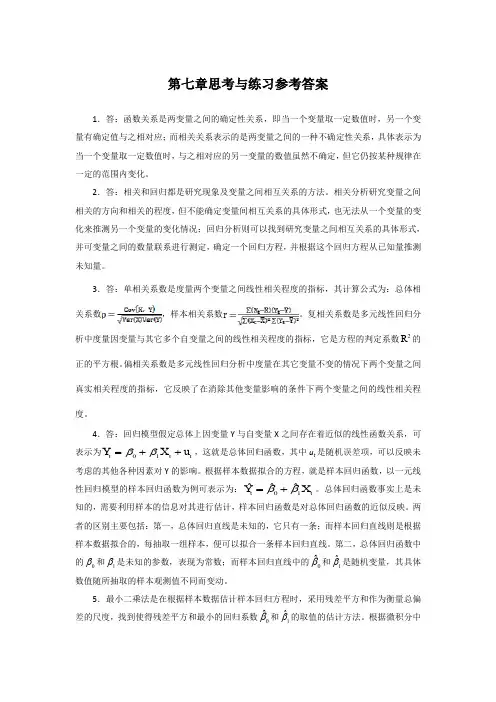
1.答:函数关系是两变量之间的确定性关系,即当一个变量取一定数值时,另一个变量有确定值与之相对应;而相关关系表示的是两变量之间的一种不确定性关系,具体表示为当一个变量取一定数值时,与之相对应的另一变量的数值虽然不确定,但它仍按某种规律在一定的范围内变化。
2.答:相关和回归都是研究现象及变量之间相互关系的方法。相关分析研究变量之间相关的方向和相关的程度,但不能确定变量间相互关系的具体形式,也无法从一个变量的变化来推测另一个变量的变化情况;回归分析则可以找到研究变量之间相互关系的具体形式,并可变量之间的数量联系进行测定,确定一个回归方程,并根据这个回归方程从已知量推测未知量。
3.答:单相关系数是度量两个变量之间线性相关程度的指标,其计算公式为:总体相关系数,样本相关系数。复相关系数是多元线性回归分析中度量因变量与其它多个自变量之间的线性相关程度的指标,它是方程的判定系数2R的正的平方根。偏相关系数是多元线性回归分析中度量在其它变量不变的情况下两个变量之间真实相关程度的指标,它反映了在消除其他变量影响的条件下两个变量之间的线性相关程度。
4.答:回归模型假定总体上因变量Y与自变量X之间存在着近似的线性函数关系,可表示为tttuXY10,这就是总体回归函数,其中ut是随机误差项,可以反映未考虑的其他各种因素对Y的影响。根据样本数据拟合的方程,就是样本回归函数,以一元线性回归模型的样本回归函数为例可表示为:ttXY10ˆˆˆ。总体回归函数事实上是未知的,需要利用样本的信息对其进行估计,样本回归函数是对总体回归函数的近似反映。两者的区别主要包括:第一,总体回归直线是未知的,它只有一条;而样本回归直线则是根据样本数据拟合的,每抽取一组样本,便可以拟合一条样本回归直线。第二,总体回归函数中的0和1是未知的参数,表现为常数;而样本回归直线中的0ˆ和1ˆ是随机变量,其具体数值随所抽取的样本观测值不同而变动。
072统计学第七章

第七章 第二部分 28~37题
28、从一批由45件正品、5件次品组成的产品中,任意抽取3件产品,求下列事件的概率:(1)恰有1件次品;(2)至少有1件次品;(3)最多有2件次品。
解:
(1)恰有1件次品:35024515CCC=0.25255102
(2)至少有1件次品:1-350345CC=0.2760205
(3)最多有2件次品:3502514535015245350345CCCCCCCC=0.99948968
29.某电冰箱厂生产某种型号的电冰箱,压缩机的使用寿命服从均值为10年,标准差为2年的正态分布。回答如下问题:(1)求整批电冰箱压缩机的使用寿命大于9年的比重; (2)求整批电冰箱压缩机的使用寿命介于9~11年的比重;(3)该厂为了提高产品竞争力,对电冰箱压缩机在保用期内的故障实行免费换新,预计免费换新的比重为1%,试确定该厂电冰箱压缩机免费换新的保用年限。
解:X~N(10,22),
(1)P(X>9)=p(210x>2109)
=φ(Z>-0.5)
=1-φ(-0.5)
=φ(0.5)
=0.6915
(2)P(9≤X≤11)
=P(2109≤210X≤21011)
=φ(-0.5≤X≤0.5)
=2φ(0.5)-1
=0.3830
30、某保险公司多年的统计资料表明,在索赔户中,被盗索赔占20%。以X表示在随机抽样调查中的100个索赔户,因被盗向保险公司索赔的户数:(1)写出X的概率分布;(2)利用中心极限定理,求被盗索赔户不少于14且不多于30户的概率近似值。
解:
(1)由题可知,X~B(100,0.2),其概率分布为:kkkCkXP100100)8.0()2.0()(,k=1,2,3……100
(2) E(X)=np=100×0.2=20
D(X)=npq=100×0.2×0.8=16
统计学课后简答题答案

第一章思考题
什么是统计学
统计学是关于数据的一门学科,它收集,处理,分析,解释来自各个领域的数据并从中得出结论.
解释描述统计和推断统计
描述统计;它研究的是数据收集,处理,汇总,图表描述,概括与分析等统计方法.
推断统计;它是研究如何利用样本数据来推断总体特征的统计方法.
统计学的类型和不同类型的特点
统计数据;按所采用的计量尺度不同分;
(定性数据)分类数据:只能归于某一类别的非数字型数据,它是对事物进行分类的结果,数据表现为类别,用文字来表述;
(定性数据)顺序数据:只能归于某一有序类别的非数字型数据.它也是有类别的,但这些类别是有序的.
(定量数据)数值型数据:按数字尺度测量的观察值,其结果表现为具体的数值.
统计数据;按统计数据都收集方法分;
观测数据:是通过调查或观测而收集到的数据,这类数据是在没有对事物人为控制的条件下得到的.
实验数据:在实验中控制实验对象而收集到的数据.
统计数据;按被描述的现象与实践的关系分;
截面数据:在相同或相似的时间点收集到的数据,也叫静态数据.
时间序列数据:按时间顺序收集到的,用于描述现象随时间变化的情况,也叫动态数据.
第二章思考题
什么是二手资料 使用二手资料应注意什么问题
与研究内容有关,由别人调查和试验而来已经存在,并会被我们利用的资料为“二手资料”.使用时要进行评估,要考虑到资料的原始收集人,收集目的,收集途径,收集时间使用时要注明数据来源.
比较概率抽样和非概率抽样的特点,指出各自适用情况
概率抽样:抽样时按一定的概率以随机原则抽取样本.每个单位别抽中的概率已知或可以计算,当用样本对总体目标量进行估计时,要考虑到每个单位样本被抽到的概率.技术含量和成本都比较高.如果调查目的在于掌握和研究对象总体的数量特征,得到总体参数的置信区间,就使用概率抽样.
非概率抽样:操作简单,时效快,成本低,而且对于抽样中的统计学专业技术要求不是很高.它适合探索性的研究,调查结果用于发现问题,为更深入的数量分析提供准备.它同样使用市场调查中的概念测试(不需要调查结果投影到总体的情况).
国开作业实用卫生统计学-第七章 四格表 自测练习16参考(含答案)
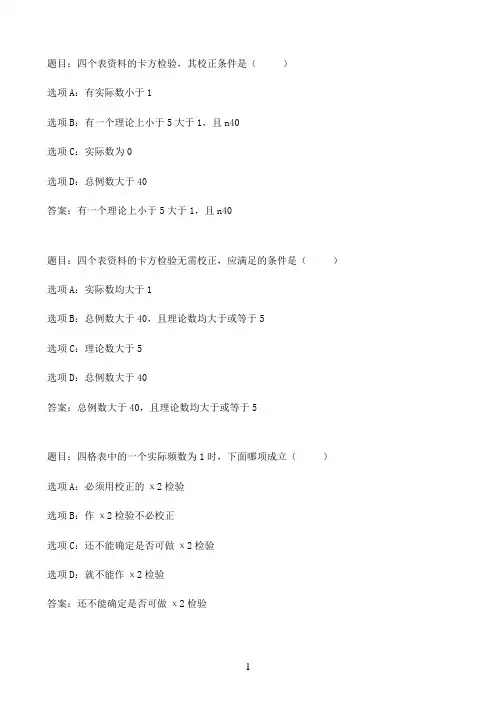
题目:四个表资料的卡方检验,其校正条件是( )
选项A:有实际数小于1
选项B:有一个理论上小于5大于1,且n40
选项C:实际数为0
选项D:总例数大于40
答案:有一个理论上小于5大于1,且n40
题目:四个表资料的卡方检验无需校正,应满足的条件是( )
选项A:实际数均大于1
选项B:总例数大于40,且理论数均大于或等于5
选项C:理论数大于5
选项D:总例数大于40
答案:总例数大于40,且理论数均大于或等于5
题目:四格表中的一个实际频数为1时,下面哪项成立( )
选项A:必须用校正的χ2检验
选项B:作χ2检验不必校正
选项C:还不能确定是否可做χ2检验
选项D:就不能作χ2检验
答案:还不能确定是否可做χ2检验
题目:作两样本率的假设检验,其检验假设是?( )
选项A:/uploads/01337/images/unit7/x.png1=/uploads/01337/images/unit7/x.png2
选项B:π1=π2
选项C:P1=P2
选项D:/uploads/01337/images/unit5/zsd_11.png=/uploads/01337/images/unit5/zsd_11.png0
答案:π1=π2
题目:两个四格表一个χ2χ20.01,1,另一个χ2χ20.05,1,可认为以下哪项正确?( )
选项A:后者者更有理由认为两总体率不同
选项B:前者更有理由认为两总体率不同
选项C:后者两个百分数相差较大
选项D:前者两个百分数相差较大
答案:前者更有理由认为两总体率不同
题目:若n≤40,或1T≤5时,需用确切概率计算法
选项A:对
选项B:错
答案:错
《统计学原理》第七章习题-河南电大-贾天骐
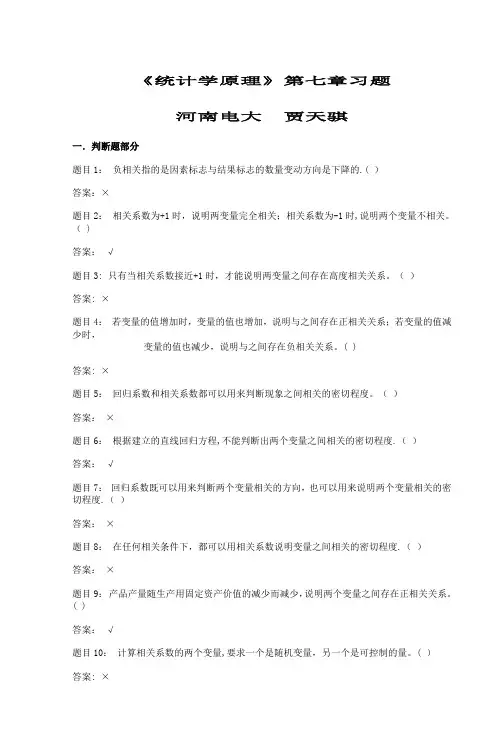
《统计学原理》第七章习题
河南电大 贾天骐
一.判断题部分
题目1: 负相关指的是因素标志与结果标志的数量变动方向是下降的.( )
答案:×
题目2: 相关系数为+1时,说明两变量完全相关;相关系数为-1时,说明两个变量不相关。( )
答案: √
题目3: 只有当相关系数接近+1时,才能说明两变量之间存在高度相关关系。( )
答案: ×
题目4: 若变量的值增加时,变量的值也增加,说明与之间存在正相关关系;若变量的值减少时,
变量的值也减少,说明与之间存在负相关关系。( )
答案: ×
题目5: 回归系数和相关系数都可以用来判断现象之间相关的密切程度。( )
答案: ×
题目6: 根据建立的直线回归方程,不能判断出两个变量之间相关的密切程度.( )
答案: √
题目7: 回归系数既可以用来判断两个变量相关的方向,也可以用来说明两个变量相关的密切程度.( )
答案: ×
题目8: 在任何相关条件下,都可以用相关系数说明变量之间相关的密切程度.( )
答案: ×
题目9: 产品产量随生产用固定资产价值的减少而减少,说明两个变量之间存在正相关关系。( )
答案: √
题目10: 计算相关系数的两个变量,要求一个是随机变量,另一个是可控制的量。( )
答案: ×
题目11: 完全相关即是函数关系,其相关系数为±1。( )
答案:√
题目12: 估计标准误是说明回归方程代表性大小的统计分析指标,指标数值越大,
说明回归方程的代表性越高。( )
答案 ×
二.单项选择题部分
题目1:当自变量的数值确定后,因变量的数值也随之完全确定,这种关系属于( )。
A。相关关系 B.函数关系 C.回归关系 D。随机关系
答案:B
题目2:现象之间的相互关系可以归纳为两种类型,即( )。
A。相关关系和函数关系 B。相关关系和因果关系
统计学课后练答案
第七章 参数估计
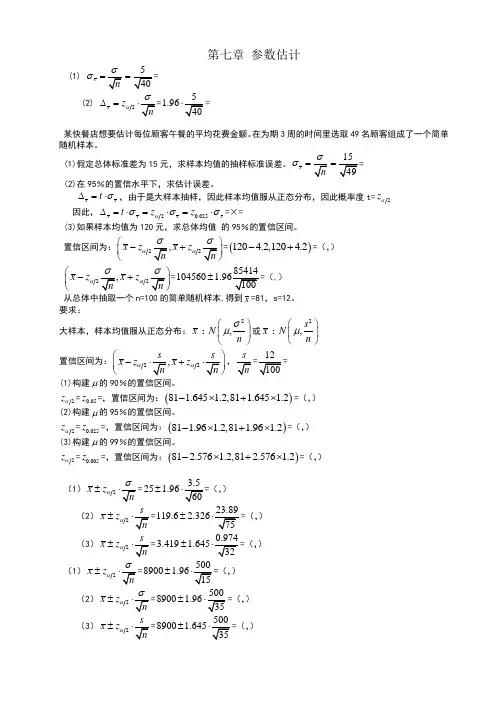
(1) xn540=
(2) 2xzn=51.9640=
某快餐店想要估计每位顾客午餐的平均花费金额。在为期3周的时间里选取49名顾客组成了一个简单随机样本。
(1)假定总体标准差为15元,求样本均值的抽样标准误差。xn1549=
(2)在95%的置信水平下,求估计误差。
xxt,由于是大样本抽样,因此样本均值服从正态分布,因此概率度t=2z
因此,xxt2xz0.025xz=×=
(3)如果样本均值为120元,求总体均值 的95%的置信区间。
置信区间为:22,xzxznn=1204.2,1204.2=(,)
22,xzxznn=854141045601.96100=(,)
从总体中抽取一个n=100的简单随机样本,得到x=81,s=12。
要求:
大样本,样本均值服从正态分布:2,xNn:或2,sxNn:
置信区间为:22,ssxzxznn,sn=12100=
(1)构建的90%的置信区间。
2z=0.05z=,置信区间为:811.6451.2,811.6451.2=(,)
(2)构建的95%的置信区间。
2z=0.025z=,置信区间为:811.961.2,811.961.2=(,)
(3)构建的99%的置信区间。
2z=0.005z=,置信区间为:812.5761.2,812.5761.2=(,)
(1)2xzn=3.5251.9660=(,)
(2)2sxzn=23.89119.62.32675=(,)
(3)2sxzn=0.9743.4191.64532=(,)
(1)2xzn=50089001.9615=(,)
统计学练习题及答案
第三章 数据分布特征的描述
1.下面是我国人口和国土面积资料:
────────┬───────────────
│根据第四人次人口普查调整数
指标 ├──────┬────────
│1982年 │ 1990年
────────┼──────┼────────
人口总数 │ 101654 │ 114333
男 │ 52352 │ 58904
女 │ 49302 │ 55429
────────┴──────┴────────
国土面积960万平方公里。
试计算所能计算的全部相对指标。
2.某企业2014年某产品单位成本520元,2015年计划规定在上年的基础上单位成
本降低5%,实际降低6%,试确定2015年单位成本的计划数与实际数,并计算2015年
单位成本比计划降低多少
3.某市共有50万人,其市区人口占85%,郊区人口占15%,为了解该市居民的
收入水平,在市区抽查了1500户居民,每人平均收入为1400元;在郊区抽查了1000
户居民,每人年平均收入为1380元,若这两个抽样数字具有代表性,则计算该市居
民年平均收入应采用哪一种形式的平均数方法进行计算
4.有两个班级统计学成绩如下:
按成绩分组 1班人数 2班人数
40以下
40—50
50—60
60—70
70—80
80—90
90以上 4
5
6
10
5
3
2 1
2
5
12
8
7
5
合计 35 40
根据上表资料计算:(1)哪个班级统计学成绩好(2)哪个班级的成绩分布差异大
管理统计学第7章习题解答
管理统计学第7章习题解答
习题7.1
1、 随机地从一批钉子中抽取10枚,测得长度(单位:cm)如下:
2.11,2.14,2.10,2.13,2.15,2.13,2.12,2.14,2.12,2.13
试求这批钉子长度总体均值μ及方差σ2的矩估计值,并求样本方差s2 .
解:X=101110iiX=2.127;2=10211()10iiXX=0.014182=0.000201;
1022211()0.014940.000229iisXX.
2、 设总体X服从几何分布,其分布律为:
P(X=k)=(1-p)k-1p,k=1,2,……,
其中p为未知参数,(X1,X2,…,Xn)是取自总体X的一个样本,求p的矩估计.
解:EX=1111(1)(1)kkkkkpppkp.
设11()kkfxkx,|x|<1. 01()1xkkxfxdxxx,/21()()1(1)xfxxx.
EX=1(1)pfpp,1pEX,1pX.
解:EX=1/λ, 所以λ的矩估计1X.再求λ的最大似然估计.
似然函数为
L(λ)= 111()niiinnxxniiifxee
(0
1ln()lnniiLnx (0
令
1ln()0niidLnxd,
从中解得1X ,此即为θ的最大似然估计.
习题7.2
1、设(X1,X2,…,X6)是取自总体X的一个样本,θ=E(X)为待估参数.问下列点估计中哪些是θ的无偏估计?
1123456(23456)/6XXXXXX
2123456(23456)/21XXXXXX
3123456()/6XXXXXX
《统计学原理》第七章习题河南电大贾天骐
.word可编辑.
. 专业.专注 . 《统计学原理》第七章习题
河南电大 贾天骐
一.判断题部分
题目1: 负相关指的是因素标志与结果标志的数量变动方向是下降的。( )
答案:×
题目2: 相关系数为+1时,说明两变量完全相关;相关系数为-1时,说明两个变量不相关。( )
答案: √
题目3: 只有当相关系数接近+1时,才能说明两变量之间存在高度相关关系。( )
答案: ×
题目4: 若变量x的值增加时,变量y的值也增加,说明x与y之间存在正相关关系;若变量x的值减少时,
y变量的值也减少,说明x与y之间存在负相关关系。( )
答案: ×
题目5: 回归系数和相关系数都可以用来判断现象之间相关的密切程度。( )
答案: ×
题目6: 根据建立的直线回归方程,不能判断出两个变量之间相关的密切程度。( )
答案: √ .word可编辑.
. 专业.专注 . 题目7: 回归系数既可以用来判断两个变量相关的方向,也可以用来说明两个变量相关的密切程度。( )
答案: ×
题目8: 在任何相关条件下,都可以用相关系数说明变量之间相关的密切程度。( )
答案: ×
题目9: 产品产量随生产用固定资产价值的减少而减少,说明两个变量之间存在正相关关系。( )
答案: √
题目10: 计算相关系数的两个变量,要求一个是随机变量,另一个是可控制的量。( )
答案: ×
题目11: 完全相关即是函数关系,其相关系数为±1。( )
答案:√
题目12: 估计标准误是说明回归方程代表性大小的统计分析指标,指标数值越大,
说明回归方程的代表性越高。( )
答案 ×
二.单项选择题部分
题目1:当自变量的数值确定后,因变量的数值也随之完全确定,这种关系属于( )。 .word可编辑.
. 专业.专注 . A.相关关系 B.函数关系 C.回归关系 D.随机关系
统计学课程作业(第七章)
《统计学》课程作业
第七章相关分析
一、单项选择题
1、当变量x按一定数值变化时,变量y也近似地按固定数值变化,这表明变量x和变量y之间存在着 ( )
A、完全相关关系 B、复相关关系 C、直线相关关系 D、函数关系
2. 相关系数的值范围 ( )
A、r B、11r C、11r D、01r
3、直线相关分析与直线回归分析的联系表现为 ( )
A、相关分析是回归分析的基础 B、回归分析是相关分析的基础
C、相关分析是回归分析的深入 D、相关分析与回归分析互为条件
4、在用一个回归方程进行估计推算时 ( )
A、只能用因变量推算自变量 B、只能用自变量推算因变量
C、既可用因变量推算自变量,也可用自变量推算因变量
D、不需要考虑因变量和自变量问题
5、如果估计标准误差0yxS,则表明 ( )
A、全部观测值和回归值都不相等 B、回归直线代表性小
C、全部观测值与回归值的离差之积为0 D、全部观测值都落在回归直线上
6、判断两个变量间相关关系的密切程度时,“显著相关”通常是指 ( )
A、5.03.0r B、8.05.0r C、18.0r D、高于0.5
7、在简单重复随机抽样条件下,欲使误差范围缩小一半,其他要求不变,则样本容量必须 ( )
A、增加2倍 B、增加3倍 C、减少2倍 D、减少3倍
8、在回归直线方程bxayc中,b表示 ( )