
oracle 100W行数据的秒级导入(SQLLOADER)
oracle 100W行数据的秒级导入(SQLLOADER).txt“我羡慕内些老人羡慕他们手牵手一直走到最后。
━交话费的时候,才发现自己的话那么值钱。
1.生成百万级的sql,保存SQL文件为getobject.sql
select
a.owner||',"'||a.object_name||'",'||a.object_id||','||to_char(a.created ,'yyyy-m m-dd hh24:mi:ss')||','||a.status
from dba_objects a,(select rownum from dual connect by rownum <= 20);
2.sql数据转换成数据文件,保存脚本为call.sql
set echo off
set term off
set trimout on
set trimspool on
set pagesize 0
set feedback off
set heading off
spool c:\getobject.csv
@c:\getobject.sql
set spool off
set heading on
set feedback on
set trimspool off
set trimout off
set term on
set echo on
注释:
set colsep' '; //-域输出分隔符
set echo off; //显示start启动的脚本中的每个sql命令,缺省为on
set echo on //设置运行命令是是否显示语句
set feedback on; //设置显示“已选择XX行”
set feedback off; //回显本次sql命令处理的记录条数,缺省为on
set heading off; //输出域标题,缺省为on
set pagesize 0; //输出每页行数,缺省为24,为了避免分页,可设定为0。
set linesize 80; //输出一行字符个数,缺省为80
set numwidth 12; //输出number类型域长度,缺省为10
set termout off; //显示脚本中的命令的执行结果,缺省为on
set trimout on; //去除标准输出每行的拖尾空格,缺省为off
set trimspool on; //去除重定向(spool)输出每行的拖尾空格,缺省为off
set serveroutput on; //设置允许显示输出类似dbms_output
set timing on; //设置显示“已用时间:XXXX”
set autotrace on-; //设置允许对执行的sql进行分析
set verify off //可以关闭和打开提示确认信息old 1和new 1的显
示.
3.运行call.sql 生成数据文件
sqlplus hxadmin/secret as sysdba;
@c:\call.sql
4.初始化环境,创建导入表OBjects
create table OBJECTS
(
OWNER VARCHAR2(50),
OBJECT_NAME VARCHAR2(50),
OBJECT_ID NUMBER,
STATUS VARCHAR2(10),
CREATED DATE
)
5.生成导入控制文件,保存控制文件为ldr_object.ctl
LOAD DATA
INFILE getobject.csv
TRUNCATE INTO TABLE OBJECTS
FIELDS TERMINATED BY "," OPTIONALLY ENCLOSED BY '"' TRAILING NULLCOLS (OWNER,
OBJECT_NAME,
OBJECT_ID,
CREATED date 'yyyy-mm-dd hh24:mi:ss',
STATUS)
6.执行sqlldr命令
C:> sqlldr hxadmin/secret control= ldr_object.ctl direct = true
7.查看ldr_object.log日志文件。
Oracle使用SqlLoad导入Excel大数据操作方法
Oracle使用SqlLoad导入Excel大数据操作方法第一步:按excel格式整理需要导入的源数据第二步:将excel表格另存为csv(逗号分割)格式。
第三步:用文本方式打开impfile.ctrl文件,修改里面的infile行为文件实际存放路径和名称,比如:infile 'c:\cust.csv'第四步:用文本方式打开impfile.ctrl文件,修改append into table 行后面加上要导入的表明,例如:append into table if_imp_card第五步:用文本方式打开impfile.ctrl文件,修改TRAILING NULLCOLS下面文本内容为表对应的字段和分割符(terminated by ','),最后一个字段用(terminated by whitespace),对于日期类型要在字段后定义上日期类型格式(Date(10) "YYYY-MM-DD"),例如:TRAILING NULLCOLS(oldtype terminated by ',',cardno terminated by ',',cardpwd terminated by ',',trackinfo terminated by ',',oldmkt terminated by ',',name terminated by ',',sex terminated by ',',cardflag terminated by ',',birthday Date(10) "YYYY-MM-DD" terminated by ',',idtype terminated by ',',idno terminated by ',',mindate Date(10) "YYYY-MM-DD" terminated by ',',maxdate Date(10) "YYYY-MM-DD" terminated by ',',ljjf terminated by ',',jfye terminated by ',',xfje terminated by ',',lczhye terminated by ',',flqye terminated by ',',addr terminated by ',',zipcode terminated by ',',tel terminated by ',',mobile terminated by whitespace)第六步:将impfile.ctl文件和要导入的csv数据文件拷贝到同一目录下,建议存放在盘符根目录;第七步:在CMD命令中输入oracle安装的bin路径,执行该命令执行如下指令:sqlldr userid=用户名/用户密码@数据库实例control=c:\impfile.ctl log=c:\impfile.log例如:D:\app\product\11.2.0\dbhome_1\BIN>sqlldr userid=dbusrif/future@crmls control=c:\impfile.ctl log=c:\impfile.log。
sqlloader导出数据和导入数据

sqlloader导出数据和导⼊数据分类: Oracle忙了⼀天终于把sqlloader导出数据和导⼊数据弄清楚了,累死俺了。
这个总结主要分为三个⼤部分,第⼀部分(实例,主要分两步),第⼆部分(参数⼩总结),第三部分(完全参数总结)第⼀部分第⼀步 :这是我的导出数据的脚本call.sqlconn scott/tigerset echo offset term offset line 1000 pages 0set feedback offset heading offset trimspool onspool /temp/test/ldr_test.csvselect a.empno||',"'||a.ename||'",'||to_char(a.hiredate,'yyyy-mm-dd hh24:mi:ss')||','||a.sal from test a;spool offset trimspool offset heading onset feedback onset term onset echo onexit注释:call.sql脚本执⾏⽅法 (1)sqlplus /nolog 先进⼊sqlplus命令模式(2)start call.sql 在sqlplus命令模式下执⾏第⼆步 :导⼊数据的脚本add_test.ctlLOAD DATAINFILE ldr_test.csvTRUNCATE INTO TABLE testFIELDS TERMINATED BY"," OPTIONALLY ENCLOSED BY'"'(EMPNO,ENAME,HIREDATE date 'yyyy-mm-dd hh24:mi:ss',SAL)注释: 在第⼀步导出数据后,执⾏add_test.sql脚本命令为: sqlplus scott/tiger control=add_test.ctl⾄此⽤sqlplus导⼊/出数据完成了,如果有些参数不明⽩,请看⼀下第⼆三部分。
oracle sqlload用法

oracle sqlload用法SQL*Loader 是 Oracle 数据库中一个用于高效地将大量数据加载到表中的工具。
它可以从文本文件、CSV 文件或其他数据库中加载数据,并将其插入到指定的表中。
以下是SQL*Loader 的用法:1. 创建控制文件:SQL*Loader 需要一个控制文件来指定数据的格式和加载方式。
控制文件可以手动创建,也可以使用Oracle Enterprise Manager 或 SQL Developer 等工具生成。
控制文件包含以下内容:- LOAD DATA:指定数据加载的语句。
- INFILE:指定要加载的数据文件的路径和名称。
- INTO TABLE:指定要加载数据的目标表的名称。
- FIELDS TERMINATED BY:指定字段之间的分隔符。
- TRAILING NULLCOLS:指定允许空列。
- 载入的列名和列数据类型。
2. 准备数据文件:需要准备一个包含要加载的数据的文本文件。
数据文件中的每一行对应表中一条记录,字段之间使用控制文件中指定的分隔符进行分隔。
3. 运行 SQL*Loader:打开命令行终端或 SQL*Plus 窗口,使用以下命令来运行 SQL*Loader:```sqlldr username/password@database control=controlfile.ctllog=logfilename.log```- `username/password`:Oracle 数据库的用户名和密码。
- `database`:要连接的数据库实例的名称。
- `control=controlfile.ctl`:指定控制文件的路径和名称。
- `log=logfilename.log`:指定日志文件的路径和名称。
4. 检查日志文件:SQL*Loader 在加载数据时会生成一个日志文件,用于记录加载过程中的错误和警告信息。
通过查看日志文件,可以了解加载过程中是否发生了错误,并可以根据其提供的信息进行调试和修复。
sqlloader的用法
sqlloader的用法sqlldr userid=system/password control=h:control.txtuserid是用户名和密码,control是控制文件位置。
下面是控制文件中的内容:load datainfile 'h:bbb.txt'--文本文件的位置append into table table_name ---#1FIELDS TERMINA TED BY ',' ----字段和字段之间的分隔符,如果使用X'09'代表是tab,是否是tab没有测试。
TRAILING NULLCOLS ------表的字段没有对应的值时允许为空(field1,field2,field3)---具体入库的表字段#1。
这里可以使用append、insert、replace和truncate,每个参数具体意义如下:APPEND 原先的表有数据就加在后面INSERT 装载空表如果原先的表有数据sqlloader会停止默认值REPLACE 原先的表有数据原先的数据会全部删除TRUNCA TE 指定的内容和replace的相同会用truncate语句删除现存数据用sqlloader也可以一次导入多个表中只要多加几个into就可以了,具体用法和insert的插入多个表用法类似。
入库的时候格式化也是可以的,可以参照外部表那篇文章。
用法二:数据文件:test1.txtSYSTEM , 40960SYSTEM , 40960SYSTEM , 323649536SYSTEM , 81920SYSTEM , 74350592SYSTEM , 65536SYSTEM , 81920SYSTEM , 40960SYSTEM , 40960SYSTEM , 19963904SYSTEM , 90112SYSTEM , 229376ZFAD , 11526144控制文件:input.ctlload datainfile 'test1.txt'append into table sum_dba_free_spacefields terminated by ','(tablespace_name,bytes)db建表:create table sum_dba_free_space(tablespace_name varchar2(30),bytes number) c:\>sqlldr scott/tiger control=input.ctl加载失败的log(同时会产生test.bad文件):c:\input.logSQL*Loader: Release 10.2.0.4.0 - Production on 星期五10月10 01:53:43 2008 Copyright (c) 1982, 2007, Oracle. All rights reserved.控制文件: input.ctl数据文件: test1.txt错误文件: test1.bad废弃文件: 未作指定(可废弃所有记录)要加载的数: ALL要跳过的数: 0允许的错误: 50绑定数组: 64 行, 最大256000 字节继续: 未作指定所用路径: 常规表SUM_DBA_FREE_SPACE,已加载从每个逻辑记录插入选项对此表APPEND 生效列名位置长度中止包装数据类型------------------------------ ---------- ----- ---- ---- ---------------------TABLESPACE_NAME FIRST * , CHARACTER BYTES NEXT * , CHARACTER表SUM_DBA_FREE_SPACE:6984 行加载成功。
sqlloader导入数据
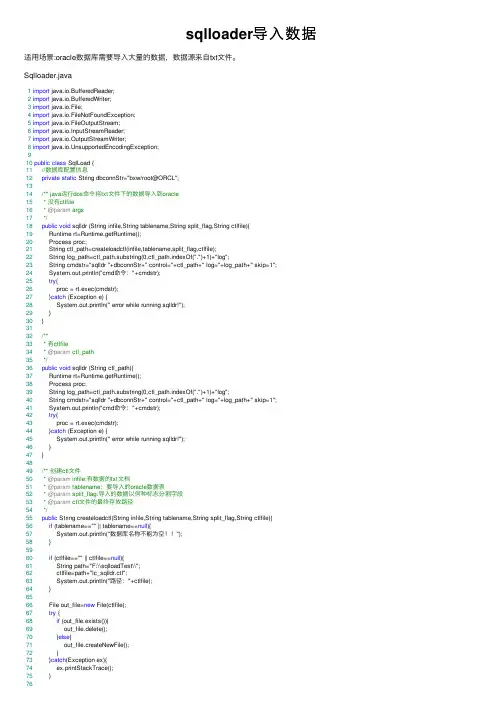
sqlloader导⼊数据适⽤场景:oracle数据库需要导⼊⼤量的数据,数据源来⾃txt⽂件。
Sqlloader.java1import java.io.BufferedReader;2import java.io.BufferedWriter;3import java.io.File;4import java.io.FileNotFoundException;5import java.io.FileOutputStream;6import java.io.InputStreamReader;7import java.io.OutputStreamWriter;8import java.io.UnsupportedEncodingException;910public class SqlLoad {11//数据库配置信息12private static String dbconnStr="bxw/root@ORCL";1314/** java运⾏dos命令将txt⽂件下的数据导⼊到oracle15 * 没有ctlfile16 * @param args17*/18public void sqlldr (String infile,String tablename,String split_flag,String ctlfile){19 Runtime rt=Runtime.getRuntime();20 Process proc;21 String ctl_path=createloadctl(infile,tablename,split_flag,ctlfile);22 String log_path=ctl_path.substring(0,ctl_path.indexOf(".")+1)+"log";23 String cmdstr="sqlldr "+dbconnStr+" control="+ctl_path+" log="+log_path+" skip=1";24 System.out.println("cmd命令:"+cmdstr);25try{26 proc = rt.exec(cmdstr);27 }catch (Exception e) {28 System.out.println(" error while running sqlldr!");29 }30 }3132/**33 * 有ctlfile34 * @param ctl_path35*/36public void sqlldr (String ctl_path){37 Runtime rt=Runtime.getRuntime();38 Process proc;39 String log_path=ctl_path.substring(0,ctl_path.indexOf(".")+1)+"log";40 String cmdstr="sqlldr "+dbconnStr+" control="+ctl_path+" log="+log_path+" skip=1";41 System.out.println("cmd命令:"+cmdstr);42try{43 proc = rt.exec(cmdstr);44 }catch (Exception e) {45 System.out.println(" error while running sqlldr!");46 }47 }4849/** 创建ctl⽂件50 * @param infile:有数据的txt⽂档51 * @param tablename:要导⼊的oracle数据表52 * @param split_flag:导⼊的数据以何种标志分割字段53 * @param ctl⽂件的最终存放路径54*/55public String createloadctl(String infile,String tablename,String split_flag,String ctlfile){56if (tablename=="" || tablename==null){57 System.out.println("数据库名称不能为空!!");58 }5960if (ctlfile=="" || ctlfile==null){61 String path="F:\\sqlloadTest\\";62 ctlfile=path+"lc_sqlldr.ctl";63 System.out.println("路径:"+ctlfile);64 }6566 File out_file=new File(ctlfile);67try {68if (out_file.exists()){69 out_file.delete();70 }else{71 out_file.createNewFile();72 }73 }catch(Exception ex){74 ex.printStackTrace();75 }7677/*78 * 编写ctlfile的格式79*/80 StringBuffer sb = new StringBuffer();81 sb.append("load data");82 sb.append("\n");83 sb.append("infile ");84 sb.append("'");85 sb.append(infile);86 sb.append("'");87 sb.append("\n");88 sb.append("append into table ");89 sb.append(tablename);90 sb.append("\n");91 sb.append("fields terminated by ");92 sb.append("'");93 sb.append(split_flag);94 sb.append("'");95 sb.append("\n");96 sb.append("(id,name,price,author,pubishdate DATE\"YYYY-MM-DD HH24:MI:SS\")"); 9798 String sbstr=sb.toString();99100 String ctlstr="load data"+"\n"+101 "infile "+"'"+infile+"'"+"\n"+102 "append into table "+tablename+"\n"+103 "fields terminated by "+"'"+split_flag+"'"+"\n"+104 "(id,name,price,author,pubishdate DATE\"YYYY-MM-DD HH24:MI:SS\")";105 System.out.println(ctlstr);106try{107//将数据库数据写⼊指定的txt⽂件108 File file = new File(ctlfile); //⾃定义⽂件路径109 OutputStreamWriter write;110//write = new OutputStreamWriter(new FileOutputStream(file),"UTF-8");111 write = new OutputStreamWriter(new FileOutputStream(file));112 BufferedWriter writer = new java.io.BufferedWriter(write);113 writer.write(ctlstr); // 输出流写⼊到⽂件中114 writer.close();115 write.close();116 }catch(UnsupportedEncodingException e){117 e.printStackTrace();118 }catch(FileNotFoundException e){119 e.printStackTrace();120 }catch(Exception ex){121 ex.printStackTrace();122 }123124return ctlfile;125 }126127public static void main(String[] args) {128 String infile="F:\\sqlloadTest\\data.txt";129 String tablename="book";130 String split_flag="|";131 String ctlfile="F:\\sqlloadTest\\lc_loader.ctl";132 SqlLoad loader=new SqlLoad();133 loader.sqlldr(infile, tablename, split_flag, ctlfile);134//loader.sqlldr(ctlfile);135 }136137 }。
数据库导入100万条数据的方法

数据库导入100万条数据的方法摘要:一、引言二、数据库导入100万条数据的方法1.选择合适的导入工具2.数据预处理3.批量导入策略4.处理并发和性能问题5.导入过程中的错误处理三、总结与展望正文:一、引言随着大数据时代的到来,处理大量数据已成为许多项目的基本需求。
在本篇中,我们将详细讨论如何高效地将100万条数据导入数据库。
数据库导入数据的方法有很多,但并非所有方法都适用于大规模数据。
接下来,我们将介绍一种适用于100万条数据导入的方法。
二、数据库导入100万条数据的方法1.选择合适的导入工具在导入大量数据时,选择合适的导入工具至关重要。
一些数据库管理系统(如MySQL、Oracle等)提供了批量导入功能,可以通过命令行或程序接口实现。
此外,还可以使用第三方工具,如Apache NiFi、Kettle等,进行数据导入。
2.数据预处理在导入数据前,应对数据进行预处理。
这包括数据清洗、格式转换、去重等操作。
数据预处理可以减少导入过程中的错误,提高数据质量。
3.批量导入策略针对100万条数据,可以采用分批导入的策略。
将数据分成小批次,每次导入一部分数据,以降低数据库的压力。
分批导入时,应注意控制每批数据的数量,避免一次性导入过多数据导致数据库崩溃。
4.处理并发和性能问题在导入过程中,可能会遇到并发和性能问题。
为解决这个问题,可以采用以下方法:a.限制并发导入任务数,避免过多任务争抢数据库资源。
b.对数据库表进行优化,如创建索引、调整字段类型等,提高数据导入速度。
c.控制导入速度,避免过快地往数据库中插入数据,导致数据库性能下降。
5.导入过程中的错误处理在数据导入过程中,可能会遇到各种错误,如数据格式错误、重复数据等。
为保证数据的正确性,应设置完善的错误处理机制。
例如:a.检测数据格式是否正确,如使用校验码、数据范围检查等方法。
b.检测数据是否重复,如有必要,可以使用数据库的唯一约束(如唯一索引)来避免重复数据。
sqlloader使用方法
sqlloader使用方法SQL*Loader是Oracle数据库提供的一种用于导入数据的工具,它可以通过读取数据文件,并将数据加载到Oracle表中。
本文将详细介绍SQL*Loader的使用方法。
一、准备工作在使用SQL*Loader之前,需要进行一些准备工作。
首先,需要创建一个数据文件,该文件包含要导入的数据。
其次,需要创建一个控制文件,该文件描述了数据文件的结构以及如何将数据加载到表中。
最后,需要确保已经创建了目标表,以便将数据加载到表中。
二、创建数据文件数据文件是包含要导入的数据的文本文件。
可以使用任何文本编辑器创建数据文件,确保数据文件的格式与要导入的表的字段格式相匹配。
每条记录应该占据一行,并且字段之间使用分隔符进行分隔。
三、创建控制文件控制文件是描述如何加载数据的文件。
它指定了数据文件的位置、格式以及要加载数据的表的结构。
控制文件是一个文本文件,可以使用任何文本编辑器进行创建。
以下是一个控制文件的示例:LOAD DATAINFILE 'data.txt'INTO TABLE employeesFIELDS TERMINATED BY ','(emp_id, emp_name, emp_salary)上述示例中,LOAD DATA表示开始数据加载。
INFILE指定了数据文件的路径和名称。
INTO TABLE指定了要将数据加载到的表的名称。
FIELDS TERMINATED BY指定了字段之间的分隔符。
括号中的内容是表中的字段列表,用于指定数据文件中各个字段的顺序。
四、执行SQL*Loader执行SQL*Loader需要使用命令行界面。
打开命令行界面,并进入SQL*Loader的安装目录。
然后使用以下命令执行SQL*Loader:sqlldr username/password@database control=controlfile.ctl上述命令中,username是Oracle数据库的用户名,password是密码,database是数据库的连接字符串,controlfile.ctl是控制文件的路径和名称。
数据库快速参入百万数据的方法
数据库快速参入百万数据的方法如果您需要在数据库中快速插入大量数据,这通常涉及到的关键点是如何高效地将数据传输到数据库。
以下是一些方法可以帮助您在数据库中快速插入百万级别的数据:1. 批量插入:•批量插入大量数据时,每次插入的数据量越多,性能通常越好。
大多数数据库系统支持批量插入,而不是单条插入。
例如,在MySQL中,您可以使用的形式一次性插入多行数据。
禁用索引和约束:•在插入大量数据时,暂时禁用索引和约束可以提高性能。
完成插入后,您可以重建索引并应用约束。
在MySQL中,您可以使用来禁用索引,使用来禁用外键约束。
调整数据库配置:•根据您的数据库,调整相关的配置参数以获得更好的性能。
例如,调整缓存大小、I/O参数、连接池等。
分批插入:•如果数据量非常大,您可以考虑将数据分成较小的批次进行插入。
这样可以在不耗尽系统资源的情况下完成操作。
使用适当的文件格式:•如果您从文件中导入数据,使用CSV或JSON等格式可能比纯文本更有效,特别是当数据库支持这些格式的导入工具时。
并行处理:•如果您的系统支持并行处理,考虑同时从多个源或多个进程插入数据。
使用专业的ETL工具:•一些ETL(提取、转换、加载)工具专为快速加载大量数据而设计。
这些工具通常具有优化过的数据库接口和批量处理功能。
压缩数据:•在传输和存储之前压缩数据可以显著减少所需的时间和带宽。
考虑硬件和网络优化:* 确保您的服务器硬件足够强大,并且网络连接具有足够的带宽和稳定性。
对于远程数据库,考虑增加带宽或使用更稳定的数据传输协议。
2. 备份:* 在进行大量数据插入操作之前,请确保您有最近的备份。
这是一个好的做法,因为即使是最先进的系统也可能出现错误。
3. 使用专业服务:* 如果您处理的数据库非常大或非常复杂,您可能需要寻求专业的帮助或服务。
许多数据库提供商和服务商都提供这种服务。
4. 考虑数据库分片:•如果数据量非常大,可能需要考虑数据库分片。
分片是将数据分布在多个服务器上的方法,每个服务器都有其自己的数据库副本。
oracle数据迁移sql语句
在进行Oracle数据库迁移时,您可以使用SQL语句来执行数据迁移任务。
以下是一些常用的SQL语句示例:1. 导出数据:```sqlSELECT * FROM 表名INTO OUTFILE '文件路径'```该语句将从指定的表中检索所有数据,并将其导出到指定的文件中。
您需要将"表名"替换为要导出数据的实际表名,并将"文件路径"替换为要导出数据的实际文件路径。
2. 导入数据:```sqlLOAD DATA INFILE '文件路径' INTO TABLE 表名```该语句将从一个文件中加载数据,并将其导入到指定的表中。
您需要将"文件路径"替换为包含要导入数据的实际文件的路径,并将"表名"替换为要将数据导入的实际表名。
3. 创建表:```sqlCREATE TABLE 表名(列1 数据类型, 列2 数据类型, ...);```该语句用于在数据库中创建一个新的表。
您需要将"表名"替换为要创建的表的名称,并在括号内指定每个列的名称和数据类型。
4. 插入数据:```sqlINSERT INTO 表名(列1, 列2, ...) VALUES (值1, 值2, ...);```该语句用于向表中插入新的行数据。
您需要将"表名"替换为要插入数据的实际表名,并在括号内指定要插入的列的名称和对应的值。
5. 更新数据:```sqlUPDATE 表名SET 列= 新值WHERE 条件;```该语句用于更新表中满足指定条件的数据。
您需要将"表名"替换为要更新数据的实际表名,并在SET子句中指定要更新的列和对应的新值,同时在WHERE子句中指定满足条件的数据行。
这只是一些常用的SQL语句示例,实际的数据库迁移可能会涉及更复杂的操作。
根据您的具体需求和数据库结构,您可能需要编写更复杂的SQL语句来完成数据迁移任务。
oracle import参数
oracle import参数摘要:一、导语二、Oracle导入参数概述1.SQL*Plus导入参数2.导入参数的作用3.导入参数的分类三、Oracle导入参数详解1.文件路径参数2.数据库连接参数3.数据转换参数4.导入控制参数四、实战案例1.使用导入参数导入数据2.处理导入过程中的错误3.优化导入性能五、总结正文:一、导语作为一名职业写手,今天我们将为大家介绍Oracle导入参数的相关知识。
Oracle数据库作为业界领先的数据库管理系统,其强大的数据导入功能为企业数据的迁移和整合提供了便利。
本文将详细解析Oracle导入参数的使用方法和实战技巧,帮助大家更好地应用这一功能。
二、Oracle导入参数概述1.SQL*Plus导入参数在Oracle中,导入参数主要通过SQL*Plus命令进行设置。
这些参数用于控制导入过程,确保数据正确、高效地导入到目标数据库。
2.导入参数的作用导入参数主要用于以下方面:- 指定数据源(如文件、数据库表等)- 控制数据导入格式- 设置数据转换规则- 定义导入错误处理方式3.导入参数的分类Oracle导入参数主要分为以下几类:- 文件路径参数:用于指定数据源文件的位置- 数据库连接参数:用于连接目标数据库- 数据转换参数:用于指定数据格式转换规则- 导入控制参数:用于控制导入过程,如分批大小、错误处理等三、Oracle导入参数详解1.文件路径参数文件路径参数用于指定数据源文件的位置。
在SQL*Plus中,可通过`FILE`关键字设置文件路径,如:IMPORT INTO table_nameFROM FILE "path_to_file"```2.数据库连接参数数据库连接参数用于连接目标数据库。
在SQL*Plus中,可通过`CONNECT`关键字设置数据库连接信息,如:```CONNECT target_database```3.数据转换参数数据转换参数用于指定数据格式转换规则。