
第九章 EM算法及其推广
或
EM算法的导出
为什么EM算法能近似实现对观测数据的极大似然估 计? 极大化(不完全数据)Y关于参数Θ的极大似然函数:
难点:有未观测数据,包含和的对数。 EM通过迭代逐步近似极大化L(Θ),希望
EM算法的导出
考虑二者的差:
Jason不等式:
EM算法的导出
令:
则:
选择:
EM算法的导出
F函数的极大—极大算法
F函数: 假设隐变量数据Z的概率分布为 数θ的函数 : 熵: F函数是θ的连续函数,重要性质: 引理9.1:对于固定的θ ,存在唯一的分布 并且
, 定义分布
与参
极大化 :
这时的 随θ 连续变化。
F函数的极大—极大算法
证明:对于固定的θ,拉格朗日函数方法对最优化问题 求 , 对
求偏导:
令偏导为0: 得:分子分母成比例, 由:
得:
F函数的极大—极大算法
引理9.2: 定理9.3: 设
为观测数据的对数似然数, 为EM算法得到的参数估计序列,F函数 ,如果 在 和 有局部极大值,那么L(θ)也在 有 局部极大值,类似地,如果 在 和 达到全局 最大值,那么L(θ)也在 达到全局最大值。
省去和Θ无关的项:
EM算法的解释
L(Θ)开始
EM在非监督学习中的应用
生成模型由联合概率分布P(X,Y)表示,可以认为非监督 学习训练数据是联合概率分布产生的数据,X为观测数 据,Y为未观测数据。
二、EM算法的收敛性
EM,提供一种近似计算含有隐变量概率模型的极大似 然估计的方法, EM,最大优点:简单性和普适性; 疑问: 1、EM算法得到的估计序列是否收敛? 2、如果收敛,是否是全局极大值或局部极大值?
EM算法在高斯混合模型学习中的 应用
1、明确隐变量,写出完全数据的对数似然函数: 完全数据: 似然函数:
EM算法在高斯混合模型学习中的 应用
1、明确隐变量,写出完全数据的对数似然函数:
EM算法在高斯混合模型学习中的 应用
2、EM算法的E步,确定Q函数
第j个观测数据来自第k个分模型的概率,称为分模型k 对观测数据yj的响应度。
通过以上两步完成了EM算法的一次迭代,由EM算法与F 函数的极大---极大算法得到的参数估计序列 是一致的。
F函数的极大—极大算法
问题和方法: 通过:找
F函数的极大—极大算法
F函数的极大—极大算法
当参数θ的维数为d大于等于2时,可采用一种特殊的 GEM算法,算法的M步分解为d次条件极大化,每次只 改变参数向量的一个分量,其余分量不改变。
EM算法在高斯混合模型学习中的 应用
2、EM算法的E步,确定Q函数
EM算法在高斯混合模型学习中的 应用
2、EM算法的E步,确定Q函数
EM算法在高斯混合模型学习中的 应用
3、确定EM算法的M步: 求:
采用求导的方法:
高斯混合模型参数估计的EM算法
输入:观测数据y1,y2,…yN, 高斯混合模型 输出:高斯混合模型参数 1、设定初始值开始迭代 2、E步,响应度计算
下观测数据yi来自掷
M步: 计算模型参数的新估计值
EM算法
初值:
利用迭代公式,得: 继续迭代,得: 得到模型参数的极大似然估计:
EM算法
如果取初值:
完全数据 complete-data 不完全数据 incomplete-data
Eห้องสมุดไป่ตู้算法
输入:观测变量数据Y,隐变量数据Z,联合分布P(Y,Z|Θ) 条件分布P(Z|Y, Θ) 输出:模型参数Θ
F函数的极大—极大算法
F函数的极大—极大算法
Q&A
随机变量Y是观测变量,表示一次试验观测的结果是1或 0,随机变量z是隐变量,表示未观测到的掷硬币A的结 果,这一模型是以上数据的生成模型。
三硬币模型
观测数据: 未观测数据: 似然函数: 即: 极大似然估计: 该问题没有解析解,EM迭代法:
EM算法
选取初值: 第i步的估计值: EM算法第i+1次迭代: E步:计算在模型参数 硬币B的概率:
高斯混合模型参数估计的EM算法
输入:观测数据y1,y2,…yN, 高斯混合模型 输出:高斯混合模型参数 3、M步,计算新一轮迭代的模型参数:
4、重复2,3步直到收敛
四、EM算法的推广
EM算法可以解释为: F函数的极大---极大算法(maximization –maximization algorithm) 广义期望极大(Generalization Expectation Maximization. GEM)
袁春 清华大学深圳研究生院 李航 华为诺亚方舟实验室
目录
EM 算法的引入 2. EM 算法的收敛性 3. EM 算法在高斯混合模型学习中的应用 4. EM 算法的推广
1.
一、EM 算法的引入
EM 算法 EM 算法的导出 EM 算法在非监督学习中的应用
三硬币模型
三硬币模型:硬币A、B、C,正面概率π,p,q, A正面时选B,反面选C, 得到结果:1101001011 问题:只能看结果,不能看中间过程,估算π,p,q, 解:模型
EM算法的收敛性
两个收敛定理: 定理9.1:设P(Y|Θ)为观测数据的似然函数,Θ(i)(i=1,2..) 为EM参数估计序列, ,为对应的似 然函数序列,则P(Y|Θ(i))是单调递增的,即: 证明:由
由:
EM算法的收敛性
令: 则: 得:
只需证右端非负
EM算法的收敛性
前半部分,Θ(i+1)为极大值,所以
三、EM算法在高斯混合模型学习 中的应用
高斯混合模型: 概率分布模型; 系数: 高斯分布密度: 第K个分模型:
可任意高斯模型
高斯混合模型参数估计的EM算法
假设观测数据y1,y2,….yN由高斯混合模型生成:
用EM算法估计参数; 1、明确隐变量,写出完全数据的对数似然函数: 设想观测数据yi是依概率ak选择第k个高斯分模型 生成,隐变量
给定观测数据Y和当前参数估计Θ
EM算法
Q函数定义: 完全数据的对数似然函数logP(Y,Z|Θ)关于在给定观测数 据Y和当前函数Θ(i)下对未观测数据Z的条件概率分布 P(Z|Y, Θ(i)),的期望称为Q函数,即:
EM算法
算法说明: 步骤3,完成一次迭代:Θ(i)到Θ(i+1),将证明每次迭代使 似然函数增大或达到局部最大值。 步骤4,停止迭代的条件
F函数的极大—极大算法
证明:由定理9.1,9.2 成立;特别的: ,
F函数的极大—极大算法
定理9.4: EM算法的一次迭代可由F函数的极大----极大算法实现。
F函数的极大—极大算法
定理9.4: EM算法的一次迭代可由F函数的极大----极大算法实现。 证明:
F函数的极大—极大算法
定理9.4: EM算法的一次迭代可由F函数的极大----极大算法实现。 证明:
后半部分:
EM算法的收敛性
定理9.2: 设L(Θ)=logP(Y|Θ),为观测数据的对数似然函数,Θ (i)(i=1,2..)为EM算法得到的参数估计序列,L(Θ(i))为对 应的对数似然函数序列, 1、如果P(Y|Θ)有上界,则L(Θ(i)) =logP(Y|Θ(i))收敛到某 一值L* ; 2、在函数Q(Θ, Θ’)与L(Θ)满足一定条件下,由EM算法 得到的参数估计序列Θ(i)的收敛值Θ*是L(Θ)的稳定点。
EM算法原理及应用

EM算法原理及应用EM算法,也被称为期望最大化算法,是一种迭代算法,用于解决含有隐变量的概率模型中的参数估计问题。
它在许多领域,如机器学习、自然语言处理、计算机视觉等方面发挥着重要的作用。
EM算法的原理EM算法的基本思想是,通过迭代的方式,不断地估计隐变量的分布,并通过最大化完全数据的似然函数来确定模型参数的精确值。
其中,E步骤是计算Q函数,M步骤是最大化Q函数,直到Q函数的值单位之间的差异小于某个预设值时,迭代停止。
这种方法通常能够比直接最大化似然函数更容易和更快速地收敛到局部最优解。
具体而言,E步骤负责计算似然函数的期望值。
通常情况下,Q函数的形式为:$$ Q(\theta,\theta^{(t)})=\sum_{Z}p(Z|X,\theta^{(t)})\log p(X,Z|\theta) $$ 这里,$\theta^{(t)}$表示参数在第$t$次迭代后的值,$Z$是隐变量,$X$是样本向量。
通过对所有可能的值$Z$求和,可以得到期望值。
M步骤负责最大化Q函数。
由于期望函数的精确形式通常难以计算,这里使用Jensen不等式来对其进行近似。
对于凸函数,Jensen不等式告诉我们,任何函数的期望值都不会超过函数期望的函数值,所以Q函数的下界可以表示为:$$ Q(\theta,\theta^{(t)})\geqslant\sum_{Z}p(Z|X,\theta^{(t)})\log\d frac{p(X,Z|\theta)}{p(Z|X,\theta^{(t)})} $$ 那么,最大化上界只需要最大化分子即可。
也就是说,通过不断地优化分子的形式,就能获得对应于参数的极大值。
EM算法的应用EM算法在各种不同的环境下都有应用。
其中,下面列出的是一些其应用范围很广的领域:1.聚类分析EM算法在聚类中可用于鉴定具有某种特定类型的顺序数据的群集,比如DNA信息、汽车引擎振动等。
通过EM算法,我们可以推断隐藏变量的概率分布,而这些隐藏变量可能与类别标签或群集的数量有关。
EM算法及其推广解析PPT课件
第21页/共26页
• 证明 由于 取对数有 由 令 于是对数似然函数可以写成
第22页/共26页
• 只需证明右端为非负值即得出结果,由于
•使
达到极大,所以有
Q( , (i) )
其第二项,由
得出
(i1)
第23页/共26页
• 定理9.2 设L(θ)=logP(Y|θ)为观测数据的对数似然函数, (i=1,2,…)为EM算
数的当前估计值.每次迭代实际在求Q函数及其极大;
第12页/共26页
• (3)M步:求使
极大化的Qθ(, ,确定(i)i)+1次迭代得参数的估计值
(i1)
(4)重复第(2)步和第(3)步,直到收敛,这里给出停止迭代得条件,一
般是对较小的正数
,若满足
则 停 止1迭, 代2 .
第13页/共26页
• 定义9.1(Q函数)完全数据(观测变量数据Y和隐变量数据Z)的对数似然函数
极大似然估计
• 极大似然估计是概率论在统计学中的应用,它是参数估计的方法之一。说的是已知某个随机样本满足某种 概率分布,但是其中具体的参数不清楚,参数估计就是通过若干次实验,观察其结果,利用结果推出参数 的大概值。
第2页/共26页
极大似然估计
• 似然函数: • 已知样本集X,X是通过概率密度p(x|θ)抽取。样本集X中各个样本的联合概率: • 为了便于分析,由于L(θ)是连乘的,还可以定义对数似然函数,将其变成连加的:
值可以任意选择(i) ,但需注意EM算法对初值是敏感 的; (2)E步:记 为第i次迭代参数θ的估计值,在 第i+1次迭代得E步,计算
P(Z | Y, (i))
(i)
Q( , (i) )
EM算法-完整推导
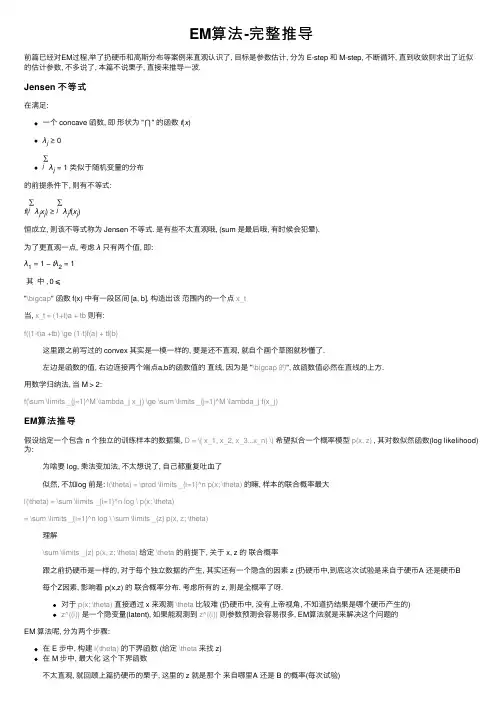
EM算法-完整推导前篇已经对EM过程,举了扔硬币和⾼斯分布等案例来直观认识了, ⽬标是参数估计, 分为 E-step 和 M-step, 不断循环, 直到收敛则求出了近似的估计参数, 不多说了, 本篇不说栗⼦, 直接来推导⼀波.Jensen 不等式在满⾜:⼀个 concave 函数, 即形状为 "⋂" 的函数f(x)λj≥0∑jλj=1 类似于随机变量的分布的前提条件下, 则有不等式:f(∑jλj x j)≥∑jλj f(x j)恒成⽴, 则该不等式称为 Jensen 不等式. 是有些不太直观哦, (sum 是最后哦, 有时候会犯晕).为了更直观⼀点, 考虑λ只有两个值, 即:λ1=1−tλ2=1其中,0⩽"\bigcap" 函数 f(x) 中有⼀段区间 [a, b], 构造出该范围内的⼀个点x_t当, x_t = (1+t)a + tb则有:f((1-t)a +tb) \ge (1-t)f(a) + tf(b)这⾥跟之前写过的 convex 其实是⼀模⼀样的, 要是还不直观, 就⾃个画个草图就秒懂了.左边是函数的值, 右边连接两个端点a,b的函数值的直线, 因为是 "\bigcap 的", 故函数值必然在直线的上⽅.⽤数学归纳法, 当 M > 2:f(\sum \limits _{j=1}^M \lambda_j x_j) \ge \sum \limits _{j=1}^M \lambda_j f(x_j)EM算法推导假设给定⼀个包含 n 个独⽴的训练样本的数据集, D = \{ x_1, x_2, x_3...x_n) \}希望拟合⼀个概率模型p(x, z) , 其对数似然函数(log likelihood)为:为啥要 log, 乘法变加法, 不太想说了, ⾃⼰都重复吐⾎了似然, 不加log 前是: l(\theta) = \prod \limits _{i=1}^n p(x; \theta)的嘛, 样本的联合概率最⼤l(\theta) = \sum \limits _{i=1}^n log \ p(x; \theta)= \sum \limits _{i=1}^n log \ \sum \limits _{z} p(x, z; \theta)理解\sum \limits _{z} p(x, z; \theta)给定\theta的前提下, 关于 x, z 的联合概率跟之前扔硬币是⼀样的, 对于每个独⽴数据的产⽣, 其实还有⼀个隐含的因素 z (扔硬币中,到底这次试验是来⾃于硬币A 还是硬币B每个Z因素, 影响着 p(x,z) 的联合概率分布. 考虑所有的 z, 则是全概率了呀.对于p(x; \theta)直接通过 x 来观测\theta⽐较难 (扔硬币中, 没有上帝视⾓, 不知道扔结果是哪个硬币产⽣的)z^{(i)}是⼀个隐变量(latent), 如果能观测到z^{(i)}则参数预测会容易很多, EM算法就是来解决这个问题的EM 算法呢, 分为两个步骤:在 E 步中, 构建l(\theta)的下界函数 (给定\theta来找 z)在 M 步中, 最⼤化这个下界函数不太直观, 就回顾上篇扔硬币的栗⼦, 这⾥的 z 就是那个来⾃哪⾥A 还是 B 的概率(每次试验)设Q_i为关于 z 的概率分布, 即\sum \limits _{z} Q_i(z) = 1 (z 如是连续变量则\sum \rightarrow \int_z) ,则对于上⾯的对数似然函数:= \sum \limits _{i=1}^n log \ \sum \limits _{z} p(x_i, z_i; \theta) \ (1)对 p 的部分, 同时乘上和除以Q_i(z_i)不改变等式 , 这种技巧, 中学的 "配平⽅或数列裂项求和" ⼀样滴= \sum \limits _i log \sum \limits _{z_i} Q_i(z_i) \frac {p(x_i, z_i; \theta)}{Q_i(z_i) } \ (2)log 函数是 concave 的, 联想 jensen不等式f(\sum \limits _j \lambda_j x_j) \ge \sum \limits _j \lambda_j f(x_j)即 log 对于与 f(); \sum \limits _{z_i} Q_i(z_i) 对应于 \sum \limits _j \lambda_j ; 最后⼀项对x_j\ge \sum \limits_{i} \sum \limits_{z_i}Q_i(z_i) \ log \frac {p(x_i, z_i; \theta)}{Q_i(z_i) } \ (3)就类似与, 把⼀个, 函数⾥⾯的参数, 提取到函数外⾯来. 如还是不理解, 回看之前写的 convex 篇什么时候会取到等于?即当\frac {p(x_i, z_i; \theta)}{Q_i(z_i) } = c是个常数的时候, (2) 和 (3) 是相等的.即p(x_i, z_i; \theta) = c \ * Q_i(z_i)在\theta给定下, 关于 x, z 的联合概率分布与隐变量 z 的分布是⼀个线性关系因为\sum \limits_{z_i} Q_i(z_i) = 1, 如果将Q_i(z_i)认为是给定x_i 和 z_i的后验概率分布, 这样就得到了该似然函数的⼀个下界,根据全概率(后验) 与贝叶斯公式:Q_i(x_i) = \frac {p(x_i, z_i; \theta)}{\sum \limits _{z_i} p(x_i, z_i; \theta)}=\frac {p(x_i, z_i; \theta)}{p(x; \theta)}=p(z_i|x_i, \theta)相当于求给定\theta 和 x_i的情况下, 求 z_i 的条件概率, 果然, 深刻理解贝叶斯公式显得多么重要呀再回顾⼀波贝叶斯公式:设A1,A2,A3..构成完备事件组, 则对任意⼀事件B有:P(A_i|B) = \frac {P(A_i)P(B|A_i)}{\sum \limits _{i=1}^n P(A_i)P(B|A_i)}同上述, 只要当我们取Q_i(z_i)的值为给定\theta 和 x_i的后验概率分布的时候, 就能保证:\frac {p(x_i, z_i; \theta)}{Q_i(z_i) }的值是⼀个常数 (反过来推的), 既然是个常数, 也就**前⾯ (3) 的地⽅可以取等号啦, 即: **\sum \limits _{i=1}^n log \ \sum \limits _{z} p(x_i, z_i; \theta) = \sum \limits_{i} \sum \limits_{z_i}Q_i(z_i) \ log \frac {p(x_i, z_i; \theta)}{Q_i(z_i) }这样⼀来, 相当于在 E 步得到了似然函数的⼀个下界, 然后在 M 步, 求解(3) 最⼤值时候的参数\theta . 然后重复以上的 E, M 步骤:E-步: For each i:Q_i(z_i) = p(z_i | x_i; \theta)M-步, 更新\theta:\theta = arg \ max _\theta \sum \limits_{i} \sum \limits_{z_i}Q_i(z_i) \ log \frac {p(x_i, z_i; \theta)}{Q_i(z_i) }....循环直到收敛, 则估计出了参数\theta但, 万⼀不收敛呢?, so, 必须证明⼀波, EM算法是收敛的哦证明EM算法会收敛假设\theta^{(t)} 和 \theta^{(t+1)}为EM算法的连续两个步骤的参数值, 欲证l (\theta)收敛, 只需证:l(\theta^{(t)}) \leq l(\theta^{(t+1)})即可EM算法使得似然函数的值单调递增即可根据前⾯关于⽤ jensen不等式的取等条件, 推导出, 取得Q_i(z_i)^{(t)}的⽅式是:Q_i ^{(t)} (z_i) = p(z_i | x_i; \theta ^{(t)})此条件下, 使得jensen不等式取等即:l(\theta^{(t)}) = \sum \limits_{i} \sum \limits_{z_i}Q_i(z_i) \ log \frac {p(x_i, z_i; \theta ^t)}{Q_i(z_i) }⽽参数\theta^{(t+1)}的取值⽅式, 是使得上⾯的这个等式的值最⼤, 则必然l(\theta^{(t+1)}) \ge l(\theta^{(t)})展开⼀波:l(\theta^{(t+1)}) \ge \sum \limits_{i} \sum \limits_{z_i}Q_i^t(z_i) \ log \frac {p(x_i, z_i; \theta ^{(t+1)})}{Q_i^t(z_i) } \ (4)\ge \sum \limits_{i} \sum \limits_{z_i}Q_i^t(z_i) \ log \frac {p(x_i, z_i; \theta^t)}{Q_i^t(z_i) }\ (5)=l(\theta^{(t)}) \ (6)(4) 源于不等式的性质, 必然成⽴嘛(5) 就是取最⼤值的⼀个过程必然成⽴(6) 取相等的⽅式去是应⽤了 Jensen不等式即证明了l(\theta^{(t)}) \leq l(\theta^{(t+1)}) , 即EM算法是收敛的呀.⼩结⾸先是要理解,参数估计的是在⼲嘛, 需要回顾统计学的基础知识, 或理解上篇扔硬币的栗⼦核⼼, ⽤到了⼀个jensen 不等式, 需要回顾凸函数的⼀些性质来理解⼀波推导的⽅式呢, 依旧是极⼤似然估计, 带log (乘法边加法)推导核⼼技巧是全概率与贝叶斯公式, 真正理解太重要, 如LDA, 逻辑回归, 贝叶斯...这些算法都⽤到了.证明收敛, 其实只是⼀些, 推理的技巧, 还是挺有意思的.总体上, EM算法, 理解起来,我感觉不是很容易, 但, 也没有想象的那样难, 只要肯坚持, 正如爱因斯坦所说的那样嘛, 当然也为了⾃勉⽬前在经济和精神双重困境中的⾃⼰:耐⼼和恒⼼, 总会获得收获的Loading [MathJax]/jax/element/mml/optable/SuppMathOperators.js。
EM算法详细例子及推导

EM算法详细例子及推导EM算法(Expectation-Maximization Algorithm)是一种用于求解含有隐变量(latent variable)的概率模型的参数估计方法。
其基本思想是通过迭代的方式,通过观测数据得到对隐变量的估计,然后再基于该估计对模型参数进行优化。
下面我们以一个简单的高斯混合模型为例,详细介绍EM算法的推导和实例。
1. 高斯混合模型(Gaussian Mixture Model, GMM)高斯混合模型是一种概率模型,由多个高斯分布组合而成。
假设我们观测到的数据由K个高斯分布组成,每个高斯分布对应一个参数向量:均值miu和方差sigma^2、同时,我们还有一个隐变量Z,表示观测数据属于哪个高斯分布,取值范围为{1,2,...,K}。
2.EM算法EM算法的核心思想是通过交替进行两个步骤:E步(Expectation)和M步(Maximization)。
在E步中,我们对当前模型参数下的隐变量进行估计,得到对隐变量的最大似然估计。
在M步中,我们利用得到的隐变量估计更新模型参数,使模型对观测数据的似然函数最大化。
不断重复这两步直至模型收敛。
下面我们通过具体的例子来推导EM算法。
假设我们观测到了一个数据集X = {x1, x2, ..., xn},我们希望通过EM算法对其进行建模。
Step1: 初始化模型参数首先,我们需要初始化模型参数。
选择K个高斯分布的参数miu和sigma^2,并假设所有的高斯分布对应的隐变量Z服从均匀分布。
这时,我们得到了初始模型参数Theta = {miu1, sigma^21, ..., miuK,sigma^K, pi1, pi2, ..., piK}。
Step2: E步,计算隐变量的后验分布在E步中,我们计算隐变量的后验分布。
对于每个观测样本xi,我们计算其属于每个高斯分布的概率,即:gamma(k,i) = P(Zi=k,xi, Theta) = P(Zi=k,xi, miu_k,sigma_k^2) = pi_k * N(xi,miu_k, sigma_k^2) / sum(pi_j * N(xi,miu_j, sigma_j^2), j=1 to K其中N(xi,miu_k, sigma_k^2)表示xi在第k个高斯分布下服从的概率密度函数。
【机器学习】EM算法详细推导和讲解

【机器学习】EM算法详细推导和讲解 今天不太想学习,炒个冷饭,讲讲机器学习⼗⼤算法⾥有名的EM算法,⽂章⾥⾯有些个⼈理解,如有错漏,还请读者不吝赐教。
众所周知,极⼤似然估计是⼀种应⽤很⼴泛的参数估计⽅法。
例如我⼿头有⼀些东北⼈的⾝⾼的数据,⼜知道⾝⾼的概率模型是⾼斯分布,那么利⽤极⼤化似然函数的⽅法可以估计出⾼斯分布的两个参数,均值和⽅差。
这个⽅法基本上所有概率课本上都会讲,我这就不多说了,不清楚的请百度。
然⽽现在我⾯临的是这种情况,我⼿上的数据是四川⼈和东北⼈的⾝⾼合集,然⽽对于其中具体的每⼀个数据,并没有标定出它来⾃“东北⼈”还是“四川⼈”,我想如果把这个数据集的概率密度画出来,⼤约是这个样⼦: 好了不要吐槽了,能画成这个样⼦我已经很⽤⼼了= = 其实这个双峰的概率密度函数是有模型的,称作⾼斯混合模型(GMM),写作: 话说往博客上加公式真是费劲= =这模型很好理解,就是k个⾼斯模型加权组成,α是各⾼斯分布的权重,Θ是参数。
对GMM模型的参数估计,就要⽤EM算法。
更⼀般的讲,EM算法适⽤于带有隐变量的概率模型的估计,什么是隐变量呢?就是观测不到的变量,对于上⾯四川⼈和东北⼈的例⼦,对每⼀个⾝⾼⽽⾔,它来⾃四川还是东北,就是⼀个隐变量。
为什么要⽤EM,我们来具体考虑⼀下上⾯这个问题。
如果使⽤极⼤似然估计——这是我们最开始最单纯的想法,那么我们需要极⼤化的似然函数应该是这个: 然⽽我们并不知道p(x;θ)的表达式,有同学说我知道啊,不就是上⾯那个混个⾼斯模型?不就是参数多⼀点麽。
仔细想想,GMM⾥的θ可是由四川⼈和东北⼈两部分组成哟,假如你要估计四川⼈的⾝⾼均值,直接⽤GMM做似然函数,会把四川⼈和东北⼈全考虑进去,显然不合适。
另⼀个想法是考虑隐变量,如果我们已经知道哪些样本来⾃四川,哪些样本来⾃东北,那就好了。
⽤Z=0或Z=1标记样本来⾃哪个总体,则Z就是隐变量,需要最⼤化的似然函数就变为: 然⽽并没有卵⽤,因为隐变量确实不知道。
EM算法及其应用
EM算法及其应用EM算法作为一种常用的统计方法,被广泛应用于各种领域,如计算机视觉、自然语言处理、生物信息学等。
在本文中,我们将详细探讨EM算法及其应用。
一、EM算法概述EM算法(Expectation-Maximization Algorithm)是一种用于概率模型参数估计的迭代算法,由Arthur Dempster等人于1977年提出。
它可以用于处理带有隐变量的模型参数估计,也可以被看做一种极大化带有隐变量的数据似然函数的方法。
EM算法的核心思想是将似然函数分解为两部分,一部分是观测数据,另一部分是隐变量。
在每次迭代中,EM算法首先根据当前参数的值计算出对隐变量的期望,即E步。
然后,它通过极大化在E步中计算出的隐变量的期望下的似然函数来更新参数,即M步。
这个过程不断迭代,直到收敛为止。
二、EM算法应用案例1. 高斯混合模型高斯混合模型(Gaussian Mixture Model,GMM)是一种用来描述多个高斯分布的模型。
在计算机视觉中,GMM被广泛应用于图像分割和姿态估计等领域。
由于图像中的像素值往往服从高斯分布,因此使用GMM进行图像分割时,可以将像素分为多个高斯分布。
使用EM算法进行GMM参数估计的步骤如下:1) 初始化高斯分布的个数和参数;2) E步:计算每个样本属于每个高斯分布的概率,即计算隐变量的期望;3) M步:根据在E步中计算出的隐变量的期望,更新高斯分布的均值和方差。
4) 不断迭代E步和M步,直到收敛。
2. K均值聚类K均值聚类是一种无监督学习的算法,它将n个样本划分为k 个簇,使得每个样本都属于距离它最近的簇。
这种算法被广泛应用于图像分割和文本聚类等领域。
使用EM算法进行K均值聚类的步骤如下:1) 随机初始化k个簇的中心点;2) E步:将每个样本分配到距离它最近的簇中,即计算隐变量的期望;3) M步:根据在E步中计算出的隐变量的期望,更新每个簇的中心点;4) 不断迭代E步和M步,直到收敛。
机器学习算法——EM算法
机器学习算法——EM算法E步:利用当前估计的参数值,求出在该参数下隐含变量的条件概率值(计算对数似然的期望值);M步:结合E步求出的隐含变量条件概率,求出似然函数下界函数的最大值(寻找能使E步产生的似然期望最大化的参数值。
)然后,新得到的参数值重新被用于E步.....直到收敛到局部最优解。
(note:每次迭代实际在求Q函数及其极大,即每次迭代使似然函数增大或达到局部极值。
)优点:简单性和普适性,可看作是一种非梯度优化方法(解决梯度下降等优化方法的缺陷:求和的项数将随着隐变量的数目以指数级上升,会给梯度计算带来麻烦)缺点:对初始值敏感,不同的初值可能得到不同的参数估计值;不能保证找到全局最优值。
一、Jensen 不等式在EM算法的推导过程中,用到了数学上的Jensen不等式,这里先来介绍一下。
其中,二、EM算法推导面对一个含有隐含变量Z的概率模型,目标是极大化观测数据Y 关于参数的对数似然函数,即极大化:事实上,EM算法是通过迭代逐步极大化的。
假设在第次迭代后的估计值是。
我们希望新的估计值能使增加,即,并逐步达到极大值。
为此考虑两者的差:上式利用了Jensen不等式,且,则可得上述推导。
注意为凹函数,不等号要改变方向令EM算法并不能保证全局最优值,直观解释如图所示。
好好理解这个图三、EM算法在高斯混合模型中的应用:高斯混合模型:步骤:(1)明确隐变量,写出完全数据的对数似然函数。
(2)EM算法的E步:确定Q函数(即:完全数据的对数似然函数关于在给定观测数据和参数的条件下对隐变量的条件概率的期望):(3)M步:求Q函数对theta的极大值,即求新一轮迭代的模型参数。
四、采用EM算法求解的模型有哪些?为什么不用牛顿法或者梯度下降法?一般有混合高斯、协同过滤、k-means。
算法一定会收敛,但是可能会收敛到局部最优。
求和的项数会随着隐变量的数目指数上升,会给梯度计算带来麻烦。
EM算法是一种非梯度优化算法。
em算法
Em算法,是指期望最大化算法,是一种迭代算法,用于统计中,以找到概率模型中参数的最大似然估计,该估计依赖于不可观察的隐藏变量。
EM算法由dempster,laind和Rubin于1977年提出,是一种非常简单实用的学习算法,可以通过MLE从不完整的数据集中估计参数。
此方法可广泛用于处理不完整的数据,例如缺陷数据,截断的数据和嘈杂的数据。
可能会有一些生动的隐喻可以清楚地解释该算法。
例如,食堂的厨师炒了一道菜,不得不将它分成两部分,以便两个人一起吃。
显然,没有必要以很小的平衡来精确称量它。
最简单的方法是将一个盘子随机分成两个碗,然后观察是否有很多盘子,然后再取其中的一些放到另一个碗中。
这个过程是反复进行的,直到每个人都看不到两个碗中所盛菜肴的重量差异。
EM算法就是这样。
假设我们知道两个参数a和b,它们在初始状态下是未知的。
如果我们知道a的信息,那么我们可以得到b的信息,如果我们知道b,那么我们可以得到a。
可以考虑给定某个初始值以获得b的估计值,然后从b的当前值重新估计a的值,直到当前值收敛为止。
在统计中,最大期望(EM)算法是一种算法,用于根据概率模型中的参数来找到参数的最大似然估计或最大后验估计。
在机器学习和计算机视觉的数据集群领域中经常使用最大期望值。
EM算法(坐标上升算法)
EM算法(坐标上升算法)⼗⼤算法之⼀:EM算法。
能评得上⼗⼤之⼀,让⼈听起来觉得挺NB的。
什么是NB啊,我们⼀般说某个⼈很NB,是因为他能解决⼀些别⼈解决不了的问题。
神为什么是神,因为神能做很多⼈做不了的事。
那么EM算法能解决什么问题呢?或者说EM算法是因为什么⽽来到这个世界上,还吸引了那么多世⼈的⽬光。
我希望⾃⼰能通俗地把它理解或者说明⽩,但是,EM这个问题感觉真的不太好⽤通俗的语⾔去说明⽩,因为它很简单,⼜很复杂。
简单在于它的思想,简单在于其仅包含了两个步骤就能完成强⼤的功能,复杂在于它的数学推理涉及到⽐较繁杂的概率公式等。
如果只讲简单的,就丢失了EM算法的精髓,如果只讲数学推理,⼜过于枯燥和⽣涩,但另⼀⽅⾯,想把两者结合起来也不是件容易的事。
所以,我也没法期待我能把它讲得怎样。
希望各位不吝指导。
⼀、最⼤似然扯了太多,得⼊正题了。
假设我们遇到的是下⾯这样的问题:假设我们需要调查我们学校的男⽣和⼥⽣的⾝⾼分布。
你怎么做啊?你说那么多⼈不可能⼀个⼀个去问吧,肯定是抽样了。
假设你在校园⾥随便地活捉了100个男⽣和100个⼥⽣。
他们共200个⼈(也就是200个⾝⾼的样本数据,为了⽅便表⽰,下⾯,我说“⼈”的意思就是对应的⾝⾼)都在教室⾥⾯了。
那下⼀步怎么办啊?你开始喊:“男的左边,⼥的右边,其他的站中间!”。
然后你就先统计抽样得到的100个男⽣的⾝⾼。
假设他们的⾝⾼是服从⾼斯分布的。
但是这个分布的均值u和⽅差∂2我们不知道,这两个参数就是我们要估计的。
记作θ= [u, ∂]T。
⽤数学的语⾔来说就是:在学校那么多男⽣(⾝⾼)中,我们独⽴地按照概率密度p(x|θ)抽取100了个(⾝⾼),组成样本集X,我们想通过样本集X来估计出未知参数θ。
这⾥概率密度p(x|θ)我们知道了是⾼斯分布N(u,∂)的形式,其中的未知参数是θ=[u, ∂]T。
抽到的样本集是X={x1,x2,…,x N},其中x i表⽰抽到的第i个⼈的⾝⾼,这⾥N就是100,表⽰抽到的样本个数。
em算法原理
EM算法原理一、简介EM(Expectation Maximization)算法是一种常见的统计学习方法,用于估计参数和解决一些难以处理的问题,特别是在存在隐变量的情况下。
EM算法最初由数学家罗伯特·卢德米勒(RobertLushmiller)和理查德·贝尔曼(RichardBellman)在20世纪50年代提出,后来由 statisticiansDempster, Laird, and Rubin 进一步发展,因此也被命名为Dempster-Laird-Rubin算法。
EM算法在许多领域都有广泛的应用,如混合高斯模型、隐马尔可夫模型、高斯过程回归等。
二、EM算法的步骤EM算法主要由两个步骤组成:E步(ExpectationStep)和M步(Maximization Step),这两个步骤在迭代过程中交替进行。
1.E步:计算隐变量的条件期望。
给定当前的参数估计值,计算隐变量的条件期望,通常表示为参数的函数。
这个步骤中,隐变量对数似然函数的参数更新起着关键作用。
2.M步:最大化期望值函数。
在E步计算出期望值之后,M步将尝试找到一组参数,使得这个期望值函数最大。
这个步骤中,通常使用优化算法来找到使期望值函数最大的参数值。
这两个步骤在迭代过程中交替进行,每次迭代都更新了参数的估计值,直到满足某个停止准则(如参数收敛或达到预设的最大迭代次数)。
三、EM算法的特点与优点1.处理隐变量:EM算法能够处理数据中存在的隐变量问题,这是它与其他参数估计方法相比的一大优势。
通过估计隐变量的概率分布,EM算法能够更准确地描述数据的生成过程。
2.简单易行:相对于其他优化算法,EM算法相对简单易懂,也容易实现。
它的主要目标是最优化一个简单的对数似然函数,这使得EM算法在许多情况下都能给出很好的结果。
3.稳健性:对于一些数据异常或丢失的情况,EM算法往往表现出较好的稳健性。
这是因为EM算法在估计参数时,会考虑到所有可用的数据,而不仅仅是正常的数据点。