
面向主题搜索中的讲解
陈 静
北京大学网络与分布式系统实验室 2002年6月
提纲
研究背景
面向主题搜索引擎的实现
中文处理
研究背景
WWW网络的迅猛增长
–全球网页数量激增
• 根据第5届搜索引擎年会的会议报告,截至 2000.1,全球网页超过10亿 • 根据Google搜索引擎的索引数量,到2002.5, 全球网页数量超过20亿
– 中国网页数量也呈现指数增所 未有的挑战
–搜索引擎怎样适应这种规模的急剧膨胀?
研究背景
面向主题搜索引擎
–优点:
• 网页抓取的准确性高,与用户关心的主题相 关度大 • 搜索的范围相对缩小,有利于快速搜集到相 关网页
–弥补了通用搜索引擎的不足
项目介绍
具体系统简介
–北京大学语言所的“汉语词语切分与词性 标注软件 ”
正确切词的意义
举例:
– 原句:“原命题、逆命题、否命题、逆否命 题的定义”
– 修改前:“原 命题 逆 命题 否 命题 逆 否 命题 的 定义” – 修改后:“原命题 逆命题 否命题 逆否命题 的 定义” – 意义:词的意义更具体、准确,是正确有效分类 的基础
修改的主要部分
图表 1 收集、控制子系统
分类器:分类目录
中文处理问题的提出: 特征词的提取
分类器的第一步:提取特征词
–本项目的特性:
• 给定一门课程,其内涵和外延一定是明确的,因此在讲 授该门课程的老师的帮助下,我们很容易在较短(一两 天)时间内获得该课程的特征词。
–我们采用手工预先提取特征词的方法
中文切词的改进
具体改进:
– 方法:修改基础字典。
• 重新定义基础字典,其中加入所有特征词 • 为新字典生成一个索引文件 • 切词软件初始化时调入新的索引文件
– 优点:灵活方便地扩充和精简字典
中文切词的改进
总结
面向课程的素材收集子系统的实现
– 面向主题搜索引擎技术 – 中文处理
谢谢!
– “面向课程的素材收集子系统” – 本项目是“远程教育”项目的一部分 – 目的:利用面向主题搜索引擎技术,在 INTERNET上搜集与给定课程相关的各 类教学素材,为教师备课提供方便 – 选定的具体实例:中学数学 – 本系统建立在天网搜索引擎的基础上
天网搜索引擎
天网的体系结构:
– 搜集器 – 控制器 – 原始数据库 – 索引器 – 索引数据库 – 检索器 – 用户接口
中文切词是分类的前提:
–明确搜索对象:中文网页 –提出要求:中文处理软件能够正确切割出特征词
中文处理背景
中文信息的特点:
–中文词汇大多是由两个或两个以上的汉字 组成的 –中文是连续书写的语言,并且缺乏天然的 词分隔符
难点:汉语切词问题
– “我的笔记本”->“我 的 笔记本”
原天网搜索引擎系统:
主题检索项中所包含的检索范围
主题检索项中所包含的检索范围主题:主题检索项中所包含的检索范围一、引言在进行任何研究、讨论或者撰写文章时,主题检索项就成为了必不可少的工具。
它所包含的检索范围直接决定了我们获取信息的全面性和深度,对于一个学者或者知识工作者来说,对主题检索项中的检索范围有着深刻的理解和把握是至关重要的。
在本文中,我将深入探讨主题检索项中的检索范围,希望通过全面的评估和分析,能够更好地理解这一重要的概念。
二、浅谈主题检索项我们需要清晰地了解什么是主题检索项。
主题检索项指的是用来表征一篇文章或者一个研究主题的关键词、标签或者分类。
其主要作用是帮助读者快速准确地获取所需信息,同时也是研究者进行学术研究和探讨的重要工具。
然而,主题检索项中的检索范围却是一个更为复杂和深入的概念。
三、检索范围的广度和深度在主题检索项中,检索范围的广度和深度是我们需要重点关注的内容。
广度指的是主题检索项所覆盖的内容范围,一般包括了主题的相关分支和扩展内容;而深度则是指主题检索项所反映的主题内容的详尽程度,是否能够涵盖该主题的全面信息。
在进行文章撰写或者资料检索时,我们需要根据具体情况来评估主题检索项中的广度和深度,以便更好地获取所需信息,也可以更准确地理解和把握研究主题。
四、主题检索项中的检索范围的重要性主题检索项中所包含的检索范围对于研究者和学者具有极其重要的意义。
一个广度和深度兼具的主题检索项将会帮助研究者更加全面地了解所研究的主题,获取更多的相关信息,从而在学术研究和探讨中能够做出更为准确和有深度的结论。
对于一个高质量的主题检索项来说,其检索范围是至关重要的。
五、对主题检索项中检索范围的个人理解在我看来,主题检索项中的检索范围应该是一个平衡的概念。
它既要涵盖主题的所有分支和相关内容,又要有深度地挖掘主题内容。
只有在广度和深度兼具的情况下,我们才能获得全面、深刻和准确的信息,从而更好地理解和掌握所研究的主题。
在实际的使用中,我们需要不断地对主题检索项中的检索范围进行评估和调整,以便更好地满足我们的需求。
主题检索语言

主题检索语言主题检索语言,顾名思义,是一种用于在文本中查找相关主题的语言。
它通过特定的语法和规则来帮助用户更高效地检索与自己感兴趣的主题相关的信息。
本文将介绍主题检索语言的定义、功能、应用场景以及一些常用的主题检索语言。
一、主题检索语言的定义主题检索语言是一种用于在文本中查找特定主题的语言。
它通过指定关键词、逻辑运算符和搜索条件来筛选出与所需主题相关的内容。
主题检索语言可以应用于各种文本数据,包括文章、新闻、论文、博客等。
主题检索语言具有以下功能:1. 关键词搜索:用户可以通过输入关键词来检索与该关键词相关的内容。
2. 逻辑运算符:主题检索语言支持逻辑运算符,如AND、OR、NOT,用户可以通过组合使用这些运算符来精确控制检索结果。
3. 短语搜索:用户可以使用引号将多个关键词括起来,以便检索包含这些关键词连续出现的内容。
4. 通配符搜索:主题检索语言支持通配符,如*和?,用户可以在关键词中使用通配符来模糊匹配一定范围的内容。
5. 范围搜索:用户可以指定搜索结果的范围,如时间范围、地理位置范围等,以便更加精确地获取所需信息。
三、主题检索语言的应用场景主题检索语言可以应用于各种场景,包括:1. 学术研究:研究人员可以使用主题检索语言来检索与自己研究方向相关的论文、期刊等文献,以便获取最新的研究成果。
2. 新闻报道:新闻编辑可以使用主题检索语言来检索与某一事件或话题相关的新闻报道,以便及时了解相关信息并撰写报道。
3. 市场调研:市场分析师可以使用主题检索语言来检索与某一产品或服务相关的市场调研报告,以便了解市场需求和竞争情况。
4. 数据分析:数据分析师可以使用主题检索语言来检索与某一指标或变量相关的数据,以便进行数据分析和预测。
四、常用的主题检索语言以下是一些常用的主题检索语言:1. 检索关键词:通过在搜索框中输入关键词来检索相关内容。
2. AND运算符:使用AND运算符可以将多个关键词组合起来,要求检索结果同时包含这些关键词。
面向主题的搜索引擎设计

选择感 兴趣 的类别。以减少用户在大量 的结果 中寻找 自
己感兴趣 的页面的时间 ,提高检索效率。
过反复试验经验获得 ),若字 串的频率和权重超过 阈值 就成为候选可鉴别词 。然后对候选鉴别词进行 一些简单
的规则过滤 ,如 以 “ 的”开头或结尾 的词 、以 “ 是”开
改进后的km as — en算法对搜 索结果 自动聚类 ; ( )抽取 2
每个类 别中的相关词作 为描述该类 的词
信息系统工程 l 0 2 . 1.2 2 20
2 3
<< SS R CI 系 实 Y A E 统 践 P F C
对字 串的频率圾 权重f  ̄定两个 阈值 ( /, m3 阈值是经
本文基 于统计的方法 ,在传统搜索 引擎搜索结果 的 基础上 ,提 出一种新 的面向主题 的搜索引擎设计方法 。 本文假设爬 虫已经将We 中的各种网页信息采集 了,在 b 此基础上 ,使用 改进 的kmen算法对结果 进行 聚类 , . as
S SP A TC 系统实践 Y R C IE
面 向主题的搜索 引擎设计
◆ 刘建舟 邵雄 凯
摘要 :本 文提 出一种新 的面向主题 的搜 索引擎设 计方法。使 用改进 Nk m。 s — 算法对结果进行 聚类,然后 用相 关词抽取技 术抽取代表每 类的 n 词语。试验结果表 明该方法是有效的。
构 ,以适应系统的分散控制 ,集 中监测 的要求 。各站应
位控制窗 口是主要显示窗 口,主要分为 四大部分 :动画 显示区、数据显示区 、流速控制 区、底部为状态条。
动 画显示 区内显示 了水位控制系统的结构框 图,储
具有双 向通讯 能力 ,而且通信延迟应在一定范围内,最
遗传算法在面向主题的元搜索引擎设计的改进及应用
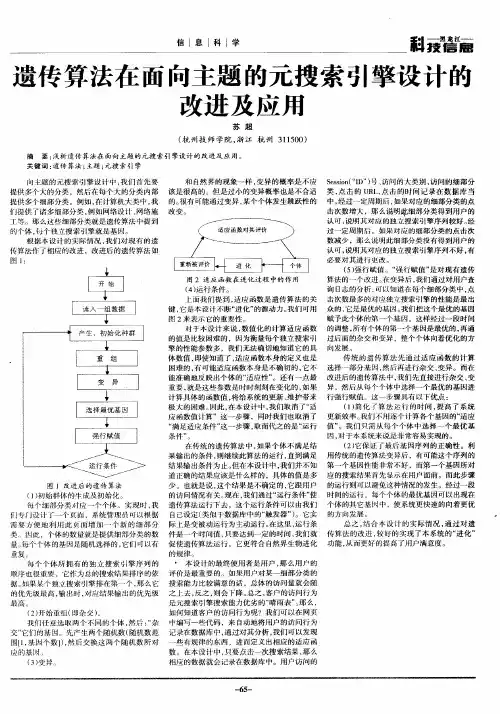
S sin “D” 号 、 问 的大 类 别 , 问 的 细 部 分 es ( I ) 访 o 访
类, 点击 的 U , 击的 时间记 录在数 据库 当 RL 点 中 。 过一 定 周 期 后 , 果 对 应 的细 部 分 类 的 点 经 如 击次数增大 ,那么说明此细部分类得 到用 户的 认 可 , 明其 对 应 的独 立 搜 索 引 擎 序 列 较好 。 说 经 过 一 定 周 期 后 ,如 果 对 应 的 细 部 分类 的 点 击 次
数 减 少 ,那 么 说 明此 细 部 分 类 没 有 得 到 用 户 的
图 2 适 应 函数 在 进 化 过 程 中的 作 用 ( ) 行条件。 4运
上面我们提 到 , 适应函数是遗传算 法的关
读入 一 组 数据
键 , 足 本 设 计不 断 “ 化 ” 源 动 力 。 们 可 用 它 进 的 我 图 2来 表 示 它 的 重 要 性 。 对于本设计来 说 , 数值化的计算适 应函数 的值是 比较 困难的 ,因为衡量每个独立搜索引 擎 的 性 能 参 数 多 ,我 们 无 法 确 切 地 知 道 它 的 具
信l j I 息科学
科
遗传 算 法在 面 向主题 的元 搜 索 引擎设 计 的 改 进 及 应 用
苏 超
( 州技 师 学院 , 江 杭 州 3 10 ) 杭 浙 15 0
摘 要: 浅析遗传 算法在 面向主题 的元搜 索引擎设计 的改进及应 用。 关键词 : 遗传算法 ; 主题 ; 元搜 索引擎 向主题的元搜索引擎设计 中 , 我们首先要 和 自然界 的现象 一样 , 变异 的概率 是不应 提供 多个 大的分类 ,然后在每个大 的分类 内部 该是很高的 。但是过小的变异概率也是不合适 很有可能通过变异 , 某个个体发生跳跃性的 提供多个细部 分类 。例如 , 在计算机大类 中 , 我 的 。 们 提 供 了诸 多 细部 分 类 , 如 网络 设 汁 、 络施 改 变 。 例 网 工等。那么这些细部分类就是遗传算法 中提 到 的 个 体 , 个独 立 搜 索 引擎 就 是 基 因 。 每 根据 本 设计 的 实 际 情 况 , 我们 对 现 有 的遗 传 算 法 作 了相 应 的 改进 ,改 进 后 的遗 传 算 法 体数值 , 即使知道了 , 适应 函数本身的定义也是 困难 的, 有可能适应函数本身是不确切的 , 它不 能准确地反映出个体的“ 适应性” 。还有一点最 重 要 , 是 这 些 参 数 是 时 时 刻 刻 在 变 化 的 , 果 就 如 计算具体的 函数值 , 将给系统的更新 、 维护带来 极大 的困难 。 因此 , 在本设计 中, 我们取消 了“ 适 应 函数值计算”这一步骤 ,同时我们也取消 了 “ 足 适 应 条 件 ” 一 步 骤 , 而 代 之 的是 “ 行 满 这 取 运 条 件 ” 。 在传统 的遗传算 法中 , 如果个体 不满足结 果 输 出 的条 件 , 继 续 此 算 法 的运 行 , 到 满 足 则 直 结果输 出条件为止 。 但在本设计 中, 我们并不知 道正确 的结果应该是什么样 的,具体 的值是多 少 。也就是说 , 这个结果是不确定 的, 它跟用户 的访 问情况有关 。 现在 , 我们通过 “ 运行条件 ” 使 遗传算法运行下去 ,这个运行条件可 以由我们 自己设 定 ( 似 于数 据 库 中 的 “ 发 器 ” 。它 实 的 方 向 发 展 。 类 触 ) 际上 是 变 被 动 运 行 为主 动 运 行 。 这 里 , 行 条 在 运 总 之 , 合 本 没 计 的 实 际 情 况 , 过 对 遗 结 通 件是一个时 间值 , 只要达到一定 的时 间, 我们就 传 算 法 的 改进 , 好 的实 现 了 本 系 统 的 “ 化 ” 较 进 促 使 遗 传 算 法 运 行 ,它 更 符 合 自然 界 生 物 进 化 功能 , 从而更好的提高了用 户满意度 。 的规律 。 ・ 本设 计的最终使用者是用户 , 那么用户 的 评 价 是 最 重 要 的 。 如果 用 户对 某 一 细 部 分 类 的 搜 索能力 比较满 意的话 ,总体 的访 问量 就会 随 之 上去 , 反之 , 则会 下 降 。 之 , 户 的 访 问行 为 总 客 是元搜索 引擎搜索 能力优 劣的“ 晴雨表 ” 那么 , 。 如何 知道 客户的访 问行 为呢?我们可 以在网页 中编写一些代码 ,来 自动地将用户 的访 问行 为 记 录在数据库 中 , 通过对其分 析, 我们可 以发 现 些 有规律 的东西 ,进 而定义 出相应 的适应 函 数 。在本设计 中 , 只要 点击一 次搜索结果 , 么 那 相应 的数据 就会 记录在数 据库 中。用户访 问的
计算机科学与技术专业毕业设计题目参考3

11
标题:基于radius的用户认证计费系统(3人)
目的:通过毕业设计,对网络协议,jsp开发,软件设计方面知识进行整合。
内容:网络计费系统从业务管理、客户管理、计费管理、用户自服务和网络管理等方面对数据网络的业务运营进行统一管理。计费管理(Realtime Billing):汇总各种业务的费用信息,包括开户费、月租费、使用费等,进行统一的结帐,生成帐单。维护管理(Operation Management):远程监控系统的运行状态,完成对整个系统的监测与控制
参考资料:JSP或ASP相关书籍,SQL数据库使用,2002;《数据库系统概论》。
5
标题:教学质量监控与信息反馈系统(2人)
目的:细化我院教学质量指标,科学进行教学质量监控和信息反馈
内容:本系统主要包括系部教学工作质量评价、日常教学质量检查、教学检查评价结果分析、学生评教,教师教学信息等。本系统采用B/S架构,前台开发工具为ASP或JSP,数据库采用SQL Server。
内容:本系统以工厂作业流程为基础,根据企业的物料购入作业流程而开发,其基本作业流程为:各分厂根据实际生产状况以及客户所下定单状况,统计出各种物料需要订购情况,并开列申购单;申购单经过审核,开列出订购单。企业根据审核的订购单进行物料采购。本系统先建立基本资料,并提供申购单、订购单开列,申购、订购报表开列功能。本系统采用C/S架构,前台开发工具为Visual Basic或Delphi,数据库采用SQL Server。
监控部分:对安全级别要求高的楼宇进行安防设计、主要是监控机房的设计和监控设备的布局和集成。
停车场系统:对校园内的停车系统进行统一的管理。
门控、门禁系统:对校园内的楼宇实行可视对将管理和电子地图控制。
主题Web信息采集技术

作者简介:杜 欢 ( 90 ),男,重庆人,助教 ,主要从事计算机 网络 方面的研 究。 18.
维普资讯
第2 卷 第5 0 期
杜 欢: 主题 We 息 采集技 术 b信
( 3)能够 方便地 对 专题 和学 科进 行 配置 。 为 了满 足这 些新 的要 求 ,主 题 型搜索 引 擎应运 而 生 。 12 主题 We . b信 息采 集技 术的 研 究现状
维普资讯
第2卷 第5 0 期
2o 年 1 07 0月
四川理 工学院学报 ( 自然科学版 )
J OURNAL I HUAN OF S C I E I Y RS N
Oc. 0 7 t2 0
文献标 识码 :A
1研 究现 状
11主题 We _ b信 息采 集技 术的产 生 背景
目前 , I e t 在 n me 的各种应用中,以 We 应用最为普及 , t b 发展速度尤为迅速, b 的信息资源也 We 上 急剧增加 0据统计 ,目前 We b上的文档个数已超过 10亿[,并且 以每天 70万个的速度增长。由于 0 1 】 5 w_ e b资源 的异构性 、开放性和广泛分布性等特点 ,使用户在获取 自己需要的信息资源时面临很大 的困 难。搜索引擎的出现为解决这一问题提供了重要的途径 ,它也逐渐成为用户在 We b上获取信息的主要 工具 。 通用搜索引擎 的出现很大程度上解决 了人们在互联网上查找信息的困难 , 但是 目 前通用搜索引擎在 使用 中也面临着许多问题 : () 1 大规模的分布式数据源。基于 We b的自身特点 ,大量的数据分布在数以亿计的计算机互联网 上 ,检索起来困难重重【 】 2。 。 () 2 网络信息的质量问题。互联 网上的信息无论从数量和类型都呈指数增长 ,大量信息的存活期
大数据经典算法PageRank 讲解
如果按这个公式迭代算下去,会发现自连接点的问题解决了,从而每个页面 都拥有一个合理的pagerank。
分块式Pagerank算法:
火龙果整理
单击此处添加段落文字内容
原来的算法存在的问题:
1.时间开销大。每次迭代就算时间开销为
2.因特网中数据大部分是分布式的,计算过程需要多次传递数据,网 络负担太大。
火龙果整理
PageRank算法
基本PageRank 面向主题PageRank Link Spam与反作弊 导航页与权威页
一小组:王高翔,李渠,刘晴,柳永康,刘昊骋 二小组: 王飞,李天照,赵俊杰,陈超,陈瑾翊
一.Pagerank定义及终点,自连接点的概念
早期搜索引擎的弊端
火龙果整理
火龙果整理
TrustRank
TrustRank的思想很直观:如果一个页面的普通rank远高 于可信网页的topic rank,则很可能这个页面被spam了。 设一个页面普通rank为P,TrustRank为T,则定义网页的 Spam Mass为:(P – T)/P。 Spam Mass越大,说明此页面为spam目标页的可能性越 大。
为了克服这种问题,需要对PageRank 计算方法进行一个平滑处理,具体做 单击添加 法是加入“跳转因子(teleporting)”。所谓跳转因子,就是我们认为在任 何一个页面浏览的用户都有可能以一个极小的概率瞬间转移到另外一个随机 页面。当然,这两个页面可能不存在超链接,因此不可能真的直接转移过去, 跳转因子只是为了算法需要而强加的一种纯数学意义的概率数字。
3.n维矩阵式一个稀疏矩阵,无论计算还是存储都很浪费资源。
能否考虑先算出局部的Pagerank值??
分块式Pagerank算法:
一种面向主题的搜索引擎的实现
面 向主题 的搜 索 引 擎 又称 垂 直 搜 索 引 擎 , 是 目前研究 的热 点之 一 。垂 直搜 索引擎 一般 都 面 向 行业 , 它会 对某 一领 域 的内容进 行搜索 , 有 很强 具
的针对性 , 与通用 搜索 引擎 主要 的不 同之处 是 : 它 首 先 , 户体验 上不 同 , 直搜索 引擎 的结 果 比较 用 垂 符 合用 户的需 求 , 因为 它 本身 搜 索 的 就 是某 一 主
Apr 2 08 .0
一
种 面 向主题 的搜 索 引擎 的实 现
同 汉 高 波
( 州 工 学 院 延 陵 学 院 , 苏 常州 2 3 0 ) 常 江 10 2
摘要 : 直搜 索 引擎的 实现 涉及 到 多方 面的 内容 , 要 包括 网站模 式定 义 、 垂 主 网站 模 式描 述 、 字段 语 义对 照、 更新周期 规 划、 复性数据 判 别 、 史数 据 清 除等 。文章 以 ht :/ w. fu d cm 的 重 历 t / ww co n .o p
搜 索引擎搜索 到的信 息越 来越 不 能满 足 人们 的需
求, 因此新 一代 搜 索 引 擎 的研究 得 到 了长 足 的 发
1 关键 技 术 与 算 法
实现 一个搜索 引擎 , 及 到 多方 面的技 术 , 涉 每
种技术都要通过各 种算法来 实现 , 下面介 绍一下搜
展 , 一代 搜索 引擎 主要 从语 义 化 、 户 体验 多样 新 用
序 , 时 间先后 的顺 序排 序等 ; 如按 另一个 重要 的 区 别在 于 , 垂直 搜 索 引 擎对 某 一 主题 的数 据更 新 速 度快 , 而通 用搜 索 引 擎 的更 新速 度 比较慢 。除 了 以上 区别 以外 , 直搜 索 引擎 还涉 及 中文分词 、 垂 分
web of science 的主题检索的原理
web of science 的主题检索的原理
Web of Science是一个由Clarivate Analytics提供的学术数据库,用于检索各个学科的科学文献。
它基于一种名为"主题集"(subject categories)的方法来进行主题检索。
主题集是一个预定义的、按学科分类的主题列表。
每篇被索引的文献都会被分配到一个或多个主题集中。
这些主题集代表了不同的学科领域,例如生物学、化学、物理学等等。
在Web of Science中进行主题检索时,用户可以选择一个或多
个主题集来限定检索范围。
系统将只返回被分配到这些主题集中的文献结果,从而提供一个特定学科领域的文献集合。
同时,Web of Science还利用了一种名为"被引频次"(cited reference)的方法来评估文献的影响力。
每篇文献中引用的其
他文献以及引用该文献的其他文献都被记录下来,并用于计算该文献的被引频次。
这使得用户可以根据文献的被引频次进行主题检索,并找到最具影响力的研究。
总结起来,Web of Science的主题检索原理主要包括以下两个
方面:
1. 使用主题集来限定检索范围,用户可以选择一个或多个主题集来获取特定学科领域的文献集合。
2. 利用被引频次方法来评估文献的影响力,并根据被引频次进行主题检索,找到最具影响力的研究。
检索步骤及检索式构造
截词截得过短;
输入的检索词太少;
应该用“与(*)”的使用了“或(+)”;
优先运算符“()”使用错误。
五、调整检索策略(正式检索)
2.检索结果信息量太少的原因:
检索词拼写错误;
遗漏重要的同义词或隐含概念;
检索词过于冷僻具体;
字段算符使用的过多;
使用过多的“AND”算符。
六、获取原始文献
满 意: 打印、Email或存档
是否需要获取全文 ?
图书馆期刊、资料。
利用全文数据库直接获取
利用文献传递系统获取(原文传递服务) 利用文摘数据库的原文服务 利用OPAC检索系统,进行馆际互借
信息检索的步骤图
分析检索课题 1.主题概念 2.信息类型 3.时间范围 4.检索目的 选择检索系统 1.学科范围 2.系统类型 3.系统功能 确定检索词 1.切分 2.删除 3.替补 4.组合 5.增加
用户评价 调整检索策略 (正式检索) 1,信息量过多时 2.信息量太少时
输出检索结果 1.文摘 2.全文
构造检索式 (试验性检索) 1.简单提问式 2.上下文提问式 3.复合提问式 4.结构性提问式
一、分析检索课题
① 分析课题的主题内容
② 确定检索时间范围
③ 确定课题的文献类型
④ 分析检索评价要求
⑤ 分析检索是否有特殊要求
二、选择检索系统
掌握数据库资源所覆盖的学科范围
掌握各种数据收录文献的类型
程进行谋划之后所制定的全盘检索方案。
在实施检索时,应及时分析:
结果与检索的内容、目的和要求是否一致,
同时根据检索结果的多少对检索策略进行相应的 修改和调整,以获得最佳的查全率和查准率, 直至得到比较满意的检索结果为止。