
slub工作原理详解
Joonsoo Kim LGE CTO SWP Lab. iamjoonsoo.kim@ js1304@
Contents
• • • • Memory allocation hierarchy Implementation – the SLUB Difference between the SLAB and the SLUB Current status
interrupt
read freelist of kmem_cache_cpu detach first object(A)
detach first object(A) assign following object(B) to freelist return object(A)
return from interrupt
return from interrupt
this_cpu_cmpxchg_double: new freelist(B),new tid
return object(A)
no need “irq disable”
Performance optimization: freelist of a slab
A DIFFERENCE BETWEEN THE SLAB AND THE SLUB
Caching policy
cpu0
cpu1
kmem_cache
In case of the SLAem_cache_node slab
In case of the SLUB
slab
assign following object(B) to freelist
return object(A)
crash
need irq disable
Performance optimization: freelist of kmem_cache_cpu
allocation request
new allocation request read freelist, tid of kmem_cache_cpu
cpu2
kmem_cache
cpu3
case 4. first free object
node0 kmem_cache_node slab case 2. normal case
slab
discard
case 3. inuse = 0
Performance optimization
• this_cpu_cmpxchg_double
Allocation hierarchy
generic kernel code
object allocator
page allocator (buddy allocator)
physical page frame
Warning: term
• “the SLAB allocator” vs “the slab”
Any questions?
return this object
freelist
tid cpu slab partial slabs kmem_cache_cpu slab
slab
slab
free object
slab
Allocation: slow-path
freelist
tid cpu slab partial slabs kmem_cache_cpu slab 2 4
freelist
tid cpu slab partial slabs kmem_cache_cpu slab2
slab1
slab3
free object
slab
Free: slow-path
cpu0 cpu1
case 1. remote cpu slab slab
slab add a slab to cpu partial list
1 slab try on node partial slabs
slab
3
free object
slab
Allocation: very slow-path
per cpu name size align … cpu0 cpu2 cpu1 freelist
tid
cpu slab partial slabs 1
Free object management
cpu object cache
data structure max number of objects size (64bits)
The SLAB
array 120 120 * 8 bytes
The SLUB
list don’t care 8 byte
• The object allocator providing same API
– The SLAB allocator: traditional allocator – The SLOB allocator: for embedded system – The SLUB allocator: default, for large system
• • • • • kmalloc alignment fallback order slab kmem_cache alignment debugging feature NUMA
CURRENT STATUS
Trends
• per cpu partial lists • common sl[aou]b • slab accounting for memcg
– the SLAB allocator
• one of the object allocator
– the slab
• just data structure • used by the slab allocator and the slub allocator
IMPLEMENTATION - SLUB
MEMORY ALLOCATION HIERARCHY
Page allocator
• page allocator
– fundamental memory allocator – manage all physical memory in system – page size = 4096 bytes – allocate 2order pages at once
struct page
Per cpu structure
free objects from slab1
freelist
tid cpu slab partial slabs kmem_cache_cpu slab2
slab1
slab3
free object
slab
Allocation: fast-path
interrupt
read freelist, tid of kmem_cache_cpu detach first object(A)
detach first object(A) this_cpu_cmpxchg_double: new freelist(B),new tid retry fail
slab caches slab slab slab
slab
slab
object
Slab
1 page
1 page fragmentation freelist inuse
1 page
slab
index
slab
_mapcount
objects
lru
…
overload
frozen
lru
… struct page
Overall structure
UMA, SMP
per cpu name size align … cpu0 cpu1
cpu2
cpu3
kmem_cache
kmem_cache_cpu per node
kmem_cache
kmem_cache
node0 kmem_cache_node
kmem_cache
• limit
– size less than page size
What is the SLAB allocator?
• The SLAB allocator
– in-kernel library like in-userspace library malloc() – kmalloc() = malloc() – kmem_cache_create(), kmem_cache_alloc(), …
acquire freelist of slab
read freelist, counter of slab insert object into freelist of slab read freelist, counter of slab
attach one object(A)
acquire freelist cmpxchg_double_slab: new freelist(NULL), new counter retry fail allocation path no need “lock” cmpxchg_double_slab: new freelist(A), new counter success free path
slab
data structure max number of objects size (64bits)
The SLAB
array 202 202 * 4 bytes
The SLUB
list don’t care 8 byte (overload “struct page”)
libusb的io原理

libusb的io原理LibUSB 的 I/O 原理LibUSB 是一个跨平台的库,用于与 USB 设备进行交互。
它提供了一组函数,允许应用程序发送和接收 USB 数据,配置设备设置并管理设备状态。
I/O 模式LibUSB 提供了两种主要 I/O 模式:同步和异步。
同步 I/O:在这种模式下,应用程序会调用一个函数并等待它执行完毕。
这种模式简单且易于使用,但会阻塞应用程序,直到操作完成。
异步 I/O:在这种模式下,应用程序将操作提交给 LibUSB,LibUSB 会在后台执行操作。
应用程序可以继续执行其他任务,而LibUSB 会在操作完成时通知应用程序。
数据传输LibUSB 通过使用端点来传输数据。
端点是 USB 设备上的逻辑通道,用于发送和接收数据。
每个端点都有一个方向,可以是输入或输出。
应用程序通过调用 libusb_bulk_transfer() 函数进行数据传输。
此函数将数据缓冲区、数据长度、端点号和可选的超时值作为参数。
LibUSB 将处理数据传输并返回其状态。
设备配置LibUSB 允许应用程序配置 USB 设备的各种设置。
这些设置包括设备的地址、配置号和接口号。
应用程序可以使用libusb_get_configuration() 和 libusb_set_configuration() 函数来获取和设置这些值。
设备状态管理LibUSB 还提供了管理 USB 设备状态的函数。
这些函数包括libusb_reset_device() 和 libusb_detach_kernel_driver()。
libusb_reset_device():此函数将 USB 设备重置为其默认状态。
libusb_detach_kernel_driver():此函数将 USB 设备与内核驱动程序分离,允许应用程序完全控制设备。
错误处理LibUSB 提供了一个错误代码系统来指示操作的状态。
应用程序应该检查函数的返回值并相应地处理错误。
bootloader原理

bootloader原理引言:在计算机系统中,bootloader(引导加载程序)是启动计算机操作系统的第一个程序。
它的主要作用是初始化系统硬件并加载操作系统内核,使计算机能够正常启动。
本文将详细介绍bootloader的原理和工作流程。
一、bootloader的作用bootloader是计算机启动过程中的重要组成部分,其作用主要有以下几个方面:1. 初始化硬件:bootloader负责初始化计算机系统的硬件设备,包括CPU、内存、外设等。
通过与硬件交互,确保系统能够正常运行。
2. 加载操作系统内核:bootloader从硬盘或其他存储设备中读取操作系统内核的镜像文件,并将其加载到内存中。
加载完成后,将控制权交给操作系统。
3. 提供启动选项:bootloader可以提供多个启动选项,允许用户选择不同的操作系统或系统配置。
这在多系统或多配置的计算机中尤为重要。
二、bootloader的工作流程1. 加电自检:当计算机加电时,CPU会首先执行自检程序,检测硬件设备是否正常工作。
自检完成后,将转移到bootloader程序上。
2. 加载bootloader:在计算机的硬盘或其他存储设备中,有一个固定的位置存放着bootloader程序。
CPU会通过读取存储设备上的引导扇区,将bootloader加载到内存中。
3. 初始化硬件:bootloader会初始化计算机的硬件设备,包括CPU、内存、硬盘、显示器等。
这些初始化操作是为了确保系统能够正常运行,并为操作系统的加载做好准备。
4. 加载操作系统内核:bootloader会从存储设备中读取操作系统内核的镜像文件,并将其加载到内存中的指定位置。
加载完成后,bootloader将控制权交给操作系统。
5. 启动操作系统:操作系统接管控制权后,会执行自己的初始化操作,并进入正常的工作状态。
至此,计算机的启动过程完成。
三、bootloader的实现方式bootloader的实现方式因计算机架构和操作系统而异。
l-bus工作原理

l-bus工作原理L-Bus工作原理L-Bus是一种用于数据传输和通信的总线协议,它具有高效、可靠和灵活的特性。
本文将介绍L-Bus的工作原理,包括其传输方式、通信协议和数据处理流程。
一、传输方式L-Bus采用串行传输方式,即将数据位逐位地通过一根传输线进行传输。
传输线上通过不同的电平表示0和1,即逻辑低和逻辑高。
传输线由发送器和接收器连接,通过发送器将数据转换为电平信号发送到传输线上,接收器则将传输线上的电平信号转换为数据。
二、通信协议L-Bus使用一种简单而高效的通信协议,其中包括数据帧的格式和通信规则。
1. 数据帧的格式L-Bus的数据帧由起始位、数据位、校验位和停止位组成。
起始位用于标识数据帧的开始,数据位包含要传输的数据,校验位用于检验数据的正确性,停止位用于标识数据帧的结束。
2. 通信规则L-Bus的通信规则包括数据的发送和接收过程。
发送过程中,发送器将数据按照数据帧的格式进行编码,并通过传输线发送出去。
接收过程中,接收器从传输线上接收数据,并按照数据帧的格式进行解码。
解码后,接收器可以获得发送器发送的原始数据。
三、数据处理流程L-Bus的数据处理流程主要包括数据发送和数据接收两个步骤。
1. 数据发送数据发送的过程如下:1) 发送器准备要发送的数据,并按照数据帧的格式进行编码。
2) 发送器将编码后的数据逐位地发送到传输线上。
3) 接收器从传输线上接收数据,并按照数据帧的格式进行解码。
4) 解码后,接收器获得发送器发送的原始数据。
2. 数据接收数据接收的过程如下:1) 接收器从传输线上接收数据,并按照数据帧的格式进行解码。
2) 解码后,接收器获得发送器发送的原始数据。
3) 接收器对接收到的数据进行处理,可以根据需要进行存储、分析或进一步传输。
四、总结L-Bus是一种高效、可靠和灵活的总线协议,通过串行传输方式实现数据的传输和通信。
它采用简单而高效的通信协议,包括数据帧的格式和通信规则。
动态链接器原理

动态链接器原理动态链接器是操作系统中一个非常重要的组件,它的作用是在程序执行过程中将程序中用到的外部函数库中的函数动态地链接到程序中,以便程序能够正常运行。
动态链接器是一个独立的模块,负责在程序执行过程中将程序中的未定义函数引用链接到相应的函数库中。
动态链接器的实现原理主要包括动态链接库加载、符号解析、重定位和重定位的过程。
动态链接库加载是指在程序运行的过程中,动态链接器需要将程序中用到的动态链接库加载到内存中,以便程序能够正常访问这些库中的函数。
动态链接库通常以共享库的形式存在,不同的操作系统有不同的共享库格式,如Linux系统中的.so 文件、Windows系统中的.dll文件等。
动态链接器会在程序加载的过程中检查程序中的动态链接库依赖关系,然后按照依赖关系将相应的库加载到内存中。
符号解析是动态链接器的另一个重要功能,它的作用是将程序中的符号与库中的函数进行匹配。
当程序中调用一个未定义的函数时,动态链接器会在程序的符号表中查找这个函数的符号,并在动态链接库中查找对应的函数。
如果找到了匹配的函数,动态链接器将函数的地址替换为实际的函数地址,以便程序能够正常执行。
重定位是动态链接器的另一个核心功能,它的作用是将程序中的函数调用的地址进行重定位,以确保程序能够正确访问库中的函数。
在程序加载的过程中,动态链接器会对程序中的函数调用的地址进行修正,将这些地址指向动态链接库中的函数的实际地址。
这样,程序就可以正确地调用库中的函数,实现程序的正常执行。
动态链接器的实现原理涉及到程序的加载、符号的解析和重定位的过程,这些过程是动态链接器能够正确链接程序的关键。
动态链接器的设计能够极大地提高程序的灵活性和可移植性,使程序能够在不同的环境中正常运行。
因此,了解动态链接器的原理对程序员来说是非常重要的,能够帮助他们更好地理解程序的执行过程,提高程序的性能和可维护性。
usb hub 工作原理
usb hub 工作原理USB Hub 工作原理USB Hub(通用串行总线集线器)是用来扩展计算机USB接口的设备。
它可以将一个USB接口扩展为多个,从而实现同时连接多个USB设备的功能。
本文将从浅入深,逐步解释USB Hub的工作原理。
什么是USB Hub?USB Hub是一种设备,它具有一个Upstream口和多个Downstream 口。
Upstream口用于连接到主机电脑的USB接口,而Downstream口则用于连接其他USB设备,如鼠标、键盘、摄像头等。
USB Hub的作用是将主机电脑的一个USB接口扩展为多个接口,便于用户连接更多的USB 设备。
Hub的架构一个USB Hub内部包含多个端口。
当USB设备插入Hub的端口时,Hub会根据设备的需求进行交互,并提供适当的电力和数据传输速率。
Hub与主机电脑之间通过Upstream口进行通信,而与其他USB设备之间通过Downstream口进行连接。
数据传输流程当用户将USB设备插入到Hub的一个空闲端口时,数据传输流程如下:1.用户将USB设备插入Hub的端口。
2.Hub检测到设备插入并发送插入事件给主机电脑。
3.主机电脑收到插入事件后,发送初始化命令给Hub。
4.Hub根据设备的需求,向主机电脑请求为该设备分配适当的电力和速率。
5.主机电脑通过配置命令告知Hub分配的电力和速率。
6.Hub向设备提供适当的电力,并根据配置信息设置数据传输速率。
7.设备与主机电脑之间开始进行数据传输。
设备的供电USB Hub不仅可以传输数据,还可以为连接的USB设备提供电力。
Hub根据设备的需求动态分配电力,以满足设备的工作要求。
总线带宽管理USB Hub能管理其所有连接设备之间的数据传输。
如果多个设备同时发送数据,Hub会依照USB规范的带宽分配方法,协调数据传输,确保传输的稳定和流畅。
总结USB Hub是一种用于扩展计算机USB接口的设备。
通过将一个USB 接口扩展为多个接口,用户可以连接更多的USB设备。
slub中的kmalloc和kfree学习笔记
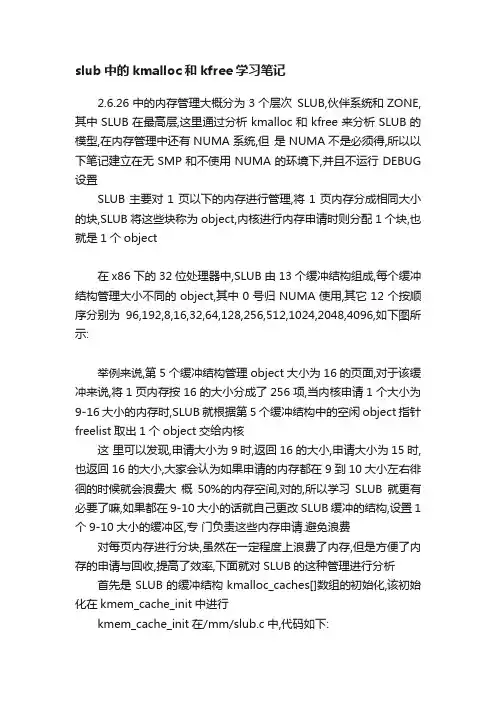
slub中的kmalloc和kfree学习笔记2.6.26中的内存管理大概分为3个层次SLUB,伙伴系统和ZONE,其中SLUB在最高层,这里通过分析kmalloc和kfree来分析SLUB的模型,在内存管理中还有NUMA系统,但是NUMA不是必须得,所以以下笔记建立在无SMP和不使用NUMA的环境下,并且不运行DEBUG 设置SLUB主要对1页以下的内存进行管理,将1页内存分成相同大小的块,SLUB将这些块称为object,内核进行内存申请时则分配1个块,也就是1个object在x86下的32位处理器中,SLUB由13个缓冲结构组成,每个缓冲结构管理大小不同的object,其中0号归NUMA使用,其它12个按顺序分别为96,192,8,16,32,64,128,256,512,1024,2048,4096,如下图所示:举例来说,第5个缓冲结构管理object大小为16的页面,对于该缓冲来说,将1页内存按16的大小分成了256项,当内核申请1个大小为9-16大小的内存时,SLUB就根据第5个缓冲结构中的空闲object指针freelist取出1个object交给内核这里可以发现,申请大小为9时,返回16的大小,申请大小为15时,也返回16的大小,大家会认为如果申请的内存都在9到10大小左右徘徊的时候就会浪费大概50%的内存空间,对的,所以学习SLUB就更有必要了嘛,如果都在9-10大小的话就自己更改SLUB缓冲的结构,设置1个9-10大小的缓冲区,专门负责这些内存申请.避免浪费对每页内存进行分块,虽然在一定程度上浪费了内存,但是方便了内存的申请与回收,提高了效率,下面就对SLUB的这种管理进行分析首先是SLUB的缓冲结构kmalloc_caches[]数组的初始化,该初始化在kmem_cache_init中进行kmem_cache_init在/mm/slub.c中,代码如下:void __init kmem_cache_init(void){int i;int caches = 0;init_alloc_cpu();#ifdef CONFIG_NUMAcreate_kmalloc_cache(&kmalloc_caches[0],"kmem_cache_node",sizeof(struct kmem_cache_node), GFP_KERNEL);kmalloc_caches[0].refcount =-1;caches++;hotplug_memory_notifier(slab_memory_callback,SLAB_CALLBACK_PRI);#endifslab_state = PARTIAL;//如果kmalloc的最小object小于64//则初始化1号和2号kmalloc_caches的大小为96和192if(KMALLOC_MIN_SIZE <= 64){create_kmalloc_cache(&kmalloc_caches[1],"kmalloc-96", 96, GFP_KERNEL);caches++;create_kmalloc_cache(&kmalloc_caches[2],"kmalloc-192", 192, GFP_KERNEL);caches++;}//按照kmalloc的最小object初始化kmalloc_cachesfor(i = KMALLOC_SHIFT_LOW; i <= PAGE_SHIFT; i++){create_kmalloc_cache(&kmalloc_caches[i],"kmalloc", 1 << i, GFP_KERNEL);caches++;}BUILD_BUG_ON(KMALLOC_MIN_SIZE > 256 ||(KMALLOC_MIN_SIZE &(KMALLOC_MIN_SIZE - 1)));//按照kmalloc的最小object重新设置size_indexfor(i = 8; i < KMALLOC_MIN_SIZE; i += 8)size_index[(i - 1)/ 8]= KMALLOC_SHIFT_LOW;if(KMALLOC_MIN_SIZE == 128){for(i = 128 + 8; i <= 192; i += 8)size_index[(i - 1)/ 8]= 8;}slab_state = UP;//按照kmalloc的最小object重新设置kmalloc_caches的名字for(i = KMALLOC_SHIFT_LOW; i <= PAGE_SHIFT; i++)kmalloc_caches[i]. name =kasprintf(GFP_KERNEL,"kmalloc-%d", 1 <<i);#ifdef CONFIG_SMPregister_cpu_notifier(&slab_notifier);kmem_size =offsetof(struct kmem_cache, cpu_slab)+nr_cpu_ids *sizeof(struct kmem_cache_cpu *);#elsekmem_size =sizeof(struct kmem_cache);#endifprintk(KERN_INFO"SLUB: Genslabs=%d, HWalign=%d, Order=%d-%d, MinObjects=%d,"" CPUs=%d, Nodes=%d\n",caches, cache_line_size(),slub_min_order,slub_max_order,slub_min_objects,nr_cpu_ids, nr_node_ids);}由于不使用NUMA系统,所以这里不会执行#ifdef CONFIG_NUMA中的代码,也就不会初始化0号缓冲所有缓冲结构的初始化都是由create_kmalloc_cache负责create_kmalloc_cache在/mm/slub.c中,代码如下:const char*name,int size, gfp_t gfp_flags){unsigned int flags = 0;//检测是否为DMA缓冲结构if(gfp_flags & SLUB_DMA)//是则加上DMA标志flags = SLAB_CACHE_DMA;down_write(&slub_lock);//分配一个缓冲if(!kmem_cache_open(s,gfp_flags,name,size, ARCH_KMALLOC_MINALIGN,flags,NULL))goto panic;//将该缓冲挂载到slab_caches链表中list_add(&s->list,&slab_caches);up_write(&slub_lock);if(sysfs_slab_add(s))goto panic;return s;panic:panic("Creation of kmalloc slab %s size=%d failed.\n", name, size);}主要的初始化在kmem_cache_open中进行kmem_cache_open在/mm/slub.c中,代码如下:static int kmem_cache_open(struct kmem_cache *s, gfp_t gfpflags,const char*name,size_t size,size_t align,unsigned long flags,void(*ctor)(struct kmem_cache *,void*)){//初始化kmem缓冲,将内容全部清零memset(s, 0, kmem_size);//设置缓冲的名字s->name = name;//设置缓冲的object初始化函数s->ctor = ctor;//设置缓冲的object大小s->objsize = size;//设置缓冲的对齐s->align = align;//设置缓冲的标志s->flags = kmem_cache_flags(size, flags, name, ctor);//根据object的大小计算对应的object数目if(!calculate_sizes(s,-1))goto error;s->refcount = 1;#ifdef CONFIG_NUMAs->remote_node_defrag_ratio = 100;#endif//初始化邻居页面链表calculate_sizes负责计算object的大小,就是对kmem_cache结构中oo,max,min成员的赋值,以及对object大小进行边界和字对齐,但是对边界和字对齐还不熟悉,所以我就不分析了 = 3=接下来是init_kmem_cache_nodes, init_kmem_cache_nodes负责对邻居页面链表进行初始化init_kmem_cache_nodes在/mm/slub.c中,由于这里不使用NUMA系统,所以代码如下:init_kmem_cache_node在mm/slub.c中,代码如下:主要进行了一下初始化工作回到kmem_cache_open中,现在到alloc_kmem_cache_cpus, alloc_kmem_cache_cpus负责CPU私有缓冲的初始化工作alloc_kmem_cache_cpus在mm/slub.c中,由于不使用SMP,所以代码如下:初始化完成后, kmem_cache_open和create_kmalloc_cache也执行完了,返回到kmem_cache_init中,接下来kmem_cache_init主要执行缓冲名字的设置工作下图是第6个缓冲结构,也就是object大小为32的缓冲初始化后的结构图kmem_cache_init执行完成后,SLUB的初始化就完成了,就接下来我们就能使用kmalloc进行内存的分配了假设kmalloc申请的大小为32,标志为GFP_KKERNEL,GFP_KERNEL是标志_GFP_WAIT , _GFP_IO 和_GFP_FS的集合,也就是kmalloc(32,GFP_KERNEL)下面就进入到kmalloc的分析中kmalloc在/mm/slub.c中,代码如下:{//也就是检测size是变量还是常量//为常量则执行ifif(__builtin_constant_p(size)){//检测申请的大小是否超过1页内存的大小if(size > PAGE_SIZE)//调用大块内存分配return kmalloc_large(size, flags);//检测申请的内存是否用于DMAif(!(flags & SLUB_DMA)){//根据申请的大小选取对应的缓冲结构struct kmem_cache *s = kmalloc_slab(size);//检测kmem缓冲取得是否成功if(!s)return ZERO_SIZE_PTR;//使用缓冲结构取得内存return kmem_cache_alloc(s, flags);}}//变量及DMA使用__kmalloc分配内存return __kmalloc(size, flags);}__builtin_constant_p检测参数是变量还是常量,举个例子说kmalloc(i,GFP_KERNEL)就是变量,kmalloc(32,GFP_KERNEL)就是常量这里先看常量,进入if中,这里先说一下kmalloc_large, kmalloc_large负责超过1页内存的申请,超过1页的内存分配由伙伴系统进行,不由SLUB进行.接下来到if (!(flags & SLUB_DMA)),这里我们申请的内存标志为GFP_KERNEL,没有DMA标志,所以进入到if中首先根据申请的大小选取对应的缓冲序号,进入到kmalloc_slab中kmalloc_slab在include /linux/slub_def.h中,代码如下:kmalloc_index在include /linux/slub_def.h中,代码如下:return 0;//检测大小是否小于kmalloc的最小objectif(size <= KMALLOC_MIN_SIZE)//小于则返回最小object的对数return KMALLOC_SHIFT_LOW;//检测kmalloc的最小object是否小于64#if KMALLOC_MIN_SIZE <= 64//大于64而小于96则使用1号kmemif(size > 64 && size <= 96)return 1;//大于128而小于192则使用2号kmemif(size > 128 && size <= 192)return 2;#endif//以下根据大小的不同,返回对应的kmem缓冲号if(size <= 8)return 3;if(size <= 16)return 4;if(size <= 32)return 5;if(size <= 64)return 6;if(size <= 128)return 7;if(size <= 256)return 8;if(size <= 512)return 9;if(size <= 1024)return 10;if(size <= 2 * 1024)return 11;if(size <= 4 * 1024)return 12;得到缓冲结构后,就来到了kmem_cache_alloc中kmem_cache_alloc在mm/slub.c中简单的调用, __builtin_return_address产生的值用于DEBUG,这里我们并不会使用到,继续来到slab_alloc中slab_alloc在mm/slub.c中,代码如下:{void**object;struct kmem_cache_cpu *c;unsigned long flags;unsigned int objsize;//保存并关闭中断local_irq_save(flags);//取得kmem缓冲中对应当前CPU序号的私有kmem缓冲c = get_cpu_slab(s, smp_processor_id());//取得缓冲中object的大小objsize = c->objsize;//检测CPU的私有kmem缓冲的空闲object指针是否为空if(unlikely(!c->freelist ||!node_match(c, node)))//为空则新申请1块页面object =__slab_alloc(s,gfpflags,node,addr, c);//不为空则使用object指针所指的objectelse{//取得空闲的objectobject = c->freelist;//object指针指向下1个空闲的objectc->freelist = object[c->offset];//设置ALLOC_FASTPATH状态计数器加1get_cpu_slab负责取得CPU的私有kmem缓冲get_cpu_slab在mm/slub.c中,代码如下由于不使用SMP,所以这里很简单,返回缓冲结构中的CPU私有缓冲结构接下来到node_match , node_match在mm/slub.c中,代码如下因为这时候是第1次调用kmalloc,所以CPU的私有kmem缓冲中的freelist指针为空所以我们进入到__slab_alloc中__slab_alloc在mm/slub.c中,代码如下:if(unlikely(!node_match(c, node)))goto another_slab;stat(c, ALLOC_REFILL);load_freelist://取得页面的空闲object指针object = c->page->freelist;//检测空闲object是否为空if(unlikely(!object))//为空则使用别的goto another_slab;if(unlikely(SlabDebug(c->page)))goto debug;//CPU的私有缓冲的object指针指向下1个空闲的objectc->freelist = object[c->offset];//设置页面的使用计数器为页面的object数目c->page->inuse = c->page->objects;//设置页面的空闲object指针为空c->page->freelist =NULL;c->node = page_to_nid(c->page);unlock_out://解除页面的锁slab_unlock(c->page);stat(c, ALLOC_SLOWPATH);return object;another_slab:deactivate_slab(s, c);new_slab://检测是否有邻居页面new= get_partial(s, gfpflags, node);//检测邻居页面取得是否成功if(new){//连接邻居页面到CPU得私有kmem缓冲上c->page =new;//ALLOC_FROM_PARTIAL状态计数器加1stat(c, ALLOC_FROM_PARTIAL);//跳转到load_freelistgoto load_freelist;}//检测是否可以中断,可以则打开IRQif(gfpflags & __GFP_WAIT)local_irq_enable();//取得1块新的页面new= new_slab(s, gfpflags, node);//关闭IRQif(gfpflags & __GFP_WAIT)local_irq_disable();//检测取得页面是否成功if(new){//取得当前CPU的私有kmem缓冲c = get_cpu_slab(s, smp_processor_id());//ALLOC_SLAB状态计数器加1stat(c, ALLOC_SLAB);//检测当前CPU的私有kmem缓冲的页面是否为空if(c->page)//释放该页面flush_slab(s, c);//为将要操作的页面上锁slab_lock(new);//设置页面属性,设置PG_active属性SetSlabFrozen(new);//连接该页面到CPU的私有kmem缓冲c->page =new;goto load_freelist;}return NULL;debug:if(!alloc_debug_processing(s, c->page, object, addr))goto another_slab;c->page->inuse++;c->page->freelist = object[c->offset];c->node =-1;goto unlock_out;}这时候CPU的私有kmem缓冲中的页面还为空,所以我们来到了new_slab标号处这里首先检测是否有邻居页面,刚初始化完出来,还没邻居呢,所以会返回空,以后我们再来分析有邻居的时候是如何分配的呢么就来到new_slabnew_slab在/mm/slub.c中,代码如下:static struct page *new_slab(struct kmem_cache *s, gfp_t flags,int node){struct page *page;void*start;void*last;void*p;BUG_ON(flags & GFP_SLAB_BUG_MASK);//取得1块新的页面page = allocate_slab(s,flags &(GFP_RECLAIM_MASK | GFP_CONSTRAINT_MASK), node);//检测取得页面是否成功if(!page)goto out;inc_slabs_node(s, page_to_nid(page), page->objects);//连接缓冲结构到该页面page->slab = s;//设置页面的slab属性page->flags |= 1 << PG_slab;if(s->flags &(SLAB_DEBUG_FREE |SLAB_RED_ZONE | SLAB_POISON |SLAB_STORE_USER | SLAB_TRACE))SetSlabDebug(page);//取得页面的起始地址start = page_address(page);if(unlikely(s->flags & SLAB_POISON))memset(start,POISON_INUSE,PAGE_SIZE << compound_order(page));//下面进行页面的object设置//首先取得页面的起始地址last = start;//按照object的大小将页面分成对应的块数//历遍块数大小//p指向页面的起始地址,每次自增object的大小for_each_object(p, s, start, page->objects){//使用缓冲的ctor函数对object进行初始化setup_object(s, page, last);//设置last所指的内容为p所指向的地址//也就是将所有object连接成1个单向链表set_freepointer(s, last, p);//设置last为plast = p;allocate_slab取得一个空的页面,并进行一下初始化,主要是将page->objects设成了缓冲成员oo中的x,这里也就是128,因为涉及到kmem_cache结构中oo成员,这个成员和边界对齐有些关系,我对边界对齐还不熟悉,就暂时不分析这个函数,不过并不会影响到下面的分析下面主要分析SLUB对页面object的初始化,也就是如何将页面分成1个个的objectfor_each_object是一个宏,在mm/slub.c中,代码如下:setup_objec在mm/slub.c中,代码如下:什么都没执行,所以这相等于一个空函数set_freepointer在mm/slub.c中,代码如下:呢么展开这几个函数,就是下列代码再将缓冲结构中的数值代入,得出这里也是SLUB最主要的部分,我们用图来说明,首先先看一下逻辑上的视图这其实连接成了1个单向链表,用链表的视角来看的话如下然后我们假设页面的起始地址为0x0000,呢么该页面的内存视图如下初始化完成后将页面的空闲object指针指向第1个object,如下然后返回到__slab_alloc中,现在跳转到标号load_freelist处首先将当前page->freelist的值赋给了将要返回的指针然后将CPU的私有kmem缓冲中的freelist,也就是空闲object 指针指向了下一项,如下将空闲object指针指向下一项的代码为c->freelist = object[c->offset] 由于c->offset为0,所以这里为c->freelist = object[0],这句代码困惑了我很久,多亏了chinaunix的dreamice和fera的提示,才顺利解决这句代码主要就是提取object指针所指的内容,object[0]也就是提取偏移为0的内容,这里object指向了第一项object,呢么object[0]就是第一项object中的下一项object地址,也就是相当于读取了一个链表节点的next节点然后将页面的freelist指针设为NULL我认为这里设为NULL的意思也就是该页面所有的项都由SLUB来管理,所以页面没有空余的项然后返回到slab_alloc中,根据__GFP_ZERO标志来判断是否需要将得到的object进行清零,然后再返回object的地址到这里kmalloc的操作就完成了现在回头看看是变量或者DMA的情况下如何进行的这种情况下会进入__kmalloc中__kmalloc在mm/slub.c中,代码如下首先进到get_slab中get_slab在mm/slub.c中,代码如下:{int index;//检测大小是否小于192if(size <= 192){//大小为0或者NULL则返回(void *)16if(!size)return ZERO_SIZE_PTR;//取得对应的kmem序号index = size_index[(size - 1)/ 8];}else//将大小转化为2进制,取得最后1位的位置index = fls(size - 1);#ifdef CONFIG_ZONE_DMAif(unlikely((flags & SLUB_DMA)))return dma_kmalloc_cache(index, flags);#endif//返回对应序号的kmem缓冲return&kmalloc_caches[index];}然后执行slab_alloc, slab_alloc在之前已经分析过了,这里就不再复述了以上只说明了第1种分配方法,根据程序的走向,kmalloc一共有4种分配方法:1. 页面为空2. 页面未满3. 页面已满4. 邻居页面未满下面分析先分析第2和第3种分配方法首先是第2种,假设还是使用kmalloc(32,GFP_KERNEL),呢么第6个缓冲结构进行第二次分配工作一路来到slab_alloc中,这次不会进入__slab_alloc了,因为这时c->freelist并不为空,它指向了页面的第二个object,然后执行下列代码: //取得空闲的objectobject = c->freelist;//object指针指向下1个空闲的objectc->freelist = object[c->offset];执行完成后的视图如下:c->freelist指向了第3个object,这里需要注意的是第1项,也就是最早分配的object,他的下一项空闲object指针也许被冲掉了,主要有2个原因,1是标志ZERO,将这个object初始化为0,2是程序的读写将指针改写了,所以如果使用kmalloc申请小于1页的内存时不使用GFP_ZERO标记,然后马上对得到的内存进行读取,呢么就能得到下一项空闲object的地址第2种分配方法一直会持续到c->freelist指向最后一项,也就是NULL,这个时候第3种分配方法就要执行了还是来到slab_alloc中,这个时候c->freelist为NULL,进入到__slab_alloc中由于这个时候CPU的私有kmem缓冲中的页面并不为空,但是页面的freelist指针为空,所以会执行if (unlikely(!object))//为空则使用别的goto another_slab;跳转到标号another_slab处执行标号another_slab处只有一个deactivate_slab函数deactivate_slab在mm/slub.c中,代码如下:static void deactivate_slab(struct kmem_cache *s,struct kmem_cache_cpu *c){struct page *page = c->page;int tail = 1;if(page->freelist)stat(c, DEACTIVATE_REMOTE_FREES);//检测object是否已经使用完了while(unlikely(c->freelist)){void**object;tail =0;/* Hot objects. Put the slab first *//* Retrieve object from cpu_freelist */object = c->freelist;c->freelist = c->freelist[c->offset];/* And put onto the regular freelist */object[c->offset]= page->freelist;page->freelist = object;page->inuse--;}由于这时c->freelist为NULL,所以不会执行while中的内容,来到unfreeze_slab中unfreeze_slab在mm/slub.c中,代码如下:static void unfreeze_slab(struct kmem_cache *s,struct page *page,int tail){struct kmem_cache_node *n =get_node(s, page_to_nid(page));struct kmem_cache_cpu *c =get_cpu_slab(s, smp_processor_id());//清除页面的PG_active属性ClearSlabFrozen(page);//检测页面的使用计数器if(page->inuse){//检测页面的空闲object指针是否为空if(page->freelist){//不为空则添加到邻居页面链表中add_partial(n, page, tail);stat(c,tail ?DEACTIVATE_TO_TAIL :DEACTIVATE_TO_HEAD);}else{stat(c, DEACTIVATE_FULL);if(SlabDebug(page)&&(s->flags & SLAB_STORE_USER))add_full(n, page);}slab_unlock(page);}else{stat(c, DEACTIVATE_EMPTY);//检测缓冲中的邻居页面计数器是否达到了最小值if(n->nr_partial < MIN_PARTIAL){//加入到邻居页面链表中add_partial(n, page, 1);slab_unlock(page);}else{slab_unlock(page);stat(get_cpu_slab(s,freelist为NULL,所以进入到else中else中主要执行了状态计数器的增加和DEBUG测试,并没有什么实质性的工作,然后就退出了回到__slab_alloc中,又来到了new_slab,这个时候邻居页面链表还是为空,所以又执行了1次第1种分配方法,分配了1个新的页面接下来先分析kfree,然后再看第4种分配方法kfree负责回收使用的内存,kfree在mm/slub.c中,代码如下:这里假设使用kfree回收的地址的页面结构属于SLUB管理的页面,也就是具有pageslab属性,不会进入到if中__builtin_return_address产生的值用于DEBUG,这里我们并不会使用到然后进入到slab_free中slab_free在mm/slub.c中,代码如下如果为当前页面,假设c->freelist指向第3项object,我们所要回收的是第1项object,呢么视图如下:这里主要将设置object所指的object中的空闲object指针指向c->freelist,然后再将c->freelist指向object,指向完毕后的视图如下: 当不为当前页面的时候,则进入到__slab_free中__slab_free在mm/slub.c中,代码如下:void*x,void*addr,unsigned int offset){void*prior;void**object =(void*)x;struct kmem_cache_cpu *c;//取得当前CPU的kmem缓冲c = get_cpu_slab(s, raw_smp_processor_id());stat(c, FREE_SLOWPATH);//将页面上锁slab_lock(page);if(unlikely(SlabDebug(page)))goto debug;checks_ok://将object的下一空闲object指针指向页面的下一空闲object//并且将页面的下一空闲object保存在priorprior = object[offset]= page->freelist;//将页面的下一空闲object指针指向当前objectpage->freelist = object;//减少页面的使用计数器page->inuse--;//检测页面是否有PG_activeif(unlikely(SlabFrozen(page))){stat(c, FREE_FROZEN);goto out_unlock;}//检测页面的使用计数器是否为0if(unlikely(!page->inuse))goto slab_empty;//检测页面原来的下一空闲object指针是否为NULLif(unlikely(!prior)){//将该页面添加到缓冲的邻居页面中add_partial(get_node(s,page_to_nid(page)), page, 1);stat(c, FREE_ADD_PARTIAL);}out_unlock:slab_unlock(page);return;slab_empty://检测页面原来的下一空闲object指针是否为NULLif(prior){//从邻居页面链表中移除该页面remove_partial(s, page);stat(c, FREE_REMOVE_PARTIAL);}__slab_free首先进行再连接过程,就如上面为当前页面差不多,然后有两种选择,1种是加入到邻居页面链表中,另1种是释放该页面先看加入到邻居页面链表中当检测使用计数器不为0,并且原下一空闲object指针为NULL的时候(不为NULL说明已经加入到邻居页面链表中了,不需要再加1次),就会执行add_partial不过首先先看get_nodeget_node在/mm/slub.c中,代码如下:由于我们不使用NUMA,所以不论node的结果如何,get_node都返回&s->local_node然后到add_partial,add_partial在mm/slub.c中,代码如下连接完成后的结构图如下:然后看释放该页面如果使用计数器为0则跳转到标号slab_empty处首先检测是否在邻居页面链表中,如果在则执行remove_partial函数remove_partial在mm/slub.c中,代码如下:简单的将页面移除并减少邻居页面计数器最后执行discard_slab释放页面,由于discard_slab和伙伴系统牵涉较深,等之后的伙伴系统学习笔记再分析吧 = 3=好,现在邻居页面链表中有存货了~ 我们看看第4种分配方法当第2种分配方法一直持续到c->freelist指向最后一项,也就是NULL,并且邻居页面链表中有存货的时候,就会进入到第4种分配方法第4种分配方法其实属于第3种方法的分支,当第3种方法进入到标号new_slab处时,进入get_partial从邻居页面链表中取得页面成功就为第4种分配方法现在进入get_partial函数中get_partial在mm/slub.c中,代码如下:get_node在之前已经分析过了,他会返回&s->local_node; 然后到get_partial_node中get_partial_node在mm/slub.c中,代码如下主要就是历遍partial链表寻找对应的页面,视图如下:红线是prev,蓝线是next, partial以next为顺序进行历遍,因为最后1个page是最后加入的然后执行lock_and_freeze_slablock_and_freeze_slab在mm/slub.c中,代码如下如果页面锁定属性为0则锁定并返回操作成功如果页面锁定属性已经为1,则不能操作该页面,返回0表示失败get_partial返回页面后跳转到load_freelist处,接下来的执行就和之前的几种方法一样了= 3= 笔记就到此结束了在这次分析中心中还是有不少疑问的,像page中的inuse属性,这个属性目前分析是只在初始化中复制,只有每次kfree的时候减一,而从不自增,如果一个页面一直减一,但其内容一直为满的话,如果最后inuse 属性为0的时候,不就把页面所有的内容都释放掉了,呢正在使用中的object也释放掉了,呢么不就导致内存同步错误了还有分析过程中的一些函数不能理解是什么时候才调用的看来光有理论还不行啊~ 还需要多实践才能搞明白 T 3T希望大家喜欢~ = 3=)/。
lsusb 原理
lsusb 原理
lsusb 原理:
lsusb是Linux系统中的一个命令行工具,用于列出系统中连接的USB设备信息。
它通过读取系统中的USB设备文件,从而得到设备的相关信息。
lsusb在执行时,会扫描/sys/bus/usb/devices/目录下的所有USB设备节点文件。
每个USB设备都有一个唯一的节点文件,其中包含了设备的厂商ID、产品ID、
设备类型、设备接口等信息。
lsusb命令输出的结果包含了几个重要的信息:
1. Bus号和设备号:每个USB设备都与主机通过USB总线进行连接,每个总
线上有多个设备。
Bus号表示设备所在的USB总线号,设备号表示设备在该总线
上的编号。
2. 设备的厂商ID和产品ID:厂商ID由USB论坛分配给设备制造商,用于唯
一标识设备制造商;产品ID由设备制造商分配给设备型号,用于唯一标识设备型号。
3. 设备类型和设备接口:设备类型表示USB设备的功能类型,例如存储设备、音频设备等;设备接口表示设备所支持的USB接口类型。
通过lsusb命令,我们可以快速了解系统中连接的USB设备的基本信息。
对于
开发人员和系统管理员来说,lsusb命令是一个非常有用的工具,可以帮助他们诊
断USB设备的连接问题、查找特定设备的详细信息,以及进行设备的管理和配置。
总结起来,lsusb命令使用简单,通过读取USB设备文件得到设备的相关信息。
它可以帮助用户快速了解系统中连接的USB设备的基本信息,为故障排除和设备
管理提供便利。
l-bus工作原理
l-bus工作原理L-Bus工作原理L-Bus(Local-Bus)是一种局域总线,广泛应用于工业自动化、机器人控制、自动化仪器等领域。
它是一种串行通信总线,用于连接各种设备和模块,实现数据的传输和控制。
L-Bus的工作原理基于主从架构,其中包括一个主站和多个从站。
主站负责发送指令和接收数据,从站负责接收指令和发送数据。
主站和从站之间通过L-Bus进行通信。
L-Bus使用差分信号传输数据,其中包括正向信号和负向信号。
正向信号和负向信号的电平差异表示二进制数据的0和1。
这种差分信号传输方式具有抗干扰能力强、传输距离远等优点,适用于工业环境中的噪声和干扰较大的场景。
L-Bus采用主机轮询的方式进行通信。
主站按照一定的时间间隔轮询各个从站,发送指令并接收数据。
从站在接收到指令后,根据指令内容执行相应的操作,并将执行结果发送给主站。
主站根据从站的响应情况,决定是否继续轮询下一个从站。
L-Bus的通信速率可以根据具体的应用需求进行调整。
通常情况下,L-Bus的通信速率较低,一般在几千位每秒到几十万位每秒之间。
这种较低的通信速率可以确保通信的可靠性和稳定性,避免数据传输过程中的错误和丢失。
除了基本的数据传输功能,L-Bus还支持多种通信方式,如广播通信、单点通信和多点通信。
广播通信是指主站向所有从站发送相同的指令,适用于需要同时控制多个设备的场景。
单点通信是指主站与某个指定的从站之间进行通信,适用于只需要与某个特定设备进行交互的场景。
多点通信是指主站与多个从站之间进行独立的通信,适用于需要与多个设备同时进行交互的场景。
总结起来,L-Bus是一种基于串行通信的局域总线,采用差分信号传输数据。
它具有抗干扰能力强、通信稳定可靠的特点。
通过主从架构和主机轮询的方式实现数据的传输和控制。
除了基本的数据传输功能,还支持广播通信、单点通信和多点通信等多种通信方式。
L-Bus在工业自动化、机器人控制等领域发挥着重要的作用,为各种设备和模块之间的通信提供了可靠的解决方案。
linux slab 原理
linux slab 原理Linux Slab原理:Linux内核中的Slab是一种内存分配机制,用于高效管理内核对象。
它的原理是基于对象缓存,通过预分配和缓存对象来加速内存分配和释放操作。
Slab划分了三层:slab、cache和slab pages。
Slab是指以固定大小的块的形式存储对象的一组连续内存区域,称为slab cache。
Cache是指一组相关slabs的集合,每个cache对应一种特定类型的对象。
Slab pages是物理内存中的一页,用于存储多个slabs。
Slab机制的工作流程如下:1. 初始状态下,cache为空,没有分配任何slabs。
2. 当需要分配对象时,将会查找cache中是否存在合适的slab。
如果找到,就从slab中分配一个对象,并将剩余的对象放回cache中;如果没有找到,进入步骤3。
3. 在内存中分配一个新的slab,将其存放在cache中,并将需要的对象分配给用户。
同时,将剩余的对象放入空闲列表中。
4. 当对象被释放后,将其放回cache的空闲列表中,以待下次分配。
使用Slab机制的优点如下:1. 对象的分配和释放速度快:由于预分配的对象存储在内存中,可以直接从slab中分配/释放,避免了内存碎片和频繁的动态内存分配。
2. 缓存利用率高:通过预分配和缓存,重复使用对象,减少了内存分配的开销。
3. 减少了内存碎片:Slab机制通过将对象存储在对齐的连续内存区域中,减少了内存碎片的产生。
总结:Slab是Linux内核中用于管理内存对象的分配机制。
通过预分配和缓存对象,Slab机制提供了高效的内存分配和释放操作。
它的优点包括快速分配和释放、高缓存利用率以及减少内存碎片。
在Linux中,Slab机制对于提高内核性能和减少内存开销发挥着重要作用。
USB传输工作原理
USB传输工作原理USB(Universal Serial Bus,通用串行总线)是一种广泛应用的计算机外部接口标准,广泛用于个人电脑及其外围设备之间的数据传输和通信。
本文旨在介绍USB传输的工作原理,从物理连接、数据传输、电源供应以及协议控制几个方面进行讲解。
一、物理连接USB传输的物理连接方式采用了一对差分信号线来传输数据,其中包括一个用于发送数据的正向差分信号线(D+)和一个用于接收数据的反向差分信号线(D-)。
这对差分信号线以双绞线的形式进行布线,以减少电磁干扰和信号失真的影响。
此外,USB接口还包括公共地线(GND)和电源线(Vcc),用于提供电源供应和信号屏蔽。
二、数据传输USB传输采用了主从设备的工作模式。
在数据传输过程中,主设备负责控制与调度,而从设备负责接受和响应主设备的指令。
USB传输支持两种模式:同步传输(Synchronous Transfer)和批量传输(Bulk Transfer)。
同步传输用于传输对实时性要求较高的数据,如音频和视频等,而批量传输适用于对实时要求较低的数据传输,如打印机的数据传输等。
数据传输过程分为三个阶段:令牌阶段、数据阶段和握手阶段。
令牌阶段由主设备发出令牌包,用于指定传输的方向和地址。
数据阶段用于实际的数据传输,其中包括数据包和错误检测码等信息。
握手阶段用于确认数据传输的成功与否,并进行必要的错误处理。
三、电源供应USB接口不仅可以传输数据,还可以为外部设备提供电源供应。
根据电源供应的要求,USB接口定义了四种不同的电源供应模式:总线供电模式、自供电模式、远程供电模式和混合供电模式。
总线供电模式中,主设备向从设备提供电源供应,常用于对功耗要求较低的设备。
自供电模式中,从设备自行提供电源供应,适用于对功耗要求较高的设备。
远程供电模式中,主设备向从设备提供电源供应,且从设备能够回馈部分电能,常见于USB充电设备。
混合供电模式则是上述模式的组合,灵活应用于各种不同的设备需求。