
深度优先遍历寻找图中两节点之间所有路径
-2-
continue; //如果 j 所对应的顶点在路径中,就不遍历该顶 点,否则遍历
if (G.E[index][j] == 1) DFS(G.V[j],E);
} path.pop_back(); //返回上一层时删除路径末尾值 }
-4-
cout << endl; path.pop_back(); //返回上一层时删除路径末尾值 return; }
//如果未找到终点,继续深度遍历 int index = find(G.V.begin(), G.V.end(), B) - G.V.begin(); for (int = 0; j < (int)G.V.size(); j++) {
int B, E; cout << "输入所求路径的起始点和终止点的值:" << endl; cin >> B >> E;
cout << "由" << B << "到" << E << "的路径为:" << endl; DFS(B,E);
-3-
system("pause"); } 代码中所用例图为:
深度优先遍历寻找图中两节点之间所有路径
李荣贵 < 东南大学计算机科学与信息学院 南京 >
前段时间写程序时用到深度优先算法寻找图中两点之间的路径, 发现网上相关的文章比较少,有的还有问题,就写了这篇文章,以供 新手们参考学习,以下代码都已经过测试,欢迎大家与我探讨交流!
程序中的图是无向无权图,我使用邻接矩阵表示,如果两个顶点 之间有边,对应的邻接矩阵相应位置的值为 1,否则为 0。遍历过程 中用一个全局变量 path 保存路径,在遍历下一节点之前需判断该节 点是否在路径中,如果在则不遍历该节点,否则遍历,这样可以防止 遍历出现死循环。遍历到某节点时,将其保存到 path 中,递归返回 上一层前,需从 path 中删除当前节点,由于递归在两种情况下返回 上一层:一,找到终点;二,该节点的邻节点已遍历完;故代码中有 两条“path.pop_back();”语句。接下来给出源代码:
void DFS(int B,int E) //深度遍历图 {
path.push_back(B); //保存顶点值到路径中 if (E == B) //如果找到了终点,输出路径 {
for (auto it = path.begin(); it != path.end(); ++it) cout << *it << " ";
#include <iostream> #include <vector> #include <algorithm> using namespace std;
struct Graph {
vector<int> V; //保存图中顶点的值
-1-
vector<vector<int>> E; //图的邻接矩阵 }; Graph G; vector<int> path; //用于保存遍历过程中所走过的顶点值
void main() {
vector<int> V = { 2, 6, 7, 9 }; G.V = V; vector<vector<int>> edges = { { 0, 1, 1, 0 }, { 1, 0, 1, 1 }, { 1, 1, 0, 1 }, { 0, 1, 1, 0 } }; G.E = edges;
深度优先遍历的算法
深度优先遍历的算法深度优先遍历(Depth-First Search,DFS)是一种用来遍历或树或图的算法。
它以一个起始节点开始,沿着路径尽可能深地,直到到达最深处或无法继续为止,然后回溯到上一个节点,继续其他路径。
DFS通过栈来实现,每次访问一个节点时,将其标记为已访问,并将其相邻的未访问节点压入栈中。
然后从栈中弹出节点,重复这个过程,直到栈为空为止。
1.创建一个栈,用来存储待访问的节点。
2.将起始节点标记为已访问,并将其压入栈中。
3.当栈不为空时,执行以下步骤:-弹出栈顶节点,并输出该节点的值。
-将该节点的未访问的相邻节点标记为已访问,并将其压入栈中。
4.重复步骤3,直到栈为空为止。
-深度优先遍历是一种先序遍历,即先访问节点本身,然后访问其子节点。
-深度优先遍历可以用来求解连通图、查找路径等问题。
-深度优先遍历的时间复杂度为O(V+E),其中V为节点数,E为边数。
1.求解连通图:深度优先遍历可以用来判断一个图是否连通,即从一个节点是否能够访问到所有其他节点。
2.查找路径:深度优先遍历可以找到两个节点之间的路径。
当遇到目标节点时,即可停止遍历,返回路径结果。
3.拓扑排序:深度优先遍历可以进行拓扑排序,即将有依赖关系的任务按一定的顺序排列。
深度优先遍历的实现可以通过递归或迭代方式来完成。
递归方式更加简洁,但在处理大规模图时可能导致栈溢出。
迭代方式则可以采用栈来避免栈溢出问题。
无论是递归方式还是迭代方式,其核心思想都是通过访问节点的相邻节点来进行深入,直至遍历完整个图或树的节点。
总而言之,深度优先遍历是一种常用的图遍历算法,它以一种深入优先的方式遍历路径。
在实际应用中,深度优先遍历可以用来求解连通图、查找路径和拓扑排序等问题,是图算法中的重要工具之一。
深度优先算法和广度优先算法的时间复杂度

深度优先算法和广度优先算法的时间复杂度深度优先算法和广度优先算法是在图论中常见的两种搜索算法,它们在解决各种问题时都有很重要的作用。
本文将以深入浅出的方式从时间复杂度的角度对这两种算法进行全面评估,并探讨它们在实际应用中的优劣势。
1. 深度优先算法的时间复杂度深度优先算法是一种用于遍历或搜索树或图的算法。
它从图中的某个顶点出发,沿着一条路径一直走到底,直到不能再前进为止,然后回溯到上一个节点,尝试走其他的路径,直到所有路径都被走过为止。
深度优先算法的时间复杂度与图的深度有关。
在最坏情况下,深度优先算法的时间复杂度为O(V+E),其中V表示顶点的数量,E表示边的数量。
2. 广度优先算法的时间复杂度广度优先算法也是一种用于遍历或搜索树或图的算法。
与深度优先算法不同的是,广度优先算法是从图的某个顶点出发,首先访问这个顶点的所有邻接节点,然后再依次访问这些节点的邻接节点,依次类推。
广度优先算法的时间复杂度与图中边的数量有关。
在最坏情况下,广度优先算法的时间复杂度为O(V+E)。
3. 深度优先算法与广度优先算法的比较从时间复杂度的角度来看,深度优先算法和广度优先算法在最坏情况下都是O(V+E),并没有明显的差异。
但从实际运行情况来看,深度优先算法和广度优先算法的性能差异是显而易见的。
在一般情况下,广度优先算法要比深度优先算法快,因为广度优先算法的搜索速度更快,且能够更快地找到最短路径。
4. 个人观点和理解在实际应用中,选择深度优先算法还是广度优先算法取决于具体的问题。
如果要找到两个节点之间的最短路径,那么广度优先算法是更好的选择;而如果要搜索整个图,那么深度优先算法可能是更好的选择。
要根据具体的问题来选择合适的算法。
5. 总结和回顾本文从时间复杂度的角度对深度优先算法和广度优先算法进行了全面评估,探讨了它们的优劣势和实际应用中的选择。
通过对两种算法的时间复杂度进行比较,可以更全面、深刻和灵活地理解深度优先算法和广度优先算法的特点和适用场景。
图的深度优先遍历(DFS)c++非递归实现
图的深度优先遍历(DFS)c++⾮递归实现深搜算法对于程序员来讲是必会的基础,不仅要会,更要熟练。
ACM竞赛中,深搜也牢牢占据着很重要的⼀部分。
本⽂⽤显式栈(⾮递归)实现了图的深度优先遍历,希望⼤家可以相互学习。
栈实现的基本思路是将⼀个节点所有未被访问的“邻居”(即“⼀层邻居节点”)踹⼊栈中“待⽤”,然后围绕顶部节点猛攻,每个节点被访问后被踹出。
读者可以⾃⼰画图分析⼀下,难度并不⼤。
代码写的⽐较随意,仅供参考。
~#include <iostream>#include <stack>using namespace std;#define MaxNode 20#define MAX 2000#define StartNode 1int map[MaxNode+1][MaxNode+1];void dfs_stack(int start, int n){int visited[MaxNode],s_top;for(int i = 0;i <= MaxNode; i++){visited[i] = 0;}visited[start] = 1;stack <int> s;cout<<start<<"";for(int i = 1; i <= n; i++){if(map[i][start] == 1 && !visited[i] ){visited[i] = 1;s.push(i);}}while(!s.empty()){s_top = s.top();visited[s_top] = 1;cout<<s_top<<"";s.pop();for(int i = 1; i <= n; i++){if(map[i][s_top] == 1 && !visited[i] ){visited[i] = 1;s.push(i);}}}}int main(int argc, const char * argv[]) {int num_edge,num_node;int x,y;cout<<"Input number of nodes and edges >"<<endl;cin>>num_node>>num_edge;for(int i =0;i<num_node;i++){for(int j=0;j<num_node;j++){map[i][j] = 0;}}for(int i = 1; i <= num_edge; i++){cin>>x>>y;map[x][y] = map[y][x] = 1;}dfs_stack(StartNode, num_node);return0;}。
深度优先遍历算法实现及复杂度分析

深度优先遍历算法实现及复杂度分析深度优先遍历算法(Depth First Search, DFS)是一种常用的图遍历算法,用于查找或遍历图的节点。
本文将介绍深度优先遍历算法的实现方法,并进行对应的复杂度分析。
一、算法实现深度优先遍历算法的基本思想是从图的某个节点出发,沿着深度方向依次访问其相邻节点,直到无法继续下去,然后返回上一层节点继续遍历。
下面是深度优先遍历算法的伪代码:```1. 初始化访问标记数组visited[],将所有节点的访问标记置为false。
2. 从某个节点v开始遍历:- 标记节点v为已访问(visited[v] = true)。
- 访问节点v的相邻节点:- 若相邻节点w未被访问,则递归调用深度优先遍历算法(DFS(w))。
3. 遍历结束,所有节点都已访问。
```二、复杂度分析1. 时间复杂度深度优先遍历算法的时间复杂度取决于图的存储方式和规模。
假设图的节点数为V,边数为E。
- 邻接表存储方式:对于每个节点,需要访问其相邻节点。
因此,算法的时间复杂度为O(V+E)。
- 邻接矩阵存储方式:需要检查每个节点与其他节点的连通关系,即需要遍历整个邻接矩阵。
因此,算法的时间复杂度为O(V^2)。
2. 空间复杂度深度优先遍历算法使用了一个辅助的访问标记数组visited[]来记录每个节点的访问状态。
假设图的节点数为V。
- 邻接表存储方式:访问标记数组visited[]的空间复杂度为O(V)。
- 邻接矩阵存储方式:访问标记数组visited[]的空间复杂度同样为O(V)。
综上所述,深度优先遍历算法的时间复杂度为O(V+E),空间复杂度为O(V)。
三、应用场景深度优先遍历算法在图的遍历和搜索问题中广泛应用。
以下是一些典型的应用场景:1. 连通性问题:判断图中两个节点之间是否存在路径。
2. 非连通图遍历:对于非连通图,深度优先遍历算法可以用于遍历所有连通分量。
3. 寻找路径:在图中寻找从起始节点到目标节点的路径。
dfs最短路径算法

dfs最短路径算法
DFS最短路径算法是一种基于深度优先搜索的算法,用于寻找图中两个节点之间的最短路径。
该算法的基本思想是从起点开始,沿着一条路径一直走到终点,如果发现当前路径比已知的最短路径更长,则回溯到上一个节点,继续探索其他路径,直到找到最短路径为止。
具体实现时,可以使用一个栈来保存当前路径,每次遍历到一个节点时,将其入栈,并计算当前路径的长度。
如果当前路径长度已经超过了已知的最短路径长度,则回溯到上一个节点,继续探索其他路径。
如果遍历到终点,则将当前路径与已知的最短路径进行比较,更新最短路径。
DFS最短路径算法的时间复杂度为O(E^V),其中E为边数,V为节点数。
由于该算法需要遍历所有可能的路径,因此在图较大时,其时间复杂度会非常高,效率较低。
因此,在实际应用中,一般使用更高效的算法,如Dijkstra算法或A*算法。
总之,DFS最短路径算法是一种基于深度优先搜索的算法,用于寻找图中两个节点之间的最短路径。
虽然其时间复杂度较高,但在一些特定的情况下,仍然可以发挥出较好的效果。
在实际应用中,应根据具体情况选择合适的算法,以提高效率和准确性。
图的深度优先遍历幻灯片PPT
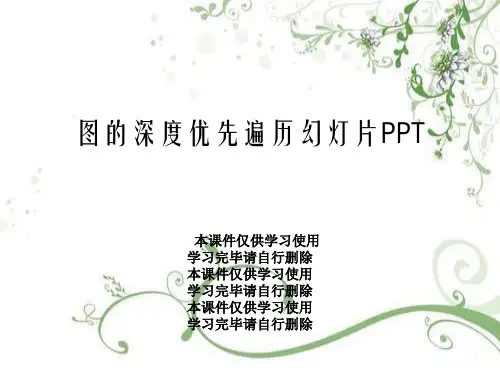
5 v5 6 v6 7 v7 8 v8
v2 v8 v3 v7 v3 v6 v4 v5
v,1
v,2
v1
v,4
v5
v1
v2
v,8
v4
v,5
v2
v8
v,3
v6
v7
0
1 v1
v2 v3
2 v2
v1 v4
v5
3 V3
v1 v6
v7
4 V4 v2 v8
5 v5 6 v6 7 v7 8 v8
v2 v8 v3 v7 v3 v6 v4 v5
v5
v2
v8
6 v6
v3 v7
7 v7
v3 v6
8 v8
v4 v5
0
1 v1
v2 v3
2 v2
v1 v4
v5
v,1
v,2
v3
3 V3
v1 v6
v7
4 V4 v2 v8
5 v5
v2 v8
v1
v,4
v5
v2
v,8
6 v6
v3 v7
7 v7
v3 v6
8 v8
v4 v5
0
1 v1
v2 v3
2 v2
v1 v4
visited[v]=true;//以前未被访问,此处被访问 //改变对应的标志为已经访问
v1
v4
v5
5 v5 6 v6
v2 v8 v3 v7
7 v7
v3 v6
8 v8
v4 v5
0
1 v1
v2 v3
2 v2
v1 v4
v5
v,1
v,2
v3
dfs通用步骤-概述说明以及解释
dfs通用步骤-概述说明以及解释1.引言1.1 概述DFS(深度优先搜索)是一种常用的图遍历算法,它通过深度优先的策略来遍历图中的所有节点。
在DFS中,从起始节点开始,一直向下访问直到无法继续为止,然后返回到上一个未完成的节点,继续访问它的下一个未被访问的邻居节点。
这个过程不断重复,直到图中所有的节点都被访问为止。
DFS算法的核心思想是沿着一条路径尽可能深入地搜索,直到无法继续为止。
在搜索过程中,DFS会使用一个栈来保存待访问的节点,以及记录已经访问过的节点。
当访问一个节点时,将其标记为已访问,并将其所有未访问的邻居节点加入到栈中。
然后从栈中取出下一个节点进行访问,重复这个过程直到栈为空。
优点是DFS算法实现起来比较简单,而且在解决一些问题时具有较好的效果。
同时,DFS算法可以用来解决一些经典的问题,比如寻找图中的连通分量、判断图中是否存在环、图的拓扑排序等。
然而,DFS算法也存在一些缺点。
首先,DFS算法不保证找到最优解,有可能陷入局部最优解而无法找到全局最优解。
另外,如果图非常庞大且存在大量的无效节点,DFS可能会陷入无限循环或者无法找到解。
综上所述,DFS是一种常用的图遍历算法,可以用来解决一些问题,但需要注意其局限性和缺点。
在实际应用中,我们需要根据具体问题的特点来选择合适的搜索策略。
在下一部分中,我们将详细介绍DFS算法的通用步骤和要点,以便读者更好地理解和应用该算法。
1.2 文章结构文章结构部分的内容如下所示:文章结构:在本文中,将按照以下顺序介绍DFS(深度优先搜索)通用步骤。
首先,引言部分将概述DFS的基本概念和应用场景。
其次,正文部分将详细解释DFS通用步骤的两个要点。
最后,结论部分将总结本文的主要内容并展望未来DFS的发展趋势。
通过这样的结构安排,读者可以清晰地了解到DFS算法的基本原理和它在实际问题中的应用。
接下来,让我们开始正文的介绍。
1.3 目的目的部分的内容可以包括对DFS(Depth First Search,深度优先搜索)的应用和重要性进行介绍。
深度优先搜索算法
深度优先搜索算法(DFS)是一种常用的图算法,该算法主要用于解决有解路径或遍历某个图结构的问题。
的主要思路是从某个图的起始点出发,访问邻居节点,直到该节点没有未被访问的邻居节点为止,然后回溯到上一个节点继续遍历其他未被访问的邻居节点。
该算法的基本流程可以概括为以下几个步骤:1. 从某个图结构的起始点开始进行深度优先搜索。
2. 如果该节点没有未被访问的邻居节点,则回溯到上一个节点。
3. 继续遍历其他未被访问的邻居节点,直到所有的节点已被访问。
4. 搜索结束。
的实现可以使用递归或栈数据结构进行。
使用递归实现时,程序会自动保存每个节点的访问状态,无需手动进行处理。
使用栈数据结构实现时,需要手动保存每个节点的访问状态,以便在回溯时继续遍历其他未被访问的邻居节点。
主要应用于解决以下问题:1. 找出两点之间的最短路径可以用来查找两个节点之间的最短路径。
在进行深度优先搜索时,需要记录每个节点的前驱节点,以便在搜索结束后构造最短路径。
2. 遍历一张图结构可以用来遍历一张图结构。
在进行深度优先搜索时,可以将图中的所有节点都进行遍历。
3. 解决迷宫问题可以用来解决迷宫问题。
在进行深度优先搜索时,需要记录每个走过的位置,以便在搜索结束后构造出从起点到终点的路径。
4. 生成所有排列或组合可以用来生成所有排列或组合。
在进行深度优先搜索时,需要记录已经访问过的节点,以便在搜索结束后生成所有满足条件的排列或组合。
存在一些问题,例如搜索过程中容易陷入死循环、需要记录每个节点的访问状态等。
为了解决这些问题,可以使用剪枝、双向搜索等技术来优化搜索算法。
总之,是一种常用的图算法,该算法主要用于解决有解路径或遍历某个图结构的问题。
的主要思路是从某个图的起始点出发, 访问邻居节点,直到该节点没有未被访问的邻居节点为止,然后回溯到上一个节点继续遍历其他未被访问的邻居节点。
在实际应用中,可以用来查找两个节点之间的最短路径、遍历一张图结构、解决迷宫问题、生成所有排列或组合等。
广度优先和深度优先的例子
广度优先和深度优先的例子广度优先搜索(BFS)和深度优先搜索(DFS)是图遍历中常用的两种算法。
它们在解决许多问题时都能提供有效的解决方案。
本文将分别介绍广度优先搜索和深度优先搜索,并给出各自的应用例子。
一、广度优先搜索(BFS)广度优先搜索是一种遍历或搜索图的算法,它从起始节点开始,逐层扩展,先访问起始节点的所有邻居节点,再依次访问其邻居节点的邻居节点,直到遍历完所有节点或找到目标节点。
例子1:迷宫问题假设有一个迷宫,迷宫中有多个房间,每个房间有四个相邻的房间:上、下、左、右。
现在我们需要找到从起始房间到目标房间的最短路径。
可以使用广度优先搜索算法来解决这个问题。
例子2:社交网络中的好友推荐在社交网络中,我们希望给用户推荐可能认识的新朋友。
可以使用广度优先搜索算法从用户的好友列表开始,逐层扩展,找到可能认识的新朋友。
例子3:网页爬虫网页爬虫是搜索引擎抓取网页的重要工具。
爬虫可以使用广度优先搜索算法从一个网页开始,逐层扩展,找到所有相关的网页并进行抓取。
例子4:图的最短路径在图中,我们希望找到两个节点之间的最短路径。
可以使用广度优先搜索算法从起始节点开始,逐层扩展,直到找到目标节点。
例子5:推荐系统在推荐系统中,我们希望给用户推荐可能感兴趣的物品。
可以使用广度优先搜索算法从用户喜欢的物品开始,逐层扩展,找到可能感兴趣的其他物品。
二、深度优先搜索(DFS)深度优先搜索是一种遍历或搜索图的算法,它从起始节点开始,沿着一条路径一直走到底,直到不能再继续下去为止,然后回溯到上一个节点,继续探索其他路径。
例子1:二叉树的遍历在二叉树中,深度优先搜索算法可以用来实现前序遍历、中序遍历和后序遍历。
通过深度优先搜索算法,我们可以按照不同的遍历顺序找到二叉树中所有节点。
例子2:回溯算法回溯算法是一种通过深度优先搜索的方式,在问题的解空间中搜索所有可能的解的算法。
回溯算法常用于解决组合问题、排列问题和子集问题。
例子3:拓扑排序拓扑排序是一种对有向无环图(DAG)进行排序的算法。
深度优先搜索算法详解及代码实现
深度优先搜索算法详解及代码实现深度优先搜索(Depth-First Search,DFS)是一种常见的图遍历算法,用于遍历或搜索图或树的所有节点。
它的核心思想是从起始节点开始,沿着一条路径尽可能深入地访问其他节点,直到无法继续深入为止,然后回退到上一个节点,继续搜索未访问过的节点,直到所有节点都被访问为止。
一、算法原理深度优先搜索算法是通过递归或使用栈(Stack)的数据结构来实现的。
下面是深度优先搜索算法的详细步骤:1. 选择起始节点,并标记该节点为已访问。
2. 从起始节点出发,依次访问与当前节点相邻且未被访问的节点。
3. 若当前节点有未被访问的邻居节点,则选择其中一个节点,将其标记为已访问,并将当前节点入栈。
4. 重复步骤2和3,直到当前节点没有未被访问的邻居节点。
5. 若当前节点没有未被访问的邻居节点,则从栈中弹出一个节点作为当前节点。
6. 重复步骤2至5,直到栈为空。
深度优先搜索算法会不断地深入到图或树的某一分支直到底部,然后再回退到上层节点继续搜索其他分支。
因此,它的搜索路径类似于一条深入的迷宫路径,直到没有其他路径可走后,再原路返回。
二、代码实现以下是使用递归方式实现深度优先搜索算法的代码:```pythondef dfs(graph, start, visited):visited.add(start)print(start, end=" ")for neighbor in graph[start]:if neighbor not in visited:dfs(graph, neighbor, visited)# 示例数据graph = {'A': ['B', 'C'],'B': ['A', 'D', 'E'],'C': ['A', 'F'],'D': ['B'],'E': ['B', 'F'],'F': ['C', 'E']}start_node = 'A'visited = set()dfs(graph, start_node, visited)```上述代码首先定义了一个用于实现深度优先搜索的辅助函数`dfs`。