
计量经济学作业-第四五章
第四章上机习题C4.1 如下模型可以用来研究竞选支出如何影响选举结果:()()u prtystrA endB endA voteA ++++=3210ex p ln ex p ln ββββ其中,voteA 表示候选人A 得到的选票百分数,endA exp 和endB exp 表示候选人A 和B 的竞选支出,而则是对A 所在党派实力的一种度量(A 所在党派在最近一次总统选举中获得的选票百分比)。
(1)如何解释1β?解 在回归方程()()u prtystrA endB endA voteA ++++=3210ex p ln ex p ln ββββ中,保持()endB ex p ln 、prtystrA 不变,可得:().ex p ln 1endA voteA ∆=∆β因为()endA endA ex p %ex p ln 100∆≈∆⋅,所以()()()()()()endA endA endA voteA exp %100exp ln 100100exp ln 111∆⋅≈∆⋅⋅=∆=∆βββ 所以1001β表示当endA exp 变动%1时vote 变动多少个百分点。
注意:100%112⋅-=∆x x x x ,x ∆%表示x 的百分数变化。
(2)用参数表示如下虚拟假设:A 的竞选支出提高%1被B 的竞选支出提高%1所抵消。
解 虚拟假设可以表示为210:ββ-=H 或者0:210=+ββH(3)利用RAW VOTE .1中的数据估计上述模型,并以通常的方式报告结论。
A 的竞选支出或影响结果吗?B 的竞选支出呢?你能用这些结论来检验第(2)部分中的假设吗?解 估计方程为()()()()793.0,14.10052,173062.0379.0382.0926.3152.0)ln(exp 615.6)ln(exp 083.6079.452===+-+=∧R SSR n prtystrAendB endA voteA从回归结果可知,()endA ex p ln 的系数估计值等于6.083,标准误等于0.382,t 统计量为15.919,p 值为0.0000。
()endB ex p ln 的系数估计值等于-6.615,标准误等于0.379,t 统计量为-17.463,p 值为0.0000。
由此可以看出()endA ex p ln 和()endB ex p ln 的斜率系数在非常小的显著性水平下都是统计上显著异于零,所以A 的竞选支出和B 的竞选支出都会影响竞选结果。
在保持其他因素不变的情况下,若A 的竞选支出增加%10,则A 得到的选票百分数将提高约0.608个百分点;若B 的竞选支出增加%10,则A 得到的选票百分数将下降约0.662个百分点.从以上叙述中我们知道,∧1β和∧2β的符号相反且都符合预期,重要程度相当,但是我们不能根据这些结论得出∧∧+21ββ的标准误差,也就不能计算相应的t 统计量,所以不能用这些结论来检验(2)中的假设。
(4)估计一个模型,使之能直接给出检验第(2)部分中假设所需要的t 统计量。
你有什么结论?(使用双侧对立假设)解 令21ββθ+=,则21βθβ-=,把它代入原始的回归方程可得: ()()()()u prtystrA endA endB endA voteA ++-++=320ex p ln ex p ln ex p ln ββθβ 利用RAW VOTE .1的数据重新估计以上方程,得到的估计方程为()()()()()()()()793.0,14.10052,173062.0379.0533.0926.3152.0exp ln exp ln 615.6exp ln 532.0079.452===+---=∧R SSR n prtystrA endA endB endA voteA 从回归结果可知,532.0-=∧θ,533.0=⎪⎭⎫ ⎝⎛∧θse ,∧θ的t 统计量为-0.998,p 值为0.3196,所以对θ所做的估计在%5的显著性水平下是不显著的,我们不能在%5的显著性水平上拒绝虚拟假设0:210=+ββH 。
比较(3)和(4)可以看到:两估计方程截距、prtystrA 的斜率估计值及其标准误都是相同的,(4)中新变量()endB ex p ln -()endA ex p ln 的系数和标准误与(3)中()endB ex p ln 的系数和标准误相同,两估计方程的SSR ,2R 都是相同的。
此外,(3)中的∧1β也可以根据∧2β和∧θ计算得出。
C4.2 本题要用到RAW LAWSCH .85中的数据。
(1)使用与习题3.4一样的模型,表述并检验虚拟假设:在其他条件不变的情况下,法学院排名对起薪中位数没有影响。
解 由题意可知,我们构造回归模型如下 ()()()u t libvol gpa lsat rank salary ++++++=cos ln ln ln 543210ββββββ则虚拟假设可以表述为0:10=βH利用RAW LAWSCH .85的数据可得估计方程为()()()()()()()()()842.0,1360321.00333.0cos ln 0376.0ln 0950.0090.000401.0000348.0533.0248.000470.000333.0343.8ln 2==++++-=∧R n t libvol gpa lsat rank salary 从回归结果可以看出,rank 斜率估计值00333.01-=∧β,000348.01=⎪⎭⎫ ⎝⎛∧βse ,t 统计量为-9.541,p 值等于0.0000,由此可知rank 即使是在很小的显著性水平上也是统计显著的,所以我们完全有理由拒绝0H 。
(2)新生年级的学生特征(gpa lsat ,)对解释salary 而言是个别或者联合显著的吗?解 从(1)的估计方程可知,lsat 的t 统计量为1.171,p 值等于0.2437;gpa 的t 统计量为2.749,p 值等于0.0068。
所以在%5的显著性水平上只有gpa 是个别显著的。
为了说明gpa lsat ,是不是联合显著的,我们做如下的虚拟假设: 0,0:320==ββH其对立假设为不全为零321,:ββH 。
(1)已经给出了不受约束模型的估计方程,受约束模型的估计方程如下:()()()()()()()822.0,1410295.00325.0000298.0343.0cos ln 0265.0ln 129.000417.0880.9ln 2==++-=∧R n t libvol rank salary两个模型的样本容量不同,是由gpa lsat ,的数据缺失造成的。
不受约束模型中841.02=ur R ,受约束模型的822.02=r R ,136=n ,5=k ,2=q ,由此可得: ()()()767.72130841.01822.0841.011222≈⋅--=----=k n R q R R F ur r ur 分子自由度为2,分母自由度为130,显著性水平为%5的F 统计量的临界值为3.00,,所以gpa lsat ,在%5的显著性水平上是联合显著的。
(3)检验要不要在方程中引入入学年级的规模(clsize )和教职工的规模(faculty );只进行一个检验。
解 回归模型如下()()()ufaculty clsize t libvol gpa lsat rank salary ++++++++=76543210cos ln ln ln ββββββββ再次利用RAW LAWSCH .85的数据得到其估计模型为 ()()()()()()()()()()()844.0,13100040.0000154.00347.00404.00000675.0000134.0cos ln 0296.0ln 0552.00932.000418.0000357.0552.0266.000558.000343.0416.8ln 2==++++++-=∧R n faculty clsize t libvol gpa lsat rank salary 回归样本容量为131,这是受到clsize 和faculty 数据缺失的影响。
从回归结果可知,clsize 和faculty 的t 统计量的值分别为0.875、0.169,p 值分别为 0.383、0.866。
由此可知,在%5,甚至是%10的显著性水平上clsize 和faculty 在统计上都不显著。
以(1)中的模型为受约束模型,本题中的模型为不受约束模型,就可以检验clsize 和faculty 的联合显著性了。
844.02=ur R ,受约束模型的842.02=r R ,131=n ,7=k ,2=q ,由此可得: ()()()788.02123844.01842.0844.011222≈⋅--=----=k n R q R R F ur r ur 分子自由度为2,分母自由度为123,显著性水平为%5的F 统计量的临界值为3.00,,gpa lsat ,在%5的显著性水平上是联合显著的,所以不应该把clsize 和faculty 放进模型中。
(4)还有哪些因素可能影响到法学院排名,但又没有被包括在薪水回归中?解 教师质量、性别差异、种族差异、学生能力测试成绩等。
C4.3 参考习题3.14,现在我们使用住房价格的对数作为因变量:()u bdrms sqrft price +++=210ln βββ(1)你想在住房增加一个150平方英尺的卧室的情况下,估计并得到price 变化百分比的一个置信区间。
以小数形式表示就是211150ββθ+=。
使用RAW HPRICE .1中的数据去估计1θ。
解 使用RAW HPRICE .1中的数据得到估计方程为()()()()588.0,3.3,880296.00000432.0097.00289.0000379.0766.4ln 2===++=∧R SSR n bdrms sqrft price 由以上回归结果可知,000379.01=∧β,0289.02=∧β,所以08575.0289.0000379.01501=+⨯=∧θ这意味着增加一个150平方英尺的卧室的情况下,price 预期大约增长%6.8。
(2)用1θ和1β表达2β,并代入()price ln 的方程。
解 112211150150βθβββθ-=⇒+=,代入方程可得:()()()ubdrms bdrms sqrft ubdrms sqrft price ++-+=+-++=1101110150150ln θβββθββ(3)利用第(2)步中的结果得到∧1θ的标准误,并使用这个标准误构造一个%95的置信区间。
《计量经济学》习题(第四章)
《计量经济学》习题(第四章)第四章习题⼀、单选题1、如果回归模型违背了同⽅差假定,最⼩⼆乘估计量____A .⽆偏的,⾮有效的 B.有偏的,⾮有效的C .⽆偏的,有效的 D.有偏的,有效的2、Goldfeld-Quandt ⽅法⽤于检验____A .异⽅差性 B.⾃相关性C .随机解释变量 D.多重共线性3、DW 检验⽅法⽤于检验____A .异⽅差性 B.⾃相关性C .随机解释变量 D.多重共线性4、在异⽅差性情况下,常⽤的估计⽅法是____A .⼀阶差分法 B.⼴义差分法C .⼯具变量法 D.加权最⼩⼆乘法5、在以下选项中,正确表达了序列⾃相关的是____j i u x Cov D j i x x Cov C ji u u Cov B ji u u Cov A j i j i j i j i ≠≠≠≠≠=≠≠,0),(.,0),(.,0),(.,0),(.6、如果回归模型违背了⽆⾃相关假定,最⼩⼆乘估计量____A .⽆偏的,⾮有效的 B.有偏的,⾮有效的C .⽆偏的,有效的 D.有偏的,有效的7、在⾃相关情况下,常⽤的估计⽅法____A .普通最⼩⼆乘法 B.⼴义差分法C .⼯具变量法 D.加权最⼩⼆乘法8、White 检验⽅法主要⽤于检验____A .异⽅差性 B.⾃相关性C .随机解释变量 D.多重共线性9、Glejser 检验⽅法主要⽤于检验____A .异⽅差性 B.⾃相关性C .随机解释变量 D.多重共线性10、简单相关系数矩阵⽅法主要⽤于检验____A .异⽅差性 B.⾃相关性C .随机解释变量 D.多重共线性2222)(.)(.)(.)(.σσσσ==≠≠i i i i x Var D u Var C x Var B u Var A12、所谓不完全多重共线性是指存在不全为零的数k λλλ,,,21 ,有____1112211221221122.0.0..k k k k k x x x k k k k A x x x v B x x x C x x x v e D x x x v e v λλλλλλλλλλλλ++++=+++=∑?++++=++++=式中是随机误差项13、设21,x x 为解释变量,则完全多重共线性是____0.(021.0.021.22121121=+=++==+x x e x D v v x x C e x B x x A 为随机误差项)14、⼴义差分法是对____⽤最⼩⼆乘法估计其参数 11211211121121)()1(....-------+-+-=-++=++=++=t t t t t t t t t t t t t t t u u x x y y D u x y C u x y B u x y A ρρβρβρρρβρβρββββ15、在DW 检验中要求有假定条件,在下列条件中不正确的是____A .解释变量为⾮随机的 B.随机误差项为⼀阶⾃回归形式C .线性回归模型中不应含有滞后内⽣变量为解释变量D.线性回归模型为⼀元回归形式16、在下例引起序列⾃相关的原因中,不正确的是____A.经济变量具有惯性作⽤B.经济⾏为的滞后性C.设定偏误D.解释变量之间的共线性17、在DW 检验中,当d 统计量为2时,表明____A.存在完全的正⾃相关B.存在完全的负⾃相关C.不存在⾃相关D.不能判定18、在DW 检验中,当d 统计量为4时,表明____A.存在完全的正⾃相关B.存在完全的负⾃相关C.不存在⾃相关D.不能判定19、在DW 检验中,当d 统计量为0时,表明____A.存在完全的正⾃相关C.不存在⾃相关D.不能判定20、在DW 检验中,存在不能判定的区域是____A. 0﹤d ﹤l d ,4-l d ﹤d ﹤4B. u d ﹤d ﹤4-u dC. l d ﹤d ﹤u d ,4-u d ﹤d ﹤4-l dD. 上述都不对21、在修正序列⾃相关的⽅法中,能修正⾼阶⾃相关的⽅法是____A. 利⽤DW 统计量值求出ρB. Cochrane-Orcutt 法C. Durbin 两步法D. 移动平均法22、在下列多重共线性产⽣的原因中,不正确的是____A.经济本变量⼤多存在共同变化趋势B.模型中⼤量采⽤滞后变量C.由于认识上的局限使得选择变量不当D.解释变量与随机误差项相关23、在DW 检验中,存在正⾃相关的区域是____A. 4-l d ﹤d ﹤4B. 0﹤d ﹤l dC. u d ﹤d ﹤4-u dD. l d ﹤d ﹤u d ,4-u d ﹤d ﹤4-l d24、逐步回归法既检验⼜修正了____A .异⽅差性 B.⾃相关性 C .随机解释变量 D.多重共线性25、设)()(,2221i i i i i ix f u Var u x y σσββ==++=,则对原模型变换的正确形式为____ )()()()(.)()()()(.)()()()(..212222122121i i i i i i i i i i i i i i i i i i i i i i i i x f u x f x x f x f y D x f u x f x x f x f y C x f u x f x x f x f y B u x y A ++=++=++=++=ββββββββ 26、在修正序列⾃相关的⽅法中,不正确的是____A.⼴义差分法B.普通最⼩⼆乘法C.⼀阶差分法D. Durbin 两步法27、在检验异⽅差的⽅法中,不正确的是____A. Goldfeld-Quandt ⽅法B. spearman 检验法C. White 检验法28、在DW 检验中,存在零⾃相关的区域是____A. 4-l d ﹤d ﹤4B. 0﹤d ﹤l dC. u d ﹤d ﹤4-u dD. l d ﹤d ﹤u d ,4-u d ﹤d ﹤4-l d29.如果模型中的解释变量存在完全的多重共线性,参数的最⼩⼆乘估计量是()A .⽆偏的 B. 有偏的 C. 不确定 D. 确定的30. 已知模型的形式为u x y 21+β+β=,在⽤实际数据对模型的参数进⾏估计的时候,测得DW 统计量为0.6453,则⼴义差分变量是( )A. 1t t ,1t t x 6453.0x y 6453.0y ----B. 1t t 1t t x 6774.0x ,y 6774.0y ----C. 1t t 1t t x x ,y y ----D. 1t t 1t t x 05.0x ,y 05.0y ----31. 在具体运⽤加权最⼩⼆乘法时,如果变换的结果是x u x x x 1xy 21+β+β=,则Var(u)是下列形式中的哪⼀种?( )A. 2σxB. 2σ2x B. 2σx D. 2σLog(x)32. 在线性回归模型中,若解释变量1x 和2x 的观测值成⽐例,即有i 2i 1kx x =,其中k 为⾮零常数,则表明模型中存在( )A. 异⽅差B. 多重共线性C. 序列⾃相关D. 设定误差33. 已知DW 统计量的值接近于2,则样本回归模型残差的⼀阶⾃相关系数ρ近似等于( ) A. 0 B. –1 C. 1 D. 4⼆、多项选择1、能够检验多重共线性的⽅法有____A.简单相关系数法B. DW检验法C. 判定系数检验法D. ⽅差膨胀因⼦检验E.逐步回归法2、能够修正多重共线性的⽅法有____A.增加样本容量B.岭回归法C.剔除多余变量E.差分模型3、如果模型中存在异⽅差现象,则会引起如下后果____A. 参数估计值有偏B. 参数估计值的⽅差不能正确确定C. 变量的显著性检验失效D. 预测精度降低E. 参数估计值仍是⽆偏的4、能够检验异⽅差的⽅法是____A. gleiser检验法B. White检验法C. 图形法D. spearman检验法E. DW检验法F. Goldfeld-Quandt检验法5、如果模型中存在序列⾃相关现象,则会引起如下后果____A. 参数估计值有偏B. 参数估计值的⽅差不能正确确定C. 变量的显著性检验失效D. 预测精度降低E. 参数估计值仍是⽆偏的6、检验序列⾃相关的⽅法是____A. gleiser检验法B. White检验法C. 图形法D. DW检验法E. Goldfeld-Quandt检验法7、能够修正序列⾃相关的⽅法有____A. 加权最⼩⼆乘法B. Durbin两步法C. ⼴义最⼩⼆乘法D. ⼀阶差分法E. ⼴义差分法8、Goldfeld-Quandt检验法的应⽤条件是____A. 将观测值按解释变量的⼤⼩顺序排列B. 样本容量尽可能⼤C. 随机误差项服从正态分布D. 将排列在中间的约1/4的观测值删除掉9、在DW检验中,存在不能判定的区域是____A. 0﹤d﹤l dB. u d﹤d﹤4-u dC. l d﹤d﹤u dD. 4-u d﹤d﹤4-l dE. 4-l d﹤d﹤4。
《计量经济学》第五章习题及参考答案.doc

第五章经典单方程计量经济学模型:专门问题一、内容提要本章主要讨论了经典单方程回归模型的几个专门题。
第一个专题是虚拟解释变量问题。
虚拟变量将经济现象中的一些定性因素引入到可以进行定量分析的回归模型,拓展了回归模型的功能。
本专题的重点是如何引入不同类型的虚拟变量来解决相关的定性因素影响的分析问题,主要介绍了引入虚拟变量的加法方式、乘法方式以及二者的组合方式。
在引入虚拟变量时有两点需要注意,一是明确虚拟变量的对比基准,二是避免出现“虚拟变量陷阱”。
第二个专题是滞后变量问题。
滞后变量包括滞后解释变量与滞后被解释变量,根据模型中所包含滞后变量的类别又可将模型划分为自回归分布滞后模型与分布滞后模型、自回归模型等三类。
本专题重点阐述了产生滞后效应的原因、分布滞后模型估计时遇到的主要困难、分布滞后模型的修正估计方法以及自回归模型的估计方法。
如对分布滞后模型可采用经验加权法、Almon多项式法、Koyck方法来减少滞项的数目以使估计变得更为可行。
而对自回归模型,则根据作为解释变量的滞后被解释变量与模型随机扰动项的相关性的不同,采用工具变量法或OLS 法进行估计。
由于滞后变量的引入,回归模型可将静态分析动态化,因此,可通过模型参数来分析解释变量对被解释变量影响的短期乘数和长期乘数。
第三个专题是模型设定偏误问题。
主要讨论当放宽“模型的设定是正确的”这一基本假定后所产生的问题及如何解决这些问题。
模型设定偏误的类型包括解释变量选取偏误与模型函数形式选取取偏误两种类型,前者又可分为漏选相关变量与多选无关变量两种情况。
在漏选相关变量的情况下,OLS估计量在小样本下有偏,在大样本下非一致;当多选了无关变量时,OLS估计量是无偏且一致的,但却是无效的;而当函数形式选取有问题时,OLS估计量的偏误是全方位的,不仅有偏、非一致、无效率,而且参数的经济含义也发生了改变。
在模型设定的检验方面,检验是否含有无关变量,可用传统的t检验与F检验进行;检验是否遗漏了相关变量或函数模型选取有错误,则通常用一般性设定偏误检验(RESET检验)进行。
计量经济学第四章练习题及参考解答
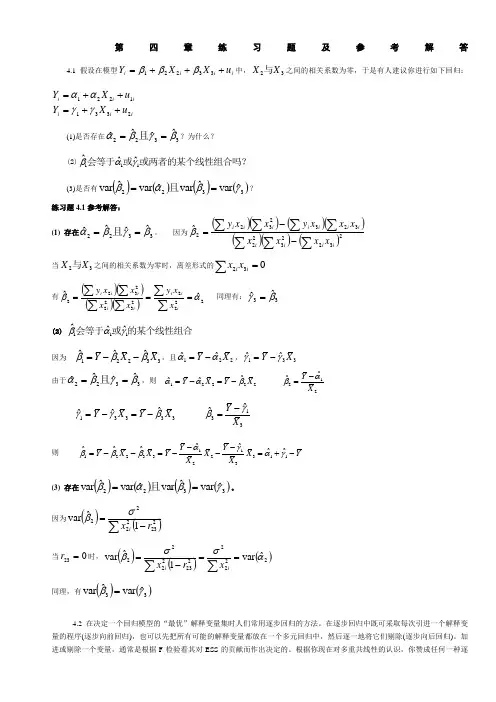
第四章练习题及参考解答4.1 假设在模型i i i iu X X Y +++=33221βββ中,32X X 与之间的相关系数为零,于是有人建议你进行如下回归:ii i i i i u X Y u X Y 23311221++=++=γγαα(1)是否存在3322ˆˆˆˆβγβα==且?为什么? (2)111ˆˆˆβαγ会等于或或两者的某个线性组合吗? (3)是否有()()()()3322ˆvar ˆvar ˆvar ˆvarγβαβ==且? 练习题4.1参考解答:(1) 存在3322ˆˆˆˆβγβα==且。
因为()()()()()()()23223223232322ˆ∑∑∑∑∑∑∑--=iiiii iii iii x x x x x xx y x x y β当32X X 与之间的相关系数为零时,离差形式的032=∑i i x x有()()()()222223222322ˆˆαβ===∑∑∑∑∑∑iiiiiiii xx y x x x x y 同理有:33ˆˆβγ= (2) 111ˆˆˆβαγ会等于或的某个线性组合 因为12233ˆˆˆY X X βββ=--,且122ˆˆY X αα=-,133ˆˆY X γγ=- 由于3322ˆˆˆˆβγβα==且,则 11222222ˆˆˆˆˆY Y X Y X X αααββ-=-=-=11333333ˆˆˆˆˆY Y X Y X X γγγββ-=-=-=则 1112233231123ˆˆˆˆˆˆˆY Y Y X X Y X X Y X X αγβββαγ--=--=--=+- (3) 存在()()()()3322ˆvar ˆvar ˆvar ˆvarγβαβ==且。
因为()()∑-=22322221ˆvarr x iσβ当023=r 时,()()()22222232222ˆvar 1ˆvar ασσβ==-=∑∑iixr x 同理,有()()33ˆvar ˆvar γβ=4.2在决定一个回归模型的“最优”解释变量集时人们常用逐步回归的方法。
计量经济学课后答案第四、五章(内容参考)

计量经济学课后答案第四、五章(内容参考)第四章随机解释变量问题1. 随机解释变量的来源有哪些?答:随机解释变量的来源有:经济变量的不可控,使得解释变量观测值具有随机性;由于随机干扰项中包括了模型略去的解释变量,而略去的解释变量与模型中的解释变量往往是相关的;模型中含有被解释变量的滞后项,而被解释变量本身就是随机的。
2.随机解释变量有几种情形? 分情形说明随机解释变量对最小二乘估计的影响与后果?答:随机解释变量有三种情形,不同情形下最小二乘估计的影响和后果也不同。
(1)解释变量是随机的,但与随机干扰项不相关;这时采用OLS估计得到的参数估计量仍为无偏估计量;(2)解释变量与随机干扰项同期无关、不同期相关;这时OLS估计得到的参数估计量是有偏但一致的估计量;(3)解释变量与随机干扰项同期相关;这时OLS估计得到的参数估计量是有偏且非一致的估计量。
3. 选择作为工具变量的变量必须满足那些条件?答:选择作为工具变量的变量需满足以下三个条件:(1)与所替代的随机解释变量高度相关;(2)与随机干扰项不相关;(3)与模型中其他解释变量不相关,以避免出现多重共线性。
4.对模型Y t =β+β1X1t+β2X2t+β3Yt-1+μt假设Yt-1与μt相关。
为了消除该相关性,采用工具变量法:先求Y t关于X1t与 X2t回归,得到Yt,再做如下回归:Y t =β+β1X1t+β2X2t+β3Y t?1-+μt试问:这一方法能否消除原模型中Yt的相关性? 为什么?解答:能消除。
在基本假设下,X1t,X2t与μt应是不相关的,由此知,由X1t 与X2t估计出的Yt应与μt不相关。
5.对于一元回归模型Y t =β+β1Xt*+μt假设解释变量Xt *的实测值Xt与之有偏误:Xt= Xt*+et,其中et是具有零均值、无序列相关,且与Xt不相关的随机变量。
试问:(1) 能否将X t= X t*+e t代入原模型,使之变换成Y t=β0+β1X t+νt后进行估计? 其中,νt为变换后模型的随机干扰项。
庞皓计量经济学练习题及参考解答第四版

庞皓计量经济学练习题及参考解答第四版目录1.简介2.练习题及解答–第一章:引言–第二章:回归分析的基本步骤–第三章:多元回归分析–第四章:假设检验和检定–第五章:函数形式选择和非线性回归–第六章:虚拟变量和联合假设检验–第七章:时间序列回归分析–第八章:面板数据回归分析–第九章:工具变量法–第十章:极大似然估计3.总结1. 简介《庞皓计量经济学练习题及参考解答第四版》是一本与《庞皓计量经济学》教材配套的习题集,旨在帮助读者巩固和加深对计量经济学理论和方法的理解。
本书第四版相比前三版进行了全面的修订和更新,更加贴近实际应用环境,同时也增加了一些新的内容。
本文档为《庞皓计量经济学练习题及参考解答第四版》的摘要,包含了各章节的练习题及参考解答。
2. 练习题及解答第一章:引言1.什么是计量经济学?计量经济学的研究范围是什么?–答案:计量经济学是运用统计学方法研究经济理论及实证问题的学科。
它主要研究经济学中的理论模型和假设是否能得到实证支持,对经济变量之间的关系进行定量分析和预测。
2.计量经济学中常用的方法有哪些?–答案:常用的计量经济学方法包括线性回归分析、假设检验、面板数据分析、时间序列分析等。
这些方法能够帮助研究者解决实际经济问题,预测经济变量,评估政策效果等。
第二章:回归分析的基本步骤1.请解释什么是回归分析?–答案:回归分析是一种研究因变量和自变量之间关系的统计方法。
通过建立一个数学模型来描述二者之间的函数关系,并利用样本数据对该函数关系进行估计和推断。
回归分析的基本思想是找到自变量对因变量的解释能力,并进行统计推断。
2.利用最小二乘法进行回归分析的基本思想是什么?–答案:基本思想是通过最小化预测值与实际观测值之间的差异,来确定最佳的参数估计值。
也就是说,最小二乘法通过选择一组参数,使得预测值与实际观测值之间的平方差最小化。
3.如何判断回归模型的拟合优度?–答案:拟合优度可以通过判断回归方程的决定系数R2来评估。
计量经济学第五章练习题及参考解答

第五章练习题及参考解答5.1 设消费函数为i i i i u X X Y +++=33221βββ式中,i Y 为消费支出;i X 2为个人可支配收入;i X 3为个人的流动资产;i u 为随机误差项,并且222)(,0)(i i i X u Var u E σ==(其中2σ为常数)。
试解答以下问题:(1)选用适当的变换修正异方差,要求写出变换过程;(2)写出修正异方差后的参数估计量的表达式。
练习题5.1参考解答:(1)因为22()i i f X X =,所以取221i iW X =,用2i W 乘给定模型两端,得 312322221i i iii i i Y X u X X X X βββ=+++ 上述模型的随机误差项的方差为一固定常数,即22221()()i i i iu Var Var u X X σ==(2)根据加权最小二乘法,可得修正异方差后的参数估计式为***12233ˆˆˆY X X βββ=--()()()()()()()***2****22232322322*2*2**2223223ˆii i i i i i i i i i i ii ii i iW y x W x W y x W x x WxWxWx xβ-=-∑∑∑∑∑∑∑()()()()()()()***2****23222222332*2*2**2223223ˆii i i i i i i i i i i i i i i i i W y x W x W y x W x x W x W x W x x β-=-∑∑∑∑∑∑∑其中22232***23222,,i ii ii i iiiW X W X W Y XXYWWW ===∑∑∑∑∑∑******222333i i i i i x X X x X X y Y Y =-=-=-5.2 下表是消费Y 与收入X 的数据,试根据所给数据资料完成以下问题:(1)估计回归模型u X Y ++=21ββ中的未知参数1β和2β,并写出样本回归模型的书写格式;(2)试用Goldfeld-Quandt 法和White 法检验模型的异方差性; (3)选用合适的方法修正异方差。
计量经济学(第四版)习题参考答案
计量经济学(第四版)习题参考答案潘省初第一章 绪论1.1 一般说来,计量经济分析按照以下步骤进行:(1)陈述理论(或假说) (2)建立计量经济模型 (3)收集数据 (4)估计参数 (5)假设检验 (6)预测和政策分析1.2 我们在计量经济模型中列出了影响因变量的解释变量,但它(它们)仅是影响因变量的主要因素,还有很多对因变量有影响的因素,它们相对而言不那么重要,因而未被包括在模型中。
为了使模型更现实,我们有必要在模型中引进扰动项u 来代表所有影响因变量的其它因素,这些因素包括相对而言不重要因而未被引入模型的变量,以及纯粹的随机因素。
1.3时间序列数据是按时间周期(即按固定的时间间隔)收集的数据,如年度或季度的国民生产总值、就业、货币供给、财政赤字或某人一生中每年的收入都是时间序列的例子。
横截面数据是在同一时点收集的不同个体(如个人、公司、国家等)的数据。
如人口普查数据、世界各国2000年国民生产总值、全班学生计量经济学成绩等都是横截面数据的例子。
1.4 估计量是指一个公式或方法,它告诉人们怎样用手中样本所提供的信息去估计总体参数。
在一项应用中,依据估计量算出的一个具体的数值,称为估计值。
如Y 就是一个估计量,1nii YY n==∑。
现有一样本,共4个数,100,104,96,130,则根据这个样本的数据运用均值估计量得出的均值估计值为5.107413096104100=+++。
第二章 计量经济分析的统计学基础2.1 略,参考教材。
2.2 NSS x ==45=1.25用=0.05,N-1=15个自由度查表得005.0t =2.947,故99%置信限为 x S t X 005.0± =174±2.947×1.25=174±3.684也就是说,根据样本,我们有99%的把握说,北京男高中生的平均身高在170.316至177.684厘米之间。
2.3 原假设 120:0=μH备择假设 120:1≠μH 检验统计量()10/2510/25XX μσ-Z ====查表96.1025.0=Z 因为Z= 5 >96.1025.0=Z ,故拒绝原假设, 即 此样本不是取自一个均值为120元、标准差为10元的正态总体。
计量经济学作业-第四五章
计量经济学作业-第四五章第四章上机习题C4.1 如下模型可以用来研究竞选支出如何影响选举结果:()()u prtystrA endB endA voteA ++++=3210ex p ln ex p ln ββββ其中,voteA 表示候选人A 得到的选票百分数,endA exp 和endB exp 表示候选人A 和B 的竞选支出,而则是对A 所在党派实力的一种度量(A 所在党派在最近一次总统选举中获得的选票百分比)。
(1)如何解释1β?解在回归方程()()u prtystrA endB endA voteA ++++=3210ex p ln ex p ln ββββ中,保持()endB ex p ln 、prtystrA 不变,可得:().ex p ln 1endA voteA ?=?β因为()endA endA ex p %ex p ln 100?≈??,所以()()()()()()endA endA endA voteA exp %100exp ln 100100exp ln 111??≈=?=?βββ 所以1001β表示当endA exp 变动%1时vote 变动多少个百分点。
注意:100%112?-=?x x x x ,x ?%表示x 的百分数变化。
(2)用参数表示如下虚拟假设:A 的竞选支出提高%1被B 的竞选支出提高%1所抵消。
解虚拟假设可以表示为210:ββ-=H 或者0:210=+ββH(3)利用RAW VOTE .1中的数据估计上述模型,并以通常的方式报告结论。
A 的竞选支出或影响结果吗?B 的竞选支出呢?你能用这些结论来检验第(2)部分中的假设吗?解估计方程为()()()()793.0,14.10052,173062.0379.0382.0926.3152.0)ln(exp 615.6)ln(exp 083.6079.452===+-+=∧R SSR n prtystrA endB endA voteA从回归结果可知,()endA ex p ln 的系数估计值等于6.083,标准误等于0.382,t 统计量为15.919,p 值为0.0000。
计量经济学(庞浩)第五章练习题参考解答
第五章练习题参考解答练习题5.1 设消费函数为i i i i u X X Y +++=33221βββ式中,i Y 为消费支出;i X 2为个人可支配收入;i X 3为个人的流动资产;i u 为随机误差项,并且222)(,0)(i i i X u Var u E σ==(其中2σ为常数)。
试回答以下问题:(1)选用适当的变换修正异方差,要求写出变换过程;(2)写出修正异方差后的参数估计量的表达式。
5.2 根据本章第四节的对数变换,我们知道对变量取对数通常能降低异方差性,但须对这种模型的随机误差项的性质给予足够的关注。
例如,设模型为u X Y 21ββ=,对该模型中的变量取对数后得如下形式u X Y ln ln ln ln 21++=ββ(1)如果u ln 要有零期望值,u 的分布应该是什么? (2)如果1)(=u E ,会不会0)(ln =u E ?为什么? (3)如果)(ln u E 不为零,怎样才能使它等于零?5.3 由表中给出消费Y 与收入X 的数据,试根据所给数据资料完成以下问题: (1)估计回归模型u X Y ++=21ββ中的未知参数1β和2β,并写出样本回归模型的书写格式;(2)试用Goldfeld-Quandt 法和White 法检验模型的异方差性; (3)选用合适的方法修正异方差。
Y X Y X Y X 55 80 152 220 95 140 65 100 144 210 108 145 70 85 175 245 113 150 801101802601101607912013519012516584115140205115180981301782651301859514019127013519090125137230120200759018925014020574105558014021011016070851522201131507590140225125165651001372301081457410514524011518080110175245140225841151892501202007912018026014524090125178265130185981301912705.4由表中给出1985年我国北方几个省市农业总产值,农用化肥量、农用水利、农业劳动力、每日生产性固定生产原值以及农机动力数据,要求:(1)试建立我国北方地区农业产出线性模型;(2)选用适当的方法检验模型中是否存在异方差;(3)如果存在异方差,采用适当的方法加以修正。
计量经济学第四章练习题及参考解答
第四章练习题及参考解答4.1 假设在模型i i i i u X X Y +++=33221βββ中,32X X 与之间的相关系数为零,于是有人建议你进行如下回归:ii i i i i u X Y u X Y 23311221++=++=γγαα(1)是否存在3322ˆˆˆˆβγβα==且?为什么? (2)111ˆˆˆβαγ会等于或或两者的某个线性组合吗? (3)是否有()()()()3322ˆvar ˆvar ˆvar ˆvar γβαβ==且?练习题4.1参考解答:(1) 存在3322ˆˆˆˆβγβα==且。
因为()()()()()()()23223223232322ˆ∑∑∑∑∑∑∑--=iiiii iii iii x x x x x x x y x x y β当32X X 与之间的相关系数为零时,离差形式的032=∑i ix x有()()()()222223222322ˆˆαβ===∑∑∑∑∑∑iiiiiiii xx y x x x x y 同理有:33ˆˆβγ= (2) 111ˆˆˆβαγ会等于或的某个线性组合 因为 12233ˆˆˆY X X βββ=--,且122ˆˆY X αα=-,133ˆˆY X γγ=- 由于3322ˆˆˆˆβγβα==且,则 11222222ˆˆˆˆˆY Y X Y X X αααββ-=-=-= 11333333ˆˆˆˆˆY Y X Y X X γγγββ-=-=-= 则 1112233231123ˆˆˆˆˆˆˆY Y Y X X Y X X Y X X αγβββαγ--=--=--=+- (3) 存在()()()()3322ˆvar ˆvar ˆvar ˆvar γβαβ==且。
因为()()∑-=22322221ˆvar r x iσβ当023=r 时,()()()22222232222ˆvar 1ˆvar ασσβ==-=∑∑iixr x 同理,有()()33ˆvar ˆvar γβ=4.2在决定一个回归模型的“最优”解释变量集时人们常用逐步回归的方法。