
双重差分模型difference in differences models
• Use time series of untreated group to establish what would have occurred in the absence of the intervention • Key concept: can control for the fact that the intervention is more likely in some types of states
• Only two periods • Intervention will occur in a group of observations (e.g. states, firms, etc.)
14
• Three key variables
– Tit =1 if obs i belongs in the state that will eventually be treated – Ait =1 in the periods when treatment occurs – TitAit -- interaction term, treatment states after the intervention
Difference in Difference Models
Bill Evans Spring 2008
1
Difference in difference models
• Maybe the most popular identification strategy in applied work today • Attempts to mimic random assignment with treatment and “comparison” sample • Application of two-way fixed effects model
17
• ui is a state effect • vt is a complete set of year (time) effects • Analysis of covariance model • Yit = β0 + β3 TitAit + ui + λt + εit
18
What is nice about the model
– ui and TitAit – λt and TitAit
19
• Group effects
– Capture differences across groups that are constant over time
• Year effects
– Capture differences over time that are common to all groups
8
Y Treatment effect= (Yt2-Yt1) – (Yc2-Yc1) Yc1 Yt1
Yc2
Yt2
control treatment t1 t2
time
9
Key Assumption
• Control group identifies the time path of outcomes that would have happened in the absence of the treatment • In this example, Y falls by Yc2-Yc1 even without the intervention • Note that underlying ‘levels’ of outcomes are not important (return to this in the regression equation)
Yi = Xiβ + αRi + εi Y (duration) R (replacement rate) Expect α > 0 Expect Cov(Ri, εi)
– Higher wage workers have lower R and higher duration (understate) – Higher wage states have longer duration and longer R (overstate)
• Suppose interventions are not random but systematic
– Occur in states with higher or lower average Y – Occur in time periods with different Y’s
• This is captured by the inclusion of the state/time effects – allows covariance between
20
Meyer et al.
• Workers’ compensation
– State run insurance program – Compensate workers for medical expenses and lost work due to on the job accident
• Premiums
– Paid by firms – Function of previous claims and wages paid
• Benefits -- % of income w/ cap
21
• Typical benefits schedule
– Min( pY,C) – P=percent replacement – Y = earnings – C = cap – e.g., 65% of earnings up to $400/month
28
29
Questions to ask?
6
Three different presentations
• Tabular • Graphical • Regression equation
7
Difference in Difference
Before Change Group 1 (Treat) Group 2 (Control) Difference Yt1 Yc1 After Change Yt2 Yc2 Difference ΔY t = Yt2-Yt1 ΔY c =Yc2-Yc1 ΔΔY ΔY t – ΔY c
24
Solution
• Quasi experiment in KY and MI • Increased the earnings cap
– Increased benefit for high-wage workers
• (Treatment)
– Did nothing to those already below original cap (comparison)
22
• Concern:
– Moral hazard. Benefits will discourage return to work
• Empirical question: duration/benefits gradient • Previous estimates
– Regress duration (y) on replaced wages (x)
2
Problem set up
• Cross-sectional and time series data • One group is ‘treated’ with intervention • Have pre-post data for group receiving intervention • Can examine time-series changes but, unsure how much of the change is due to secular changes
– If using time series, estimate Yt1 – Yt2
• Solution?
5
Difference in difference models
• Basic two-way fixed effects model
– Cross section and time fixed effects
• Compare change in duration of spell before and after change for these two groups
25
26
27
Model
• Yit = duration of spell on WC • Ait = period after benefits hike • Hit = high earnings group (Income>E3) • Yit = β0 + β1Hit + β2Ait + β3AitHit + β4Xit’ + εit • Diff-in-diff estimate is β3
• Yit = β0 + β1Tit + β2Ait + β3TitAit + εit
15
Yit = β0 + β1Tit + β2Ait + β3TitAit + εit
Before Change Group 1 (Treat) Group 2 (Control) Difference β0+ β1 β0 After Change Difference
• Problem:
– given progressive nature of benefits, replaced wages reveal a lot about the workers – Replacement rates higher in higher wage states
双重差分模型研究

双重差分模型研究作者:王小语林冬冬来源:《中国管理信息化》2021年第02期[摘要]应用双重差分模型(difference-in-difference,DID)可以很好地解决样本自选择带来的内生性问题,近年来普遍被用于某一项公共政策或项目实施效果的定量评估,在计量经济学领域以及社会学领域被广泛应用。
文章通过梳理双重差分法的发展历史,分析了该方法的构建原理,并通过实例研究阐明了该方法的应用以及应用中出现的问题,以期规范实证论文中双重差分方法的应用,提高研究结论的可信度,发挥经济研究对实践的指导意义。
[关键词]双重差分模型;政策评价;内生性0 引言双重差分模型(difference-in-difference,DID)是近年来被广泛应用的一种定量的研究方法,可以很好地解决样本自选择带来的内生性问题,特别适用于衡量某项政策出台后产生的边际效应。
由于上述优势,双重差分模型被广泛应用于某一项公共政策或项目实施效果的定量评估,且取得了一系列的研究成果。
但是,随着方法模型被广泛应用,产生了应用不规范等一系列问题,削弱了研究结论的可靠性,影响了双重差分模型的长远发展,需要进一步梳理双重差分模型的发展历史以及原理,以更好地规范实证研究中方法的应用,进一步提高管理的科学性。
1 双重差分方法的发展历史1.1 国内国外的首次应用1985年,两位普林斯顿大学的学者在项目评价相关论文中首次应用了双重差分模型,为以后双重差分模型在计量经济学领域以及社会学领域的应用奠定了基础。
在此后的国外研究中,双重差分模型被广泛应用于西方各项政策实施效果的评价。
我国首次应用双重差分模型对政策效果进行定量评价的文献是2005年学者周黎安、陈烨发表的《中国农村税费改革的政策效果:基于双重差分模型的估计》一文,该文通过对全国县级市的数据进行定量分析,对我国实施的农村税费改革这一政策进行了定量评价,验证了这一政策的正面作用。
此后,很多学者相继应用这种方法研究了我国如新所得税法、营改增、沪港通等公共政策产生的经济影响。
双重差分模型幻灯片+-+difference+in+differences+models
Y Yc1 Treatment effect= (Yt2-Yt1) – (Yc2-Yc1)
Yc2 Yt1
control Yt2 treatment t1 t2 Treatment Effect
time
11
• In contrast, what is key is that the time trends in the absence of the intervention are the same in both groups • If the intervention occurs in an area with a different trend, will under/over state the treatment effect • In this example, suppose intervention occurs in area with faster falling Y
17
• ui is a state effect • vt is a complete set of year (time) effects • Analysis of covariance model • Yit = β0 + β3 TitAit + ui + λt + εit
18
What is nice about the model
3
Y True effect = Yt2-Yt1 Estimated effect = Yb-Ya Yt1 Ya Yb Yt2
t1
ti
t2
time
4
• Intervention occurs at time period t1 • True effect of law
双重差分模型原理

双重差分模型原理
双重差分模型是一种用于处理面板数据(panel data)的经济计量模型,也称为固定效应模型(fixed effects model)或差分于均值模型
(differences-in-differences model)。
在双重差分模型中,研究者通过对数据进行两次差分来控制潜在的混淆因素,从而估计出因果效应。
具体而言,双重差分模型通过两次差分来消除个体固定效应和时间固定效应,从而实现对处理组和对照组之间因果效应的估计。
双重差分模型的基本形式可以表示为:
Y_it = α+ β*D_t + γ*D_i + δ*(D_t*D_i) + ε_it,
其中,Y_it表示个体i在时间t的观测值,α表示截距项,D_t和D_i分别为时间和个体的虚拟变量(通常为0或1),β表示处理效应,γ表示个体固定效应,δ表示时间固定效应,ε_it表示随机误差项。
当研究者关注的是处理效应β时,通过在双重差分模型中控制时间和个体的固定效应,可以消除个体间的差异和时间间的趋势,从而更准确地估计处理效应。
双重差分模型的核心假设是平行趋势假设(parallel trends assumption),即处理组和对照组在处理介入之前趋势一致。
这个假设的成立保证了因果效应的可
辨识性。
需要注意的是,双重差分模型的估计结果是基于大样本理论的,需要在实际应用中注意是否满足这些假设,以及可能存在的其他混淆因素。
双重差分模型简介及其在金融学研究中的运用

Financial View金融视线 |双重差分模型简介及其在金融学研究中的运用巴英龙中央财经大学 北京 100081摘要:本文追溯了双重差分模型的起源与经济学含义,并通过清晰简明的推导,对双重差分模型、多期双重差分模型、倾向匹配得分双重差分等模型的原理和使用条件进行区分。
另外,本文综述多篇具有代表性的学术研究作品,并通过这些研究展示了双重差分模型在数理经济学和数理金融学等方面的实证意义,为后续研究提供思路。
关键词:双重差;金融模型;金融学中图分类号:F832 文献识别码:A 文章编号:1673-5889(2021)11-0109-04自20世纪中叶,金融学演化成一门独立的研究学科以来,就在不断革新的研究工具和研究思路中,继续细化成各个不同的学术流派。
在日益复杂的商业活动中,金融学不断创新,并在经济活动决策中扮演着越来越重要的角色。
21世纪以来,各种信息呈几何式增长,还有不断扩容的存储设备、逐渐提速的计算设备等为处理信息创造条件。
学者们开始逐渐探索收集数据、整理数据、处理和分析数据的科学方法。
而互联网、计算机的出现更为金融学的发展提供新的契机,一门以金融学为基础,数学和数理知识为支撑的新学科——数理金融学蓬勃发展。
数理金融学将数学模型与推导运用到金融学研究实践中,为决策制定、商业活动等提供了科学支持。
本文将介绍19世纪70年代以来,在数理金融的学术研究中大放异彩的一个数学模型:双重差分模型,通过清晰简明的推导使读者对该模型形成系统的认识,并抽丝剥茧地介绍在不同运用前提下,该模型的多种变型。
在模型推导结束后,本文将通过几篇经典文献对该模型及其变型进行剖析,并为读者开拓研究思路。
一、实验与数据在社会科学的学术研究中,根据数据集的不同收集过程,实验可分为“理想实验”“准实验”“自然实验”。
在现代金融学学术研究中,通过仔细设计与收集,许多商业活动的数据能够被运用为“准实验”。
当选取自然状况下发生的事件作为研究样本时,由于这些数据在形成过程中较少受到人为设计的实验因素的干扰,其结果往往会更具有说服力。
政策效果评估的双重差分方法
政策效果评估的双重差分方法政策效果评估在政府工作中至关重要,它可以帮助政策制定者了解政策的实际影响,从而做出更为有效的决策。
双重差分方法(Differences-in-Differences,DiD)作为一种常见的政策效果评估方法,具有诸多优点,但也存在一定的局限性。
本文将详细介绍双重差分方法在政策效果评估中的应用,并通过实际案例分析其优势、挑战及改进建议。
双重差分方法是一种广泛应用于政策效果评估、医学、社会科学等诸多领域的方法。
该方法通过比较政策实施组与对照组在政策实施前后的变化差异,来评估政策的实际效果。
近年来,随着大数据技术的发展,双重差分方法在政策效果评估领域的应用日益广泛。
数据来源主要包括政府部门、调查机构和相关研究机构等。
在收集数据时,需要确保数据的准确性、可靠性和时效性。
同时,还需对数据进行必要的处理,如清洗、整理等,以保证数据分析的质量。
因变量即政策效果评估的指标,应根据具体政策的不同进行选择。
例如,教育政策的效果可以通过学生成绩、升学率等指标来评估;环境保护政策的效果可以通过空气质量、水质等指标来评估。
在选择因变量时,应注意选择具有代表性、可操作性和可比较性的指标。
自变量即影响政策效果的因素,包括政策实施前后的时间趋势、地区差异、人群特征等。
在选择自变量时,需要充分了解政策实施的背景和影响因素,并对自变量进行合理控制和分析。
例如,在评估教育政策效果时,需要考虑不同地区的教育资源、师资力量等因素。
双重差分方法的核心是通过比较政策实施组和对照组在政策实施前后的变化差异来评估政策效果。
需要确定实施组和对照组;需要对其在政策实施前后的数据进行比较和分析。
在应用双重差分方法时,应注意选择合适的对照组和处理潜在的混淆因素。
以某城市推行垃圾分类政策为例,采用双重差分方法评估其效果。
收集该城市在推行垃圾分类政策前后的相关数据,包括垃圾产生量、分类投放情况、回收利用率等。
数据来源包括政府部门、研究机构和社会调查等。
二重差分法分析(DID)
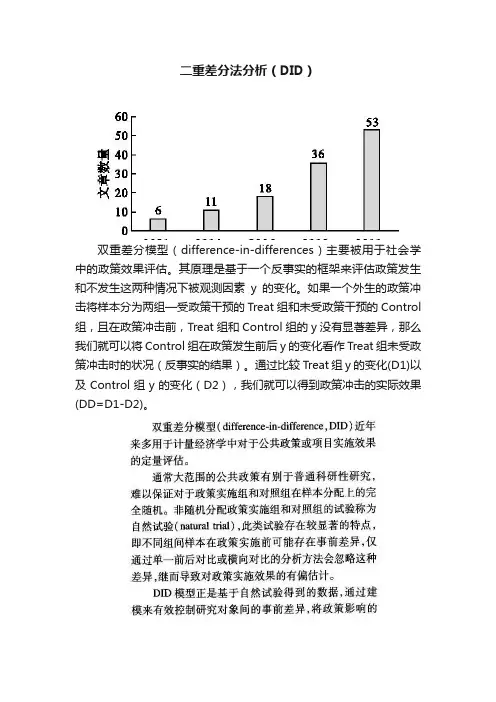
二重差分法分析(DID)双重差分模型(difference-in-differences)主要被用于社会学中的政策效果评估。
其原理是基于一个反事实的框架来评估政策发生和不发生这两种情况下被观测因素y的变化。
如果一个外生的政策冲击将样本分为两组—受政策干预的Treat组和未受政策干预的Control 组,且在政策冲击前,Treat组和Control组的y没有显著差异,那么我们就可以将Control组在政策发生前后y的变化看作Treat组未受政策冲击时的状况(反事实的结果)。
通过比较Treat组y的变化(D1)以及Control组y的变化(D2),我们就可以得到政策冲击的实际效果(DD=D1-D2)。
双重差分法,英文名Differences-in-Differences,别名“倍差法”,小名“差中差”。
作为政策效应评估方法中的一大利器,双重差分法受到越来越多人的青睐,概括起来有如下几个方面的原因:(1)可以很大程度上避免内生性问题的困扰:政策相对于微观经济主体而言一般是外生的,因而不存在逆向因果问题。
此外,使用固定效应估计一定程度上也缓解了遗漏变量偏误问题。
(2)传统方法下评估政策效应,主要是通过设置一个政策发生与否的虚拟变量然后进行回归,相较而言,双重差分法的模型设置更加科学,能更加准确地估计出政策效应。
(3)双重差分法的原理和模型设置很简单,容易理解和运用,并不像空间计量等方法一样让人望而生畏。
(4)尽管双重差分法估计的本质就是面板数据固定效应估计,但是DID听上去或多或少也要比OLS、FE之流更加“时尚高端”,因而DID的使用一定程度上可以满足“虚荣心”。
在细致介绍DID之前首先强调一点,一般而言,DID仅适用于面板数据,因此在只有截面数据时,还是不要浪费心思在DID上了。
不过,事无绝对,在某些特殊的情景下,截面数据通过巧妙的构造也是可以运用DID的,大神Duflo曾经就使用截面数据和DID研究了南非的养老金计划项目对学前儿童健康的影响,感兴趣的可以去搜搜大神的文章。
双向固定效应和双重差分
Generated from a theoretical model of consumer choice
Thought by economists to be fairly universal in application
Simple research design
Prices typically changed due to state/federal tax hikes
States with changes are ‘treatment’ States without changes are control
vt – time fixed effects. Impacts common to all groups but vary by year
εit -- idiosyncratic error
.
3
Excises taxes on poor health
Alcohol and cigarettes are taxed at the federal, state and local level
Beer, $0.02 a can Liquor, $13.50 per 100 proof gallon (50% alcohol), or,
$2.14/750 ml bottle of 80 proof liquor Total taxes on cigarettes are such that in NYC, you spend
Medical/psychological view – certain goods not subject to these laws
双重差分模型介绍及其应用
双重差分模型介绍及其应用
双重差分模型(Double Difference Model)是一种统计分析模型,
用于估计处理效应或政策影响的因果效应。
该模型是在差分法
(Difference-in-Difference)的基础上引入了两个时间点之间的差分,
从而进一步控制了时间固定效应和处理固定效应,更准确地评估了处理效应。
双重差分模型最初在经济学领域中被广泛应用,用于评估各种政策措
施对经济变量的影响。
例如,研究者可以在一些地区实施了项政策(处理组),而另一个地区则没有实施该政策(对照组),通过比较两个地区在
政策实施前后的数据差异,就可以得到该政策的因果效应。
在实际应用中,双重差分模型可以应用于各种领域的研究。
除了经济
学领域,它还在医学、教育、社会科学等领域得到了广泛应用。
例如,在
医学研究中,研究者可以将其中一种新的治疗方法应用于一组患者,而另
一组患者则继续采用传统治疗方法,通过比较两组患者的数据差异,可以
评估新治疗方法的效果。
在教育研究中,研究者可以随机将一些学校或班
级分为处理组和对照组,然后比较两组学生在教育政策实施后的学业成绩,评估政策的效果。
双重差分模型的核心思想是通过数据分析方法消除可能存在的混淆因素,实现对处理效应的准确估计。
然而,该模型也受到一些限制。
首先,
它仍然需要依赖于其中一种原因导致的差异,如果没有合理的随机分组或
自然实验条件,模型的结果可能会受到偏差的影响。
其次,双重差分模型
的应用也需要满足一些基本的假设,如平行趋势假设和稳定性假设,如果
这些假设不能成立,模型的效果可能会受到影响。
双重差分模型-许红伟
*
本文受国家自然科学基金(项目编号:70802039)资助。感谢匿名审稿人的宝贵建议。
1
我国推出融资融券交易促进了标的股票的定价效率吗?
——基于双重差分模型的实证研究
摘要:基于双重差分(DID)模型,本文研究了我国融资融券试点对股票定价效率和收益率分 布的影响,发现其仅在少数指标上有一定积极作用,总体上效果仍然相当有限,为现有文献争 议和后续政策完善提供了新的经验证据。具体来说,融资融券试点一年内: (1)对定价效率的 改善仍然较弱,标的股票价格负面信息含量和对市场向下波动的调整速度变化均不明显;(2 ) 能够显著减少股价暴跌概率,对抑制暴涨却几乎没有影响,最终只起到了“单向缓冲器”作用; (3)仅能显著降低含 H 股、高市值、低换手率和低市盈率股票的偏度,对改善收益率的尖峰 现象则没有起到积极作用。结合市场实际运行情况,本文认为融资融券这一机制创新没有完全 发挥功能的主要原因在于诸多交易限制,并提出了相应的政策建议。 关键词:卖空机制; 融资融券; 定价效率; 收益率分布; 双重差分模型 JEL 分类号:G13; G14; G18 文章标识码: A
—————————— 投稿日期:2011 年 7 月 25 日 修改日期:2011 年 12 月 22 日 作者简介:许红伟,男,上海交通大学安泰经济与管理学院博士研究生。 陈欣,男,上海交通大学安泰经济与管理学院副教授,明尼苏达大学博士。 联系方式: 许红伟,上海市法华镇路 535 号南楼 303 室, 邮编 200052,电话 13918928410, EMAIL:randysue@ 陈欣,通讯作者,上海市法华镇路 535 号 10 号楼 204 室,邮编 200052, 电话 021- 52301259,EMAIL:xi融券余额历史走势 虽然目前我国融资融券交易发展缓慢,但它可以放大资金和证券双向供求关系,为投资者 带来了新的投资理念、盈利模式和交易方式,从逻辑推理上来说,一定会或多或少影响标的股 票的价格形成过程。那么,这种影响程度究竟如何?是否能提高我国股票定价效率、缓解同涨 同跌和暴涨暴跌等现象?借助于融资融券在我国试点这一难得的“自然实验”,通过严谨的定 量方法来进行深入研究,具有十分重要的理论和政策意义,一方面为国际文献争议提供了新的 经验证据,另一方面也为监管层完善后续相关政策、特别是进一步深化金融创新提供了理论基 础和实证支持。 因此,基于以上理论和实践背景,本文主要采用双重差分模型(Difference-in-Differences Model,下称 DID 模型),对融资融券推出如何影响标的股票价格效率和收益率分布进行了相
动态效应检验模型
动态效应检验模型
动态效应检验通常是在经济学中使用,主要是在面板数据模型中考察某种经济现象随时间变化的影响。
以下是几种常用的动态效应检验模型:
1、固定效应模型(Fixed Effects Model):这种模型假设所有观测值之间的差异都是由不可观测的固定效应引起的。
例如,如果研究不同国家的教育投资对经济增长的影响,那么每个国家的特定文化、历史、政治和经济条件等可能就是那些不可观测的固定效应。
2、随机效应模型(Random Effects Model):这种模型假设所有的观测值之间的差异都是随机产生的。
例如,如果我们要研究不同年份的教育投资对经济增长的影响,那么不同年份的宏观经济条件、科技发展水平、政治环境等可能就是那些随机效应。
3、混合效应模型(Mixed Effects Model):这种模型结合了固定效应和随机效应的特性。
在某些情况下,固定效应和随机效应同时存在,那么就需要使用混合效应模型。
4、差分法(Difference Method):这种方法通过比较一个或多个变量的不同时间点的观测值来估计某种影响。
例如,我们可以通过比较同一企业在采用新技术前后的生产率来估计这种技术对企业生产率的影响。
5、双重差分法(Differences-in-Differences Method):这种方法通过比较处理组和对照组在接受某种处理前后的表现来估计这种处理的影
响。
例如,我们可以通过比较接受新技术培训的企业和未接受新技术培训的企业的生产率变化来估计新技术对企业生产率的影响。
以上就是一些常用的动态效应检验模型,具体使用哪种模型需要依据研究问题和可获得数据的特性来决定。