
经典线性回归模型的诊断与修正
经典线性回归模型的诊断与修正下表为最近20年我国全社会固定资产投资与GDP的统计数据:1
年份国内生产总值(亿元)GDP 全社会固定资产投资(亿元)PI
1996
199779715
1998
1999
2000
2001
2002
2003137422
2004
2005
2006
2007
2008
2009
2010
2011
2012
2013
2014643974
2015
1、普通最小二乘法回归结果如下:
方程初步估计为:
GDP=+
1数据来源于国家统计局网站年度数据
F= DW=
2、异方差的检验与修正
首先,用图示检验法,生成残差平方和与解释变量PI的散点图如下:
从上图可以看出,残差平方和与解释变量的散点图主要分布在图形的下半部分,有随PI的变动增大的趋势,因此,模型可能存在异方差。
但是否确定存在异方差,还需作进一步的验证。
G-Q检验如下:
去除序列中间约1/4的部分后,1996-2003年的OLS估计结果如下所示:
残差平方和RSS1=.
2008-2015年的OLS估计结果如下:
残差平方和RSS2=+09.
根据G-Q检验,F统计量为
F=>
因此,在5%的显著性水平下拒绝两组子样本方差相同的假设,即存在异方差。
Gleiser检验结果如下
参数的估计值显著地不为0,则可以认定模型存在着异方差。
异方差的修正:
运用加权最小二乘法对异方差进行修正
对加权后的模型进行异方差检验,结果如下:
已知 White统计量n,由于>,因此,可以判断在给
定显著性水平的情况下,加权后的模型不再存在异方差,说明异方差性已经消除。
3、序列相关性的检验与修正
序列相关性的检验如下:
做残差与残差滞后一期的散点图:
可以看出,E与E(-1)逐渐合拢,因此残差与其滞后一期的残差存在序列相关性。
D-W检验:
从OLS估计结果中可直接得到DW值为,给定α=,已知n=20,k=2,查DW检验临界值表可得,,,由<可知模型存在正自相关。
序列相关性的修正:
利用广义差分法,由于,有估计结果如下:
在新序列估计结果下, <DW=<4-,故不再存在序列相关性,自相关已经得到消除。
运用Cochrane-Orcutt迭代法进行自相关的修正:
根据结果可知, <DW=<4-,故不再存在自相关。
R--线性回归诊断(一)

R--线性回归诊断(⼀)线性回归诊断--R【转载时请注明来源】:Ljt 勿忘初⼼⽆畏未来作为⼀个初学者,⽔平有限,欢迎交流指正。
在R中线性回归,⼀般使⽤lm函数就可以得到线性回归模型,但是得到的模型到底合不合适?在我们使⽤所得到的线性模型之前就需要进⾏回归诊断。
线性回归的诊断,主要是检验线性回归模型的假设是否成⽴。
线性回归模型 y=Θ0+Θ1x1+Θ2x2+.......+Θm x m+ε(⾃变量与因变量之间是线性关系)基本假设:(1)随机⼲扰项ε服从零均值,同⽅差,零协⽅差(相互独⽴)的正态分布E(εi)=0 ; var(εi)=σ2 ;cov(εi , εj)=0 ;εi~N(0,σ2)(2)随机⼲扰项ε与解释变量间不相关cov(X i , εi) =0(⼀)显著性检验(1)回归⽅程显著性 F 检验:看⾃变量 X1 , X2 .....X m 从整体上对随机变量Y是否有明显的影响。
原假设 H0:Θ1 =Θ2=.....=Θm=0 (H0 若被接受则表明随机变量Y与X1 , X2 .....X m 之间的关系由线性回归模型表⽰不合适)P值<α : 拒绝原假设。
即在显著性⽔平α下,Y 与 X1 , X2 .....X m 有显著的线性关系,回归⽅程是显著的。
(⾃变量全体对因变量产⽣线性影响)(2)回归系数显著性 t 检验:看单个的⾃变量 X i 对Y是否有明显影响。
原假设 H0i:Θi =0 (H0i若被接受则表明⾃变量X i 对因变量Y的线性效果不显著)P值<α : 拒绝原假设。
即在显著性⽔平α下,Y 与 X i有显著的线性关系。
对于⼀元线性回归这两种检验是等价的;对于多元线性回归,这两种检验是不等价的:F检验显著,说明Y对⾃变量X1 , X2 .....X m整体的线性回归效果是显著的,但不等于Y对每个⾃变量X i 的效果都显著;反之,某个或某⼏个X i的系数不显著,回归⽅程显著性的F检验仍然有可能是显著的。
计量经济学EVIEWS自相关检验与修正
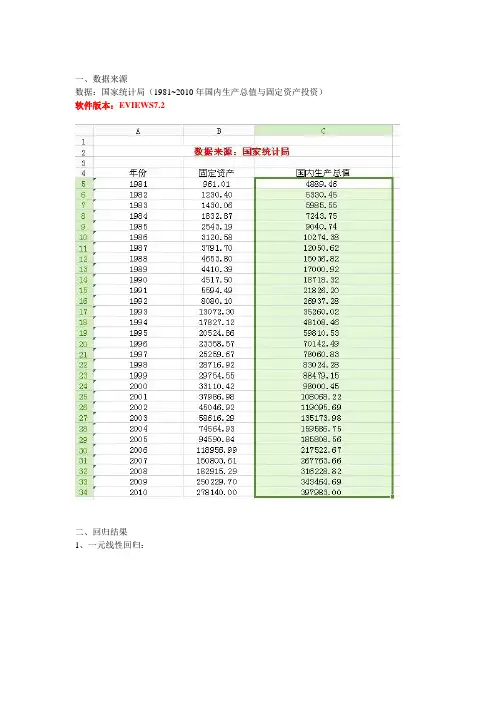
一、数据来源
数据:国家统计局(1981~2010年国内生产总值与固定资产投资)软件版本:EVIEWS7.2
二、回归结果
1、一元线性回归:
三、模型诊断与修正
DW检验:相关系数δ=0.8546,查表得,
1.35
1.49
L
U
d
d
=
=
经检验,DW<1.35,自变量呈一阶正自
相关
四、广义差分法修正后的结果
对E 进行滞后一期的自回归,可得回归方程:E=0.9337E(-1)
对原模型进行广义差分,输出结果为:
**ˆˆ6981.723 1.002749t t y x =+
由于使用广义差分数据,样本容量减少了1个,为29个。
查5%的显著性水平的DW
统计表可知, 1.341.48
L U d d ==,模型中的4-DU>DW>DU ,所以广义差分模型已无序列相关。
根据()1ˆˆ16981.723βρ-=,可得1
ˆ=105305.023β。
因此,原回归模型应为 105305.023 1.002749t t y x =+
采用普莱斯-文斯滕变换后第一个观测值变为211y δ-为1750.7019和211x δ-为344.1377,变换后普通最小二乘结果为**ˆˆ7555.503 1.0611t t y
x =+,根据()1ˆˆ17555.503βρ-=,得1
ˆ=113959.321β,由此,最终模型是 ˆ113959.321 1.0611t t y
x =+。
计量经济学第二章经典线性回归模型

Yt = α + βXt + ut 中 α 和 β 的估计值 和
,
使得拟合的直线为“最佳”。
直观上看,也就是要求在X和Y的散点图上
Y
* * Yˆ ˆ ˆX
Yt
* **
Yˆt
et * *
*
*
**
*
**
**
*
Xt
X
图 2.2
残差
拟合的直线 Yˆ ˆ ˆX 称为拟合的回归线.
对于任何数据点 (Xt, Yt), 此直线将Yt 的总值 分成两部分。
β
K
βK
β1 β1
...
βK
βK
Var(β 0 )
Cov(β1 ,β
0
)
Cov(β 0 ,β1 )
Var(β1 )
...
Cov(β
0
,β
K
)
...
Cov(β1
,β
K
)
...
...
...
...
Cov(β
K
,β
0
)
Cov(β K ,β1 )
...
Var(β K )
不难看出,这是 β 的方差-协方差矩阵,它是一 个(K+1)×(K+1)矩阵,其主对角线上元素为各 系数估计量的方差,非主对角线上元素为各系 数估计量的协方差。
ut ~ N (0, 2 ) ,t=1,2,…n
二、最小二乘估计
1. 最小二乘原理
为了便于理解最小二乘法的原理,我们用双
变量线性回归模型作出说明。
对于双变量线性回归模型Y = α+βX + u, 我 们
的任务是,在给定X和Y的一组观测值 (X1 ,
线性回归模型的经典假定及检验修正

线性回归模型的经典假定及检验、修正一、线性回归模型的基本假定1、一元线性回归模型一元线性回归模型是最简单的计量经济学模型,在模型中只有一个解释变量,其一般形式是Y =β0+β1X 1+μ其中,Y 为被解释变量,X 为解释变量,β0与β1为待估参数,μ为随机干扰项。
回归分析的主要目的是要通过样本回归函数(模型)尽可能准确地估计总体回归函数(模型)。
为保证函数估计量具有良好的性质,通常对模型提出若干基本假设。
假设1:回归模型是正确设定的。
模型的正确设定主要包括两个方面的内容:(1)模型选择了正确的变量,即未遗漏重要变量,也不含无关变量;(2)模型选择了正确的函数形式,即当被解释变量与解释变量间呈现某种函数形式时,我们所设定的总体回归方程恰为该函数形式。
假设2:解释变量X 是确定性变量,而不是随机变量,在重复抽样中取固定值。
这里假定解释变量为非随机的,可以简化对参数估计性质的讨论。
假设3:解释变量X 在所抽取的样本中具有变异性,而且随着样本容量的无限增加,解释变量X 的样本方差趋于一个非零的有限常数,即∑(X i −X ̅)2n i=1n→Q,n →∞ 在以因果关系为基础的回归分析中,往往就是通过解释变量X 的变化来解释被解释变量Y 的变化的,因此,解释变量X 要有足够的变异性。
对其样本方差的极限为非零有限常数的假设,旨在排除时间序列数据出现持续上升或下降的变量作为解释变量,因为这类数据不仅使大样本统计推断变得无效,而且往往产生伪回归问题。
假设4:随机误差项μ具有给定X 条件下的零均值、同方差以及无序列相关性,即E(μi|X i)=0Var(μi|X i)=σ2Cov(μi,μj|X i,X j)=0, i≠j随机误差项μ的条件零均值假设意味着μ的期望不依赖于X的变化而变化,且总为常数零。
该假设表明μ与X不存在任何形式的相关性,因此该假设成立时也往往称X为外生性解释变量随机误差项μ的条件同方差假设意味着μ的方差不依赖于X的变化而变化,且总为常数σ2。
标准线性回归模型
可以通过对自变量进行变换(如对数 转换、幂转换等)或使用多项式回归 等方法处理非线性关系,提高模型拟 合效果。
时间序列数据的处理
时间序列数据的特点
时间序列数据具有时序依赖性和动态 变化性,不同时间点的数据之间存在 相关性。
处理方法
通过差分、季节性差分、指数化等方 法消除时间序列数据的趋势和季节性 影响,或者使用ARIMA、SARIMA等 时间序列模型对数据进行拟合和预测。
可以通过剔除相关性较高的自变量、使用主成分分析等方法处
理多重共线性问题。
无异方差性
异方差性的定义
异方差性是指误差项的方差不恒定,即随着自变量的变化,误差 项的方差也会发生变化。
异方差性的检验
可以通过图形方法(如残差图)或统计方法(如White检验)来 检验异方差性。
处理异方差性的方法
可以通过使用稳健的标准误、对数变换等方法处理异方差性问题。
准线性回归模型
• 引言 • 模型假设 • 标准线性回归模型的参数估计 • 模型的评估与诊断 • 线性回归模型的扩展 • 案例分析
01
引言
目的和背景
探索自变量与因变量 之间的非线性关系
为复杂数据提供更准 确的预测和解释
弥补标准线性回归模 型的局限性,处理非 线性数据
标准线性回归模型的定义
线性关系
检验残差是否服从正态分布。
详细描述
正态性检验是用来检验回归模型的残差是否服从正态分布的一种方法。如果残差服从正态分布,那么 我们可以认为模型满足经典假设之一,这有助于我们更好地理解和解释模型的结果。
异方差性检验
总结词
检验残差是否具有异方差性。
详细描述
异方差性检验是用来检验回归模型的残差是否具有异方差性的一种方法。如果残差具有 异方差性,那么模型的估计参数可能会受到影响,导致模型的结果不准确。因此,进行
应用统计学多重线性回归模型

2020年8月3日星期一
重庆交通大学管理学院
08:19:10
残差分析
❖ 残差种类 非标准化残差(原始残差) 标准化残差(Pearson残差) 学生化残差 剔除残差 学生化剔除残差
2020年8月3日星期一
重庆交通大学管理学院
08:19:10
残差分析
❖ 模型适用条件的检验-因变量与自变量之间存在线性 关系的检验(以例1为例:年龄)
初步分析: 与简单线性回归相类似,先绘制散点图,以便在进行回 归分析之前了解各变量之间是否存在线性关系。本例有 两个自变量与一个反应变量,绘制散点图矩阵,如下。
2020年8月3日星期一
重庆交通大学管理学院
08:19:08
简单分析实例-初步分析
❖ 绘制散点图矩阵
2020年8月3日星期一
重庆交通大学管理学院
模型的进一步诊断与修正
❖ 多重共线性的识别
多重共线性:是指自变量间存在相关关系,即一个自变量可以用其他 一个或几个自变量的线性表达式进行表示。有以下表现形式:
整个模型的方差分析结果为P<,但各自变量的偏回归系数的统计学 结果却为P> ;
专业上认为应该有统计学意义的自变量检验结果却无统计学意义; 自变量的偏回归系数取值大小甚至符号明显与实际情况违背,难以 解释; 增加或删除一条记录或一个自变量,偏回归系数发生很大变化。
2020年8月3日星期一
重庆交通大学管理学院
08:19:11
残差分析
❖ 模型适用条件的检验-方差齐性的检验
2020年8月3日星期一
重庆交通大学管理学院
08:19:11
残差分析
❖ 模型适用条件的检验-正态性的检验
2020年8月3日星期一
经典线性回归模型的Eviews操作
经典线性回归模型经典回归模型在涉及到时间序列时,通常存在以下三个问题:1)非平稳性→ ADF单位根检验→ n阶单整→取原数据序列的n阶差分(化为平稳序列)2)序列相关性→D.W.检验/相关图/Q检验/LM检验→n阶自相关→自回归ar(p)模型修正3)多重共线性→相关系数矩阵→逐步回归修正注:以上三个问题中,前两个比较重要。
整体回归模型的思路:1)确定解释变量和被解释变量,找到相关数据。
数据选择的时候样本量最好多一点,做出来的模型结果也精确一些。
2)把EXCEL里的数据组导入到Eviews里。
3)对每个数据序列做ADF单位根检验。
4)对回归的数据组做序列相关性检验。
5)对所有解释变量做多重共线性检验。
6)根据上述结果,修正原先的回归模型。
7)进行模型回归,得到结论。
Eviews具体步骤和操作如下。
一、数据导入1)在EXCEL中输入数据,如下:除去第一行,一共2394个样本。
2)Eviews中创建数据库:File\new\workfile, 接下来就是这个界面(2394就是根据EXCEL里的样本数据来),OK3)建立子数据序列程序:Data x1再enter键就出来一个序列,空的,把EXCEL里对应的序列复制过来,一个子集就建立好了。
X1是回归方程中的一个解释变量,也可以取原来的名字,比如lnFDI,把方程中所有的解释变量、被解释变量都建立起子序列。
二、ADF单位根检验1)趋势。
打开一个子数据序列,先判断趋势:view\graph,出现一个界面,OK。
得到类似的图,下图就是有趋势的时间序列。
X1.4.2.0-.2-.4-.6-.8100020003000400050002)ADF检验。
直接在图形的界面上进行操作,view\unit root test,出现如下界面。
在第二个方框内根据时序的趋势选择,Intercept指截距,Trend为趋势,有趋势的时序选择第二个,OK,得到结果。
上述结果中,ADF值为-3.657113,t统计值小于5%,即拒绝原假设,故不存在单位根。
线性回归模型的建模与分析方法
线性回归模型的建模与分析方法线性回归模型是一种常用的统计学方法,用于研究自变量与因变量之间的关系。
在本文中,我们将探讨线性回归模型的建模与分析方法,以及如何使用这些方法来解决实际问题。
一、线性回归模型的基本原理线性回归模型假设自变量与因变量之间存在线性关系,即因变量可以通过自变量的线性组合来预测。
其基本形式可以表示为:Y = β0 + β1X1 + β2X2 + ... + βnXn + ε其中,Y表示因变量,X1、X2、...、Xn表示自变量,β0、β1、β2、...、βn表示回归系数,ε表示误差项。
二、线性回归模型的建模步骤1. 收集数据:首先需要收集自变量和因变量的相关数据,确保数据的准确性和完整性。
2. 数据预处理:对数据进行清洗、缺失值处理、异常值处理等预处理步骤,以确保数据的可靠性。
3. 模型选择:根据实际问题和数据特点,选择适合的线性回归模型,如简单线性回归模型、多元线性回归模型等。
4. 模型拟合:使用最小二乘法等方法,拟合回归模型,得到回归系数的估计值。
5. 模型评估:通过统计指标如R方值、调整R方值、残差分析等,评估模型的拟合优度和预测能力。
6. 模型应用:利用已建立的模型进行预测、推断或决策,为实际问题提供解决方案。
三、线性回归模型的分析方法1. 回归系数的显著性检验:通过假设检验,判断回归系数是否显著不为零,进一步判断自变量对因变量的影响是否显著。
2. 多重共线性检验:通过计算自变量之间的相关系数矩阵,判断是否存在多重共线性问题。
若存在多重共线性,需要进行相应处理,如剔除相关性较高的自变量。
3. 残差分析:通过观察残差的分布情况,判断模型是否符合线性回归的基本假设,如误差项的独立性、正态性和方差齐性等。
4. 模型诊断:通过观察残差图、QQ图、杠杆值等,判断是否存在异常值、离群点或高杠杆观测点,并采取相应措施进行修正。
5. 模型优化:根据模型评估结果,对模型进行优化,如引入交互项、非线性变换等,以提高模型的拟合效果和预测准确性。
经典线性回归模型
·β的OLS估计量:在假定2.3成立时
( ) å å b =
XTX
-1 X T Y
= çæ 1 èn
n i=1
xi xiT
Hale Waihona Puke -1ö æ1 ÷ç ø èn
n i=1
xi yi
÷ö ø
( ) ·估计量的抽样误差(sampling error): b - b = X T X -1 X Te
·第i次观测的拟合值(fitted value): yˆi = xiTb
且自变量的回归系数和 y 与 x 的样本相关系数之间的关系为
b1 == corr(Y , X )
å( 1 n
n - 1 i=1
yi
- y)2
º r sy
å( ) 1 n
n - 1 i=1
xi - x 2
sx
·修正决定系数(adjusted coefficient of determination, adjusted R square)
4.假定我们观测到上述这些变量的n组值: (y i , x i1 , L , ) x ip (i=1,…,n)。称
这n组值为样本(sample)或数据(data)。
§2.2 经典线性回归模型的假定
假定 2.1(线性性(linearity))
yi = b0 + b1xi1 + L + b p xip + e i (i=1,…,n)。
( ) ( ) E ~x jei
çæ E x j1e i =ç M
÷ö ÷=0
(i=1,…,n ; j=1,…,n )。
( ) ç
è
E
x jp e i
÷ ø
·不相关条件(zerocorrelation conditions)
回归分析回归诊断
0.925064 0.855744
0.814528
0.192504 19
方差分析
回归分析 残差 总计
df 4
14 18
SS 3.077652 0.518811 3.596463
Intercept X Variable 1 X Variable 2 X Variable 3 X Variable 4
还有模型的设定
标准的回归假定:
1,关于模型设定的假定 2,关于误差的假定 3,关于预测变量的假定
非随机的 其取值是误差取得的,但几乎不可能。测量误差将 影响到误差方差,相关系数,复相关系数及回归系数 的估计,其影响程度的大小取决于多个因素。 是线性无关的
4,关于观测的假定 所有观测是同样可靠性
数据的诊断 异常值 强影响点 假定是否满足
y
12
10
8
6
4
2
0
0
10
20
30
x 40
存在一个有影响观测值的散点图
有影响的观测值 (图示)
y
12
10
8
6
4
存在影响值的趋势
2
有影响的观
测值
0
0
10
20
30
x 40
存在一个有影响观测值的散点图
有影响的观测值 (图示)
y
12
10
不存在影响
8
值的趋势
6
4
存在影响值的趋势
2
有影响的观
测值
0
0
10
20
其次,必须确定“度量影响的尺度是什么?”为 了定量地刻划影响的大小,迄今为止已提出多种 尺度,基于置信域的尺度,基于似然函数的尺度 等等。