
关于无损分解和保持依赖的判断
关于无损分解和保持依赖的判断,是系分和数工考试中每年基本上都会考的题,而且绝大部分是对一个关系模式分解成两个模式的考察,分解为三个以上模式时无损分解和保持依赖的判断比较复杂,考的可能性不大,因此我们只对“一个关系模式分解成两个模式”这种类型的题的相关判断做一个总结。
以下的论述都基于这样一个前提:
R是具有函数依赖集F的关系模式,(R1 ,R2)是R的一个分解。
首先我们给出一个看似无关却非常重要的概念:属性集的闭包。
令α为一属性集。
我们称在函数依赖集F下由α函数确定的所有属性的集合为F下α的闭包,记为α+ 。
下面给出一个计算α+的算法,该算法的输入是函数依赖集F和属性集α,输出存储在变量result中。
算法一:
result:=α;
while(result发生变化)do
for each 函数依赖β→γ in F do
begin
if β∈result then result:=result∪γ;
end
属性集闭包的计算有以下两个常用用途:
·判断α是否为超码,通过计算α+(α在F下的闭包),看α+ 是否包含了R中的所有属性。
若是,则α为R的超码。
·通过检验是否β∈α+,来验证函数依赖是否成立。
也就是说,用属性闭包计算α+,看它是否包含β。
(请原谅我用∈符号来表示两个集合之间的包含关系,那个表示包含的符号我找不到,大家知道是什么意思就行了。
)
看一个例子吧,2005年11月系分上午37题:
● 给定关系R(A1,A2,A3,A4)上的函数依赖集F={A1→A2,A3→A2,A2→A3,A2→A4},R的候选关键字为________。
(37)A. A1 B. A1A3 C. A1A3A4 D. A1A2A3
首先我们按照上面的算法计算A1+ 。
result=A1,
由于A1→A2,A1∈result,所以result=result∪A2=A1A2
由于A2→A3,A2∈result,所以result=result∪A3=A1A2A3
由于A2→A4,A2∈result,所以result=result∪A3=A1A2A3A4
由于A3→A2,A3∈result,所以result=result∪A2=A1A2A3A4
通过计算我们看到,A1+ =result={A1A2A3A4},所以A1是R的超码,理所当然是R的候
选关键字。
此题选A 。
好了,有了前面的铺垫,我们进入正题。
无损分解的判断。
如果R1∩R2是R1或R2的超码,则R上的分解(R1,R2)是无损分解。
这是一个充分条件,当所有的约束都是函数依赖时它才是必要条件(例如多值依赖就是一种非函数依赖的约束),不过这已经足够了。
保持依赖的判断。
如果F上的每一个函数依赖都在其分解后的某一个关系上成立,则这个分解是保持依赖的(这是一个充分条件)。
如果上述判断失败,并不能断言分解不是保持依赖的,还要使用下面的通用方法来做进一步判断。
该方法的表述如下:
算法二:
对F上的每一个α→β使用下面的过程:
result:=α;
while(result发生变化)do
for each 分解后的Ri
t=(result∩Ri)+ ∩Ri //(result∩Ri)+表示result∩Ri的闭包
result=result∪t
这里的属性闭包是在函数依赖集F下计算出来的。
如果result中包含了β的所有属性,则函数依赖α→β。
分解是保持依赖的当且仅当上述过程中F的所有依赖都被保持。
下面给出一个例题,2006年5月系分上午43题:
●设关系模式R<U, F>,其中U={A, B, C, D, E},F={A→BC,C→D,BC→E,E→A},则分解ρ={R1(ABCE),R2(CD)}满足(43)。
(43)A.具有无损连接性、保持函数依赖
B.不具有无损连接性、保持函数依赖
C.具有无损连接性、不保持函数依赖
D.不具有无损连接性、不保持函数依赖
先做无损链接的判断。
R1∩R2={C},计算C+。
Result=C
由于C→D,C∈result,所以result=result∪D=CD
可见C是R2的超码,该分解是一个无损分解。
再做保持依赖的判断。
A→BC,BC→E,E→A都在R1上成立(也就是说每一个函数依赖左右两边的属性都在R1中),C→D在R2上成立,因此给分解是保持依赖的。
选A。
再看一个复杂点的例题。
2007年5月数工40-41题。
●给定关系模式R<U, F>,U={A, B, C, D, E},F={B→A,D→A,A→E,AC→B},其候选关键字为
(40),则分解ρ={R1(ABCE),R2(CD)}满足(41)。
(40)A.ABD
B.ABE
C.ACD
D.CD
(41)A.具有无损连接性、保持函数依赖
B.不具有无损连接性、保持函数依赖
C.具有无损连接性、不保持函数依赖
D.不具有无损连接性、不保持函数依赖
看见了吧,和前面一题多么的相像!
对于第一问,分别计算ABCD四个选项的闭包,
(ABD)+ = { ABDE }
(ABE)+ = { ABE }
(ACD)+ = { ABCDE }
(CD)+ = { ABCDE }
选D。
再看第二问。
先做无损链接的判断。
R1∩R2={C},计算C+。
result=C
因此C既不是R1也不是R2的超码,该分解不具有无损分解性。
再做保持依赖的判断。
B→A,A→E,AC→B在R1上成立,D→A在R1和R2上都不成立,因此需做进一步判断。
由于B→A,A→E,AC→B都是被保持的(因为它们的元素都在R1中),因此我们要判断的是D→A是不是也被保持。
对于D→A应用算法二:
result=D
对R1,result∩R1=ф(空集,找不到空集的符号,就用这个表示吧),t=ф,result=D
再对R2,result∩R2=D,D+ =ADE ,t=D+ ∩R2=D
一个循环后result未发生变化,因此最后result=D,并未包含A,所以D→A未被保持,该分解不是保持依赖的。
选D。
[总结]关系数据库设计基础(函数依赖、无损连接性、保持函数依赖、范式、……)
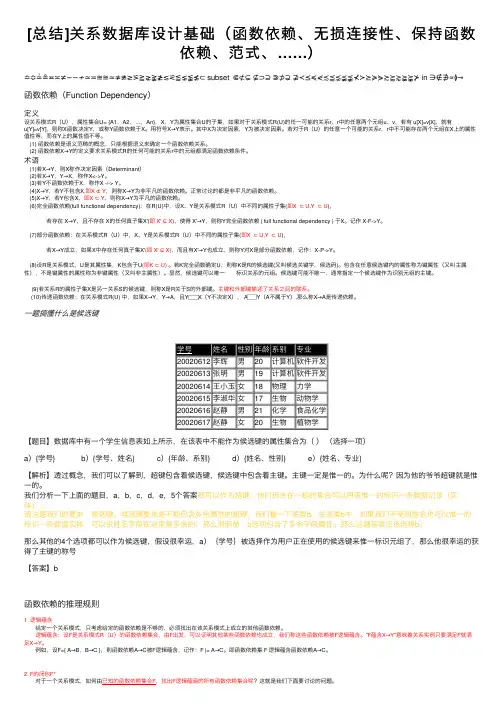
[总结]关系数据库设计基础(函数依赖、⽆损连接性、保持函数依赖、范式、……)≏≎≟≗≖≍≭∼∽≁≃≂≅≊≈≉≇≳⪞⪆⋧⪊≵≲⪝⪅⋦⪉≴⊂ subset ⋐⊄⊊ ⊈⊃⊇ ⋑⊅⊋ ⊉≺⪯≼⋞≾⪷⋨⪵⪹⊀≻⪰≽⋟≿⪸⋩⪶⪺⊁ in ∋∉∌∝≬⊸函数依赖(Function Dependency)定义设关系模式R(U),属性集合U= {A1,A2,…,An},X,Y为属性集合U的⼦集,如果对于关系模式R(U)的任⼀可能的关系r,r中的任意两个元组u、v,若有 u[X]=v[X],就有u[Y]=v[Y],则称X函数决定Y,或称Y函数依赖于X。
⽤符号X→Y表⽰。
其中X为决定因素,Y为被决定因素。
若对于R(U)的任意⼀个可能的关系r,r中不可能存在两个元组在X上的属性值性等,⽽在Y上的属性值不等。
(1) 函数依赖是语义范畴的概念,只能根据语义来确定⼀个函数依赖关系。
(2) 函数依赖X→Y的定义要求关系模式R的任何可能的关系r中的元组都满⾜函数依赖条件。
术语 (1)若X→Y,则X称作决定因素(Determinant) (2)若X→Y,Y→X,称作X<->Y。
(3)若Y不函数依赖于X,称作X -/-> Y。
(4)X→Y,若Y不包含X,即X ⊄ Y,则称X→Y为⾮平凡的函数依赖。
正常讨论的都是⾮平凡的函数依赖。
(5)X→Y,若Y包含X,即X ⊂ Y,则称X→Y为平凡的函数依赖。
(6)完全函数依赖(full functional dependency):在R(U)中,设X、Y是关系模式R(U)中不同的属性⼦集(即X ⊂ U,Y ⊂ U), 若存在 X→Y,且不存在 X的任何真⼦集X'(即 X' ⊊ X),使得 X'→Y,则称Y完全函数依赖 ( full functional dependency ) 于X。
记作 X-F->Y。
(7)部分函数依赖:在关系模式R(U)中,X、Y是关系模式R(U)中不同的属性⼦集(即X ⊂ U,Y ⊂ U), 若X→Y成⽴,如果X中存在任何真⼦集X'(即 X' ⊊ X),⽽且有X'→Y也成⽴,则称Y对X是部分函数依赖,记作:X-P->Y。
关系模式分解的无损连接和保持函数依赖

关系模式分解的无损连接和保持函数依赖一、引言关系模式是关系数据库中的核心元素之一,它描述了数据的结构和关系。
在设计关系数据库时,我们常常需要对关系模式进行分解,以满足数据库的需求。
本文将讨论关系模式分解的无损连接和保持函数依赖的相关概念和方法。
二、关系模式分解关系模式分解是将一个关系模式拆分成多个较小的关系模式的过程。
在分解关系模式时,我们需要考虑两个重要的性质:无损连接和保持函数依赖。
2.1 无损连接无损连接是指在关系模式分解后,通过对分解后的关系进行连接操作能够恢复原始关系模式。
换句话说,无损连接要求分解后的关系能够完整地保留原始关系中的所有信息。
2.2 保持函数依赖保持函数依赖是指在关系模式分解后,分解后的关系中依然能够保持原始关系中的函数依赖关系。
函数依赖是指一个属性或者属性集合的值决定了另一个属性或者属性集合的值。
三、关系模式分解的方法关系模式分解有多种方法,下面介绍三种常用的方法:自然连接、垂直分解和水平分解。
3.1 自然连接自然连接是指通过公共属性将两个或多个关系模式进行连接,得到一个具有完整信息的新关系模式。
自然连接的特点是能够保持原始关系中的所有信息和函数依赖。
3.2 垂直分解垂直分解是指根据属性集合的划分,将一个关系模式分解成多个关系模式。
垂直分解的优点是能够消除冗余数据,提高查询效率。
但是需要注意的是,垂直分解可能会造成关系丢失或信息损失。
3.3 水平分解水平分解是指将一个关系模式的元组进行水平划分,得到多个关系模式。
水平分解的特点是能够提高并发性能和容错性。
但是需要注意的是,水平分解可能会造成查询的复杂性增加和数据的分布不均衡。
四、关系模式分解的应用关系模式分解在实际的数据库设计中有着广泛的应用。
下面介绍两个例子以说明关系模式分解的应用。
4.1 学生课程关系考虑一个学生选课系统,其中包含学生和课程两个关系模式。
学生关系模式包括学生ID、姓名和年龄等属性,课程关系模式包括课程ID、课程名称和教师名称等属性。
关系模式无损及保持函数依赖的判定

关系模式无损及保持函数依赖的判定在数据库的世界里,有一门课非常重要,听起来复杂,其实一旦了解了,就像喝水一样简单。
这门课就是关于关系模式无损及保持函数依赖的判定。
说实话,乍一听这名字,很多人都会觉得有点绕。
但是,咱们可以轻松搞定这事儿。
想象一下你家里的冰箱。
里面各种各样的食材,鱼、肉、蔬菜,真是五花八门。
每次打开冰箱门,看到那些东东,你就知道要做什么了。
可是,如果这些食材全乱七八糟地放在一起,那可就糟了,找个东西就得翻半天。
关系模式就有点像这个冰箱,食材(数据)得好好分门别类。
无损性在这里就相当于我们把冰箱整理得井井有条,随取随用,不会出错。
比如,牛肉和鸡肉放在一起,那你一不小心把牛肉用错了,哎呀,可就麻烦了。
再说说保持函数依赖,这就像家里的规矩。
比如,家里规定:晚饭前不可以玩手机。
这样一来,大家都得遵守这个规矩,才能和谐相处。
在数据库中,函数依赖就是指某些数据项之间的关系。
如果有一个函数依赖存在,就意味着一个数据项的值决定了另一个数据项的值。
比如,学生的学号决定了他的姓名,学号就是那个“规矩”,保证大家都能遵循。
咱们可不能随便乱来,要保持这些依赖关系,才能让数据的完整性得到保障。
再回到关系模式无损的事情上。
无损分解就像咱们把冰箱里的食材分类,保证每种食材都能用得上。
比如,先把鱼和肉分开,再把鸡蛋和蔬菜放在一边,这样无论你想做什么,都能很方便地找到需要的食材。
如果分解得不好,可能一分开,整个菜都做不好了。
要是你把肉和蔬菜分开,但在某个地方漏掉了牛肉,那你就可能做不出你想要的红烧肉了。
无损性就像是保证了这个分解过程的有效性,确保你分开了,但是每样东西还在,没丢。
这里再给大家讲一个小故事。
前几天我去朋友家做客,看到他家冰箱简直乱得像个战场,啧啧,根本找不到东西。
后来他跟我说,最近工作太忙,没时间整理。
于是,我就给他提议,不如一起分类一下,把常用的东西放在最上面,少用的放在下面。
你猜怎么着?他真的开始整理了,整理完之后,连我都觉得轻松多了。
数据库保持函数依赖的分解

2NG
a1
a2
a3
思考:不保持函数依赖的 分解会导致什么问题?
例: 分, G ) 职工工号 工资级别 工资数目 R上的FD集为: F= { N→S, /* 每个职工只有一个工资级别 */ S →G /* 一个工资级别只有一个工资数目*/ } 将R分解为:ρ ={ NS, SG }, ρ保持依赖?无损分解? 解:PNS(F)={N→S}, PSG(F)={S→G}。 因为PNS(F)∪PSG(F)= F, 所以ρ保持函数依赖; 也是无损分解:
1A 1AB 2AC a1 a1 2B a2 b22 3C b13 a3
例: 分解是否保持FD集,是否无损分解
设有关系模式:R(ABC), R上的FD集为: F= { C→B, B→A } 将R分解为:ρ ={ AB, AC }, ρ保持依赖?无损分解? 解:PAB(F)={B→A}, PAC(F)={C→A}。 ρ不保持依赖(丢失C→B) ; 也是损失分解:
问题:如何在保证无损和保持依赖的前提下,使分解所 得的关系模式集符合尽可能高的范式? 目前有三个算法: 1. 保持依赖且无损地分解成3NF关系模式集 2. 无损地分解成BCNF关系模式集 3. 无损地分解成4NF关系模式集(超出课程范围, 不讲)
则称分解ρ保持函数依赖集F。
两个函数依赖集F和G是等价的,当且仅当:
1) 凡是能够由F推出的FD都能够由G推出; 2) 凡是不能由F推出的FD也不能由G推出。
例: 分解是否保持FD集,是否无损分解
设有关系模式:R( N, S, G ) 职工工号 工资级别 工资数目 R上的FD集为: F= { N→S, /* 每个职工只有一个工资级别 */ S →G /* 一个工资级别只有一个工资数目*/ } 将R分解为:ρ ={ NS, NG }, ρ保持依赖?无损分解? 解:PNS(F)={N→S}, PNG(F)={N→G}。 因为根据N→S和N→G推不出S →G, 所以ρ不保持 函数依赖; 但是是无损分解:
规范化无损分解及保持函数依赖

AB BC CD
a1
a2
b13 a3 a3
b14 b24 a4
b 21 a 2 b31 b32
无损分解的测试方法
(2)把表格看成模式R的一个关系,反复检查F中每个FD在表格中是否成立, 若不成立,则修改表格中的值。修改方法如下: 对于F中一个FD X Y ,如果表格中有两行在X值上相等,在Y值上不相等, ai 那么把这两行在Y值上也改成相等的值。如果Y值中有一个是 ,那么另一 aj aj bij 个也改成 ;如果没有 ,那么用其中一个 替换另一个值(尽量把下标 ij改成较小的数)。一直到表格不能修改为止。 (3)若修改的最后一张表格中有一行全 是a,即 a1a 2 a n ,那么称ρ 相对于F 是无损分解,否则称有损分解。 A B C D
分解成3NF模式集既无损 又保持函数依赖的方法
① 对于关系模式R和R上成立的FD集F,先求出F的最小依赖集,然后再把最小依 赖集中那些左部相同的FD用合并性合并起来。 ② 对最小依赖集中每个FD X→Y去构成一个模式XY。 ③ 在构成的模式集中,如果每个模式都不包含R的候选键,那么把候选键作为一 个模式放入模式集中。
保持函数依赖的模式分解
设关系模式R<U,F>被分解为若干个关系模式 R1<U1,F1>,R2<U2,F2>,…,Rn<Un,Fn> (其中U=U1∪U2∪…∪Un,且不存在Ui Uj,Fi为F 在Ui上的投影),若F所逻辑蕴含的函数依赖一定
也由分解得到的某个关系模式中的函数依赖Fi所逻
辑蕴含,则称关系模式R的这个分解是保持函数依
, Rk 是R
例:设关系模式R(ABCD),R分解成 {AB, BC, CD} 。如果R上成立的函数依赖 集 F1 {B A, C D},那么ρ 相对于F 是否无损分解?如果R上成立的函数依赖集 1 F2 {A B, C D} 呢? (1)构建一张k行n列的表格,每 列对应一个属性 A j 1 j n ,每行 对应一个模式 R i 1 i K 。如 果 A j在 R i 中,那么在表格的第i行 第j列处填上符号 a j ,否则填上 bij。 A B C D
大题解题方法
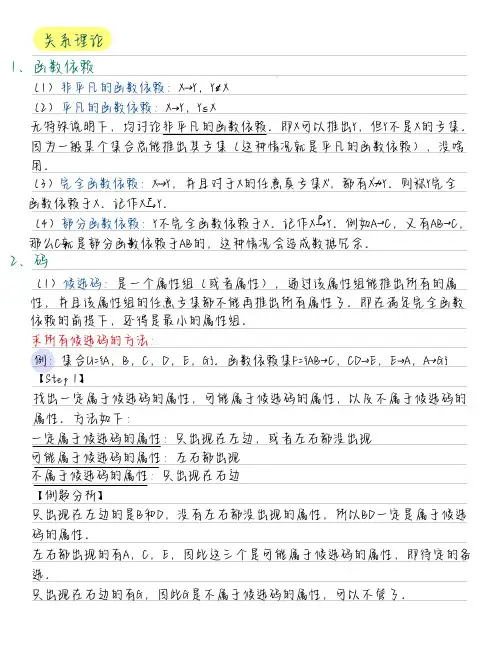
i. 2NF(没有部分函数依赖):若码是AB,F中若为(A C,AB D},对于C,只
需要A就能推出,那么C部分函数依赖于码AB,这种情况就不是2NF。 若要分解为2NF,只需将不符合要求的拿出来,即分为R {A,B,D}和R {A,C}
3NF(没有部分函数依赖与传递函数依赖):若码是AB,F若为{AB→ C,E C D.}, 这里不存在部分函数依赖。但是对于D,需要AB推出C后才能间接推出D,那么D 传递函数依赖于AB,不满足3NF。 若要分解为3N F,同样将不符合要求的拿出来,即分为R 1 {A,B,C}和R {C,D}。 BCNF(没有部分函数依赖,同时每一个决定因素都包含码): 若R是(A,B,C),F是{AC→B,AB→ C,B→ C},候选码则是AC和AB。这里不存在 部分函数依赖,但对于B→ C来说,决定因素B不包含码,因此它不是BCNF。
传递函数依赖:若X→ Y,Y→Z,且Z¢ Y,Y→X,有X→Z,此时称Z对X有传递函数 依赖。 例如在关系R中,码是客户姓名,非主属性是订单编号和订单负责人,通过客 户姓名可以推出他的订单编号,再通过订单编号能推出订单负责人,这种情 况下客户姓名和订单负责人是间接决定的,存在传递函数依赖,不满足3NF (4)BCNF:消除任何属性对候选码的传递依赖,即每一个决定因素都包含 码,表现为在函数依赖集当中,左边的都包含候选码(整个属性组!) (5)4NF(应该不考这个):不允许有非平凡且非函数依赖的多值依赖 多值依赖(个人理解,仅供参考,我觉得不会细考):X,Y,Z属于集合U, 且Z=U-X-Y。当给定一组(x,z)值的时候,可以确定一组Y的值,但这组Y的 值仅仅取决于x,此时有X→ → Y。其实这里就是存在了一对多的关系,即一个x 和一组z有关,但x并不能唯一确定一个z,通过x和z能找到一组y,但你只通过 x也能确定y。 平凡的多值依赖:Z是空集 非平凡的多值依赖:Z不是空集
关于依赖方法
A1A2A3栏目名(X)课程A6A7网站名(Y)
……………………
t1晓津专栏数据库原理计算机自考
private static ITypeMap map = MemoryTypeMap.Instance;
public T Create()
{
TypeConstructor constructor = map[typeof(T)];
if (constructor != null)
泛关系模式→数据库模式→关系数据库→表结构→关系模式实例(表)→记录(行、列.)
关系模式的存储异常:数据冗余、更新异常、插入异常和删除异常
二、函数依赖(FD)
1、函数依赖的定义(领会):设有关系模式R(A1,A2,...An)或简记为R(U),X,Y是U的子集,r是R的任一具体关系,如果对r的任意两个元组t1,t2,由t1[X]=t2[X]导致t1[Y]=t2[Y],则称X函数决定Y,或Y函数依赖于X,记为X→Y。X→Y为模式R的一个函数依赖。
1. 依赖倒置原则, 例:
BUTTON -》 LAMP 灯, 一个按钮控制灯的开关。 正常情况下我们都是BUTTON 直接调用LAMP 的开关方法, 这样存在着BUTTON 这个高层依赖于低层的LAMP , 如果当按钮需要控制其它的设备时, 将无法重用。 并且这种高层依赖于低层的策略是存在着问题的。
using System;
using System.Collections.Generic;
南京邮电大学数据库系统课后习题答案2
4.30 设有关系模式R(ABCD),其上的FD集为 ② F={AB→C,C→A,C→D}, ρ={ACD, BC} ⑤ F={A→B,B→C,C→D}, ρ={AB,AD,CD}
解② :(1)R的关键码 AB、BC (2) ρ中有R1(ACD), R2(BC)
R1∩R2=C, R1-R2=AD, 由F经合并性推理得: C→AD,ρ无损
F2={职工编号→部门名,部门名→部门经理} Key2: 职工编号, R2无部分依赖,达2NF
(3)分解成3NF R1无传递依赖,达3NF R2中:职工编号→部门经理 是传递依赖关系
将R2分解为3NF模式集 R21(职工编号,部门名) R22(部门名,部门经理 )
ρ={(职工编号,日期,日营业额), (职工编号,部门名),(部门名,部门经理)}
R2(CNO, TNAME, TADDR) } F2={CNO→TNAME,TNAME→TADDR}, KEY=(CNO) ρ中R1、R2的所有属性都是原子的,且没有非 主属性对候选键的部分函数依赖,达到2NF;
(3) 试把R分解成3NF模式集,并说明理由;
ρ={ R1(SNO, CNO, GRADE) , F1={{SNO,CNO}→GRADE}, KEY=(SNO, CNO) R21(CNO, TNAME) , F21={CNO→TNAME}, KEY=(CNO)
F={ { SNO,CNO }→GRADE , CNO→TNAME , TNAME→TADDR }
KEY={ SNO,CNO }
(2) 试把R分解成2NF模式集,并说明理由;
ρ={ R1(SNO, CNO, GRADE) , F1={{ SNO,CNO }→GRADE}, KEY=(SNO, CNO)
保持函数依赖
关于无损分解和保持依赖的判断,是系分和数工考试中每年基本上都会考的题,而且绝大部分是对一个关系模式分解成两个模式的考察,分解为三个以上模式时无损分解和保持依赖的判断比较复杂,考的可能性不大,因此我们只对“一个关系模式分解成两个模式”这种类型的题的相关判断做一个总结。
以下的论述都基于这样一个前提:R是具有函数依赖集F的关系模式,(R1 ,R2)是R的一个分解。
首先我们给出一个看似无关却非常重要的概念:属性集的闭包。
令α为一属性集。
我们称在函数依赖集F下由α函数确定的所有属性的集合为F下α的闭包,记为α+ 。
下面给出一个计算α+的算法,该算法的输入是函数依赖集F和属性集α,输出存储在变量result中。
算法一:result:=α;while(result发生变化)dofor each 函数依赖β→γ in F dobeginif β∈result then result:=result∪γ;end属性集闭包的计算有以下两个常用用途:·判断α是否为超码,通过计算α+(α在F下的闭包),看α+ 是否包含了R中的所有属性。
若是,则α为R的超码。
·通过检验是否β∈α+,来验证函数依赖是否成立。
也就是说,用属性闭包计算α+,看它是否包含β。
(请原谅我用∈符号来表示两个集合之间的包含关系,那个表示包含的符号我找不到,大家知道是什么意思就行了。
)看一个例子吧,2005年11月系分上午37题:● 给定关系R(A1,A2,A3,A4)上的函数依赖集F={A1→A2,A3→A2,A2→A3,A2→A4},R的候选关键字为________。
(37)A. A1 B. A1A3 C. A1A3A4 D. A1A2A3首先我们按照上面的算法计算A1+ 。
result=A1,由于A1→A2,A1∈result,所以result=result∪A2=A1A2由于A2→A3,A2∈result,所以result=result∪A3=A1A2A3由于A2→A4,A2∈result,所以result=result∪A3=A1A2A3A4由于A3→A2,A3∈result,所以result=result∪A2=A1A2A3A4通过计算我们看到,A1+ =result={A1A2A3A4},所以A1是R的超码,理所当然是R的候选关键字。
关系模式分解的无损连接和保持函数依赖
关系模式分解的无损连接和保持函数依赖一、关系模式分解的概念关系模式分解是指将一个复杂的关系模式分解为若干个简单的关系模式的过程。
在实际应用中,由于某些原因(如性能、数据冗余等),需要将一个大型的关系模式分解成多个小型的关系模式,从而提高数据库系统的效率和可维护性。
二、无损连接和保持函数依赖在进行关系模式分解时,有两种重要的约束条件:无损连接和保持函数依赖。
无损连接是指在进行关系模式分解后,仍然能够通过连接操作得到原始数据集合。
保持函数依赖是指在进行关系模式分解后,仍然能够维护原始数据集合中所有函数依赖。
三、无损连接和保持函数依赖的定义1. 无损连接假设R是一个关系模式,R1和R2是R的两个投影。
如果存在一个连接操作J(R1,R2),使得J(R1,R2)中包含了所有R中元组,则称R1和R2对于R具有无损连接。
2. 保持函数依赖假设R是一个关系模式,F是R上的一组函数依赖集合。
如果对于F中任何一个函数依赖X→Y,都存在一个关系模式R1和R2,使得R=R1⋈R2,且X和Y分别属于R1和R2的属性集合,则称关系模式分解后,仍然能够维护原始数据集合中所有函数依赖。
四、无损连接和保持函数依赖的算法在进行关系模式分解时,需要考虑如何保证无损连接和保持函数依赖。
以下是两种常用的算法。
1. 剖析算法剖析算法是一种自顶向下的分解方法。
该方法首先将原始关系模式拆分成两个投影,并检查它们是否具有无损连接。
如果没有,则再次拆分,并重复该过程直到满足无损连接为止。
剖析算法的优点是简单易懂,容易实现。
但是缺点也很明显,即可能会产生大量冗余数据。
2. 合成算法合成算法是一种自底向上的分解方法。
该方法首先将原始关系模式拆分为多个小型关系模式,并检查它们是否能够维护原始数据集合中所有函数依赖。
如果不能,则将两个小型关系模式合并,并重复该过程直到满足保持函数依赖为止。
合成算法的优点是能够保证数据的最小化,减少数据冗余。
但是缺点也很明显,即实现难度较大。