
Hadoop云计算平台搭建最详细过程(共22页)
Hadoop云计算平台及相关组件搭建安装过程详细教程 ——Hbase+Pig+Hive+Zookeeper+Ganglia+Chukwa+Eclipse等 一.安装环境简介 根据官网,Hadoop已在linux主机组成的集群系统上得到验证,而windows平台是作为开发平台支持的,由于分布式操作尚未在windows平台上充分测试,所以还不作为一个生产平台。Windows下还需要安装Cygwin,Cygwin是在windows平台上运行的UNIX模拟环境,提供上述软件之外的shell支持。 实际条件下在windows系统下进行Hadoop伪分布式安装时,出现了许多未知问题。在linux系统下安装,以伪分布式进行测试,然后再进行完全分布式的实验环境部署。Hadoop完全分布模式的网络拓补图如图六所示: (1) 网络拓补图如六所示:
图六 完全分布式网络拓补图 (2) 硬件要求:搭建完全分布式环境需要若干计算机集群,Master和Slaves 处理器、内存、硬盘等参数要求根据情况而定。 (3) 软件要求 操作系统64位Ubuntu12.04.4 JDK版本:jdk-7u51-linux-x64.tar.gz NO. Project Version Content 1 Hardware environment CPU: Intel 2.00 GHz Disk : 150GB Memory: 2.00GB Master/NameNode IP:192.168.100.90 Slave1/DataNode IP:192.168.100.105 Slave2/DataNode IP:192.168.100.106 2 Operation system Ubuntu-12.04 64-bit
3 JDK jdk-7u51-linux-x64.tar.gz /usr/bin/jvm/jdk1.7.0_51 4 Hadoop hadoop-1.2.1.tar.gz /home/majiangbo/hadoop-1.2.1 5 Zookeeper zookeeper-3.4.6.tar.gz /home/majiangbo/hadoop-1.2.1/zookeeper-3.4.6 6 HBase Hbase-0.94.20.tar.gz /home/majiangbo/hadoop-1.2.1/hbase-0.94.20
7 Pig pig-0.12.0.tat.gz /home/majiangbo/hadoop-1.2.1/pig-0.12.0 8 Hive hive-0.12.0.tar.gz /home/majiangbo/hadoop-1.2.1/hive-0.12.0 9 Ganglia /home/majiangbo/hadoop-1.2.1/ 10 Eclipse Eclipse standard 4.3.2 /home/majiangbo/eclipse 11 Hadoop for eclipse plugin Hadoop-eclipse-plugin-1.2.1.jar /home/majiangbo/eclipse/plugins
12 Chukwa (可选)
并且所有机器均需配置SSH免密码登录。 二. Hadoop集群安装部署 目前,这里只搭建了一个由三台机器组成的小集群,在一个hadoop集群中有以下角色:Master和Slave、JobTracker和TaskTracker、NameNode和DataNode。下面为这三台机器分配IP地址以及相应的角色: 192.168.100.90——master,namenode,jobtracker——master(主机名) 192.168.100.105——slave,datanode,tasktracker——slave1(主机名) 192.168.100.106——slave,datanode,tasktracker——slave2(主机名) 实验环境搭建平台如图七所示: 图七 hadoop集群实验平台 并且,Hadoop要求集群上每台的用户账户名和密码相同。具体安装步骤如下: 1. 下载和安装JDK,版本为jdk-7u51-linux-x64.tar.gz (1) JDK的安装目录为/usr/lib/jvm,创建此文件夹,在终端输入命令: mkdir /usr/lib/jvm (2) 权限不够的话重新改下用户密码就可以了,命令: sudo passwd,之后重新输入密码。 (3) 移动jdk到/usr/lib/jvm,并解压,然后为了节省空间删除安装包。命令: mv jdk--7u51-linux-x64.tar.gz /usr/lib/jvm tar –zxvf jdk--7u51-linux-x64.tar.gz rm –rf jdk--7u51-linux-x64.tar.gz 2. 配置环境变量 在终端输入命令:sudo gedit /etc/profile 打开profile文件,在文件最下面输入如下内容,如图八所示:
图八 JAVA环境变量设置 即为: # set java environment export JAVA_HOME=/usr/lib/jvm/jdk1.7.0_51 export CLASSPATH=”.:$JAVA_HOME/lib:$CLASSPATH” export PATH=”$JAVA_HOME/:$PATH” 这一步的意义是配置环境变量,使系统可以找到jdk。 3. 验证JDK是否安装成功 (1) 输入命令:java –version,如图九所示。如果出现java版本信息,说明当前安装的jdk并未设置成ubuntu系统默认的jdk,接下来还需要手动将安装的jdk设置成系统默认的jdk。
图九 java版本信息 (2) 手动设置需输入以下命令: sudo update-alternatives –install /usr/bin/java java /usr/lib/jvm/jdk1.7.0-51/bin/java 300 sudo update-alternatives –install /usr/bin/javac javac /usr/lib/jvm/jdk1.7.0_51/javac 300 sudo update-alternatives –config java 然后输入java –version就可以看到所安装的jdk的版本信息。 4. 三台主机上分别设置/etc/hosts和/etc/hostname Hosts这个文件用于定义主机名和IP地址之间的对应关系,而hostname这个文件用于定义你的Ubuntu的主机名。 (1) 修改/etc/hosts,命令sudo gedit /etc/hosts 127.0.0.1 localhost 192.168.100.90 master 192.168.100.105 slave1 192.168.100.106 slave2 (2) 修改/etc/hostname,命令 sudo gedit /etc/hostname(修改完重启有效) master 以及slave1 ,slave2 5. 在这两台主机上安装OpenSSH,并配置SSH可以免密码登录 (1) 确认已经连接上网,输入命令: sudo apt-get install ssh (2) 配置为可以免密码登录本机,接下来输入命令: ssh-keygen –t dsa –P ‘’ –f ~/.ssh/id_dsa 解释一下,ssh-keygen 代表生成密匙,-t表示指定生成的密匙类型,dsa是密匙认证的意思,即密匙类型,-P用于提供密语,-f指定生成的密匙文件。这个命令会在.ssh文件夹下创建id_dsa以及id_dsa.pub两个文件,这是ssh一对私匙和公匙,把id_dsa.pub追加到授权的key中。输入命令: cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys (3) 验证ssh是否已经安装成功,输入命令:ssh –version。 将文件复制到slave主机相同的文件夹内,输入命令: scp authorized_keys slave1:~/.ssh/ scp authorized_keys slave2:~/.ssh/ (4) 看是否可以从master主机免密码登录slave,输入命令: ssh slave1 ssh slave2 6. 配置两台主机的Hadoop文件 首先到Hadoop的官网下载hadoop-1.2.1.tar.gz包,默认讲Hadoop解压到 /home/u(你的Ubuntu用户名)/ 目录下 (1) 进入hadoop内的conf文件夹,找到hadoop-env.sh,修改: export JAVA_HOME=/usr/lib/jvm/jdk1.7.0_51,指定JDK的安装位置,如图十所示: 图十 JAVA_HOME 路径设置 (2) 修改core-site.xml,这是Hadoop的核心配置文件,这里配置的是HDFS的地址及端号:
fs.default.name hdfs://master:9000 hadoop.tmp.dir /tmp (3) 修改hdfs-site.xml dfs.replication 2
Hadoop集群配置详细

Linux系统配置
7安装JDK 将JDK文件解压,放到/usr/java目录下 cd /home/dhx/software/jdk mkdir /usr/java mv jdk1.6.0_45.zip /usr/java/
cd /usr/java
unzip jdk1.6.0_45.zip
从当前用户切换root用户的命令如下: 编辑主机名列表的命令
从当前用户切换root用户的命令如下:
Linux系统配置
操作步骤需要在HadoopMaster和HadoopSlave节点
上分别完整操作,都是用root用户。 从当前用户切换root用户的命令如下:
su root
从当前用户切换root用户的命令如下:
Linux系统配置
1拷贝软件包和数据包 mv ~/Desktop/software ~/
环境变量文件中,只需要配置JDK的路径
gedit conf/hadoop-env.sh
从当前用户切换root用户的命令如下: 编辑主机名列表的命令
Hadoop配置部署
3配置核心组件core-site.xml
gedit conf/core-site.xml
<configuration> <property> <name></name> /*2.0后用 fs.defaultFS代替*/ <value>hdfs://master:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/dhx/hadoopdata</value> </property> </configuration>
Hadoop环境搭建及wordcount实例运行

环境概述
虚拟平台:VirtualBox4.2.0
Linux版本:Ubuntu10.04
Hadoop版本:hadoop-0.20.2
JDK版本:1.6.0
Hadoop环境规划:一台namenode主机master,两台datanode主机salve1、slave2,master主机IP为111.111.111.2,slave1主机IP为111.111.111.3,slave2主机IP为111.111.111.4。
ssh_5.3p1-3ubuntu3_all.deb
依次安装即可
dpkg -i openssh-client_5.3p1-3ubuntu3_i386.deb
dpkg -i openssh-server_5.3p1-3ubuntu3_i386.deb
dpkg -i ssh_5.3p1-3ubuntu3_all.deb
14/02/20 15:59:58 INFO mapred.JobClient: Running job: job_201402201551_0003
14/02/20 15:59:59 INFO mapred.JobClient: map 0% reduce 0%
14/02/20 16:00:07 INFO mapred.JobClient: map 100% reduce 0%
111.111.111.2 master
111.111.111.3 slave1
111.111.111.4 slave2
然后按以下步骤配置master到slave1之间的ssh信任关系
用户@主机:/执行目录
操作命令
说明
hadoop@master:/home/hadoop
hadoop核心组件概述及hadoop集群的搭建
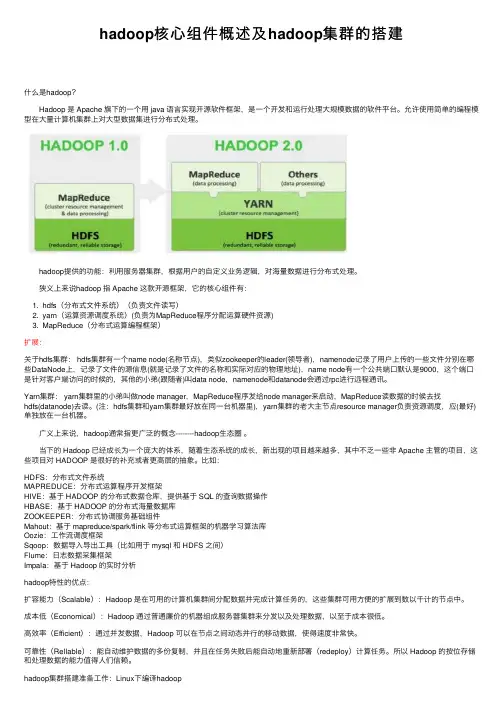
hadoop核⼼组件概述及hadoop集群的搭建什么是hadoop? Hadoop 是 Apache 旗下的⼀个⽤ java 语⾔实现开源软件框架,是⼀个开发和运⾏处理⼤规模数据的软件平台。
允许使⽤简单的编程模型在⼤量计算机集群上对⼤型数据集进⾏分布式处理。
hadoop提供的功能:利⽤服务器集群,根据⽤户的⾃定义业务逻辑,对海量数据进⾏分布式处理。
狭义上来说hadoop 指 Apache 这款开源框架,它的核⼼组件有:1. hdfs(分布式⽂件系统)(负责⽂件读写)2. yarn(运算资源调度系统)(负责为MapReduce程序分配运算硬件资源)3. MapReduce(分布式运算编程框架)扩展:关于hdfs集群: hdfs集群有⼀个name node(名称节点),类似zookeeper的leader(领导者),namenode记录了⽤户上传的⼀些⽂件分别在哪些DataNode上,记录了⽂件的源信息(就是记录了⽂件的名称和实际对应的物理地址),name node有⼀个公共端⼝默认是9000,这个端⼝是针对客户端访问的时候的,其他的⼩弟(跟随者)叫data node,namenode和datanode会通过rpc进⾏远程通讯。
Yarn集群: yarn集群⾥的⼩弟叫做node manager,MapReduce程序发给node manager来启动,MapReduce读数据的时候去找hdfs(datanode)去读。
(注:hdfs集群和yarn集群最好放在同⼀台机器⾥),yarn集群的⽼⼤主节点resource manager负责资源调度,应(最好)单独放在⼀台机器。
⼴义上来说,hadoop通常指更⼴泛的概念--------hadoop⽣态圈。
当下的 Hadoop 已经成长为⼀个庞⼤的体系,随着⽣态系统的成长,新出现的项⽬越来越多,其中不乏⼀些⾮ Apache 主管的项⽬,这些项⽬对 HADOOP 是很好的补充或者更⾼层的抽象。
Hadoop安装部署手册

1.1软件环境1)CentOS6.5x642)Jdk1.7x643)Hadoop2.6.2x644)Hbase-0.98.95)Zookeeper-3.4.61.2集群环境集群中包括 3个节点:1个Master, 2个Slave2安装前的准备2.1下载JDK2.2下载Hadoop2.3下载Zookeeper2.4下载Hbase3开始安装3.1 CentOS安装配置1)安装3台CentOS6.5x64 (使用BasicServer模式,其他使用默认配置,安装过程略)2)Master.Hadoop 配置a)配置网络修改为:保存,退出(esc+:wq+enter ),使配置生效b) 配置主机名修改为:c)配置 hosts修改为:修改为:在最后增加如下内容以上调整,需要重启系统才能生效g) 配置用户新建hadoop用户和组,设置 hadoop用户密码id_rsa.pub ,默认存储在"/home/hadoop/.ssh" 目录下。
a) 把id_rsa.pub 追加到授权的 key 里面去b) 修改.ssh 目录的权限以及 authorized_keys 的权限c) 用root 用户登录服务器修改SSH 配置文件"/etc/ssh/sshd_config"的下列内容3) Slavel.Hadoop 、Slavel.Hadoop 配置及用户密码等等操作3.2无密码登陆配置1)配置Master 无密码登录所有 Slave a)使用 hadoop 用户登陆 Master.Hadoopb)把公钥复制所有的 Slave 机器上。
使用下面的命令格式进行复制公钥2) 配置Slave 无密码登录Mastera) 使用hadoop 用户登陆Slaveb)把公钥复制Master 机器上。
使用下面的命令格式进行复制公钥id_rsa 和相同的方式配置 Slavel 和Slave2的IP 地址,主机名和 hosts 文件,新建hadoop 用户和组c) 在Master机器上将公钥追加到authorized_keys 中3.3安装JDK所有的机器上都要安装 JDK ,先在Master服务器安装,然后其他服务器按照步骤重复进行即可。
组建hadoop集群实验报告

组建hadoop集群实验报告一、实验目的本次实验的目的是通过组建Hadoop 集群,熟悉和掌握Hadoop 的部署过程和相关技术,加深对分布式计算的理解并掌握其应用。
二、实验环境- 操作系统:Ubuntu 20.04- Hadoop 版本:3.3.0- Java 版本:OpenJDK 11.0.11三、实验步骤1. 下载和安装Hadoop在官方网站下载Hadoop 的二进制文件,并解压到本地的文件夹中。
然后进行一些配置,如设置环境变量等,以确保Hadoop 可以正常运行。
2. 配置Hadoop 集群a) 修改核心配置文件在Hadoop 的配置目录中找到`core-site.xml` 文件,在其中添加以下配置:xml<configuration><property><name>fs.defaultFS</name><value>hdfs:localhost:9000</value></property></configuration>b) 修改HDFS 配置文件在配置目录中找到`hdfs-site.xml` 文件,在其中添加以下配置:xml<configuration><property><name>dfs.replication</name><value>1</value></property></configuration>c) 修改YARN 配置文件在配置目录中找到`yarn-site.xml` 文件,在其中添加以下配置:xml<configuration><property><name>yarn.resourcemanager.hostname</name><value>localhost</value></property><property><name>yarn.nodemanager.aux-services</name><value>mapreduce_shuffle</value></property><property><name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</nam e><value>org.apache.hadoop.mapred.ShuffleHandler</value></property></configuration>3. 启动Hadoop 集群在终端中执行以下命令来启动Hadoop 集群:bashstart-all.sh这将启动Hadoop 中的所有守护进程,包括NameNode、DataNode、ResourceManager 和NodeManager。
精品课件-云计算与大数据-第8章 Hadoop和Spark平台
8.2 Hadoop组成、体系结构和部署
8.2.3 Hadoop部署 3、完全分布式模式 • 完全分布式模式将构建一个Hadoop集群,实现真正的分布式。
其体系结构由两层网络拓扑组成,形成多个机架(Rack), 每个机架会有30~40台的机器,这些机器共享具有GB级别带 宽的网络交换机。 • 在配置Hadoop时,配置文件分为两类: (1) 只 读 类 型 的 默 认 文 件 : core-default.xml 、 hdfsdefault.xml、mapred-default.xml、mapred-queues.xml (2) 定 位 ( site-specific ) 设 置 : core-site.xml 、 hdfssite.xml、mapred-site.xml、mapred-queues.xml
8.2 Hadoop组成、体系结构和部署
8.2.1 Hadoop的组成 3、Flume数据收集工具 • Flume
的海量日志采集、聚合和传输的系统,Flume支持在日志系 统中定制各类数据发送方,用于收集数据;同时,Flume提 供对数据进行简单处理,并写到各种数据接受方(可定制) 的能力。
8.2 Hadoop组成、体系结构和部署 8.2.1 Hadoop的组成
8.2 Hadoop组成、体系结构和部署
8.2.1 Hadoop的组成 1、Sqoop数据库同步工具 • Sqoop项目开始于2009年,最早是作为Hadoop的一个第三方
模块存在,后来为了让使用者能够快速部署,也为了让开发 人员能够更快速的迭代开发,Sqoop独立成为一个Apache项 目。它主要用于在Hadoop与传统的数据库等之间进行数据的 传递,可以将一个关系型数据库(例如:MySQL、Oracle、 Postgres等)中的数据导入到Hadoop的HDFS中,也可以将 HDFS的数据导入到关系型数据库中。
hadoop安装以及配置启动命令
hadoop安装以及配置启动命令本次安装使⽤的Hadoop⽂件是badou学院的Hadoop1.2.1.tar.gz,以下步骤都是在此版本上进⾏。
1、安装,通过下载tar.gz⽂件安装到指定⽬录2、安装好后需要配置Hadoop集群配置信息: 在hadoop的conf路径中的masters中添加master(集群机器主的hostname)在slaves中添加集群的slave的hostname名称名称对应的是各⾃机器的hostname这样通过hosts⽂件中配置的域名地址映射可以直接找到对应的机器 a、core-site.xml 在xml⽂件中添加<property><name>hadoop.tmp.dir</name><value>/usr/local/src/hadoop.1.2.1/tmp</value></property> <property><name></name><value>hdfs://192.168.79.10:9000</value></property> c、hdfs-site.xml 在⽂件中添加<property><name>dfs.replication</name><value>3</value></property><!-- 复制节点数 --> d、hadoop-env.xml 在⽂件中添加export JAVA_HOME=/usr/local/src/jdk1.6.0_45 步骤2配置好后将当前hadoop⽂件夹复制到集群中其他机器上,只需要在对应机器上修改其对应的ip、port、jdk路径等信息即可搭建集群3、配置好Hadoop环境后需要测试环境是否可⽤: a、⾸先进⼊Hadoop的安装⽬录,进⼊bin⽬录下,先将Hadoop环境初始化,命令:./hadoop namenode -format b、初始化之后启动Hadoop,命令:./start_all.sh c、查看Hadoop根⽬录下的⽂件,命令:./hadoop fs -ls/ d、上传⽂件,命令:./hadoop fs -put ⽂件路径 e、查看⽂件内容,命令:./hadoopo fs -cat hadoop⽂件地址注意:在安装Hadoop环境时先安装好机器集群,使得⾄少3台以上(含3台)机器之间可以免密互相登录(可以查看上⼀篇的linux的ssh免密登录)执⾏Python⽂件时的部分配置/usr/local/src/hadoop-1.2.1/bin/hadoop/usr/local/src/hadoop-1.2.1/contrib/streaming/hadoop-streaming-1.2.1.jar。
云计算Hadoop运行环境的配置实验报告
以上操作的目的,是确保每台机器除了都能够使用ip地址访问到对方外,还可以通过主
注意:另外2台也要运行此命令。
)查看证书
hadooptest身份,进入hadooptest家目录的 .ssh文件夹。
(3)新建“认证文件”,在3台机器中运行如下命令,给每台机器新建“认证文件”注意:另外2台也要运行此命令。
其次,虚拟机之间交换证书,有三种拷贝并设置证书方法:
hadoops1机器里的authorized_keys也有三份证书,内容如下:hadoops2机器里的authorized_keys也有三份证书,内容如下:
) Java环境变量配置
继续以root操作,命令行中执行命令”vi m /etc/profile”,在最下面加入以下内容,
.实验体会
通过这次的实验熟悉并了Hadoop运行环境,并学会了如何使用它。
这次实验成功完成了Hadoop 集群,3个节点之间相互ping通,并可以免密码相互登陆,完成了运行环境java安装和配置。
大数据--Hadoop集群环境搭建
⼤数据--Hadoop集群环境搭建⾸先我们来认识⼀下HDFS, HDFS(Hadoop Distributed File System )Hadoop分布式⽂件系统。
它其实是将⼀个⼤⽂件分成若⼲块保存在不同服务器的多个节点中。
通过联⽹让⽤户感觉像是在本地⼀样查看⽂件,为了降低⽂件丢失造成的错误,它会为每个⼩⽂件复制多个副本(默认为三个),以此来实现多机器上的多⽤户分享⽂件和存储空间。
Hadoop主要包含三个模块:HDFS模块:HDFS负责⼤数据的存储,通过将⼤⽂件分块后进⾏分布式存储⽅式,突破了服务器硬盘⼤⼩的限制,解决了单台机器⽆法存储⼤⽂件的问题,HDFS是个相对独⽴的模块,可以为YARN提供服务,也可以为HBase等其他模块提供服务。
YARN模块:YARN是⼀个通⽤的资源协同和任务调度框架,是为了解决Hadoop中MapReduce⾥NameNode负载太⼤和其他问题⽽创建的⼀个框架。
YARN是个通⽤框架,不⽌可以运⾏MapReduce,还可以运⾏Spark、Storm等其他计算框架。
MapReduce模块:MapReduce是⼀个计算框架,它给出了⼀种数据处理的⽅式,即通过Map阶段、Reduce阶段来分布式地流式处理数据。
它只适⽤于⼤数据的离线处理,对实时性要求很⾼的应⽤不适⽤。
多相关信息可以参考博客:。
本节将会介绍Hadoop集群的配置,⽬标主机我们可以选择虚拟机中的多台主机或者多台阿⾥云服务器。
注意:以下所有操作都是在root⽤户下执⾏的,因此基本不会出现权限错误问题。
⼀、Vmware安装VMware虚拟机有三种⽹络模式,分别是Bridged(桥接模式)、NAT(⽹络地址转换模式)、Host-only(主机模式):桥接:选择桥接模式的话虚拟机和宿主机在⽹络上就是平级的关系,相当于连接在同⼀交换机上;NAT:NAT模式就是虚拟机要联⽹得先通过宿主机才能和外⾯进⾏通信;仅主机:虚拟机与宿主机直接连起来。
hadoop入门教程
ubuntu 下安装配置hadoop 1.0.4第一次搞hadoop,折腾我2天,功夫不负有心人,终于搞好了,现在来分享下,我的环境操作系统:wmv虚拟机中的ubuntu12.04hadoop版本:hadoop-1.0.4(听说是稳定版就下了)eclipse版本:eclipse-jee-indigo-SR2-win321.先安装好jdk,然后配置好jdk的环境变量,在这里我就不累赘了!网上多的是2.安装ssh这个也不用说了2.把hadoop-1.0.4.tar.gz拖到虚拟机中,解压,比如: /home/wys/Documents/hadoop-1.0.4/ (有的还单独建了个用户,为了舍去不必要的麻烦我都是用root用户来操作的)3.修改hadoop-1.0.4/conf 下面的core-site.xml文件,如下:<configuration><property><name></name><value>hdfs://192.168.116.128:9000</value></property><property><name>hadoop.tmp.dir</name><value>/home/wys/Documents/tmp</value></property></configuration>192.168.116.128这个是虚拟机中ubuntu的ip,听说用localhost,127.0.0.1都不行,我没试过,直接写上ip地址了tmp是预先创建的一个目录4.修改hadoop-env.sh把export JAVA_HOME=xxxxxx 这行的#号去掉,写上jdk的目录路径5.修改hdfs-site.xml如下:<configuration><property><name>dfs.replication</name><value>1</value></property><property><name>dfs.permissions</name><value>false</value></property></configuration>说明:为了以后用eclipse开发出现各种问题,就把权限关了!6.修改mapred-site.xml<configuration><property><name>mapred.job.tracker</name><value>192.168.116.128:9001</value></property></configuration>这里我也用了本机ip7.启动hadoop为了方便启动,我就把hadoop配置到了环境变量(配置完记得重启):export HADOOP_HOME=/home/wys/Documents/hadoop-1.0.4export JAVA_HOME=/home/wys/Documents/jdk1.6.0_24export JRE_HOME=$JAVA_HOME/jreexport PATH=$PATH:$HADOOP_HOME/bin把这个复制到/etc/profile 文件中HADOOP_HOME JAVA_HOME根据实际情况而定!重启之后格式化分布式文件系统:hadoop namenode -format接着启动hadoop:start-all.sh成功后会看到一下信息:starting namenode, logging to /home/wys/Documents/hadoop-1.0.4/libexec/../logs/hadoop-root-namenode-ubuntu.outlocalhost: starting datanode, logging to /home/wys/Documents/hadoop-1.0.4/libexec/../logs/hadoop-root-datanode-ubu ntu.outlocalhost: starting secondarynamenode, logging to /home/wys/Documents/hadoop-1.0.4/libexec/../logs/hadoop-root-secondarynam enode-ubuntu.outstarting jobtracker, logging to /home/wys/Documents/hadoop-1.0.4/libexec/../logs/hadoop-root-jobtracker-ubu ntu.outlocalhost: starting tasktracker, logging to /home/wys/Documents/hadoop-1.0.4/libexec/../logs/hadoop-root-tasktracker-ub untu.out现在就可以在浏览器中输入地址:http://192.168.116.128:50030http://192.168.116.128:50070均可以查看到一些信息假如这个http://192.168.116.128:50070地址无法访问是因为hadoop.tmp.dir 这个没指定文件夹至此hadoop已安装配置完成!Eclipse 连接hadoop开发程序入门前面一遍博文介绍了如何安装配置hadoop地址:/wqs1010/article/details/8486040这里就来介绍一下用eclipse如何连接hadoop开发由于我用的是虚拟机中的系统来做测试,多少有点不正确,还请谅解!1.首先要下载eclipse hadoop插件我用的是hadoop 1.0.4的版本,这里有个已经做好了的版本下载地址:hadoop-eclipse-plugin-1.0.4.jar下载下来直接把jar文件放到eclipse/plugins/文件夹中,然后重启eclipse2.之后会到看到如下图:然后设置下右边的hadoop根目录没有的话说明插件没安装成功!3.切换到Map/Reduce视图:下面有个黄色的大象:4.右击新建一个hadoop地址把红框的都填下:Location name : 这个随便写个Map/Reduce host port: 这2个是要根据conf/mapred-site.xml这个来定的DFS Master port:这个是对应你conf/core-site.xml这个文件中这个属性的值右边的Advanced parameters就不用改了!完成后再看工程视图:一步一步展开DFS Locations当出现ConnectException异常时,只要检查下你写的地址跟端口是否跟hadoop配置文件中一样即可!5.连接成功之后类似这个样子:6.新建一个MapReduce Project把\hadoop-1.0.4\src\examples\org\apache\hadoop\examples\WordCount.java复制到你的工程7.在eclipse里,创建远程目录命名为wordCount,建完之后刷新就可以看到了8.然后从本地上传一个word.txt文件word.txt内容:java c++ python cjava c++ javascripthelloworld hadoopmapreduce java hadoop hbase当出现node.SafeModeException: 异常,这时就要把hadoop安全模式关闭, 命令:hadoop dfsadmin –safemode leave9.上传之后run as WordCount.java 记得带上参数,用空格隔开这个时候会出现Exception in thread "main" java.io.IOException: Failed to set permissions of path: \tmp\hadoop-wys\mapred\staging\wys1479426331\.stagingto 0700 异常,是因为没有权限,网上说替换hadoop-core-xx.jar包中的org.apache.hadoop.fs.FileUtil.class文件,除此之外我还没找到其他的方法了!文件地址:FileUtil10.替换之后刷新工程,再次执行WordCount.java文件当控制台打印下面这些说明已经执行成功!再看DFS Locations下面会多出来一个文件夹和2个文件,打开part-r-00000文件这个就是你想要的:恭喜你,此时大功告成!。