
编译原理及实现课后习题答案
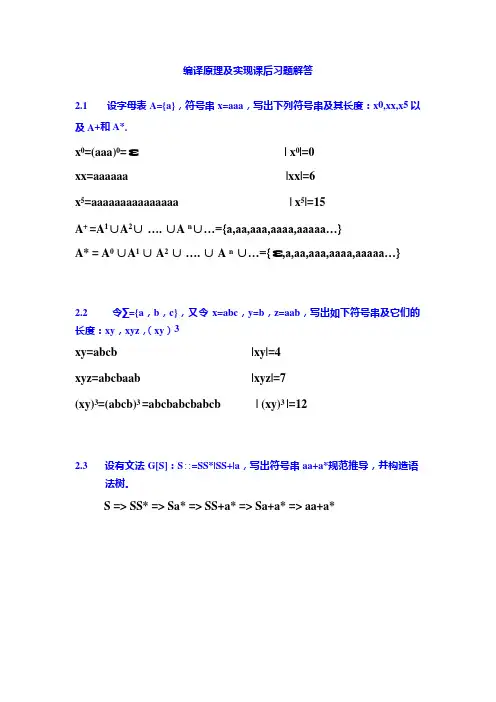
编译原理及实现课后习题解答2.1 设字母表A={a},符号串x=aaa,写出下列符号串及其长度:x0,xx,x5以及A+和A*.x0=(aaa)0=ε| x0|=0xx=aaaaaa |xx|=6x5=aaaaaaaaaaaaaaa | x5|=15A+ =A1∪A2∪…. ∪A n∪…={a,aa,aaa,aaaa,aaaaa…}A* = A0 ∪A1 ∪A2∪…. ∪ A n ∪…={ε,a,aa,aaa,aaaa,aaaaa…}2.2 令∑={a,b,c},又令x=abc,y=b,z=aab,写出如下符号串及它们的长度:xy,xyz,(xy)3xy=abcb |xy|=4xyz=abcbaab |xyz|=7(xy)3=(abcb)3 =abcbabcbabcb | (xy)3 |=122.3设有文法G[S]:S∷=SS*|SS+|a,写出符号串aa+a*规范推导,并构造语法树。
S => SS* => Sa* => SS+a* => Sa+a* => aa+a*2.4 已知文法G[Z]:Z∷=U0∣V1 、U∷=Z1∣1 、V∷=Z0∣0 ,请写出全部由此文法描述的只含有四个符号的句子。
Z=>U0=>Z10=>U010=>1010Z=>U0=>Z10=>V110=>0110Z=>V1=>Z01=>U001=>1001Z=>V1=>Z01=>V101=>01012.5 已知文法G[S]:S∷=AB A∷=aA︱εB∷=bBc︱bc , 写出该文法描述的语言。
A∷=aA︱ε描述的语言: {a n|n>=0}B∷=bBc︱bc描述的语言:{b n c n|n>=1}L(G[S])={a n b m c m|n>=0,m>=1}2.6 已知文法E∷=T∣E+T∣E-T 、T∷=F∣T*F∣T/F 、F∷=(E)∣i,写出该文法的开始符号、终结符号集合V T、非终结符号集合V N。
开始符号:EV t={+, - , * , / ,(, ), i}V n={E , F , T}2.7 对2.6题的文法,写出句型T+T*F+i 的短语、简单短语以及句柄。
短语:T+T*F+i T+T*F i i T T*F 简单短语:i T*F T 句柄:T2.8 设有文法G[S]:S ∷=S*S|S+S|(S)|a ,该文法是二义性文法吗?根据所给文法推导出句子a+a*a ,画出了两棵不同的语法树,所以该文法是二义性文法。
2.9 写一文法,使其语言是奇正整数集合。
A::=1|3|5|7|9|NA N::=0|1|2|3|4|5|6|7|8|92.10给出语言{a n b m |n,m ≥1}的文法。
G[S]: S::=AB A::=aA|aB::=bB|b3.1 有正则文法G[Z]:Z::=Ua|Vb,U::=Zb|b,V::=Za|a ,画出该文法的状态图,并检查句子abba是否合法。
解:该文法的状态图如下:句子abba合法。
3.2 状态图如图3.35所示,S为开始状态,Z为终止状态。
写出相应的正则文法以及V,V n和V t。
图3-35状态图解:左线性文法G[Z]: 右线性文法G’[S]: Z::=Ab|b S::=aA|bA::=Aa|a A::=aA|b V={Z,A,a,b} V={S,A,a,b}V n={Z,A} V n={S,A}V t={a,b} V t={a,b}3.3 构造下列正则表达式相应的NFA:1(1|0)*|01(1010*|1(010)*1)*0解:正则表达式:1(1|0)*|01、2、3、4、正则表达式:1(1010*|1(010)*1)*03.4将图3.36的NFA M确定化图3.36 状态图DFA:3.5 将图3.37的DFA 化简。
q0={0,1}q1={2,4}q2={3,5}化简后的DFA :4.1 对下面文法,设计递归下降分析程序。
S →aAS|(A) , A →Ab|c解:首先将左递归去掉,将规则A →Ab|c 改成 A →c{b} 非终结符号S 的分析程序如下:非终结符号A的分析程序如下:4.2 设有文法G[Z]:Z∷=(A) , A∷=a|Bb , B∷=Aab若采用递归下降分析方法,对此文法来说,在分析过程中,能否避免回溯?为什么?解:若采用递归下降分析方法,对此文法来说,在分析过程中不能避免回朔。
因为规则A∷=a|Bb和规则B∷=Aab构成了间接左递归,不满足实现没有回溯的递归下降分析方法的条件(1)(书P67),且规则A: := a|Bb,FIRST(a)={a},FIRST(Bb)={a},即此规则候选式的首符号集有相交,不满足实现没有回溯的递归下降分析方法的条件(2)(书P67),在分析过程中,将造成回溯。
改写文法可避免回溯:将规则B∷=Aab代入规则A∷=a|Bb得:A∷=a|Aabb,再转换成:A∷=a{abb},可避免回溯。
4.3 若有文法如下,设计递归下降分析程序。
<语句>→<语句><赋值语句>|ε<赋值语句>→ID=<表达式><表达式>→<项>|<表达式>+<项>|<表达式>-<项><项>→<因子>|<项>*<因子>|<项>/<因子><因子>→ID|NUM|(<表达式>)解:首先,去掉左递归<语句>→<语句><赋值语句>|ε改为:<语句>→{<赋值语句>}<表达式>→<项> | <表达式> + <项> | <表达式> - <项>改为:<表达式>→<项>{(+ | -)<项>}<项>→<因子> | <项> * <因子> | <项> / <因子>改为:<项>→<因子>{(* | /)<因子>}则文法变为:<语句>→{<赋值语句>}<赋值语句>→ID=<表达式><表达式>→<项>{(+ | -)<项>}<项>→<因子>{(* | /)<因子>}<因子>→ID|NUM|(<表达式>)非终结符号<赋值语句> 的分析程序如下:非终结符号<表达式> 的分析程序如下:非终结符号 <项> 的分析程序如下:非终结符号 <因子> 的分析程序如下:复值语句的分析程序4.4 有文法G[A]:A::=aABe|ε,B::=Bb|b(1)求每个非终结符号的FOLLOW集。
(2)该文法是LL(1)文法吗?(3)构造LL(1)分析表。
解:(1)FOLLOW(A)=First(B)∪{#}={b,#}FOLLOW(B)={e,b}(2)该文法中的规则B::=Bb|b为左递归,因此该文法不是LL(1)文法(3)先消除文法的左递归(转成右递归),文法变为:A::=aABe|ε,B::=bB’,B’::=bB’|ε,该文法的LL(1)分析表为:4.5 若有文法A→(A)A|ε(1)为非终结符A构造FIRST集合和FOLLOW集合。
(2)说明该文法是LL(1)的文法。
解:(1)FIRST(A)={(,ε}FOLLOW(A)={),#}(2)该文法不含左递归;FIRST((A)A)={(},FIRST(ε)={ε},FIRST((A)A)∩FIRST(ε)=Φ,且FOLLOW(A)={),#},FIRST((A)A)∩FOLLOW(A) =Φ,因此,该文法满足LL(1)文法的条件,是LL(1)文法。
4.6 利用分析表4-1,识别以下算术表达式,请写出分析过程。
(1)i+i*i+i(2)i*(i+i+i)解:(1)i+i*i+i4.7 考虑下面简化了的C声明文法:<声明语句>→<类型><变量表>;<类型>→int|float|char<变量表>→ID,<变量表>|ID(1)在该文法中提取左因子。
(2)为所得的文法的非终结符构造FIRST集合和FOLLOW集合。
(3)说明所得的文法是LL(1)文法。
(4)为所得的文法构造LL(1)分析表。
(5)假设有输入串为“char x,y,z;”,写出相对应的LL(1)分析过程。
解:(1)规则<变量表>→ID,<变量表>|ID提取公因子如下:<变量表>→ID(,<变量表>|ε)增加新的非终结符<变量表1>,规则变为:<变量表>→ID<变量表1><变量表1>→,<变量表>|εC声明文法改变为:<声明语句>→<类型><变量表>;<类型>→int|float|char<变量表>→ID<变量表1><变量表1>→,<变量表>|ε(2)FIRST(<声明语句>)=FIRST(<类型>)={int,float,char}FIRST(<变量表>)={ID}FIRST(<变量表1>)={,,ε}FOLLOW(<声明语句>)={#}FOLLOW(<类型>)=FIRST(<变量表>)={ID}FOLLOW(<变量表>)=FOLLOW(<变量表1>)={;}(3)所得文法无左递归,且FIRST(int)∩FIRST(float)∩FIRST(char)=ΦFIRST(,<变量表>)∩FIRST(ε)=ΦFIRST(,<变量表>)∩FOLLOW(<变量表1>)=Φ因此,所得文法为LL(1)文法。
(5)输入串“char x,y,z;”相对应的LL(1)分析过程如下:5.1 考虑以下的文法:S→S;T|TT→a(1)为这个文法构造LR(0)的项目集规范族。
(2)这个文法是不是LR(0)文法?如果是,则构造LR(0)分析表。
(完整版)编译原理及实现课后习题答案
编译原理及实现课后习题解答2.1设字母表A={a},符号串x=aaa,写出下列符号串及其长度:x0,xx,x5 以及A+和A*.x0=(aaa)0=ε| x0|=0xx=aaaaaa |xx|=6x5=aaaaaaaaaaaaaaa | x5|=15A+ =A1∪A2∪ …. ∪A n∪…={a,aa,aaa,aaaa,aaaaa…}A* = A0 ∪A1 ∪A2 ∪…. ∪A n ∪…={ε,a,aa,aaa,aaaa,aaaaa…}2.2令∑={a,b,c},又令x=abc,y=b,z=aab,写出如下符号串及它们的长度:xy,xyz,(xy)3xy=abcb |xy|=4xyz=abcbaab |xyz|=7(xy)3=(abcb)3 =abcbabcbabcb | (xy)3 |=122.3设有文法G[S]:S∷=SS*|SS+|a,写出符号串aa+a*规范推导,并构造语法树。
S => SS* => Sa* => SS+a* => Sa+a* => aa+a*SS S *S S + aa a2.4 已知文法G[Z]:Z∷=U0∣V1 、U∷=Z1∣1 、V∷=Z0∣0 ,请写出全部由此文法描述的只含有四个符号的句子。
Z=>U0=>Z10=>U010=>1010Z=>U0=>Z10=>V110=>0110Z=>V1=>Z01=>U001=>1001Z=>V1=>Z01=>V101=>01012.5已知文法G[S]:S∷=AB A∷=aA︱εB∷=bBc︱bc , 写出该文法描述的语言。
A∷=aA︱ε描述的语言: {a n|n>=0}B∷=bBc︱bc 描述的语言:{b n c n|n>=1}L(G[S])={a n b m c m|n>=0,m>=1}2.6已知文法E∷=T∣E+T∣E-T 、T∷=F∣T*F∣T/F 、F∷=(E)∣i,写出该文法的开始符号、终结符号集合V T、非终结符号集合V N。
编译原理课后习题答案+清华大学出版社第二版
用以引用非局部(包围它的过程)变量时,寻找该变量的地址。 DL: 动态链,指向调用该过程前正在运行过程的数据段基地址,用以过程执行结束释放
数据空间时,恢复调用该过程前运行栈的状态。 RA: 返回地址,记录调用该过程时目标程序的断点,即调用过程指令的下一条指令的地
编译程序大致有哪几种开发技术?
答案:
(1)自编译:用某一高级语言书写其本身的编译程序。 (2)交叉编译:A 机器上的编译程序能产生 B 机器上的目标代码。 (3)自展:首先确定一个非常简单的核心语言 L0,用机器语言或汇编语言书写出它的编
译程序 T0,再把语言 L0 扩充到 L1,此时 L0⊂ L1 ,并用 L0 编写 L1 的编译程序 T1,再把语 言 L1 扩充为 L2,有 L1 ⊂ L2 ,并用 L1 编写 L2 的编译程序 T2,……,如此逐步扩展下 去, 好似滚雪球一样,直到我们所要求的编译程序。 (4)移植:将 A 机器上的某高级语言的编译程序搬到 B 机器上运行。
(main).
答案: 程序执行到赋值语句 b∶=10 时运行栈的布局示意图为:
1
《编译原理》课后习题答案第二章
第 3题 写出题 2 中当程序编译到 r 的过程体时的名字表 table 的内 容。
name
kind
level/val
adr
size
答案:
题 2 中当程序编译到 r 的过程体时的名字表 table 的内容为:
盛威网()专业的计算机学习网站
2
《编译原理》课后习题答案第一章
合实现方案,即先把源程序翻译成较容易解释执行的某种中间代码程序,然后集中解释执行 中间代码程序,最后得到运行结果。
编译原理第二版课后习答案

《编译原理》课后习题答案第一章第 1 章引论第 1 题解释下列术语:(1)编译程序(2)源程序(3)目标程序(4)编译程序的前端(5)后端(6)遍答案:(1)编译程序:如果源语言为高级语言,目标语言为某台计算机上的汇编语言或机器语言,则此翻译程序称为编译程序。
(2)源程序:源语言编写的程序称为源程序。
(3)目标程序:目标语言书写的程序称为目标程序。
(4)编译程序的前端:它由这样一些阶段组成:这些阶段的工作主要依赖于源语言而与目标机无关。
通常前端包括词法分析、语法分析、语义分析和中间代码生成这些阶段,某些优化工作也可在前端做,也包括与前端每个阶段相关的出错处理工作和符号表管理等工作。
(5)后端:指那些依赖于目标机而一般不依赖源语言,只与中间代码有关的那些阶段,即目标代码生成,以及相关出错处理和符号表操作。
(6)遍:是对源程序或其等价的中间语言程序从头到尾扫视并完成规定任务的过程。
第 2 题一个典型的编译程序通常由哪些部分组成?各部分的主要功能是什么?并画出编译程序的总体结构图。
答案:一个典型的编译程序通常包含 8 个组成部分,它们是词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、中间代码优化程序、目标代码生成程序、表格管理程序和错误处理程序。
其各部分的主要功能简述如下。
词法分析程序:输人源程序,拼单词、检查单词和分析单词,输出单词的机内表达形式。
语法分析程序:检查源程序中存在的形式语法错误,输出错误处理信息。
语义分析程序:进行语义检查和分析语义信息,并把分析的结果保存到各类语义信息表中。
中间代码生成程序:按照语义规则,将语法分析程序分析出的语法单位转换成一定形式的中间语言代码,如三元式或四元式。
中间代码优化程序:为了产生高质量的目标代码,对中间代码进行等价变换处理。
目标代码生成程序:将优化后的中间代码程序转换成目标代码程序。
表格管理程序:负责建立、填写和查找等一系列表格工作。
表格的作用是记录源程序的各类信息和编译各阶段的进展情况,编译的每个阶段所需信息多数都从表格中读取,产生的中间结果都记录在相应的表格中。
编译原理及实现课后答案
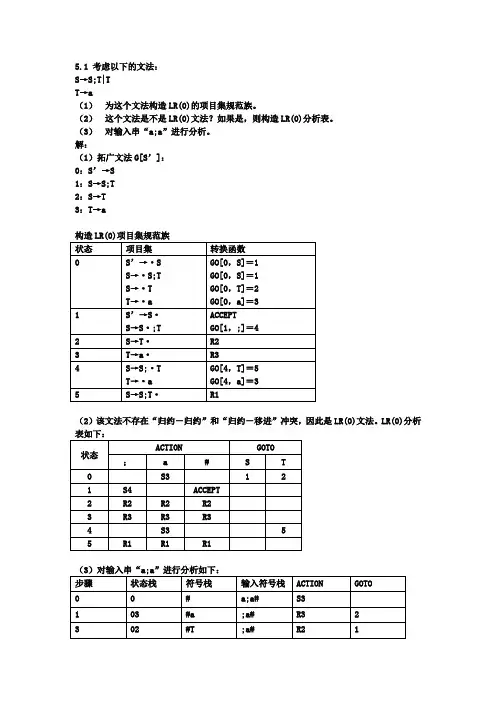
5.1 考虑以下的文法:S→S;T|TT→a(1)为这个文法构造LR(0)的项目集规范族。
(2)这个文法是不是LR(0)文法?如果是,则构造LR(0)分析表。
(3)对输入串“a;a”进行分析。
解:(1)拓广文法G[S’]:0:S’→S1:S→S;T2:S→T3:T→a构造LR(0)项目集规范族(2)该文法不存在“归约-归约”和“归约-移进”冲突,因此是LR(0)文法。
LR(0)分析表如下:(3)对输入串“a;a”进行分析如下:5.2 证明下面文法是SLR(1)文法,但不是LR(0)文法。
S→AA→Ab|bBaB→aAc|a|aAb解:文法G[S]:0:S→A1:A→Ab2:A→bBa3:B→aAc4:B→a5:B→aAb状态5存在“归约-移进”冲突,状态9存在“归约-归约”冲突,因此该文法不是LR(0)文法。
状态5:FOLLOW(B)={a},因此,FOLLOW(B)∩{b}=Φ状态9:FOLLOW(B)={a},FOLLOW(A)={#,b,c},因此FOLLOW(B)∩FOLLOW(A)=Φ该SLR(1)分析表无重定义,因此该文法是SLR(1)文法,不是LR(0)文法。
5.3 证明下面文法是LR(1)文法,但不是SLR(1)文法。
S→AaAb|BbBaA→εB→ε解:拓广文法G[S’]:0:S’→S1:S→AaAb2:S→BbBa3:A→ε4:B→ε={a,b},即FOLLOW(A)∩FOLLOW(B)={a,b}≠Φ,所以该文法不是SLR(1)文法。
构造LR(1)项目集规范族:分析表无重定义,说明该文法是LR(1)文法,不是SLR(1)文法。
5.4 考虑以下的文法:E→EE+E→EE*E→a(1)为这个文法构造LR(1)项目集规范族。
(2)构造LR(1)分析表。
(3)为这个文法构造LALR(1)项目集规范族。
(4)构造LALR(1)分析表。
(5)对输入符号串“aa*a+”进行LR(1)和LALR(1)分析。
编译原理(第二版)清华大学---答案详解
第1章引论第1题解释下列术语:(1)编译程序(2)源程序(3)目标程序(4)编译程序的前端(5)后端(6)遍答案:(1) 编译程序:如果源语言为高级语言,目标语言为某台计算机上的汇编语言或机器语言,则此翻译程序称为编译程序。
(2) 源程序:源语言编写的程序称为源程序。
(3) 目标程序:目标语言书写的程序称为目标程序。
(4) 编译程序的前端:它由这样一些阶段组成:这些阶段的工作主要依赖于源语言而与目标机无关。
通常前端包括词法分析、语法分析、语义分析和中间代码生成这些阶段,某些优化工作也可在前端做,也包括与前端每个阶段相关的出错处理工作和符号表管理等工作。
(5) 后端:指那些依赖于目标机而一般不依赖源语言,只与中间代码有关的那些阶段,即目标代码生成,以及相关出错处理和符号表操作。
(6) 遍:是对源程序或其等价的中间语言程序从头到尾扫视并完成规定任务的过程。
第2题一个典型的编译程序通常由哪些部分组成?各部分的主要功能是什么?并画出编译程序的总体结构图。
答案:一个典型的编译程序通常包含8个组成部分,它们是词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、中间代码优化程序、目标代码生成程序、表格管理程序和错误处理程序。
其各部分的主要功能简述如下。
词法分析程序:输人源程序,拼单词、检查单词和分析单词,输出单词的机内表达形式。
语法分析程序:检查源程序中存在的形式语法错误,输出错误处理信息。
语义分析程序:进行语义检查和分析语义信息,并把分析的结果保存到各类语义信息表中。
中间代码生成程序:按照语义规则,将语法分析程序分析出的语法单位转换成一定形式的中间语言代码,如三元式或四元式。
中间代码优化程序:为了产生高质量的目标代码,对中间代码进行等价变换处理。
目标代码生成程序:将优化后的中间代码程序转换成目标代码程序。
表格管理程序:负责建立、填写和查找等一系列表格工作。
表格的作用是记录源程序的各类信息和编译各阶段的进展情况,编译的每个阶段所需信息多数都从表格中读取,产生的中间结果都记录在相应的表格中。
编译原理(第2版)课后习题答案详解
第1 章引论第1 题解释下列术语:(1)编译程序(2)源程序(3)目标程序(4)编译程序的前端(5)后端(6)遍答案:(1)编译程序:如果源语言为高级语言,目标语言为某台计算机上的汇编语言或机器语言,则此翻译程序称为编译程序。
(2)源程序:源语言编写的程序称为源程序。
(3)目标程序:目标语言书写的程序称为目标程序。
(4)编译程序的前端:它由这样一些阶段组成:这些阶段的工作主要依赖于源语言而与目标机无关。
通常前端包括词法分析、语法分析、语义分析和中间代码生成这些阶段,某些优化工作也可在前端做,也包括与前端每个阶段相关的出错处理工作和符号表管理等工作。
(5)后端:指那些依赖于目标机而一般不依赖源语言,只与中间代码有关的那些阶段,即目标代码生成,以及相关出错处理和符号表操作。
(6)遍:是对源程序或其等价的中间语言程序从头到尾扫视并完成规定任务的过程。
第2 题一个典型的编译程序通常由哪些部分组成?各部分的主要功能是什么?并画出编译程序的总体结构图。
答案:一个典型的编译程序通常包含8 个组成部分,它们是词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、中间代码优化程序、目标代码生成程序、表格管理程序和错误处理程序。
其各部分的主要功能简述如下。
词法分析程序:输人源程序,拼单词、检查单词和分析单词,输出单词的机内表达形式。
语法分析程序:检查源程序中存在的形式语法错误,输出错误处理信息。
语义分析程序:进行语义检查和分析语义信息,并把分析的结果保存到各类语义信息表中。
中间代码生成程序:按照语义规则,将语法分析程序分析出的语法单位转换成一定形式的中间语言代码,如三元式或四元式。
中间代码优化程序:为了产生高质量的目标代码,对中间代码进行等价变换处理。
目标代码生成程序:将优化后的中间代码程序转换成目标代码程序。
表格管理程序:负责建立、填写和查找等一系列表格工作。
表格的作用是记录源程序的各类信息和编译各阶段的进展情况,编译的每个阶段所需信息多数都从表格中读取,产生的中间结果都记录在相应的表格中。
编译原理及实践教程第1章参考答案
1.翻译程序:能够将某种语言写的程序转换成另一种语言的程序,而且后者与前者在逻辑上是等价的。
编译程序:是一种将高级语言程序(源程序)翻译成低级语言(目标程序)的程序解释程序:接受某高级语言的一个语句输入,进行解释并控制计算机执行,马上得到这句的执行结果,然后再接受下一句。
源程序:被翻译的程序。
目标程序:翻译后的程序。
遍:对源程序或源程序的中间结果从头到尾扫描一次,并作有关的加工处理,生成新的中间结果或目标程序。
编译前端:主要指与源语言有关,与目标语言无关的部分,通常包括词法分析、语法分析、语义分析和中间代码生成,与机器无关部分的代码优化编译后端:指与目标机器有关的部分。
如与机器有关的优化、目标代码生成2.高级语言程序有哪两种执行方式?其特点是什么?阐述其主要异同点。
答:高级语言程序有编译程序和解释程序两种执行方式;编译程序(Compiler)——将高级程序设计语言程序翻译成逻辑上等价的低级语言(汇编语言,机器语言)程序的翻译程序。
解释程序(Interpreter)——将高级程序设计语言写的源程序作为输入,边解释边执行源程序本身,而不产生目标程序的翻译程序。
3.编译过程可分为哪些阶段?各个阶段的主要任务是什么?答:编译过程逻辑上可分为五个阶段:词法分析、语法分析、语义分析与中间代码生成、代码优化、目标代码生成。
第一阶段:词法分析任务: 从左到右扫描源程序,识别出每个单词第二阶段:语法分析任务: 在词法分析的基础上,根据语言的语法规则,将单词符号串分解成各类语法短语(例:程序、语句、表达式)。
第三阶段:语义分析和中间代码生成任务:对语法分析所识别出的各类语法范畴分析其含义,进行初步的翻译(翻译成中间代码)。
第四阶段:代码优化任务:对已产生的中间代码进行加工变换,使生成的目标代码更为高效(时间和空间)。
第五阶段:目标代码的生成任务:把中间代码(或经优化的中间代码)变换成特定机器上的低级语言代码。
4. 编译程序有哪些主要构成成分?各自的主要功能是什么?答:(1) 记号(token)当扫描程序将字符收集到一个记号中时,它通常是以符号表示这个记号;这也就是说,作为一个枚举数据类型的值来表示源程序的记号集。
编译原理课后习题答案解析+清华大学出版社第二版
管理。(数组 CODE 存放的只读目标程序,它在运行时不改变。)运行时的数据区 S 是由解 释程序定义的一维整型数组,解释执行时对数据空间 S 的管理遵循后进先出规则,当每个 过程(包括主程序)被调用时,才分配数据空间,退出过程时,则所分配的数据空间被释放。 应用动态链和静态链的方式分别解决递归调用和非局部变量的引用问题。
RA 的用途说明如下: T: 栈顶寄存器 T 指出了当前栈中最新分配的单元(T 也是数组 S 的下标)。 B:基址寄存器,指向每个过程被调用时,在数据区 S 中给它分配的数据段起 始 地址,
也称基地址。 SL: 静态链,指向定义该过程的直接外过程(或主程序)运行时最新数据段的基地址,
用以引用非局部(包围它的过程)变量时,寻找该变量的地址。 DL: 动态链,指向调用该过程前正在运行过程的数据段基地址,用以过程执行结束释放
广义上讲,编译程序和解释程序都属于翻译程序,但它们的翻译方式不同,解释程序是 边翻译(解释)边执行,不产生目标代码,输出源程序的运行结果。而编译程序只负责把源 程序翻译成目标程序,输出与源程序等价的目标程序,而目标程序的执行任务由操作系统来 完成,即只翻译不执行。
)
第4题
对下列错误信息,请指出可能是编译的哪个阶段(词法分析、语法分析、语义分析、代 码生成)报告的。 (1) else 没有匹配的 if (2) 数组下标越界 (3) 使用的函数没有定义 (4) 在数中出现非数字字符
CAL L A 调用过程,完成填写静态链、动态链、返回地址,给出被调用过程的基地址值,送入基址 寄存器 B 中,目标程序的入口地址 A 的值送指令地址寄存器 P 中,使指令从 A 开始执 行。 第6题
编译原理课后习题答案
第一章1.典型的编译程序在逻辑功能上由哪几部分组成?答:编译程序主要由以下几个部分组成:词法分析、语法分析、语义分析、中间代码生成、中间代码优化、目标代码生成、错误处理、表格管理。
2. 实现编译程序的主要方法有哪些?答:主要有:转换法、移植法、自展法、自动生成法。
3. 将用户使用高级语言编写的程序翻译为可直接执行的机器语言程序有哪几种主要的方式?答:编译法、解释法。
4. 编译方式和解释方式的根本区别是什么?答:编译方式:是将源程序经编译得到可执行文件后,就可脱离源程序和编译程序单独执行,所以编译方式的效率高,执行速度快;解释方式:在执行时,必须源程序和解释程序同时参与才能运行,其不产生可执行程序文件,效率低,执行速度慢。
第二章1.乔姆斯基文法体系中将文法分为哪几类?文法的分类同程序设计语言的设计与实现关系如何?答:1)0型文法、1型文法、2型文法、3型文法。
2)2. 写一个文法,使其语言是偶整数的集合,每个偶整数不以0为前导。
答:Z→SME | BS→1|2|3|4|5|6|7|8|9M→ε | D | MDD→0|SB→2|4|6|8E→0|B3. 设文法G为:N→ D|NDD→ 0|1|2|3|4|5|6|7|8|9请给出句子123、301和75431的最右推导和最左推导。
答:N⇒ND⇒N3⇒ND3⇒N23⇒D23⇒123N⇒ND⇒NDD⇒DDD⇒1DD⇒12D⇒123N⇒ND⇒N1⇒ND1⇒N01⇒D01⇒301N⇒ND⇒NDD⇒DDD⇒3DD⇒30D⇒301N⇒ND⇒N1⇒ND1⇒N31⇒ND31⇒N431⇒ND431⇒N5431⇒D5431⇒75431N⇒ND⇒NDD⇒NDDD⇒NDDDD⇒DDDDD⇒7DDDD⇒75DDD⇒754DD⇒7543D⇒75431 4. 证明文法S→iSeS|iS| i是二义性文法。
答:对于句型iiSeS存在两个不同的最左推导:S⇒iSeS⇒iiSesS⇒iS⇒iiSeS所以该文法是二义性文法。
习题参考答案-编译原理及实践教程(第3版)-黄贤英-清华大学出版社
附录部分习题参考答案第1章习题1. 解释下列术语。
翻译程序,编译程序,解释程序,源程序,目标程序,遍,前端,后端解答:略!2. 高级语言程序有哪两种执行方式?阐述其主要异同点。
描述编译方式执行程序的过程。
解答:略!3. 在你所使用的C语言编译器中,观察程序1.1经过预处理、编译、汇编、链接四个过程生成的中间结果。
解答:略!4. 编译程序有哪些主要构成成分?各自的主要功能是什么?解答:略!5. 编译程序的构造需要掌握哪些原理和技术?编译程序构造工具的作用是什么?解答:略!6. 复习C语言,其字母表中有哪些符号?有哪些关键字、运算符和界符?标识符、整数和实数的构成规则是怎样的?各种语句和表达式的结构是什么样的?解答:略!7.编译技术可应用在哪些领域?解答:略!8. 你能解释在Java编译器中,输入某个符号后会提示一些单词、某些单词会变为不同的颜色是如何实现的吗?你能解释在Code Blocks中在输入{后,会自动添加},输入do 会自动添加while()是为什么吗?解答:略!第2章习题1. 判断题,对下面的陈述,正确的在陈述后的括号内画√,否则画×。
(1) 有穷自动机识别的语言是正规语言。
()(2) 若r1和r2是Σ上的正则表达式,则r1|r2也是。
()(3) 设M是一个NFA,并且L(M)={x,y,z},则M的状态数至少为4个。
()(4) 令Σ={a,b},则所有以b开头的字构成的正规集的正则表达式为b*(a|b)*。
()(5) 对任何一个NFA M,都存在一个DFA M',使得L(M')=L(M)。
()1解答:略!2.从供选择的答案中,选出应填入下面叙述中?内的最确切的解答。
有穷自动机可用五元组(Q,V T,δ,q0,Q f)来描述,设有一有穷自动机M定义如下:V T={0,1},Q={q0,q1,q2},Q f={q2},δ的定义为:δ (q0,0)=q1δ (q1,0)=q2δ (q2,1)=q2δ (q2,0)=q2M是一个 A 有穷状态自动机,它所对应的状态转换图为 B ,它所能接受的语言可以用正则表达式表示为 C 。