
Hadoop Hive sql语法详解
Hadoop Hive sql语法详解
Hive 是基于Hadoop 构建的一套数据仓库分析系统,它提供了丰富的SQL查询方式来分析存储在Hadoop 分布式文件系统中的数据,可以将结构化的数据文件映射为一张数据库表,并提供完整的SQL查询功能,可以将SQL语句转换为MapReduce任务进行运行,通过自己的SQL 去查询分析需要的内容,这套SQL 简称Hive SQL,使不熟悉mapreduce 的用户很方便的利用SQL 语言查询,汇总,分析数据。而mapreduce开发人员可以把己写的mapper 和reducer 作为插件来支持Hive 做更复杂的数据分析。
它与关系型数据库的SQL 略有不同,但支持了绝大多数的语句如DDL、DML 以及常见的聚合函数、连接查询、条件查询。HIVE不适合用于联机online)事务处理,也不提供实时查询功能。它最适合应用在基于大量不可变数据的批处理作业。
HIVE的特点:可伸缩(在Hadoop的集群上动态的添加设备),可扩展,容错,输入格式的松散耦合。
Hive 的官方文档中对查询语言有了很详细的描述,请参考:/hadoop/Hive/LanguageManual ,本文的内容大部分翻译自该页面,期间加入了一些在使用过程中需要注意到的事项。
1. DDL 操作
DDL
?建表
?删除表
?修改表结构
?创建/删除视图
?创建数据库
?显示命令
建表:
CREATE [EXTERNAL] TABLE [IF NOT EXISTS] table_name
[(col_name data_type [COMMENT col_comment], ...)]
[COMMENT table_comment]
[PARTITIONED BY (col_name data_type [COMMENT col_comment], ...)]
[CLUSTERED BY (col_name, col_name, ...)
[SORTED BY (col_name [ASC|DESC], ...)] INTO num_buckets BUCKETS]
[ROW FORMAT row_format]
[STORED AS file_format]
[LOCATION hdfs_path]
?CREATE TABLE 创建一个指定名字的表。如果相同名字的表已经存在,则抛出异常;用户可以用 IF NOT EXIST 选项来忽略这个异常
?EXTERNAL 关键字可以让用户创建一个外部表,在建表的同时指定一个指向实际数据的路径(LOCATION)
?LIKE 允许用户复制现有的表结构,但是不复制数据
?COMMENT可以为表与字段增加描述
?ROW FORMAT DELIMITED [FIELDS TERMINATED BY char] [COLLECTION ITEMS TERMINATED BY char]
[MAP KEYS TERMINATED BY char] [LINES TERMINATED BY char]
| SERDE serde_name [WITH SERDEPROPERTIES (property_name=property_value,
property_name=property_value, ...)]
用户在建表的时候可以自定义 SerDe 或者使用自带的 SerDe。如果没有指定 ROW FORMAT
或者 ROW FORMAT DELIMITED,将会使用自带的 SerDe。在建表的时候,用户还需要为表指定列,用户在指定表的列的同时也会指定自定义的 SerDe,Hive 通过 SerDe 确定表的具体的列的数据。
?STORED AS
SEQUENCEFILE
| TEXTFILE
| RCFILE
| INPUTFORMAT input_format_classname OUTPUTFORMAT output_format_classname
如果文件数据是纯文本,可以使用 STORED AS TEXTFILE。如果数据需要压缩,使用 STORED AS
SEQUENCE 。
创建简单表:
hive> CREATE TABLE pokes (foo INT, bar STRING);
创建外部表:
CREATE EXTERNAL TABLE page_view(viewTime INT, userid BIGINT,
page_url STRING, referrer_url STRING,
ip STRING COMMENT 'IP Address of the User',
country STRING COMMENT 'country of origination')
COMMENT 'This is the staging page view table'
ROW FORMAT DELIMITED FIELDS TERMINATED BY '\054'
STORED AS TEXTFILE
LOCATION '';
建分区表
CREATE TABLE par_table(viewTime INT, userid BIGINT,
page_url STRING, referrer_url STRING,
ip STRING COMMENT 'IP Address of the User')
COMMENT 'This is the page view table'
PARTITIONED BY(date STRING, pos STRING)
ROW FORMAT DELIMITED ‘\t’
FIELDS TERMINATED BY '\n'
STORED AS SEQUENCEFILE;
建Bucket表
CREATE TABLE par_table(viewTime INT, userid BIGINT,
page_url STRING, referrer_url STRING,
ip STRING COMMENT 'IP Address of the User')
COMMENT 'This is the page view table'
PARTITIONED BY(date STRING, pos STRING)
CLUSTERED BY(userid) SORTED BY(viewTime) INTO 32 BUCKETS
ROW FORMAT DELIMITED ‘\t’
FIELDS TERMINATED BY '\n' STORED AS SEQUENCEFILE;
创建表并创建索引字段ds
hive> CREATE TABLE invites (foo INT, bar STRING) PARTITIONED BY (ds STRING);
复制一个空表
CREATE TABLE empty_key_value_store
LIKE key_value_store;
例子
create table user_info (user_id int, cid string, ckid string, username string)
row format delimited
fields terminated by '\t'
lines terminated by '\n';
导入数据表的数据格式是:字段之间是tab键分割,行之间是断行。
及要我们的文件内容格式:
100636 100890 c5c86f4cddc15eb7 yyyvybtvt
100612 100865 97cc70d411c18b6f gyvcycy
100078 100087 ecd6026a15ffddf5 qa000100
显示所有表:
hive> SHOW TABLES;
按正条件(正则表达式)显示表,
hive> SHOW TABLES '.*s';
修改表结构
?增加分区、删除分区
?重命名表
?修改列的名字、类型、位置、注释
?增加/更新列
?增加表的元数据信息
表添加一列 :
hive> ALTER TABLE pokes ADD COLUMNS (new_col INT);
添加一列并增加列字段注释
hive> ALTER TABLE invites ADD COLUMNS (new_col2 INT COMMENT 'a comment');
更改表名:
hive> ALTER TABLE events RENAME TO 3koobecaf;
删除列:
hive> DROP TABLE pokes;
增加、删除分区
?增加
ALTER TABLE table_name ADD [IF NOT EXISTS] partition_spec [ LOCATION 'location1' ]
partition_spec [ LOCATION 'location2' ] ...
partition_spec:
: PARTITION (partition_col = partition_col_value, partition_col = partiton_col_value, ...)
?删除
ALTER TABLE table_name DROP partition_spec, partition_spec,...
重命名表
?ALTER TABLE table_name RENAME TO new_table_name 修改列的名字、类型、位置、注释:
?ALTER TABLE table_name CHANGE [COLUMN] col_old_name col_new_name column_type
[COMMENT col_comment] [FIRST|AFTER column_name]
?这个命令可以允许改变列名、数据类型、注释、列位置或者它们的任意组合
表添加一列 :
hive> ALTER TABLE pokes ADD COLUMNS (new_col INT);
添加一列并增加列字段注释
hive> ALTER TABLE invites ADD COLUMNS (new_col2 INT COMMENT 'a comment');
增加/更新列
?ALTER TABLE table_name ADD|REPLACE COLUMNS (col_name data_type [COMMENT
col_comment], ...)
? ADD是代表新增一字段,字段位置在所有列后面(partition列前)
REPLACE则是表示替换表中所有字段。
增加表的元数据信息
?ALTER TABLE table_name SET TBLPROPERTIES table_properties table_properties:
:[property_name = property_value…..]
?用户可以用这个命令向表中增加metadata
hive语法和常用函数
Hive是一个基于Hadoop分布式系统上的数据仓库,最早是由Facebook公司开发的,Hive极大的推进了Hadoop ecosystem在数据仓库方面上的发展。
Facebook的分析人员中很多工程师比较擅长而SQL而不善于开发MapReduce程序,为此开发出Hive,并对比较熟悉SQL的工程师提供了一套新的SQL-like方言——Hive QL。
Hive SQL方言特别和MySQL方言很像,并提供了Hive QL的编程接口。Hive QL语句最终被Hive解析器引擎解析为MarReduce程序,作为job提交给Job Tracker运行。这对MapReduce框架是一个很有力的支持。
Hive是一个数据仓库,它提供了数据仓库的部分功能:数据ETL(抽取、转换、加载)工具,数据存储管理,大数据集的查询和分析能力。
由于Hive是Hadoop上的数据仓库,因此Hive也具有高延迟、批处理的的特性,即使处理很小的数据也会有比较高的延迟。故此,Hive的性能就和居于传统数据库的数据仓库的性能不能比较了。
Hive不提供数据排序和查询的cache功能,不提供索引功能,不提供在线事物,也不提供实时的查询功能,更不提供实时的记录更性的功能,但是,Hive能很好地处理在不变的超大数据集上的批量的分析处理功能。Hive是基于hadoop平台的,故有很好的扩展性(可以自适应机器和数据量的动态变化),高延展性(自定义函数),良好的容错性,低约束的数据输入格式。
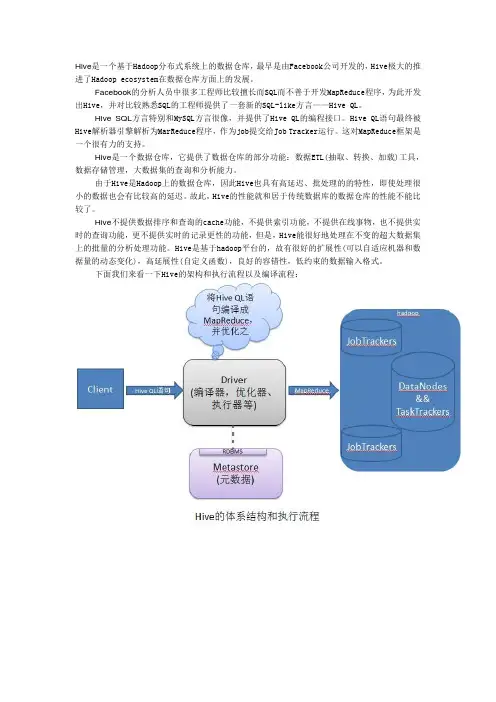
下面我们来看一下Hive的架构和执行流程以及编译流程:
用户提交的Hive QL语句最终被编译为MapReduce程序作为Job提交给Hadoop执行。
Hive的数据类型
Hive的基本数据类型有:TINYINT,SAMLLINT,INT,BIGINT,BOOLEAN,FLOAT,DOUBLE,STRING,TIMESTAMP(V0.8.0+)和BINARY(V0.8.0+)。
HiveQL详解

HiveQL详解
Hive 是基于Hadoop 构建的⼀套数据仓库分析系统,它提供了丰富的SQL查询⽅式来分析存储在Hadoop 分布式⽂件系统中的数据,可以将
结构化的数据⽂件映射为⼀张数据库表,并提供完整的SQL查询功能,可以将SQL语句转换为MapReduce任务进⾏运⾏,通过⾃⼰的SQL
去查询分析需要的内容,这套SQL 简称Hive SQL,使不熟悉mapreduce 的⽤户很⽅便的利⽤SQL 语⾔查询,汇总,分析数据。⽽
mapreduce开发⼈员可以把⼰写的mapper 和reducer 作为插件来⽀持Hive 做更复杂的数据分析。它与关系型数据库的SQL 略有不同,但⽀持了绝⼤多数的语句如DDL、DML 以及常见的聚合函数、连接查询、条件查询。HIVE不适合⽤于
联机,也不提供实时查询功能。它最适合应⽤在基于⼤量不可变数据的批处理作业。如
HIVE的特点:可伸缩(在Hadoop的集群上动态的添加设备),可扩展,容错,输⼊格式的松散耦合。
Hive 的官⽅⽂档中对查询语⾔有了很详细的描述,请参考: ,本⽂的内容⼤部分翻译⾃该页⾯,期间加⼊了⼀些在使⽤过程中需要注意到
的事项。
1. DDL 操作
1.1、建表:
CREATE [EXTERNAL] TABLE [IF NOT EXISTS] table_name
[(col_name data_type [COMMENT col_comment], ...)]
[COMMENT table_comment]
[PARTITIONED BY (col_name data_type [COMMENT col_comment], ...)]
[CLUSTERED BY (col_name, col_name, ...)
[SORTED BY (col_name [ASC|DESC], ...)] INTO num_buckets BUCKETS]
[ROW FORMAT row_format]
hive sql 拆解字段 -回复

hive sql 拆解字段 -回复
Hive SQL拆解字段-简介与背景
在进行数据处理和分析时,往往需要对字段进行拆解和解析。Hive SQL作为一种开源的数据仓库工具,为我们提供了便捷而强大的数据处理能力。其中,拆解字段是其中一个重要的操作,在实际应用中,往往需要通过拆解字段来获得更具体的信息和指标。本文将从Hive SQL拆解字段的基本语法和操作方式开始,逐步详细介绍如何使用Hive SQL来拆解字段,并举例说明其实际应用。
第一步-了解Hive SQL的基本语法和操作方式
在使用Hive SQL进行字段拆解之前,我们首先需要了解一些基本的语法和操作方式。Hive SQL使用类似于传统SQL的语法,它会将我们输入的SQL语句转化为MapReduce任务来执行。同时,Hive SQL还提供了一些特殊的函数和关键字,用来支持更复杂的数据处理和分析操作。
例如,Hive SQL提供了split函数,它可以根据指定的分隔符将一个字段拆分成多个子字段。具体的语法如下:
SELECT split(column, delimiter) FROM table;
在这个语法中,column表示要拆分的字段,delimiter表示用来分隔字段的符号。执行这个语句之后,Hive SQL会返回一个包含拆分后子字段的结果集。
第二步-使用Hive SQL拆解字段的常见场景和方法
在实际应用中,我们经常会遇到一些需要拆解字段的场景。下面我们就通过一些具体的例子来说明如何使用Hive SQL来拆解字段。
1. 拆解URL中的参数
假设我们有一个包含URL的字段,我们想要从中提取出特定的参数。这时,我们可以使用Hive SQL的split函数来拆解这个字段,并通过索引来访问子字段。例如,我们可以使用如下的语句来拆解URL字段并获取其中的参数值:
SELECT split(split(url, '?')[1], '=')[1] FROM table;
hive sql 建表语句

hive sql 建表语句
Hive是基于Hadoop的数据仓库基础设施,可以通过Hive SQL来进行数据的查询、分析和处理。以下是符合标题要求的10个Hive
SQL建表语句:
1. 创建学生表(student):
CREATE TABLE student (
id INT,
name STRING,
age INT,
gender STRING,
grade STRING
);
2. 创建课程表(course):
CREATE TABLE course (
id INT,
name STRING,
credit INT,
teacher STRING
);
3. 创建成绩表(score):
CREATE TABLE score ( student_id INT,
course_id INT,
score INT
);
4. 创建订单表(order):
CREATE TABLE order (
order_id INT,
customer_id INT,
order_date DATE,
total_amount DOUBLE
);
5. 创建产品表(product):
CREATE TABLE product (
product_id INT,
name STRING,
price DOUBLE,
category STRING
);
6. 创建员工表(employee):
CREATE TABLE employee (
employee_id INT, name STRING,
position STRING,
department STRING,
hire_date DATE
);
7. 创建部门表(department):
CREATE TABLE department (
department_id INT,
hivesql 正则

- 1 - hivesql 正则
HiveSQL则是基于HQL(HiveQL)的正则表达式功能,它能对Hive中的数据进行快速筛选,精确提取需要的信息,极大地提高数据分析和处理的效率。
一、什么是HiveSQL正则
HiveSQL正则是一种基于HiveQL的正则语法,它能够有效的进行数据匹配,快速筛选出想要的信息。它是基于HiveQL实现的正则表达式,可以对所有HiveQL类型的数据进行搜索,如INT,FLOAT,STRING,BOOLEAN等。HiveSQL正则表达式具有规则性,可以根据不同的搜索规则,有效的筛选出需要的数据。
二、HiveSQL正则的基本使用
1、搜索字符或字符串:使用*与字符串连接,如SELECT * FROM
table WHERE colume LIKE%string%’,表示在列中搜索字符串;
2、搜索空值:可以使用IS NULL进行搜索,如SELECT * FROM table
WHERE colume IS NULL,表示搜索该列的空值;
3、搜索数值:可以使用=,>,>=,<,<=等运算符来搜索指定的数值,如SELECT * FROM table WHERE colume > 5,表示搜索该列大于5的数值;
4、搜索复合条件:可以通过使用SELECT * FROM table WHERE
colume > 5 AND colume< 10进行复合条件搜索,表示搜索满足该条件的数据;
5、正则表达式:正则表达式是一种文本模式匹配,能够根据文 - 2 - 本提供的搜索规则,快速筛选出指定的数据,如SELECT * FROM table
WHERE colume RLIKE^Hive’,表示在列中搜索以Hive开头的文本。
三、HiveSQL正则的优点
1、HiveSQL正则表达式具有规则性,可以根据不同的搜索规则,快速的进行数据匹配,极大的提高数据分析和处理的效率;
hive 分列函数

hive 分列函数
Hive 分列函数
Hive 是基于 Hadoop 的数据仓库基础架构,通过将 SQL 查询转换为
MapReduce 任务来实现分布式数据处理。Hive 中的分列函数是一种非常有用的功能,可以根据指定的分隔符将字符串拆分为多个列。本文将介绍 Hive 中常用的分列函数及其用法。
一、split() 函数
split() 函数用于将字符串按照指定的分隔符拆分为数组,并返回数组中的指定位置的元素。其语法如下:
split(str, delimiter)
其中,str 是要拆分的字符串,delimiter 是分隔符。例如,我们有一个字符串 "hello world",要按照空格拆分,可以使用如下语句:
select split("hello world", " ")[0];
这将返回字符串 "hello"。
二、str_to_map() 函数
str_to_map() 函数用于将字符串按照指定的分隔符拆分为键值对,并返回一个 Map 对象。其语法如下:
str_to_map(str[, delimiter1, delimiter2])
其中,str 是要拆分的字符串,delimiter1 是键和值之间的分隔符,默认为 ":",delimiter2 是键值对之间的分隔符,默认为 ","。例如,我们有一个字符串 "name:John,age:30",要按照 ":" 和 "," 拆分,可以使用如下语句:
select str_to_map("name:John,age:30", ":", ",");
这将返回一个包含键值对的 Map 对象。
三、regexp_extract() 函数
regexp_extract() 函数用于从字符串中提取符合正则表达式的子串,并返回提取的结果。其语法如下:
regexp_extract(str, regex, index)
其中,str 是要提取的字符串,regex 是正则表达式,index 是要提取的结果在正则表达式中的位置。例如,我们有一个字符串
hive sql原理
hive sql原理
Hive是一个基于Hadoop的数据仓库基础设施,它提供了一种类似于SQL的查询语言,称为Hive SQL,用于在大规模数据集上进行数据分析和处理。Hive SQL的原理是将查询转化为一系列的MapReduce作业来执行。
Hive SQL中的查询语句类似于传统的SQL语句,包括SELECT、FROM、WHERE、GROUP BY、ORDER BY等关键字。在执行查询之前,Hive会将查询语句解析成一个查询计划,然后将查询计划转化为一系列的MapReduce任务。
在执行过程中,Hive会将查询语句中的表和分区映射到Hadoop的文件系统中的文件或者Hive中的容器中。然后,Hive会将查询计划转化为一系列的MapReduce任务,其中Map任务负责对输入数据进行切分和处理,Reduce任务负责对Map任务的结果进行聚合。每个任务都在Hadoop集群上并行执行,以实现高性能的数据处理。
Hive SQL还支持数据的压缩、分桶和索引等特性,以提高查询性能。数据的压缩可以减少数据的存储空间,分桶可以将数据划分为若干个桶,以加速基于某个字段的查询,索引可以加速特定列上的查询操作。
总的来说,Hive SQL的原理是将查询转化为一系列的MapReduce任务来执行,通过并行化和优化技术来提高查询性能。通过这种方式,Hive可以方便地对大规模数据集进行数据分析和处理。
hive union all用法
hive union all用法
在Hadoop生态系统中,Apache Hive是一个大数据仓库解决方案,通常用于处理和分析存储在Hadoop分布式文件系统中的海量数据集。Hive基于SQL语言,可以让分析师和业务用户以非程序员的方式查询数据。Hive中的UNION ALL操作是将两个或多个SELECT语句的结果集合并成一个输出结果,本篇文章将详细介绍Hive中的UNION ALL用法。
一、UNION ALL操作的语法
在Hive中,UNION ALL操作的语法如下:
SELECT column_name(s) FROM table1
UNION ALL
SELECT column_name(s) FROM table2;
其中,table1和table2是要合并的表名,column_name是要合并的列名。需要注意的是,每个SELECT语句必须具有相同的列数,并且每个查询返回的每个列的数据类型必须相同。
二、UNION ALL操作的执行过程
执行UNION ALL操作时,Hive会按顺序执行每个SELECT语句,并将结果集合并成一个输出结果。在合并结果集时,不会去除任何重复行。具体流程如下:
1. 执行第一个SELECT语句,生成第一个结果集。
2. 执行第二个SELECT语句,生成第二个结果集。
3. 将第一个和第二个结果集合并成一个输出结果,不去除任何重复行。
三、UNION ALL操作的示例
下面以两个表的UNION ALL操作为例,演示UNION ALL操作的用法。
1. 创建两个表
首先需要创建两个表,用于演示UNION ALL操作。
CREATE TABLE table1(
id INT, name STRING
);
INSERT INTO table1 VALUES(1,'张三');
INSERT INTO table1 VALUES(2,'李四');
hive sql 查 字段类型
- 1 - hive sql 查 字段类型
HiveSQL是一种基于Hadoop的数据仓库系统,它提供了一种类
SQL 的查询语言来操作 Hadoop 集群中的数据。在 Hive SQL 中,我们可以使用不同的数据类型来定义表中的字段。本文将介绍 Hive
SQL 中常用的数据类型及其用法。
1. 布尔型(Boolean Type)
布尔型只有两个值:TRUE 或 FALSE。在 Hive SQL 中,我们可以使用 TINYINT 来代表布尔型。
例如,我们可以创建一个名为 employee 的表,其中包含 name、age 和 is_employee 字段。is_employee 字段用来表示该员工是否是公司员工,如果是,则值为 TRUE,否则值为 FALSE。
CREATE TABLE employee (name STRING, age INT, is_employee
TINYINT);
2. 整型(Integers)
整型用于表示整数。在 Hive SQL 中,我们可以使用不同的整型数据类型,如 TINYINT、SMALLINT、INT 和 BIGINT,并根据需要选择适当的类型。
例如,我们可以创建一个名为 employee 的表,其中包含 name、age 和 salary 字段。salary 字段用来表示员工的薪水,因此我们可以使用 BIGINT 数据类型。
CREATE TABLE employee (name STRING, age INT, salary
BIGINT); - 2 - 3. 浮点型(Floating Point)
浮点型用于表示带小数点的数字。在 Hive SQL 中,我们可以使用 FLOAT 或 DOUBLE 数据类型来表示浮点型。
例如,我们可以创建一个名为 product 的表,其中包含 name、price 和 discount 字段。price 字段用来表示产品的价格,discount 字段用来表示折扣率,因此我们可以使用 DOUBLE 数据类型。
hive sql语法 insert语法
sql语法中insert用法
Hive SQL语法中的INSERT语句用于将数据插入到表中。其基本语法如下:
INSERT INTO TABLE table_name [PARTITION
(partition_column=value, ...)]
SELECT column1, column2, ...
FROM source_table
WHERE condition;
其中:
- `table_name`:要插入数据的表名。
- `PARTITION`:可选,用于指定分区信息。可以指定一个或多个分区列及其对应的值。
- `SELECT`:从源表中选择要插入的数据。可以指定要插入的列和条件。
- `source_table`:源表名,即要从中选择数据插入的目标表。
- `condition`:可选,用于过滤源表中的数据。只有满足条件的行才会被插入。
示例:
假设我们有一个名为`employees`的表,包含以下字段:`id`(员工ID)、`name`(员工姓名)、`age`(员工年龄)和`department`(所属部门)。现在我们想要将年龄大于30的员工信息插入到另一个名为`old_employees`的表中。可以使用以下INSERT语句实现:
INSERT INTO TABLE old_employees
SELECT id, name, age, department
FROM employees
WHERE age > 30;