
2012高教社杯全国大学生数学建模竞赛A题答案
2012年全国大学生数学建模竞赛A题 附件1-葡萄酒品尝评分表
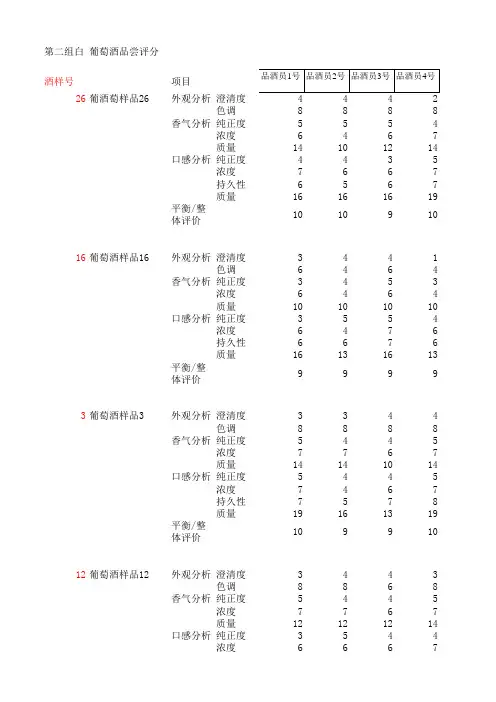
2 葡萄酒样品2
外观分析 澄清度 色调
香
6
7
7
7
6
7
7
19
16
16
16
10
9
9
8
3
4
4
4
8
8
8
8
5
4
5
4
7
6
7
7
14
12
12
12
4
5
5
5
6
6
7
7
7
6
6
7
16
16
16
22
9
9
9
10
4
4
3
4
8
8
6
8
5
5
4
5
7
7
6
6
14
12
12
12
5
5
4
5
7
6
7
7
6
6
7
7
19
16
16
7
14
12
12
14
5
4
5
5
6
6
6
6
6
6
6
6
16
16
16
19
9
9
9
10
4
4
4
4
8
8
6
8
4
4
5
4
6
7
6
6
12
12
12
12
4
5
5
4
6
6
7
2012年全国大学生数学建模竞赛A题国一

摘要
在问题一中,首先根据 T 检验、方差显著性检验和 Wilcoxon 秩和检验对两组评酒 员给葡萄酒的评价结果的差异的显著性检验。在大多数评酒员评分可靠的假设下,分别 利用评分方差比较模型,说明第二组结果可靠。在此基础上引入了评酒员“失误度”概 念来衡量每位评酒员与所有评酒员总体评价的差异, 对各组失误度求和得到第二组结果 更可靠。为了进一步优化评酒员评分,利用根据失误度对评酒员排序,跨组选取失误度 最小的 10 位评酒员组成新的评分组,其平均值认为比第二组更可靠,作为整个文章中 评价葡萄酒质量的标准指标。 在问题二中,由于红、白葡萄的理化指标有较大差异,分开考虑红白两种葡萄酒: 对于红葡萄酒,对应问题一得出的葡萄酒质量指标,从三个角度,即外观分析(又分为 由大分子因子决定的澄清度和基于 LAB 色彩模型的色调考虑到指标间存在的竞争关系 采用非线性回归分析和逐步回归分析) 、香气分析(Fisher 线性判别分析)和口感分析 (主成分分析和因子分析) ,后进行异常点检验,逐一剔除异常点来求解酿酒葡萄的量 化指标。对于白葡萄酒的三个指标采用 Fisher 判别分析求解。最后将三个方面得分加权 平均得到酿酒葡萄量化的总分,进行聚类分析,根据聚类分析结果将红葡萄和白葡萄各 分为四级。 在问题三中,为研究酿酒葡萄与葡萄酒的理化指标之间的联系,将葡萄酒的理化指 标用酿酒葡萄的理化指标来表示。根据指标间的相关性,剔除部分相关性不强的指标, 选择部分相关性较好的酿酒葡萄的指标作为自变量, 对不同的葡萄酒指标分别进行多元 线性回归、逐步回归和回归检验。根据指标本身的特点及 AIC 信息统计量,剔除不显著 的自变量,而达到用尽量少的葡萄的理化指标来表示葡萄酒的理化指标的目的。在求解 过程中,建立典型相关分析模型来分析红葡萄酒色泽指标间的关系,利用主成分分析将 白葡萄的多个指标综合为少数几个主成分,再进行回归分析。模型求解结果显示,葡萄 酒的每个指标都能用部分葡萄的指标来线性表示,且具有较好的拟合效果。 在问题四中,为了分析酿酒葡萄和葡萄酒的理化指标对葡萄酒质量的影响,结合问 题一、二、三的结果以及理化指标和芳香物质的化学意义,综合评估各个广义上的理化 指标(附件二和附件三) ,针对红葡萄酒和白葡萄酒的区别分别在酿酒葡萄和葡萄酒的 理化指标中选取对葡萄酒质量影响较大的指标, 通过线性回归分析将理化指标和葡萄酒 质量进行拟合,从而得出酿酒葡萄和葡萄酒的理化指标对葡萄酒质量的影响。为进一步 论证结果,首先,对模型进行残差分析以及拟合情况分析;其次,用分组样本检验方法, 将白葡萄酒的 28 个样本数据分成两组,采用用一组进行拟合,另一组进行结果回带分 析的方式,进一步论证用葡萄和葡萄酒的理化指标来评价葡萄酒的质量的可靠性。通过 论证分析得出结论:葡萄和葡萄酒的理化指标可以用来评价葡萄酒的质量,但也有其不 足之处,如当从葡萄酒食用性方便角度考虑,用评酒员评价方法就更直接。 关键词:葡萄酒质量 识别聚类 失误度 非线性回归 逐步回归 Fisher 判别分析 主成 分分析 因子分析 显著性检验 残差分析 异常点检测
2012全国大学生数学建模A题
一、问题重述确定葡萄酒质量时一般是通过聘请一批有资质的评酒员进行品评。
每个评酒员在对葡萄酒进行品尝后对其分类指标打分,然后求和得到其总分,从而确定葡萄酒的质量。
酿酒葡萄的好坏与所酿葡萄酒的质量有直接的关系,葡萄酒和酿酒葡萄检测的理化指标会在一定程度上反映葡萄酒和葡萄的质量。
附件1给出了某一年份一些葡萄酒的评价结果,附件2和附件3分别给出了该年份这些葡萄酒的和酿酒葡萄的成分数据。
请尝试建立数学模型讨论下列问题:1. 分析附件1中两组评酒员的评价结果有无显著性差异,哪一组结果更可信?2. 根据酿酒葡萄的理化指标和葡萄酒的质量对这些酿酒葡萄进行分级。
3. 分析酿酒葡萄与葡萄酒的理化指标之间的联系。
4.分析酿酒葡萄和葡萄酒的理化指标对葡萄酒质量的影响,并论证能否用葡萄和葡萄酒的理化指标来评价葡萄酒的质量?二、问题分析2.1 对问题一的分析该评酒员分为第一组和第二组两组,其中每组有10人分别对红葡萄酒和白葡萄酒进行品尝,并对各酒样品的外观、香气、口感和平衡/整体各方面进行评分。
由于每个品酒员自己本身上的差异,存在着主观误差,为避免评酒员主观上的误差,本文去掉最高分和一个最低分,然后再计算出各组品酒员对各样品酒的平均分。
这样得到的数据更具准确性。
2.2 对问题二的分析根据附件二酿酒葡萄的理化指标和葡萄酒的质量利用之成分分析,选用酿酒葡萄的一级指标,对多次测试的,我们取其平均值。
利用matlab软件实现其主成分分析,具体程序可见附录一。
最后,可到各个酿酒葡萄的排名和得分情况,再取一些分数值就可以对酿酒葡萄进行分类了。
2.3对问题三分析在问题二中对酿酒葡萄进行了分类,我们选用一级酿酒葡萄和葡萄酒来进行相关性分析。
由于酿酒葡萄和葡萄酒的理化指标过多,所以我们选用一级指标进行分析。
又根据文献3对酿酒葡萄选用VC含量、多酚氧化酶活力、总酚、总糖、还原糖、可溶性固形物、固酸比来进行分析。
利用spss软件进行相关性分析,得到酿酒葡萄和葡萄酒的相关性表,分析总结就可得到它们之间的联系。
2012数学建模A题论文:葡萄酒的评价

承诺书我们仔细阅读了中国大学生数学建模竞赛的竞赛规则.我们完全明白,在竞赛开始后参赛队员不能以任何方式(包括电话、电子邮件、网上咨询等)与队外的任何人(包括指导教师)研究、讨论与赛题有关的问题。
我们知道,抄袭别人的成果是违反竞赛规则的, 如果引用别人的成果或其他公开的资料(包括网上查到的资料),必须按照规定的参考文献的表述方式在正文引用处和参考文献中明确列出。
我们郑重承诺,严格遵守竞赛规则,以保证竞赛的公正、公平性。
如有违反竞赛规则的行为,我们将受到严肃处理。
我们授权全国大学生数学建模竞赛组委会,可将我们的论文以任何形式进行公开展示(包括进行网上公示,在书籍、期刊和其他媒体进行正式或非正式发表等)。
我们参赛选择的题号是(从A/B/C/D中选择一项填写): A我们的参赛报名号为(如果赛区设置报名号的话):所属学校(请填写完整的全名):参赛队员(打印并签名) :1.2.3.指导教师或指导教师组负责人(打印并签名):日期: 2012年 9月日赛区评阅编号(由赛区组委会评阅前进行编号):编号专用页赛区评阅编号(由赛区组委会评阅前进行编号):全国统一编号(由赛区组委会送交全国前编号):全国评阅编号(由全国组委会评阅前进行编号):葡萄酒的评价摘要葡萄拥有很高的营养价值,含有多种氨基酸、蛋白质和维生素,而以葡萄为原料的葡萄酒也蕴藏了多种营养物质,而且这些物质都是人体必须补充和吸收的营养品。
目前,已知的葡萄酒中含有的对人体有益的成分大约就有600种。
葡萄酒的营养价值由此也得到了广泛的认可,可以说葡萄酒是一个良好的滋补品。
本文通过对葡萄酒的评价,以及酿酒葡萄和葡萄酒的理化指标之间的关系进行讨论分析。
对不同的酿酒葡萄进行了分类,并更深入讨论两者的理化指标是否影响葡萄酒质量。
对于本题,我们主要采用SPSS软件对模型进行求解。
针对问题一,首先我们将附件1中数据在Excel中进行处理;其次,我们在SPSS中,采用T检验,分别分析出两组评酒品红、白葡萄酒的评价结果有无差异性。
数学建模2012a题

数学建模2012a题(实用版)目录一、数学建模 2012a 题概述二、题目背景及要求三、解题思路与方法四、具体解题过程五、答案与解析正文一、数学建模 2012a 题概述数学建模 2012a 题是一道经典的数学建模题目,主要考察学生运用数学知识解决实际问题的能力。
题目内容丰富,涉及多个学科领域,包括数学、物理、化学、生物等。
此题对学生的综合素质和创新能力有很高的要求,需要学生具备较强的分析问题和解决问题的能力。
二、题目背景及要求数学建模 2012a 题的背景是一个实际的生态问题,具体涉及到某种动植物的数量增长与环境因素之间的关系。
题目要求参赛者建立一个数学模型,描述这种关系,并利用模型分析和预测动植物数量的变化趋势。
三、解题思路与方法针对这道题目,首先要明确题目所给出的背景和要求,然后根据题目的特点,选择合适的数学模型进行建立。
一般来说,数学建模的解题思路包括以下几个步骤:1.充分理解题目,明确题目要求。
2.提炼题目中的关键信息,建立数学模型。
3.求解数学模型,得到问题的解。
4.分析解的合理性,并根据实际情况进行调整。
四、具体解题过程以某种动植物的数量增长为例,假设其数量与时间、环境因素(如温度、湿度等)有关,可以建立如下的数学模型:设动植物数量为 N(t),t 表示时间,环境因素为 E,可以得到如下的数量增长方程:dN(t)/dt = f(N(t), E)其中,f(N(t), E) 表示动植物数量的增长率,根据实际情况和生物学知识可以进行具体设定。
根据题目要求,需要利用该模型分析和预测动植物数量的变化趋势。
可以利用数值方法(如有限差分法、龙格库塔法等)对上述微分方程进行求解,得到动植物数量随时间的变化情况。
同时,可以根据实际情况对模型进行调整和优化,以提高预测的准确性。
五、答案与解析数学建模 2012a 题的答案并不唯一,关键在于参赛者能否根据题目要求建立合适的数学模型,并利用模型得出合理的结论。
全国大学生数学建模优秀论文A题

2012高教社杯全国大学生数学建模竞赛承诺书我们仔细阅读了中国大学生数学建模竞赛的竞赛规则.我们完全明白,在竞赛开始后参赛队员不能以任何方式(包括电话、电子邮件、网上咨询等)与队外的任何人(包括指导教师)研究、讨论与赛题有关的问题。
我们知道,抄袭别人的成果是违反竞赛规则的, 如果引用别人的成果或其他公开的资料(包括网上查到的资料),必须按照规定的参考文献的表述方式在正文引用处和参考文献中明确列出。
我们郑重承诺,严格遵守竞赛规则,以保证竞赛的公正、公平性。
如有违反竞赛规则的行为,我们将受到严肃处理。
我们参赛选择的题号是(从A/B/C/D中选择一项填写): A我们的参赛报名号为(如果赛区设置报名号的话):S55001所属学校(请填写完整的全名):郑州科技学院参赛队员(打印并签名) :1. 刘超2. 赵芬芳3. 尹峰指导教师或指导教师组负责人(打印并签名):闫天增日期: 2012 年 9 月 10 日赛区评阅编号(由赛区组委会评阅前进行编号):2012高教社杯全国大学生数学建模竞赛编号专用页赛区评阅编号(由赛区组委会评阅前进行编号):赛区评阅记录(可供赛区评阅时使用):评阅人评分备注全国统一编号(由赛区组委会送交全国前编号):全国评阅编号(由全国组委会评阅前进行编号):葡萄酒的评价摘要确定葡萄酒质量时一般是通过聘请一批有资质的评酒员进行品评。
酿酒葡萄的好坏与所酿葡萄酒的质量有直接的关系,葡萄酒和酿酒葡萄检测的理化指标会在一定程度上反映葡萄酒和葡萄的质量。
本文通过对27种红葡萄酒和28种白葡萄的理化指标数据进行分析,采用显著性差异分析法、可靠度分析、因子分析法、相关系数分析、主成分分析法以及聚类分析法,借助统计软件SPSS和数学软件MATLAB,分析了两组评酒员的评价结果有无显著性差异和可信度,给出了酿酒葡萄与葡萄酒的理化指标之间的联系,建立了基于酿酒葡萄理化指标和葡萄酒质量的聚类分析模型确定了葡萄酒质量的影响因素,最后通过补充相关信息,建立基于分析模型确定了葡萄酒质量的影响因素。
2012年全国数学建模A题参考答案
2012高教社杯全国大学生数学建模竞赛题目(请先阅读“全国大学生数学建模竞赛论文格式规范”)A题葡萄酒的评价确定葡萄酒质量时一般是通过聘请一批有资质的评酒员进行品评。
每个评酒员在对葡萄酒进行品尝后对其分类指标打分,然后求和得到其总分,从而确定葡萄酒的质量。
酿酒葡萄的好坏与所酿葡萄酒的质量有直接的关系,葡萄酒和酿酒葡萄检测的理化指标会在一定程度上反映葡萄酒和葡萄的质量。
附件1给出了某一年份一些葡萄酒的评价结果,附件2和附件3分别给出了该年份这些葡萄酒的和酿酒葡萄的成分数据。
请尝试建立数学模型讨论下列问题:1. 分析附件1中两组评酒员的评价结果有无显著性差异,哪一组结果更可信?2. 根据酿酒葡萄的理化指标和葡萄酒的质量对这些酿酒葡萄进行分级。
3. 分析酿酒葡萄与葡萄酒的理化指标之间的联系。
4.分析酿酒葡萄和葡萄酒的理化指标对葡萄酒质量的影响,并论证能否用葡萄和葡萄酒的理化指标来评价葡萄酒的质量?附件1:葡萄酒品尝评分表(含4个表格)附件2:葡萄和葡萄酒的理化指标(含2个表格)附件3:葡萄和葡萄酒的芳香物质(含4个表格)答案仅供参考:1. 分析附件1中两组评酒员的评价结果有无显著性差异根据表1计算的各取样点葡萄质量综合评分结果, 结合当地气象资料,进行相关普查和回归分析, 挑选出相关性显著, 并通过0. 01显著性检验的11个因子, 果实着色期平均最低气温(Tn45 )、果实着色期平均日较差(D45 )、果实着色期平均相对湿度(U45 )、果实着色期降水量(R 45 )、果实着色期水热系数(K 45 )、全生育期平均相对湿度(Ug )、全生育期降水量(Rg )、全生育期水热系数(Kg )、7~ 8月份降水量(R 7- 8 )、日照时数( S7- 8 )、水热系数(K 7- 8 )。
利用DPS3. 01 数据处理系统对这些影响因素进行因子分析, 并进行倾斜旋转( promaxrotation)得到11种影响酿酒葡萄品质气象因子结构如表5。
2012高教社杯全国大学生数学建模竞赛全国一等奖A题
2011高教社杯全国大学生数学建模竞赛城市表层土壤重金属污染分析摘要本文主要研究重金属对城市表层土壤污染的问题,我们根据题目所给定的一些数据和信息分析并建立了扩散传播模型、权重分配模型、对比模型和转换模型解决问题。
首先,我们利用Matlab 软件拟出该城区地势图(图1),根据所给数据绘出该地区的三维地势及采样点在其上的综合空间分布图。
之后将8种重金属的浓度等高线投影到该地区三维地形图曲面上,接着分别计算8种重金属在五个区域的平均值,立体图和平面图(图1附件)相结合便可得出8种重金属元素在该城区的空间分布。
其次,在确定该城区内不同区域重金属的污染程度时,我们运用两种方法进行解答。
先假设各重金属毒性及其它性质相同,运用公式ijij P C P ='求出各区域各金属相对于背景平均值的比值作为金属污染程度,再运用1ji ij j C C ==∑求出各区域重金属污染程度,并将各区进行比较。
之后,我们加上各重金属的毒性,对各重金属求出权数,再结合国标重金属污染等级和已知的各组数据来确定金属的污染程度。
由上述两种方法的对比,更准确地得出重金属对各区的影响程度。
即: 工业区>交通区>生活区>公园绿地区>山区 并根据第一个模型的数据来说明重金属污染的主要原因。
再次,对重金属污染物的传播特征进行了分析,判断出重金属污染物主要是通过大气、土壤和水流进行传播。
在分析之中,我们得出这三种状态的传播并不是孤立存在的,而是可以相互影响和叠加的,因此,我们分别建立三个传播模型,再对这三个传播模型进行了时间和空间上的拟合,得出重金属浓度最高的区域图,并结合各重金属的分布图(图6)来确定各污染源的位置。
最后,本题中只给出了重金属对土壤的污染,对于研究城市地质环境的演变模式,还需要搜集一些信息(图7)。
根据每种因素对地质环境的影响程度进行由定性到定量的转化。
建立同一地质时期地质环境中各因素的正影响和负影响的权重分配模型,再对这些权重进行验算和修正。
2012年数学建模A题第二问参考答案——葡萄分级
描述统计量均值标准差分析 N 天门冬氨酸75.6341 20.68785 27 苏氨酸152.9496 80.05794 27 丝氨酸124.6556 56.67784 27 谷氨酸117.0330 63.52041 27 脯氨酸1441.5378 1557.60578 27 甘氨酸79.5337 52.14485 27 丙氨酸55.2167 29.02871 27 胱氨酸24.2585 12.99296 27 缬氨酸28.8896 11.63951 27 蛋氨酸8.2985 4.98859 27 异亮氨酸17.5300 11.85535 27 亮氨酸24.9378 13.34513 27 酪氨酸 3.4504 2.19987 27 苯丙氨酸 4.7326 2.71900 27 赖氨酸33.0193 19.53507 27 组氨酸23.2141 13.00215 27描述统计量均值标准差分析 N 天门冬氨酸75.6341 20.68785 27 苏氨酸152.9496 80.05794 27 丝氨酸124.6556 56.67784 27 谷氨酸117.0330 63.52041 27 脯氨酸1441.5378 1557.60578 27 甘氨酸79.5337 52.14485 27 丙氨酸55.2167 29.02871 27 胱氨酸24.2585 12.99296 27 缬氨酸28.8896 11.63951 27 蛋氨酸8.2985 4.98859 27 异亮氨酸17.5300 11.85535 27 亮氨酸24.9378 13.34513 27 酪氨酸 3.4504 2.19987 27 苯丙氨酸 4.7326 2.71900 27 赖氨酸33.0193 19.53507 27 组氨酸23.2141 13.00215 27 精氨酸141.5248 106.81323 27成份矩阵a成份1 2 3 4 5天门冬氨酸.512 .504 .386 .279 .180 苏氨酸.374 .639 -.355 -.205 .343 丝氨酸.746 .103 -.103 .415 -.117 谷氨酸.690 .562 -.139 -.220 -.025 脯氨酸-.104 .034 -.187 .739 .532 甘氨酸.482 .676 .068 -.101 -.238 丙氨酸.622 .449 -.185 -.039 -.068 胱氨酸.392 .168 .051 .603 -.475 缬氨酸.861 -.237 .040 .025 -.161 蛋氨酸.703 .043 -.233 -.270 .408 异亮氨酸.756 -.170 .252 -.131 -.180 亮氨酸.853 -.286 .152 -.038 -.081 酪氨酸.317 -.119 .763 -.144 .218 苯丙氨酸.187 .093 .669 .046 .318 赖氨酸.693 -.466 -.198 .224 .194 组氨酸.796 -.525 -.158 -.073 .078 精氨酸.635 -.508 -.226 -.114 .023 提取方法 :主成份。
2012数学建模A题葡萄酒答案
图一的两组红葡萄酒的平均值、和标准差第二组红葡萄酒标准差平均值标准差酒样品1 9.638465 酒样品1 68.1 9.048634 酒样品2 80.3 6.307843 酒样品2 74 4.027682 酒样品3 80.4 6.769211 酒样品3 74.6 5.541761 酒样品4 68.6 10.39444 酒样品4 71.2 6.425643 酒样品5 73.3 7.874713 酒样品5 72.1 3.695342 酒样品6 72.2 7.728734 酒样品6 66.3 4.595892 酒样品7 71.5 10.17895 酒样品7 65.3 7.91693 酒样品8 72.3 6.634087 酒样品8 66 8.069146 酒样品9 81.5 5.739725 酒样品9 78.2 5.072803 酒样品10 74.2 5.51362 酒样品10 68.8 6.014797 酒样品11 61.7 7.91693 酒样品11 61.6 6.168018 酒样品12 53.9 8.924996 酒样品12 68.3 5.012207 酒样品13 74.6 6.703233 酒样品13 68.8 3.910101 酒样品14 73 6 酒样品14 72.6 4.812022 酒样品15 58.7 9.250225 酒样品15 65.7 6.429965 酒样品16 74.9 4.254409 酒样品16 69.9 4.483302 酒样品17 79.3 9.381424 酒样品17 74.5 3.02765 酒样品18 59.9 6.871034 酒样品18 65.4 7.089899 酒样品19 69.4 6.25744 酒样品19 72.6 7.426679 酒样品20 78.6 5.103376 酒样品20 75.8 6.250333 酒样品21 77.1 10.77497 酒样品21 72.2 5.95912 酒样品22 77.2 7.11493 酒样品22 71.6 4.926121 酒样品23 85.6 5.699903 酒样品23 77.1 4.976612 酒样品24 78 8.653837 酒样品24 71.5 3.27448 酒样品25 69.2 8.038795 酒样品25 68.2 6.613118 酒样品26 73.8 5.593647 酒样品26 72 6.44636 酒样品27 73 7.055337 酒样品27 71.5 4.527693图二两组白葡萄酒的平均值、和标准差第一组白葡萄酒第二组白葡萄酒干白品种平均值标准差干白品种平均值标准差酒样品1 82 9.60324 酒样品1 77.9 5.087021 酒样品2 74.2 14.1798 酒样品2 75.8 7.00476 酒样品3 85.3 19.10817 酒样品3 75.6 11.93687 酒样品4 79.4 6.686637 酒样品4 76.9 6.488451 酒样品5 71 11.24475 酒样品5 26.1 5.126185 酒样品6 68.4 12.75583 酒样品6 75.5 4.766783 酒样品7 77.5 6.258328 酒样品7 74.2 1.212265 酒样品8 71.4 13.54991 酒样品8 72.3 5.578729 酒样品9 72.9 9.631545 酒样品9 80.4 10.30857 酒样品10 74.3 14.58348 酒样品10 79.8 8.390471酒样品11 72.3 13.30873 酒样品11 71.4 9.371351 酒样品12 63.3 10.76052 酒样品12 72.4 11.83404 酒样品13 65.9 13.06777 酒样品13 73.9 6.838616 酒样品14 72 10.68748 酒样品14 77.1 3.984693 酒样品15 72.4 11.4717 酒样品15 78.4 7.351493 酒样品16 74 13.34166 酒样品16 53.1 9.06826 酒样品17 78.8 12.00741 酒样品17 80.3 6.201254 酒样品18 73.1 12.51177 酒样品18 76.7 5.498485 酒样品19 72.2 6.811755 酒样品19 76.4 5.103376 酒样品20 77.8 8.024961 酒样品20 43.2 7.07421 酒样品21 76.4 13.14196 酒样品21 79.2 8.024961 酒样品22 71 11.77568 酒样品22 79.4 7.321202 酒样品23 75.9 6.607235 酒样品23 77.4 3.405877 酒样品24 73.3 10.54145 酒样品24 76.1 6.208417 酒样品25 77.1 5.820462 酒样品25 79.5 10.31988 酒样品26 81.3 8.53815 酒样品26 74.3 7.532168 酒样品27 64.8 12.01666 酒样品27 77 5.962848 酒样品28 81.3 8.969702 酒样品28 79.6 5.037636描述统计量N 均值标准差方差统计量统计量标准误统计量统计量VAR00003 27 68.5185 1.50722 7.83174 61.336 VAR00004 27 74.4444 2.24201 11.64980 135.718 VAR00005 27 72.7037 2.70265 14.04338 197.217 VAR00006 27 65.2963 1.44393 7.50290 56.293 VAR00007 27 74.1852 2.64469 13.74223 188.849 VAR00008 27 72.7037 2.13091 11.07254 122.601 VAR00009 27 71.2222 1.51002 7.84628 61.564 VAR00010 27 72.0741 1.95456 10.15619 103.148 VAR00011 27 78.4444 1.23035 6.39311 40.872 VAR00012 0Zscore(VAR00003) 0Zscore(VAR00004) 0Zscore(VAR00005) 0Zscore(VAR00006) 0Zscore(VAR00007) 0Zscore(VAR00008) 0Zscore(VAR00009) 0Zscore(VAR00010) 0Zscore(VAR00011) 0Zscore(VAR00012) 0描述统计量N 均值标准差方差统计量统计量标准误统计量统计量VAR00003 27 68.5185 1.50722 7.83174 61.336 VAR00004 27 74.4444 2.24201 11.64980 135.718 VAR00005 27 72.7037 2.70265 14.04338 197.217 VAR00006 27 65.2963 1.44393 7.50290 56.293 VAR00007 27 74.1852 2.64469 13.74223 188.849 VAR00008 27 72.7037 2.13091 11.07254 122.601 VAR00009 27 71.2222 1.51002 7.84628 61.564 VAR00010 27 72.0741 1.95456 10.15619 103.148 VAR00011 27 78.4444 1.23035 6.39311 40.872 VAR00012 0Zscore(VAR00003) 0Zscore(VAR00004) 0Zscore(VAR00005) 0Zscore(VAR00006) 0Zscore(VAR00007) 0Zscore(VAR00008) 0Zscore(VAR00009) 0Zscore(VAR00010) 0Zscore(VAR00011) 0Zscore(VAR00012) 0有效的 N (列表状态)0模型描述模型名称MOD_2因变量 1 VAR000032 VAR000073 VAR000054 VAR000115 VAR00008方程 1 二次自变量VAR00004常数包含其值在图中标记为观测值的变量未指定用于在方程中输入项的容差.0001个案处理摘要N变量处理摘要变量因变量自变量VAR00003 VAR00007 VAR00005 VAR00011 VAR00008 VAR00004 正值数27 27 27 27 27 27 零的个数0 0 0 0 0 0 负值数0 0 0 0 0 0 缺失值数用户自定义缺失0 0 0 0 0 0 系统缺失0 0 0 0 0 0模型描述模型名称MOD_2因变量 1 VAR000032 VAR000073 VAR000054 VAR000115 VAR00008方程 1 二次自变量VAR00004常数包含其值在图中标记为观测值的变量未指定用于在方程中输入项的容差.0001个案处理摘要N个案总数27已排除的个案a0模型描述模型名称MOD_2因变量 1 VAR000032 VAR000073 VAR000054 VAR000115 VAR00008方程 1 二次自变量VAR00004常数包含其值在图中标记为观测值的变量未指定用于在方程中输入项的容差.0001模型描述模型名称MOD_2因变量 1 VAR000032 VAR000073 VAR000054 VAR000115 VAR00008方程 1 二次自变量VAR00004常数包含其值在图中标记为观测值的变量未指定用于在方程中输入项的容差.0001。