
数据库优化方案
数据库优化方案
1. 高效地进行SQL语句设计:
通常情况下,可以采用下面的方法优化SQL对数据操作的表现:
(1)减少对数据库的查询次数,即减少对系统资源的请求,使用快照和显形图等分布式数据库对象可以减少对数据库的查询次数。
(2)尽量使用相同的或非常类似的SQL语句进行查询,这样不仅充分利用SQL共享池中的已经分析的语法树,要查询的数据在SGA中命中的可能性也会大大增加。
(3)避免不带任何条件的SQL语句的执行。没有任何条件的SQL语句在执行时,通常要进行FTS,数据库先定位一个数据块,然后按顺序依次查找其它数据,对于大型表这将是一个漫长的过程。
(4)如果对有些表中的数据有约束,最好在建表的SQL语句用描述完整性来实现,而不是用SQL程序中实现。
一、操作符优化:
1、IN操作符
用IN写出来的SQL的优点是比较容易写及清晰易懂,这比较适合现代软件开发的风格。但是用IN的SQL性能总是比较低的,从Oracle执行的步骤来分析用IN的SQL与不用IN的SQL有以下区别:
ORACLE试图将其转换成多个表的连接,如果转换不成功则先执行IN里面的子查询,再查询外层的表记录,如果转换成功则直接采用多个表的连接方式查询。由此可见用IN的SQL至少多了一个转换的过程。一般的SQL都可以转换成功,但对于含有分组统计等方面的SQL就不能转换了。在业务密集的SQL当中尽量不采用IN操作符。
优化sql时,经常碰到使用in的语句,一定要用exists把它给换掉,因为Oracle在处理In时是按Or的方式做的,即使使用了索引也会很慢。
2、 NOT IN操作符
强列推荐不使用的,因为它不能应用表的索引。用NOT EXISTS或(外连接+判断为空)方案代替
3、IS NULL或IS NOT NULL操作
判断字段是否为空一般是不会应用索引的,因为B树索引是不索引空值的。
用其它相同功能的操作运算代替,a is not null改为 a>0 或a>’’等。
不允许字段为空,而用一个缺省值代替空值,如业扩申请中状态字段不允许为空,缺省为申请。
避免在索引列上使用IS NULL和IS NOT NULL 避免在索引中使用任何可以为空的列,ORACLE将无法使用该索引.对于单列索引,如果列包含空值,索引中将不存在此记录.对于复合索引,如果每个列都为空,索引中同样不存在此记录.如果至少有一个列不为空,则记录存在于索引中.举例:如果唯一性索引建立在表的A 列和B 列上,并且表中存在一条记录的A,B 值为(123,null) , ORACLE 将不接受下一条具有相同A,B值(123,null)的记录(插入).然而如果所有的索引列都为空,ORACLE将认为整个键值为空而空不等于空.因此你可以插入1000 条具有相同键值的记录,当然它们都是空!因为空值不存在于索引列中,所以WHERE子句中对索引列进行空值比较将使ORACLE停用该索引.
低效: (索引失效)
SELECT …FROM DEPARTMENT WHERE DEPT_CODE ISNOTNULL;
高效: (索引有效)
SELECT …FROM DEPARTMENT WHERE DEPT_CODE >=0;
4、>及 < 操作符(大于或小于操作符)
大于或小于操作符一般情况下是不用调整的,因为它有索引就会采用索引查找,但有的情况下可以对它进行优化,如一个表有100万记录,一个数值型字段 A,30万记录的A=0,30万记录的A=1,39万记录的A=2,1万记录的A=3。那么执行A>2与A>=3的效果就有很大的区别了,因为A>2时ORACLE会先找出为2的记录索引再进行比较,而A>=3时ORACLE则直接找到=3的记录索引。
用>=替代>
高效:
SELECT …FROM DEPARTMENT WHERE DEPT_CODE >=0;
低效:
SELECT*FROM EMPWHERE DEPTNO >3
两者的区别在于, 前者DBMS将直接跳到第一个DEPT等于4的记录而后者将首先定位到DEPT NO=3的记录并且向前扫描到第一个DEPT大于3的记录.
5、LIKE操作符:
LIKE操作符可以应用通配符查询,里面的通配符组合可能达到几乎是任意的查询,但是如果用得不好则会产生性能上的问题,如LIKE ‘%5400%’这种查询不会引用索引,而LIKE‘X5400%’则会引用范围索引。一个实际例子:用YW_YHJBQK表中营业编号后面的户标识号可来查询营业编号 YY_BH LIKE‘%5400%’ 这个条件会产生全表扫描,如果改成YY_BH LIKE ’X5400%’ OR YY_BH LIKE ’B5400%’
则会利用YY_BH的索引进行两个范围的查询,性能肯定大大提高。
6、用EXISTS替换DISTINCT:
当提交一个包含一对多表信息(比如部门表和雇员表)的查询时,避免在SELECT子句中使用DISTINCT. 一般可以考虑用EXIST 替换, EXISTS使查询更为迅速,因为RDBMS核心模块将在子查询的条件一旦满足后,立刻返回结果.
例子:
(低效):
SELECTDISTINCT DEPT_NO,DEPT_NAMEFROM DEPT D , EMP EWHERE =
(高效):
SELECT DEPT_NO,DEPT_NAMEFROM DEPT D WHEREEXISTS
(SELECT'X'FROM EMP EWHERE = ;
如: 用EXISTS 替代IN、用NOT EXISTS替代NOT IN:
在许多基于基础表的查询中,为了满足一个条件,往往需要对另一个表进行联接.在这种情况下,使用EXISTS(或NOT EXISTS)通常将提高查询的效率.在子查询中,NOT IN 子句将执行一个内部的排序和合并. 无论在哪种情况下,NOT IN都是最低效的(因为它对子查询中的表执行了一个全表遍历).为了避免使用NOT IN ,我们可以把它改写成外连接(Outer Joins)或NOT
EXISTS.
例子:
(高效):
SELECT*FROM EMP (基础表)WHERE EMPNO >0ANDEXISTS
(SELECT'X'FROM DEPTWHERE = AND LOC='MELB')
(低效):
SELECT*FROM EMP (基础表)WHERE EMPNO >0AND DEPTNOIN
(SELECT DEP TNOFROM DEPT WHERE LOC ='MELB')
7、用UNION替换OR (适用于索引列)
通常情况下, 用UNION替换WHERE 子句中的OR 将会起到较好的效果.对索引列使用OR
将造成全表扫描. 注意,以上规则只针对多个索引列有效.如果有column 没有被索引, 查询效率可能会因为你没有选择OR而降低. 在下面的例子中, LOC_ID和REGION 上都建有索引.
(高效):
SELECT LOC_ID,LOC_DESC,REGIONFROM LOCATION WHERE LOC_ID =10
UNIONSELECT LOC_ID , LOC_DESC , REGIONFROM LOCATION WHERE REGION ='MELBOURNE'
(低效):
SELECT LOC_ID,LOC_DESC,REGIONFROM LOCATION WHERE LOC_ID= 10OR REGION = 'MELBOURNE'
如果你坚持要用OR, 那就需要返回记录最少的索引列写在最前面.
8、用IN来替换OR
这是一条简单易记的规则,但是实际的执行效果还须检验,在ORACLE8i下,两者的执行路径似乎是相同的.
低效:
SELECT….FROM LOCATION WHERE LOC_ID =10OR LOC_ID=20OR LOC_ID=30
高效:
SELECT…FROM LOCATION WHERE LOC_IN IN (10,20,30);
二、SQL语句结构优化
1、SELECT子句中避免使用‘ * ‘:
2、用TRUNCATE替代DELETE :
用TRUNCATE替代DELETE删除全表记录:(大数据量的表用次方法) 当删除表中的记录时,在通常情况下,回滚段(rollback segments )用来存放可以被恢复的信息. 如果你没有COMMIT 事务,ORACLE会将数据恢复到删除之前的状态(准确地说是恢复到执行删除命令之前的状况)而当运用TRUNCATE 时, 回滚段不再存放任何可被恢复的信息.
3、用Where子句替换HAVING 子句:
避免使用HAVING 子句, HAVING 只会在检索出所有记录之后才对结果集进行过滤.这个处理需要排序,总计等操作.如果能通过WHERE 子句限制记录的数目,那就能减少这方面的开销. (非oracle中)on、where、having这三个都可以加条件的子句中,on是最先执行,where 次之,having 最后,因为on是先把不符合条件的记录过滤后才进行统计,它就可以减少中间运算要处理的数据,按理说应该速度是最快的, where 也应该比having快点的
4、sql语句用大写
因为oracle 总是先解析sql语句,把小写的字母转换成大写的再执行。
5、在Java代码中尽量少用连接符“+”连接字符串!
6、避免改变索引列的类型.:
当比较不同数据类型的数据时, ORACLE自动对列进行简单的类型转换. 假设EMPNO 是一个数值类型的索引列.
SELECT … FROM EMP WHERE EMPNO = ‘123'实际上,经过ORACLE类型转换, 语句转化为:
SELECT …FROM EMP WHERE EMPNO = TO_NUMBER(‘123')
幸运的是,类型转换没有发生在索引列上,索引的用途没有被改变.现在,假设EMP_TYPE是一个字符类型的索引列.
SELECT …FROM EMP WHERE EMP_TYPE =123
这个语句被ORACLE转换为:
SELECT …FROM EMP WHERETO_NUMBER(EMP_TYPE)=123
因为内部发生的类型转换, 这个索引将不会被用到! 为了避免ORACLE对你的SQL 进行隐式的类型转换,最好把类型转换用显式表现出来.注意当字符和数值比较时, ORACLE会优先转换数值类型到字符类型
7、优化GROUP BY:
提高GROUP BY 语句的效率, 可以通过将不需要的记录在GROUP BY之前过滤掉.下面两个
查询返回相同结果但第二个明显就快了许多.
低效:
1SELECT JOB,AVG(SAL)FROM EMP GROUPby JOBHAVING JOB= 'PRESIDENT' OR JOB ='MANAGER'
高效:
1SELECT JOB,AVG(SAL)FROM EMP WHERE JOB ='PRESIDENT'OR JOB='MANAGER'GROUPby JOB
oracle优化方法总结
千里之行,始于足下。
第 1 页/共 2 页
oracle优化方法总结
Oracle优化是提高数据库性能和响应能力的重要步骤。本文总结了一些常见的Oracle优化方法。
1. 使用索引:索引是提高查询性能的主要方法。通过在表中创建适当的索引,可以加快查询速度,并减少数据访问的开销。但是要注意不要过度使用索引,因为过多的索引会增加写操作的开销。
2. 优化查询语句:查询语句的效率直接影响数据库的性能。可以通过合理地编写查询语句来提高性能。例如,使用JOIN来替代子查询,尽量避免使用通配符查询,使用LIMIT来限制结果集的大小等。
3. 优化表结构:表的设计和结构对数据库的性能也有很大的影响。合理的表设计可以减少数据冗余和不必要的数据存储,提高查询速度。例如,适当地使用主键、外键和约束,避免过多的数据类型和字段等。
4. 优化数据库参数设置:Oracle有很多参数可以用来调整数据库的性能。根据具体的应用场景和需求,可以根据情况调整参数的值。例如,调整SGA和PGA的大小,设置合适的缓冲区大小,调整日志写入方式等。
5. 使用分区表:当表的数据量很大时,可以考虑将表分成多个分区。分区表可以加速查询和维护操作,提高数据库的性能。可以按照时间、地域、业务等来进行分区。
6. 优化存储管理:Oracle提供了多种存储管理选项,如表空间和数据文件管理。合理地分配存储空间和管理数据文件可以提高数据库的性能。例如,定期清理无用的数据文件,使用自动扩展表空间等。 锲而不舍,金石可镂。
7. 数据压缩:对于大量重复数据或者冷数据,可以考虑使用Oracle的数据压缩功能。数据压缩可以减少磁盘空间的使用,提高IO性能。
8. 使用并行处理:对于大型计算或者批处理任务,可以考虑使用Oracle的并行处理功能。并行处理可以将任务分成多个子任务,并行执行,提高处理能力和效率。
9. 数据库分区:对于大型数据库,可以考虑将数据库分成多个独立的分区。数据库分区可以提高数据的并行处理能力,减少锁竞争和冲突,提高数据库的性能。
数据库查询性能差的原因分析与解决方案
数据库查询性能差的原因分析与解决方案
一、引言
数据库查询性能是决定系统整体性能的重要因素之一。当数据库查询性能差时,会导致系统响应时间延长、效率低下,影响用户体验和系统的可用性。因此,深入分析查询性能差的原因,并提出有效的解决方案,对于提升系统性能具有重要意义。
二、数据库查询性能差的原因分析
1. 数据库设计问题:良好的数据库设计能够提高查询性能。如果数据库的表结构设计不合理,如表之间存在冗余数据、缺乏索引、表字段不合理等,都会导致查询性能下降。
2. 查询语句问题:查询语句的编写有时会导致性能问题。当查询语句中存在大量的连接操作、子查询、不合理的顺序等,都会增加系统查询负担,导致性能下降。 3. 数据量过大:当数据库中数据量超过一定程度时,查询性能就会明显下降。数据量过大会导致磁盘I/O负载加重,从而降低系统的响应速度。
4. 硬件资源问题:硬件资源不足也会影响数据库查询性能。例如,内存容量不足、磁盘I/O速度慢,都会限制数据库的查询能力。
5. 数据库参数配置问题:数据库的参数配置对于查询性能有着重要的影响。如果数据库的参数配置不合理,比如缓冲区设置过小、线程数配置不当等,都会导致查询性能下降。
三、解决方案
1. 优化数据库设计:对于已经存在的数据库,可以通过对表进行重构、去除冗余数据、合理设计索引等方式来优化数据库结构,从而提高查询性能。
2. 优化查询语句:仔细审查查询语句,避免使用不必要的连接操作和子查询。编写高效的查询语句,可以使用合适的索引、合理的顺序等来加快查询速度。 3. 数据分区和分页:对于数据量过大的表,可以考虑进行数据分区,将数据分散存储,从而减少单个查询操作的数据量。对于查询结果过多的情况,可以使用分页查询,限制一次查询的结果条数,减少数据的传输和加载。
4. 提升硬件资源:根据实际情况,考虑提升硬件资源。可以增加内存容量,加快磁盘I/O速度,提高服务器的计算性能,从而提升数据库查询性能。
数据库性能优化方法
- 1 - 数据库性能优化方法
随着信息技术的迅速发展,数据库在商业系统和科学计算中的重要地位已经日益凸显,影响着系统的性能和可用性。因此,数据库性能优化来保证数据的高效存取和高性能的操作一直以来都是重要的话题。
一般来说,数据库性能优化可以通过两个方面来实现,即数据库结构优化和查询优化。结构优化是指优化数据库表和索引结构以提高其性能,通过这种优化可以有效地改善数据库的查询性能;查询优化则是指改进查询的方法以提高性能,使用一些SQL语句优化技术能够改善查询的性能。
数据库结构优化具体可以采取哪些方法呢?
首先,在建立数据表时,要根据数据表中设计关键字段,比如字段的长度、类型、默认值等,这样可以使数据表更具紧凑,减少空间占用,提高查询性能。
其次,合理设置索引,可以显著提高查询性能,索引应满足以下几个原则:只设置相关的字段上的索引;控制索引的数量,避免使用太多的索引;建立联合索引;改善索引结构,并充分利用索引位置。
此外,合理使用存储过程、视图和触发器也能够有效改善数据库的查询性能。存储过程可以减少物理IO、减少网络传输,从而节省资源,提高查询性能;视图可以屏蔽数据表,使用户只能查询视图中的字段;触发器可以实现索引的重建、数据完整性的检查等,可以有效提高查询性能。 - 2 - 此外,查询优化也是提高数据库性能的重要手段。一般来说,查询优化可以通过以下几种方式来实现:
1、使用正确的查询语法,尽量使用简洁的SQL语句;
2、合理使用排序、分组和聚集函数;
3、合理使用表连接,尽量避免全表扫描;
4、优化查询条件,减少穷举;
5、合理使用索引;
6、使用SQL性能分析工具。
以上就是数据库性能优化的方法,有效的数据库性能优化可以改善系统应用的性能,维持数据库的稳定性和可靠性,使系统的更新和维护更加快捷安全。
数据库的查询优化方法分析
数据库的查询优化方法分析
赵云峰 甘建(玉溪师范学院信息技术工程学院)
摘要:本文主要探讨了在数据库的应用中对数据库查询优化的一些策
略,其中包括基于索引、SQL语句的优化的方法,并简要对其他一些常用方
法做了介绍。
关键词:数据库查询优化查询优化
0引言
随着计算机应用的深入,计算机技术的成熟,各种应用软件的
普及,应用数据也随着日常工作而迅速增长,作为数据仓库的数据
库的重要性也日益显著。
数据库系统作为管理信息系统的核心,各种基于数据库的联机
事务处理以及联机分析处理正慢慢的转变成为计算机应用的最为
重要的部分,根据以往大量的应用实例来看,在数据库的各种操作
中,查询操作所占的比重最大,而在查询操作中基于SELECT语句
在SQL语句中又是代价最大的语句。如果在使用中采用了优秀的查
询策略,往往可以降低查询的时间,提高查询的效率,由此可见查询
优化在数据库中的重要性。本文就数据库查询优化中的策略进行介
绍及探索。
1基于索引的优化
数据库的优化方法多种多样,不同的方法对提高数据库查询效
率也不相同。
索引作为数据库中的重要数据结构,它的根本目的就是为了提
高查询的效率。而优化查询的重要方法就是建立索引,建立适合关
系数据库系统的索引,这样就可以避免表扫描,并减少了因为查询
而造成的输入输出开销,有效提高数据库数据的查询速度,优化了
数据库性能。然而在创建索引时也增加了系统时间和空间的开销。
所以创建索引时应该与实际查询需求相结合,这样才能实现真正的
优化查询。
1.1判断并建立必要的索引对所要创建的索引进行正确的判
断,使所创建的索引对数据库的工作效率提高有所帮助。为了实现
这一点,我们应做到以下要求:在熟记数据库程序中的相关SQL语
句的前提下,统计出常用且对性能有影响的语句;判断数据库系统
中哪些表的哪些字段要建立索引。其次,对数据库中操作频繁的表,
数据流量较大的表,经常需要与其他表进行连接的表等,要进行重
云南信托_TCMP_TA_数据库性能优化方案(760)
云南信托数据库性能问题排查
【处理时间】 2015年05月25日 ~ 2015年06月10日
【客户名称】 云南信托
【主机信息】 IBM X3850 x5;Redhat 5.7 x86_64,oracle10.2.0.5 RAC ;RAM 64GB;ASM;
2 pyhsical 12 logical CPU Intel(R) Xeon(R) CPU E7- 4807 @ 1.87GHz
【处理人员】 周光晖
【问题说明】 现象:
接到云南信托客户反映数据库性能一直很慢。和同行业的其他客户相比数据库的处理能力很低。
要求恒生电子DBA介入查找原因,并给出相关建议。
事 件 分 析
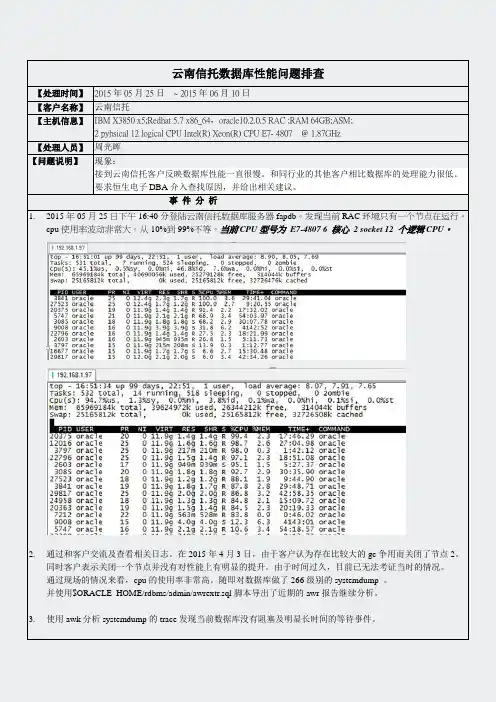
1. 2015年05月25日下午16:40分登陆云南信托数据库服务器fapdb。发现当前RAC环境只有一个节点在运行。cpu使用率波动非常大。从10%到99%不等。当前CPU型号为 E7-4807 6 核心 2 socket 12 个逻辑CPU。
2. 通过和客户交流及查看相关日志。在2015年4月3日,由于客户认为存在比较大的gc争用而关闭了节点2。同时客户表示关闭一个节点并没有对性能上有明显的提升。由于时间过久,目前已无法考证当时的情况。
通过现场的情况来看,cpu的使用率非常高。随即对数据库做了266级别的systemdump 。
并使用$ORACLE_HOME/rdbms/admin/awrextr.sql脚本导出了近期的awr报告继续分析。
3. 使用awk分析systemdump的trace发现当前数据库没有阻塞及明显长时间的等待事件。
4. 查看下午2:00~3:00及3:00~4:00的awr。
从load pfrofile中发现硬解析的比率略高一般建议每秒钟少于20次。过高的硬解析容易导致Cursor pin s on X,
library cache: mutex X , latch: row cache objects /shared pool等问题。
关系数据库之优化技术

关系数据库之优化技术
摘 要:关系数据库分为两类:一是桌面数据库,二是客户/服务器数据库。为了使得Oracle数据库在最理想的状态下运行,在信息系统开发之前首先要做的就是对数据库的最优策划,主要针对关系数据库的技术优化进行浅析。
关键词:关系数据库;优化技术
1 关系数据库概述
关系数据库分为两类:一是桌面数据库,例如Access,FoxPro和Dbase等;另一类是客户/服务器数据库,例如SQL?Server、Oracle和Sybase等。一般而言,桌面数据库用于小型的、单机的应用程序,它不需要网络和服务器,实现起来比较方便,但它只提供数据的存取功能;客户/服务器数据库主要适用于大型的、多用户的数据库管理系统,应用程序包括两部分:一部分驻留在客户机上,用于向用户显示信息及实现与用户的交互;另一部分驻留在服务器中,主要用来实现对数据库的操作和对数据的计算处理。
2 关系数据库技术优化策略
为了保证Oracle数据库运行在最佳的性能状态下,在信息系统开发之前就应该考虑数据库的优化策略。优化策略一般包括服务器操作系统参数调整、数据库参数调整、网络性能调整、应用程序SQL语句分析及设计等几个方面,其中应用程序的分析与设计是在信息系统开发。 分析评价Oracle数据库性能主要有数据库吞吐量、数据库用户响应时间两项指标。数据库用户响应时间又可以分为系统服务时间和用户等待时间两项,即:
数据库用户响应时间=系统服务时间+用户等待时间
因此,获得满意的用户响应时间有两个途径:一是减少系统服务时间,即提高数据库的吞吐量;二是减少用户等待时间,即减少用户访问同一数据库资源的冲突率。
为了使得Oracle数据库在最理想的状态下运行,在信息系统开发之前首先要做的就是对数据库的最优策划。最优策划一般包括对服务器操作系统参数调整(设置)、数据库参数调整(设置)、网络性能调整(设置)和应用程序SQL语句进行分析及设计等等方面。其中应用程序的分析与设计是在信息系统开发。
大型数据库的性能优化方法
计算机时代2010年第6期 ・ 33 ・
大型数据库的性能优化方法
黄明辉
(湖北三峡职业技术学院信息工程系,湖北宜昌443000)
摘要:因为大型数据库与小型数据库在数据量上有了质的突变,若要使系统达到最优化的性能并不是一件容易的
事。如果设计的数据库模型不够合理,不仅会增加客户端和服务器端程序的编程和维护的难度,而且会影响系统实际运
行的性能。文章从大型数据库设计与应用的不同阶段来分析比较数据库性能优化的相关技巧,给出了一些具体的优化
方法。
关键词:大型数据库;应用;性能;优化方法
Optimization Method of Large Database Performance
HUANG Ming—hui
(Dept.of Information Engineering,Hubei Three Gorges Polytechnic,Yichang,Hubei 443000,China)
Abstract:Compared with a small database,the data in a large database have a qualitative mutation,and it is not easy for the system to achieve optimum performance.If a designed database model is not reasonable enough.it will not only increase the dificulty in programming and maintaining the client and server,but also affect the practical running performance of the system. The related techniques of optimizing database performance are analyzed and compared from the diferent stages of large database design and application,and some specific optimization methods are given.
PAR平台数据库查询优化方案
2013年第1l期 计算机与现代化 JISUANJI YU XIANDAIHUA 总第219期
文章编号:1006—2475(2013)11-0058-03
PAR平台数据库查询优化方案
汤沁 ,薛锦云
(1.江西师范大学计算机信息工程学院,江西南昌330022;
2.江西师范大学江西省高性能计算技术重点实验室,江西南昌330022)
摘要:数据库系统的查询优化技术是提高数据库系统效率的重要技术。当今Java和c++等主流程序设计语言依靠SQL
语句,造成数据库系统中查询复杂、繁琐、效率低下、可靠性得不到保证等。针对上述问题,在PAR(Partition And Recur)
平台数据库关系代数实现机制基础上,提出和实现基于关系代数的查询优化规则设计方法。这种设计不仅提高了数据
库查询效率,也为高可靠数据库的形式化开发提供了依据。
关键词:查询优化;关系代数;PAR平台
中图分类号:TP311 文献标识码:A doi:10.3969/j.issn.1006—2475.2013.11.013
Query Optimization on PAR Database
TANG Qin ,XUE Jin.yun
(1.School of Computer&Information Engineering,Jiangxi Normal University,Nanchang 330022,China;
2.Key Izboratory of High Performance Computing Technology in Jiangxi Province,Jiangxi Normal University,Nanchang 33( ̄2,China)
Abstract:As the amount of data increases rapidly,the query efficiency of database decreases,and the system responds slowly. The design method on the PAR platform is proposed and achieved based on relational algebra query optimization rules.This de— sign not only improves the efficiency of database queries,but also provides a basis for the formal development of highly reliable database. Key words:query optimization;relational algebra;PAR platform
mysql高并发解决方案
mysql⾼并发解决⽅案
mysql⾼并发的解决⽅法有:
优化SQL语句,优化数据库字段,加缓存,分区表,读写分离以及垂直拆分,解耦模块,⽔平切分等。
⾼并发⼤多的瓶颈在后台,在存储mysql的正常的优化⽅案如下:
(1)代码中sql语句优化
(2)数据库字段优化,索引优化
(3)加缓存,redis/memcache等
(4)主从,读写分离
(5)分区表
(6)垂直拆分,解耦模块
(7)⽔平切分
⽅案分析:1、⽅法1个⽅法2是最简单,也是提升效率最快的⽅式。因为每条语句都命中了索引,是最⾼效的。但是如果是为了使sql达到最优⽽去建索引,那么索引就泛滥了,对于千万级以上的表来说,维护索引的成本⼤⼤增加,反⽽增加了数据库的内存的开销。2、数据库字段的优化。曾经发现⼀⾼级程序员在表字段的设计上,⼀个⽇期类型,被设计为varchar类型,不规范的同时,⽆法对写⼊数据校验,做索引的效率也有差别3、缓存适合读多写少更新频度相对较低的业务场景,否则缓存异议不⼤,命中率不⾼。缓存通常来说主要为了提⾼接⼝处理速度,降低并发带来的db压⼒以及由此产⽣的其他问题。4、分区不是分表,结果还是⼀张表,只不过把存放的数据⽂件分成了多个⼩块。在表数据⾮常⼤的情况下,可以解决⽆法⼀次载⼊内存,以及⼤表数据维护等问题。5、垂直拆分将表按列拆成多表,常见于将主表的扩展数据独⽴开,⽂本数据独⽴开,降低磁盘io的压⼒。
6、⽔平拆,⽔平拆分的主要⽬的是提升单表并发读写能⼒(压⼒分散到各个分表中)和磁盘IO性能(⼀个⾮常⼤的.MYD⽂件分摊到各个⼩表的.MYD⽂件中)。如果没有千万级以上数据,为什么要拆,仅对单表做做优化也是可以的;再如果没有太⼤的并发量,分区表也⼀般能够满⾜。所以,⼀般情况下,⽔平拆分是最后的选择,在设计时还是需要⼀步⼀步⾛。
基于MySQL的数据库性能优化研究
基于MySQL的数据库性能优化研究
一、引言
数据库作为现代信息系统的核心组成部分,承担着存储、管理和检索数据的重要任务。在众多数据库管理系统中,MySQL因其开源、稳定、易用等特点而备受青睐。然而,随着数据量的不断增加和业务需求的不断变化,数据库性能优化成为了每个数据库管理员和开发人员都需要面对的重要课题。本文将围绕基于MySQL的数据库性能优化展开研究,探讨如何通过合理的配置和优化手段提升数据库系统的性能表现。
二、数据库性能优化的重要性
数据库性能直接影响着系统的响应速度、并发处理能力以及用户体验。一旦数据库性能出现瓶颈,将导致系统运行缓慢甚至崩溃,严重影响业务正常运转。因此,对数据库进行性能优化显得尤为重要。
三、MySQL数据库性能优化策略
1. 硬件优化
在进行MySQL数据库性能优化时,首先需要考虑硬件方面的优化。包括但不限于: - 硬盘I/O性能:选择高速硬盘、RAID等技术提升磁盘读写速度。 - 内存配置:合理配置内存大小,提高缓存命中率。 -
CPU性能:选择高性能CPU,提升数据处理速度。 2. 数据库设计优化
良好的数据库设计是保证数据库性能的基础。在设计数据库时,应该遵循以下原则: - 合理规范化:避免数据冗余,减少数据更新异常。 - 适当索引:根据查询需求建立合适的索引,提高查询效率。 -
分表分库:对大表进行分割,减少单表数据量,提升查询速度。
3. 查询语句优化
SQL查询是数据库性能优化的关键环节。编写高效的查询语句可以显著提升数据库性能。在进行查询语句优化时,应该注意以下几点:
- 避免全表扫描:尽量使用索引字段进行查询,避免全表扫描。 - 合理使用JOIN操作:避免多表JOIN操作过多,影响查询效率。 - 限制返回结果集大小:只返回必要字段,避免返回过多数据。
4. 参数调优
MySQL提供了丰富的参数配置选项,通过调整这些参数可以有效提升数据库性能。常见的参数包括: - innodb_buffer_pool_size:设置InnoDB缓冲池大小。 - key_buffer_size:设置MyISAM索引缓冲区大小。 - query_cache_size:设置查询缓存大小。