
编译原理第三章答案
第3章 文法和语言
第1题
文法G=({A,B,S},{a,b,c},P,S)其中P为:
S→Ac|aB
A→ab
B→bc
写出L(G[S])的全部元素。
答案:
L(G[S])={abc}
第2题
文法G[N]为:
N→D|ND
D→0|1|2|3|4|5|6|7|8|9
G[N]的语言是什么?
答案:
G[N]的语言是V+。V={0,1,2,3,4,5,6,7,8,9}
N=>ND=>NDD.... =>NDDDD...D=>D......D
或者:允许0开头的非负整数?
第3题
为只包含数字、加号和减号的表达式,例如9-2+5,3-1,7等构造一个文法。
答案:
G[S]: S->S+D|S-D|D D->0|1|2|3|4|5|6|7|8|9
第4题
已知文法G[Z]:
Z→aZb|ab
写出L(G[Z])的全部元素。
答案:
Z=>aZb=>aaZbb=>aaa..Z...bbb=> aaa..ab...bbb
L(G[Z])={anbn|n>=1}
第5题
写一文法,使其语言是偶正整数的集合。 要求:
(1) 允许0打头;
(2)不允许0打头。
答案:
(1)允许0开头的偶正整数集合的文法 E→NT|D T→NT|D N→D|1|3|5|7|9 D→0|2|4|6|8
(2)不允许0开头的偶正整数集合的文法 E→NT|D T→FT|G N→D|1|3|5|7|9 D→2|4|6|8 F→N|0
G→D|0
第6题
已知文法G:
<表达式>::=<项>|<表达式>+<项>
<项>::=<因子>|<项>*<因子>
<因子>::=(<表达式>)|i
试给出下述表达式的推导及语法树。
(5)i+(i+i)
(6)i+i*i
第8题
文法G[S]为:
S→Ac|aB
A→ab
B→bc
该文法是否为二义的?为什么?
答案:
对于串abc
(1)S=>Ac=>abc (2)S=>aB=>abc
即存在两不同的最右推导。所以,该文法是二义的。
或者:
第10题
文法S→S(S)S|ε
(1) 生成的语言是什么?
(2) 该文法是二义的吗?说明理由。
答案:
(1) 嵌套的括号
(2) 是二义的,因为对于()()可以构造两棵不同的语法树。
第11题
令文法G[E]为:
E→T|E+T|E-T
T→F|T*F|T/F
F→(E)|i
证明E+T*F是它的一个句型,指出这个句型的所有短语、直接短语和句柄。
第14题
给出生成下述语言的上下文无关文法: (1){ anbnambm| n,m>=0} (2){ 1n0m 1m0n| n,
m>=0}
(3){WaWr|W属于{0|a}*,Wr表示W的逆}
答案:
(1) S→AA A→aAb|ε (2) S→1S0|A A→0A1|ε (3)
S→0S0|1S1|ε
第16题 给出生成下述语言的三型文法:
(1){an|n >=0 }
(2) { anbm|n,m>=1 }
(3){anbmck|n,m,k>=0 }
答案:
(1) S→aS|ε
(2) S→aA A→aA|B B→bB|b
(3) A→aA|B B→bB|C C→cC|ε
第18题
解释下列术语和概念:
(1) 字母表
(2) 串、字和句子
(3) 语言、语法和语义
答案:
(1) 字母表:是一个非空有穷集合。
(3)语言:它是由句子组成的集合,是由一组记号所构成的集合。程序设计的语言就是所
有该语言的程序的全体。语言可以看成在一个基本符号集上定义的,按一定规则构成的一切
基本符号串组成的集合。
语法:表示构成语言句子的各个记号之间的组合规律。程序的结构或形式。
语义:表示按照各种表示方法所表示的各个记号的特定含义。语言所代表的含义。
附加题
问题1:
给出下述文法所对应的正规式: S→0A|1B A→1S|1 B→0S|0
答案:
R = (01 | 10) ( 01 | 10 )*
问题2:
已知文法G[A],写出它定义的语言描述 G[A]: A → 0B|1C B → 1|1A|0BB C →
0|0A|1CC
答案:
G[A]定义的语言由0、1符号串组成,串中0和1的个数相同.
问题3:
给出语言描述,构造文法. 构造一文法,其定义的语言是由算符+, *, (,)和运算对象a构成
的算术表达式的集合.
答案一:
G[E] E→E+T|T T→T* F|F F→(E)|a
答案二:
G[E] E→E+E|E
*
E|(E)|a
问题4:
已知文法G[S]:
S→dAB
A→aA|a
B→ε|bB
相应的正规式是什么?G[S]能否改写成为等价的正规文法?
答案:
正规式是daa*b*;
相应的正规文法为(由自动机化简来):
G[S]:S→dA A→a|aB B→aB|a|b|bC C→bC|b
也可为(观察得来):G[S]:S→dA A→a|aA|aB B→bB|ε
问题5:
已知文法G:
E→E+T|E-T|T
T→T*F|T/F|F
F→(E)|i
试给出下述表达式的推导及语法树
(1) i;
(2) i*i+i
(3) i+i*i
(4) i+(i+i)
答案:
(1)E=>T=>F=>i
(2)E=>E+T=>T+T=>T*F+T=>F*F+T=>i*F+T=>i*i+T=>i*i+F=>i*i+i
(3)E=>E+T=>T+T=>F+T=>i+T=>i+T*F=>i+F*F=>i+i*F=>i+i*i
(4)E=>E+T=>T+T=>F+T=>i+T=>i+F=>i+(E)=>i+(E+T)=>i+(T+T)=>i+(F+T)
=>i+(i+T)=>i+(i+F)=>i+(i+i)
编译原理三、四章答案(清华版)

第三章习题解答6.每个表达式的推导及语法树分别如下:(1) <表达式>=> <项>=> <因子>=> i(2) <表达式>=> <项>=><因子>=>(<表达式>)=>(<项>)=>(<因子>)=>(i)(3) <表达式>=> <项>=><项>*<因子>=><因子>*<因子>=>i*<因子>=>i*i(4) <表达式>=> <表达式>+<项>=> <项>+<项>=> <项>*<因子>+<项>=> <因子>*<因子>+<项>=> i*<因子>+<项>=> i*i+<项>=> i*i+<因子>=> i*i+i(5) <表达式>=> <表达式>+<项>=> <项>+<项>=> <因子>+<项>=> i+<项>=> i+<因子>=>i+<表达式>=>i+(<表达式>+<项>)=> i+(<项>+<项>)=> i+(<因子>+<项>)=> i+(i+<项>)=> i+(i+<因子>)=>i+(i+i)(6) <表达式>=> <表达式>+<项>=> <项>+<项>=> <因子>+<项>=> i+<项>=> i+<项>*<因子>=> i+<因子>*<因子>=> i+i*<因子>=> i+i*i<表达式> <项> <因子>i<表达式><项><因子>()<表达式><项><因子>i<表达式><项>*<项><因子><因子>ii图(1)图(2)图(3)()<表达式><表达式><表达式><项>+<项>*<项><因子><因子>i<因子>ii <表达式><表达式><项>+<项><因子><因子>i<表达式><项>+<项><因子>i <因子>i图(4)图(5)<表达式><表达式><项>+<项><因子>i图(6)*<项><因子><因子>i i11.根据文法G 给定的规则,从文法的开始符E 出发可推导出E+T*F ,推导过程如下:E => E+T => E+T*F ,所以E+T*F 是该文法的一个句型。
编译原理练习答案蒋宗礼第三章
在整个分裂过程中,所有新结点均用不同的名字,保留 X 和 Y 为全图的唯一初态结点 和终态结点。至此,我们得到了一个非确定有限自动机M,
第二部分
例题与习题
重点与难点
重点:词法分析器的输入、输出,用于识别符号的状态转移图的构造,根据状态转移图实现 词法分析器。 难点:词法的正规文法表示、正规表达式表示、状态转移图表示,它们之间的转换。
l, d 初态 ① l
②
其它
终态
③
例 4 叙述下面的正规式描述的语言,并画出接受该语言的最简 DFA 的状态转换图。 * * (1|01) 0 【解】描述的语言是,所有不含子串 001 的 0 和 1 的串。
例 5 给定如下正规式 0(0|1)*1 (1) 写出相应的正规文法。 (2) 画出相应的状态转移图。 【解】 (1) 引入非终结符 S, A, S → 0(0|1)*1 →0A + + A →(0|1)*1→(ε | (0|1) )1→1| (0|1) 1→1| (0|1) (0|1)*1→1| 0A|1A 得到正规文法 G[S]: S 0A A 0A|1A|1 (2) (1)中给出的是一个右线性文法。 。 按照由右线性正规文法构造状态转换图的方法,构造相应的状态转移图如图 1
则(U|V) 、 (U·V)和(U)*也都是正规式,它们所表示的正规集分别为 L(U) ∪L(V)、 L (U) L (V)(连接积)和(L (U))*(闭包) 。 仅通过有限次使用上述三步骤定义的表达式才是∑上的正规式, 仅由这些正规式所表示 的字集才是∑上的正规集。 令 U、V 和 W 均为正规式,则下述关系成立: (1)U|V=V|U(交换律) (2)U|(V|W)=(U|V)W 或 U(VW)=(UV)W (结合律) (3)U(V|W)=UV|UW 或 (V|W)U=VU|WU(分配律) (4)ε U=Uε =U 若两个正规式所表示的正规集相同,则认为二者等价。 例如:b(ab)*=(ba)*b, (a|b)*=(a*b*)*。 注意: a*b*、(a|b)* 、(ab)* 、a*|b*相互都不等价,它们表示的含义如图所示
编译原理课后习题答案+清华大学出版社第二版
用以引用非局部(包围它的过程)变量时,寻找该变量的地址。 DL: 动态链,指向调用该过程前正在运行过程的数据段基地址,用以过程执行结束释放
数据空间时,恢复调用该过程前运行栈的状态。 RA: 返回地址,记录调用该过程时目标程序的断点,即调用过程指令的下一条指令的地
编译程序大致有哪几种开发技术?
答案:
(1)自编译:用某一高级语言书写其本身的编译程序。 (2)交叉编译:A 机器上的编译程序能产生 B 机器上的目标代码。 (3)自展:首先确定一个非常简单的核心语言 L0,用机器语言或汇编语言书写出它的编
译程序 T0,再把语言 L0 扩充到 L1,此时 L0⊂ L1 ,并用 L0 编写 L1 的编译程序 T1,再把语 言 L1 扩充为 L2,有 L1 ⊂ L2 ,并用 L1 编写 L2 的编译程序 T2,……,如此逐步扩展下 去, 好似滚雪球一样,直到我们所要求的编译程序。 (4)移植:将 A 机器上的某高级语言的编译程序搬到 B 机器上运行。
(main).
答案: 程序执行到赋值语句 b∶=10 时运行栈的布局示意图为:
1
《编译原理》课后习题答案第二章
第 3题 写出题 2 中当程序编译到 r 的过程体时的名字表 table 的内 容。
name
kind
level/val
adr
size
答案:
题 2 中当程序编译到 r 的过程体时的名字表 table 的内容为:
盛威网()专业的计算机学习网站
2
《编译原理》课后习题答案第一章
合实现方案,即先把源程序翻译成较容易解释执行的某种中间代码程序,然后集中解释执行 中间代码程序,最后得到运行结果。
编译原理第三版课后习题答案
编译原理第三版课后习题答案编译原理是计算机科学中的一门重要课程,它研究的是如何将高级程序语言转换为机器语言的过程。
而《编译原理》第三版是目前被广泛采用的教材之一。
在学习过程中,课后习题是巩固知识、提高能力的重要环节。
本文将为读者提供《编译原理》第三版课后习题的答案,希望能够帮助读者更好地理解和掌握这门课程。
第一章:引论习题1.1:编译器和解释器有什么区别?答案:编译器将整个源程序转换为目标代码,然后一次性执行目标代码;而解释器则逐行解释源程序,并即时执行。
习题1.2:编译器的主要任务是什么?答案:编译器的主要任务是将高级程序语言转换为目标代码,包括词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成等过程。
第二章:词法分析习题2.1:什么是词法分析?答案:词法分析是将源程序中的字符序列划分为有意义的词素(token)序列的过程。
习题2.2:请给出识别下列词素的正则表达式:(1)整数:[0-9]+(2)浮点数:[0-9]+\.[0-9]+(3)标识符:[a-zA-Z_][a-zA-Z_0-9]*第三章:语法分析习题3.1:什么是语法分析?答案:语法分析是将词法分析得到的词素序列转换为语法树的过程。
习题3.2:请给出下列文法的FIRST集和FOLLOW集:S -> aAbA -> cA | ε答案:FIRST(S) = {a}FIRST(A) = {c, ε}FOLLOW(S) = {$}FOLLOW(A) = {b}第四章:语义分析习题4.1:什么是语义分析?答案:语义分析是对源程序进行静态和动态语义检查的过程。
习题4.2:请给出下列文法的语义动作:S -> if E then S1 else S2答案:1. 计算E的值2. 如果E的值为真,则执行S1;否则执行S2。
第五章:中间代码生成习题5.1:什么是中间代码?答案:中间代码是一种介于源代码和目标代码之间的表示形式,它将源代码转换为一种更容易进行优化和转换的形式。
编译原理第三版答案
编译原理第三版答案第一章答案1.问题:什么是编译器?答案:编译器是一种将源程序转换为目标程序的软件工具。
它负责对源代码进行词法分析、语法分析、语义分析和代码生成等一系列操作,最终生成可执行的目标程序。
2.问题:编译器的主要任务是什么?答案:编译器的主要任务是将高级语言程序转换为能被计算机硬件执行的机器码。
它包括了对源代码进行词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成等过程。
3.问题:编译器的工作过程是什么?答案:编译器的工作过程分为多个阶段。
首先是词法分析,将源代码拆分成一个个的词法单元。
然后是语法分析,根据语法规则构建语法树。
接着是语义分析,对语法树进行检查,确保程序的语义正确。
之后是中间代码生成和优化,将语法树转换为更加高效的中间代码。
最后是目标代码生成,将中间代码转换为特定的目标机器代码。
4.问题:编译器的优化技术有哪些?答案:编译器的优化技术包括了常量折叠、公共子表达式消除、循环优化、函数内联和代码重排等。
这些技术可以提高程序的执行效率和优化代码的空间利用率。
5.问题:编译器的应用领域有哪些?答案:编译器广泛应用于软件开发领域。
它们被用于将高级语言转换为目标机器码,用于开发操作系统、编程语言和应用软件等。
第二章答案1.问题:什么是有限自动机(DFA)?答案:有限自动机是一种表示有限状态和状态之间转换关系的模型。
它可以根据输入字符进行状态转换,最终决定是否接受某个字符串。
2.问题:有限自动机的主要组成部分是什么?答案:有限自动机主要由状态集合、输入字符集、转移函数、初始状态和接受状态集合组成。
3.问题:什么是正则表达式?答案:正则表达式是一种用于描述字符串模式的表达式。
它由普通字符和特殊字符组成,可以用于匹配符合条件的字符串。
4.问题:正则表达式的常用操作符有哪些?答案:正则表达式的常用操作符包括了字面量字符、字符类、重复操作符、选择操作符和位置操作符等。
5.问题:正则表达式如何转换为有限自动机?答案:正则表达式可以通过字面化、连接、选择和闭包等操作转换为等价的有限自动机。
《编译原理教程》课后习题答案第三章语法分析
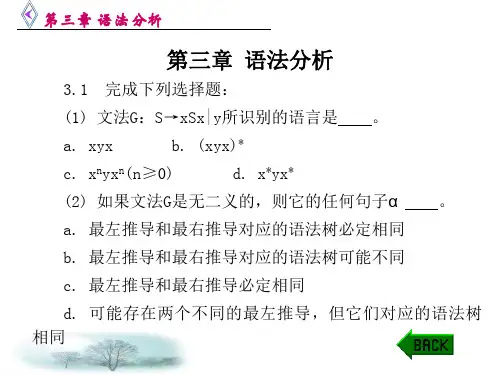
第三章 语法分析
3.10 已知文法G[A]: A→aABl|a B→Bb|d
(1) 试给出与G[A]等价的LL(1)文法G[A′]; (2) 构造G[A′]的LL(1)分析表; (3) 给出输入串aadl#的分析过程。 【解答】 (1) 文法G[A]存在左递归和回溯,故其不是 LL(1)文法。要将G[A]改造为LL(1)文法,首先要消除文法 的左递归,即将形如P→Pα | β 的产生式改造为 P→β P′ P→α P′| ε
对A′→ABl来说, FIRST(A)∩FOLLOW(A′)={a}∩{#,d}=Φ ,所以文法 G′[A]为所求等价的LL(1)文法。
第三章 语法分析
(2) 构造预测分析表的方法如下: ① 对文法G[A′]的每个产生式A→α 执行②、③ 步。 ② 对 每 个 终 结 符a∈FIRST(A) ,把 A→α 加 入 到 M[A,a]中,其中α 为含有首字符a的候选式或为唯一的 候选式。 ③ 若ε ∈FIRST(A),则对任何属于FOLLOW(A)的 终结符b,将A→ε 加入到M[A,b]中。把所有无定义的 M[A,a]标记上“出错”。 由此得到G[A′]的预测分析表,见表3-1。
c. 最左推导和最右推导必定相同
d. 可能存在两个不同的最左推导,但它们对应的语法树 相同
第三章 语法分析
(3) 采用自上而下分析,必须 。
a. 消除左递归
b. 消除右递归
c. 消除回溯
d. 提取公共左因子
(4) 设a、b、c是文法的终结符,且满足优先关系 ab和bc,则 。
编译原理第3章 习题解答
第3章习题解答1.构造正规式1(0|1)*101相应的DFA.[答案]先构造NFA确定化0 1X AA A ABAB AC ABAC A ABYABY AC AB重新命名,令AB为B、AC为C、ABY为D0 1X AA A BB C BC A DD C B转化成DFA:============================================================== 2.将下图确定化:[答案]0 1S VQ QUVQ VZ QUQU V QUZVZ Z ZV ZQUZ VZ QUZZ Z Z重新命名,令VQ为A、QU为B、VZ为C、V为D、QUZ为E、Z为F。
0 1S A BA C BB D EC F FD FE C EF F F转化为DFA:================================================================ 3.把下图最小化:[答案](1)初始分划得Π0:终态组{0},非终态组{1,2,3,4,5}对非终态组进行审查:{1,2,3,4,5}a {0,1,3,5}而{0,1,3,5}既不属于{0},也不属于{1,2,3,4,5} ∵{4} a {0},所以得新分划 (2)Π1:{0},{4},{1,2,3,5} 对{1,2,3,5}进行审查: ∵{1,5} b {4}{2,3} b {1,2,3,5},故得新分划 (3)Π2:{0},{4},{1, 5},{2,3} {1, 5} a {1, 5}{2,3} a {1,3},故状态2和状态3不等价,得新分划 (3)Π3:{0},{2},{3},{4},{1, 5} 这是最后分划了 (4)最小DFA :======================================= 4.构造一个DFA ,它接收Σ={0,1}上所有满足如下条件的字符串:每个1都有0直接跟在右边。
《编译原理教程》习题解析与上机指导(第四版) 第三章
B.一个非终结符
C.多个终结符
D.多个非终结符
(20) LL(1)分析表需要预先定义和构造两族与文法有关的集
合。
A.FIRST和FOLLOW
B.FIRSTVT和FOLLOW
C.FIRST和LASTVT
D.FIRSTVT和LASTVT
(21) 设a、b、c是文法的终结符且满足优先关系ab和bc,则 。
D.翻译过程
(12) 规范归约中的“可归约串”由 定义。
A.直接短语
B.最右直接短语
C.最左直接短语
D.最左素短语
(13) 规范归约是指 。
A.最左推导的逆过程
B.最右推导的逆过程
C.规范推导
D.最左归约的逆过程
(14) 文法G[S]:S→aAcB | Bd
A→AaB | c
B→bScA | b
则句型aAcbBdcc的短语是 。
A.Bd
B.cc
C.a
D.b
(15) 文法G[E]:E→E+T | T
T→T*P | P
P→(E) | i
则句型P+T+i的句柄和最左素短语是 。
A.P+T和T
B.P和P+T
C.i和P+T+i
D.P和P
(16) 采用自顶向下分析,必须 。
A.消除左递归
B.消除右递归
C.消除回朔
D.提取公共左因子
(17) 对文法G[E]:E→E+S | S
满足ab、a⋖b和a⋗b三种关系之一 D.文法可存在…QR…的句型且任何终结符对(a,b)满足
ab、a⋖b和a⋗b三种关系
(23) 任何算符优先文法 优先函数。
编译原理(第三版)第3章课后练习及参考答案中石大版
第3章练习P47作业布置:P47 4 ,9,11,14(1)4、已知文法G[Z]:(1)Z::=aZb (2)Z::=ab写出L(G[Z])的全部元素解:L(G[Z])={a n b n,n>=1}9、考虑下面的上下文无关文法:S→SS* | SS+ | a(1)表明通过此文法如何生成串aa+a*,并为该串构造语法树(2)该文法生成的语言是什么?解:(1)推导过程见语法树。
语法树如下(2)该文法生成的语言为用递归逆波兰式表示的运算式。
逆波兰式是将运算对象写在前面,把运算符写在后面。
11、G[E]:E→T|E+T|E-TT→F|T*F|T/FF → (E)|i证明E+T*F 是它的一个句型,指出这个句型的所有短语、直接短语和句柄。
解:可为E+T*F 构造一棵语法树(见下图),所以它是句型。
从语法树中容易看出,E+T*F 的短语有:T*F 是句型E+T*F 的相对于T 的短语,也是相对于规则T →T*F 的直接短语。
E+T*F 是句型E+T*F 的相对于E 的短语。
句型E+T*F 的句柄(最左直接短语)是T*F 。
14、给出生成下述语言的上下文无关文法:(1){a n b n a m b m |n,m>=0}(2){1n 0m 1m 0n |n,m>=0}(3){WaW r |W 属于{0|a}*,W r 表示W 的逆}解:(1)所求文法为G[S]=({S,A},{a,b},P,S),其中P 为:S →AA A →aAb|ε (2)所求文法为G[S]=({S,A},{0,1},P,S),其中P 为: S →1S0|AA →0A1|ε(3)W 属于{0|a}*是指W 可以的取值为{ε,0,a,00,a0,aa0,00aa,a0a0,…}E E + T T * F如果W=aa0a00,则W r=00a0aa。
所求文法为G[S]=({S,P,Q},{0,a},P,S),其中P为:S 0S0|aSa|a。
编译原理(龙书)习题答案(chap2-3)
状态
a
b
-A{0}
B
A
B{0,1}
B
C
C{0,2}
B
D
+D{0,3}
E
D
+E{0,1,3} E
F
+F{0,2,3} E
D
DFA的状态图:
1) a(a | b) * a
以a开头和结尾且至少包含两个字符的a,b字符串的集合
2) (( | a)b*)*
由a和b组成的任意字符串的集合
3) (a | b)*a(a | b)(a | b)
倒数第三个字符为a的任意的a,b字符串的集合
4) a*ba*ba*ba*
包含3个b的a,b字符串的集合
5)(aa | bb)*((ab | ba)(aa | bb)*(ab | ba)(aa | bb)*)*
由相同数目的a和b组成的字符串的集合,或者空串
5) S a | S S | S S | S| ( S )
以a为变量,包括+,连接,*和括号四种运算的表 达式的集合
2.2.3 练习2.2.2中哪些文法具有二义性? 3) 4) 5)具有二义性。 以5)为例进行说明: 给定字符串 a+a+a ,对应着两棵分析树:
DFA的转换表:
状态
ห้องสมุดไป่ตู้
a
b
+A{0,1,2,3,5,6,7,9,10,11} B
C
+B{1,2,3,4,5,6,7,9,10,11} B
C
+C{1,2,3,5,6,7,8,9,10,11} B
C
DFA的状态图:
4) (a | b)*abb(a | b)*