
NCBI简介及序列编号说明
一:NCBI简介
NCBI的GenBank与DDBJ(DNA Data Bank of Japan)、EMBL的EBI数据库共同组成国际DNA 数据库,每日都交换更新数据和信息,并主持两个国际年会-国际DNA数据库咨询会议和国际DNA数据库协作会议,互相交换信息,因此三个库的数据实际上是相同的。
GenBank 有来自于70,000多种生物的核苷酸序列。
每条纪录都有编码区(CDS)特征的注释,还包括氨基酸的翻译。
(是美国国家生物技术信息中心(National Center for Biotechnology Information ,NCBI)建立的DNA序列数据库,从公共资源中获取序列数据,主要是科研人员直接提供或来源于大规模基因组测序计划( Benson等,1998)。
Entrez 是美国国家生物技术信息中心所提供的在线资源检索器。
该资源将GenBank序列与其原始文献出处链接在一起。
Entrez 是由NCBI主持的一个数据库检索系统。
它包括核酸,蛋白以及Medline文摘数据库,在这三个数据库中建立了非常完善的联系。
因此,可以从一个DNA序列查询到蛋白产物以及相关文献,而且,每个条目均有一个类邻(neighboring)信息,给出与查询条目接近的信息。
)
DDBJ主要向研究者收集DNA序列信息并赋予其数据存取号,信息来源主要是日本的研究机构,亦接受其他国家呈递的序列。
EBI的主要任务:⑴为科学界建立和维护生物学数据库,提供免费的数据和生物信息服务,支持生物学数据的存储和挖掘,促进科技进步;⑵通过生物信息学的基础研究继续推动生物学发展;⑶为各个层次的科学工作者提供生物信息学培训;⑷支持帮助边缘尖端科技成果向工业界的转化;⑸协调欧洲生物数据的提供。
RefSeq是NCBI数据库的参考序列。
RefSeq资料库是NCBI将GenBank的序列再做详细整理的non-redundent序列资料库,它的序列格式和GenBank几乎完全相同,但因为是完全不同的独立资料库,为与GenBank区别,RefSeq的Accession Number格式和GenBank不同。
二:常用序列编号
一般来说,mRNA和基因组序列是我们主要的寻找对象。
如果想找标准序列的话,mRNA用NM_开头的,基因组用NC_或者AC_开头的。
1. mRNA
NM_表示标准序列, 为转录产物序列;成熟mRNA转录本序列。
XM_表示预测的蛋白编码序列;mRNA来自基因组注释,序列相当于基因组重叠群。
大多数属于预测的。
NR_表示非编码的转录子序列,包括结构RNAs,假基因转子等。
2. 基因组
NC_完整的基因组分子序列,标记的类别包括基因组、染色体、细胞器、质粒。
AC_一些可供选择的注释的基因组序列,主要用来标记病毒和原核生物。
三:ACCESSION编号
ACCESSION是NCBI序列数据中我们常用到编号(另一个是GI)。
ACCESSION形式为CC_#####,其中CC 为两个字母,其不同组合又可以区分为蛋白序列、核酸序列或基因组序列,而#为位数不等的数字;ACCESSION 后面又会加版本号,以CC_####.#形式表示,最后的尾数递增表示序列信息较之前的版本有所修改。
这样ACCESSION+版本号就是一个唯一的表示,代表一个唯一的序列,而且这个编号不会改变。
1)AC_***:genomic mixed,一些可供选择的注释的基因组序列,主要用来标记病毒和原核生物;
2)AP_***:protein mixed,AC_标记序列对应的蛋白产物;
3)NC_***:genomic mixed,完整的基因组分子序列,标记的类别包括基因组、染色体、细胞器、质粒;4)NG_***:genomic mixed,不完整的基因组区域,提供NCBI基因组注释途径。
比较有代表性有不转录的假基因或者哪些很难自行化注释的基因组簇;
5)NM_***:mRNA mixed,转录组产物序列;成熟mRNA转录本序列;
6)NP_***:protein mixed,蛋白产物;主要是全长转录氨基酸序列,但也有一些只有部分蛋白质的部分氨基酸序列;
7)NR_***:RNA mixed,非编码的转录子序列,包括结构RNAs,假基因转子等;
8)NT_***:genomic automated,BAC或者鸟枪测序法的还未完全注释的测序序列;
9)NW_***:genomic automated,BAC或者鸟枪法测序的还未完全注释的测序序列;
10)NZ_ABCD1234***:genomic automated,收集的各种利用鸟枪法测序的测序计划,ABCD代表的是计划名称;
11)XM_***:mRNA automated,转录产物;mRNA来自基因组注释,序列相当于基因组重叠群;
12)XP_***:protein automated,蛋白产物;序列相当于基因组重叠群;
13)XR:RNA automated,转录产物;非编码区来自基因组注释,序列相当于基因组重叠群;
14)YP_***:protein mixed,蛋白产物;不涉及到转录组,主要用来标记细菌、病毒和线粒体;
15)ZP_***:protein automated,蛋白产物;主要是用电脑自动注释;
16)NS_***:genomic automated,未知生物分子基因组序列。
在前面介绍了一些常见序列的accession号,其实在NCBI中还有很多accession号,仅与RNA相关的就有116种,这里各举一个例子供参考。
不同的编码代号代表不同的意思,如NM_开头的表示标准序列,XM_表示预测的蛋白编码序列,NR_表示非编码蛋白的mRNA序列,AF开头的表示克隆序列,BC开头的表示模板序列。
四:GI编号:
GI编号是NCBI网站的所有序列相关数据库的流水编号,其最有用的特征就是唯一性。
对于每一条递交给NCBI的序列,都会付给一个编号,而且这个编号对应的序列不可更改。
这个编号对应这个唯一的一条序列,类似与我们用的身份证号。
因此,利用GI在NCBI中查询时,你只要把数据库(蛋白质/核苷酸)选对,只要输入这个号码就可以把相应的序列调出来。
值得一提的是登录号(Accession Number)。
每一个递交的序列,除了获得一个GI号,还会被赋予一个登录号。
递交序列的作者利用登录号对序列进行修改和完善。
每一次修改的序列会获得一个新的GI号,登录号不变,但会追加一个流水的版本号。
因此,GI号和带版本号的登录号都唯一定位到唯一条序列。
(LOCUS出现在GenBank中的LOCUS行以及DDBJ记录(EMBL的ID行)是GenBank中最初的辨识器。
由于使用LOCUS(或ID)名称作为对核酸序列唯一辨识器的困难,国际核酸序列数据库合作者们(DDBJ/EMBL/GenBank)引入了序列号。
NCBI给每个记录赋予一个gi(geninfo)标识符。
这意味着翻译产物蛋白质序列(不是简单附属于DNA记录,如同在GenBank记录中显示的),也有自己的gi号码。
一个特定的标识符当且仅当序列更改时才更改。
NID行是核苷酸序列的gi号码(geninfo identifier)前缀字母(d,e或g)表明是哪一个数据库生成了这个号码,或这一号码用于哪个数据库。
因为NCBI首先使用了这个号码,所以DDBJ和EMBL用NCBI(GenBank)指定的号码来填充他们的数据库。
简单地说,一个gi号码对应于一个核酸序列(蛋白质序列也有gi号码)。
当序列改变时,gi号码也改变,但检索号码不变。
在形式上,它只是简单的整数(所以有时被称为GI号)。
它只是一
些特定序列的辨识器。
假定一个序列加入GenBank,给定序列号U00001。
当该序列在NCBI所内部处理时,它加入所谓的ID数据库。
ID确认以前从未见过U00001,就给它一个gi号54。
当提交器通过改变出处修改记录时,U00001又加入ID。
ID认出该记录出现过,恢复原先的U00001和新记录进行比较,如果完全相同,则给该记录gi号54;如果不相同,即使只有一对碱基不同,则给新gi号88。
然而因为原数据库的意义,新序列仍保持序列号U00001。
这时ID标识旧记录(gi54)的替换时间,并将它加入历史指示它被gi88的记录替代。
ID也加入历史gi88指出它替代了gi54。
序列号是对LOCUS/ID 号的改进,但实际使用中,问题和不足是显然的。
例如,当序列对于时间是稳定时,许多使用者发现用相同的序列号复现出的序列并不总是相同的。
这是因为序列号标明了整个数据库的记录,一旦记录被修改了(或者说从开始部分插入了1000bp)的时候,序列号不变(只是相同记录的升级版)。
如果我们分析起始序列和记录序列U00001的第100个位置假设是与蛋白质相关的位点,升级后一个完全不同的序列将在第100个位置上。
所以,在GENEBANK中的LOCUS行就相当于DDBJ2或EMBL中的ID行,ID号是永恒不变的,而gi号码在序列改变时则会被指派新的gi号码,相应地其多肽段的gi号码也会相应地发生改变。
)。
最新NCBI数据库检索资料讲解

一、PubMed数据库简介
PubMed是美国国家医学图书馆(NLM)下属的国家 生物技术信息中心(NCBI)开发的、基于WWW的医 学数据库查询系统。
PubMed的网址: /pubmed /entrez/query.fcgi
NCBI中通过Entrez可互查的数据库
NCBI数据库
Nucleotide:DNA序列数据库 Protein:蛋白质序列数据库 Genome:基因组序列数据库 Structure:分子结构模型数据库 Popset:种群、种系发生或突变序列数据库 Taxonomy:微生物类别数据库 OMIM:人类孟德尔遗传学在线数据库。
一. Nucleotide(GenBank)
该数据库由国际核苷酸序列数据库成
员 美 国 国 立 卫 生 研 究 院 GenBank 、 日 本 DNA数据库(DDBJ)和英国Hinxton Hall的 欧洲分子生物学实验室数据库(EMBL)三
部分数据组成。
二 . Genome
即基因组数据库,提供了多种 基因组、完全染色体、临近序列图 谱以及一体化基因物理图谱。
包含研究一个人群、一个种系发生 或描述人群变化的一组组联合序列。 PopSet既包含核酸序列数据又包含蛋白 质序列数据。
六. OMIM
孟德尔遗传学(OMIM)数据库是人类 基因和基因疾病的目录数据库。该数据 库括原文信息、图片和参考信息,同 时还可以链接到Entrez系统MEDLINE数 据库中相关文献和序列信息。
Tax & Accounting
Scientific
Healthcare
11,500 Employees 9,900 Employees 4,400 Employees 3,100 Employees 2,600 Employees 2,800 Employees
ncbi介绍

• 在1992年10月,NCBI承担起对GenBank DNA 序列数据库的责任。NCBI受过分子生物学高 级训练的工作人员通过来自各个实验室递交的 序列和同国际核酸序列数据库(EMBL和DDBJ) 交换数据建立起数据库。同美国专利和商标局 的安排使得专利的序列信息也被整合。 GenBank是NIH遗传序列数据库,一个所有可 以公开获得的DNA序列的注释过的收集。 GenBank同日本和欧洲分子生物学实验室的 DNA数据库共同构成了国际核酸序列数据库合 作。这三个组织每天交换数据。
向GenBank提交数据 · 关于提交序列数据,收到 accession number,和对 纪录作更新的一般信息。 · BankIt - 用于一条或者少数条提交的基于WWW的 提交工具软件。(请在提交前用 VecScreen 去除载 体) · Sequin - 提交软件程序,用于一条或者很多条的 提交,长序列,完整基因组,alignments,人群/种 系/突变研究的提交。可以独立使用,或者用基于 TCP/IP的"network aware"模式,可以链接到其他 NCBI的资源和软件比如Entrez和PowerBLAST。 (请在提交前用VecScreen去除载体)
NCBI提供的附加的软件工具
• 开放阅读框寻觅器(ORF Finder),电子 PCR,和序列提交工具,Sequin和BankIt。 所有的NCBI数据库和软件工具可以从 WWW或FTP来获得。 NCBI还有E-mail服务器,提供用文 本搜索或序列相似搜索访问数据库一种 可选方法。
教育和训练
• NCBI通过赞助会议,研讨会,和系列 演讲来培养在应用于分子生物学和遗传 学的计算机领域的科学交流。一个科学 访问学者项目已经成立,来培养同外部 科学家的合作。作为NIH内部的部分研究 项目,也提供博士后工作位置。 •
NCBI中RefSeq各种accession说明
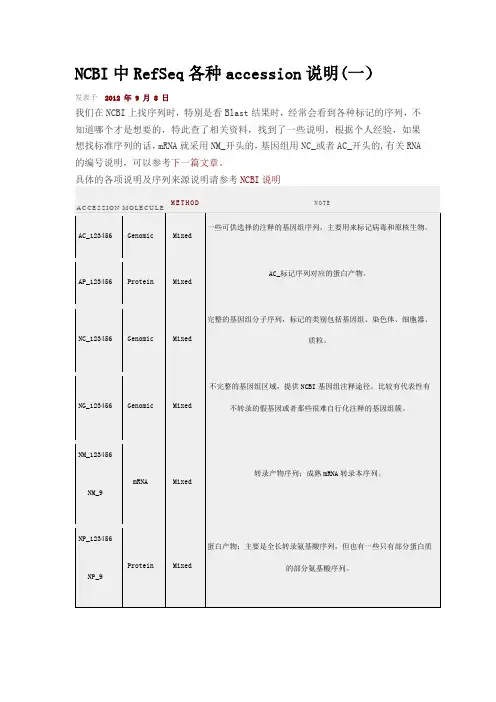
XR_123456
RNA Automated 转录产物;非编码区来自基因组注释,序列相当于基因组重叠群。
YP_123456
YP_9
Protein Mixed
蛋白产物。不涉及到转录,主要用来标记细菌、病毒和线粒体。
ZP_
Protein Automated
蛋白产物,主要是用电脑自动注释。
NS_123456 Genomic Automated
未知生物分子基因组序列。
此条目由 yuyin110 发表在 NCBI、公共数据库 分类目录,并贴了 accession、NCBI、
NM_、RefSeq 标签。将固定链接加入收藏夹。 感谢你们的整理!
NG_123456 Genomic
Mixed
不完整的基因组区域,提供 NCBI 基因组注释途径。比较有代表性有 不转录的假基因或者那些很难自行化注释的基因组簇。
NM_123456
NM_9
mRNA
Mixed
转录产物序列;成熟 mRNA 转录本序列。
NP_123456
NP_9
Protein
Mixed
蛋白产物;主要是全长转录氨基酸序列,但也有一些只有部分蛋白质 的部分氨基酸序列。
METHOD
ACCESSION MOLECULE
NOTE
AC_123456 Genomic
Mixed
一些可供选择的注释的基因组序列,主要用来标记病毒和原核生物。
AP_123456 Protein Mixed
AC_标记序列对应的蛋白产物。
NC_123456 Genomic
Mixed
完整的基因组分子序列,标记的类别包括基因组、染色体、细胞器、 质粒。
NZ_ABCD
ncbi的核酸序列

ncbi的核酸序列NCBI的核酸序列是一个研究者和科学家最重要的数据资源之一。
它们能够帮助科学家们更好地理解生命的运作,发现生物的潜在的特征和基因的表达方式。
NCBI的核酸序列也被用来发现新的基因、寻找新的基因型、以及研究基因表达的变化。
因此,NCBI的核酸序列在生物学研究中发挥着不可或缺的作用。
NCBI的核酸序列是由一系列核酸分子连续排列而成。
这些核酸分子可以是RNA或DNA,它们代表着一系列遗传信息,涉及基因和蛋白质的表达。
这些序列记录了基因在生物细胞中的结构和功能,并且也提供了有关基因组中基因结构和序列的重要信息。
NCBI也提供了一个在线的基因库,研究者可以通过它来获取DNA 和RNA的序列数据,它们可以用来鉴定基因序列、了解基因的特性以及基因的表达谱。
在这个基因库中,研究者可以搜索到许多种类的数据,比如基因表达谱、基因组分析、染色体图谱和其他相关数据。
这些基因库中的数据是 NCBI究者使用的重要资源,它们能够帮助研究者们深入理解基因的结构、功能和表达谱。
此外,NCBI的核酸序列还可以用来识别特定的基因组成分,以及研究不同样品中的表达差异。
这对于对特定基因的精确鉴定和分析是非常有用的,从而帮助我们更好地理解基因和蛋白质的表达谱及其在人类生态系统中的作用。
NCBI的核酸序列能够有效地帮助研究者们进行生物学研究,从而深入地了解基因特征、影响其表达方式以及与疾病发生有关的基因组成。
这样,它们也可以更好地帮助我们针对慢性疾病开发有效的疗法和护理策略,以期促进人类的健康。
总的来说,NCBI的核酸序列是研究者和科学家最重要的数据资源之一,他们能够从中获取有关基因的结构和功能的重要信息,并且还能够帮助我们更好地理解慢性疾病的发生机制、预防疾病发生以及发现新的护理策略,以期改善人类的健康。
ncbi使用指导

ncbi使用指导摘要:一、NCBI简介1.NCBI的定义与作用2.NCBI的主要数据库二、NCBI数据库的使用1.基因数据库1.1 基因序列数据库1.2 基因表达数据库1.3 基因调控数据库2.蛋白质数据库2.1 蛋白质序列数据库2.2 蛋白质结构数据库3.核酸序列数据库3.1 核酸序列数据库概述3.2 核酸序列数据库的使用方法4.文献数据库4.1 PubMed简介4.2 如何利用PubMed进行文献检索三、NCBI工具的使用1.基因芯片数据分析工具2.基因序列比对工具3.蛋白质结构预测工具四、NCBI的进阶使用技巧1.如何利用NCBI进行基因注释2.如何利用NCBI进行基因家族分析3.如何利用NCBI进行共表达网络分析正文:一、NCBI简介CBI(National Center for Biotechnology Information,美国国家生物技术信息中心)是一个提供生物信息学资源的网站,它为全球科研工作者提供了大量的生物学数据和工具。
NCBI的主要数据库包括基因数据库、蛋白质数据库、核酸序列数据库和文献数据库等。
二、NCBI数据库的使用1.基因数据库基因数据库包括基因序列数据库、基因表达数据库和基因调控数据库。
基因序列数据库提供了大量的基因序列信息,用户可以通过关键词搜索、序列相似性搜索等方式找到需要的基因序列。
基因表达数据库则提供了基因在不同生物体、不同组织、不同发育阶段的表达信息。
基因调控数据库则包含了基因调控相关的信息,如启动子、转录因子结合位点等。
2.蛋白质数据库蛋白质数据库包括蛋白质序列数据库和蛋白质结构数据库。
蛋白质序列数据库提供了蛋白质的氨基酸序列信息,用户可以通过序列相似性搜索找到相似的蛋白质序列。
蛋白质结构数据库则提供了蛋白质的三维结构信息,用户可以通过结构域、功能域等关键词搜索需要的蛋白质结构。
3.核酸序列数据库核酸序列数据库包括DNA序列数据库和RNA序列数据库。
ncbi使用指导

ncbi使用指导【原创版】目录1.NCBI 的概述2.NCBI 的使用方法3.NCBI 的数据库资源4.NCBI 的实用工具5.NCBI 的注意事项正文CBI(National Center for Biotechnology Information)是美国国家生物技术信息中心的缩写,是一个提供生物学和医学信息的数据库和工具的官方网站。
该网站由美国国家卫生研究院(NIH)建立,旨在为科学家、医生、研究人员和学生提供免费的生物学和医学信息。
以下是 NCBI 的使用指导:一、NCBI 的概述CBI 提供了多种数据库资源和实用工具,包括基因序列、蛋白质序列、基因组信息、生物学文献等。
这些资源对于生物学和医学研究非常重要。
二、NCBI 的使用方法1.访问 NCBI 的官方网站:https:///2.在主页上,你可以看到 NCBI 提供的各种数据库和工具的链接。
你可以点击链接进入相应的数据库或工具页面。
3.在数据库或工具页面,你可以使用各种搜索框和过滤器来查找你需要的信息。
例如,在基因序列数据库中,你可以输入基因名称或序列号来查找相关的基因序列信息。
三、NCBI 的数据库资源1.基因序列数据库(GenBank):提供了全球各种生物的基因序列信息。
2.蛋白质序列数据库(Protein Database):提供了全球各种生物的蛋白质序列信息。
3.基因组数据库(Genome Database):提供了全球各种生物的基因组信息。
4.生物学文献数据库(PubMed):提供了全球生物学和医学领域的文献信息。
四、NCBI 的实用工具1.BLAST(Basic Local Alignment Search Tool):用于比较基因序列或蛋白质序列的相似性。
2.Entrez:用于在 NCBI 的数据库中搜索和获取相关的生物学信息。
3.Coffee Break:用于查看和下载基因序列或蛋白质序列的图片。
五、NCBI 的注意事项1.在使用 NCBI 的数据库和工具时,请遵守相关的知识产权和版权规定。
ncbi使用指导
ncbi使用指导摘要:一、NCBI简介1.NCBI的定义和作用2.NCBI的主要数据库二、NCBI数据库使用指导1.基因数据库a.基因序列数据库b.基因表达数据库2.蛋白质数据库a.蛋白质序列数据库b.蛋白质结构数据库3.核酸数据库a.核酸序列数据库b.核酸变异数据库4.文献数据库a.PubMedb.基因组数据库三、NCBI工具使用指导1.BLAST2.Entrez3.RefSeq4.dbSNP四、NCBI的高级功能1.基因变异分析2.基因表达数据分析3.蛋白质结构预测正文:CBI(National Center for Biotechnology Information,美国国家生物技术信息中心)是一个提供生物信息学资源的公共数据库,为全球科研人员提供免费的生物信息学资源。
NCBI的主要数据库包括基因数据库、蛋白质数据库、核酸数据库和文献数据库。
在基因数据库方面,NCBI收录了大量基因序列数据,包括基因组、转录组、单细胞测序等。
此外,还提供了基因表达数据库,可以查询基因在不同组织、不同发育阶段、不同生理条件下的表达水平。
在蛋白质数据库方面,NCBI收录了大量的蛋白质序列和结构信息。
蛋白质序列数据库包括TrEMBL、Swiss-Prot等,结构数据库包括PDB(Protein Data Bank)。
在核酸数据库方面,NCBI收录了大量的核酸序列数据,包括基因组、转录组、突变组等。
此外,还提供了核酸变异数据库,包括SNP(单核苷酸多态性)、CNV(拷贝数变异)等变异信息。
在文献数据库方面,NCBI提供了PubMed,这是一个收录了大量生物医学相关文献的数据库。
此外,还有基因组数据库和dbSNP等特殊文献数据库。
为了方便用户使用这些数据库,NCBI提供了一系列工具。
其中,BLAST (Basic Local Alignment Search Tool)是一种用于序列比对的算法,可以帮助用户找到相似的序列。
ncbi数据库检索解读
收集并储存大分子结构信息,部分来源于PDB
提供并及时更新后生生物的全基因组序列以及最为精确的注释. 是一个蛋白质信息最为准确的蛋白质数据库, 它所提供的蛋白质信息有着最详尽的注释和 最少的冗余..
5 UniProtKB\Swiss-prot
2.2.4 SRS 检索实例
已知BPMV的名字,查询其基因组的信息,核酸序 列信息,蛋白质序列信息和结构信息
第二章 数据库检索
2.1 综合性数据库 NCBI
2.1.1 NCBI简介
美国参议员Claude Pepper率先意识到信息计算机化过程 方法对指导生物医学研究的重要性,发起了在1988年11月4日 建立国立生物技术信息中心的立法. (National Center for Biotechnology Information , NCBI) . NCBI隶属于国立医学图书馆( National Library of Medicing, NLM)。NLM在创立和维护生物医学数据库方面有 丰富的经验。
包含用于群体进化或变异研究的比对序列
准确的基因表达谱数据和大规模的分子实验数据
公众医学信息中心,是NLM在生命科学领域 Central数据库 期刊文献的数字存档 医学主题5 Bookshelf 数据库
16 OMIM 数据库
主要着眼于可遗传或遗传性的基因疾病,包括文献, 序列记录,染色体定位图谱及相关的数据库的链接
7 uniSTS数据库 8 基因数据库 9 UniGene数据库
可通过基因名称,同义词,编号,出版物,染色体号等属性 寻找基因 GenBank 中基因序列的集合
10 SNP数据库 11 PopSet 12 GEO数据库 13 PubMed
用于存储包括单核苷酸替换,一两个碱基的插入 或缺失等多态性信息
NCBI_功能详细介绍
NCBI_功能详细介绍NCBI(National Center for Biotechnology Information,国家生物技术信息中心)是一个提供生物医学和基因组学研究数据的资源库和数据库。
NCBI的主要目标是促进和推动生物医学研究的发展,并为科学家、医生和公众提供相关信息。
NCBI提供了各种各样的数据库和工具,用于存储、检索和分析生物医学和基因组学数据。
下面是一些NCBI提供的主要功能的详细介绍:2. GenBank:GenBank是一个基因序列数据库,存储了全球范围内的基因序列数据。
研究人员可以通过GenBank获得基因序列和相关信息,用于基因功能研究、进化分析和生物信息学研究。
3. BLAST:BLAST(Basic Local Alignment Search Tool)是一种常用的序列比对工具,用于比对给定的DNA、RNA或蛋白质序列与NCBI数据库中的序列。
BLAST可以帮助研究人员确定新序列的相关性,并找到与其相似的序列。
4. Entrez:Entrez是一个综合性的引擎,可以对NCBI的不同数据库进行全文。
研究人员可以通过Entrez进行文献检索、基因和蛋白质注释、序列比对等操作,方便地获取各类生物学数据。
5. PubChem:PubChem是一个化学物质数据库,存储了数百万种化合物的化学结构和相关信息。
研究人员可以通过PubChem化合物的属性、药理学和毒理学数据,以及相关的文献信息。
6. OMIM:OMIM(Online Mendelian Inheritance in Man)是一个遗传疾病数据库,提供了人类遗传疾病的基因和表型信息。
研究人员可以通过OMIM了解各种遗传疾病的发病机制、遗传模式以及相关基因的功能。
7. RefSeq:RefSeq是一个参考序列数据库,存储了各个物种的基因组和转录组序列。
RefSeq提供了基因的注释信息,包括基因的外显子、内含子、启动子、终止子等区域的序列。
ncbi 基因结构
NCBI(美国国家生物技术信息中心)是一个根据基因序列和相关信息进行存储、管理和分析的数据库资源,它收集和整理了全球范围内已知的基因结构数据,以提供对基因组学和生物医学研究的支持。
在NCBI基因结构数据库中,主要包括以下几个重要的数据:
1. 基因序列:这是基因结构的基础,包括DNA序列和RNA序列。
2. 基因元件:这些是基因序列中的各种元件,如启动子、终止子、内含子等。
3. 基因注释:包括基因的功能、位置、表达等注释信息。
4. 基因变异数据:包括各种基因变异的信息,如单核苷酸变异(SNV)、插入或缺失(INDEL)、复制数变异(CNV)等。
5. 基因表达数据:包括各种组织或细胞中的基因表达数据。
这些数据可以通过NCBI的网站进行查询和下载,为科学家们提供了重要的研究资源。