
模型中对未来数据的预测
1 趋势分析法
趋势分析法称之趋势曲线分析、曲线拟合或曲线回归,它是迄今为止研究最多,也最为
流行的定量预测方法。它是根据已知的历史资料来拟合一条曲线,使得这条曲线能反映负荷
本身的增长趋势,然后按照这个增长趋势曲线,对要求的未来某一点估计出该时刻的负荷预
测值。常用的趋势模型有线性趋势模型、多项式趋势模型、线性趋势模型、对数趋势模型、
幂函数趋势模型、指数趋势模型、逻辑斯蒂(logistic)模型、龚伯茨(gompertz)模型等,寻求
趋势模型的过程是比较简单的,这种方法本身是一种确定的外推,在处理历史资料、拟合曲
线,得到模拟曲线的过程,都不考虑随机误差。采用趋势分析拟合的曲线,其精确度原则上
是对拟合的全区间都一致的。在很多情况下,选择合适的趋势曲线,确实也能给出较好的预
测结果。但不同的模型给出的结果相差会很大,使用的关键是根据地区发展情况,选择适当
的模型。
2 回归分析法
回归分析法(又称统计分析法),也是目前广泛应用的定量预测方法。其任务是确定预测
值和影响因子之间的关系。但由于回归分析中,选用何种因子和该因子系用何种表达式有时
只是一种推测,而且影响因子的多样性和某些因子的不可测性,使得回归分析在某些情况下
受到限制。
回归分析预测方法是要通过对历史数据的分析研究,该方法不仅依赖于模型的准确性,
更依赖于影响因子其本身预测值的准确度。
3 指数平滑法
趋势分析和回归分析都是根据时间序列的实际值建立模型,再利用模型来进行预测计算
的。指数平滑法是用以往的历史数据的指数加权组合,来直接预报时间序列的将来值。
其中衰减因子0<α<1,体现"重近轻远",即近期数据对预测影响大,远期数据影响小的
基本原则。α越大时,由近期到远期数据的加权系数由大变小就越快,是强调新近数据的作
用。例如当α=0.9时,各加权系数分别为0.9,0.09,0.009等。在极端情形下,α=1,则以
往数据对预报没有任何影响。
4 灰色模型法
灰色系统理论是反模糊控制的观点和方法延伸到复杂的大系统中,将自动控制与运筹学
的数学方法相结合,研究广泛存在于客观世界中具有灰色性的问题。有部分信息已知和未知
的系统称为灰色系统。
但使用长数据列得到的结果与其它相比,并不占优,数据列过长,系统受干扰的成分多,
不稳定因素大,反而易使模型精度降低,降低预测结果的可信度。
5 分析与比较
(1)从适用条件看,回归分析和趋势分析致力于统计规律的研究与描述,适用于大样本,
且过去、现在和未来发展模式一致的预测;指数平滑法是利用惯性原理对增长趋势外推,实
现"重近轻远"的预测原则;灰色模型法是通过对原始数据的整理来寻求规律,它适用于贫信
息条件下的分析和预测。
(2)从采用的数据形式看,灰色系统理论是采用生成数序列建模。回归分析法、趋势分
析法均是采用原始数据建模。而指数平滑法是通过对原始数据进行指数加权组合直接预测未
来值。
(3)从计算复杂程度看,相对简单的是回归分析法和趋势分析法。
(4)从适用的时间分类看,指数平滑法、灰色模型法较适宜近期预测。对中、长期预测,
回归法、趋势分析法、改进型灰色模型较为合适。
应用统计学中的预测建模技术与方法

应用统计学中的预测建模技术与方法统计学是一门应用广泛的学科,其中的预测建模技术与方法在实际应用中具有重要的作用。
预测建模能够通过对过去和现有数据的分析,来预测未来的发展趋势和结果。
本文将介绍一些常见的预测建模技术与方法,并探讨它们在应用统计学中的应用。
一、线性回归分析线性回归分析是一种常见的预测建模技术,它通过对自变量和因变量之间的线性关系进行建模,来预测未来的因变量。
线性回归模型可以用来预测各种不同类型的数据,例如股票价格、销售量等。
通过对历史数据的回归分析,我们可以得到一个预测模型,以便在未来的情况下进行预测。
二、时间序列分析时间序列分析是一种专门用于预测时间相关数据的方法。
它建立在时间序列的基础上,通过对时间序列数据的统计和分析,来预测未来的趋势和变化。
时间序列分析可以应用于各种领域,例如经济学、气象学等。
在金融领域中,时间序列分析可以用于预测股票价格的波动情况,帮助投资者做出合理的决策。
三、决策树分析决策树分析是一种通过构建决策树来进行预测的方法。
决策树是一种用图形表示的预测模型,它通过将问题分解成一系列的决策节点和叶节点,并根据特定的规则来进行决策。
决策树分析可以应用于各种预测问题,例如市场调研、客户细分等。
通过对历史数据的分析,我们可以构建一个决策树模型,从而在未来的情况下进行预测。
四、神经网络分析神经网络分析是一种通过模拟人脑神经元之间的相互连接关系来进行预测的方法。
神经网络由多个神经元组成,每个神经元都有自己的权重和阈值。
通过对输入数据的处理和调整神经元之间的连接权重,神经网络可以学习和适应不同的数据模式,并进行预测。
神经网络分析可以应用于各种复杂的预测问题,例如语音识别、图像处理等。
五、贝叶斯统计分析贝叶斯统计分析是一种基于贝叶斯定理的预测方法。
贝叶斯定理将观察到的数据和先验知识结合起来,通过统计推断得到后验概率,并进一步进行预测。
贝叶斯统计分析可以应用于各种预测问题,例如医学诊断、风险评估等。
数学建模之中国人口增长的预测和人口结构的简析
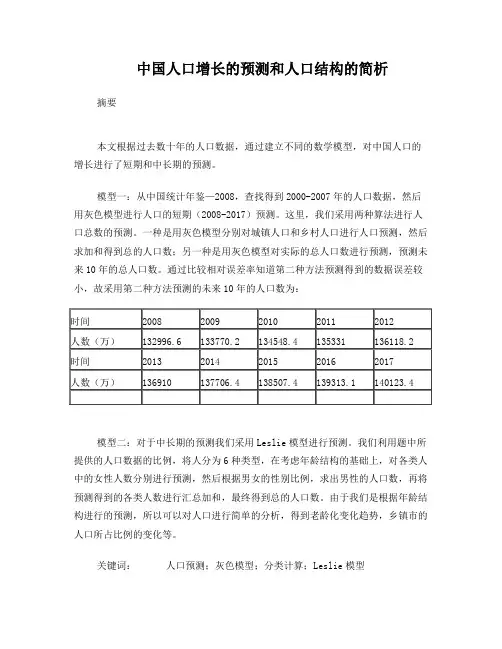
中国人口增长的预测和人口结构的简析摘要本文根据过去数十年的人口数据,通过建立不同的数学模型,对中国人口的增长进行了短期和中长期的预测。
模型一:从中国统计年鉴—2008,查找得到2000-2007年的人口数据,然后用灰色模型进行人口的短期(2008-2017)预测。
这里,我们采用两种算法进行人口总数的预测。
一种是用灰色模型分别对城镇人口和乡村人口进行人口预测,然后求加和得到总的人口数;另一种是用灰色模型对实际的总人口数进行预测,预测未来10年的总人口数。
通过比较相对误差率知道第二种方法预测得到的数据误差较小,故采用第二种方法预测的未来10年的人口数为:模型二:对于中长期的预测我们采用Leslie模型进行预测。
我们利用题中所提供的人口数据的比例,将人分为6种类型,在考虑年龄结构的基础上,对各类人中的女性人数分别进行预测,然后根据男女的性别比例,求出男性的人口数,再将预测得到的各类人数进行汇总加和,最终得到总的人口数。
由于我们是根据年龄结构进行的预测,所以可以对人口进行简单的分析,得到老龄化变化趋势,乡镇市的人口所占比例的变化等。
关键词:人口预测;灰色模型;分类计算;Leslie模型一、模型假设模型一的假设:1、不考虑国际迁移,认为国家内部迁移不改变人口总量;2、不考虑自然灾害、疾病等因素对人口数量的影响;3、文中短期预测到2017年4、大面积自然灾害、疾病的发生以及人们的生育观念等因素会对当年的生育率和人口数量产生影响,认为这些因素在预测误差允许的范围内.模型二的假设:1、每一年龄组的女性在每一个时间段内有相同的生育率和死亡率;2、在预测的时间段内男女的性别比例保持现状不变;3、不考虑人口的迁入和迁出;4、不考虑空间等自然因素的影响,不考虑自然灾害对人口数量的影响。
二、问题分析中国是一个人口大国,随着经济的不断发展,生产力达到较高的水平,现在的问题已不是仅仅满足个人的需要,而是要考虑社会的需要。
中国未富先老,对经济的发展产生很大的影响。
数学建模中的预测方法:时间序列分析模型
自相关函数
k 满足 ( B) k 0
它们呈指数或者正弦波衰减,具有拖尾性
3)ARMA( p, q)序列的自相关与偏自相关函数均是拖尾的
(2)模型的识别
自相关函数与偏自相关函数是识别ARMA模型的最主 要工具,B-J方法主要利用相关分析法确定模型的阶数. 若样本自协方差函数 k 在 q 步截尾,则 X t 是MA( q )序列
注:实参数 1 ,2 ,
,q 为移动平均系数,是待估参数
引入滞后算子,并令 (B) 1 1B 2 B2 q Bq 则模型【3】可简写为
X t ( B)ut
【4】
注1:移动平均过程无条件平稳 注2:滞后多项式的根都在单位圆外时,AR过程与MA过程 能相互表出,即过程可逆,
2
N 为样本大小,则定义AIC准则函数
用AIC准则定阶是指在
得 AIC (S )
p, q
最小的点
ˆ,q ˆ) (p
作为
( p, q)
的估计。
2p N 2( p q ) 2 ( p , q ) ˆ ARMA 模型 : AIC ln N
AR( p )模型 :
ˆ2 AIC ln
应用案例:
(1)CUMCM2004-A:奥运临时超市网点设计;
(2)CUMCM2004-B:电力市场的输电阻塞管理;
(3)CUMCM2005-A:长江水质的评价与预测;
(4)CUMCM2006-B:艾滋病疗法的评价与预测; (5)CUMCM2008-B:高校学费标准探讨问题。
3.灰预测GM(1,1):小样本的未来预测 应用案例
k 在
2) kk 的截尾性判断 作如下假设检验:M N
H0 : pk , pk 0, k 1, , M H1 : 存在某个 k ,使kk
如何在Excel中使用Forecast进行预测分析分析

如何在Excel中使用Forecast进行预测分析分析如何在Excel中使用Forecast进行预测分析在现代商业和金融领域,预测分析是一种重要的工具,可以帮助企业和个人做出合理的决策和计划。
对于许多人来说,Excel是一种常见且易于使用的软件,因此,在Excel中学习如何使用Forecast进行预测分析是非常有用的。
本文将介绍如何在Excel中使用Forecast进行预测分析。
一、准备工作在开始使用Forecast进行预测分析之前,我们需要确保已经正确地准备了数据。
要进行预测分析,我们需要有一段时间序列的数据,以便根据过去的趋势来预测未来的发展。
确保数据已经整理好,并且按照时间的先后顺序排列。
二、打开Excel并导入数据首先,打开Excel,创建一个新的工作簿。
然后,将准备好的数据导入到工作簿中的一个工作表中。
确保数据已经正确地排列在一个列中,日期或时间应该是第一列。
三、创建一个Forecast模型在Excel中,Forecast是一个内置的函数,可以根据历史数据来预测未来的趋势。
我们需要创建一个Forecast模型,以便进行预测分析。
1. 选择一个空白单元格,通常是在数据的右侧或下方,以便容纳预测结果。
2. 输入“=FORECAST.ETS(”(不包括引号)。
3. 接下来,输入一个引用到第一步准备好的时间序列数据的单元格范围。
例如,如果数据在A2:A100中,那么你应该输入“$A$2:$A$100”。
4. 输入一个整数,表示预测的时间间隔。
例如,如果你希望预测未来3个月的数据,那么你应该输入“3”。
5. 最后,输入一个数字,表示Forecast使用的算法类型。
如果你不确定应该选择哪种算法,可以使用默认的“1”。
四、应用Forecast模型完成Forecast模型的创建后,我们需要应用该模型来进行预测分析。
1. 将光标移动到创建Forecast模型的单元格中。
2. 按下Enter键,Excel会根据你提供的数据和参数计算出预测结果。
数据预测—非线性回归
数据预测—非线性回归非线性回归是一种在数据预测中常用的方法,它适用于无法通过线性关系来准确预测的场景。
通过寻找非线性模型中的最佳拟合曲线,非线性回归可以帮助我们预测未来的数据趋势。
什么是非线性回归回归分析是一种统计方法,用于确定自变量与因变量之间的关系。
线性回归假设自变量与因变量之间存在线性关系,但在某些情况下,真实的关系可能是非线性的。
这时,我们就需要使用非线性回归来更准确地建立模型。
非线性回归用曲线来描述自变量与因变量的关系,常见的非线性模型包括指数模型、多项式模型、对数模型等。
通过调整非线性模型的参数,我们可以找到最佳的拟合曲线,从而预测未来的数据。
如何进行非线性回归进行非线性回归的一般步骤如下:1. 收集数据:首先,我们需要收集自变量与因变量之间的样本数据。
2. 选择合适的模型:根据数据的特点,选择适合的非线性模型来描述自变量与因变量之间的关系。
3. 参数估计:使用统计方法,估计非线性模型中的参数值,找到最佳的拟合曲线。
4. 模型评估:通过评估模型的拟合程度,确定模型的可靠性和预测能力。
5. 预测未来数据:使用已建立的非线性模型,预测未来的数据趋势。
非线性回归的优势和应用非线性回归相比线性回归具有以下优势:- 更准确的预测能力:非线性回归可以更好地拟合真实的数据模式,提供更准确的预测结果。
- 更强的灵活性:非线性回归可以适应各种复杂的数据模式和关系,允许我们探索更多的可能性。
非线性回归在各个领域都有广泛的应用,例如金融、医学、经济学等。
在金融领域,非线性回归可以用于股票价格预测和风险评估;在医学领域,非线性回归可以用于疾病发展趋势预测和药物效果评估。
总结非线性回归是一种在数据预测中常用的方法,适用于无法通过线性关系进行准确预测的场景。
通过寻找非线性模型中的最佳拟合曲线,非线性回归可以帮助我们更准确地预测未来的数据趋势。
非线性回归具有更准确的预测能力和更强的灵活性,在各个领域都有广泛的应用。
我国人口出生率预测——基于ARIMA模型分析

现代经济信息我国人口出生率预测——基于ARIMA模型分析郭 敏 田 荟 张施伟 云南财经大学摘要:人口增长率是控制人口增长的重要指标之一。
本文利用国家统计局对我国1960-2016年来我国人口出生率统计的数据分析,运用ARIMA模型对未来三年人口出生率进行预测。
预测结果显示:本文探究的ARIMA(0,1,2)模型,可用于我国人口出生率的预测,为我国政府在制定相关管理政策上提供参考,且通过ARIMA模型可预测2018年我国的人口出生率将在13.06282‰左右浮动。
关键词:人口增长率;统计量描述;ARIMA模型中图分类号:C924. 24 文献识别码:A 文章编号:1001-828X(2018)028-0004-03一、前言18世纪末,英格兰政治经济学家托马斯马尔萨斯(Thomas Maithus)在其经济增长模型中提出人口的大量增长会使得人均消费和人均产出都没有增加,控制人口是提高生活水平的唯一手段①(斯蒂芬D威廉森)。
作为世界上人口第一大国,人口问题在不同历史阶段面临着不同的挑战。
“坚持以人为本,树立全面、协调、可持续的发展观,促进经济社会和人的全面发展”,十六届三中全会提出对以人为本发展观内涵的认识,深化以控制人口,提高人口素质为前提的发展概念。
人口出生率是控制人口增长的重要指标。
对我国过去人口出生率特征的分析及未来我国人口出生率预测是政府制定宏观人口调控政策的内在指导依据。
本文主要研究1950-2016年我国人口出生率,利用ARIMA模型分析其特征并预测我国未来五年人口率。
二、研究方法1.ARIMA基本介绍在时间序列数据中随机变量序列是一个随机的过程。
不平稳的随机过程被称为非平稳过程②,其统计量(如均值E(Xi),方差Var(Xi )等)在不同的时间点上是不同的,随机规律难以预测。
因此,博克思和詹金斯(Box and Jenkins)在上世纪70年代初提出了一种著名时问序列预测方法,所以又称为box--jenkins模型、博克思一詹金斯法。
数学建模统计预测方法及预测模型
利润额yt 200 300 350 400
1200
1000
利润额 yt
500 630 700 750 850 950 1020
800
600
400
y a
200
0
1993 1994 1995 1996 1997 1998 1999 2000 2001 2002 2003
中南大学
统计预测
y a ebt
y a1 b1x
?
中南大学
★ 最小二乘法原理 ★
• 概念:离差与离差平方
12
y6
10
e
8
yˆ6
6
e
4
2
0
1
2
3
4
5
6
统计预测
离差:et yt yˆt
n
n
离差和: et ( yt yˆt )
t 1
t 1
n
n
离差平方和 ei2 ( yt yˆt )2
t 1
t 1
最小
拟合程度最好
时序 (t)
23 24 25 26 27 28 29 30 31 32
总额 ( yt ) 1163.6 1271.1 1339.4 1432.8 1558.6 1800.0 2140.0 2350.0 2570.0 2849.4
统计预测方法是一种具有通用性的方法。 统计预测的三个要素:
❖ 实际资料是预测的依据; ❖ 理论是预测的基础; ❖ 数学模型是预测的手段。
2000
1000
0
0
1
2
3
4
5
6
7
8
9
10
某商场过去9年市场需求量统计数据
时间序列的7种预测模型适用条件
时间序列的7种预测模型适用条件时间序列分析是一种重要的预测方法,它可以用来分析时间序列数据的趋势、季节性、周期性等特征,并预测未来的值。
时间序列的预测模型有许多种,不同的模型适用于不同的情况。
接下来,本文将介绍时间序列的7种预测模型适用条件。
1. 移动平均模型移动平均模型是最简单的时间序列预测模型,它适用于平稳的时间序列。
平稳时间序列是指在时间上的均值和方差都不会发生明显的变化。
在使用移动平均模型时,需要选取合适的平滑因子,通常选择3、5、7等奇数个周期进行平滑。
2. 简单指数平滑模型简单指数平滑模型是一种基于加权移动平均的方法,通过对历史数据进行指数加权平均,预测未来数据的变化趋势。
该模型适用于趋势比较平稳的时间序列,且最好不要出现季节性变化。
3. Holt-Winters 模型Holt-Winters 模型既考虑了时间序列的趋势,又考虑了季节性因素。
该模型适用于具有季节性变化的时间序列,可以通过调整相应的平滑系数和季节系数,获得更准确的预测结果。
4. 季节性自回归移动平均模型 SARIMASARIMA 模型是一种拓展的自回归移动平均模型,可以用于处理具有明显季节变化的时间序列。
该模型适用于具有季节性变化和趋势变化的时间序列,可以通过选择合适的 p、d 和 q 参数以及 P、D 和 Q 参数,拟合不同的模型结构进行预测。
5. 自回归积分滑动平均模型 ARIMAARIMA 模型是一种用于处理时间序列数据的常用模型,可以进行平稳性检验、自相关性和部分自相关性分析等。
该模型适用于没有季节性变化、存在趋势变化的时间序列。
6. 神经网络模型神经网络模型是另一种常用的时间序列预测方法,它可以利用网络的非线性映射能力对时间序列进行建模和预测。
该模型适用于复杂的时间序列,但需要大量的数据进行训练,同时参数设置比较复杂。
7. 非参数回归模型非参数回归模型是一种不依赖于某种特定的函数形式的回归方法。
它适用于数据量较小或者数据分布较为杂乱,无法使用传统的回归模型进行拟合的情况。
天气预报模型中的数据分析与特征提取方法
天气预报模型中的数据分析与特征提取方法随着科技的发展,天气预报已经成为人们生活中不可或缺的一部分。
天气预报模型通过分析历史天气数据和其他相关数据来预测未来天气情况。
数据分析和特征提取是天气预报模型的核心环节,它们对于提高预报准确性起着关键作用。
在天气预报模型中,数据分析的目标是深入了解各种气象因素之间的关系,以便更好地预测未来天气。
数据分析可以通过多种方法来实现,包括统计分析、机器学习和人工智能等。
其中,统计分析是最常用的方法之一。
统计分析通过对大量历史天气数据进行分析,找出其中的规律和趋势。
例如,气温与季节之间存在着一定的关系,我们可以通过统计方法找出这种关系的模式,并将其应用于未来天气的预测中。
同时,统计分析还可以帮助我们理解不同气象因素之间的相互影响,从而更好地理解天气系统的运行机制。
机器学习是近年来天气预报领域的热门研究方向。
机器学习算法可以通过学习大量的历史天气数据,自动发现其中的规律和模式,并根据这些规律和模式来进行未来天气的预测。
机器学习可以分为监督学习和无监督学习两种方式。
监督学习是一种通过给定输入和输出的训练样本,让模型学习输入和输出之间的映射关系的方法。
在天气预报模型中,我们可以将历史气象数据作为输入,将未来的天气情况作为输出,通过训练模型来预测未来天气。
常用的监督学习算法包括决策树、支持向量机和神经网络等。
无监督学习是一种通过给定输入样本,让模型自动发现其中的模式和规律的方法。
在天气预报模型中,我们可以将历史天气数据作为输入,让模型自动发现其中的天气模式,并将其应用于未来预测中。
常用的无监督学习算法包括聚类算法和关联规则挖掘算法等。
除了数据分析外,特征提取也是天气预报模型中的重要环节。
特征提取的目标是从原始数据中提取出有用的特征,以便更好地预测未来天气。
特征提取可以通过多种方法来实现,包括统计特征、时频特征和图像特征等。
统计特征是指通过统计方法从数据中提取的特征。
例如,平均值、方差和相关系数等都可以作为统计特征。
数据的预测根据已有数据预测未来的情况
数据的预测根据已有数据预测未来的情况数据的预测:根据已有数据预测未来的情况数据在现代社会中扮演着至关重要的角色。
通过收集和分析大量的数据,人们可以揭示出许多隐藏在数字背后的规律和趋势。
在这些规律和趋势的基础上,人们可以进行数据的预测,以便更好地了解未来可能出现的情况。
本文将以此为主题,探讨数据的预测方法以及其在不同领域中的应用。
1. 数据的预测方法1.1 统计方法统计方法是一种常用且有效的数据预测方法。
通过对已有数据的统计分析,可以得出一些相对稳定的规律和趋势。
例如,利用历史交易数据可以预测股市的涨跌趋势,利用天气数据可以预测未来几天的天气情况。
在统计方法中,常用的分析工具包括回归分析、时间序列分析等。
1.2 机器学习方法机器学习是一种基于数据的预测方法,在近年来得到了迅猛发展。
通过构建合适的模型,并利用大量的已有数据进行训练,机器学习可以自动发现数据中潜在的规律和模式,并用以预测未来。
主流的机器学习方法包括决策树、支持向量机、神经网络等。
2. 数据预测的应用2.1 经济领域在经济领域,数据的预测应用广泛。
例如,通过对国民经济数据的预测,政府可以制定相应的经济政策,以维持社会的稳定发展。
另外,商业公司也利用数据的预测来做出市场营销决策,优化生产计划,提高经营效益。
2.2 医疗领域数据的预测在医疗领域有着重要的应用。
通过分析患者的病历数据、基因数据等,可以预测患者未来可能出现的疾病风险和治疗效果。
这有助于医生制定个性化的治疗方案,提高治疗效果和患者的生活质量。
2.3 环境领域在环境领域,数据的预测可以帮助我们更好地了解和应对自然环境的变化。
例如,通过气象数据的预测,可以预警自然灾害的发生,及时采取相应的防范和救援措施。
此外,通过分析大气、水质等数据,也可以预测环境污染的程度和发展趋势,指导环保工作的开展。
3. 数据的预测和隐私保护在进行数据的预测时,隐私保护是一个重要的问题。
因为数据的预测需要基于大量的已有数据,而这些数据中可能包含着个人的敏感信息。