
视觉SLAM十四讲-第七讲-视觉里程计(1)教学提纲
视觉里程计02基于特征匹配的位姿估计

视觉⾥程计02基于特征匹配的位姿估计
特征点的投影模型为 p=1ZKP,P为世界坐标系下某点的坐标(Z为z⽅向的坐标),p为对应图像特征点。K为内参,在标定好的相机
下,K已知
根据对极⼏何约束,假设p2为相机位姿运动R,t后与前⼀帧的特征点p1匹配的特征点,则有
s1p1=KP
s2p2=K(RP+t)
参考视觉slam14讲的推导,这⾥可以得到对极约束
pT2K−Tt∧RKH−1p1=0
可以通过8点法求解本质矩阵进⽽得到R,t每两帧之间的位姿递推误差积累很快,因此直接递推的位姿是不太稳定的。
t的缩放尺⼨不确定,因此不能获得绝对位置
主要基于视觉slam14讲的代码,稍微改动的测试,尽管能够求解姿态但是并不⼗分准确,后续考虑使⽤双⽬相机实现定位功能
#include
#include
#include
#include
#include "opencv2/features2d/features2d.hpp"
#include
#include
#include
#include
//#include "stdafx.h"
using namespace cv;
using namespace std;
void find_feature_matches(
const Mat& img_1, const Mat& img_2,
std::vector& keypoints_1,
std::vector& keypoints_2,
std::vector< DMatch >& matches);
void pose_estimation_2d2d(
std::vector keypoints_1,
std::vector keypoints_2,
std::vector< DMatch > matches,
Mat& R, Mat& t);
// 像素坐标转相机归⼀化坐标
Point2d pixel2cam(const Point2d& p, const Mat& K);
12_视觉里程计1_ICP算法

12_视觉⾥程计1_ICP算法
前⾔
ICP的英⽂全称为Iterative Closest Point,即为迭代最近点。它在激光雷达应⽤频率很⾼,主要是在点云配准领域。ICP算法在是是视觉
SLAM中应⽤也⾮常多,这个算法还是很重要。我们下⾯的讨论还是基于视觉SLAM,好了我们开始吧!
ICP算法流程
ICP算法顾名思义,就是找最近点。算法流程如下:
step1:预处理点云
step2:寻找对应点(最近点)
step3:根据对应点,计算R和t
step4:对点云进⾏转换,计算误差
step5:不断迭代,直⾄误差⼩于某⼀个值
3D-3D: ICP
假设我们有⼀组配对好的3D点如下:
\boldsymbol{P}=\left\{\boldsymbol{p}_{1}, \cdots, \boldsymbol{p}_{n}\right\}, \quad \boldsymbol{P}^{\prime}=\left\
{\boldsymbol{p}_{1}^{\prime}, \cdots, \boldsymbol{p}_{n}^{\prime}\right\}
现在我们想要找到⼀个欧式变换,使得
\forall i, \boldsymbol{p}_{i}=\boldsymbol{R} \boldsymbol{p}_{i}^{\prime}+\boldsymbol{t}.
上述的这个问题就可以使⽤ICP算法求解。这⾥主要需要注意下,如果仅考虑3D点之间的变换,此时和相机并没有关系。在RGB-D SLAM中
⽤ICP问题指代匹配好的两组点间的运动估计问题(跟激光SLAM有区别,激光SLAM通常是未知的情况)。ICP求解主要是两种⽅式,⼀种
是SVD,另⼀种是⾮线性优化⽅式求解。
SVD⽅法
根据前⾯描述的ICP问题,令第i对点的误差为:
\boldsymbol{e}_{i}=\boldsymbol{p}_{i}-\left(\boldsymbol{R} \boldsymbol{p}_{i}^{\prime}+\boldsymbol{t}\right).
【视觉SLAM十四讲课后作业答案】第三讲:李群与李代数

第一节课习题
屋卡
2017年12月19日
一、验证向量叉乘的李代数性质
我们说向量和叉乘运算构成了李代数,现在请你验证它。书中对李代数的定义为:李代数由⼀个集合 V,⼀个数域 F 和⼀个⼀元运算 [,] 组成。如果它们满⼀以下⼀条性质,称 (V,F,[,]) 为⼀个李代数,记作 g
二、推导 SE(3) 的指数映射
课上给出了 SO(3) 的指数映射推导,但对于 SE(3),仅介绍了结论,没有给出详细推导。请你完成 SE(3) 指数映射部分,有关左雅可⼀的详细推导。
三、伴随
在 SO(3) 和 SE(3) 上,有⼀个东西称为伴随(Adjoint)。下⼀请你证明
SO(3) 伴随的性质。 对于 SO(3),有:
Rexp(p∧)RT = exp((Rp)∧).
此时称 Ad(R) = R。
解:
四、轨迹的描绘
我们通常会记录机器⼀的运动轨迹,来观察它的运动是否符合预期。⼀部分数据集都会提供标准轨迹 以供参考,如 kitti、TUM-RGBD 等。这些⼀件会有各⼀的格式,但⼀先你要理解它的内容。记世界坐标 系为 W,机器⼀坐标系为 C,那么机器⼀的运动可以⼀ TWC 或 TCW 来描述。现在,我们希望画出机器 ⼀在世界当中的运动轨迹,请回答以下问题:
1.事实上,TWC 的平移部分即构成了机器⼀的轨迹。它的物理意义是什么?为何画出 TWC 的平移 部分就得到了机器⼀的轨迹?
解:wcT的平移部分构成机器人的轨迹,它的物理意义是机器人在现实三维空间中的坐标点。wcT包含平移和旋转部分 ,平移指的是机器人在空间中的运动位置,而旋转部分是指机器人在每个位置的方向状态。
2. 我为你准备了⼀个轨迹⼀件(code/trajectory.txt)。该⼀件的每⼀⼀由若⼀个数据组成,格式为
[t,tx,ty,tz,qx,qy,qz,qw],
其中 t 为时间,tx,ty,tz 为 TWC 的平移部分,qx,qy,qz,qw 是四元数表⼀的 TWC 的旋转部分,qw 为四元数实部。同时,我为你提供了画图程序
视觉slam十四讲课后习题ch3-7
视觉slam⼗四讲课后习题ch3-7
题⽬回顾:
设有⼩萝⼘⼀号和⼩萝⼘⼆号位于世界坐标系中,⼩萝⼘⼀号的位姿为:q1=[0.35,0.2,0.3,0.1],
t2=[0.3,0.1,0.1]^T (q的第⼀项为实部。请你把q归⼀化后在进⾏计算)。这⾥的q和t的表达的是Tcw,也就是世界到相机的变换关系。⼩萝⼘
⼆号的位姿为q2=[-0.5,0.4,-0.1,0.2],t=[-0.1,0.5,0.3]^T.现在,⼩萝⼘⼀号看到某个点在⾃⾝的坐标系下,坐标为p=[0.5,0,0.2]^T ,求该向量在⼩
萝⼘⼆号坐标系下的坐标,请编程实现此事。
解:
pw:某个点在世界坐标系下的坐标
T_1w :表⽰世界坐标系到⼩萝⼘⼀号坐标系的变换关系
T_2w:表⽰世界坐标系到⼩萝⼘⼆号坐标系的变换关系
P2 :表⽰该点在⼩萝⼘⼆号坐标系下的坐标(即为所求)
单位四元数到旋转矩阵R的变化关系可参考书上55页。之后变换矩阵T=[R t]
[0 1]
由变换关系可列出下⾯的式⼦:
p = T_1w * Pw 可解出来pw
p2=T_2W*pW 带⼊上式解出来的Pw即可求出来p2
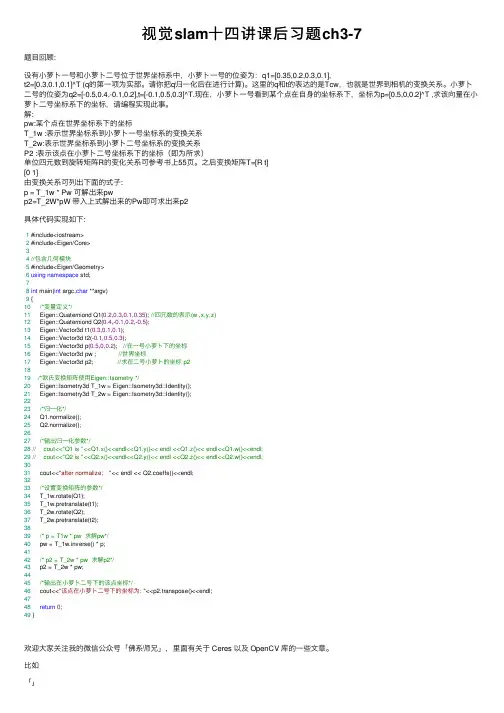
具体代码实现如下:
1 #include
2 #include
3
4 //包含⼏何模块
5 #include
6 using namespace std;
7
8 int main(int argc,char **argv)
9 {
10 /*变量定义*/
11 Eigen::Quaterniond Q1(0.2,0.3,0.1,0.35); //四元数的表⽰(w ,x,y,z)
12 Eigen::Quaterniond Q2(0.4,-0.1,0.2,-0.5);
13 Eigen::Vector3d t1(0.3,0.1,0.1);
14 Eigen::Vector3d t2(-0.1,0.5,0.3);
15 Eigen::Vector3d p(0.5,0,0.2); //在⼀号⼩萝⼘下的坐标
计算机视觉技术中的视觉SLAM方法
计算机视觉技术中的视觉SLAM方法
计算机视觉技术中的视觉SLAM(Simultaneous Localization and Mapping)是一种重要的技术手段,用于实现机器或无人系统在未知环境中的自主定位和建图。视觉SLAM方法通过分析场景中的图像或视频流,提取出关键的视觉特征,并通过特征匹配、视觉里程计、重建和优化等步骤,实现对环境的定位和地图的构建。
视觉SLAM方法有着广泛的应用,如无人飞行器、自动驾驶汽车、增强现实等领域。在这些应用中,视觉SLAM能够帮助机器或系统在未知环境中实现自主导航和场景理解,提高其感知能力和操作能力。
视觉SLAM方法主要可以分为稀疏SLAM和稠密SLAM两大类。
稀疏SLAM方法采用基于特征的方法,即通过提取场景中的显著特征点或关键帧进行定位和建图。典型的算法有基于滤波的扩展卡尔曼滤波(EKF-SLAM)和基于优化的非线性后端优化(BA)等方法。
扩展卡尔曼滤波是最早提出并应用于SLAM问题的方法之一。它基于线性化的状态空间模型,通过滤波器进行状态估计和地图更新,但在处理大规模、复杂环境时存在计算效率低和不稳定的问题。
非线性后端优化方法是基于图优化理论的方法,通过最小化误差函数对状态和地图进行联合优化,可以得到更准确的定位和地图。典型的算法有基于因子图的优化(GTSAM)和基于位姿图的优化(Pose Graph Optimization)等方法。
稠密SLAM方法则采用光流法或深度学习方法,通过计算相邻帧之间的像素位移或深度信息,实现对环境的精确建模。典型的算法有基于基础矩阵的方法(例如,八点法、五点法)和基于深度学习的全局优化方法(例如,地图拼接网络、深度光度法)等。 八点法是基础矩阵计算中最简单常见的算法之一,通过至少通过八对对应点对计算出两帧之间的基础矩阵,从而实现相机运动的估计和地图的重建。八点法基于线性方程组的求解,具有计算效率高的优势,但对输入数据质量和数量有一定要求。
视觉SLAM技术与应用

视觉SLAM技术与应用
视觉SLAM(Simultaneous Localization and Mapping)是指通过摄像机或者其他视觉传感器实现同时定位和建图的技术。它是机器人导航与场景理解中的重要组成部分,也被广泛应用于增强现实、无人驾驶、智能制造等领域。本文将对视觉SLAM技术的原理和应用进行探讨。
一、视觉SLAM的原理
视觉SLAM依赖于视觉传感器获取场景的视觉信息,并通过计算机视觉算法对图像进行处理和分析,实现同时定位和建图的功能。其基本原理如下:
1. 特征提取与匹配:视觉SLAM首先通过特征提取算法从图像中提取出一些具有唯一性和区分性的特征点。然后利用特征描述子对这些特征点进行编码,以实现特征的匹配。
2. 视觉里程计:在特征匹配的基础上,通过对特征点的位置变化进行分析和计算,可以估计出相机在连续帧间的相对运动,即相机的位姿变换。这个过程被称为视觉里程计,用于实现机器人的定位。
3. 环路检测与优化:为了提高定位的准确性和鲁棒性,视觉SLAM进一步利用环路检测算法来检测地图中是否存在已经观测过的环路。当检测到环路时,可以通过图优化算法对整个地图的重建进行优化,进而提高整个系统的精度。 4. 建图:视觉SLAM通过不断积累相机位姿和地图的信息,可以实时地构建和更新场景的三维地图。这个过程可以基于稠密或稀疏特征点的方法进行,具体的实现根据应用场景的需求而定。
二、视觉SLAM的应用
1. 增强现实(AR):视觉SLAM技术在增强现实应用中起着至关重要的作用。通过实时定位和建图,可以将虚拟的三维物体精确地叠加到真实世界中,实现交互性强、沉浸感强的增强现实体验。
2. 无人驾驶:视觉SLAM技术在无人驾驶领域具有广泛的应用前景。通过即时感知环境并实时建图,可以帮助无人驾驶汽车实现精确定位和路径规划,提高行驶的准确性和安全性。
3. 智能制造:视觉SLAM技术也在智能制造中发挥着重要作用。通过自动化机器人实现场景的定位和建图,可以提高生产过程中的效率和精度,实现智能制造的目标。
【转】SLAM视觉SLAM中的后端:后端优化算法与建图模板
【转】SLAM视觉SLAM中的后端:后端优化算法与建图模板
前⾯的话
前⾯系列⼀中我们介绍了,VSLAM 是利⽤多视图⼏何理论,根据相机拍摄的图像信息对相机进⾏定位并同时构建周围环境地图。按照相机的分类,有单⽬、双⽬、 RGBD、鱼眼、全景等。同时,VSLAM 主要包括视觉⾥程计(visual odometry, VO)、后端优化、回环检测、建图。 VSLAM 前端为视觉⾥程计和回环检测,相当于是对图像数据进⾏关联;后端是对前端输出的结果进⾏优化,利⽤滤波或⾮线性优化理论,得到最优的位姿估计和全局⼀致性地图。
前⾯已经介绍了VSLAM的前端:视觉⾥程计和回环检测,这次我们将介绍系列⼆:VSLAM中的后端优化和建图。
接下来,我们将详细介绍。
2 后端:最优化位姿估计和全局⼀致性地图
2.1 后端优化
SLAM 的后端求解⽅法可⼤致分为两⼤类,⼀类是基于滤波器的⽅法;另⼀类则是⾮线性优化⽅法。这是根据假设的不同,如果假设马尔可夫性, K 时刻状态只与 K-1 时刻状态有关,⽽与之前的状态⽆关,这样会得到以扩展卡尔曼滤波(EKF)为代表的滤波器⽅法。在滤波⽅法中,本⽂会从某时刻的状态估计推导到下⼀个时刻。另外⼀种⽅法是考虑K 时刻与之前所有状态的关系,这将得到⾮线性优化为主体的优化框架。
2.1.1 滤波⽅法
由于SLAM 本质上是⼀个状态估计问题,该问题可以归结为⼀个运动⽅程和⼀个观测⽅程,顺理成章地把 SLAM 融⼊到滤波框架中。早期的SLAM 研究基本都是在滤波器的框架下。在假定从 0 到 t 时刻的观测信息以及控制信息已知的条件下,对系统状态的后验概率进⾏估计,根据后验概率表⽰⽅式的不同,存在多种基于滤波器的⽅法,如扩展卡尔曼滤波(EKF)⽅法、粒⼦滤波(PF)等。 1.卡尔曼滤波(KF) Kalman滤波算法的本质就是利⽤两个正态分布的融合仍是正态分布这⼀特性进⾏迭代⽽已。
步骤⼀:⽤上⼀次的最优状态估计和最优误差估计去计算这⼀次的先验状态估计和先验误差估计。
SLAM入门之视觉里程计(2):相机模型(内参数,外参数)
SLAM⼊门之视觉⾥程计(2):相机模型(内参数,外参数)
相机成像的过程实际是将真实的三维空间中的三维点映射到成像平⾯(⼆维空间)过程,可以简单的使⽤⼩孔成像模型来描述该过程,以了
解成像过程中三维空间到⼆位图像空间的变换过程。
本⽂包含两部分内容,⾸先介绍⼩孔成像模型的各种⼏何关系;接着描述了成像过程中的四种坐标系(像素坐标,图像坐标,相机坐标,世
界坐标)的变换关系。
⼩孔成像模型
相机可以抽象为最简单的形式:⼀个⼩孔和⼀个成像平⾯,⼩孔位于成像平⾯和真实的三维场景之间,任何来⾃真实世界的光只有通过⼩孔
才能到达成像平⾯。因此,在成像平⾯和通过⼩孔看到的真实三维场景存在着⼀种对应关系,也就是图像中的⼆维像点和真实三维世界的三
维点存在某种变换关系。找到了这种变换关系,就可以利⽤图像中的⼆维点信息来恢复场景的三维信息。下图是⼩孔成像的模型,为了简化模型,将成像平⾯放在了⼩孔的前⾯,并且成的像也是正⽴的在描述⼩孔的成像过程前,⾸先来定义两个坐标系:
相机坐标系(三维坐标系)
相机的中⼼被称为焦点或者光⼼,以焦点O_c为原点和坐标轴X_c,Y_c,Z_c组成了相机坐标系
图像坐标系(⼆维坐标系)
成像平⾯中,以成像平⾯的中⼼O'为原点和坐标轴x',y'组成了图像坐标系。
⼩孔成像实际就是将相机坐标系中的三维点变换到成像平⾯中的图像坐标系中的⼆维点。
假设,三维空间中点P,其在相机坐标系中的坐标是P_c=[X,Y,Z]^T;其像点p,在图像坐标系的中的坐标是p=[x,y]^T,由于光轴垂直与成像
平⾯,那么可以知道像点p在相机坐标系中的坐标是p=[x,y,z]^T,其中z =f(f是焦点到成像平⾯之间的距离,被称为焦距)。
由上图根据三⾓形的相似关系,可以得到如下公式:
\frac{Z}{f}=\frac{X}{x}=\frac{Y}{y}
将上⾯公式整理后可以得到:
\left\{ \begin{array}{l} x = f\frac{X}{Z} \\ y = f\frac{Y}{Z} \\ z = f \end{array} \right.
视觉slam十四讲 引用
视觉SLAM十四讲
引言
视觉SLAM(Simultaneous Localization and Mapping)是一种通过摄像头获取图像数据,并在其中实时地定位和构建地图的技术。它在无人驾驶、增强现实、机器人导航等领域有着广泛的应用。《视觉SLAM十四讲》是一本经典的教材,本文将对该教材进行探讨和总结。
什么是视觉SLAM
视觉SLAM是一种通过计算机视觉技术来实现实时定位和地图构建的技术。通过摄像头获取图像,利用SLAM算法来实时地对机器人的位置和运动进行估计,并同时构建地图。与传统的SLAM技术相比,视觉SLAM能够减少对其他传感器的依赖,提高系统的自主性和灵活性。
视觉SLAM的基本流程
视觉SLAM的基本流程包括图像预处理、特征提取与匹配、运动估计、地图更新等步骤。具体步骤如下:
1. 图像预处理
– 图像去畸变:对图像进行去除镜头畸变的处理,提高后续特征提取和匹配的效果。
– 图像降噪:通过滤波等方法降低图像中的噪声,提高图像质量。
2. 特征提取与匹配
– 特征提取:通过提取图像中的角点、边缘等特征点,用于后续的特征匹配和运动估计。
– 特征匹配:通过比较两幅图像中的特征点,找到它们之间的对应关系,用于后续的运动估计和地图更新。
3. 运动估计
– 单目SLAM:通过分析图像序列中的特征点的运动,估计机器人的运动轨迹。
– 双目SLAM:利用双目摄像头获取的图像,通过立体视觉的方法来估计机器人的运动轨迹。 – 深度估计SLAM:通过利用深度传感器获取的深度信息,估计机器人的运动轨迹。
4. 地图更新
– 同步优化:通过对图像序列中的特征点和机器人的位姿进行联合优化,得到更精确的运动轨迹和地图。
– 闭环检测:通过对图像序列中的特征点和地图进行匹配,检测是否存在闭环,进而修正运动估计和地图。
视觉SLAM算法简介
视觉SLAM算法有很多种,常用的包括特征点法、直接法、半直接法等。
SLAM14讲第七章特征点法
SLAM14讲第七章特征点法
视觉前端和优化后端
视觉⾥程计VO-根据相邻图像的信息估计处粗略的相机运动,给后端较好的估计值
【⼀】特征提取与匹配:特征点法
——运⾏稳定,对光照、动态物体不敏感
主要问题:根据图像来估计相机运动
特征点-路标-有代表性的点-图像信息的⼀种表达形式-在相机运动之后保持稳定-⾓点|边缘|区块
仅灰度值:受光照、形变、物体材质的影响严重【×】
SIFT\SURF\ORB——可重复性、可区别性、⾼效、局部
特征点=关键点(图像中的位置、朝向、⼤⼩)+描述⼦(向量,周围像素)
依据【外观相似的特征有相似的描述⼦原则】
SIFT尺度不变特征变换 5228.7ms
FAST关键点——计算速度很快,没有描述⼦,不具有⽅向性
ORB(旋转、尺度不变性)——速度极快的⼆进制描述⼦BRIEF 1000点/15.3ms
SURF 217.3ms
7.1 ORB特征
Oriented FAST关键点(FAST+特征点主⽅向)+BRIEF特征⼦
1 FAST关键点
FAST⾓点:检测局部像素像素灰度变化明显的地⽅(只⽐较像素亮度⼤⼩)
FAST-9/11/12(半径为3的圆上16个像素点中有N个⼤于或⼩于中⼼点的阈值120%/80%)
FAST-12预测试:第1/5/9/13个点的情况
#⾮极⼤值抑制:⼀定区域内仅保留响应极⼤值的⾓点,避免集中
【缺点1】FAST特征点量⼤且不确定,往往希望对图像提取固定数量的特征
【改进】固定数量N,原始FAST⾓点计算Harries响应值
【缺点2】FAST不具有⽅向信息
【改进】由构建图像⾦字塔并在每⼀层检测⾓点实现尺度不变性,灰度质⼼(以图像块灰度值作为权重的中⼼)法实现特征旋转
2 BRIEF描述⼦
关键点附近两个像素p和q的⼤⼩关系,1/0,128维,随机选取
旋转后的Steer BRIEF特征
7.2 特征匹配(数据关联)
#场景⼤量重复纹理导致的误匹配问题
计算特征点之间的描述⼦距离,通常汉明距离,⼆进制不同位数的个数