
基于云模型的协同过滤推荐算法
基于HMM模型的协同过滤推荐方法
和数据 空间的 可扩展的 问题 。然后 , 出了喜好度 的概念 并给 出 了计算 方法 , 提 喜好 度概 念的加入 能为 目标用户推 荐
更适 合 的 商品 。最 后 , 结合 喜 好 度 给 出 了基 于 HMM 的协 同过 滤 预 测 模 型 。通 过 对 一 个 实 例 的 研 究 验 证 了所 提 出 的 算 法 以及 推 荐 模 型 的 可行 性 。 关键词 : 隐马 尔可 夫模 型 ; 同过 滤 推 荐 ; ( ) 协 前 后 向评 估 算 法 ; 览路 径 ; 好 度 浏 喜 中图 分 类 号 : P 9 T 31 文 献 标 志码 : A
Jn 0 8 u e2 0
基于 H MM 模 型 的协 同 过滤 推 荐 方 法
黄 光球 , 永梅 赵
( 西安建筑科 技大学 管理学院 , 西安 7 0 5 ) 10 5
( u n n n 3 o u ct) h a g a 9 @sh . oq l
摘
要: 考虑 到用户浏 览路 径、 时间、 浏览次数都是 影响推荐 准确度的 重要 因素 , 出一种基 于隐马 尔可夫模 型 提
ac rc f o c u a y o mme d t n y a c c l b r t n f t r g r c mme d t n meh d b s d o d e r o d lf c n ai ,a d n mi ol o ai l i e o o a o i en n ai t o a e n Hi d n Mak v Mo e o HMM1
wa o s d F rt i i a e s r’b ha ir sprpo e , is, tsmultd u es e vo s whi e sbrwsng W e a e , a d s tup te n a e tneg bo e l aus rwa o i e b p g s n e h e r s— ih rs t a c r i g t s e a ir , Be a e h d t i s d c o d n o hi b h vo s c us t e a a t e wa n t e ’ rtn b u e s r ws r u e t e r b e u s o us r s aig ut s r ’b o e o t , h p o lm o a a f d t s a e e sa d i ta a ig wa e o v d, W h n HM M s u e o r p a e te sm i t e mo e o me s r s r’sm iaiy p r n s n niilr tn sr s le s e wa s d t e l c h i l ud d lt a u e u es i lrt , i t e a c r c fne r s— egh o o h c u a y o a e tn i b rc mme ain wa mprv d g e ty An ts t e h n tm er c mme ain p o lm n nd to si o e r al . d i et d t e o —i e o l nd t r b e a d o t e e tnsb e daa s c r b e h xe il t pa e p o l m, The t o c pto a y de e wa e p, whih m a h e o me dain be o n he c n e ffnc g e r s s tu c de t e r c m n to c me m oe s ia l , Fi al t e fnc g e s p le t e t b ih h p e i t n r ut b e nl y, h a y de r e wa a p id o sa ls t e r d ci m o l f y a i c la o ain itrn o de o d n m c ol b r t fle g o i r c mme dain, A a e sud ho h x el n ro ma e o hi d 1 eo n to c s t y s wst e e c le tpe r nc ft s mo e . f
协同过滤推荐技术综述-
Recommendations) [16-17] ;3) 对用户访问网站时的干 扰较小;4) 技术易于实现[19] . 因此它成为一种较流 行的推荐技术. 自 1992 年美国施乐公司 PARC 研究 中心( Xerox Palo Alto Research Center) 正式提出协 同过滤以来,国内外众多研究人员对如何完善协同 过滤推荐技术开展大量的工作,但少有相应的研究 总结,尤其是国内学者工作更是较少. 本文系统归纳 协同过滤领域的研究工作,全面回顾协同过滤的内 涵、发展、存在问题、研究现状及未来研究热点,为后 续研究提供参考,促进我国个性化信息服务更好、更 快地发展.
基于 AI的自适应学习系统操作手册

基于的自适应学习系统操作手册第一章:系统概述 (3)1.1 系统简介 (3)1.2 功能特点 (3)1.2.1 个性化学习路径 (3)1.2.2 智能推荐学习资源 (4)1.2.3 实时反馈与评估 (4)1.2.4 互动式学习体验 (4)1.2.5 数据分析与可视化 (4)1.3 技术架构 (4)1.3.1 人工智能算法 (4)1.3.2 云计算与大数据 (4)1.3.3 网络安全技术 (4)1.3.4 跨平台兼容性 (4)第二章:安装与配置 (4)2.1 系统安装 (4)2.1.1 安装准备 (5)2.1.2 安装步骤 (5)2.2 硬件要求 (5)2.3 软件配置 (5)2.3.1 操作系统 (6)2.3.2 驱动程序 (6)2.3.3 软件依赖 (6)第三章:用户管理 (6)3.1 用户注册 (6)3.1.1 注册流程 (6)3.1.2 注意事项 (6)3.2 用户登录 (6)3.2.1 登录流程 (7)3.2.2 注意事项 (7)3.3 用户权限设置 (7)3.3.1 权限管理概述 (7)3.3.2 权限设置流程 (7)3.3.3 注意事项 (7)第四章:课程管理 (7)4.1 课程创建 (7)4.1.1 创建课程流程 (7)4.1.2 注意事项 (8)4.2 课程编辑 (8)4.2.1 修改课程信息 (8)4.2.2 注意事项 (8)4.3 课程发布 (8)4.3.2 注意事项 (8)第五章:学习进度管理 (9)5.1 学习进度跟踪 (9)5.1.1 功能概述 (9)5.1.2 操作步骤 (9)5.1.3 注意事项 (9)5.2 学习提醒功能 (9)5.2.1 功能概述 (9)5.2.2 操作步骤 (9)5.2.3 注意事项 (9)5.3 学习进度报告 (9)5.3.1 功能概述 (10)5.3.2 操作步骤 (10)5.3.3 注意事项 (10)第六章:智能推荐系统 (10)6.1 推荐算法介绍 (10)6.2 推荐内容设置 (11)6.3 推荐效果评估 (11)第七章:交互式学习 (12)7.1 互动问答功能 (12)7.1.1 功能概述 (12)7.1.2 操作步骤 (12)7.1.3 注意事项 (12)7.2 作业与练习 (12)7.2.1 功能概述 (12)7.2.2 操作步骤 (12)7.2.3 注意事项 (12)7.3 交流讨论区 (12)7.3.1 功能概述 (13)7.3.2 操作步骤 (13)7.3.3 注意事项 (13)第八章:数据分析与评估 (13)8.1 数据收集 (13)8.1.1 收集目的 (13)8.1.2 收集方法 (13)8.1.3 注意事项 (13)8.2 数据分析 (14)8.2.1 数据预处理 (14)8.2.2 数据分析方法 (14)8.3 学习效果评估 (14)8.3.1 评估指标 (14)8.3.2 评估方法 (14)第九章:系统维护与升级 (14)9.1.1 维护目的 (15)9.1.2 维护内容 (15)9.1.3 维护周期 (15)9.1.4 维护人员 (15)9.2 系统升级 (15)9.2.1 升级目的 (15)9.2.2 升级流程 (15)9.2.3 升级周期 (16)9.2.4 升级人员 (16)9.3 常见问题解答 (16)9.3.1 系统运行缓慢怎么办? (16)9.3.2 数据丢失怎么办? (16)9.3.3 系统安全如何保障? (16)第十章:用户支持与反馈 (16)10.1 用户服务 (16)10.1.1 服务宗旨 (16)10.1.2 服务内容 (16)10.1.3 服务流程 (17)10.2 反馈渠道 (17)10.2.1 反馈收集 (17)10.2.2 反馈途径 (17)10.3 用户满意度调查 (17)10.3.1 调查目的 (17)10.3.2 调查内容 (17)10.3.3 调查方式 (18)第一章:系统概述1.1 系统简介基于的自适应学习系统是一款集成了先进人工智能技术的教育辅助系统。
基于项目的协同过滤算法 ItemCF流程图
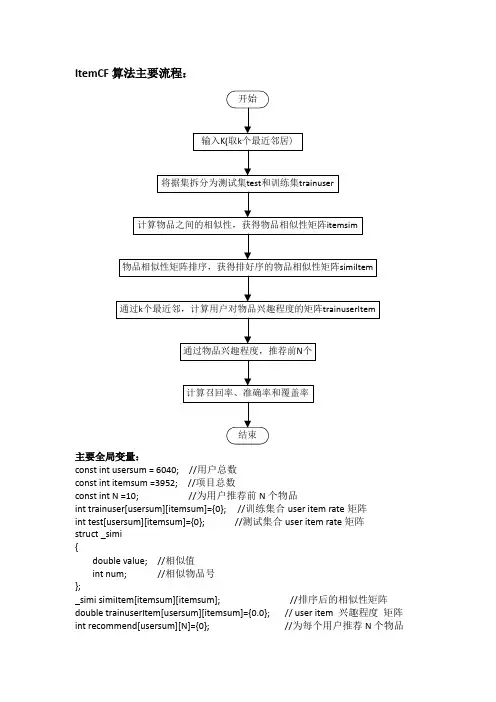
ItemCF算法主要流程:主要全局变量:const int usersum = 6040; //用户总数const int itemsum =3952; //项目总数const int N =10; //为用户推荐前N个物品int trainuser[usersum][itemsum]={0}; //训练集合user item rate矩阵int test[usersum][itemsum]={0}; //测试集合user item rate矩阵struct _simi{double value; //相似值int num; //相似物品号};_simi simiItem[itemsum][itemsum]; //排序后的相似性矩阵double trainuserItem[usersum][itemsum]={0.0}; // user item 兴趣程度矩阵int recommend[usersum][N]={0}; //为每个用户推荐N个物品拆分数据集函数int SplitData(int m, int k) 主要流程:将数据集拆分为测试集test和训练集trainuser,其中1/m为测试集,取不同的k<=m-1值在相同的随即种子下可得到不同的测/训集合计算项目之间相似度函数double Simility(int* ItemA, int* ItemB)主要流程:计算用户ItemA和ItemB的相似性,返回值为ItemA和ItemB的相似度用户i对物品j预测兴趣程度函数double getUserLikeItem(int i,int j,int k)主要流程:利用k个最近邻来计算推荐函数int getRecommend()主要流程:通过物品兴趣程度,推荐前N个。
一种基于云模型数据填充的算法

O 引 言
现今世界信息量 随着 网络的发展 而飞速膨 胀 , 如
或产 品的特 征来 推荐 给 目标 用 户或 产 品的打 分数据
值 , 中最常使用的方法是 K 近邻 ( 其 K—N aet e h ers N i — g
从 电子商务网站获得 的产 品数据 , 其数据 量增 长的如 此快 以致 我 们 很 难 处 理 它 , 如 : ao 、 mao 例 Y ho A zn和 C N w等等这些 网站每天 都提供 了大量选 择给它 的 D o 潜在客户 如何从 中找到最适合 用户 的需 求和爱好 的 产 品则成为难点 , 为了克服这个问题 , 推荐系统 出现并
余 志 虎 , 玉峰 戚
( 南京 邮 电大学 计 算机 学 院, 苏 南京 2 0 0 ) 江 1 0 3
摘 要 : 同过滤推荐 技术 是现如 今 电子 商务 系统 中最重要 的技术 之一 。针对 目前协 同 过滤 推荐 技术 中存 在 的 因数 据极 协
度稀疏 而导致 相似性 度量 不准 , 荐质 量严重受 到影 响的 问题 , 推 利用 云模 型在定 性知 识表 示 及定 性 、 量知 识 转 换时 的作 定 用 , 出一种 基于 云模 型 的数据填 充算法 , 提 它利 用相 似用 户计算 目标用户 评分 缺失项 。利用经 典 实验 数 据进 行验 证 比较 ,
中图分 类号 : P 0 . T 316 文 献标识码 : A 文章编号 : 7 — 2 X 2 1 )2 0 4 4 1 3 6 9 ( li g Al o ihm s d o o d M o e Da a Filn g r t Ba e n Cl u d l
YU h— u Z i ,QIYufn h — g e
(c ̄ l f o ue, aj gUnvrt f ot & T l o Sh mp t N ni i syo ss oC r n ei P e cmmui t n , nig2 0 0 , hn ) e nc i sNaj 10 3 C i ao n a
协同过滤的基本思想

协同过滤的基本思想
协同过滤(CollaborativeFiltering)推荐算法是最经典、最常用的推荐算法。
所谓协同过滤,基本思想是根据用户之前的喜好以及其他兴趣相近的用户的选择来给用户推荐物品(基于对用户历史行为数据的挖掘发现用户的喜好偏向,并预测用户可能喜好的产品进行推荐),一般是仅仅基于用户的行为数据(评价、购买、下载等),而不依赖于项的任何附加信息(物品自身特征)或者用户的任何附加信息(年龄,性别等)。
目前应用比较广泛的协同过滤算法是基于邻域的方法,而这种方法主要有下面两种算法:
1、基于用户的协同过滤算法(UserCF):给用户推荐和他兴趣相似的其他用户喜欢的产品。
2、基于物品的协同过滤算法(ItemCF):给用户推荐和他之前喜欢的物品相似的物品。
不管是UserCF还是ItemCF算法,非常重要的步骤之一就是计算用户和用户或者物品和物品之间的相似度,所以下面先整理常用的相似性度量方法,然后再对每个算法的具体细节进行展开。
【计算机科学】_协同过滤推荐_期刊发文热词逐年推荐_20140724
推荐指数 4 2 2 1 1 1 1 1 1 1 1 1 1
2011年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17
科研热词 协同过滤 项目类别 语义相似 移动数字图书馆 知识推荐 知识发现 用户推荐 数据挖掘 推荐 情境 协同过滤:推荐系统 信息熵 二分网络 个性化推荐 个性化情境 slope one算法 k近邻
推荐指数 4 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2012年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26
科研热词 协同过滤 重叠度因子 跨荐 数据稀疏性 推荐系统 推荐算法 推荐 多相似度 协同过滤推荐算法 协同过滤推荐 协作 动态混合qos 全局相似性 主题模型 个性化推荐 三维协同过滤 user-based mae cubesvd cubeals
推荐指数 5 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2009年 序号 1 2 3 4 5 6
科研热词 协同过滤 自动推荐系统 社会网络 推荐系统模型 基于内容 同构化整合
推荐指数 2 1 1 1 1 1
2010年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13
科研热词 协同过滤 电子商务 推荐系统 评分信息 相似性权重 相似度算法 用户特征向量 用户偏好度 时间效应 共同邻居 共同评分 全面均值 个性化
推荐指数 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2013年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
基于项目分类的协同过滤改进算法
I 指标 法” 基于权重的相似性 等计算 方法也 陆续被提 出。 、 另外 , 利用修正的条件概率方 法计算 项 目相 似性 ; 采用基 于 用户兴趣度 的相 似性 计算 方法 ; 于项 目类 别 的相 似性 方 基
法 和结合共 同邻居及用户评分 的相 似性度量 方法也 被研 究者们提 出以改进 相似度计 算的准确性 。
熊忠阳 , 刘
摘
芹, 张玉芳 , 李文 田
( 重庆 大 学 计算机 学院 , 重庆 404 ) 00 4
要 :为 了解 决 用户评分 数据 稀疏 性和 用户 最近邻 寻找 的 准确 性 问题 , 出 了一 种基 于项 目分 类 的协 同过 滤 提
推 荐 改进 算法 。该算 法首先 利 用项 目分类信 息为类 内未评 分项 目预 测评 分值 ; 然后 通过 计算 类 内用 户间 的相似 度得 到 目 用 户的最 近邻居 ; 标 最后进 行推 荐 。实验 结果表 明 , 算法 可以 准确 地获 取 用户兴趣 最近 邻 , 效地 解 该 有
n ae t e g b r ,at r ih i c ud rc mme d t e i msb s d o h n l r dci n e rs — ih o s f c o l e o n e wh t n h e a e n t e f a e it .E p rme tlrs l h w a i t i p o x e i na e ut s o t tt s s h h
Abs r t To o r o h a a k a e y te d t pa s n s nd i c urt ft e u e eg o s,t i pe a p t ac : vec me t e drwb c sc us d b h a as re e sa na c a eo h s rn ihb r hspa rc me u wi n i r v d c la r tv le n e o t a mp o e o lboa ie f tr g r c mme ai n ag rt m ,ba i n t e h i u fie c a sfc to h i i nd to lo ih sng o he t c n q e o t m l si a in. The ag — i lo rt m r tr td he u ae t ms b p y n he ie ca sfc to a d t e a c lt d t e u e i lrt t n c a s sf r ih f s a e t nrt d ie y a pli g t tm ls i ai n, n h n c l ua e h s r smia iy wihi l se o i i
在线学习系统中的深度学习推荐算法分析
在线学习系统中的深度学习推荐算法分析作者:陈曦来源:《数码设计》2020年第09期摘要:近年来,我国信息技术高速发展,智能手机几乎普及到了每一个人,人们的生活、工作方式发生了巨大的变化,已经进入到了互联网时代。
在这个背景下,在线学习系统已经成为许多人获取知识的重要途径,互联网技术与教育相结合已经是必然趨势,本文对在线学习系统中的深入学习推荐算法进行了讨论。
关键词:互联网技术;在线学习系统;深度学习中图分类号:TP391.3;文献标识码:A;文章编号:1672-9129(2020)09-0162-02引言:传统教育模式存在同质化严重、个性化不足等问题,无法发挥每个学生的特长。
在互联网背景下,传统的教育模式迎来了改变,互联网技术极大丰富了教学手段和教学资源,通过深度学习推荐算法,能够建立个性化、智能化的在线学习系统。
因此对在线学习系统中的深度学习推荐算法进行深入分析与研究,具有重要意义。
1;在线学习系统中深度学习推进算法的重要性在互联网高度发展的背景下,在线学习的模式受到越来越多的关注,在线学习没有空间与时间的限制,可以提供大量的教学资源,学习者可以利用多媒体资源进行自主学习,学习方式更加灵活。
同时。
学习者还能通过网络社区与其他学习者进行交流和探讨,能加深学生对知识的理解,培养学生的自主学习能力。
目前,在线学习系统逐渐被应用在教育工作的各个方面,已经成为了教育系统中的重要组成部分。
大部分在线学习系统都是以平台为核心,平台上的教学资源众多,且存在同质化现象。
学生在学习之前,首先需要一定时间来寻找有用、适合自己的教学资源,降低了学习效率和学习体验。
深度学习推荐算法有效解决了这个难题,深度学习推荐算法可以收集并分析每个学习者的历史行为数据和兴趣偏好,构建全面的数据学习模型,自动为学生推荐其需要或感兴趣的教育资源,能够为学生提供个性化、智能化的服务。
将深度学习推荐算法应用到在线学习系统中,将原本的搜索模式改变成了智能服务模式,极大的提高了学习者的学习效率和学习体验。
Web服务QoS预测与主动推荐方法综述
Web服务QoS预测与主动推荐方法综述闫红丹;杨怀洲【摘要】随着Web服务数量的迅猛增加,如何及时有效地根据服务质量(Quality of Service,QoS)推荐优质服务已成为研究热点.在实际应用中,由于网络环境、地理位置和服务运行环境等存在差异,导致QoS的不同并表现出强烈的不稳定性,仅通过挖掘QoS数据中近邻信息难以保证预测的准确度.协同过滤算法作为现今在解决QoS预测准确度方面的一个重要方法,就非常值得研究.本文针对基于Web服务QoS预测的主动服务推荐方法及其存在的问题进行了分析和总结.总结了当下QoS 预测方法的研究趋势和发展前景.【期刊名称】《智能计算机与应用》【年(卷),期】2019(009)001【总页数】4页(P199-202)【关键词】Web服务;QoS预测;协同过滤;服务推荐【作者】闫红丹;杨怀洲【作者单位】西安石油大学计算机学院,西安710065;西安石油大学计算机学院,西安710065【正文语种】中文【中图分类】TP3930 引言近年来,Internet的迅猛发展使其成为全球信息传递与共享的巨大资源库。
越来越多的网络环境下的Web应用系统被建立起来,Web服务也日益丰富。
根据近几年数字统计显示,网络上有由7 739个提供者提供有28 606个可用的Web服务[1]。
那么如何从海量的Web服务中快速有效地帮用户推荐一个优质的服务,就非常重要了。
Web服务作为独立的,自描述的模块化应用程序,是一种松散耦合的软件系统。
旨在支持网络上机器到机器的自动交互,已经普遍部署并且可以在Web上使用。
这让使用者查找、选择和调用性能较好的Web服务变得很难。
QoS通常被用于描述Web服务的非功能特性[2],QoS的服务特性有性能(执行时间、响应时间、吞吐量等)、可信度(可用性、可靠性、准确性、稳定性、完整性等)和用户满意度等。
QoS是动态发现、查询、选择和主动推荐服务的基础[3]。
但是获取真实有效的与用户相关的QoS属性的值是一项具有挑战性的任务,这就需要对QoS进行预测。