
postgresql常用命令讲解
1.createdb 数据库名称产生数据库2.dropdb 数据库名称删除数据库3.CREATE USER 用户名称创建用户4.drop User 用户名称删除用户5.SELECT usename FROM pg_user;查看系统用户信息\du7.SELECT version();查看版本信息8.psql 数据库名打开psql交互工具9.mydb=> \i basics.sql\i 命令从指定的文件中读取命令。
10.COPY weather FROM '/home/user/weather.txt'; 批量将文本文件中内容导入到wether表11.SHOW search_path;显示搜索路径12.创建用户CREATE USER 用户名WITH PASSWORD '密码'13.创建模式CREATE SCHEMA myschema;14.删除模式DROP SCHEMA myschema;15.查看搜索模式SHOW search_path;16.设置搜索模式SET search_path TO myschema,public;17.创建表空间create tablespace 表空间名称location '文件路径';18.显示默认表空间show default_tablespace;19.设置默认表空间set default_tablespace=表空间名称;20.指定用户登录psql MTPS -u21.显示当前系统时间、now()22.配置plpgsql语言CREATE LANGUAGE 'plpgsql' HANDLER plpgsql_call_handler 23.删除规则DROP RULE name ON relation [ CASCADE | RESTRICT ]输入name要删除的现存的规则.relation该规则应用的关系名字(可以有大纲修饰).CASCADE自动删除依赖于此规则的对象。
RESTRICT如果有任何依赖对象,则拒绝删除此规则。
这个是缺省。
24.日期格式函数select 'P'||to_char(current_date,'YYYYMMDD')||'01'25.产生组Create Group 组名称26.修改用户归属组Alter Group 组名称add user 用户名称26.为组赋值权限grant 操作On 表名称to group 组名称:27.创建角色Create Role 角色名称28.删除角色Drop Role 角色名称29.获得当前postgresql版本SELECT version();30.在linux中执行计划任务通过crontab执行su root -c "psql -p 5433 -U developer MTPS -c'select test()'"developer用户的密码存储于环境变量PGPASSWORD中。
31.查询表是否存在select * from pg_statio_user_tables where relname='你的表名';32.为用户复制SCHEMA权限grant all on SCHEMA 作用域名称to 用户名称33.整个数据库导出pg_dumpall -D -p 端口号-h 服务器IP -U postgres(用户名) >/home/xiaop/all.bak34.数据库备份恢复psql -h 192.168.0.48 -p 5433 -U postgres35.当前日期函数current_date36.返回第十条开始的5条记录select * from tabname limit 5 offset 10;37.为用户赋模式权限Grant on schema developer to UDataHouse38.将字符转换为日期时间select to_timestamp('2010-10-21 12:31:22', 'YYYY-MM-DD hh24:mi:ss')39.数据库备份pg_dumpall -h 192.168.0.4 -p 5433 -Upostgres >/DataBack/Postgresql2010012201.dmp如8.1以后多次输入密码40.\dn查看schema41.删除schemadrop schema _clustertest cascade;42.导出表./pg_dump -p 端口号-U 用户-t 表名称-f 备份文件位置数据库;43.字符串操作函数select distinct(split_part(ip,'.',1)||'.'||split_part(ip,'.',2)) from t_t_userip order by (split_part(ip,'.',1)||'.'||split_part(ip,'.',2));44.删除表主键alter table 表名drop CONSTRAINT 主键名称;45.创建表空间create tablespace 空间名称location '路径'46.查看表结构select * from information_schema.columns./postgres -D /usr/local/src/dataor./pg_ctl -D /usr/local/src/data -l logfile start47.查看数据库大小SELECT pg_size_pretty(pg_database_size('MTPS')) As fulldbsize;48.查看数据库表大小SELECT pg_size_pretty(pg_total_relation_size('developer.t_L_collectfile')) As fulltblsize,pg_size_pretty(pg_relation_size('developer.t_L_collectfile')) As justthetblsize49.设置执行超过指定秒数的sql语句输出到日志log_min_duration_statement = 350.超过一定秒数sql自动执行执行计划shared_preload_libraries = 'auto_explain'custom_variable_classes = 'auto_explain'auto_explain.log_min_duration = 4s51.数据库备份select pg_start_backup('backup baseline');select pg_stop_backup();recovery.confrestore_command='cp /opt/buxlog/%f %p'52.重建索引REINDEX { INDEX | TABLE | DATABASE | SYSTEM } name [ FORCE ]INDEX重新建立声明了的索引。
TABLE重新建立声明的表的所有索引。
如果表有个从属的"TOAST"表,那么这个表也会重新索引。
DATABASE重建当前数据库里的所有索引。
除非在独立运行模式下,会忽略在共享系统表上的索引(见下文)。
SYSTEM在当前数据库上重建所有系统表上的索引。
不会处理在用户表上的索引。
另外,除了是在单主机模式下,共享的系统表也会被忽略(见下文)。
name需要重建索引的索引,表或者数据库的名称。
表和索引名可以有模式修饰。
目前,REINDEX DATABASE 和REINDEX SYSTEM 只能重建当前数据库的索引,因此其参数必须匹配当前数据库的名字。
FORCE这是一个废弃的选项,如果声明,会被忽略。
54.数据字典查看表结构SELECT column_name, data_type from information_schema.columns where table_name = 'blog_sina_content_train';52.查看被锁定表SELECT pg_class.relname AS table, pg_database.datname AS database, pid, mode, grantedFROM pg_locks, pg_class, pg_databaseWHERE pg_locks.relation = pg_class.oidAND pg_locks.database = pg_database.oid;53.查看客户端连接情况SELECT client_addr ,client_port,waiting,query_start,current_query FROMpg_stat_activity;54.常看数据库.conf配置show all55.修改数据库postgresql.conf参数修改postgresql.conf内容pg_ctl reload56.回滚日志强制恢复pg_resetxlog -f 数据库文件路径idvalue | remark----------+--------33953557 | inser57.当前日期属于一年中第几周select EXTRACT(week from TIMESTAMP '2010-10-22');58.显示最近执行命令\sI. SQL 命令ABORT —退出当前事务ALTER AGGREGATE —修改一个聚集函数的定义ALTER CONVERSION —修改一个编码转换的定义ALTER DATABASE —修改一个数据库ALTER DOMAIN —改变一个域的定义ALTER FUNCTION —修改一个函数的定义ALTER GROUP —修改一个用户组ALTER INDEX —改变一个索引的定义ALTER LANGUAGE —修改一个过程语言的定义ALTER OPERATOR —改变一个操作符的定义ALTER OPERATOR CLASS —修改一个操作符表的定义ALTER ROLE —修改一个数据库角色ALTER SCHEMA —修改一个模式的定义ALTER SEQUENCE —更改一个序列生成器的定义ALTER TABLE —修改表的定义ALTER TABLESPACE —改变一个表空间的定义ALTER TRIGGER —改变一个触发器的定义ALTER TYPE —改变一个类型的定义ALTER USER —改变数据库用户帐号ANALYZE —收集与数据库有关的统计BEGIN —开始一个事务块CHECKPOINT —强制一个事务日志检查点CLOSE —关闭一个游标CLUSTER —根据一个索引对某个表集簇COMMENT —定义或者改变一个对象的评注COMMIT —提交当前事务COMMIT PREPARED —提交一个早先为两阶段提交准备好的事务COPY —在表和文件之间拷贝数据CREATE AGGREGATE —定义一个新的聚集函数CREATE CAST —定义一个用户定义的转换CREATE CONSTRAINT TRIGGER —定义一个新的约束触发器CREATE CONVERSION —定义一个新的的编码转换CREATE DATABASE —创建新数据库CREATE DOMAIN —定义一个新域CREATE FUNCTION —定义一个新函数CREATE GROUP —定义一个新的用户组CREATE INDEX —定义一个新索引CREATE LANGUAGE —定义一种新的过程语言CREATE OPERATOR —定义一个新的操作符CREATE OPERATOR CLASS —定义一个新的操作符表CREATE ROLE — define a new database role CREATE RULE —定义一个新的重写规则CREATE SCHEMA —定义一个新的模式CREATE SEQUENCE —创建一个新的序列发生器CREATE TABLE —定义一个新表CREATE TABLE AS —从一条查询的结果中定义一个新表CREATE TABLESPACE —定义一个新的表空间CREATE TRIGGER —定义一个新的触发器CREATE TYPE —定义一个新的数据类型CREATE USER —创建一个新的数据库用户帐户CREATE VIEW —定义一个视图DEALLOCATE —删除一个准备好的查询DECLARE —定义一个游标DELETE —删除一个表中的行DROP AGGREGATE —删除一个用户定义的聚集函数DROP CAST —删除一个用户定义的类型转换DROP CONVERSION —删除一个用户定义的编码转换DROP DATABASE —删除一个数据库DROP DOMAIN —删除一个用户定义的域DROP FUNCTION —删除一个函数DROP GROUP —删除一个用户组DROP INDEX —删除一个索引DROP LANGUAGE —删除一个过程语言DROP OPERATOR —删除一个操作符DROP OPERATOR CLASS —删除一个操作符表DROP ROLE —删除一个数据库角色DROP RULE —删除一个重写规则DROP SCHEMA —删除一个模式DROP SEQUENCE —删除一个序列DROP TABLE —删除一个表DROP TABLESPACE —删除一个表空间DROP TRIGGER —删除一个触发器定义DROP TYPE —删除一个用户定义数据类型DROP USER —删除一个数据库用户帐号DROP VIEW —删除一个视图END —提交当前的事务EXECUTE —执行一个准备好的查询EXPLAIN —显示语句执行规划FETCH —用游标从查询中抓取行GRANT —定义访问权限INSERT —在表中创建新行LISTEN —监听一个通知LOAD —装载或重载一个共享库文件LOCK —明确地锁定一个表MOVE —重定位一个游标NOTIFY —生成一个通知PREPARE —创建一个准备好的查询PREPARE TRANSACTION —为当前事务做两阶段提交的准备REINDEX —重建索引RELEASE SAVEPOINT —删除一个前面定义的保存点RESET —把一个运行时参数值恢复为缺省值REVOKE —删除访问权限ROLLBACK —退出当前事务ROLLBACK PREPARED —取消一个早先为两阶段提交准备好的事务ROLLBACK TO —回滚到一个保存点SAVEPOINT —在当前事务里定义一个新的保存点SELECT —从表或视图中取出若干行SELECT INTO —从一个查询的结果中定义一个新表SET —改变运行时参数SET CONSTRAINTS —设置当前事务的约束检查模式SET ROLE — set the current user identifier of the current sessionSET SESSION AUTHORIZATION —为当前会话设置会话用户标识符和当前用户标识符SET TRANSACTION —设置当前事务的特性SHOW —显示运行时参数的数值START TRANSACTION —开始一个事务块TRUNCATE —清空一个或者一堆表UNLISTEN —停止监听通知信息UPDATE —更新一个表中的行VACUUM —垃圾收集以及可选地分析一个数据库II. 客户端应用clusterdb —对一个PostgreSQL数据库进行建簇createdb —创建一个新的PostgreSQL 数据库createlang —定义一种新的PostgreSQL 过程语言createuser —定义一个新的PostgreSQL 用户帐户dropdb —删除一个现有PostgreSQL 数据库droplang —删除一种PostgreSQL 过程语言dropuser —删除一个PostgreSQL 用户帐户ecpg —嵌入的SQL C 预处理器pg_config —检索已安装版本的PostgreSQL 的信息pg_dump —将一个PostgreSQL数据库抽出到一个脚本文件或者其它归档文件中pg_dumpall —抽出一个PostgreSQL 数据库集群到脚本文件中pg_restore —从一个由pg_dump 创建的备份文件中恢复PostgreSQL 数据库。
postgresql copy用法

PostgreSQL COPY用法在PostgreSQL中,COPY是一种用于将数据导入或导出数据库的强大工具。
它可以高效地处理大量数据,并提供了许多选项来满足不同的需求。
本文将深入探讨PostgreSQL COPY的用法,包括如何导入和导出数据,以及一些常见的使用场景和技巧。
1. 导入数据要将数据导入PostgreSQL数据库,可以使用COPY命令。
COPY命令有两种形式:COPY FROM和COPY TO,分别用于从文件导入数据和将数据导出到文件。
1.1 COPY FROMCOPY FROM命令用于将数据从文件导入到数据库表中。
它的基本语法如下:COPY table_name [ ( column_name [, ...] ) ]FROM { 'filename' | PROGRAM 'command' | STDIN }[ [ WITH ] ( option [, ...] ) ]其中,table_name是目标表的名称,column_name是要导入的列的列表。
filename 是包含要导入数据的文件的路径,’filename’表示文件路径,PROGRAM ’command’表示要执行的外部命令,STDIN表示从标准输入读取数据。
COPY FROM命令还支持一些选项,可以通过WITH子句指定。
常用的选项包括DELIMITER、NULL、HEADER等。
例如,可以使用DELIMITER选项指定字段分隔符:COPY table_name FROM 'filename' WITH DELIMITER ','1.2 示例假设有一个名为employees的表,包含以下列:id、name、age、salary。
要将数据从一个CSV文件导入到该表中,可以使用以下命令:COPY employees (id, name, age, salary) FROM 'path/to/file.csv' WITH DELIMITER ','这将从指定的文件中读取数据,并将其插入到employees表中。
postgresql的d命令

postgresql的d命令ostgreSQL-psql常⽤命令⽂章索引[隐藏]\d命令1 2 3格式:\d [ pattern ] \d [ pattern ] +该命令将显⽰每个匹配关系(表,视图,索引,序列)的信息,包括对象所有的列,它们的类型,表空间(如果不是默认的)和任何特殊属性(如NOT NULL或默认值等)。
与唯⼀约束相关的索引,规则,约束,触发器也同样会显⽰出来。
如果关系是⼀个视图,还会显⽰视图的定义。
1.如果\d命令什么都不带,将列出当前数据库中的所有表。
1 2 3 4 5 6 7 8 9 10 11 12sample_db=# \dList of relationsSchema | Name | Type | Owner --------+----------------+-------+---------public | account | table | postgre public | book | table | postgre public | customers | table | postgre public | fruits | table | postgre ...public | view_t | view | postgre public | view_t2 | view | postgre (42 rows)2.\d后⾯跟⼀个表名,表⽰显⽰这个表的结构定义。
1 2 3 4 5 6 7 8 9 10 11 12sample_db=# \d tb_dept2Table "public.tb_dept2"Column | Type | Modifiers----------+-----------------------+-----------id | integer | not nullname | character varying(22) |location | character varying(50) |Indexes:"tb_dept2_pkey" PRIMARY KEY, btree (id)"tb_dept2_name_key" UNIQUE CONSTRAINT, btree (name)Referenced by:TABLE "tb_tmp" CONSTRAINT "fk_emp_dept" FOREIGN KEY (deptid) REFERENCES tb_dept2(id)3.\d也可以显⽰索引信息1 2 3 4 5 6sample_db=# \d tb_dept2_pkeyIndex "public.tb_dept2_pkey"Column | Type | Definition--------+---------+------------id | integer | idprimary key, btree, for table "public.tb_dept2"4.\d后⾯可以跟⼀通配符"*"或"?" 1sample_db=# \d boo?1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22sample_db=# \d boo?Table "public.book"Column | Type | Modifiers------------------+------------------------+-----------bookid | integer | not nullbookname | character varying(255) | not nullauthors | character varying(255) | not nullinfo | character varying(255) |comment | character varying(255) |year_publication | date | not nullIndexes:"uniqididx" UNIQUE, btree (bookid)"bkcmtidx" btree (comment)"bknameidx" btree (bookname)sample_db=# \d a*Table "public.account"Column | Type | Modifiers--------+---------------+-----------id | integer |name | character(20) |Triggers:account_stamp BEFORE INSERT ON account FOR EACH ROW EXECUTE PROCEDURE account_stam()5.\d+命令,该命令将显⽰⽐\d命令更详细的信息,除了前⾯介绍的那些,它还会显⽰任何与表列关联的注释,以及表中出现的ODI。
Postgresql常用命令集

PostgreSQL 在后台运行的是一个叫做postmaster 的程序,缺省的TCP/IP 端口为5432。
在客户端可以有很多工具连接到服务器上操作数据,对于一个Unix 下的系统管理员而言,熟练掌握psql 环境下的数据操作是十分需要的。
在启动psql 之前,当然要求psql 在你的PATH 路径上,所以我们需要指定:$ export PATH=$PATH:/usr/local/pgsql/bin然后我们就可以进入了:PostgreSQL 常用命令2010年09月03日星期五 05:32 P.M.\d [ table ]列出数据库中的表,或(如果声明了)表table的列/字段.如果表名是用统配符(“*”)声明的,列出所有表和表的列/字段信息.\da列出所有可用聚集.\dd object列出pg_description里对声明的对象的描述,对象可以是一个表,表中的列/字段,类型,操作符或聚集.小技巧:并非所有对象在pg_description里有描述.此后期命令在快速获取 Postgres 内部特性时很有用.\df列出函数.\di只列出索引.\do只列出操作符.\ds只列出序列.\dS列出系统表和索引.\dt只列出非系统表.\dT列出类型.\e [ filename ]编辑当前查询缓冲或文件filename 的内容.\E [ filename ]编辑当前查询缓冲或文件filename 的内容并且在编辑结束后执行之.\f [ separator ]设置域分隔符.缺省是单个空白.\g [ { filename | |command } ]将当前查询输入缓冲送给后端并且(可选的)将输出放到filename或通过管道将输出送给一个分离的Unix shell 用以执行command.\h [ command ]给出声明的 SQL 命令的语法帮助.如果command不是一个定义的 SQL命令(或在 psql 里没有文档),或没有声明command,这时 psql将列出可获得帮助的所有命令的列表.如果命令command是一个通配符(“*”),则给出所有 SQL 命令的语法帮助.\H切换 HTML3 输出.等效于 -H 命令行选项.\i filename从文件filename中读取查询到输入缓冲.\l列出服务器上所有数据库.\m切换老式监视器样的表输出,这时表周围有边界字符包围着.这是标准SQL 输出.缺省时,psql 只包括列/字段间的分隔符.\o [ { filename | |command } ]将后面的查询结果输出到文件filename或通过管道将后面结果输出到一个独立的Unix shell 里执行command.如果没有声明参数,将查询结果输出到stdout.\p打印当前查询缓冲区.\q退出 psql 程序.\r重置(清空)查询缓冲区.\s [ filename ]将命令行历史打印出或是存放到filename.如果省略filename,将不会把后继的命令存放到历史文件中.此选项只有在 psql 配置成使用输入行时才有效.\t切换输出的列/字段名的信息头和行记数脚注(缺省是开).\T table_options允许你在使用HTML 3.0 格式输出时声明放在表table ...中的标记选项.例如,border将给你的表以边框.这必须和\H后期命令一起使用.\x切换扩展行格式.当打开时,每一行将在左边打印列/字段名而在右边打印列/字段值.这对于那些不能在一行输出的超长行是很有用的.HTML 行输出模式也支持这个标记.\w filename将当前查询缓冲区输出到文件filename.\z生成一个带有正确 ACL(赋予/禁止权限)的数据库中所有表的输出列表.\! [ command ]回到一个独立的Unix shell或执行一个Unix 命令command.\?获得关于反斜杠(“\”) 命令的帮助.一般选项\c[onnect] [数据库名|- [用户名称]]联接到新的数据库 (当前为 "test")\cd [目录名] 改变当前的工作目录\copyright 显示 PostgreSQL 用法和发布信息\encoding [编码]显示或设置客户端编码\h [名字] SQL 命令的语法帮助, 用 * 可以看所有命令的帮助\q 退出 psql\set [名字 [值]]设置内部变量, 如果没有参数就列出所有\timing 查询计时开关切换 (目前是关闭)\unset 名字取消(删除)内部变量\! [命令] 在 shell 里执行命令或者开始一个交互的 shell 信息选项\d [名字] 描述表, 索引, 序列, 或者视图\d{t|i|s|v|S} [模式] (加 "+" 获取更多信息)列出表/索引/序列/视图/系统表\da [模式] 列出聚集函数\db [模式] 列出表空间 (加 "+" 获取更多的信息)\dc [模式] 列出编码转换\dC 列出类型转换\dd [模式] 显示目标的注释\dD [模式] 列出域\df [模式] 列出函数 (加 "+" 获取更多的信息)\dg [模式] 列出组\dn [模式] 列出模式 (加 "+" 获取更多的信息)\do [名字] 列出操作符\dl 列出大对象, 和 \lo_list 一样\dp [模式] 列出表, 视图, 序列的访问权限\dT [模式] 列出数据类型 (加 "+" 获取更多的信息)\du [模式] 列出用户\l 列出所有数据库 (加 "+" 获取更多的信息)\z [模式] 列出表, 视图, 序列的访问权限 (和 \dp 一样)命令: ABORT描述: 终止当前事务语法:ABORT [ WORK | TRANSACTION ]命令: ALTER DATABASE描述: 改变一个数据库语法:ALTER DATABASE 名字 SET 参数 { TO | = } { 值 | DEFAULT }ALTER DATABASE 名字 RESET 参数ALTER DATABASE 名字 RENAME TO 新名字ALTER DATABASE 名字 OWNER TO 新属主命令: ALTER GROUP描述: 改变一个用户组语法:ALTER GROUP 组名称 ADD USER 用户名称 [, ... ]ALTER GROUP 组名称 DROP USER 用户名称 [, ... ]ALTER GROUP 组名称 RENAME TO 新名称命令: ALTER INDEX描述: 改变一个索引的定义语法:ALTER INDEX 索引名称动作 [, ... ]ALTER INDEX 索引旧名称RENAME TO 索引新名称动作为以下之一:OWNER TO 新属主SET TABLESPACE indexspace_name命令: ALTER SEQUENCE描述: 改变一个序列生成器的定义语法:ALTER SEQUENCE 名字 [ INCREMENT [ BY ] 递增 ][ MINVALUE 最小值 | NO MINVALUE ] [ MAXVALUE 最大值 | NO MAXVALUE ] [ RESTART [ WITH ] 开始 ] [ CACHE 缓存 ] [ [ NO ] CYCLE ]命令: ALTER TABLE描述: 改变一个表的定义语法:ALTER TABLE [ ONLY ] 表名 [ * ]action [, ... ]ALTER TABLE [ ONLY ] 表名 [ * ]RENAME [ COLUMN ] 字段名 TO 新字段名ALTER TABLE 表名RENAME TO 新表名action 为下面的一种:ADD [ COLUMN ] 字段名类型 [ 字段约束 [ ... ] ]DROP [ COLUMN ] 字段名 [ RESTRICT | CASCADE ]ALTER [ COLUMN ] 字段名 TYPE 类型 [ USING 表达式 ]ALTER [ COLUMN ] 字段名 SET DEFAULT 表达式ALTER [ COLUMN ] 字段名 DROP DEFAULTALTER [ COLUMN ] 字段名 { SET | DROP } NOT NULLALTER [ COLUMN ] 字段名 SET STATISTICS integerALTER [ COLUMN ] 字段名 SET STORAGE { PLAIN | EXTERNAL | EXTENDED | MAIN } ADD 表约束DROP CONSTRAINT 约束名字 [ RESTRICT | CASCADE ]CLUSTER ON 索引名称SET WITHOUT CLUSTERSET WITHOUT OIDSOWNER TO 新属主SET TABLESPACE 表空间名字命令: ALTER TRIGGER描述: 改变一个触发器的定义语法:ALTER TRIGGER 名字 ON 表 RENAME TO 新名字命令: ALTER USER描述: 改变一个数据库用户语法:ALTER USER name [ [ WITH ] option [ ... ] ]where option can be:CREATEDB | NOCREATEDB| CREATEUSER | NOCREATEUSER| [ ENCRYPTED | UNENCRYPTED ] PASSWORD 'password'| VALID UNTIL 'abstime'ALTER USER name RENAME TO newnameALTER USER name SET parameter { TO | = } { value | DEFAULT }命令: COPY描述: 在一个文件和一个表之间拷贝数据语法:COPY 表名 [ ( 字段 [, ...] ) ]FROM { '文件名' | STDIN }[ [ WITH ][ BINARY ][ OIDS ][ DELIMITER [ AS ] 'delimiter' ][ NULL [ AS ] 'null string' ][ CSV [ QUOTE [ AS ] 'quote' ][ ESCAPE [ AS ] 'escape' ][ FORCE NOT NULL column [, ...] ]COPY 表名 [ ( 字段 [, ...] ) ]TO { '文件名' | STDOUT }[ [ WITH ][ BINARY ][ OIDS ][ DELIMITER [ AS ] 'delimiter' ][ NULL [ AS ] 'null string' ][ CSV [ QUOTE [ AS ] 'quote' ][ ESCAPE [ AS ] 'escape' ][ FORCE QUOTE column [, ...] ]命令: CREATE TABLE描述: 定义一个新的表语法:CREATE [ [ GLOBAL | LOCAL ] { TEMPORARY | TEMP } ] TABLE table_name ( { column_name data_type [ DEFAULT default_expr ] [ column_constraint [ ... ] ]| table_constraint| LIKE parent_table [ { INCLUDING | EXCLUDING } DEFAULTS ] } [, ... ] )[ INHERITS ( parent_table [, ... ] ) ][ WITH OIDS | WITHOUT OIDS ][ ON COMMIT { PRESERVE ROWS | DELETE ROWS | DROP } ][ TABLESPACE tablespace ]where column_constraint is:[ CONSTRAINT constraint_name ]{ NOT NULL |NULL |UNIQUE [ USING INDEX TABLESPACE tablespace ] |PRIMARY KEY [ USING INDEX TABLESPACE tablespace ] |CHECK (expression) |REFERENCES reftable [ ( refcolumn ) ] [ MATCH FULL | MATCH PARTIAL | MATCH SIMPLE ][ ON DELETE action ] [ ON UPDATE action ] }[ DEFERRABLE | NOT DEFERRABLE ] [ INITIALLY DEFERRED | INITIALLY IMMEDIATE ]and table_constraint is:[ CONSTRAINT constraint_name ]{ UNIQUE ( column_name [, ... ] ) [ USING INDEX TABLESPACE tablespace ] |PRIMARY KEY ( column_name [, ... ] ) [ USING INDEX TABLESPACE tablespace ] |CHECK ( expression ) |FOREIGN KEY ( column_name [, ... ] ) REFERENCES reftable [ ( refcolumn [, ... ] ) ][ MATCH FULL | MATCH PARTIAL | MATCH SIMPLE ] [ ON DELETE action ] [ ON UPDATE action ] }[ DEFERRABLE | NOT DEFERRABLE ] [ INITIALLY DEFERRED | INITIALLY IMMEDIATE ]。
linux下操作PostgreSQL的常用命令
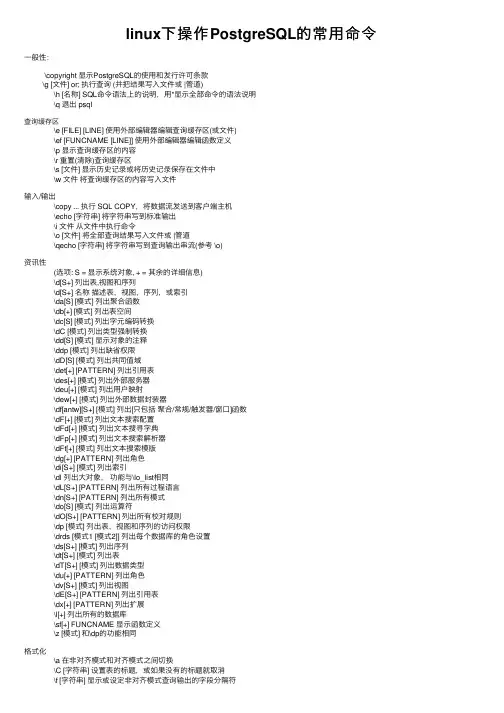
linux下操作PostgreSQL的常⽤命令⼀般性:\copyright 显⽰PostgreSQL的使⽤和发⾏许可条款\g [⽂件] or; 执⾏查询 (并把结果写⼊⽂件或 |管道) \h [名称] SQL命令语法上的说明,⽤*显⽰全部命令的语法说明 \q 退出 psql查询缓存区 \e [FILE] [LINE] 使⽤外部编辑器编辑查询缓存区(或⽂件) \ef [FUNCNAME [LINE]] 使⽤外部编辑器编辑函数定义 \p 显⽰查询缓存区的内容 \r 重置(清除)查询缓存区 \s [⽂件] 显⽰历史记录或将历史记录保存在⽂件中 \w ⽂件将查询缓存区的内容写⼊⽂件输⼊/输出 \copy ... 执⾏ SQL COPY,将数据流发送到客户端主机 \echo [字符串] 将字符串写到标准输出 \i ⽂件从⽂件中执⾏命令 \o [⽂件] 将全部查询结果写⼊⽂件或 |管道 \qecho [字符串] 将字符串写到查询输出串流(参考 \o)资讯性 (选项: S = 显⽰系统对象, + = 其余的详细信息) \d[S+] 列出表,视图和序列 \d[S+] 名称描述表,视图,序列,或索引 \da[S] [模式] 列出聚合函数 \db[+] [模式] 列出表空间 \dc[S] [模式] 列出字元编码转换 \dC [模式] 列出类型强制转换 \dd[S] [模式] 显⽰对象的注释 \ddp [模式] 列出缺省权限 \dD[S] [模式] 列出共同值域 \det[+] [PATTERN] 列出引⽤表 \des[+] [模式] 列出外部服务器 \deu[+] [模式] 列出⽤户映射 \dew[+] [模式] 列出外部数据封装器 \df[antw][S+] [模式] 列出[只包括聚合/常规/触发器/窗⼝]函数 \dF[+] [模式] 列出⽂本搜索配置 \dFd[+] [模式] 列出⽂本搜寻字典 \dFp[+] [模式] 列出⽂本搜索解析器 \dFt[+] [模式] 列出⽂本搜索模版 \dg[+] [PATTERN] 列出⾓⾊ \di[S+] [模式] 列出索引 \dl 列出⼤对象,功能与\lo_list相同 \dL[S+] [PATTERN] 列出所有过程语⾔ \dn[S+] [PATTERN] 列出所有模式 \do[S] [模式] 列出运算符 \dO[S+] [PATTERN] 列出所有校对规则 \dp [模式] 列出表,视图和序列的访问权限 \drds [模式1 [模式2]] 列出每个数据库的⾓⾊设置 \ds[S+] [模式] 列出序列 \dt[S+] [模式] 列出表 \dT[S+] [模式] 列出数据类型 \du[+] [PATTERN] 列出⾓⾊ \dv[S+] [模式] 列出视图 \dE[S+] [PATTERN] 列出引⽤表 \dx[+] [PATTERN] 列出扩展 \l[+] 列出所有的数据库 \sf[+] FUNCNAME 显⽰函数定义 \z [模式] 和\dp的功能相同格式化 \a 在⾮对齐模式和对齐模式之间切换 \C [字符串] 设置表的标题,或如果没有的标题就取消 \f [字符串] 显⽰或设定⾮对齐模式查询输出的字段分隔符 \H 切换HTML输出模式 (⽬前是关闭) \pset 名称 [值] 设定表输出选项 (名称:= {format|border|expanded|fieldsep|footer|null| recordsep|tuples_only|title|tableattr|pager}) \t [开|关] 只显⽰记录 (⽬前是关闭) \T [字符串] 设置HTML <表格>标签属性, 或者如果没有的话取消设置 \x [开|关] 切换扩展输出模式(⽬前是关闭)连接 \c[onnect] {[DBNAME|- USER|- HOST|- PORT|-] | conninfo} connect to new database (currently "postgres") \encoding [编码名称] 显⽰或设定客户端编码 \password [USERNAME] 安全地为⽤户改变⼝令 \conninfo 显⽰当前连接的相关信息操作系统 \cd [⽬录] 改变⽬前的⼯作⽬录 \timing [开|关] 切换命令计时开关 (⽬前是关闭) \! [命令] 在 shell中执⾏命令或启动⼀个交互式shell变量 \prompt [⽂本] 名称提⽰⽤户设定内部变量 \set [名称 [值数]] 设定内部变量,若⽆参数则列出全部变量 \unset 名称清空(删除)内部变量⼤对象 \lo_export LOBOID ⽂件 \lo_import ⽂件 [注释] \lo_list \lo_unlink LOBOID ⼤对象运算。
postgresql 基本查询语句

postgresql 基本查询语句PostgreSQL是一种开源的关系型数据库管理系统,支持SQL语言,本文将列举一些常用的基本查询语句,并对其进行详细介绍。
1. SELECT语句:SELECT语句用于从表中检索数据。
可以使用SELECT语句选择指定的列或所有列,并可以使用WHERE子句进行条件过滤。
2. DISTINCT关键字:DISTINCT关键字用于去除查询结果中的重复行。
例如,SELECT DISTINCT column FROM table;3. WHERE子句:WHERE子句用于在SELECT语句中添加条件过滤。
可以使用比较运算符(如=、<、>等)和逻辑运算符(如AND、OR、NOT)组合多个条件。
例如,SELECT column FROM table WHERE condition;4. ORDER BY子句:ORDER BY子句用于对查询结果进行排序。
可以按照一个或多个列进行排序,并可以指定升序(ASC)或降序(DESC)。
例如,SELECT column FROM table ORDER BY column ASC;5. LIMIT子句:LIMIT子句用于限制查询结果的行数。
可以使用LIMIT关键字加上一个整数值指定需要返回的行数。
例如,SELECT column FROM table LIMIT 10;6. OFFSET子句:OFFSET子句用于指定查询结果的起始位置。
可以使用OFFSET关键字加上一个整数值指定起始位置。
例如,SELECT column FROM table OFFSET 10;7. GROUP BY子句:GROUP BY子句用于将查询结果按照指定列进行分组。
可以结合聚合函数(如SUM、AVG、COUNT等)对每个组进行计算。
例如,SELECT column, COUNT(column) FROM table GROUP BY column;8. HAVING子句:HAVING子句用于在GROUP BY子句后对分组进行条件过滤。
postgre set用法

postgre set用法PostgreSQL是一种功能强大的开源关系型数据库管理系统。
在PostgreSQL中,SET命令用于设置数据库的各种属性或选项。
下面是《PostgreSQLSET用法》的相关内容:一、SET命令的基本用法SET命令用于修改当前会话的数据库设置。
通过使用SET命令,您可以更改数据库的参数、配置选项、角色权限等。
以下是SET命令的基本语法:```scssSET[key]=value;```其中,key表示要设置的参数名称,value表示要设置的值。
您可以在SET命令后指定多个参数和值对,用逗号分隔。
二、设置参数和配置选项在PostgreSQL中,可以使用SET命令设置各种参数和配置选项,以控制数据库的行为和性能。
以下是几个常见的参数和配置选项的示例:1.设置数据目录:```sqlSETconfig_directory='path/to/data/directory';```2.设置最大连接数:```sqlSETmax_connections=100;```3.设置工作进程数量:```sqlSETworker_processes=4;```4.设置最大锁定延迟时间:```scssSETlock_timeout='1s';```通过设置这些参数和选项,您可以更好地控制数据库的性能和稳定性。
三、设置角色权限除了设置参数和配置选项外,您还可以使用SET命令为特定的角色分配权限。
以下是设置角色权限的示例:1.授予角色特定的权限:```sqlGRANTSELECT,INSERTONTABLEmy_tableTOrole_name;```这将授予名为"role_name"的角色对表"my_table"的SELECT和INSERT权限。
2.回收角色已持有的权限:```scssREVOKESELECTONTABLEmy_tableFROMrole_name;```这将从名为"role_name"的角色中回收对表"my_table"的SELECT 权限。
PostgreSQL操作-psql基本命令
PostgreSQL操作-psql基本命令⼀、建⽴连接==================================================================================接⼊PostgreSQL数据库: psql -h IP地址 -p 端⼝ -U 数据库名之后会要求输⼊数据库密码⼆、访问数据库1、列举数据库:\l2、选择数据库:\c 数据库名3、查看该某个库中的所有表:\dt4、切换数据库:\c interface5、查看某个库中的某个表结构:\d 表名6、查看某个库中某个表的记录:select * from apps limit 1;7、显⽰字符集:\encoding8、退出psgl:\q==================================================================================列出当前数据库所有表\dt列出表名SELECT tablename FROM pg_tables;WHERE tablename NOT LIKE 'pg%'AND tablename NOT LIKE 'sql_%'ORDER BY tablename;列出数据库名\l或SELECT datname FROM pg_database;切换数据库\c 数据库名1、通过命令⾏查询\d 数据库 —— 得到所有表的名字\d 表名 —— 得到表结构2、通过SQL语句查询"select * from pg_tables" —— 得到当前db中所有表的信息(这⾥pg_tables是系统视图)"select tablename from pg_tables where schemaname='public'" —— 得到所有⽤户⾃定义表的名字(这⾥"tablename"字段是表的名字,"schemaname"是schema的名字。
postgresql 常用sql 语句
postgresql 常用sql 语句PostgreSQL是一个开源的关系型数据库管理系统,具有稳定性高、功能强大等优点。
在使用PostgreSQL时,掌握常用的SQL语句是非常重要的。
以下是一些常用的PostgreSQL SQL语句:1. 创建数据库:CREATE DATABASE database_name;创建名为database_name的数据库。
2. 删除数据库:DROP DATABASE database_name;删除名为database_name的数据库。
3. 创建表格:CREATE TABLE table_name (column1 datatype,column2 datatype,...);创建名为table_name的表格,并指定各列的数据类型。
4. 删除表格:DROP TABLE table_name;删除名为table_name的表格。
5. 插入数据:INSERT INTO table_name (column1, column2, ...)VALUES (value1, value2, ...);向名为table_name的表格插入数据。
6. 查询数据:SELECT column1, column2, ...FROM table_nameWHERE condition;查询名为table_name的表格中符合条件condition的数据。
7. 更新数据:UPDATE table_nameSET column1 = value1, column2 = value2, ...WHERE condition;更新名为table_name的表格中符合条件condition的数据。
8. 删除数据:DELETE FROM table_nameWHERE condition;删除名为table_name的表格中符合条件condition的数据。
9. 查询表格结构:\d table_name;查看名为table_name的表格的结构。
pgsql常用sql语句
pgsql常用sql语句pgsql是一种开源的关系型数据库管理系统,它支持大部分SQL标准,同时也提供了一些自己的特性。
下面列举了10个pgsql常用的SQL语句,包括数据查询、数据插入、数据更新和数据删除等操作。
1. 查询表中所有数据```SELECT * FROM 表名;```这个语句可以查询指定表中的所有数据,并返回结果。
2. 查询表中指定列的数据```SELECT 列名1,列名2 FROM 表名;```这个语句可以查询指定表中指定列的数据,并返回结果。
3. 查询满足条件的数据```SELECT * FROM 表名 WHERE 条件;```这个语句可以查询满足指定条件的数据,并返回结果。
4. 插入数据```INSERT INTO 表名 (列名1,列名2) VALUES (值1,值2); ```这个语句可以向指定表中插入一条数据。
5. 更新数据```UPDATE 表名 SET 列名 = 值 WHERE 条件;```这个语句可以更新指定表中满足条件的数据。
6. 删除数据```DELETE FROM 表名 WHERE 条件;```这个语句可以删除指定表中满足条件的数据。
7. 创建表```CREATE TABLE 表名 (列名1 数据类型1,列名2 数据类型2,...);```这个语句可以创建一个新的表,并定义表的列名和数据类型。
8. 删除表```DROP TABLE 表名;```这个语句可以删除指定的表。
9. 添加列```ALTER TABLE 表名 ADD 列名数据类型;```这个语句可以向指定表中添加一列。
10. 修改列```ALTER TABLE 表名 ALTER COLUMN 列名 TYPE 数据类型;```这个语句可以修改指定表中的列的数据类型。
以上是pgsql常用的一些SQL语句,可以用于查询、插入、更新和删除数据,以及创建和修改表结构。
通过这些SQL语句,可以方便地对数据库进行操作和管理。
postgresql基本查询语句
postgresql基本查询语句PostgreSQL是一种功能强大的开源数据库管理系统,在各种应用领域广泛使用。
对于数据库管理员和开发人员来说,了解和掌握PostgreSQL中的基本查询语句是至关重要的。
本文将介绍一些常用的基本查询语句,并提供相应的示例。
1. SELECT语句SELECT语句是在数据库中检索数据的基本方式。
它可以从一个或多个表中选择特定的列,并通过WHERE子句添加过滤条件。
下面是一个SELECT语句的示例:```sqlSELECT 列名1, 列名2, ...FROM 表名WHERE 条件;```示例:```sqlSELECT first_name, last_nameFROM employeesWHERE department = 'IT';```这个查询语句将从名为"employees"的表中选取"first_name"和"last_name"两列,并且只选择部门为"IT"的员工。
2. INSERT语句INSERT语句用于向数据库中的表中插入新的行。
它指定要插入的表、要插入的列和要插入的值。
下面是一个INSERT语句的示例:```sqlINSERT INTO 表名 (列1, 列2, ...)VALUES (值1, 值2, ...);```示例:```sqlINSERT INTO employees (first_name, last_name, department)VALUES ('John', 'Doe', 'HR');```这个INSERT语句将在"employees"表中插入一行数据,包含"first_name"、"last_name"和"department"三列,并为它们指定了相应的值。