
PostgreSQL常用命令.
PostgreSQL 常用命令 \d [ table ]
列出数据库中的表,或(如果声明了)表 table 的列/字段.如果表名是用统配符 (“*”)声明的,列出所有表和表的列/字段信息. \da
列出所有可用聚集. \dd object
列出 pg_description 里对声明的对象的描述,对象可以是一个表,表中的列/字段,类型,操作符或聚集. 小技巧:并非所有对象在 pg_description 里有描述.此后期命令在快速获取 Postgres 内部特性时很有用. \df
列出函数. \di
只列出索引. \do
只列出操作符. \ds
只列出序列. \dS
列出系统表和索引. \dt
只列出非系统表. \dT
列出类型. \e [ filename ]
编辑当前查询缓冲或文件 filename 的内容. \E [ filename ]
编辑当前查询缓冲或文件 filename 的内容并且在编辑结束后执行之. \f [ separator ]
设置域分隔符.缺省是单个空白. \g [ { filename | |command
} ]
将当前查询输入缓冲送给后端并且(可选的)将输出放到 filename 或通过管道将输出送给一个分离的Unix shell 用以执行 command. \h [ command ]
给出声明的 SQL 命令的语法帮助.如果 command 不是一个定义的 SQL 命令(或在 psql 里没有文档),或没有声明 command ,这时 psql将列出可获得帮助的所有命令的列表.如果命令 command 是一个通配符(“*”),则给出所有 SQL 命令的语法帮助. \H
切换 HTML3 输出.等效于 -H 命令行选项. \i filename
从文件 filename 中读取查询到输入缓冲. \l 列出服务器上所有数据库. \m
切换老式监视器样的表输出,这时表周围有边界字符包围着.这是标准 SQL 输出.缺省时,psql 只包括列/字段间的分隔符. \o [ { filename | |command
} ]
将后面的查询结果输出到文件 filename 或通过管道将后面结果输出到一个独立的Unix shell 里执行 command.如果没有声明参数,将查询结果输出到stdout. \p
打印当前查询缓冲区. \q
退出 psql 程序. \r
重置(清空)查询缓冲区. \s [ filename ]
将命令行历史打印出或是存放到 filename.如果省略 filename ,将不会把后继的命令存放到历史文件中.此选项只有在 psql 配置成使用输入行时才有效. \t
切换输出的列/字段名的信息头和行记数脚注(缺省是开). \T table_options
允许你在使用HTML 3.0 格式输出时声明放在表 table ... 中的标记选项.例如,border 将给你的表以边框.这必须和 \H 后期命令一起使用. \x
切换扩展行格式.当打开时,每一行将在左边打印列/字段名而在右边打印列/字段值.这对于那些不能在一行输出的超长行是很有用的.HTML 行输出模式也支持这个标记. \w filename
将当前查询缓冲区输出到文件 filename. \z
生成一个带有正确 ACL(赋予/禁止 权限)的数据库中所有表的输出列表. \! [ command ]
回到一个独立的Unix shell或执行一个Unix 命令 command. \?
获得关于反斜杠 (“\”) 命令的帮助.
一般选项 \c[onnect] [数据库名|- [用户名称]] 联接到新的数据库 (当前为 "test") \cd [目录名] 改变当前的工作目录 \copyright 显示 PostgreSQL 用法和发布信息 \encoding [编码] 显示或设置客户端编码 \h [名字] SQL 命令的语法帮助, 用 * 可以看所有命令的帮助 \q 退出 psql \set [名字 [值]] 设置内部变量, 如果没有参数就列出所有 \timing 查询计时开关切换 (目前是 关闭) \unset 名字 取消(删除)内部变量 \! [命令] 在 shell 里执行命令或者开始一个交互的 shell
信息选项 \d [名字] 描述表, 索引, 序列, 或者视图 \d{t|i|s|v|S} [模式] (加 "+" 获取更多信息) 列出表/索引/序列/视图/系统表 \da [模式] 列出聚集函数 \db [模式] 列出表空间 (加 "+" 获取更多的信息) \dc [模式] 列出编码转换 \dC 列出类型转换 \dd [模式] 显示目标的注释 \dD [模式] 列出域 \df [模式] 列出函数 (加 "+" 获取更多的信息) \dg [模式] 列出组 \dn [模式] 列出模式 (加 "+" 获取更多的信息) \do [名字] 列出操作符 \dl 列出大对象, 和 \lo_list 一样 \dp [模式] 列出表, 视图, 序列的访问权限 \dT [模式] 列出数据类型 (加 "+" 获取更多的信息) \du [模式] 列出用户 \l 列出所有数据库 (加 "+" 获取更多的信息) \z [模式] 列出表, 视图, 序列的访问权限 (和 \dp 一样)
命令: ABORT 描述: 终止当前事务 语法: ABORT [ WORK | TRANSACTION ]
命令: ALTER DATABASE 描述: 改变一个数据库 语法: ALTER DATABASE 名字 SET 参数 { TO | = } { 值 | DEFAULT } ALTER DATABASE 名字 RESET 参数 ALTER DATABASE 名字 RENAME TO 新名字 ALTER DATABASE 名字 OWNER TO 新属主 命令: ALTER GROUP 描述: 改变一个用户组 语法: ALTER GROUP 组名称 ADD USER 用户名称 [, ... ] ALTER GROUP 组名称 DROP USER 用户名称 [, ... ] ALTER GROUP 组名称 RENAME TO 新名称
命令: ALTER INDEX 描述: 改变一个索引的定义 语法: ALTER INDEX 索引名称 动作 [, ... ] ALTER INDEX 索引旧名称 RENAME TO 索引新名称 动作为以下之一: OWNER TO 新属主 SET TABLESPACE indexspace_name
命令: ALTER SEQUENCE 描述: 改变一个序列生成器的定义 语法: ALTER SEQUENCE 名字 [ INCREMENT [ BY ] 递增 ] [ MINVALUE 最小值 | NO MINVALUE ] [ MAXVALUE 最大值 | NO MAXVALUE ] [ RESTART [ WITH ] 开始 ] [ CACHE 缓存 ] [ [ NO ] CYCLE ]
命令: ALTER TABLE 描述: 改变一个表的定义 语法: ALTER TABLE [ ONLY ] 表名 [ * ] action [, ... ] ALTER TABLE [ ONLY ] 表名 [ * ] RENAME [ COLUMN ] 字段名 TO 新字段名 ALTER TABLE 表名 RENAME TO 新表名 action 为下面的一种: ADD [ COLUMN ] 字段名 类型 [ 字段约束 [ ... ] ] DROP [ COLUMN ] 字段名 [ RESTRICT | CASCADE ] ALTER [ COLUMN ] 字段名 TYPE 类型 [ USING 表达式 ] ALTER [ COLUMN ] 字段名 SET DEFAULT 表达式 ALTER [ COLUMN ] 字段名 DROP DEFAULT ALTER [ COLUMN ] 字段名 { SET | DROP } NOT NULL ALTER [ COLUMN ] 字段名 SET STATISTICS integer ALTER [ COLUMN ] 字段名 SET STORAGE { PLAIN | EXTERNAL | EXTENDED | MAIN } ADD 表约束 DROP CONSTRAINT 约束名字 [ RESTRICT | CASCADE ] CLUSTER ON 索引名称 SET WITHOUT CLUSTER
PGSQL基础语句汇总
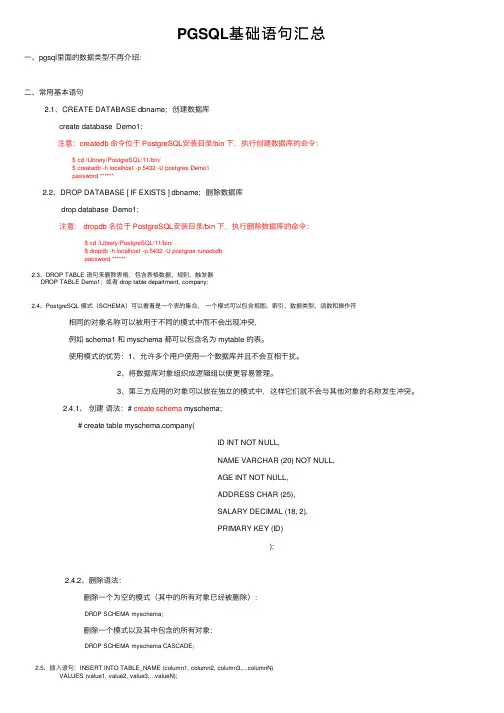
PGSQL基础语句汇总⼀、pgsql⾥⾯的数据类型不再介绍:⼆、常⽤基本语句2.1、CREATE DATABASE dbname; 创建数据库create database Demo1;注意:createdb 命令位于 PostgreSQL安装⽬录/bin 下,执⾏创建数据库的命令: $ cd /Library/PostgreSQL/11/bin/ $ createdb -h localhost -p 5432 -U postgres Demo1 password ******2.2、DROP DATABASE [ IF EXISTS ] dbname; 删除数据库drop database Demo1;注意: dropdb 名位于 PostgreSQL安装⽬录/bin 下,执⾏删除数据库的命令: $ cd /Library/PostgreSQL/11/bin/ $ dropdb -h localhost -p 5432 -U postgres runoobdb password ******2.3、DROP TABLE 语句来删除表格,包含表格数据、规则、触发器DROP TABLE Demo1; 或者 drop table department, company;2.4、PostgreSQL 模式(SCHEMA)可以看着是⼀个表的集合,⼀个模式可以包含视图、索引、数据类型、函数和操作符 相同的对象名称可以被⽤于不同的模式中⽽不会出现冲突, 例如 schema1 和 myschema 都可以包含名为 mytable 的表。
使⽤模式的优势:1、允许多个⽤户使⽤⼀个数据库并且不会互相⼲扰。
2、将数据库对象组织成逻辑组以便更容易管理。
3、第三⽅应⽤的对象可以放在独⽴的模式中,这样它们就不会与其他对象的名称发⽣冲突。
2.4.1、创建语法:# create schema myschema;# create table pany( ID INT NOT NULL, NAME VARCHAR (20) NOT NULL, AGE INT NOT NULL, ADDRESS CHAR (25), SALARY DECIMAL (18, 2), PRIMARY KEY (ID) ); 2.4.2、删除语法: 删除⼀个为空的模式(其中的所有对象已经被删除): DROP SCHEMA myschema; 删除⼀个模式以及其中包含的所有对象: DROP SCHEMA myschema CASCADE;2.5、插⼊语句:INSERT INTO TABLE_NAME (column1, column2, column3,...columnN)VALUES (value1, value2, value3,...valueN);所有字段插⼊值或者 INSERT INTO TABLE_NAMEVALUES (value1,value2,value3,...valueN);案例:# INSERT INTO COMPANY (ID,NAME,AGE,ADDRESS,SALARY,JOIN_DATE) VALUES (1, 'Paul', 32, 'California', 20000.00,'2001-07-13');所有字段插⼊值或者 INSERT INTO COMPANY VALUES (1, 'Paul', 32, 'California', 20000.00,'2001-07-13');2.6、查询语句:SELECT column1, column2,...columnN FROM table_name;案例:SELECT * FROM company;SELECT * FROM COMPANY WHERE SALARY > 50000; =或!=或 >=、IS NOT NULL;案例2: # SELECT (17 + 6) AS ADDITION ;# SELECT COUNT(*) AS "RECORDS" FROM COMPANY;PostgreSQL 还内置了⼀些数学函数,如: 1、avg() :返回⼀个表达式的平均值 2、sum() :返回指定字段的总和 3、count() :返回查询的记录总数2.7、更新数据库表中数据语法:UPDATE table_name SET column1 = value1,column2 = value2...., columnN = valueN WHERE [condition];案例:# UPDATE COMPANY SET SALARY = 15000 WHERE ID = 3;2.8、DELETE 语句来删除 PostgreSQL 表中的数据DELETE FROM table_name WHERE [condition];案例:DELETE FROM table_name WHERE [condition];2.9、查询数据 limit 或 OFFSET案例:=# SELECT * FROM COMPANY LIMIT 4;偏移 offset# SELECT * FROM COMPANY LIMIT 3 OFFSET 2;2.10、DISTINCT 关键字与 SELECT 语句⼀起使⽤,⽤于去除重复记录,只获取唯⼀的记录案例:SELECT DISTINCT name FROM COMPANY;2.11、PostgreSQL 约束⽤于规定表中的数据规则。
PostgreSQL数据库的sql语法(整理版)

PostgreSQL数据库的sql语法(整理版)1. 概述 PostgreSQL是⼀个免费的关系型数据库服务器(ORDBMS)2. 登录数据库 以⽤户的名义登录数据库,这时使⽤的是psql命令psql -h 127.0.0.1 -U dbuser -p 5832 -d database 上⾯的命令的参数含义如下:-h 指定服务器-p 指定端⼝-U 指定⽤户-d 指定数据库 输⼊上⾯的命令以后,系统会提⽰输⼊dbuser⽤户的密码。
输⼊正确,就可以登录控制台了。
3. 控制台命令操作命令设置密码\password dbuser退出控制台\q查看SQL命令的解释\h command ,如\h select查看psql命令列表\?列出所有数据库\l进⼊其他数据库\c [database_name]列出当前数据库的所有表格\d列出某⼀张表的结构\d [table_name]列出所有⽤户\du打开⽂本编辑器\e列出当前数据库和连接的信息\conninfo4. PSQL数据库操作命令操作命令创建数据库create database [db_name];删除数据库drop database [db_name];查询所有数据库select datname from PG_DATABASE; / select * from PG_DATABASE;查询某⼀数据库的所有表select table_name FROM information_schema.tables where table_schema = 'public';创建表create table if not exists ke_p_role ( id serial primary key, #唯⼀值,递增 name varchar (64) not null, #字符串64位 seq smallint not null, #最⼩int型 description varchar(128) not null # 字符串128位 )插⼊表数据insert into ke_p_role (id, name, seq, description) values ('1', 'Administrator', '1', 'Have all permissions'), ('2', 'Devs', '2', 'Own add or delete'), ('3', 'Tourist', '3', 'Only viewer')insert into ke_p_role values ('1', 'Administrator', '1', 'Have all permissions'), ('2', 'Devs', '2', 'Own add orinsert into ke_p_role values ('1', 'Administrator', '1', 'Have all permissions'), ('2', 'Devs', '2', 'Own add ordelete'), ('3', 'Tourist', '3', 'Only viewer')插⼊并返回插⼊的数据insert into ke_p_role values ('1', 'Administrator', '1', 'Have all permissions') returning *;根据字段,不存在则插⼊,存在则更新create table if not exists ke_topic_rank ( cluster varchar(64), topic varchar(128), tkey varchar(128), tvalue bigint, primary key (cluster, topic, tkey))insert into ke_topic_rank values ('test1','test2','test3', 7) on conflict (cluster,topic,tkey) do update set tvalue=alue;查询记录select * from user_tbl;查询记录,带limit和offset偏移量select * from ke_consumer_group_summary where cluster='cluster1' limit 2 offset 0;去重查询select distinct on(name) * from t_ai_project;递归查询with recursive summary as ( (select topic, diffval, timespan from ke_logsize where diffval > 0 order by topic asc, timespan desc limit 1) union all select u.* from summary s, lateral( select topic,diffval,timespan from ke_logsize where diffval > 0 and topic > s.topic order by topic asc, timespan desc limit 1) u)select topic, diffval, timespan, '1' as rownum, '1' as rank from summary;查询,coalesce判断是否为空如果a.logsize为空,则返回右边的0select coalesce(sum(a.logsize),0) from (select logsize from ke_logsize where cluster='cluster1' and topic in ('phone') and tm='20200615' order by timespan desc limit 1) a查询,ifnull,为空则返回0select ifnull(lag,0) from ke_consumer_bscreen where cluster='cluster1' and tm='20200713' and "group"='consumer' and topic='topic1' order by timespan desc limit 1更新数据 update user_tbl set name = '李四' where name = '张三';删除数据 delete from user_tbl where name = '李四' ;添加表字段 alter table user_tbl add email varchar(40);更新表字段 alter table user_tbl alter column signupdate set not null;重命名表字段 alter table user_tbl rename column signupdate to signup;删除表字段 alter table user_tbl drop column email;重命名表名 alter table user_tbl rename to backup_tbl;删除表名 drop table if exists backup_tbl;清空表数据 truncate table ke_alarm_config;查询postgres当前的连接数select * from pg_stat_activity;postgres的最⼤连接数show max_connections; 注意:mysql的insert into values后⾯的值带有双引号,但postgresql带有的是单引号,如:insert into ke_topic_rank values('test1','test2','test3', 7)5. 备份与还原 这⾥使⽤的是postgresql11。
postgresql的d命令

postgresql的d命令ostgreSQL-psql常⽤命令⽂章索引[隐藏]\d命令1 2 3格式:\d [ pattern ] \d [ pattern ] +该命令将显⽰每个匹配关系(表,视图,索引,序列)的信息,包括对象所有的列,它们的类型,表空间(如果不是默认的)和任何特殊属性(如NOT NULL或默认值等)。
与唯⼀约束相关的索引,规则,约束,触发器也同样会显⽰出来。
如果关系是⼀个视图,还会显⽰视图的定义。
1.如果\d命令什么都不带,将列出当前数据库中的所有表。
1 2 3 4 5 6 7 8 9 10 11 12sample_db=# \dList of relationsSchema | Name | Type | Owner --------+----------------+-------+---------public | account | table | postgre public | book | table | postgre public | customers | table | postgre public | fruits | table | postgre ...public | view_t | view | postgre public | view_t2 | view | postgre (42 rows)2.\d后⾯跟⼀个表名,表⽰显⽰这个表的结构定义。
1 2 3 4 5 6 7 8 9 10 11 12sample_db=# \d tb_dept2Table "public.tb_dept2"Column | Type | Modifiers----------+-----------------------+-----------id | integer | not nullname | character varying(22) |location | character varying(50) |Indexes:"tb_dept2_pkey" PRIMARY KEY, btree (id)"tb_dept2_name_key" UNIQUE CONSTRAINT, btree (name)Referenced by:TABLE "tb_tmp" CONSTRAINT "fk_emp_dept" FOREIGN KEY (deptid) REFERENCES tb_dept2(id)3.\d也可以显⽰索引信息1 2 3 4 5 6sample_db=# \d tb_dept2_pkeyIndex "public.tb_dept2_pkey"Column | Type | Definition--------+---------+------------id | integer | idprimary key, btree, for table "public.tb_dept2"4.\d后⾯可以跟⼀通配符"*"或"?" 1sample_db=# \d boo?1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22sample_db=# \d boo?Table "public.book"Column | Type | Modifiers------------------+------------------------+-----------bookid | integer | not nullbookname | character varying(255) | not nullauthors | character varying(255) | not nullinfo | character varying(255) |comment | character varying(255) |year_publication | date | not nullIndexes:"uniqididx" UNIQUE, btree (bookid)"bkcmtidx" btree (comment)"bknameidx" btree (bookname)sample_db=# \d a*Table "public.account"Column | Type | Modifiers--------+---------------+-----------id | integer |name | character(20) |Triggers:account_stamp BEFORE INSERT ON account FOR EACH ROW EXECUTE PROCEDURE account_stam()5.\d+命令,该命令将显⽰⽐\d命令更详细的信息,除了前⾯介绍的那些,它还会显⽰任何与表列关联的注释,以及表中出现的ODI。
pg中 copy用法(一)

pg中 copy用法(一)PG中COPY用法1. COPY命令的基本概念•COPY命令是PostgreSQL数据库中用于从文件中导入数据到表中的命令。
•COPY命令可以将数据以各种形式(如文本、CSV等)从文件复制到指定的表中。
•在使用COPY命令前,必须先创建好目标表并确保表结构和文件格式相匹配。
2. COPY命令的语法COPY table_name [ ( column_name [, ...] ) ]FROM { 'filename' | PROGRAM 'command' | STDIN }[ [ WITH ] ( option [, ...] ) ]•table_name:目标表的名称。
•column_name:可选参数,指定需要导入的特定列。
•filename:源文件的路径。
•PROGRAM ‘command’:通过执行外部程序的输出作为数据源。
•STDIN:通过标准输入作为数据源。
•option:可选参数,用于指定相关选项。
3. COPY命令的选项•DELIMITER:指定输入文件的字段分隔符。
•NULL:指定输入文件中的空值表示方式。
•HEADER:指示输入文件是否包含列标题。
•FORMAT:指定输入文件的格式类型(如text、csv等)。
•ENCODING:指定输入文件的编码方式。
•QUOTE:指定输入文件中的字段引用符号。
•ESCAPE:指定输入文件中的转义符号。
4. COPY命令的示例用法从文本文件导入数据COPY employees FROM '/path/to/' (FORMAT text, DELIM ITER ',' NULL 'NULL');•以上示例将指定的文本文件以逗号分隔符的格式导入到employees表中。
从CSV文件导入数据COPY products (id, name, price) FROM '/path/to/' (F ORMAT csv, HEADER);•以上示例将指定的CSV文件导入到products表中的id、name和price列。
pgsql的使用方法

pgsql的使用方法PostgreSQL(简称pg)是一种开源的关系型数据库管理系统,广泛用于企业级应用和大规模数据处理。
本文将介绍pgsql的使用方法,包括安装、配置、创建数据库和表、插入和查询数据等方面的内容。
一、安装pgsql1. 下载在官网(省略)下载适合您操作系统的pgsql安装包,选择合适的版本。
2. 安装解压下载的安装包,并按照提示进行安装。
注意,安装时需要选择合适的目录和配置选项。
二、配置pgsql1. 修改配置文件找到pgsql的配置文件(通常位于安装目录下的data文件夹),使用文本编辑器打开。
根据需要,修改以下常用配置项:- listen_addresses:指定pgsql监听的IP地址;- port:指定pgsql监听的端口号;- max_connections:指定最大连接数;- shared_buffers:指定共享缓冲区的大小;- work_mem:指定每个工作进程可用的内存量。
2. 启动pgsql在命令行中输入以下命令启动pgsql服务:```pg_ctl start -D <pgsql安装目录>/data```三、创建数据库和表1. 创建数据库在命令行中输入以下命令创建数据库:```createdb <数据库名>```2. 连接数据库在命令行中输入以下命令连接数据库:```psql -d <数据库名>```3. 创建表在psql命令行中输入以下命令创建表:```CREATE TABLE <表名> (<列名1> <数据类型1>,<列名2> <数据类型2>,...);```四、插入和查询数据1. 插入数据在psql命令行中输入以下命令插入数据:```INSERT INTO <表名> (<列名1>, <列名2>, ...) VALUES (<值1>, <值2>, ...);```2. 查询数据在psql命令行中输入以下命令查询数据:```SELECT <列名1>, <列名2>, ...FROM <表名>WHERE <条件>;```五、其他常用操作1. 更新数据在psql命令行中输入以下命令更新数据:```UPDATE <表名>SET <列名> = <新值>WHERE <条件>;```2. 删除数据在psql命令行中输入以下命令删除数据:```DELETE FROM <表名>WHERE <条件>;```3. 导出数据在命令行中输入以下命令将数据导出到文件中:```COPY <表名> TO '<文件路径>' DELIMITER ',' CSV HEADER; ```4. 导入数据在命令行中输入以下命令将文件中的数据导入到数据库中:```COPY <表名> FROM '<文件路径>' DELIMITER ',' CSV HEADER; ```六、总结本文介绍了pgsql的使用方法,包括安装、配置、创建数据库和表、插入和查询数据等方面的内容。
vacuum full analyze语句
vacuum full analyze语句什么是vacuum full analyze语句?Vacuum full analyze语句是在数据库管理系统(PostgreSQL)中用于执行彻底清理和重新分析数据库的一种命令。
它是对数据库进行优化和性能改进的一种重要方法。
在本文中,我们将逐步回答以下问题:什么是vacuum full analyze语句以及为什么需要执行它?什么是数据库的清理和分析过程?vacuum full analyze语句的执行步骤是什么?以及它如何提高数据库的性能?I. 什么是vacuum full analyze语句以及为什么需要执行它?Vacuum full analyze是一个在PostgreSQL数据库中执行的关键性能和优化命令。
它的主要目的是清理和重新组织数据库中的数据,以提高数据库的性能和响应时间。
Vacuum full analyze包含两个关键操作:vacuum和analyze。
Vacuum 操作用于从磁盘中物理删除已被删除或过期的数据并释放空间。
而analyze操作则是为了生成和更新数据库统计信息,以优化查询计划。
执行vacuum full analyze语句的原因有以下几点:1. 数据库中经常进行增删改的操作会导致数据碎片的产生,占用宝贵的磁盘空间。
执行vacuum操作可以清理这些碎片,释放磁盘空间。
2. 当数据表中的数据发生变化时,数据库的统计信息可能会过时。
这可能导致查询计划的选择不佳,影响查询性能。
通过执行analyze操作可以重新生成和更新这些统计信息。
3. 数据库的性能和响应时间可能会随着时间的推移而下降。
这是因为数据库会产生许多废弃的元组、无效索引等。
执行vacuum full analyze语句可以清理这些无效的数据和索引,提高数据库的性能。
II. 什么是数据库的清理和分析过程?数据库的清理和分析过程是一个包括多个步骤的操作,它用于解决数据库中的碎片和过时统计信息等问题。
postgresql在windows(包括win7)下的安装配置
postgresql在windows(包括win7)下的安装配置首先,以下是常用命令:③initdb 初始化数据库。
④pg_ctl start 启动数据库⑤pg_ctl stop 停止数据库⑥post_svc -install 建立windows nt 服务(需要设置系统环境变量)⑦post_svc -remove 删除windows nt 服务⑧使用"createdb 库名" 新建数据库⑨使用"createuser 用户名"创建数据库帐号⑩使用"psql -h localhost -d 库名- U 用户名"进入数据库接着来讲解:一、下载postgresql for windows/products/pgbindownload.do免安装的,直接解压到硬盘的一个目录下。
笔者在d:\pgsql二、设置环境变量,可以把以下内容写成一个BATset PGHOME=d:\pgsqlset PATH=%PGHOME%\bin;%path%set PGHOST=localhostset PGLIB=%PGHOME%\libset PGDATA=%PGHOME%\data笔者把它们写成了inst.batD:\pgsql>instD:\pgsql>set PGHOME=d:\pgsqlD:\pgsql>setPATH=d:\pgsql\bin;d:\pgsql\bin;d:\pgsql\bin;C:\Windows\system32;C:\ Windows;C:\Windows\System32\Wbem;C:\Windows\System32\WindowsPowerSh ell\v1.0\;C:\Program Files\Common Files\Thunder Network\KanKan\Codecs;C:\Program Files\Microsoft SQL Server\90\Tools\binn\;d:\MATLAB7\bin\win32;D:\pgsql>set PGHOST=localhostD:\pgsql>set PGLIB=d:\pgsql\libD:\pgsql>set PGDATA=d:\pgsql\data三、初始化数据库D:\pgsql>initdb --locale=CThe files belonging to this database system will be owned by user "Administrator ".This user must also own the server process.The database cluster will be initialized with locale C.The default database encoding has accordingly been set to SQL_ASCII.The default text search configuration will be set to "english".fixing permissions on existing directory d:/pgsql/data ... okcreating subdirectories ... okselecting default max_connections (100)selecting default shared_buffers ... 32MBcreating configuration files ... okcreating template1 database in d:/pgsql/data/base/1 ... ok initializing pg_authid ... okinitializing dependencies ... okcreating system views ... okloading system objects' descriptions ... okcreating conversions ... okcreating dictionaries ... oksetting privileges on built-in objects ... okcreating information schema ... okvacuuming database template1 ... okcopying template1 to template0 ... okcopying template1 to postgres ... okWARNING: enabling "trust" authentication for local connectionsYou can change this by editing pg_hba.conf or using the -A option the next time you run initdb.Success. You can now start the database server using:"postgres" -D "d:/pgsql/data"or"pg_ctl" -D "d:/pgsql/data" -l logfile start四、启动D:\pgsql>pg_ctl start五、重新开一个MSDOS窗口创建数据库,以mydb为例D:\pgsql>createdb -h 127.0.0.1 mydb创建用户D:\pgsql>createuser -h 127.0.0.1 deepfuture Shall the new role be a superuser? (y/n) yD:\pgsql>D:\pgsql>六、启动图形界面开始管理启动pgAdmin3.exe程序进行配置(在BIN目录下)。
psqlcopywith参数
psql copy命令及其参数1. 什么是psql copy命令?psql copy命令是PostgreSQL数据库中的一个功能强大的工具,用于将数据从一个源表复制到另一个目标表,或者将数据从文件中导入到数据库表中。
它提供了一个高效且灵活的方法来处理大量数据的导入和导出操作。
2. copy命令的基本语法COPY table_name [ ( column_name [, ...] ) ]FROM { 'filename' | PROGRAM 'command' | STDIN }[ [ WITH ] ( option [, ...] ) ][ WHERE condition ]•table_name:目标表的名称。
•column_name:可选参数,指定要复制的列。
•filename:指定数据文件的路径。
•PROGRAM 'command':指定一个外部命令来生成数据。
•STDIN:从标准输入读取数据。
•option:可选参数,用于指定导入导出的选项。
•condition:可选参数,用于指定要复制的数据的条件。
3. copy命令的常用参数3.1 FORMAT 参数•CSV:指定导入导出的数据格式为CSV(逗号分隔值)。
•TEXT:指定导入导出的数据格式为文本。
•BINARY:指定导入导出的数据格式为二进制。
3.2 DELIMITER 参数•',':指定CSV文件中的列分隔符为逗号。
•'\t':指定CSV文件中的列分隔符为制表符。
3.3 HEADER 参数•true:指定CSV文件中包含表头。
•false:指定CSV文件中不包含表头。
3.4 NULL 参数•'null_string':指定CSV文件中表示NULL值的字符串。
3.5 ENCODING 参数•'encoding_name':指定数据文件的编码格式。
vacuum命令语法
`vacuum`命令是PostgreSQL数据库中用于优化表空间和回收未使用的空间的常用命令。
其基本语法如下:
```sql
VACUUM [ ( option [, ...] ) ] table_name [, ...]
```
其中,`option`表示可选参数,可以指定不同的选项来控制`vacuum`命令的行为。
常用的选项包括:
- `--analyze`:分析表并生成统计信息,以帮助优化查询计划。
- `--all`:对表中的所有数据页进行分析和回收操作。
- `--freeze n`:将表冻结到第n个版本,以便在事务提交后保留已修改的数据行。
- `--full`:执行完全的清理操作,包括删除死元组、合并相邻的空闲空间等。
- `--index-only`:只对索引进行清理操作,而不对实际数据页进行操作。
- `--page-count n`:设置清理操作的目标页面数。
- `--table-size n`:设置表的最大大小(以MB为单位)。
- `--verbose`:显示详细的清理进度信息。
例如,要清理名为`mytable`的表并生成统计信息,可以使用以下命令:
```sql
VACUUM ANALYZE mytable;
```。
PG数据库常用命令
PG数据库常⽤命令查看帮助命令DB=# help --总的帮助DB=# \h --SQL commands级的帮助DB=# \? --psql commands级的帮助按列显⽰,类似MySQL的\GDB=# \xExpanded display is on.查看DB安装⽬录(最好root⽤户执⾏)find / -name initdb查看有多少DB实例在运⾏(最好root⽤户执⾏)find / -name postgresql.conf查看DB版本cat $PGDATA/PG_VERSIONpsql --versionDB=# show server_version;DB=# select version();查看DB实例运⾏状态pg_ctl status查看所有数据库psql –l --查看5432端⼝下⾯有多少个DBpsql –p XX –l --查看XX端⼝下⾯有多少个DBDB=# \lDB=# select * from pg_database;创建数据库createdb database_nameDB=# \h create database --创建数据库的帮助命令DB=# create database database_name进⼊某个数据库psql –d dbnameDB=# \c dbname查看当前数据库DB=# \cDB=# select current_database();查看数据库⽂件⽬录DB=# show data_directory;cat $PGDATA/postgresql.conf |grep data_directorycat /etc/init.d/postgresql|grep PGDATA=lsof |grep 5432得出第⼆列的PID号再ps –ef|grep PID查看表空间select * from pg_tablespace;查看语⾔select * from pg_language;查询所有schema,必须到指定的数据库下执⾏select * from information_schema.schemata;SELECT nspname FROM pg_namespace;\dnS查看表名DB=# \dt --只能查看到当前数据库下public的表名DB=# SELECT tablename FROM pg_tables WHERE tablename NOT LIKE 'pg%' AND tablename NOT LIKE 'sql_%' ORDER BY tablename;DB=# SELECT * FROM information_schema.tables WHERE table_name='ff_v3_ff_basic_af';查看表结构查看表结构DB=# \d tablenameDB=# select * from information_schema.columns where table_schema='public' and table_name='XX';查看索引DB=# \diDB=# select * from pg_index;查看视图DB=# \dvDB=# select * from pg_views where schemaname = 'public';DB=# select * from information_schema.views where table_schema = 'public';查看触发器DB=# select * from information_schema.triggers;查看序列DB=# select * from information_schema.sequences where sequence_schema = 'public';查看约束DB=# select * from pg_constraint where contype = 'p'DB=# select a.relname as table_name,b.conname as constraint_name,b.contype as constraint_type from pg_class a,pg_constraint b where a.oid = b.conrelid and a.relname = 'cc';查看XX数据库的⼤⼩SELECT pg_size_pretty(pg_database_size('XX')) As fulldbsize;查看所有数据库的⼤⼩select pg_database.datname, pg_size_pretty (pg_database_size(pg_database.datname)) AS size from pg_database;查看各数据库数据创建时间:select datname,(pg_stat_file(format('%s/%s/PG_VERSION',case when spcname='pg_default' then 'base' else'pg_tblspc/'||t2.oid||'/PG_11_201804061/' end, t1.oid))).* from pg_database t1,pg_tablespace t2 where t1.dattablespace=t2.oid;按占空间⼤⼩,顺序查看所有表的⼤⼩select relname, pg_size_pretty(pg_relation_size(relid)) from pg_stat_user_tables where schemaname='public' order bypg_relation_size(relid) desc;按占空间⼤⼩,顺序查看索引⼤⼩select indexrelname, pg_size_pretty(pg_relation_size(relid)) from pg_stat_user_indexes where schemaname='public' order bypg_relation_size(relid) desc;查看参数⽂件DB=# show config_file;DB=# show hba_file;DB=# show ident_file;查看当前会话的参数值DB=# show all;查看参数值select * from pg_file_settings查看某个参数值,⽐如参数work_memDB=# show work_mem修改某个参数值,⽐如参数work_memDB=# alter system set work_mem='8MB'--使⽤alter system命令将修改postgresql.auto.conf⽂件,⽽不是postgresql.conf,这样可以很好的保护postgresql.conf⽂件,加⼊你使⽤很多alter system命令后搞的⼀团糟,那么你只需要删除postgresql.auto.conf,再执⾏pg_ctl reload加载postgresql.conf⽂件即可实现参数的重新加载。