
16种常用数据分析方法
一、描述统计
描述性统计是指运用制表和分类,图形以及计筠概括性数据来描述数据的集中趋势、离散趋势、偏度、峰度。
1、缺失值填充:常用方法:剔除法、均值法、最小邻居法、比率回归法、决策树法。
2、正态性检验:很多统计方法都要求数值服从或近似服从正态分布,所以之前需要进行正态性检验。常用方法:非参数检验的K-量检验、P-P图、Q-Q图、W检验、动差法。
二、假设检验
1、参数检验
参数检验是在已知总体分布的条件下(一股要求总体服从正态分布)对一些主要的参数(如均值、百分数、方差、相关系数等)进行的检验 。
1)U验 使用条件:当样本含量n较大时,样本值符合正态分布
2)T检验 使用条件:当样本含量n较小时,样本值符合正态分布
A 单样本t检验:推断该样本来自的总体均数μ与已知的某一总体均数μ0 (常为理论值或标准值)有无差别;
B 配对样本t检验:当总体均数未知时,且两个样本可以配对,同对中的两者在可能会影响处理效果的各种条件方面扱为相似;
C 两独立样本t检验:无法找到在各方面极为相似的两样本作配对比较时使用。
2、非参数检验
非参数检验则不考虑总体分布是否已知,常常也不是针对总体参数,而是针对总体的某些一股性假设(如总体分布的位罝是否相同,总体分布是否正态)进行检验。
适用情况:顺序类型的数据资料,这类数据的分布形态一般是未知的。 A 虽然是连续数据,但总体分布形态未知或者非正态;
B 体分布虽然正态,数据也是连续类型,但样本容量极小,如10以下;
主要方法包括:卡方检验、秩和检验、二项检验、游程检验、K-量检验等。
三、信度分析
检査测量的可信度,例如调查问卷的真实性。
分类:
1、外在信度:不同时间测量时量表的一致性程度,常用方法重测信度
2、内在信度;每个量表是否测量到单一的概念,同时组成两表的内在体项一致性如何,常用方法分半信度。
四、列联表分析
用于分析离散变量或定型变量之间是否存在相关。
对于二维表,可进行卡方检验,对于三维表,可作Mentel-Hanszel分层分析。
列联表分析还包括配对计数资料的卡方检验、行列均为顺序变量的相关检验。
五、相关分析
研究现象之间是否存在某种依存关系,对具体有依存关系的现象探讨相关方向及相关程度。
1、单相关: 两个因素之间的相关关系叫单相关,即研究时只涉及一个自变量和一个因变量;
2、复相关 :三个或三个以上因素的相关关系叫复相关,即研究时涉及两个或两个以上的自变量和因变量相关;
3、偏相关:在某一现象与多种现象相关的场合,当假定其他变量不变时,其中两个变量之间的相关关系称为偏相关。
六、方差分析 使用条件:各样本须是相互独立的随机样本;各样本来自正态分布总体;各总体方差相等。
分类
1、单因素方差分析:一项试验只有一个影响因素,或者存在多个影响因素时,只分析一个因素与响应变量的关系
2、多因素有交互方差分析:一顼实验有多个影响因素,分析多个影响因素与响应变量的关系,同时考虑多个影响因素之间的关系
3、多因素无交互方差分析:分析多个影响因素与响应变量的关系,但是影响因素之间没有影响关系或忽略影响关系
4、协方差分祈:传统的方差分析存在明显的弊端,无法控制分析中存在的某些随机因素,使之影响了分祈结果的准确度。协方差分析主要是在排除了协变量的影响后再对修正后的主效应进行方差分析,是将线性回归与方差分析结合起来的一种分析方法,
七、回归分析
分类:
1、一元线性回归分析:只有一个自变量X与因变量Y有关,X与Y都必须是连续型变量,因变量y或其残差必须服从正态分布。
2、多元线性回归分析
使用条件:分析多个自变量与因变量Y的关系,X与Y都必须是连续型变量,因变量y或其残差必须服从正态分布 。
1)变呈筛选方式:选择最优回归方程的变里筛选法包括全横型法(CP法)、逐步回归法,向前引入法和向后剔除法
2)横型诊断方法: A 残差检验: 观测值与估计值的差值要艰从正态分布
B 强影响点判断:寻找方式一般分为标准误差法、Mahalanobis距离法
C 共线性诊断:
• 诊断方式:容忍度、方差扩大因子法(又称膨胀系数VIF)、特征根判定法、条件指针CI、方差比例
• 处理方法:增加样本容量或选取另外的回归如主成分回归、岭回归等
3、Logistic回归分析
线性回归模型要求因变量是连续的正态分布变里,且自变量和因变量呈线性关系,而Logistic回归模型对因变量的分布没有要求,一般用于因变量是离散时的情况
分类:
Logistic回归模型有条件与非条件之分,条件Logistic回归模型和非条件Logistic回归模型的区别在于参数的估计是否用到了条件概率。
4、其他回归方法 非线性回归、有序回归、Probit回归、加权回归等
八、聚类分析
样本个体或指标变量按其具有的特性进行分类,寻找合理的度量事物相似性的统计量。
1、性质分类:
Q型聚类分析:对样本进行分类处理,又称样本聚类分祈 使用距离系数作为统计量衡量相似度,如欧式距离、极端距离、绝对距离等
R型聚类分析:对指标进行分类处理,又称指标聚类分析 使用相似系数作为统计量衡量相似度,相关系数、列联系数等 2、方法分类:
1)系统聚类法: 适用于小样本的样本聚类或指标聚类,一般用系统聚类法来聚类指标,又称分层聚类
2)逐步聚类法 :适用于大样本的样本聚类
3)其他聚类法 :两步聚类、K均值聚类等
九、判别分析
1、判别分析:根据已掌握的一批分类明确的样品建立判别函数,使产生错判的事例最少,进而对给定的一个新样品,判断它来自哪个总体
2、与聚类分析区别
1)聚类分析可以对样本逬行分类,也可以对指标进行分类;而判别分析只能对样本
2)聚类分析事先不知道事物的类别,也不知道分几类;而判别分析必须事先知道事物的类别,也知道分几类
3)聚类分析不需要分类的历史资料,而直接对样本进行分类;而判别分析需要分类历史资料去建立判别函数,然后才能对样本进行分类
3、进行分类 :
1)Fisher判别分析法 :
以距离为判别准则来分类,即样本与哪个类的距离最短就分到哪一类, 适用于两类判别;
以概率为判别准则来分类,即样本属于哪一类的概率最大就分到哪一类,适用于
适用于多类判别。 2)BAYES判别分析法 :
BAYES判别分析法比FISHER判别分析法更加完善和先进,它不仅能解决多类判别分析,而且分析时考虑了数据的分布状态,所以一般较多使用;
十、主成分分析
将彼此梠关的一组指标变适转化为彼此独立的一组新的指标变量,并用其中较少的几个新指标变量就能综合反应原多个指标变量中所包含的主要信息 。
十一、因子分析
一种旨在寻找隐藏在多变量数据中、无法直接观察到却影响或支配可测变量的潜在因子、并估计潜在因子对可测变量的影响程度以及潜在因子之间的相关性的一种多元统计分析方法
与主成分分析比较:
相同:都能够起到済理多个原始变量内在结构关系的作用
不同:主成分分析重在综合原始变适的信息.而因子分析重在解释原始变量间的关系,是比主成分分析更深入的一种多元统计方法
用途:
1)减少分析变量个数
2)通过对变量间相关关系探测,将原始变量进行分类
十二、时间序列分析
动态数据处理的统计方法,研究随机数据序列所遵从的统计规律,以用于解决实际问题;时间序列通常由4种要素组成:趋势、季节变动、循环波动和不规则波动。
主要方法:移动平均滤波与指数平滑法、ARIMA横型、量ARIMA横型、ARIMAX模型、向呈自回归横型、ARCH族模型
十三、生存分析
用来研究生存时间的分布规律以及生存时间和相关因索之间关系的一种统计分析方法 1、包含内容:
1)描述生存过程,即研究生存时间的分布规律
2)比较生存过程,即研究两组或多组生存时间的分布规律,并进行比较
3)分析危险因素,即研究危险因素对生存过程的影响
4)建立数学模型,即将生存时间与相关危险因素的依存关系用一个数学式子表示出来。
2、方法:
1)统计描述:包括求生存时间的分位数、中数生存期、平均数、生存函数的估计、判断生存时间的图示法,不对所分析的数据作出任何统计推断结论
2)非参数检验:检验分组变量各水平所对应的生存曲线是否一致,对生存时间的分布没有要求,并且检验危险因素对生存时间的影响。
A 乘积极限法(PL法)
B 寿命表法(LT法)
3)半参数横型回归分析:在特定的假设之下,建立生存时间随多个危险因素变化的回归方程,这种方法的代表是Cox比例风险回归分析法
4)参数模型回归分析:已知生存时间服从特定的参数横型时,拟合相应的参数模型,更准确地分析确定变量之间的变化规律
十四、典型相关分析 相关分析一般分析两个变里之间的关系,而典型相关分析是分析两组变里(如3个学术能力指标与5个在校成绩表现指标)之间相关性的一种统计分析方法。
典型相关分析的基本思想和主成分分析的基本思想相似,它将一组变量与另一组变量之间单变量的多重线性相关性研究转化为对少数几对综合变量之间的简单线性相关性的研究,并且这少数几对变量所包含的线性相关性的信息几乎覆盖了原变量组所包含的全部相应信息。
十五、R0C分析
R0C曲线是根据一系列不同的二分类方式(分界值或决定阈).以真阳性率(灵敏度)为纵坐标,假阳性率(1-特异度)为横坐标绘制的曲线
用途:
1、R0C曲线能很容易地査出任意界限值时的对疾病的识别能力
用途 ;
2、选择最佳的诊断界限值。R0C曲线越靠近左上角,试验的准确性就越高;
3、两种或两种以上不同诊断试验对疾病识别能力的比较,一股用R0C曲线下面积反映诊断系统的准确性。
十六、其他分析方法
多重响应分析、距离分祈、项目分祈、对应分祈、决策树分析、神经网络、系统方程、蒙特卡洛模拟等。
讲解Excel的16种图表类型的“含义”,知道该怎么画图了!
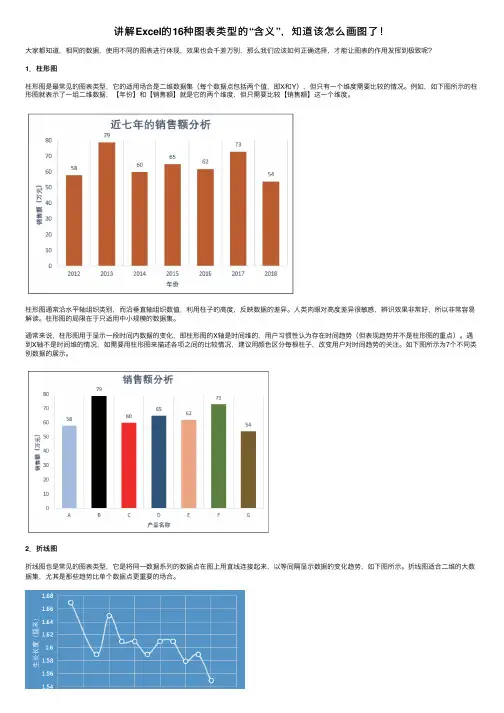
讲解Excel的16种图表类型的“含义”,知道该怎么画图了!
⼤家都知道,相同的数据,使⽤不同的图表进⾏体现,效果也会千差万别,那么我们应该如何正确选择,才能让图表的作⽤发挥到极致呢?
1.柱形图
柱形图是最常见的图表类型,它的适⽤场合是⼆维数据集(每个数据点包括两个值,即X和Y),但只有⼀个维度需要⽐较的情况。例如,如下图所⽰的柱形图就表⽰了⼀组⼆维数据,【年份】和【销售额】就是它的两个维度,但只需要⽐较【销售额】这⼀个维度。
柱形图通常沿⽔平轴组织类别,⽽沿垂直轴组织数值,利⽤柱⼦的⾼度,反映数据的差异。⼈类⾁眼对⾼度差异很敏感,辨识效果⾮常好,所以⾮常容易
解读。柱形图的局限在于只适⽤中⼩规模的数据集。
通常来说,柱形图⽤于显⽰⼀段时间内数据的变化,即柱形图的X轴是时间维的,⽤户习惯性认为存在时间趋势(但表现趋势并不是柱形图的重点)。遇
到X轴不是时间维的情况,如需要⽤柱形图来描述各项之间的⽐较情况,建议⽤颜⾊区分每根柱⼦,改变⽤户对时间趋势的关注。如下图所⽰为7个不同类别数据的展⽰。
2.折线图
折线图也是常见的图表类型,它是将同⼀数据系列的数据点在图上⽤直线连接起来,以等间隔显⽰数据的变化趋势,如下图所⽰。折线图适合⼆维的⼤数据集,尤其是那些趋势⽐单个数据点更重要的场合。
折线图可以显⽰随时间⽽变化的连续数据(根据常⽤⽐例设置),它强调的是数据的时间性和变动率,因此⾮常适⽤于显⽰在相等时间间隔下数据的变化
趋势。在折线图中,类别数据沿⽔平轴均匀分布,所有的值数据沿垂直轴均匀分布。折线图也适合多个⼆维数据集的⽐较,如下图所⽰为两个产品在同⼀时间内的销售情况⽐较。
不管是⽤于表现⼀组或多组数据的⼤⼩变化趋势,在折线图中数据的顺序都⾮常重要,通常数据之间有时间变化关系才会使⽤折线图。
3.饼图
饼图虽然也是常⽤的图表类型,但在实际应⽤中应尽量避免使⽤饼图,因为⾁眼对⾯积的⼤⼩不敏感。例如,对同⼀组数据使⽤饼图和柱形图来显⽰,效果如下图所⽰。
十六种常用技术指标

十六种常用技术指标
技术指标是投资者和交易者常用的工具,用于分析市场的趋势、波动和价值。技术指标基于历史价格和成交量数据,对未来的市场走势进行预测。下面是十六种常用的技术指标。
1.移动平均线(MA):移动平均线是基于一段时间内的平均价格计算得出的线条。它可以帮助投资者判断趋势的方向和强度。
2.指数移动平均线(EMA):指数移动平均线是加权移动平均线的一种形式,它更加重视最近的价格数据,对市场的反应更为敏感。
3.相对强弱指标(RSI):RSI是通过计算一定时间内的价格变化来评估市场超买和超卖程度的指标。它的取值范围是0~100,通常超过70被视为超买,低于30被视为超卖。
4.随机指标(KDJ):KDJ指标通过比较一定时间内的最高价、最低价和收盘价,来判断市场的超买和超卖程度。
5. 布林带(Bollinger Bands):布林带通过计算价格的标准差来绘制上下两条线,可以帮助投资者判断价格的高低点和波动范围。
6.平均真实范围(ATR):ATR衡量市场价格的波动性,可以帮助投资者确定止损和止盈的位置。
7.相对强弱指数(ROC):ROC通过计算价格相对于一定时间内的前期价格的变化百分比来判断市场趋势的强度。
8.平均趋向指标(ADX):ADX指标用来衡量趋势的强度和方向。当ADX值高于25时,表示市场处于强势趋势阶段。 9. 随机相对强弱指标(StochRSI):StochRSI是RSI指标和随机指标的结合,用来判断市场超买和超卖程度的更准确指标。
10. 动量指标(Momentum):动量指标衡量价格变动的速度和幅度,可以帮助投资者确认趋势的延续或转折。
11.田字格(K线图):K线图通过绘制开盘价、最高价、最低价和收盘价来反映市场的价格波动情况。
12.MACD指标:MACD指标通过计算价格的长期移动平均线和短期移动平均线的差值,来判断市场的趋势和买卖信号。
13. 成交量指标(Volume):成交量指标用于衡量交易市场的活跃程度,可以帮助投资者确认市场趋势的可靠性。
数据分析那些事(菜鸟入门必看)
想拿高薪,选对行业很重要!学大数据,工资高,前景好! 16年老品牌,上市IT培训机构 学大数据,就选光环大数据 官方网站 数据分析新手入门常见问题 经常有网友会对数据分析方面有一些困惑,并且咨询我该怎么办?并且经常是同样的问题,所以觉得有必要对一些经典共性的问题进行整理,与大家分享,这里并非标准答案,仅作参考! 欢迎提出自己对数据方面的疑问,将在此篇将持续更新,敬请关注。 ----------------------------------------我不是完美的分割线--------------------------------------- Q1:我现在的工作有一点数据分析的模块,自从上微薄后了解到还有专门从事数据分析工作,我现在想做这一行,但是经验、能力都还是菜鸟中的菜鸟,请问成为一名数据分析师还有需要哪些准备? A:很简单,我们可以看一下国内知名互联网数据分析师的招聘要求,进行自我对照,即可知道需要做哪些准备。 数据分析师职位要求 : 1、计算机、统计学、数学等相关专业本科及以上学历; 2、具有深厚的统计学、数据挖掘知识,熟悉数据仓库和数据挖掘的相关技术,能够熟练地使用SQL; 3、三年以上具有海量数据挖掘、分析相关项目实施的工作经验,参与过较完整的数据采集、整理、分析和建模工作; 4、对商业和业务逻辑敏感,熟悉传统行业数据挖掘背景、了解市场特点及用户需求,有互联网相关行业背景,有网站用户行为研究和文本挖掘经验尤佳; 5、具备良好的逻辑分析能力、组织沟通能力和团队精神; 6、富有创新精神,充满激情,乐于接受挑战。 Q2:对数据分析有浓厚兴趣,希望从事数据分析、市场研究相关工作,但听说对学历要求较高,请问我是否要读研,读研的话应该读哪个方向? A:读研要看自身情况,但可明确:专业不是问题,本科学历就够。关键是兴趣与能力,以及自身的努力,兴趣是学习成长最好的老师! 当然如果是在校生考上研究生的话那是最好,如果考不上可以先工作,等你工作有经验了,你就知道哪方面的知识是自己需要,要考哪方面的研究生,也就更有方向性。 Q3:那么如何培养对数据分析的兴趣呢? A:建议如下: 1、先了解数据分析是神马? 2、了解数据分析有何用?可解决什么问题? 3、可以看看啤酒与尿布等成功数据分析案例;
效率评估方法和效率评估系统
效率评估方法和效率评估系统
一、引言
在现代社会中,效率评估是衡量一个系统、流程或组织运行效率的重要指标。通过评估效率,可以发现问题、优化流程、提高生产力和资源利用率。本文将介绍效率评估的方法和效率评估系统的标准格式。
二、效率评估方法
1. 数据收集
效率评估的第一步是收集相关数据。可以通过以下方式进行数据收集:
- 直接观察:观察系统或流程的运行情况,记录关键指标。
- 问卷调查:向相关人员发送问卷,收集他们对系统或流程的评价和建议。
- 数据记录:收集系统或流程产生的数据,如生产数量、时间消耗等。
2. 数据分析
收集到数据后,需要进行数据分析以评估效率。常用的数据分析方法包括:
- 统计分析:对收集到的数据进行统计,计算平均值、标准差等指标,以了解系统或流程的整体表现。
- 流程分析:通过绘制流程图、时间线等方式,分析系统或流程中的瓶颈和优化点。
- 比较分析:将不同系统或流程的数据进行比较,找出效率差异,并分析差异的原因。
3. 效率评估指标 在评估效率时,需要选择适当的评估指标。常用的效率评估指标包括:
- 生产效率:衡量生产系统或流程的产出与投入的比例。
- 时间效率:衡量完成一个任务所需的时间。
- 资源利用效率:衡量资源的利用情况,如人力、物料等。
- 成本效率:衡量完成任务所需的成本。
4. 结果报告
根据数据分析和评估指标的结果,编写效率评估报告。报告应包括以下内容:
- 数据分析结果:对数据进行分析和解释,包括统计指标、流程图等。
- 效率评估指标分析:对评估指标进行分析,找出问题和改进方向。
- 建议和推荐:根据评估结果,提出改进措施和建议。
三、效率评估系统
1. 系统概述
效率评估系统是一个用于评估系统、流程或组织效率的软件系统。它可以自动化数据收集、数据分析和结果报告的过程,提高评估效率和准确性。
2. 功能特点
效率评估系统的功能特点包括:
- 数据收集:系统可以自动收集相关数据,包括系统产生的数据和用户反馈的数据。
16用巴雷特图分析方法、柱状图法...
I 实施六西格玛解决呆滞库存问题 摘 要 库存管理作为供应链管理体系的核心,正越来越受到经营者的关注。合理的库存水平的设置显得尤为关键,过多的库存会大量占用企业的资金,阻碍现金流的循环和周转,库存积压还可能造成产品销毁,使运行成本增加,影响企业的盈利能力。反之,在缺货的情况下,不但可能丢失订单并且给竞争对手有机可乘,从而丢失市场份额。 论文首先阐述了六西格玛的基本思想、基础理论、工具与方法,以及实施六西格玛改进法的DMAIC方法体系。针对陶氏化学有限公司库存体系中有关绩效指标-呆滞库存,运用六西格玛DMAIC实施改进以降低库存呆滞库存率。论文分析了陶氏化学有限公司供应链流程中的各个环节库存问题,确定项目研究的范围,定义了缺陷和判断基准。二是组织收集数据,通过量化的数据分析图来反映界定存在问题的流程范围,采用因果图等工具分析找出关键因素X。项目小组采用头脑风暴法和价值流图等工具方法确定改进措施。通过项目的实施,根本上改进了导致呆滞库存率居高不下的因素 - 安全库存的设置。项目实施后9个月运行结果表明,绩效显著提高。 项目的成功实施不仅节约了数目可观的年供应链服务成本,而且优化了企业内部各供应链部门的流程配合,并进一步推广了六西格玛的管理模式,使得其更深入人心,成为解决问题的首选方式。实践表明,对于供应链库存管理,六西格玛方法是解决问题的最佳实践。 关键词:呆滞库存,六西格玛,DMAIC法,供应链,质量改进
II Abstract As the primary key in the whole Supply Chain system, the inventory management is drawing more and more attention from the enterprisers. The right level of inventory is very crucial, excessive inventory occupies big amount of operating capital, which prevents the healthy circulation of the cash flow. Overstocking sometimes leads to product write off in worse case, causing an increase in operating cost. Both impact the profitability of the company. This thesis starts with an introduction of Six Sigma basic concept & theory, the tools and methodology, as well as the DMAIC system of Six Sigma implementation. This thesis is aimed to reduce the Slow Moving Inventory (SMI) rate, which is a key performance index in the inventory management of The Dow Chemical Company, and focuses on how the Six Sigma MAIC methodology is fully applied. First of all, identify what is the project scope, the defect and the baseline performance by reviewing the inventory in whole supply chain. Secondly, Data collection and mining. Taking advantage of some quantified analysis charts e.g. Cause & Effective Chart etc., the key factor or root cause X is found out. After that, the brain-storming sessions and value chain mappings are utilized to find out the solution. Consequently, the implementation of the project improves the setting of safety stock, which is proved to be the root cause of the constant high level of SMI rate. After 9 month of implementation, the SMI performance is dramatically improved. The successful roll out of the project not only result in a remarkable annual saving in supply chain cost to serve, but also optimize the work process among different supply chain functions within the company, and further promote the six sigma methodology into people’s heart and mind, making it become the preferred way of working. This project success, which is an example of practice, demonstrates that Six Sigma is a best practice for problem solving in Supply Chain inventory management. Six Sigma in Controlling Slow Moving Inventory
50张经典的数据分析图表

50张经典的数据分析图表
1. 散点图(Scatter plot)
散点图是用于研究两个变量之间关系的经典的和基本的图表。 如果数据中有多个组,则可能需要
以不同颜色可视化每个组。
2. 带边界的气泡图(Bubble plot with Encircling)
有时,您希望在边界内显示一组点以强调其重要性。
3. 带线性回归最佳拟合线的散点图 (Scatter plot with linear regression line of best fit)
如果你想了解两个变量如何相互改变,那么最佳拟合线就是常用的方法。 下图显示了数据中各组
之间最佳拟合线的差异。
针对每列绘制线性回归线:
4. 抖动图 (Jittering with stripplot)
通常,多个数据点具有完全相同的 X 和 Y 值。 结果,多个点绘制会重叠并隐藏。 为避免这种
情况,请将数据点稍微抖动,以便您可以直观地看到它们。
5. 计数图 (Counts Plot)
避免点重叠问题的另一个选择是增加点的大小,这取决于该点中有多少点。 因此,点的大小越大,
其周围的点的集中度越高。
6. 边缘直方图 (Marginal Histogram)
边缘直方图具有沿 X 和 Y 轴变量的直方图。 这用于可视化 X 和 Y 之间的关系以及单独的 X
和 Y 的单变量分布。 这种图经常用于探索性数据分析(EDA)。
7. 边缘箱形图 (Marginal Boxplot)
边缘箱图与边缘直方图具有相似的用途。 然而,箱线图有助于精确定位 X 和 Y 的中位数、第25
和第75百分位数。
8. 相关图 (Correllogram)
相关图用于直观地查看给定数据框(或二维数组)中所有可能的数值变量对之间的相关度量。
9. 矩阵图 (Pairwise Plot)
矩阵图是探索性分析中的最爱,用于理解所有可能的数值变量对之间的关系。 它是双变量分析的
必备工具。
16种常用的数据分析方法-相关分析
16种常⽤的数据分析⽅法-相关分析
相关性分析研究现象之间是否存在某种依存关系,对具体有依存关系的现象探讨相关⽅向及相关程度。
相关分析是⼀种简单易⾏的测量定量数据之间的关系情况的分析⽅法。可以分析包括变量间的关系情况以及关系强弱程度等。
如:⾝⾼和体重的相关性;降⽔量与河流⽔位的相关性;⼯作压⼒与⼼理健康的相关性等。
相关性种类
客观事物之间的相关性,⼤致可归纳为两⼤类:
⼀、函数关系
函数关系是两个变量的取值存在⼀个函数来唯⼀描述。
⽐如销售额与销售量之间的关系,可⽤函数y=px(y表⽰销售额,p表⽰单价,x表⽰销售量)来表⽰。所以,销售量和销售额存在函数关系。
这⼀类关系,不是我们关注的重点。
⼆、统计关系
统计关系,指两事物之间的⾮⼀⼀对应关系,即当变量x取⼀定值时,另⼀个变量y虽然不唯⼀确定,但按某种规律在⼀定的范围内发⽣变化。
⽐如:⼦⼥⾝⾼与⽗母⾝⾼、⼴告费⽤与销售额的关系,是⽆法⽤⼀个函数关系唯⼀确定其取值的,但这些变量之间确实存在⼀定的关系。⼤多数情况下,⽗母⾝⾼越⾼,⼦⼥的⾝⾼也就越⾼;⼴告费⽤花得越多,其销售额也相对越多。
这种关系,就叫做统计关系。
按照相关表现形式,⼜可分为不同的相关类型,详见下图:
相关性描述⽅式
描述两个变量是否有相关性,常见的⽅式有3种:1.相关图(典型的如散点图和列联表等等)
2.相关系数
3.统计显著性
⽤可视化的⽅式来呈现各种相关性,常⽤散点图,如下图:
相关性分析步骤
Step1:相关分析前,⾸先通过散点图了解变量间⼤致的关系情况。
如果变量之间不存在相互关系,那么在散点图上就会表现为随机分布的离散的点,如果存在某种相关性,那么⼤部分的数据点就会相对密集并以某种趋势呈现。
如上图,展现了平时成绩与能⼒评分之间的关系情况:X增⼤时,Y会明显的增⼤,说明X和Y之间有着正向相关关系。Step2:计算相关系数
散点图能够展现变量之间的关系情况,但不精确。还需要通过相关分析得到相关系数,以数值的⽅式精准反映相关程度。
16种统计分析方法
.
1 / 8 16种常用的数据分析方法汇总2015-11-10 分类:数据分析评论(0) 经常会有朋友问到一个朋友,数据分析常用的分析方法有哪些,我需要学习哪个等等之类的问题,今天数据分析精选给大家整理了十六种常用的数据分析方法,供大家参考学习。一、描述统计描述性统计是指运用制表和分类,图形以及计筠概括性数据来描述数据的集中趋势、离散趋势、偏度、峰度。1、缺失值填充:常用方法:剔除法、均值法、最小邻居法、比率回归法、决策树法。2、正态性检验:很多统计方法都要求数值服从或近似服从正态分布,所以之前需要进行正态性检验。常用方法:非参数检验的K-量检验、P-P图、Q-Q图、W检验、动差法。二、假设检验1、参数检验参数检验是在已知总体分布的条件下(一股要求总体服从正态分布)对一些主要的参数(如均值、百分数、方差、相关系数等)进行的检验。1)U验使用条件:当样本含量n较大时,样本值符合正态分布2)T检验使用条件:当样本含量n较小时,样本值符合正态分布A 单样本t检验:推断该样本来自的总体均数μ与已知的某一总体均数μ0 (常为理论值或标准值)有无差别;B 配对样本t检验:当总体均数未知时,且两个样本可以配对,同对中的两者在可能会影响处理效果的各种条件方面扱为相似;C 两独立样本t检验:无法找到在各方面极为相似的两样本作配对比较时使用。2、非参数检验 .
2 / 8 非参数检验则不考虑总体分布是否已知,常常也不是针对总体参数,而是针对总体的某些一股性假设(如总体分布的位罝是否相同,总体分布是否正态)进行检验。适用情况:顺序类型的数据资料,这类数据的分布形态一般是未知的。A 虽然是连续数据,但总体分布形态未知或者非正态;B 体分布虽然正态,数据也是连续类型,但样本容量极小,如10以下;主要方法包括:卡方检验、秩和检验、二项检验、游程检验、K-量检验等。三、信度分析检査测量的可信度,例如调查问卷的真实性。分类:1、外在信度:不同时间测量时量表的一致性程度,常用方法重测信度2、内在信度;每个量表是否测量到单一的概念,同时组成两表的内在体项一致性如何,常用方法分半信度。四、列联表分析用于分析离散变量或定型变量之间是否存在相关。对于二维表,可进行卡方检验,对于三维表,可作Mentel-Hanszel分层分析。列联表分析还包括配对计数资料的卡方检验、行列均为顺序变量的相关检验。五、相关分析研究现象之间是否存在某种依存关系,对具体有依存关系的现象探讨相关方向及相关程度。1、单相关:两个因素之间的相关关系叫单相关,即研究时只涉及一个自变量和一个因变量;2、复相关:三个或三个以上因素的相关关系叫复相关,即研究时涉及两个或两个以上的自变量和因变量相关; .
16种常用数据分析方法
一、描述统计
描述性统计是指运用制表和分类,图形以及计筠概括性数据来描述数据的集中趋势、离散趋势、偏度、峰度。
1、缺失值填充:常用方法:剔除法、均值法、最小邻居法、比率\回归法、决策树法。
2、正态性检验:很多统计方法都要求数值服从或近似服从正态分布,所以之前需要进行正态性检验。常用方法:非参数检验的K-量检验、P-P图、Q—Q图、W检验、动差法。
二、假设检验
1、参数检验
参数检验是在已知总体分布的条件下(一股要求总体服从正态分布)对一些主要的参数(如均值、百分数、方差、相关系数等)进行的检验 。
1)U验 使用条件:当样本含量n较大时,样本值符合正态分布
2)T检验 使用条件:当样本含量n较小时,样本值符合正态分布
A 单样本t检验:推断该样本来自的总体均数μ与已知的某一总体均数μ0
(常为理论值或标准值)有无差别;
B 配对样本t检验:当总体均数未知时,且两个样本可以配对,同对中的两者在可能会影响处理效果的各种条件方面扱为相似;
C 两独立样本t检验:无法找到在各方面极为相似的两样本作配对比较时使用.
2、非参数检验
非参数检验则不考虑总体分布是否已知,常常也不是针对总体参数,而是针对总体的某些一股性假设(如总体分布的位罝是否相同,总体分布是否正态)进行检验.
适用情况:顺序类型的数据资料,这类数据的分布形态一般是未知的。
A 虽然是连续数据,但总体分布形态未知或者非正态;
B 体分布虽然正态,数据也是连续类型,但样本容量极小,如10以下;
主要方法包括:卡方检验、秩和检验、二项检验、游程检验、K-量检验等。
三、信度分析
检査测量的可信度,例如调查问卷的真实性。
分类:
1、外在信度:不同时间测量时量表的一致性程度,常用方法重测信度
2、内在信度;每个量表是否测量到单一的概念,同时组成两表的内在体项一致性如何,常用方法分半信度。
四、列联表分析
16种统计分析方法-统计分析方法有多少种
16种常用的数据分析方法汇总
2015-11-10分类:数据分析 评论(0)
经常会有朋友问到一个朋友,数据分析常用的分析方法有哪些,我需要学习哪个 等等之类的问题,今天 数据分析精选给大家整理了十六种常用的 数据分析方法, 供大家参考学习。
一、 描述统计
描述性统计是指运用制表和分类,图形以及计筠概括性数据来描述数据的集中趋 势、离散趋势、偏度、峰度。
1、 缺失值填充:常用方法:易9除法、均值法、最小邻居法、比率回归法、决策 树法。
2、 正态性检验:很多统计方法都要求数值服从或近似服从正态分布,所以之前
需要进行正态性检验。常用方法:非参数检验的 K-量检验、P-P图、Q-Q图、W
检验、动差法。
二、 假设检验
1、 参数检验
参数检验是在已知总体分布的条件下(一股要求总体服从正态分布)对一些主要 的参数(如均值、百分数、方差、相关系数等)进行的检验 。
1) U验 使用条件:当样本含量n较大时,样本值符合正态分布
2) T检验 使用条件:当样本含量n较小时,样本值符合正态分布
A单样本t检验:推断该样本来自的总体均数 卩与已知的某一总体均数 卩0常为 理论值或标准值)有无差别;
B配对样本t检验:当总体均数未知时,且两个样本可以配对,同对中的两者在 可能会影响处理效果的各种条件方面扱为相似;
C两独立样本t检验:无法找到在各方面极为相似的两样本作配对比较时使用。
2、 非参数检验
非参数检验则不考虑总体分布是否已知, 常常也不是针对总体参数,而是针对总 体的某些一股性假设(如总体分布的位罝是否相同,总体分布是否正态)进行检 验。 适用情况:顺序类型的数据资料,这类数据的分布形态一般是未知的
A 虽然是连续数据,但总体分布形态未知或者非正态;
B 体分布虽然正态,数据也是连续类型,但样本容量极小,如 10 以下;
主要方法包括:卡方检验、秩和检验、二项检验、游程检验、 K-量检验等。