
数据编码方式介绍
1.Base64
这里讨论的编码主要的目的是将不可显示的二进制数组转变为可显示的字符串,包括其逆运算。
通过特定的协议传输数据,或者加密解密的时候都会用到类似的方法。
在这类运算中用的比较多的是Base64,比如MIME中,DotNET中更是直接提供了Base64 Encode和Decode的方法,相当方便。
但是Base64通常由“a-z”、“A-Z”、0-9以及“+”和“=”这些符号组成,当中包含了很多混淆的字符,例如“1”、“I”和“l”,“0”和“O”或者“2”和“Z”,看起来总是不爽。
特别是当作为序列号编码时,是不应该包含容易混淆的字母,所以有另一种编码形式叫做Base24,用过MS产品的兄弟们一定非常熟悉。
但是Base24在实现上还要多绕一个弯,先放一放,我们在下面说Base32,能够基本满足要求的,又非常直观的编码方式。
Base32的原理和Base64一模一样,所以先看一下Base64编码是怎么一回事。
Base64顾名思义就是用64个可显示字符表示所有的ASC字符,64也就是6Bits,而ASC字符一共有256个,也就是8Bits,很简单了,取一下最小公约数,24位,言下之意就是用4个Base64的字符来表示3个ASC字符。
即在编码时,3个一组ASC字符,产生4个Base64字符,解码时4个一组,还原3个ASC字符。
根据这个原理Base64编码之后的字符串应该比原先增加1/3的长度。
这里所谓的编码就是一次取6Bits,换算出来的值作为索引号,利用这个索引数,到预先定义的长度为64的字符数组中取相应的字符替换即可;解码就是逆运算,根据字符取在预定义数组中的索引值,然后按8Bits一组还原ASC字符。
Base32和Base64相比只有一个区别就是,用32个字符表示256个ASC字符,也就是说5个ASC字符一组可以生成8个Base32字符,反之亦然。
2.Base32
2.1.Base32数据编码简介
Base32数据编码机制,主要用来把二进制数据编码成可见的字符串,其编码规则是:任意给定一个二进制数据,以5个位(bit)为一组进行切分(base64以6个位(bit)为一组),对切分而成的每个组进行编码得到1个可见字符。
Base32编码表字符集中的字符总数为25=32个,这也是Base32名字的由来。
以下是我在网上找的一个标准的Base32编码表,如表1所示。
表1 标准Base编码表
2.2.编码演示
下面对“bhst”字符串进行编码,说明Base32的编码过程。
步骤如下:
(1)字符“bhst”取ASCII码之后,对其转换成二进制,得到共以下的四个字节是,“1100010,1101000,1110011,1110100,”,28个bit的二进制串。
因为base32是属于传输8bit 字节代码的编码方式,所以这里要对“bhst”字符串对应的二进制最高位加0变成每组8个bit。
组成32个bit的二进制串.
(2)以5个bit为一组对“bhst”字符串对应的二进制串进行切分。
得到“01100,01001,10100,00111,00110,11101,00000”7个字节的“bhst”二进制串。
其中,每组的二进制串不足5个用0补充。
(3)计算每组二进制串所对应的十进制,然后参考标准Base32编码表,找出所对应的编码字符,组合成密文。
注:最后一个分组位数不足4个的时候,则用字符“=”编码。
如表2所示:
表2 以5个bit为一组切分得到7个字节的目标二进制串及对应的标准Base32编字符
2.3.实例解码
以密文“I4AG6AA=”为例。
步骤如下:
(1)对密文中的编码字符(对照标准Base32编码表)找出所对应的十进制编码值。
分别为:8 28 0 6 30 0 0。
(2)把十进制的编码值转换成二进制,不足5个bit用0补充。
得到:01000,11100,00000,00110,11110,00000,00000
(3)组合每组的二进制串,并以8个bit为一组进行切分。
得到:01000111,00000000,01101111,00000000,00000000
(4)还原每组二进制串得到明文的ASCII码71 0 111 0 0,还原成字符为Go。
如表3所示:
表3。
计算机数据编码方法

计算机数据编码方法
计算机数据编码方法是将数据转换为计算机可以理解和处理的二进制形式的过程。
以下是几种常见的数据编码方法:
1. ASCII编码:ASCII(American Standard Code for Information Interchange)是一种使用7位或8位二进制来表示字符的编码方式。
它包括了常见的字母、数字、标点符号以及一些控制字符。
2. Unicode编码:Unicode是一种国际字符集,它为世界上几乎所有的字符都分配了唯一的编码值。
Unicode编码可以使用不同的编码方案实现,如UTF-8、UTF-16等。
3. UTF-8编码:UTF-8是一种变长编码方式,它能表示Unicode字符集中的所有字符。
UTF-8编码使用1至4个字节来表示不同的字符,其中英文字母和常见符号使用1个字节表示,而一些特殊字符和汉字则使用2至4个字节表示。
4. UTF-16编码:UTF-16也是一种变长编码方式,它使用2或4个字节来表示字符。
UTF-16编码主要用于表示较少使用的字符,对于常见的英文字母和数字,UTF-16编码与ASCII编码相同,使用2个字节表示。
5. Base64编码:Base64编码是一种将二进制数据转换为可打印字符的编码方式。
它将每3个字节的二进制数据转换为4个字符,常用于在文本传输中编码二进制数据。
这些编码方法具有不同的特点和应用场景,选择合适的编码方法取决于所需编码的数据类型和使用环境。
常用编码方式

常用编码方式常用编码方式编码是人类通讯的一种基本方式,对于计算机而言,为了能够处理和保存各种类型的数据,也需要有一种统一的编码方式。
以下是常用的几种编码方式:一、ASCII编码ASCII编码是美国信息交换标准代码的缩写,是一种基于拉丁字母的编码方式。
它定义了128个字符,包括数字、字母、标点符号和一些控制字符。
由于只有128个字符,存储效率和传输效率比较高,但是只能表示英文字符,不能表示汉字等其他语言的字符。
二、Unicode编码Unicode编码是国际组织制定的一种万国码,目的就是解决计算机处理多语言的问题。
Unicode编码采用32位编码方式,可以表示2^32个字符,不仅包括了世界上所有的语言文字,还包括了一些图形符号、表情符号等特殊符号。
三、UTF-8编码UTF-8编码是一种对Unicode编码进行转换的编码方式。
UTF-8编码采用变长编码方式,能够同样表示所有Unicode字符,但是在表示英文字符时只需要一个字节,而对于中文等其他常用字符采用3个字节表示,使得存储效率和传输效率都得到了优化。
四、GB2312编码GB2312编码是中国制定的中文编码方式,采用双字节编码,共收录了6763个汉字和682个非汉字字符。
GB2312编码虽然不能够表示所有的中文字符,但是对于一般的中文书写和交流已经够用。
在此基础之上,GB18030编码进行了扩充,可以表示Unicode完整字符集,包括了中文和其他字符。
五、Base64编码Base64编码是一种基于64个可打印字符的编码方式,常用于在数据传输时对二进制数据进行编码,以便于传输。
Base64编码可以将任何类型的数据转换为可打印的ASCII字符,但编码后会把数据长度增加到原来的4/3倍,这会造成一定程度上的数据冗余,在传输速度和存储空间中需要平衡考量。
六、URL编码URL编码是指对URL中的一些特殊字符进行编码,以便于在传输过程中不同的系统能够正确解析。
数据编码的基本方式

六、作业
每人独立完成20个文件扩展名的归类表格
文件类型 文本 格式
图形
图像 音频 视频 动画
四、视频
(1)数字视频 数字视频由一系列帧组成,每帧是一 副静止的图像 (2)数字视频文件的压缩 (3)数字音频文件格式
五、动画
逐格拍摄平面图画或立体物体,使它 产生运动幻觉的一种电影。卡通片是 最常见的一种动画,还包括木偶动画 、剪影动画、实体动画等。拍摄时, 一个动作往往被分解成数十幅图画, 然后再以每格1/24秒的速度逐一拍摄
北京化大附中 杨帆
在密室逃脱游戏中,一扇紧闭的大门上 写着“SOS”的字样,大门上挂着一把 密码锁,游戏者如何通过线索打开这扇 大门。 提示:是一把6为数字的密码锁。
一、编码
1、数字 、文字(英文)ASCII码表 2、汉字编码:GB2312国标码(一个 汉字占两个字节 啊:0xB0(第一个字节) 0xA1(第 二个字节) 区位码、音码、形码、形音码
二、位图、矢量图
1、概念 2、生成方式 3、色彩 4冗余:例如一幅静态图像中的一大片蓝天、草地。 ②时间冗余:这是序列图像(电视图像、运动图像)和语 音数据中所经常包含的冗余。 ③结构冗余:有些图像从大体上看存在着非常强的纹理 结构,例如草席图像,我们称之为它在结构上存在冗余。 ④知识冗余:有许多图像的理解与某些基础知识有相当 大的相关性。例如:人脸的图像有固定的结构。比如说嘴的 上方有鼻子,鼻子的上方有眼睛,鼻子位于脸的中线上等等。 ⑤视觉冗余:是由于人体器官的不敏感性造成的。例如 在高亮度下,人的视觉灵敏度下降,对灰度值的表示就可以 粗糙一些。 ⑥信息熵冗余:又可称为编码冗余,是指一组数据携带 的平均信息量。 模拟图像信号的数字化和相应的图像频带压缩技术
计算机中数据的编码方式
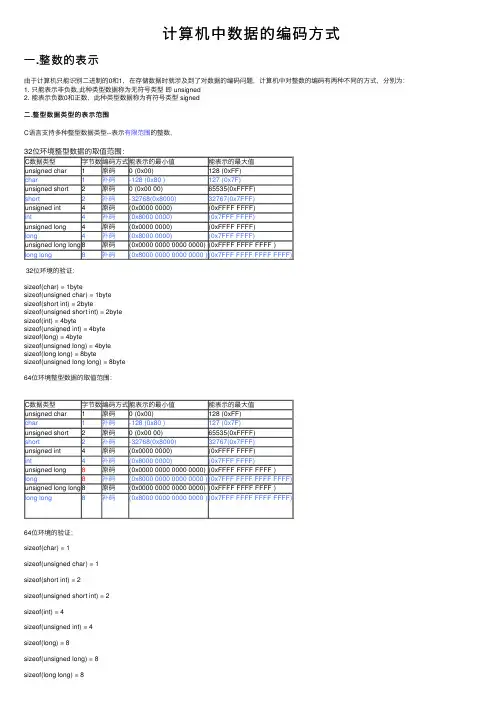
计算机中数据的编码⽅式⼀.整数的表⽰由于计算机只能识别⼆进制的0和1,在存储数据时就涉及到了对数据的编码问题,计算机中对整数的编码有两种不同的⽅式,分别为:1. 只能表⽰⾮负数,此种类型数据称为⽆符号类型即 unsigned2. 能表⽰负数0和正数,此种类型数据称为有符号类型 signed⼆.整型数据类型的表⽰范围C语⾔⽀持多种整型数据类型--表⽰有限范围的整数,32位环境整型数据的取值范围:C数据类型字节数编码⽅式能表⽰的最⼩值能表⽰的最⼤值unsigned char1原码0 (0x00)128 (0xFF)char1补码-128 (0x80 )127 (0x7F)unsigned short2原码0 (0x00 00)65535(0xFFFF)short2补码-32768(0x8000)32767(0x7FFF)unsigned int4原码(0x0000 0000)(0xFFFF FFFF)int4补码(0x8000 0000)(0x7FFF FFFF)unsigned long4原码(0x0000 0000)(0xFFFF FFFF)long4补码(0x8000 0000)(0x7FFF FFFF)unsigned long long8原码(0x0000 0000 0000 0000)(0xFFFF FFFF FFFF )long long8补码(0x8000 0000 0000 0000 )(0x7FFF FFFF FFFF FFFF)32位环境的验证:sizeof(char) = 1bytesizeof(unsigned char) = 1bytesizeof(short int) = 2bytesizeof(unsigned short int) = 2bytesizeof(int) = 4bytesizeof(unsigned int) = 4bytesizeof(long) = 4bytesizeof(unsigned long) = 4bytesizeof(long long) = 8bytesizeof(unsigned long long) = 8byte64位环境整型数据的取值范围:C数据类型字节数编码⽅式能表⽰的最⼩值能表⽰的最⼤值unsigned char1原码0 (0x00)128 (0xFF)char1补码-128 (0x80 )127 (0x7F)unsigned short2原码0 (0x00 00)65535(0xFFFF)short2补码-32768(0x8000)32767(0x7FFF)unsigned int4原码(0x0000 0000)(0xFFFF FFFF)int4补码(0x8000 0000)(0x7FFF FFFF)unsigned long8原码(0x0000 0000 0000 0000)(0xFFFF FFFF FFFF )long8补码(0x8000 0000 0000 0000 )(0x7FFF FFFF FFFF FFFF)unsigned long long8原码(0x0000 0000 0000 0000)(0xFFFF FFFF FFFF )long long8补码(0x8000 0000 0000 0000 )(0x7FFF FFFF FFFF FFFF)64位环境的验证;sizeof(char) = 1sizeof(unsigned char) = 1sizeof(short int) = 2sizeof(unsigned short int) = 2sizeof(int) = 4sizeof(unsigned int) = 4sizeof(long) = 8sizeof(unsigned long) = 8sizeof(long long) = 8sizeof(unsigned long long) = 8三.⽆符号数的编码计算机对⽆符号数的编码⽅式采⽤原码的形式,假设⼀个整数数据类型有 w 位。
常见编码和加密算法
常见编码有ASCII码、ISO-8859-1和GB2312,具体介绍如下:
1. ASCII码:美国人发明的,用1个字节的低7位表示,总共有128个,对于键盘上的字符足够了,一个字符用一个字节表示。
2. ISO-8859-1:欧洲人用的,用1个字节8位表示,总共256个,也是一个字符用一个字节表示。
3. GB2312:国人自己的,用2个字节编码表示,总的编码范围是A1-F7。
其中从A1-A9是符号区,总共包含682个符号,从B0-F7是汉字区,包含6763个汉字。
常见加密算法有对称加密和非对称加密。
对称加密常见的有DES、RC4和AES;非对称加密常见的有RSA、DSA。
对于加密算法一般采用非对称加密算法管理对称算法的密钥,然后用对称加密算法加密数据。
此外,数字证书采用链式签名管理,顶级CA证书已内置在操作系统中。
数字证书的应用包括实现数据加解密、身份认证、签名等多种功能。
以上信息仅供参考,如有需要,建议查阅相关网站。
常用code码 -回复

常用code码-回复[常用code码]在软件开发和计算机科学领域,常常会使用各种编码来表示和处理数据。
编码是用来将字符、数字和其他信息转换成计算机可以理解和处理的二进制形式的一种方式。
本文将介绍一些常用的编码格式,以及它们在实际应用中的用途和特点。
一、ASCII码ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)是计算机中最常用的字符编码之一。
它使用7位二进制数来表示128个字符,包括大小写字母、数字、标点符号和一些特殊的控制字符。
ASCII码常用于英文和其他拉丁字母的文本处理。
二、UnicodeUnicode是一种字符编码标准,它包含了世界上大部分字符的编码,不仅包括各种文字,还有符号、表情等。
Unicode编码是由国际标准化组织(ISO)维护和发布的。
与ASCII码不同,Unicode使用16位二进制数表示一个字符,因此可以表示更多的字符。
Unicode编码有多种实现方式,其中比较常见的是UTF-8、UTF-16和UTF-32。
三、UTF-8UTF-8(Unicode Transformation Format-8)是一种可变长度的Unicode编码方案,其中英文字符使用一个字节表示,而中文和其他非英文字符使用两个或多个字节表示。
UTF-8广泛应用于互联网上的文本处理,因为它既能够兼容ASCII字符,又能够表示世界上的任意字符。
UTF-8也是现代编程语言和数据库的默认编码方式。
四、URL编码URL编码通常用于将URL中的特殊字符转义成可安全传输的形式。
URL 中常见的特殊字符包括空格、井号、问号、斜杠等。
URL编码使用百分号()后跟两位十六进制数来表示一个字符的编码。
例如,空格在URL编码中表示为"20",而井号表示为"23"。
URL编码保证了URL的完整性和可靠性。
了解计算机编码和数据传输技术
了解计算机编码和数据传输技术计算机编码和数据传输技术是信息科学与技术领域的重要基础知识,它们在日常生活和各行各业中发挥着重要的作用。
本文将深入探讨计算机编码和数据传输技术的原理和应用,以帮助读者更好地了解和应用这些知识。
一、计算机编码技术计算机编码技术是将字符、图形等信息转换成计算机可以识别和处理的二进制形式。
常见的编码方式有ASCII码、Unicode和UTF-8等。
下面将逐一介绍这些编码方式及其特点。
1. ASCII码ASCII码(American Standard Code for Information Interchange,美国信息交换标准代码)是最早和最广泛使用的计算机编码方式。
它将所有可打印字符、控制字符和非可打印字符分别映射到0-127的整数值。
ASCII码被广泛应用于英语及西方国家的计算机系统。
2. UnicodeUnicode是一种字符编码方案,它为世界上所有的字符都分配了唯一的代码点,并支持多种编码方式。
Unicode可以解决不同国家和地区的字符兼容性问题,支持包括中文在内的各种语言字符,并可用于跨平台的数据交换。
3. UTF-8UTF-8是Unicode的一种变长字符编码方式,它可以解决Unicode编码在存储和传输时的效率问题。
UTF-8使用1-4个字节表示一个字符,根据字符的不同而变化长度。
UTF-8在互联网应用中被广泛使用,能够兼容ASCII码。
二、数据传输技术数据传输技术是指将数据从一个位置传输到另一个位置的过程。
在计算机网络和通信领域,数据传输技术尤为重要。
下面将介绍常见的数据传输技术。
1. 串行传输和并行传输串行传输和并行传输是两种常见的数据传输方式。
串行传输是指将数据一个位一个地按照顺序发送,传输速度相对较慢;而并行传输是指同时传输多个比特位,传输速度较快。
串行传输适用于长距离传输和对传输速度要求不高的场景,而并行传输适用于高速传输和短距离传输。
2. 基带传输和宽带传输基带传输和宽带传输是根据信号的调制方式来划分的。
数据集的各种编码方式
数据集的各种编码方式
数据集可以使用以下各种编码方式:
1. ASCII编码:ASCII码是美国信息交换标准代码,用于在计
算机中表示英文字符。
它使用7位二进制表示128个字符,包括英文字母、数字、标点和控制字符。
2. UTF-8编码:UTF-8是一种可变长度的字符编码方式,可以
用于表示Unicode字符集。
它使用1到4个字节表示不同的字符,可以表示几乎所有的字符,包括世界上所有的语言。
3. UTF-16编码:UTF-16也是一种Unicode字符编码方式,使
用16位(2个字节)表示一个字符。
它包括基本多文种平面(BMP)字符和辅助平面字符。
4. UTF-32编码:UTF-32也是一种Unicode字符编码方式,使
用32位(4个字节)表示一个字符。
它可以表示所有的Unicode字符,包括辅助平面字符。
5. ASCII编码的扩展:为了表示更多的字符,ASCII编码进行
了扩展。
例如,ISO-8859编码系列是基于ASCII编码的扩展,用于表示欧洲各种语言的字符。
6. Unicode编码:Unicode是一种字符编码标准,用于表示世
界上所有语言的字符。
它包括各种字符集,如UTF-8、UTF-
16和UTF-32。
除了上述编码方式,还有一些其他特定的编码方式,如
GB2312(中国内地的中文字符集)、Shift JIS(用于日文字符集)等。
根据不同的需求和应用场景,选择合适的编码方式是非常重要的。
常见的基本数据编码方式
常见的基本数据编码方式什么是基本数据编码方式?常用的基本编码方式有哪些?它们有什么不同之处及应用场景是什么?本文将为读者深入解析,带您了解基本数据编码方式。
一、什么是基本数据编码方式?在计算机中,数据的传输、存储和处理过程中,需要将数据按照一定的格式进行编码和解码。
基本数据编码方式是将数据按照特定的规则转换成计算机可识别的二进制数据的一种方法。
二、常用的基本编码方式有哪些?1. ASCII码ASCII码是美国信息交换标准代码的缩写,是一种基于26个大写字母、26个小写字母、数字、标点符号以及一些控制字符组成的7位二进制编码方式。
ASCII 码可以表示128种不同的字符,被广泛应用于计算机系统中,如文本文件和网页等。
2. UnicodeUnicode是一种统一的字符集标准和编码协议,采用16位二进制编码,它定义了世界上所有主要的语言文字的字符集合,可以表示超过100,000个字符。
Unicode包含了ASCII码中的所有字符,以及世界各地使用的符号、汉字和emoji表情等。
3. UTF-8UTF-8(Unicode Transformation Format-8bit)是一种字节序列频率最高的Unicode编码方式之一,采用可变长度的编码方式,根据不同的字符长度,采用1-4个字节进行编码。
UTF-8可以表示Unicode字符集的所有字符,且节约存储空间,被广泛应用于计算机系统中。
4. GBKGBK是国家标准的中文编码之一,是中国大陆所使用的编码方式。
GBK编码采用2个字节表示一个中文字符,共能够表示21886个汉字和图形符号以及94个ASCII字符。
目前GBK编码已经逐渐被UTF-8、UTF-16等Unicode编码所替代,但在一些需要适配老系统和老设备的场景,仍然需要使用GBK编码。
5. Base64Base64是一种基于64个可打印字符来表示二进制数据的编码方式,常用于网络传输和数据存储,如电子邮件、图片和加密数据等。
数据编码的基本方式
28
机内码
文档仅供参考,如有不当之处,请联系改正。
GB2312-80统一要求了中文旳基本编码原则,但是 要存储在计算机中与西文编码在计算机中旳表达
)8= ( )16=
文档仅供参考,如有不当之处,请联系改正。
编码
计算机是美国人发明旳,所以计算机旳字 符集中自然包括了英文旳26个字母。
计算机要在全世界通用,必须采用公认旳 原则格式对字符、符号进行编码。
常用旳字符编码有ASCII码、BCD码、西文 字符编码和EBCDIC码。
21
文档仅供参考,如有不当之处,请联系改正。
文档仅供参考,如有不当之处,请联系改正。
二进制数转换为十六进制数
整数部分从低位向高位方向每4位用一种等值旳十六 进制数来替代,即四位并为一位,最终不足4位时在 高位处补0,补够4位;小数部分从高位向低位方向 每4位用一种等值旳十六进制数来替,最终不足4位 时在低位处补0,补够4位。 (1110 0101 1010 . 1011 1001)2 =(E5A.B9)16
78~7E
位 区 1~15
16~55
56~87
88~94
21 22 23 24 25 26 …………7C 7D 7E
7F
1 2 3 4 5 6 ………………91 92 93 94
非中文图形符号(常用符号、数字序号、俄文、 英文、法文、希腊字母、日文平、片假名等)
啊阿埃
一级中文
(3755个)
二级中文(3008个)
23
文档仅供参考,如有不当之处,请联系改正。
西文字符处理起来比较简朴,而中文信息 处理起来就复杂了。中文是图形文字,常 用中文就有3000~6000个,形状和笔画差 别很大。这就决定了中文字符旳编码方案 必须完全不同于西文旳编码方案。