
高等教育:《词法分析(2)》
pointer to table entry pointer to table entry LT LE EQ NE GT GE
No2t0e1:9/1E2/a3ch token has a unique token id编e译n原ti理fier to define category of lexemes 5
编译原理
8
Fig 3-13 标识符和保留字的转换图
return(gettoken(), install_id( ))返回记号和属性值 lexical_value;
install_id( )首先得到该词素,再对符号表进行操 作(查表及填表);
gettoken()在符号表中查找单词,若是关键字, 则返回相应的token,否则返回token类型为id。
Lex 编译器
lex.yy.c
lex.yy.c
C 编译器
a.out
输入流
2019/12/3
a.out
编译原理
记号序列
20
Lex程序结构
Lex 程序结构包括三个部分:
declarations 声明 %% translation rules 转换规则,这是关键部分 %% auxiliary procedures 辅助过程
其中,pi是正规表达式,每个动作actioni表示匹配 该表达式成功后,词法分析器要执行的程序段(用C
语言编写) 应该执行的代码。这些代码都放在函数
yylex中。
2019/12/3
编译原理
24
[a-z]+ printf("%s", yytext);
2019/12/3
编译原理
25
Lex 的正规表达式(P98图3-48)
匹配0个或者多个上述的模式。
匹配1个或者多个上述模式。
匹配0个或1个上述模式。
作为模式的最后编译一原个理 字符匹配一行的结尾。
26
Lex 的正规表达式(P98图3-48)
字符 {}
\
^ | "<一些符号>" /
()
含义
指出一个模式可能出现的次数。 例如: A{1,3} 表示 A 可能出现1次或3次。
}
2019/12/3
编译原理
16
3.4 Lex:词法分析程序生成器
Lex 代表 Lexical-Analyzer,是一种生成扫描器 的工具。扫描器是一种识别文本中的单词模式(正 则表达式)的程序。
Flex: Fast Lexical Analyzer Generator Lesk 1975年实现,unix的标准命令 中文文档(Yacc 与 Lex 快速入门)
letter或digit
start 9 letter
other 10
* return(gettoken(), 11 install_id( ))
2019/12/3
编译原理
9
Fig 3-14 无符号数的转换图 num digit+ (.digit+)? (E (+ | )? digit+)?
digit
start
a
e
i
o
u
2019/12/3
error
编译原理
Note: The error path is taken if the character is other than a cons or the vowel in the lex order.
14
3.3.4 状态转换图的实现
状态转换图可以变换成程序,用于识别对应的 token。
字符
含义A-Z, 0-9, a Nhomakorabeaz 构成了部分模式的字符和数字。
.
匹配任意字符,除了 \n。
-
用来指定范围。例如:A-Z 指从 A 到 Z 之间的所有字符。
[]
* + ? $ 2019/12/3
一个字符集合。匹配括号内的任意 字符。如果第一个字
符是 ^ 那么它表示否定模式。例如: [abC] 匹配 a, b, 和 C中的任何一个。
2019/12/3
编译原理
27
正规表达式举例
常规表达式 joke[rs]
A{1,2}shis?
(A[b-e])+
含义
匹配 jokes 或 joker。
匹配 AAshis, Ashis, AAshi, Ashi。
匹配在 A 出现位置后跟 随的从 b 到 e 的所有字
符中的 1 个或 个。
2019/12/3
通用表驱动算法(Loop and switch) 词法分析器的C代码
2019/12/3
编译原理
15
TOKEN getRelop()
{ TOKEN retToken = new(RELOP); while(1) { switch (state) { case 0: c = nextchar(); if (c == ‘<‘) state = 1; else if (c == ‘=‘) state = 5; else if (c == ‘>’) state = 6; else fail(); break; case 1: … … case 8: retract(); retToken.attribute = GT; return(retToken); } }
(Arrowhead)
终止状态Final State(s) : End of pattern
(Concentric Circles)
假定状态转换图是确定的(Deterministic) - No need
to choose between 2 different actions !
2019/12/3
start 0 < = >
2019/12/3
1 = 2 return(relop, LE)
> 3 return(relop, NE)
other 4 * return(relop, LT)
5 return(relop, EQ)
6 = 7 return(relop, GE)
other 8 * return(relop, GT)
digit
digit
start
digit
.
digit
E
+|-
digit
other *
12
13 14
15 16
17
18
19
E
digit
start
digit 20
digit
.
digit
21
22
digit
other
*
23
24
digit
return(NUM, install_num( ))
start
digit
3.3.1 状态转换图(Transition Diagrams)
状态转换图是正规表达式的一种表示
每个状态转换图有
状态States : Represented by Circles
动作Actions : Represented by Arrows between
states
初始状态Start State : Beginning of a pattern
other
*
25
26
27
2019/12/3
编译原理
10
Fig 3-14 无符号数的转换图 num digit+ (.digit+)? (E (+ | )? digit+)?
digit
digit
digit
start
digit
.
digit
E
+|-
digit
other *
12
13 14
15 16
17
18
19
E other
* 20
other
digit *
21
2019/12/3
编译原理
11
空白的转换图
delim blank | tab | newline
ws delim+
delim
start 22
delim 23 other
* 24
2019/12/3
编译原理
12
例. P76. 3.2.5(1)
编译原理
28
Lex定义的全局量
函数 int yylex() yytext is a null-terminated string containing the text of the
lexeme just recognized as a token. This global variable is declared and managed in the lex.yy.c file. yyleng is an integer holding the length of the lexeme stored in yytext. yylval is the global variable used to store attributes about the token, e.g. for an integer lexeme it might store the value, for a string literal, the pointer to its characters and so on.
编译原理
2
词法规则
digit [0-9] digits digit+ number digits (.digits)? (E(+|)? digits)? letter_ [A-Za-z] id letter (letter | digit )* if if then then else else relop < | < = | = | < > | > | > =
编译原理 第2章 词法分析
㈢单词二元式编码
经词法分析后,单词用二元式 (code,val) 表示。 code表示单词的种别,用整数码表示。单词种别表示单词 的语法特性,在语法分析时使用。 val表示单词的值,在本书中用字符串表示。单词值表示了 单词的语义特性,在语义分析时使用。
㈣编码原则
通常将标识符归为一种,常数按类型分种,基本字、运算 符及界符采用一符一种。 如果一个种别仅包含一个单词,那么单词种别就可代表该 单词,无需给出单词值。为了输入和处理的方便,无意义的 单词值用字符串"NUL"表示。若一个种别含有多个单词,除 给出种别外,还需给出它的值。
②预处理主要工作 删除注释 删除续行符,以及后续换行符(0AH)。 换行符、TAB和空格具有界符作用,预处理时通常予以保留。 在后面的分析中可以看到,它们的存在反而给后续的单词识别 带来方便。为了简化判断,可在预处理时,将换行符和TAB统 一替换为空格。 大多数语言(除C语言)不区分大小写,可在预处理时,将 大写字母变换成小写字母,或相反,以方便后续处理。 对于受书写格式限制的语言(例Fortran和Cobol),还应识 别标号区,正确给出语句标号。识别续行标志,把相继行捻接 在一起,给出语句结束符。 上述源程序经预处理后,扫描缓冲区中的内容如下所示:
第2章 词法分析
2.1 词法分析器的设计考虑及手工构造
2.1.1 单词类型及二元式编码 2.1.2 源程序的输入及预处理 2.1.3 基本字的识别和超前搜索 2.1.4 遍 2.1.5 状态转换图和词法分析器的手工构造
2.2 正规式、自动机及词法分析器的自动生成
2.2.1 2.2.2 2.2.3 2.2.4 2.2.5 基本概念 正规式与正规集 确定有限自动机(DFA) 非确定有限自动机(NFA) 正规式与确定有限自动机的等价性
编译原理与技术 词法分析 (2)(2)

2024/7/1
《编译原理与技术》讲义
20
正规式与有限自动机
✓ R= R1 | R2
Si
S0 Sj
(3)
fi
f0
fj
引入新的终态f0和 (fi,)=f0和(fj,)=f0
2024/7/1
《编译原理与技术》讲义
21
正规式与有限自动机
✓ R= R1 ·R2
(1)
Si
fi
Sj
fj
R1对应的 NFA,Si为初 态,fi为终态
…
2024/7/1
《编译原理与技术》讲义
5
有限自动机的表示
e.g.7 NFA Mn =(, S, S0,F,),其中:
= { 0,1 } , S = {S0, S1 , S2 , S3 , S4 },F={S2 , S4}
(S0,0)= {S0, S3 } (S0,1)= {S0, S1 }
(S1,0)= ∅
有限自动机
有限自动机(Finite Automata-FA)是种更 一般化的状态转换图。分为NFA和DFA。
词法分析器自动生成:
正规式
NFA
DFA
词法程序
非确定有限 自动机
确定的有限 自动机
2024/7/1
《编译原理与技术》讲义
1
非确定有限自动机-NFA
NFA Mn 是一个五元组 Mn =(, S, S0,F,), 其中:
2024/7/1
《编译原理与技术》讲义
15
比较 DFA 和 NFA(2)
DFA
NFA
容易实现-当输入串结束 由于面临同样输入符号存 时(或不存在相应状态转 在多重状态转换或存在转 换)时,若当前状态为终 换的选择,实现较为复杂。 态即为接受“已读入”的串, 一般地,NFA接受串如果
二词法分析PPT课件

L(r)={a,b}{a,b} ={aa,ab,ba,bb}
a
{ ,a,aa,…}
(ab)
{ ,a,b,aa,ab ……}
➢正则表达式的名字 ❖为了方便,为较长的正则表达式提供一个简化的名字 ❖例如: 一个或多个数字序列的正则表达式 (0|1|…|9)(0|1|…|9)* 可写为
digit digit* 其中digit = 0|1|…|9是名字为digit的正则表达式
例如: a1=a a2=aa a0=ε
4 语言
• 定义 字母表上的一些符号串的集合
• 例如
• ε是一个语言 • 空集也是一个语言
5 语言的运算
• 连接
• L和M的连接记为LM LM ={st|s∈L,t∈M}
• 例如:
L=ab,cde M = 0,1 LM =ab0,ab1,cde0,cde1
• {ε}A=A{ε}=A
调用 Token
语法分析
• 词法分析主要研究:
• 词义结构的表示法:正则表达式 • 识别系统:有穷自动机是对正则表达式给出的串格式的识别算法 • 实际编写程序实现有穷自动机的识别过程.
2.2 正则表达式
• 功能
表示字符串的格式
• 正则表达式的定义
• 正则表达式r完全由它所匹配的串集来定义 • 这个集合称为由正则表达式生成的语言, 写作 L(r) • L(r) 定义在正规符号的集合上,称为字母表∑
2.2.1 符号串和语言
1. 字母表
• 定义 符号的非空有穷集合
• 例如 ∑={0‚1} Α={a‚b,c}
2 符号串
• 定义 由字母表中的符号组成的任何有穷序列.
• 例如 0,00,10 是∑={0‚1}的符号串 a, ab, aaca 是Α={a‚b,c}的符号串
自然语言处理的词法分析与句法分析

自然语言处理的词法分析与句法分析自然语言处理是人工智能领域的一个重要分支,旨在使计算机能够理解和处理人类语言。
其中,词法分析和句法分析是自然语言处理的两个主要任务。
词法分析负责将一段文本分解成单词或词素,而句法分析则对文本的语法结构进行分析和解析。
本文将详细介绍词法分析和句法分析的基本概念、方法和应用。
一、词法分析1. 概念和任务词法分析是自然语言处理中的一个基础任务,主要目标是将一段文本拆分成一个个单词或词素。
词法分析可以看作是自然语言处理中最初的处理环节,在很大程度上决定了后续处理任务的难度和准确性。
具体而言,词法分析的任务包括以下几个方面:(1)分词:将连续的文本流分成一个个独立的单词。
分词在汉语处理中尤为重要,因为汉语中没有像英语中的空格来明确标识词之间的边界。
(2)词性标注:对每个单词进行词性标注,即确定它的词性类别(如名词、动词、形容词等)。
词性标注常常需要结合上下文语境进行判断。
(3)词干提取:将一个单词的派生形式还原为它的词干或原型形式。
例如,“running”和“ran”都可以还原为“run”。
2. 方法和技术(1)规则法:基于规则的词法分析方法依靠人工定义的词法规则和规则库进行分析。
这种方法简单直观,易于理解和实现,但对规则的编写需要大量的人工劳动,并且规则难以适应复杂多变的语言现象。
(2)统计法:统计法通过学习大量的语料库数据,利用统计模型来进行词法分析。
常见的统计模型包括隐马尔可夫模型(Hidden Markov Model,HMM)、最大熵模型(Maximum Entropy Model,MEM)、条件随机场(Conditional Random Field,CRF)等。
统计法的优点是能够自动学习语言规律,适应性较好,但需要大量的训练数据和计算资源。
(3)深度学习法:深度学习方法基于神经网络,通过多层的神经网络结构来进行词法分析。
典型的深度学习模型包括循环神经网络(Recurrent Neural Network,RNN)、长短期记忆网络(Long Short-Term Memory,LSTM)等。
第二章 词法分析
8
单词种别表示单词的种类, (1) 单词种别表示单词的种类,是语法分 析所需要的信息。 析所需要的信息。 一个语言的单词符号如何划分种类、 一个语言的单词符号如何划分种类、分为 几类、如何编码都属于技术性问题, 几类、如何编码都属于技术性问题,主要取 决于处理上的方便。 决于处理上的方便。 通常让每种单词对应一个整数码, 通常让每种单词对应一个整数码,这样可 最大限度地把各个单词区别开来。 最大限度地把各个单词区别开来。
6
(4) 运 算 符 : 如 “ +” 、 “ − ” 、 “ * ” 、 /”、 >”、 <”等 “/”、“>”、“<”等。 (5) 界符:在语言中是作为语法上的分界符 界符: 号使用的, 号使用的 , 如“ , ”、 “ ;” 、 “( ” 、 “ ) ” 等。 一个程序语言的保留字、 一个程序语言的保留字、运算符和界符 的个数是确定的, 的个数是确定的,而标识符或常数的使用则 不限定个数。 不限定个数。
24
终态一般对应一个return( 语句。 终态一般对应一个return( )语句。 return意味着从词法分析器返回到调用段 return意味着从词法分析器返回到调用段 一般指返回到语法分析器。 ,一般指返回到语法分析器。
图2–4 含有分支或回路的状态示意 (a) 含分支的状态 ;(b) 含回路的状态 含分支的状态i; 含回路的状态i
(3,’if’) (1,指向 的符号表入口) 指向i (1,指向i的符号表入口) (4,’=’) (2,’5’) (3,’then’) (1,指向 的符号表入口) 指向x (1,指向x的符号表入口) (4,’:=’) (1,指向 的符号表入口) 指向y (1,指向y的符号表入口) (5,’;’)
实验2 词法分析
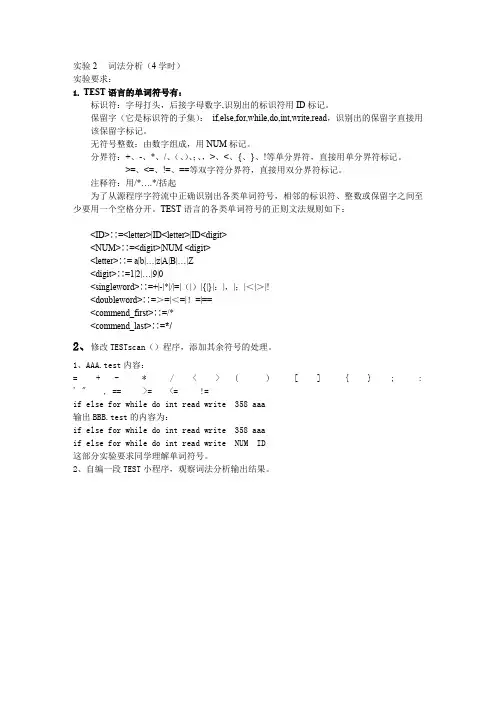
实验2 词法分析(4学时)实验要求:1. TEST语言的单词符号有:标识符:字母打头,后接字母数字,识别出的标识符用ID标记。
保留字(它是标识符的子集):if,else,for,while,do,int,write,read,识别出的保留字直接用该保留字标记。
无符号整数:由数字组成,用NUM标记。
分界符:+、-、*、/、(、)、;、,>、<、{、}、!等单分界符,直接用单分界符标记。
>=、<=、!=、==等双字符分界符,直接用双分界符标记。
注释符:用/*….*/括起为了从源程序字符流中正确识别出各类单词符号,相邻的标识符、整数或保留字之间至少要用一个空格分开。
TEST语言的各类单词符号的正则文法规则如下:<ID>∷=<letter>|ID<letter>|ID<digit><NUM>∷=<digit>|NUM <digit><letter>∷= a|b|…|z|A|B|…|Z<digit>∷=1|2|…|9|0<singleword>∷=+|-|*|/|=|(|)|{|}|:|,|;|<|>|!<doubleword>∷=>=|<=|!=|==<commend_first>∷=/*<commend_last>∷=*/2、修改TESTscan()程序,添加其余符号的处理。
1、AAA.test内容:= + - * / < > ( ) [ ] { } ; : ' " , == >= <= !=if else for while do int read write 358 aaa输出BBB.test的内容为:if else for while do int read write 358 aaaif else for while do int read write NUM ID这部分实验要求同学理解单词符号。
编译原理 词法分析2(附答案) 东华大学 姚励
作业第二题:(上海交通大学1984年考研试题)下述正规表达式中(1)与(a*|b)*(c|d)等价。
⑴(a|b)*c|(a|b)*d⑵a*(c|d)|b*(c|d)⑶a*(c|d)*|b(c|d)*第三题:(西北工业大学1999年考研试题)设字母表∑={a,b,0,1},请写出满足下述条件的正则表达式:以字母a或b打头,以1结尾。
答案:a(a|b|0|1)*1| b(a|b|0|1)*1第四题:(1)构造一个正规式,它接受∑={a,b}上所有包含ab的字符串。
(2)构造一个正规式,它接受∑={a,b}上所有以ab结尾字符串。
(3)构造一个正规式,它接受∑={a,b,c}上符合以下规则的字符串:如果以a开头,则串内至少包含一个c;如果以b开头,则串内至多包含一个 a。
答案:(1) (a|b) * ab (a|b)*(2) (a|b) * ab(3) a (a|b|c)* c (a|b|c)* | b ( (b|c) * a(b|c) * | (b|c) * )第六题:试构造正规表达式((a*|b)(b*a)) *的NFA,然后确定化和最小化。
答案:与正规表达式等价的NFA如下所示:注:未标明转移条件的,均默认为条件为ε上图对应状态名Si如下:3 4 5 61 2 9 10 11 12 13 14 15 167 8S1闭包={ S1,S2,S3,S4,S6,S7,S9,S10,S11,S13,S14,S16 } S2闭包={ S2,S3,S4,S6,S7,S9,S10,S11,S13,S14 }S3闭包={ S3,S4,S6,S9,S10,S11,S13,S14 }S4闭包={ S4 }S5闭包={ S4,S5,S6,S9,S10,S11,S13,S14 }S6闭包={ S6,S9,S10,S11,S13,S14 }S7闭包={ S7 }S8闭包={ S8,S9,S10,S11,S13,S14 }S9闭包={ S9,S10,S11,S13,S14 }S10闭包={ S10,S11,S13,S14 }S11闭包={ S11 }S12闭包={ S11,S12 ,S13,S14}S13闭包={ S13,S14 }S14闭包={ S14 }S15闭包={ S2,S3,S4,S6,S7,S9,S10,S11,S13,S14,S15,S16 }S16闭包={ S16 }DFA取Q1= S1闭包={ S1,S2,S3,S4,S6,S7,S9,S10,S11,S13,S14,S16 } 则f(Q1,a)= S5闭包+ S15闭包={ S2,S3,S4,S5,S6,S7,S9,S10,S11,S13,S14,S15,S16 }=Q2f(Q1,b)= S8闭包+ S12闭包={ S8,S9,S10,S11,S12,S13,S14 }=Q3此时,Q2,Q3未标记。
第2章 词法分析-编译原理及实践教程(第3版)-黄贤英-清华大学出版社
=> 0 >
1=
2
>
3=
4
其他
Hale Waihona Puke 其他6*5*
识别>、>=、>>、>>=四个单词的状态转换图
数值型常量的识别
0~9
1~9
=> 0
1
其他
* 2
0
十进制整型数
=> 0
0~7 0 3 其他 4 *
八进制整型数
=> 0 0
0~9
0~9 |a~f
|a~f |A~F
3 x/X 5 |A~F 6 其他 7 *
十六进制整型数
字母或数字
* 0 字母 1 其它 2
识别标识符的转换图
一个状态图可用于识别一定的字符串,大多数程序 设计语言的单词符号都可以用转换图来识别。
字母或数字
* 0 字母 1 其它 2
识别过程是:从初始状态0开始,若读入一个字母, 转入1状态,若再读入字母或数字,仍处于1状态, 否则转向2状态,结束一个标识符的识别过程。状 态上的*表示多读入一个符号。
错误处理程序
源 程 序
词
语
语
法
法
义
分
分
分
析单 析 语
器
词 记
器
法 单
析 器
语 法 单
中 间 代 码 生 成 器
中 间 代
代 码 优 化
器
中 间 代
目 标 代 码 生 成
器
目 标 代 码
号
位
位
码
码
表格管理程序
2.1 词法分析器概述
• 功能:
源程序
词法分析程序 Token串 语法分析程序
lect3-lexical-2(3)
北京大学信息科学技术学院2015年春季学期《编译技术》第3章词法分析(2)Lexical Analysis【对应教材 3.3- 3.5】取下一个Token符号表语法分析器词法分析器上节内容回顾☐词法分析器的作用Token(词法单元)源程序☐词法单元的描述方法⏹ 字母表、符号串和语言⏹正则集合、正则表达式和正则定义Review Questions☐写一个正则表达式,表示所有能被5整除的十进制数。
☐写一个正则表达式,表示所有能被5整除的不包含前导0的十进制数。
☐写一个正则表达式,表示所有能被5整除的二进制数。
☐词法分析器的作用☐词法单元的规约⏹串和语言;正则表达式、正则定义☐词法单元的识别☐词法分析器生成工具—LEX☐有限自动机(Finite Automata)☐正则表达式到有限自动机☐词法分析器生成工具的设计☐一般有两种方式:⏹借助状态转换图(有限自动机的图形表示)手工构造词法分析器。
⏹通过LEX自动生成词法分析器。
正则表达式⇒ NFA⇒ DFA⇒ minDFA⇒词法分析器☐状态转换图(transition diagram)⏹状态(state):表示在识别词素时可能出现的情况状态看作是已处理部分的总结某些状态为接受状态或最终状态,表明已找到词素加上*的接受状态表示最后读入的符号不在词素中 ☐开始状态(初始状态):用“开始”边表示⏹边(edge):从一个状态指向另一个状态;边的标号是一个或多个符号当前符号为s,下一个输入符号为a,就沿着从s离开,标号为a的边到达下一个状态= 2r 1> 3<other *开始40 =>5 return(relop, EQ)= other 768 *eturn(relop, LE) return(relop, NE) return(relop, LT)return(relop, GE) return(relop, GT)letter或digit开始letter other *11 return(getToken(), installId( ))9 10number → digit+ (.digit+)? (E (+ | -)? digit+)?digit Edigitdigitdigit开始12 digit13.14digit15E+/-16digit17 18other other other*19开始20delim21other*22delimdelim → blank | tab | newline ws → delim +北京大学信息科学技术学院手动编写词法分析程序:以relop 为例TOKEN getRelop ( ){ TOKEN retToken = new ( RELOP ) ;while ( 1 ) { /* 反复读入字符,直到return 或 遇到错误 */switch (state) {case 0 : c = nextChar ( ) ;if ( c == ' < ' ) state = 1 ; else if ( c == ' = ' ) state = 5 ; else if ( c == ' > ' ) state = 6 ; else fail ( ) ; /* 非关系算符 */ break ;case 1 : …… …… 2 =return(relop, LE) case 8 : retract ( ); retToken.attribute = GT; return (retToken); 开始1> < other3 return(relop, NE)4 * return(relop, LT)} 0= } >5 return(relop, EQ)} 2015年春季学期 《编译技术》课程= 6 other 7 return(relop, GE)8* return(relop 1, G 1T)首先通过正则表达式来描述词法单元的模式 基本目标:判断一个串s是否属于一个正则表达式R表示的语言s∈L(R)在现实中,还要能够连续识别多个不同类别的词法单元if (a == b) …(1)分别为每一类词法单元写出正则表达式R i(2)构造一个正则表达式R来匹配所有的词法单元R = R1 | R2 | … | R k(3)设输入为x1x2…x n, 对1≤i≤n,检查是否x1…x i∈L(R)(4)如果匹配成功,则存在j,使得x1…x i∈L(R j)(5)把x1…x i从输入中移走,继续执行(3)如何确定匹配的长度?有可能多个前缀都可以产生匹配解决办法:匹配最长可能的串选择哪个正则表达式来匹配?有可能多个正则表达式都可以匹配解决办法:排在前面的正则表达式优先匹配如果所有正则表达式都不能匹配怎么办?怎么报错?解决办法:可以构造一个ERROR正则表达式,放到所有表达式在后面,用来报告错误信息14Quiz:选择题使用如下的词法描述,在识别字符串“dictatorial” 的过程中会如何进行分割?dict (1)dictator (2)[a-z]* (3)dictatorial (4)a)4b)3c) 1, 3d) 2, 3内容提要词法分析器的作用词法单元的规约串和语言;正则表达式、正则定义 词法单元的识别☐词法分析器生成工具—LEX 有限自动机(Finite Automata)正则表达式到有限自动机词法分析器生成工具的设计Lex 简介Lex 是一种词法分析程序的自动构造工具。
6.第三章词法分析(2)
DFA表示为状态转换图:例
例1的DFA M=({0,1,2,3},{a,b}, δ,0,{3})
δ 所对应的状态转换图如 P48.图3.5
a
1
b a
a
0
b
3
b
a,b
2
以后,将不加区别的使用DFA和状态转 换图。
12
DFA识别(读出,接受)字α
DFA识别字α 对于*中的任何一个字,若存 在一条从初态结点到某一终态结点的通路,且 这条通路上所有箭弧的标记符连接成的字等于 ,则称为DFA M所识别。 例: 图3.5的DFA识别字abbab, 因为存在路 径 012333;但不接受字ababa, 因为不存 在识别路径。 a a 1 a,b 3 b a 0
状态 0 1 2 3
a 1 3 1 3
b 2 2 3 3
10
DFA表示为 --- 状态转换图
DFA也可以表示成一张确定的状态转换图。 假定DFA M含有m个状态n个输入字符,那末 这张图: 含有m个状态结点 每个结点顶多有 n条箭弧射出和别的结点相 连接 每条箭弧用上的一个不同字符作标记 整张图含有唯一的初态和若干个 ( 可以是 0 个)终态结点。 某个结点可以既是初态同时又是终态。
任务:从左到右一个字符一个字符地读入源程 序,对构成源程序的字符流进行扫描和分解, 从而识别出一个个单词符号。
逻辑上紧密相连的一组字符, 这些字符具有集体含义。
单词:标识符,保留字,常数,算符,界符 词法分析阶段的工作所依循的是语言的词法规 则。描述词法规则的有效工具是正规式和有限 自动机。
第3章 词法分析(II)
词法分析(Lexical Analysis) 词法的表示 词法分析器的设计与实现