
语义特征编码
语义特征编码
语义特征编码属于信息处理的范畴,主要是对语句信息的处理,解决了语句的存储和检索问题,有利于基于自然语句搜索的全文搜索的研究。
语义特征编码定义
语句增量Hash的结果作为特征量,依次表示语句的特征,相同的语句只有唯一的特征量.
语义特征编码技术特点
语句经过特征编码处理后转换为统一长度的字符串或者整型结构的数据,解决了语句的存储和检索问题。
语义特征编码功能
1、语义特征编码技术保证了语句中文字之间顺序关系,决定了语句的存储量只与不同语句的多少有关,相同的语句无需再次存储。
2、对所有语言采用统一的处理方式---语义特征编码技术,查找:采用先计算特征编码再查找的方式进行,保证了检索的效率和精准度。
记忆的过程和环节

记忆的过程和环节记忆是人类大脑的一项重要功能,它使我们能够存储和回忆以往的经历、知识和技能。
记忆的过程可以分为编码、存储和提取三个环节。
一、编码编码是记忆的第一个环节,它指的是将外界的信息转化为大脑可以存储和处理的形式。
在接收到外界信息后,大脑会根据其特征、意义和情感进行编码。
例如,当我们看到一朵红玫瑰时,大脑会将其颜色、形状、香味等特征进行编码。
编码的方式有很多种,其中最常见的是语义编码和视觉编码。
语义编码是指将信息转化为语义概念,例如将一个单词与其意义联系起来;而视觉编码则是将信息转化为视觉形象,例如将一个物体的形状和颜色进行编码。
二、存储存储是记忆的第二个环节,它指的是将编码后的信息存储在大脑中,以便以后的回忆和使用。
存储的过程涉及到神经元之间的连接和强化,形成记忆的痕迹。
人类的记忆可以分为短期记忆和长期记忆两种。
短期记忆是暂时存储的记忆,它的容量有限,保持时间较短;而长期记忆是相对永久的存储,可以持续较长时间。
存储的方式也有多种,其中包括语义存储、情景存储和过程存储等。
语义存储是指将信息存储为概念和事实,例如存储一个人的名字和职业;情景存储是指将信息存储为具体的场景和经历,例如存储一次旅行的画面和感受;过程存储则是指将信息存储为技能和习惯,例如存储弹钢琴的技巧和打字的方法。
三、提取提取是记忆的第三个环节,它指的是从存储中获取和回忆信息的过程。
在需要使用记忆中的信息时,大脑会通过搜索和检索的方式找到并提取相关的记忆。
提取的过程可以受到多种因素的影响,例如记忆的强度、情境的相似性和情绪的影响等。
当我们回忆某个事件或者寻找某个知识时,我们往往需要根据一些线索和提示来启动相关的记忆。
记忆的提取可以是主动的,也可以是被动的。
主动提取是指有意识地回忆和搜索记忆;而被动提取则是在特定的情境下,无意识地回忆和启动相关的记忆。
总结记忆的过程和环节包括编码、存储和提取三个阶段。
编码是将外界信息转化为大脑可以处理的形式;存储是将编码后的信息存储在大脑中;提取是从存储中获取和回忆信息。
机器学习中的特征编码方法(八)

机器学习中的特征编码方法在机器学习领域,特征编码是一个关键的环节,它将原始数据转换成适合机器学习算法处理的特征表示。
特征编码方法的选择,直接影响了机器学习模型的性能和准确度。
本文将介绍几种常见的特征编码方法,并分析它们的优缺点以及适用场景。
一、独热编码(One-Hot Encoding)独热编码是将类别型特征转换成二进制的向量表示。
对于一个具有n个不同取值的类别型特征,独热编码将其转换成一个n维的向量,其中只有一个元素为1,其余元素都为0。
独热编码的优点是简单易懂,不会引入顺序关系,适用于类别之间没有大小关系的特征。
然而,独热编码会导致特征空间的维度急剧增加,当类别数量较多时,会导致稀疏性问题,影响模型训练的效率和性能。
二、标签编码(Label Encoding)标签编码是将类别型特征直接映射成整数值。
例如,对于一个有三个类别(A、B、C)的特征,可以分别用0、1、2来表示。
标签编码的优点是简单高效,不会引入额外的维度,适用于类别之间有大小关系的特征。
但是,标签编码会引入大小关系,可能导致机器学习模型错误地学习到特征之间的顺序关系。
三、二进制编码(Binary Encoding)二进制编码是将类别型特征转换成二进制的表示形式。
首先将类别型特征用标签编码映射成整数值,然后再将整数值转换成二进制形式。
二进制编码的优点是能够有效减少特征空间的维度,同时保留了类别之间的相对顺序关系。
然而,二进制编码可能会引入更多的噪声,对于类别数量较多的特征,可能会导致过拟合问题。
四、嵌入编码(Embedding Encoding)嵌入编码是一种通过神经网络学习得到的特征表示方法。
对于类别型特征,可以使用嵌入层将其映射成低维的实数向量。
嵌入编码的优点是能够同时考虑特征的语义信息和相似性,适用于类别数量较多且具有复杂关系的特征。
然而,嵌入编码需要大量的数据和计算资源来训练,对于小样本和资源有限的场景不太适用。
五、特征哈希(Feature Hashing)特征哈希是一种使用哈希函数将特征映射成固定维度的方法。
短时记忆的视觉和听觉编码
实验编号:2013.2.8.3 2013学年第2学期记忆的视觉和听觉编码专业年级:应用心理2012级实验组别:实验者:李德輝10120320139其他成员:实验时间:摘要短时记忆的编码方式是认知心理学研究中的一个重要问题,存在视觉编码、听觉编码、语义编码等多种观点。
减数法是反应时研究的传统方法,应用于当代认知心理学中为探明认知加工过程提供了一条途径。
波斯纳(Posner,1967,1969)将减数法应用于短时记忆编码的研究中,以音同形同、音同形异、音异形异的字母对为实验材料,让被试做出同/异判断,分析其反应时,得出某些情境中短时记忆中信息编码的规律:先形成视觉编码,再转化成听觉编码。
本实验将对该经典实验进行重复验证,并对实验中减数法原理的运用进行初步讨论。
关键词短时记忆视觉编码听觉编码减数法延迟时间1 引言短时记忆(Short-term Memory)是指脑中的信息在一分钟之内加工编码的记忆。
它建立在感觉记忆的基础上,是信息加工系统的核心。
感觉记忆中的信息是无意识的,也是未经加工的感觉痕迹,而短时记忆中的信息是来自于感觉记忆并对其进行操作、加工,是正在操作的、活动的记忆,只有当那些被加工、处理和编码后的信息才能被转入长时记忆中储存,否则就会遗忘。
短时记忆的刺激编码方式一直是认知心理学的重要问题之一。
一般认为,关于短时记忆的编码方式有四种观点:一、信息的编码是一听觉形式表征的,即听觉编码。
人们在对刺激信息进行编码时是根据刺激信息的名称进行编码,如果名称相同和意义相同,就作出相同判断,并与长时记忆中的信息建立联系。
二、信息编码根据外形轮廓进行,即视觉编码。
如果信息的外形轮廓相同,无论其形状、大小或其他物理特征是否相同,都会作出相同的判断。
三、信息以语义编码的形式进行加工,即根据刺激的语义特征进行编码。
四、短时记忆中同时存在上述三种或两种编码过程。
康拉德(R.Conrad,1963,1964)以发音相似的一系列字母为材料,要求被试进行回忆,发现被试对发音相似的字母产生的听觉混淆多于发音不同的字母,占总错误的80%。
5语义特征

语义特征特征主要包括词义的扩大或缩小,词义褒贬色彩的转换,词义引申以及词义创新。
扩大词义311:intellectual。
在美国和欧洲,intellectua1只包括大学教授等有较高学术地位的人,而不包括普通大学生。
在中国,知识分子包括大学生大学教授、工程师、中级教员,在农村地区甚至中学生都是知识分子,而且有的知识分子表示一个政治阶层。
再如,cadre。
原有英语是指政党或军队中受过专业训练的核心人物,它不是常用词,许多讲英语的人都不知道它是什么意思。
而在中国,干部是领导干部、行政干部、军事干部的总称。
另外,teacher一词在原有英语中是指“教书的人”,而在汉文化中它不仅代表老师,还代表一种长者身份,因此它的词义比原有的英语词义更宽泛。
4.1.2缩小词义如:ehemisL在原有英语中它既代表化学家又代表化学师、药剂师药商等,而在中国英语中这些成为一ist的人应该都是在本专业工作中极其出类拔萃的人员。
又如,engineer在原有英语中不仅指从事工程施工的专业人员,有时还指一些体力劳动者。
Sanitary engineer 指的是从事垃圾收集和处理的劳动者,domesticengineer指的是佣人。
而在中国英语中,engineer是指具有一定任职资格的专业技术人员。
4.2词义褒贬色彩的转换Ambitious在原有英语中是褒义词,指“有雄心的、有抱负的”,但在中国英语中却是贬义词,有“野心勃勃”的意思。
landlord和capi talist在原有英语中是中性词,指土地或资本的拥有者,但在中国英语里却带有明显的贬义,他们都属于剥削阶级。
Do—gooder在中国英语里是褒义词指“做好事的人”,但对美国人来说却带有贬义,它代表“空想的社会改良家”。
Propaganda在中国英语里是褒义或中性词,指“宣传”,但在原有英语中却带有贬义,代表“蛊惑或欺骗性的宣传”。
Indi~duMism在中国人中引起的反应是“自私”,和“利己主义”、“自私自利”同义。
认知心理学考试重点整理解读
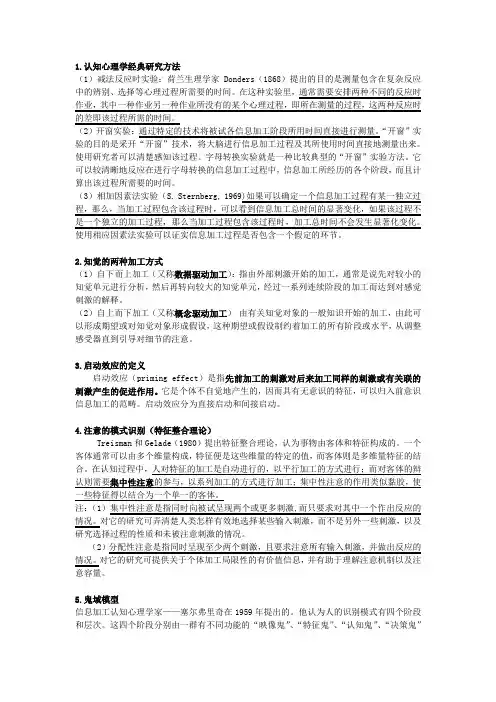
1.认知心理学经典研究方法(1)减法反应时实验:荷兰生理学家Donders(1868)提出的目的是测量包含在复杂反应中的辨别、选择等心理过程所需要的时间。
在这种实验里,通常需要安排两种不同的反应时作业,其中一种作业另一种作业所没有的某个心理过程,即所在测量的过程,这两种反应时的差即该过程所需的时间。
(2)开窗实验:通过特定的技术将被试各信息加工阶段所用时间直接进行测量。
“开窗”实验的目的是采开“开窗”技术,将大脑进行信息加工过程及其所使用时间直接地测量出来。
使用研究者可以清楚感知该过程。
字母转换实验就是一种比较典型的“开窗”实验方法。
它可以较清晰地反应在进行字母转换的信息加工过程中,信息加工所经历的各个阶段,而且计算出该过程所需要的时间。
(3)相加因素法实验(S. Sternberg, 1969)如果可以确定一个信息加工过程有某一独立过程,那么,当加工过程包含该过程时,可以看到信息加工总时间的显著变化,如果该过程不是一个独立的加工过程,那么当加工过程包含该过程时,加工总时间不会发生显著化变化。
使用相应因素法实验可以证实信息加工过程是否包含一个假定的环节。
2.知觉的两种加工方式(1)自下而上加工(又称数据驱动加工):指由外部刺激开始的加工,通常是说先对较小的知觉单元进行分析,然后再转向较大的知觉单元,经过一系列连续阶段的加工而达到对感觉刺激的解释。
(2)自上而下加工(又称概念驱动加工)由有关知觉对象的一般知识开始的加工,由此可以形成期望或对知觉对象形成假设,这种期望或假设制约着加工的所有阶段或水平,从调整感受器直到引导对细节的注意。
3.启动效应的定义启动效应(priming effect)是指先前加工的刺激对后来加工同样的刺激或有关联的刺激产生的促进作用。
它是个体不自觉地产生的,因而具有无意识的特征,可以归入前意识信息加工的范畴。
启动效应分为直接启动和间接启动。
4.注意的模式识别(特征整合理论)Treisman和Gelade(1980)提出特征整合理论,认为事物由客体和特征构成的。
语义特征分析法

语义特征分析法
语义特征分析法(SFA)是一种用于描述和分析图像中形状变化、区域分布和周期性结构等内容的算法,其目的是获得对所处理图形的解释性,并根据该解释进行分类。
语义特征分析法是基于Image Semantic Feature Analysis(ISFA)开发的,ISFA是一种用于从图像中提取特征信息的算法。
语义特征分析法主要检测图像中的空间特征,并将其转换成表示不同空间结构的特征向量。
通常情况下,图像的空间特征表示为三维空间中的几何物体或形状,如点、线、弧、三角形和多边形等。
通过识别这些形状,可以对图像中的物体的形状、大小、位置、分布和周期性等特征进行分析,最终得到图像的语义特征信息。
例如,在面部识别领域,语义特征分析法可以用来检测图像中面部特征,如眼睛、鼻子、嘴巴和脸颊等,并提取每个面部特征所在的相对位置,比如眼睛的位置和鼻子的大小等。
此外,语义特征分析法还可以用于检测图像中的纹理和结构,比如地形模式、山脉纹理和水系结构等。
语义特征分析法可用于多种应用,如图像分类、检索和内容感知等。
具体而言,语义特征分析法可用于提取图像中的特征信息,以便进行图像分析和分类;可用于图像检索,以查找与特定图像相似的图像;可用于图像感知,以更好地理解图像的内容。
因此,语义特征分析法是一种强大而流行的图像分析技术,可以从图像中提取有用的信息,以便进行语义分析、图像检索和图像感知等任务。
语义特征名词解释
语义特征名词解释
语义特征是指词语在语义上具有的一些特点或属性,它们描述了词语在语义层面的含义和意义。
语义特征帮助我们理解和区分词语的意义,从而更好地使用和理解语言。
常见的语义特征包括:
1.类别特征:描述词语所属的类别或范畴。
例如,动物、植物、人类等。
2.属性特征:描述词语的一些属性或特征。
例如,颜色、形状、大小等。
可以通过属性特征来区分不同的事物或概念。
3.关系特征:描述词语与其他词语之间的关系。
例如,同义词、反义词、上下义关系等。
关系特征是词语之间联系的重要方面,能够帮助我们理解词语的语义。
4.功能特征:描述词语在句子中所承担的功能或作用。
例如,
主语、谓语、宾语等。
功能特征能够帮助我们理解句子的结构和意义。
5.事件特征:描述词语所表示的事件或行为。
例如,吃饭、学习、运动等。
事件特征描述了词语所涉及的动作或行为,帮助我们理解词语的意义和用法。
6.虚拟特征:描述词语所表示的概念或假设。
例如,可能性、
条件等。
虚拟特征描述了词语所涉及的想象或假设情况,帮助
我们理解词语在不同语境中的含义。
语义特征在自然语言处理和语义学研究中具有重要意义。
通过对词语的语义特征进行分析和归纳,我们可以建立词语间的关联性,解决词汇歧义问题,提高机器理解和处理文本的能力。
此外,语义特征还可以应用于信息检索、机器翻译等领域,提升自然语言处理的效果和准确度。
特征融合编码
特征融合编码一、简介特征融合编码是一种用于将多个特征进行融合和编码的方法。
在机器学习和特征工程中,特征的选择和融合是非常重要的步骤。
特征融合编码可以通过提取特征的共同信息和关联性,生成新的特征向量,从而提高模型的性能。
二、特征融合编码的目的特征融合编码的主要目的是将不同类型和来源的特征进行有效的融合,生成新的特征向量。
这样可以使得特征更加综合和有意义,能够更好地反映样本的特征信息,提高模型的性能和准确度。
三、特征融合编码的方法特征融合编码可以采用多种方法,下面介绍了几种常见的方法:1. 特征组合特征组合是将不同特征进行简单的组合,生成新的特征向量。
这种方法常用于特征之间存在较为明显的关联性的情况。
例如,可以将身高和体重两个特征进行组合,生成BMI(Body Mass Index)特征。
2. 特征互补特征互补是指将不同类型的特征进行融合,得到更为全面和综合的特征向量。
例如,可以将图像特征和文本特征进行融合,生成更加具有代表性的特征向量。
3. 特征编码特征编码是将原始特征进行数值化表示的过程。
常见的特征编码方法有独热编码(One-Hot Encoding)和标签编码(Label Encoding)等。
特征编码可以将离散型特征转换为数值型特征,便于模型计算和处理。
4. 特征选择特征选择是指从原始特征中选择出对模型训练和预测有更大贡献的特征子集。
特征选择可以提高模型的泛化能力和减少模型的复杂度。
常用的特征选择方法有过滤式(Filter),包裹式(Wrapper)和嵌入式(Embedded)等。
四、特征融合编码的应用场景特征融合编码在各种机器学习任务中都有广泛的应用,下面列举了一些具体的应用场景:1. 自然语言处理(Natural Language Processing)在文本分类、情感分析等自然语言处理任务中,可以将文本特征和词向量特征进行融合编码,生成更具有语义信息的特征向量。
2. 图像处理(Image Processing)在图像分类、目标检测等图像处理任务中,可以将图像特征和颜色特征进行融合编码,提取更有代表性的特征向量。
特征抽取与特征编码在文本分类中的应用对比
特征抽取与特征编码在文本分类中的应用对比在文本分类任务中,特征抽取和特征编码是两个重要的步骤。
它们的目的是将文本数据转化为机器学习算法能够处理的数值特征,以便进行分类或其他相关任务。
本文将对特征抽取和特征编码这两种方法进行对比,并探讨它们在文本分类中的应用。
一、特征抽取特征抽取是将文本数据转化为数值特征的过程。
常用的特征抽取方法包括词袋模型(Bag-of-Words)和TF-IDF(Term Frequency-Inverse Document Frequency)。
词袋模型是一种简单而常用的特征抽取方法。
它将每个文本看作一个词汇表中的词的集合,不考虑词的顺序和语法结构。
词袋模型的优点是简单快速,适用于大规模文本数据。
然而,它忽略了词的顺序信息,不能捕捉到文本的上下文信息。
与词袋模型相比,TF-IDF方法考虑了词的重要性。
TF-IDF根据词在文档中的频率和在整个语料库中的逆文档频率来计算权重。
这样,常见的词汇在整个语料库中的权重较低,而在某个特定文档中的频率较高的词汇权重较高。
TF-IDF方法可以更好地捕捉到文本的重要信息,但它仍然忽略了词的顺序和语义信息。
二、特征编码特征编码是对抽取得到的特征进行进一步处理的过程。
常见的特征编码方法包括词嵌入(Word Embedding)和主题模型(Topic Model)。
词嵌入是一种将词映射到低维向量空间的方法。
它通过训练神经网络模型或使用预训练的词向量模型(如Word2Vec、GloVe等)来学习词的分布式表示。
词嵌入方法可以捕捉到词之间的语义和语法关系,有助于提高文本分类的性能。
主题模型是一种用于挖掘文本背后潜在主题的方法。
它假设文档由多个主题组成,每个主题又由一组词汇表示。
主题模型可以将文本数据转化为主题分布的向量表示,从而提取出文本的语义信息。
常用的主题模型包括潜在语义分析(Latent Semantic Analysis)和潜在狄利克雷分配(Latent Dirichlet Allocation)。
短时记忆的编码方式是什么
短时记忆的编码方式是什么方式1.听觉编码Conrad(1964)的实验为短时记忆的听觉编码提供了有力的证据。
他把B、C、P、T、V这五个音近字母,和另外五个音近字母F、M、N、S、_,随时混合,逐个用速示器呈现,每个呈现0.75秒,然后要求被试按原来呈现次序把各字母默写出来,记不清时允许猜写。
实验结果表明:各字母尽管是以视觉方式呈现的,但记忆中的混淆次数,将近80%发生在音近字母之间。
实验继续下去,则进一步发现,各字母之间混淆的次数分配在视觉呈现和听觉呈现两种条件下相当一致,等级相关达0.64,因而证明短时记忆的编码是以语音听觉占优热的。
[9]Conrad认为短时记忆错误的产生是以听觉特征而不是以视觉特征为基础的。
即使是视觉呈现的刺激材料,进入短时记忆时发生了形-音转换,其编码仍具有听觉性质。
Posner.M.I(1967,1969)用减法反应时,字母匹配任务研究了短时记忆信息的编码。
实验是让被试辨认两个字母是否相同。
两个字母都用大写体,如A、A,叫做等同辨认;两个字母一个用大写体,一个用小写体,如A、a,叫做同称辨认(辨认前告诉被试不管字母是大写还是小写)。
结果表明,在两个字母同时呈现而让被试进行辨认的情况下,则等同辨认的反应时短;但若使两个字母的呈现时间间隔1-2秒,则等同辨认的优热趋于消失。
这表明由瞬间记忆转入短时记忆后,编码的形状(视觉)优势已经让位于语音(听觉)了。
这种情况似乎可以说明由主要为视觉的感觉记忆过渡到主要为听觉的语词记忆。
[Conrad(1964)的实验有两点值得考虑:一是认为短时记忆听觉编码的存在是以听觉混淆为证据的,而听觉混淆现象也可能是内部言语运动或发音的混淆所致,二是Conrad的实验材料是有利于声音编码的英文字母,因而其短时记忆听觉编码的普遍性受到怀疑。
而Posner(1969)的实验也可以说明短时记忆的编码有视觉和听觉编码两个连续阶段,至少在部分时间里,信息在短时记忆中是以视觉编码的。