
完整word版,何晓群版应用回归分析考试重点题型
一元,多元线形回归分析:一. 请分别叙述变量间统计关系与函数关系的区别,以及相关分析与回归分析的联系与区别。
答:各自然现象或社会现象之间普遍存在着各种联系,根据这些联系的紧密程度不同,可将之分为函数关系与统计关系。
一种情况下某变量Y 能被其余的一类变量1,,n X X K 完全决定,这时两者之间存在着完全的确定性关系,这种关系可以通过一个函数1(,,)n Y f X X =K 表示。
这样的确定性关系被称为函数关系。
另一种情况下变量之间虽然存在紧密的联系,但并不能互相唯一确定,这种非确定性的紧密联系被称为统计关系。
相关分析与回归分析都是研究两边统计关系的方法,在实际问题的处理中往往结合使用两者。
两者的区别主要在于:1.目标不同:相关分析主要用于刻画X,Y 两变量间的联系的密切程度,而回归分析除此之外,还关心对未观察Y 值的预测与控制。
2.角度不同:相关分析中X ,Y 两变量地位相同,因此假设两者都是随机变量;而回归分析中只将变量Y 作为主要研究对象,因而往往假设Y 是随机变量,而X 是非随机变量。
二. 请叙述(一元)多元线性回归模型及其基本假设 答:1.一元线性模型的基本形式是:i 01i i y =+x +ββε ,其中01ββ,称为回归系数,i ε称为随机误差。
其基本假设为:G-M 假设:i i j 2E =00Cov =,i j i jεεεσ≠⎧⎨=⎩,(,)或者更强的正态性假设:i ε独立同分布,21N εσ:(0,) 。
2.多元线性模型的基本假设是:0p y=X +=,,TβεβββK ,其中()称为回归系数阵,1=,,T n εεεK ()称为随机误差.其基本假设为: a. G-M 假设:i i j 2E =00Cov =,i j i jεεεσ≠⎧⎨=⎩,(,)或者更强的正态性假设:i ε独立同分布,21N εσ:(0,) 。
b.rank(X)=p+1<n三. 请叙述最小二乘法(最大似然法)的基本思路、理论基础与性质,并对两者作比较。
答:1. 最小二乘法的基本思路是通过最小化残差平方和20p 011p 1Q(,,)=(y )=(y x )'(y x )ni i ip i βββββββ=--∑K --x -...-x求得回归系数i β的估计值。
其理论基础是函数极值理论。
2.最大似然法的基本思路是最大化似然函数/22/221(2)()exp{(y x )'(y x )}2n n L πσββσ--=---求得回归系数i β的估计值。
其理论基础是函数极值理论。
3.两者对β的估计结论是一致的,且结果均具有线性,无偏性,稳定性(在G-M 假设下是最小方差线性无偏估计,在正态性假设下是最小方差无偏估计,具体参见问题四)。
4.相对来说,使用最大似然法需要的假设较强,需要正态性假设,而最小二乘法本身不需要任何假设。
但是,最大似然法可以得到2σ的估计,而最小二乘法不行。
四. 假设通过最小二乘估计得到回归方程01122y ...+i i i p pi x x x ββββε=++++ 的估计,请叙述估计量1ˆˆˆ=,,p βββK ()以及残差1n e=e ,,e K ()的定义及其性质。
答:1.估计量具有线性,无偏性,稳定性,即:a. ˆβ是y 的线性变换1ˆ=x'x xy β-()b. ˆβ是无偏的。
ˆE ββ= c .在G-M 假设下ˆβ是最小方差线性无偏估计,在正态性假设下是最小方差无偏估计。
21ˆD()=x'x βσ-()。
2. 残差ˆi i i e yy =-,它具有以下性质 a. i i Ee =E =0εb. 21D e =I-H),H=x x'x x',I σ-()(其中()是单位阵,即2,h H i ii ii σD (e )=(1-h )是的主对角线元素。
c. x'e=0d. ˆ(,)0Cov e β=,且正态性假设下两者独立 e .212nii eσ=∑服从自由度为n-p-1的开方分布,即2212(n p 1)nii eχσ=--∑:五、叙述多元线性回归中常见的显著性检验方法及其关系。
答:常见的显著性检验方法有t 检验,F 检验,偏F 检验三种。
假设检验水平为α。
1.F 检验012i H ==...00p ββββ==⇔≠原假设:备择假设:存在 检验统计量:/F=(p,n p 1)/1SSR pF SSE n p ----:判断法则:(p,n p 1)F F α>--时拒绝原假设。
2.t 检验0H 00j j j ββ=⇔≠原假设:备择假设:检验统计量:1ˆ(n p 1),c x'x)jj t β---:其中是矩阵(的主对角元素判断法则:/2|t|t (n p 1)α≥--时拒绝原假设。
3.偏F 检验0H 00j j j ββ=⇔≠原假设:备择假设: 检验统计量:(j)(j)SSR F =(1,n p 1),SSR x /1j j SSR F SSE n p -----:其中是剔除后的回归平方和。
判断法则:j (1,n p 1)F F α>--时拒绝原假设。
4.三者的关系。
t 检验与偏F 检验等价,F 检验与另两者不同(实质上是另两者的前提),通常先做F 检验,再做t 检验或偏F 检验。
六、给出一元回归模型估计值的点估计与区间估计(置信度1-α)答:1.在未观测点0x 处,y 的点估计为0010ˆˆˆ=+x y ββ。
2.在未观测点0x 处,0y 的区间估计为(预测区间)200/200(x )1ˆˆt (n ,x y h n Lxx α-±-=+其中n 相当大时(n>15),可以简化为0ˆˆ2yσ±。
3. 在未观测点0x 处,0Ey 的区间估计为(置信区间)200/200(x )1ˆt (n ,x y h n Lxxα-±-=+其中。
3. 给定置信上界2T 与置信下界1T 时,0x 的取值范围为1020101110201011ˆˆˆˆ22ˆ0ˆˆˆˆˆˆ22ˆ0ˆˆT T x T T x σβσββββσβσββββ+---><<+---<>>时,时,七.叙述样本数据与回归系数标准化的意义与方法答:多元线性回归模型中,由于自变量的数量级差异较大,因而舍入误差将对估计的精度造成较大的影响;同时自变量的单位不同也会造成回归方程的解释比较困难,因而通常需要对样本数据进行预处理,即数据的标准化。
数据的标准化通常这样进行:*2ij11*2i 11x 1x ,(x )1,(y )nnj ij jj ij j i i nni yy i i i x x x L x n y y y y L y n ====-==-==-∑∑∑∑其中其中利用标准化样本数据的得到的回归方程系数*ˆiβ称为标准化回归系数,其满足:**0ˆˆˆ(1,2...,),0ii i p ββ===.八.给出偏决定系数、偏相关系数的定义答:1.当其余自变量固定时,i x 对y 的影响程度称为i x 的偏决定系数,定义为 11112;1,2,...i 1,1,...111(x ,...x ,x ,...x )(x ,...,x )r (x ,...x ,x ,...x )i i p p yi i pi i p SSE SSE SSE -+-+-+-=2. 当其余自变量固定时,i x 与j x 的相关程度称为两者的偏相关系数,定义为ˆˆij ;1,2...,...p r i ij i j -∆=∆其中是样本相关阵的行j 列的代数余子式。
计算:1. (20分)近来某时尚杂志进行了一项关于高清数字电视的调查。
对于各不同品牌不同型号的数字电视,该杂志基于画面质量给出了一个测试总分i x (i=1,2,…24),同时,该杂志也收集了这些数字电视的平均市场售价i y 。
数据显示2424111090,143101ii i i xy ====∑∑2424242211150528,877429461,6562786ii i i i i i xy x y ======∑∑∑假设样本数据符合正态性假设,随机项的方差为2σ。
根据以上条件,请 (1)(5分)建立y 关于x 的一元线性回归方程 (2)(5分)给出作2σ的无偏估计。
(3)(5分)在=0.05α的显著性水平下,检验变量之间的显著性。
(已知:0.05F 22=4.30(1,))(4)(5分)假设某种新上市的数字电视的评分为45分,请给出其市场建议价0y ,并作该价格的置信水平为95%的区间估计。
解:(1)根据题意,有:x=45.42y=5962.54, -----------1分22xx 1L =-n()1023.83ni i X X ==∑ ----------1分xy 1L =-n 63615.58ni i i X Y XY ==∑ ------------1分从而101L ˆˆˆ=62.13,3140.59xy xxy x L βββ==-= 所以回归方程为y=62.133140.59x + ---------2分(2)22121SST=L -n(y)24183785.96,ˆSSR 3952123.96,SSE=20231662nyy i i xxy L SST SSR β=====-=∑ ------3分所以21ˆ=919621n-2SSE σ= -------2分 (3)建立假设为:011H 00ββ=⇔≠原假设:备择假设: ------1分构造检验统计量:/1F=4.30(1,22)/22SSR F SSE =: ------3分由于0.05F=4.30 4.30F 22≥=(1,),所以拒绝原假设 ------1分即认为变量之间存在显著的线性关系。
(4)0y 的估计值为0010ˆˆˆx =5936.44y ββ=+ ------1分 由于样本量较大,所以可以用近似公式计算预测区间 ------1分 即价格0y 的预测区间为0ˆˆ2=5936.442958.97=4018.507854.38y σ±±⨯(,) ------3分2.(15分)某市最近进行的一项有关公共交通的调查发现,公交车的维护费用iy 与其已使用月数i x 之间的关系可以用一元线性回归模型i 01i i y x ββξ=++描述,其误差项满足1i i i ξξμ-=+,其中随机项i μ满足G-M 假设。
实验的实际观测数据(10组)由下表给出,请根据数据给出该回归模型的估计,并预测某辆已使用了4年的公交车的维护费用。
解:由于误差项满足1i i i ξξμ-=+,而i μ满足G-M 假设,所以可以通过差分法来消除自相关性。
(完整word版)应用回归分析,第9章课后习题参考答案

第9章 含定性变量的回归模型思考与练习参考答案9.1 一个学生使用含有季节定性自变量的回归模型,对春夏秋冬四个季节引入4个0—1型自变量,用SPSS 软件计算的结果中总是自动删除了其中的一个自变量,他为此感到困惑不解。
出现这种情况的原因是什么?答:假如这个含有季节定性自变量的回归模型为:t t t t kt k t t D D D X X Y μαααβββ++++++=332211110其中含有k 个定量变量,记为x i 。
对春夏秋冬四个季节引入4个0—1型自变量,记为D i ,只取了6个观测值,其中春季与夏季取了两次,秋、冬各取到一次观测值,则样本设计矩阵为:⎪⎪⎪⎪⎪⎪⎪⎪⎭⎫⎝⎛=000110010110001010010010100011)(616515414313212111k k k k k k X X X X X X X X X X X XD X,显然,(X ,D)中的第1列可表示成后4列的线性组合,从而(X ,D)不满秩,参数无法唯一求出。
这就是所谓的“虚拟变量陷井",应避免。
当某自变量x j 对其余p —1个自变量的复判定系数2j R 超过一定界限时,SPSS 软件将拒绝这个自变量x j 进入回归模型.称Tol j =1—2j R 为自变量x j 的容忍度(Tolerance ),SPSS 软件的默认容忍度为0。
0001。
也就是说,当2j R >0.9999时,自变量x j 将被自动拒绝在回归方程之外,除非我们修改容忍度的默认值。
而在这个模型中出现了完全共线性,所以SPSS 软件计算的结果中总是自动删除了其中的一个定性自变量。
⎪⎪⎪⎪⎪⎭⎫⎝⎛=k βββ 10β⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=4321ααααα9。
2对自变量中含有定性变量的问题,为什么不对同一属性分别建立回归模型,而采取设虚拟变量的方法建立回归模型?答:原因有两个,以例9.1说明。
一是因为模型假设对每类家庭具有相同的斜率和误差方差,把两类家庭放在一起可以对公共斜率做出最佳估计;二是对于其他统计推断,用一个带有虚拟变量的回归模型来进行也会更加准确,这是均方误差的自由度更多。
应用回归分析+第2章详细答案word资料7页
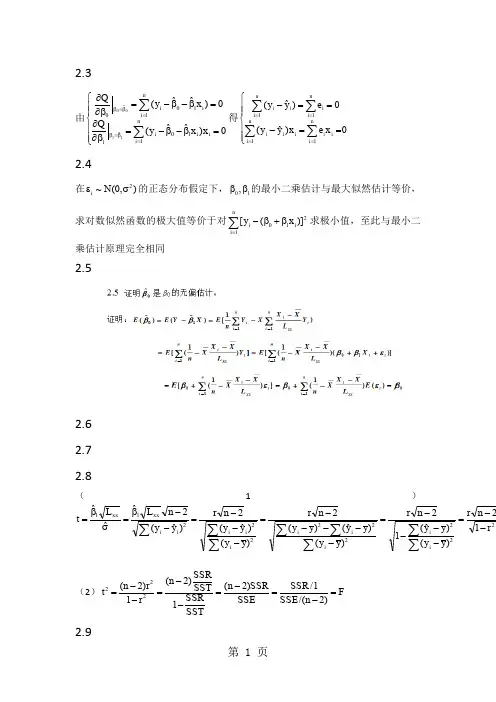
由⎪⎪⎩⎪⎪⎨⎧=β-β-=β∂∂=β-β-=β∂∂∑∑=β=β=β=βn1i i i 10i ˆ1n 1i i 10i ˆ00x )x ˆˆy (Q 0)x ˆˆy (Q 1100得⎪⎪⎩⎪⎪⎨⎧==-==-∑∑∑∑====n 1i n 1i i i i i i n 1i n1i i i i 0x e x )y ˆy (0e )y ˆy ( 2.4在),0(N ~2i σε的正态分布假定下,10,ββ的最小二乘估计与最大似然估计等价,求对数似然函数的极大值等价于对∑=β+β-n1i 2i 10i )]x (y [求极小值,至此与最小二乘估计原理完全相同2.52.6 2.7 2.8(1)22i2i 2i2i 2i2i2i i2i i xx 1xx 1r 12n r )y y ()y y ˆ(12n r )y y ()y yˆ()y y (2n r )y y ()yˆy (2n r )y ˆy (2n L ˆˆL ˆt --=----=-----=---=--β=σβ=∑∑∑∑∑∑∑∑(2)F )2n /(SSE 1/SSR SSE SSR )2n (SSTSSR 1SST SSR)2n (r 1r )2n (t 222=-=-=--=--= 2.92.11如果一个线性回归方程通过F 检验,只能说明x 与y 之间的线性关系是显著的,不能说明数据拟合得很好,决定系数r 2是一个回归直线与样本观测值拟合优度的相对指标。
2.12如果自变量观测值都乘以2,回归参数的最小二乘估计0ˆβ不变,1ˆβ变为原来的½; 如果自变量观测值都加上2,回归参数的最小二乘估计0ˆβ,1ˆβ都扩大两倍; 2.13不成立,相关系数与样本量n 有关,当n 较小时,相关系数的绝对值容易接近于1;当n 较大时,相关系数绝对值容易偏小。
2.14(1)散点图为(2)x 与y 之间大致呈线性关系(3)设回归方程为 x ˆˆy ˆ10β+β= 模型非标准化系数 标准系数 tSig.B标准 误差试用版1(常量)-1.0006.351-.157.885x7.0001.915.9043.656.035由系数分析表可知:7ˆ,1ˆ10=β-=β (4)模型汇总b模型RR 方调整 R 方标准 估计的误差1.904a.817 .756 6.05530a. 预测变量: (常量), x 。
《应用回归分析》课后习题部分答案-何晓群版

第二章 一元线性回归2.14 解答:(1)散点图为:(2)x 与y 之间大致呈线性关系。
(3)设回归方程为01y x ββ∧∧∧=+1β∧=12217()ni ii nii x y n x yxn x --=-=-=-∑∑0120731y x ββ-∧-=-=-⨯=-17y x ∧∴=-+可得回归方程为(4)22ni=11()n-2i i y y σ∧∧=-∑ 2n 01i=11(())n-2i y x ββ∧∧=-+∑=2222213⎡⎤⨯+⨯+⨯⎢⎥+⨯+⨯⎣⎦(10-(-1+71))(10-(-1+72))(20-(-1+73))(20-(-1+74))(40-(-1+75)) []1169049363110/3=++++=6.1σ∧=(5)由于211(,)xxN L σββ∧t σ∧==服从自由度为n-2的t 分布。
因而/2||(2)1P t n αασ⎡⎤⎢⎥<-=-⎢⎥⎣⎦也即:1/211/2(p t t ααβββ∧∧∧∧-<<+=1α-可得195%β∧的置信度为的置信区间为(7-2.3537+2.353 即为:(2.49,11.5)2201()(,())xxx Nn L ββσ-∧+t ∧∧==服从自由度为n-2的t 分布。
因而/2|(2)1P t n αα∧⎡⎤⎢⎥⎢⎥<-=-⎢⎥⎢⎥⎢⎥⎢⎥⎣⎦即0/200/2()1p βσββσα∧∧∧∧-<<+=- 可得195%7.77,5.77β∧-的置信度为的置信区间为()(6)x 与y 的决定系数22121()490/6000.817()ni i nii y y r y y ∧-=-=-==≈-∑∑(7)由于(1,3)F F α>,拒绝0H ,说明回归方程显著,x 与y 有显著的线性关系。
(8)t σ∧==其中2221111()22n ni i i i i e y y n n σ∧∧====---∑∑ 7 3.661==≈/2 2.353t α= /23.66t t α=>∴接受原假设01:0,H β=认为1β显著不为0,因变量y 对自变量x 的一元线性回归成立。
何晓群:《应用回归分析》第四版-第二章一元线性回归

1998年19年的样本数据 分布情况见图2.2.
( xi
,
yi
)(i
1,2,
, n)
.
数据见表2.2;样本
表2.2
人均国民收入表
年份 人均国民 人均消费金 收入(元) 额(元)
年份 人均国民 人均消费金
收入(元)
额(元)
1980 460
234.75
1990 1634
797.08
1981 489
259.26
返 回 前一页 后一页
二、一元线性回归模型的数学形式
1、一元线性理论回归模型
y 0 1x 称为变量 y 对 x 的一元线性理论回归模型.
y
被解释变量(因变量)
x
解释变量(自变量)
随机误差(不可观测)
未知 0 参数 1
回归常数 回归系数
回归分析
(2.1)
返 回 前一页 后一页
火灾损失 y (千元) 19.6 31.3 24.0 17.3 43.2 36.4 26.1
y
60
45 30 15
图2.1 0 1 2 3 4 5 6 7 8 9 x
返 回 前一页 后一页
回归分析
【例2.2】在研究我国人均消费水平的问题中, 把全国人均消费
金额记作 y (元); 气人均国民收入记为 x (元). 我们收集到1980-
( x1, y1 )
0
图2.3
x
返 回 前一页 后一页
回归分析
5、0, 1的最小二乘估计(OLSE)
求回归参数 0, 1 的最小二乘估计, 即求
n
Q(0,1) (yi 0 1xi)2 i1
应用回归分析人大前四章课后习题答案详解Word版
3.10验证决定系数 与F值之间的关系式: 38
3.11研究货运总量y(万吨)与工业总产值38
1)计算出y, x1 ,x2, x3的相关系数矩阵39
2)求y关于x1, x2, x3的三元线性回归方程40
3)对所求的的方程作拟合优度检验41
③不论是时间序列数据还是横截面数据的手机,样本容量的多少一般要与设置的解释变量数目相配套。
4)统计数据的整理中不仅要把一些变量数据进行折算,差分,甚至把数据对数化,标准化等,有时还须注意剔除个别特别大或特别小的“野值”,有时需要利用差值的方法把空缺的数据补齐。
1.7构造回归理论模型的基本根据是什么?
1)绘制y对x的散点图,可以用直线回归描述两者之间的关系吗?31
2)建立y对x的线性回归;32
3)用线性回归的Plots功能绘制标准残差的直方图和正态概率图,检验误差项的正态性假设。32
3多元线性回归34
3.1写出多元线性回归模型的矩阵表示形式,并给出多元线性回归模型的基本假设。34
3.2讨论样本容量n与自变量个数p的关系,它们对模型的参数估计有何影响?35
由于许多经济变量的前后期之间总是有关联的,因此时间序列数据容易产生模型中随机误差项的序列相关。对于具有随机误差项序列相关的情况,就要通过对数据的某种计算整理来消除序列相关性,最常用的处理方法是差分法。
②横截面数据是在同一时间截面上的统计数据。由于一个回归模型往往涉及众多解释变量,如果其中某一因素或一些因素随着解释变量观测值的变化而对被解释变量产生不同影响,就产生异方差。因此当用截面数据作样本时,容易产生异方差。对于具有异方差性的建模问题,数据整理就是注意消除异方差性,这常与模型参数估计方法结合起来考虑。
(完整word版)应用回归分析试题(一)
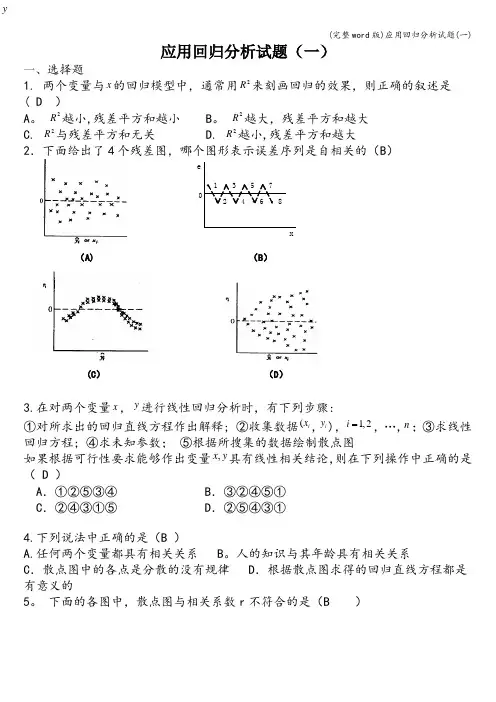
(完整word 版)应用回归分析试题(一)应用回归分析试题(一)一、选择题1. 两个变量与x 的回归模型中,通常用2R 来刻画回归的效果,则正确的叙述是( D )A 。
2R 越小,残差平方和越小B 。
2R 越大,残差平方和越大 C. 2R 与残差平方和无关 D. 2R 越小,残差平方和越大2.下面给出了4个残差图,哪个图形表示误差序列是自相关的(B )(A) (B )(C ) (D )3.在对两个变量x ,y 进行线性回归分析时,有下列步骤:①对所求出的回归直线方程作出解释; ②收集数据(i x ,i y ),1,2i ,…,n ;③求线性回归方程; ④求未知参数; ⑤根据所搜集的数据绘制散点图 如果根据可行性要求能够作出变量,x y 具有线性相关结论,则在下列操作中正确的是( D )A .①②⑤③④B .③②④⑤①C .②④③①⑤D .②⑤④③①4.下列说法中正确的是(B )A.任何两个变量都具有相关关系 B 。
人的知识与其年龄具有相关关系C .散点图中的各点是分散的没有规律D .根据散点图求得的回归直线方程都是有意义的5。
下面的各图中,散点图与相关系数r 不符合的是(B )12345678xey二、填空题1。
OLSE 估计量的性质线性、无偏、最小方差.2. 学习回归分析的目的是对实际问题进行预测和控制。
3. 检验统计量t 值与P 值的关系是P (|t |>|t 值|)=P 值,P 值越小,|t 值| 越大 ,回归方程越显著。
4。
在一元线性回归中,SST 自由度为n —1, SSE 自由度为n —2, SSR 自由度为1。
5。
在多元线性回归中,样本决定系数2R = 1SSR SSESSTSST =-。
三、叙述题1. 叙述一元线性回归模型中回归方程系数的求解过程及结果(OLSE 法) 答案:定义离差平方和2^1)()(i ni i y y Q ∑=-=β最小二乘思想找出参数10,ββ的估计值^1^0,ββ.使得离差平方和最小,使^1^0,ββ满足下述条件:∑∑==--=-=ni i i ni i i x y x y Q 1210,121^^010)(min ),(),(1ββββββββ根据微分中值定理可得:0)(2|0)(2|^11^01^11^11^00^00=---=∂∂=---=∂∂∑∑====i i n i i i n i i x x y Qx y Qββββββββββ求解正规方程组得到:⎪⎪⎪⎩⎪⎪⎪⎨⎧---=-=∑∑=-=----n i i n i i i x x y y x x xy 121^11^^0)())((βββ令 --=-=--==--=--=-=-=∑∑∑∑y x n y x y y x x L xn x x x L ni i i i ni i xy ni ini i xx 1121212)()()(则一元线性回归模型中回归方程系数可表示为⎪⎪⎩⎪⎪⎨⎧=-=--xx xy L L x y ^1^1^0βββ2。
应用回归分析-课后知识题目解析-何晓群
第二章一元线性回归2.14 解答:(1)散点图为:(2)x与y之间大致呈线性关系。
(3)设回归方程为01y xββ∧∧∧=+1β∧=12217()ni iiniix y n x yx n x--=-=-=-∑∑0120731y xββ-∧-=-=-⨯=-17y x∧∴=-+可得回归方程为(4)22ni=11()n-2i iy yσ∧∧=-∑2n01i=11(())n-2iy xββ∧∧=-+∑=2222213⎡⎤⨯+⨯+⨯⎢⎥+⨯+⨯⎣⎦(10-(-1+71))(10-(-1+72))(20-(-1+73))(20-(-1+74))(40-(-1+75))[]1169049363110/3=++++=6.1σ∧=≈(5)由于211(,)xxN L σββ∧t σ∧==服从自由度为n-2的t 分布。
因而/2|(2)1P t n αασ⎡⎤⎢⎥<-=-⎢⎥⎣⎦也即:1/211/2(p t t ααβββ∧∧∧∧-<<+=1α-可得195%β∧的置信度为的置信区间为(7-2.3537+2.353 即为:(2.49,11.5)2201()(,())xxx Nn L ββσ-∧+t ∧∧==服从自由度为n-2的t 分布。
因而/2(2)1P t n αα∧⎡⎤⎢⎥⎢⎥<-=-⎢⎥⎢⎥⎢⎥⎢⎥⎣⎦即0/200/2()1p βσββσα∧∧∧∧-<<+=-可得195%7.77,5.77β∧-的置信度为的置信区间为()(6)x与y的决定系数22121()490/6000.817 ()niiniiy yry y∧-=-=-==≈-∑∑(7)ANOVAx平方和df 均方 F 显著性组间(组合)9.000 2 4.500 9.000.100 线性项加权的8.167 1 8.167 16.333 .056偏差.8331 .833 1.667 .326组内 1.000 2 .500总数10.000 4由于(1,3)F Fα>,拒绝H,说明回归方程显著,x与y有显著的线性关系。
应用回归分析(第三版)何晓群 刘文卿 课后习题答案 完整版
资料范本本资料为word版本,可以直接编辑和打印,感谢您的下载应用回归分析(第三版)何晓群刘文卿课后习题答案完整版地点:__________________时间:__________________说明:本资料适用于约定双方经过谈判,协商而共同承认,共同遵守的责任与义务,仅供参考,文档可直接下载或修改,不需要的部分可直接删除,使用时请详细阅读内容第二章一元线性回归分析思考与练习参考答案2.1 一元线性回归有哪些基本假定?答:假设1、解释变量X是确定性变量,Y是随机变量;假设2、随机误差项ε具有零均值、同方差和不序列相关性:E(εi)=0 i=1,2, …,nVar (εi)=s2 i=1,2, …,nCov(εi, εj)=0 i≠j i,j= 1,2, …,n假设3、随机误差项ε与解释变量X之间不相关:Cov(Xi, εi)=0 i=1,2, …,n假设4、ε服从零均值、同方差、零协方差的正态分布εi~N(0, s2 ) i=1,2, …,n2.2 考虑过原点的线性回归模型Yi=β1Xi+εi i=1,2, …,n误差εi(i=1,2, …,n)仍满足基本假定。
求β1的最小二乘估计解:得:2.3 证明(2.27式),Sei =0 ,SeiXi=0 。
证明:其中:即: Sei =0 ,SeiXi=02.4回归方程E(Y)=β0+β1X的参数β0,β1的最小二乘估计与最大似然估计在什么条件下等价?给出证明。
答:由于εi~N(0, s2 ) i=1,2, …,n所以Yi=β0 + β1Xi + εi~N(β0+β1Xi , s2 )最大似然函数:使得Ln(L)最大的,就是β0,β1的最大似然估计值。
同时发现使得Ln(L)最大就是使得下式最小,上式恰好就是最小二乘估计的目标函数相同。
值得注意的是:最大似然估计是在εi~N(0, s2 )的假设下求得,最小二乘估计则不要求分布假设。
所以在εi~N(0, s2 ) 的条件下,参数β0,β1的最小二乘估计与最大似然估计等价。
应用回归分析第四版课后知识题目解析全何晓群刘文卿
实用回归分析第四版第一章回归分析概述1.3回归模型中随机误差项ε的意义是什么?答:ε为随机误差项,正是由于随机误差项的引入,才将变量间的关系描述为一个随机方程,使得我们可以借助随机数学方法研究y与x1,x2…..xp的关系,由于客观经济现象是错综复杂的,一种经济现象很难用有限个因素来准确说明,随机误差项可以概括表示由于人们的认识以及其他客观原因的局限而没有考虑的种种偶然因素。
1.4 线性回归模型的基本假设是什么?答:线性回归模型的基本假设有:1.解释变量x1.x2….xp是非随机的,观测值xi1.xi2…..xip是常数。
2.等方差及不相关的假定条件为{E(εi)=0 i=1,2…. Cov(εi,εj)={σ^23.正态分布的假定条件为相互独立。
4.样本容量的个数要多于解释变量的个数,即n>p.第二章一元线性回归分析思考与练习参考答案2.1一元线性回归有哪些基本假定?答:假设1、解释变量X是确定性变量,Y是随机变量;假设2、随机误差项ε具有零均值、同方差和不序列相关性:E(εi)=0 i=1,2, …,nVar (εi)=σ2i=1,2, …,nCov(εi,εj)=0 i≠j i,j= 1,2, …,n假设3、随机误差项ε与解释变量X之间不相关:Cov(X i, εi)=0 i=1,2, …,n假设4、ε服从零均值、同方差、零协方差的正态分布εi~N(0, σ2 ) i=1,2, …,n2.3 证明(2.27式),∑e i =0 ,∑e i X i=0 。
证明:其中:即:∑e i =0 ,∑e i X i=02.5 证明ˆβ是β0的无偏估计。
证明:)1[)ˆ()ˆ(1110∑∑==--=-=niixxiniiYLXXXYnEXYEEββ)])(1([])1([111iixxiniixxiniXLXXXnEYLXXXnEεββ++--=--=∑∑==11)()1(])1([βεβεβ=--+=--+=∑∑==ixxiniixxiniELXXXnLXXXnE2.6证明证明:∑∑+-=-=niiiniXYYYQ12121))ˆˆ(()ˆ(ββ01ˆˆˆˆi i i i iY X e Y Yββ=+=-())1()1()ˆ(222122xxniiLXnXXXnVar+=-+=∑=σσβ0100ˆˆQ Qββ∂∂==∂∂)] ()1([])1([)ˆ(102110i i xx i ni i xx i n i X Var L X X X nY L X X X n Var Var εβββ++--=--=∑∑== 222212]1[])(2)1[(σσxx xx i xx i ni L X n L X X X nL X X X n +=-+--=∑=2.7 证明平方和分解公式:SST=SSE+SSR证明:2.8 验证三种检验的关系,即验证: (1)21)2(r r n t --=;(2)2221ˆˆ)2/(1/t L n SSE SSR F xx ==-=σβ 证明:(1)ˆt ======(2)22222011111111ˆˆˆˆˆˆ()()(())(())nnnni i ii xx i i i i SSR y y x y y x x y x x L βββββ=====-=+-=+--=-=∑∑∑∑2212ˆ/1ˆ/(2)xx L SSR F t SSE n βσ∴===-2.9 验证(2.63)式:2211σ)L )x x (n ()e (Var xx i i ---=证明:()()∑∑==-+-=-=ni ii i n i i Y Y Y Y Y Y SST 1212]ˆ()ˆ[()()()∑∑∑===-+--+-=ni ii ni i i i ni iY Y Y Y Y Y Y Y 12112)ˆˆ)(ˆ2ˆ()()SSESSR )Y ˆY Y Y ˆn1i 2ii n 1i 2i +=-+-=∑∑==112222222ˆˆˆvar()var()var()var()2cov(,)ˆˆˆvar()var()2cov(,())()()11[]2[]()1[1]i i i i i i i iiiii i xx xxi xxe y y y y y y y x y y x x x x x x n L n L x x n L βββσσσσ=-=+-=++-+---=++-+-=--其中:222221111))(1()(1))(,()()1,())(ˆ,(),())(ˆ,(σσσββxxi xx i ni i xxii i ni i i ii i i i L x x n L x x n y L x x y Cov x x y n y Cov x x y Cov y y Cov x x y y Cov -+=-+=--+=-+=-+∑∑==2.10 用第9题证明是σ2的无偏估计量证明:2221122112211ˆˆ()()()22()111var()[1]221(2)2n n i i i i n n i i i i xx E E y y E e n n x x e n n n L n n σσσσ=====-=---==----=-=-∑∑∑∑ 第三章1.一个回归方程的复相关系数R=0.99,样本决定系数R 2=0.9801,我们能判断这个回归方程就很理想吗? 答:不能断定这个回归方程理想。
何晓群:《应用回归分析》第四版-第十章 含定性变量的回归模型1
Model 1
AN OVA
Regress ion Residual Total
Sum of Squares 290372875. 924
39856639.705 330229515. 630
df
Mean Square
F
2 145186437. 962 87.425
24
1660693.321
§10.1 自变量中含有定性变量的回归模型
x1是
变量,它对回归的贡献也是
不可缺少的。如果不考虑家庭年收入这个自变量,13户
庭的平均年储蓄增加额为
元,14户
家庭的平均年储蓄增加额为
元,这样会认
为高学历家庭每年的储蓄额比低学历的家庭平均少
5059.36-3009.31=2050.05元,而用回归法算出的数值
储蓄回归模型实际上被拆分为
的回归模型。
当
,认为β3=0,这时高学历与低学历家庭的
储蓄回归模型是如下形式的联合回归模型:
yi=β0+β1xi1+β2xi2+εi
返 回 前一页 后一页
§9.2 自变量定性变量回归模型的应用
Coeffi ci ents
(C ons tant) X1 X2 X3
Unstandardized Coef f icients
§10.2 自变量定性变量回归模型的应用
y((((((
5.0
4.5
4.0
3.5
3.0
2.5
2.0
1.5 1.0
200
300
400
500
600
700
800
900
x((((
图10.1 单位成本对批量散点图