
实验一(词法分析)..
南京信息工程大学实验(实习)报告一.实验目的1、学会针对DFA转换图实现相应的高级语言源程序。
2、深刻领会状态转换图的含义,逐步理解有限自动机。
3、掌握手工生成词法分析器的方法,了解词法分析器的内部工作原理。
二.实验内容计算机程序设计语言的编译程序的词法分析部分实现。
给出算法的流程图及有穷状态自动机的模型(可以用矩阵或者状态图表示)从左到右扫描每行该语言源程序的符号,拼成单词,换成统一的内部表示(token)送给语法分析程序。
为了简化程序的编写,有具体的要求如下:(1)数仅仅是整数。
(2)空白符仅仅是空格、回车符、制表符。
(3)代码是自由格式。
(4)注释应放在花括号之内,并且不允许嵌套三.实验要求要求实现编译器的以下功能:(1)按规则拼单词,并转换成二元式形式(2)删除注释行(3)删除空白符 (空格、回车符、制表符)(4)列表打印源程序,按照源程序的行打印,在每行的前面加上行号,并且打印出每行包含的记号的二元形式(5)发现并定位错误词法分析进行具体的要求:(1)记号的二元式形式中种类采用枚举方法定义;其中保留字和特殊字符是每个都一个种类,标示符自己是一类,数字是一类;单词的属性就是表示的字符串值。
(2)词法分析程序当识别一个单词完毕,采用返回值的形式返回符号的种类,同时采用程序变量的形式提供当前识别出记号的属性值。
(3)标示符和保留字的词法构成相同,为了更好的实现,把语言的保留字建立一个表格存储,这样可以把保留字的识别放在标示符之后,用识别出的标示符对比该表格,如果存在该表格中则是保留字,否则是一般标示符。
(选做)四.实验步骤(1)词法分析器的设计方法有如下四个步骤:1.写出该语言的词法规则。
2.把词法规则转换为相应的状态转换图。
3.把各转换图的初态连在一起,构成识别该语言的自动机。
4.设计扫描器;把扫描器作为语法分析的一个过程,当语法分析需要一个单词时,就调用扫描器。
扫描器从初态出发,当识别一个单词后便进入终态,送出二元式。
词法分析需要一个单词时,扫描器取单词的程序流程图如下:(2)词法分析器的输出形式词法分析器输出的单词符号常常表示为二元式:(单词种别,单词符号的属性值)—单词种别通常用整数编码。
—标识符一般统归为一种。
常数按类型(整、实、布尔等)分种。
关键字可视其全体为一种,也可以一字一种。
采用一字一种的分法实际处理起来较为方便。
运算符可采用一符一种的方法。
至于界符一般也采用一符一种的分法。
(3)核心代码及其功能#include "ctype.h"#include "string.h"#include "stdio.h"/*定义一个全局变量,一个全局指针*/FILE *fp; /*fp是一个指向FILE类型结构的指针变量,可以使fp指向某一个文件的结构变量,从而通过该结构体变量中的文件信息访问该文件*/int id; /*标志变量,用来标识各类型的ID*//*函数声明*/int search(char searchchar[],int wordtype);char alphaprocess(char buffer);char digitprocess(char buffer);char otherprocess(char buffer);void error();/*主函数*/void main(){/*自定义函数的声明*/char cbuffer;if ((fp=fopen("example.cpp","r"))==NULL) /*以只读方式打开文件"example.c",NULL在stdio.h文件中已被定义为0*/printf("error");else{cbuffer=fgetc(fp); /*文件不为空则从文件中取字符*/while (cbuffer!=EOF) /*EOF文件结束标志*/{if(cbuffer==' '||cbuffer=='\n'||cbuffer=='\t') /*掠过空格和回车符*/{cbuffer=fgetc(fp);//id=4;}else if(isalpha(cbuffer))cbuffer=alphaprocess(cbuffer); /*检查cbuffer是否为字母,是则调用alphaprocess()函数*/else if (isdigit(cbuffer))cbuffer=digitprocess(cbuffer); /*检查cbuffer是否为数字0~9,是则调用digitprocess()函数*/else cbuffer=otherprocess(cbuffer); /*非上述两者则调用otherprocess()函数*/ }}}/*主函数结束*//*处理读取字符为字母的情况*/char alphaprocess(char buffer){int atype;int i=-1;char alphatp[20]; /*字符数组存储从文件中读取的字符*/while((isalpha(buffer))||(isdigit(buffer))||buffer=='_'||buffer=='.') /*标识符的组成成分*/{alphatp[++i]=buffer; /*将当前读取的字符存如数组*/buffer=fgetc(fp); /*读取下一个字符*/}alphatp[i+1]='\0'; /*字符串以'\0'作为结束标志*/atype=search(alphatp,1); /*调用函数,判断当前字符串是否为关键字*/if(atype!=0) /*是关键字则输出该关键字,编号为1,并输出该关键字在关键字表中的位子*/{printf("(%s, (1,%d))\n",alphatp,atype);id=1; /*关键字的ID为1*/}else{printf("(%s ,2)\n",alphatp); /*为标识符时,编号为2*/id=2; /*标识符的ID为2*/}return(buffer);}/*判断字符串是否为关键字*/int search(char searchchar[],int wordtype){char*key[32]={"auto","break","case","char","const","continue","default","do","double","else", "enum","extern","float","for","goto","if","int","long","register","return","short","signed","sizeof", "static","struct","volatile","while","switch","typedef","union","unsigned","void"};/*设置数组指针存储c语言中的32个关键字*/int i;int p;switch (wordtype){case 1:for (i=0;i<=31;i++){if (strcmp(key[i],searchchar)==0) /*比较字符串,为关键字则定位该关键字的序号*/{ p=i+1; break; }else p=0;}}return(p);}/*alphaprocess()函数结束*//*处理读取字符为数字时的情况*/char digitprocess(char buffer){int i=-1;char digittp[20];int flag=0;while (isdigit(buffer)||buffer=='.'||buffer=='e'||buffer=='E')//考虑数字为小数和指数时的情况{if(buffer=='.'||buffer=='e'||buffer=='E'){flag++;}digittp[++i]=buffer;buffer=fgetc(fp); /*同上*/}digittp[i+1]='\0';if(flag>1){error();}else{printf("(%s ,3)\n",digittp); /*输出该数字,编号为3*/id=3; /*设置ID为3*/}return(buffer);}/*digitprocess()函数结束*//*处理读出字符为其他字符的情况*/char otherprocess(char buffer){int n=0;char ch[20];ch[0]=buffer;ch[1]='\0';if(ch[0]=='%'||ch[0]=='\\'){ buffer=fgetc(fp);ch[1]=buffer;ch[2]='\0';printf("(%s ,4)\n",ch); /*识别运算符% \ */id=4;buffer=fgetc(fp);return(buffer);}if(ch[0]=='&'){buffer=fgetc(fp);if(buffer!='&'){printf("(%s ,4)\n",ch); /*识别引用运算符&*/id=4;return(buffer);}if(buffer=='&'){ch[1]=buffer;ch[2]='\0';printf("(%s ,4)\n",ch); /*识别关系运算符&&*/id=4;buffer=fgetc(fp);return(buffer);}}if(ch[0]==','||ch[0]==';'||ch[0]=='{'||ch[0]=='}'||ch[0]=='('||ch[0]==')'){printf("(%s ,5)\n",ch); /*分界符,;(){}的id标记为5*/buffer=fgetc(fp);id=5;return(buffer);}if(ch[0]=='*'||ch[0]=='/') /*运算符'*''/'的id标记为4*/{printf("(%s ,4)\n",ch);buffer=fgetc(fp);id=4;return(buffer);}if(ch[0]=='='||ch[0]=='!'||ch[0]=='<'||ch[0]=='>'){buffer=fgetc(fp);if(buffer=='=') /*防止'==','!=','<=','>='符号的分离*/{ch[1]=buffer;ch[2]='\0';printf("(%s ,4)\n",ch); /*'==','!=','<=','>='的标记为4 */ }else{printf("(%s ,4)\n",ch); /*'=','!','<','>'的标记为4*/id=4;return(buffer);}buffer=fgetc(fp);id=4;return(buffer);}if(ch[0]=='+'||ch[0]=='-'){if(id==4) /*如果'+','-'前ID为4的字符则可能为正负数或'++','--',否则为加减号*/{for(int i=1;i<10;i++){buffer=fgetc(fp);if(buffer=='+'){ch[1]='+';ch[2]='\0';id=4;goto L;break; /*跳出for循环体*/}if(buffer=='-'){ch[1]='-';ch[2]='\0';id=4;goto L;break; /*跳出for循环体*/}if((buffer==',')||(buffer==';')||(buffer=='+')||(buffer=='-')||(buffer==')'))break; /*防止将+12;+12,+12+,+12-,+12)作为整体输出*/ch[i]=buffer;ch[i+1]='\0';}printf("(%s ,3)\n",ch); /*识别特殊数字*/id=3;//buffer=fgetc(fp);return(buffer);}ch[2]='\0';L: printf("(%s ,4)\n",ch); /*识别特殊运算符++ --*/buffer=fgetc(fp);id=4;return(buffer);}}/*otherprocess()函数结束*/void error(){printf("程序出错\n"); }//被测程序#include "ctype.h"char test(char buffer){int i=-1;1.1.0;double j=i++;if (i&&j) i==j;return(buffer);}(3)实验结果的屏幕截图五.实验总结在整个编译器设计过程中,遇到了很多意想不到的困难,其主要原因是对各个部分要实现的功能考虑不够周全,典型的如在词法分析器的设计中,当前待分析字符串为“a>+”,当前字符为‟>‟,此时,分析器到底是将其分析为大于关系运算符还是大于等于关系运算符呢?又比如,…+‟分析为正号还是加法符号,以及对空白符、跳格符、回车符和换行符等编辑性字符的处理,及删除注解等。
词法分析实验报告

词法分析实验报告词法分析实验报告引言词法分析是自然语言处理中的一个重要环节,它负责将输入的文本分割成一个个的词语,并确定每个词语的词性。
本次实验旨在通过实现一个简单的词法分析器,来探索词法分析的原理和实践。
实验内容本次实验中,我们使用Python编程语言来实现词法分析器。
我们选取了一段简单的英文文本作为输入,以便更好地理解和演示词法分析的过程。
1. 文本预处理在进行词法分析之前,我们首先需要对输入文本进行预处理。
预处理的目的是去除文本中的标点符号、空格和其他无关的字符,以便更好地进行后续的分词操作。
2. 分词分词是词法分析的核心步骤之一。
在这个步骤中,我们将文本分割成一个个的词语。
常见的分词方法包括基于规则的分词和基于统计的分词。
在本次实验中,我们选择了基于规则的分词方法。
基于规则的分词方法通过事先定义一系列的分词规则来进行分词。
这些规则可以是基于语法的,也可以是基于词典的。
在实验中,我们使用了一个简单的基于词典的分词规则,即根据英文单词的常见前缀和后缀来进行分词。
3. 词性标注词性标注是词法分析的另一个重要步骤。
在这个步骤中,我们为每个词语确定其词性。
词性标注可以通过事先定义的规则和模型来进行。
在本次实验中,我们使用了一个简单的基于规则的词性标注方法。
基于规则的词性标注方法通过定义一系列的词性标注规则来进行词性标注。
这些规则可以是基于词法的,也可以是基于语法的。
在实验中,我们使用了一个简单的基于词法的词性标注规则,即根据英文单词的后缀来确定其词性。
实验结果经过实验,我们得到了输入文本的分词结果和词性标注结果。
分词结果如下:- I- love- natural- language- processing词性标注结果如下:- I (代词)- love (动词)- natural (形容词)- language (名词)- processing (名词)讨论与总结通过本次实验,我们深入了解了词法分析的原理和实践。
编译原理实验词法分析实验报告
编译原理实验词法分析实验报告一、实验目的词法分析是编译过程的第一个阶段,其主要任务是从左到右逐个字符地对源程序进行扫描,产生一个个单词符号。
本次实验的目的在于通过实践,深入理解词法分析的原理和方法,掌握如何使用程序设计语言实现词法分析器,提高对编译原理的综合应用能力。
二、实验环境本次实验使用的编程语言为_____,开发工具为_____。
三、实验原理词法分析的基本原理是根据编程语言的词法规则,将输入的字符流转换为单词符号序列。
单词符号通常包括关键字、标识符、常量、运算符和界符等。
词法分析器的实现方法有多种,常见的有状态转换图法和正则表达式法。
在本次实验中,我们采用了状态转换图法。
状态转换图是一种有向图,其中节点表示状态,有向边表示在当前状态下输入字符的可能转移。
通过定义不同的状态和转移规则,可以实现对各种单词符号的识别。
四、实验步骤1、定义单词符号的类别和编码首先,确定实验中要识别的单词符号种类,如关键字(if、else、while 等)、标识符、整数常量、浮点数常量、运算符(+、、、/等)和界符(括号、逗号等)。
为每个单词符号类别分配一个唯一的编码,以便后续处理。
2、设计状态转换图根据单词符号的词法规则,绘制状态转换图。
例如,对于标识符的识别,起始状态为“起始状态”,当输入为字母时进入“标识符中间状态”,在“标识符中间状态”中,若输入为字母或数字则继续保持该状态,直到遇到非字母数字字符时结束识别,确定为一个标识符。
3、编写词法分析程序根据状态转换图,使用所选编程语言实现词法分析器。
在程序中,通过不断读取输入字符,根据当前状态进行转移,并在适当的时候输出识别到的单词符号。
4、测试词法分析程序准备一组包含各种单词符号的测试用例。
将测试用例输入到词法分析程序中,检查输出的单词符号是否正确。
五、实验代码以下是本次实验中实现词法分析器的核心代码部分:```include <stdioh>include <ctypeh>//单词符号类别定义typedef enum {KEYWORD,IDENTIFIER,INTEGER_CONSTANT,FLOAT_CONSTANT,OPERATOR,DELIMITER} TokenType;//关键字列表char keywords ={"if","else","while","for","int","float","void"};//状态定义typedef enum {START,IN_IDENTIFIER,IN_INTEGER,IN_FLOAT,IN_OPERATOR} State;//词法分析函数TokenType getToken(char token, int tokenLength) {State state = START;int i = 0;while (1) {char c = getchar();switch (state) {case START:if (isalpha(c)){state = IN_IDENTIFIER;tokeni++= c;} else if (isdigit(c)){state = IN_INTEGER;tokeni++= c;} else if (c =='+'|| c ==''|| c ==''|| c =='/'|| c =='('|| c ==')'|| c ==';'|| c ==','){state = IN_OPERATOR;tokeni++= c;} else if (c ==''){state = IN_FLOAT;tokeni++= c;} else if (c == EOF) {tokeni ='\0';tokenLength = i;return -1;} else {tokeni ='\0';tokenLength = i;return -2;}break;case IN_IDENTIFIER:if (isalpha(c) || isdigit(c)){tokeni++= c;} else {ungetc(c, stdin);tokeni ='\0';tokenLength = i;//检查是否为关键字for (int j = 0; j < sizeof(keywords) / sizeof(keywords0); j++){if (strcmp(token, keywordsj) == 0) {return KEYWORD;}}return IDENTIFIER;}break;case IN_INTEGER:if (isdigit(c)){tokeni++= c;} else if (c ==''){state = IN_FLOAT;tokeni++= c;} else {ungetc(c, stdin);tokeni ='\0';tokenLength = i;return INTEGER_CONSTANT;}break;case IN_FLOAT:if (isdigit(c)){tokeni++= c;} else {ungetc(c, stdin);tokeni ='\0';tokenLength = i;return FLOAT_CONSTANT;}break;case IN_OPERATOR: tokeni ='\0';tokenLength = i;return OPERATOR; break;}}}int main(){char token100;int tokenLength;TokenType tokenType;while ((tokenType = getToken(token, &tokenLength))!=-1) {switch (tokenType) {case KEYWORD:printf("Keyword: %s\n", token);break;case IDENTIFIER:printf("Identifier: %s\n", token);break;case INTEGER_CONSTANT:printf("Integer Constant: %s\n", token);break;case FLOAT_CONSTANT:printf("Float Constant: %s\n", token);break;case OPERATOR:printf("Operator: %s\n", token);break;case DELIMITER:printf("Delimiter: %s\n", token);break;}}return 0;}```六、实验结果对准备的测试用例进行输入,得到的词法分析结果如下:测试用例 1:```int main(){int num = 10;float pi = 314;if (num > 5) {printf("Hello, World!\n");}}```词法分析结果:```Keyword: int Identifier: main Delimiter: (Delimiter: ){Identifier: num Operator: =Integer Constant: 10;Identifier: float Identifier: pi Operator: =Float Constant: 314;Keyword: ifDelimiter: (Identifier: numOperator: >Integer Constant: 5){Identifier: printfDelimiter: (String: "Hello, World!\n" Delimiter: );}```测试用例 2:```for (int i = 0; i < 10; i++){double result = i 25;```词法分析结果:```Keyword: for Delimiter: (Keyword: int Identifier: i Operator: =Integer Constant: 0;Identifier: i Operator: <Integer Constant: 10;Identifier: i Operator: ++)Identifier: doubleIdentifier: resultOperator: =Identifier: iOperator:Float Constant: 25;}```通过对多个测试用例的分析,词法分析器能够正确识别出各种单词符号,实验结果符合预期。
编译原理词法分析实验报告
编译原理词法分析实验报告实验一词法分析一、实验目的通过设计编制调试一个具体的词法分析程序,加深对词法分析原理的理解。
并掌握在对程序设计语言源程序进行扫描过程中将其分解为各类单词的词法分析方法。
编制一个读单词过程,从输入的源程序中,识别出各个具有独立意义的单词,即基本保留字、标识符、常数、运算符、分隔符五大类。
并依次输出各个单词的内部编码及单词符号自身值。
二、实验内容(1)功能描述:该程序是实现一个词法分析器,词法分析器的功能是输入源程序,输出单词符号。
词法分析器的单词符号常常表示成以下的二元式(单词种别码,单词符号的属性值)。
本实验中,采用的是将单词分为五种的方法。
识别关键字:main、if、int、for、while、do、return、break、continue;单词种别码为1。
标识符:单词种别码为2。
常数:为无符号整形数;单词种别码为3。
运算符:包括:+、-、*、/、=、>、<、>=、<=、!= ;单词种别码为4。
分隔符:包括:,、;、{、}、(、);单词种别码为5。
(2)程序结构描述:输入:从控制台输入一段源程序代码,对输入的代码进行词法分析,处理:分离出关键字、标识符、数值、运算符和界符。
输出:在词法分析结果表中输出每个单词所在行号、类型以及它所对应的编码。
其中,编码是自定义的,一种类型对应一个编码。
词法分析结果显示在控制台上。
(3)程序设计思路1、定义编码表,用ArrayList集合存放单词,如:关键字、运算符、分界符。
这三种单词是固定的,标示符和数字这两种单词不存放在集合中。
编码表是固定的,只需要初始化一次就够了,所以将集合定义为static类型,使其在类加载时,进行一次初始化。
2、static char allstr[] = new char[100000];该数组用于存储用户从控制台输入的所有字符。
3、//从键盘获取一个一个的字符public char Getchar() {try {ch = (char) System.in.read();} catch (Exception e) {e.printStackTrace();}return ch;}4、用while循环遍历allstr数组中存放的字符,判断分离出关键字、标示符、数字、运算符、标示符。
编译原理实验--词法分析器
实验一词法分析器设计【实验目的】1.熟悉词法分析的基本原理,词法分析的过程以及词法分析中要注意的问题。
2.复习高级语言,进一步加强用高级语言来解决实际问题的能力。
3.通过完成词法分析程序,了解词法分析的过程。
【实验内容】用C语言编写一个PL/0词法分析器,为语法语义分析提供单词,使之能把输入的字符串形式的源程序分割成一个个单词符号传递给语法语义分析,并把分析结果(基本字,运算符,标识符,常数以及界符)输出。
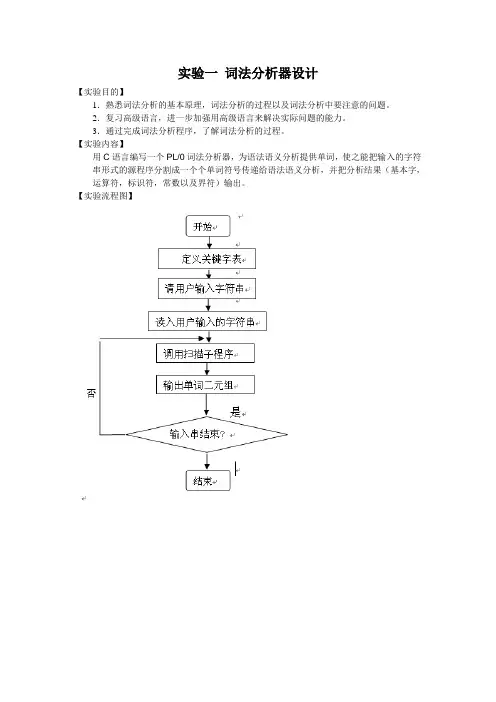
【实验流程图】【实验步骤】1.提取pl/0文件中基本字的源代码while((ch=fgetc(stream))!='.'){int k=-1;char a[SIZE];int s=0;while(ch>='a' && ch<='z'||ch>='A' && ch<='Z'){if(ch>='A' && ch<='Z') ch+=32;a[++k]=(char)ch;ch=fgetc(stream);}for(int m=0;m<=12&&k!=-1;m++)for(int n=0;n<=k;n++){if(a[n]==wsym[m][n]) ++s;else s=0;if(s==(strlen(wsym[m]))) {printf("%s\t",wsym[m]);m=14;n=k+1;} }2.提取pl/0文件中标识符的源代码while((ch=fgetc(stream))!='.'){int k=-1;char a[SIZE]=" ";int s=0;while(ch>='a' && ch<='z'||ch>='A' && ch<='Z'){if(ch>='A' && ch<='Z') ch+=32;a[++k]=(char)ch;ch=fgetc(stream);}for(int m=0;m<=12&&k!=-1;m++)for(int n=0;n<=k;n++){if(a[n]==wsym[m][n]) ++s;else s=0;if(s==(strlen(wsym[m]))) {m=14;n=k+1;}}if(m==13) for(m=0;a[m]!=NULL;m++) printf("%c ",a[m]);3.提取pl/0文件中常数的源代码while((ch=fgetc(stream))!='.'){while(ch>='0' && ch<='9'){num=10*num+ch-'0';ch=fgetc(stream);}if(num!=0) printf("%d ",num);num=0;}4.提取pl/0文件中运算符的源代码int ch=fgetc(stream);while(ch!='.'){switch(ch){case'+': printf("+ ");break;case'-': printf("- ");break;case'*': printf("* ");break;case'/': printf("/ ");break;case'>': if(fgetc(stream)=='=')printf(">= "); else printf("> ");break;case'<': if(fgetc(stream)=='=')printf("<= "); else printf("< ");break;case':': printf(":= ");break;case'#': printf("# ");break;case'=': printf("= ");break;default: break;}ch=fgetc(stream);5.提取pl/0文件中界符的源代码int ch=fgetc(stream);while(ch!='.'){switch(ch){case',': printf(", ");break;case';': printf("; ");break;case'(': printf("( ");break;case')': printf(") ");break;default: break;}ch=fgetc(stream);}【实验结果】1.pl/0文件(222.txt)内容const a=10;var b,c;procedure p;beginc:=b+a;end;beginread(b);while b#0 dobegincall p;write(2*c);read(b)endend .2.实验运行结果【实验小结】1.了解程序在运行过程中对词法分析,识别一个个字符并组合成相应的单词,是机器能过明白程序,定义各种关键字,界符。
实验1词法分析
实验1识别器的实现1.实验目的:掌握简单识别程序的分析、设计与实现的基本技术与一般方法。
2.实验题目:(1)假设一个语言允许使用十六进制数,其规定是:必须以数字打头,必须以H结尾,数中允许使用的字母为A,B,C,D,E, F(分别表示10~15)。
该语言的标识符为字母开头的字母数字串。
试设计一个DFA,使它能识别标识符、无符号的十进制和十六进制整数(假定各单词之间用界限符或空格分开),并编制相应的识别程序。
输入:学生自行确定符号串的输入形式,如键盘输入、文本文件、字符数组等。
输出:标识出规范的符号串与不合规范的符号串。
(2)己知PascaI语言的实数表示规则如下:1)十进制表示①必须有小数点:②实数的小数点前后必须出现数字。
2)科学表示(指数形式)①字母e表示以十为底的指数;②e前必须有实数或整数;②e后必须有整数,表示实数的指数部分(10的多少次方)。
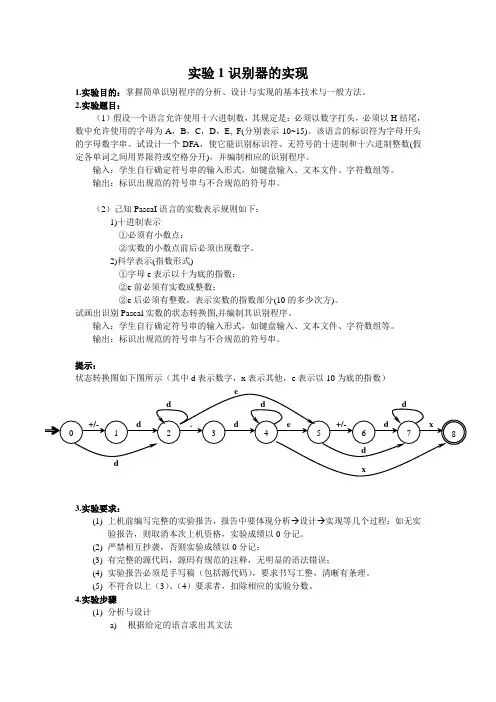
试画出识别Pascal实数的状态转换图,并编制其识别程序。
输入:学生自行确定符号串的输入形式,如键盘输入、文本文件、字符数组等。
输出:标识出规范的符号串与不合规范的符号串。
提示:3.实验要求:(1)上机前编写完整的实验报告,报告中要体现分析→设计→实现等几个过程;如无实验报告,则取消本次上机资格,实验成绩以0分记。
(2)严禁相互抄袭,否则实验成绩以0分记;(3)有完整的源代码,源码有规范的注释,无明显的语法错误;(4)实验报告必须是手写稿(包括源代码),要求书写工整,清晰有条理。
(5)不符合以上(3)、(4)要求者,扣除相应的实验分数。
4.实验步骤(1)分析与设计a)根据给定的语言求出其文法b)将该文法转换成正规式c)由正规式构造NFAd)将NFA转换成DFA,并将其最小化(2)编码实现:根据最小化的DFA编写词法分析程序(3)系统调试5.实验总结(不少300字)第一题:一、分析(1)文法:该语言的十六进制,如:0aH,77H,7BH等由以数字打头及以H结尾;该语言的标识符,如:Num,a3,go等由A到Z(or a到z)和0至9所组成;该语言的无符号的十进制,如:8,90,123等由0到9之间的任意数字组成。
实验一 词法分析

实验一 词法分析目的:理解词法分析的功能,熟悉词法分析程序的构造。
内容:(1)定义语言子集的单词表1:单词-内码表模式1(2)构造自动机若考虑保留字和标识符,则可采用如下两种模式:① 模式1:将所有单词统一编制自动机(如右上图,识别int 、if 的自动机)② 模式2:将所有系统保留字和标识符统一识别,因保留字从构成规则上看是标识符的一个子集。
注:加*的终态使用了超前搜索。
说明: (a )关于运算符,这里只用前缀为+作为例子。
(b )非终态编号<100,终态>100,便于以后处理 (c )内码=状态编号-100实验要求分两个层次: (a )考虑到本实验不宜太难,基本要求只实现算术四则运算符、实数(和后续实验结合起来最终可实现一个文本计算器)。
(b )较高要求实现标识符及保留字,建立符号表登记标识,只考虑标识符的名称,类型属性。
(3)编码① 获取有效字符char getEffChar(){….}② 状态转换图的实现//硬编码法,此法代码冗长,不推荐。
int getNextState(int state, char input) { if(state==0 || input==’+’) return 1;if(state==1) {if( input==’+’) return 108;if( input==’=’) return 109;return 107;}…}//提示:数字标识符的判断可自定义函数。
建议用查表法(即转换成三元组),如下表。
表2:三元组表③实现跳转int getToken() {state=0;while(state<100) {c=getEffChar();state=getNextState(state,c);}return state-100; //将终态转换成内码。
}④主程序主程序必须考虑数据的录入,结果的输出。
这里不再详述,以下只是主要处理代码片段。
编译原理 实验一 词法分析
《编译系统设计实践》实验项目一:词法分析指导老师:陈晖组长:许堃组员:一、实验目的词法分析的目的是将输入的源程序进行划分,给出基本符号(token)的序列,并掠过注解和空格等分隔符号。
基本符号是与输入的语言定义的词法所规定的终结符。
二、实验内容本实验要求学生编制一个读单词过程,从输入的源程序中,识别出各个具有独立意义的单词,即基本保留字、标识符、常数、运算符、分隔符五大类。
并依次输出各个单词的内部编码及单词符号自身值。
(遇到错误时可显示“Error”,然后跳过错误部分继续进行)三、程序设计与实现程序功能描述:程序从文本读入一段程序代码,对每一个字符进行分析,识别出各个具有独立意义的单词,并依次输出各个单词的内部编码及单词符号自身值。
过程描述:过程描述:先从文本中读入字符,定义两个指针begin和forward,begin指向每一个词素的首个字符,forward一直向前扫描,直到发现某个单词被匹配为止,一旦确定了下一个单词,forward指针将指向该词素结尾的字符,确定词素后,根据内部编号输出其编号和自身值。
数据结构:数组程序流程图:正则表达式:标识符 id->letter_(letter_|digit)*无符号数 number->digit optitionalfraction optionalexponent 空白符 ws->(blank|tab|newline)+ 关系运算符 relop-> <|>|<=|>=|=|<> 运算符 operator->+|-|*|/DFA 图:=|<>|<|>|<=|>=|+|-|*|/ a —z A--Z0--9;| ( | ) | ,| [ | ] | .开始(每个词素首个字符)符号转化 符号转化符号转化符号转化关键字?标识符?结束startdelim22other24 23*19 12141316151817 startotherdigit. digit E+ | -digitdigit digitdigit Edigit *startletter9other 11 10letter/dig*start<other= 67 8return(relop, LE) 54>= 123other>=* * return(relop, NE)return(relop, LT)return(relop, EQ)return(relop, GE)return(relop, GT)10四、程序测试第一组测试:输入:输出:第二组测试:输入:输出:第三组测试:输入:输出:五、小组成员分工与实验小结由于有一段时间没有编程序,而且实验本身也有些难度,所以在实验初期遇到了很大阻碍,不知道该从何下手。
编译原理词法分析实验
编译原理词法分析实验一、实验目的本实验旨在通过编写一个简单的词法分析器,了解编译原理中词法分析的基本原理和实现方法。
二、实验材料1. 计算机编程环境2. 编程语言三、实验步骤1. 了解词法分析的概念和作用。
词法分析是编译器中的第一个阶段,它的主要任务是将源代码中的字符序列转化为有意义的标识符,如关键字、操作符、常量和标识符等。
2. 设计词法分析器的流程和算法。
词法分析器的主要原理是通过有限状态自动机来识别和提取标识符。
在设计过程中,需考虑各种可能出现的字符序列,并定义相应的状态转移规则。
3. 根据设计的流程和算法,使用编程语言编写词法分析器的代码。
4. 编译并运行词法分析器程序,输入待分析的源代码文件,观察程序的输出结果。
5. 分析输出结果,检查程序是否正确地提取了源代码中的标识符。
四、实验结果经过词法分析器的处理,源代码将被成功地转化为有意义的标识符。
结果可以通过以下几个方面来验证:1. 关键字和操作符是否被正确识别和提取。
2. 常量和标识符是否被正确识别和提取。
3. 检查程序的错误处理能力,如能否发现非法字符或非法标识符。
4. 输出结果是否符合预期,可与自己编写的语法规则进行对比。
5. 对于特殊情况,如转义字符等是否正确处理。
五、实验总结通过本次实验,我深入了解了编译原理中词法分析的重要性和基本原理。
编写词法分析器的过程中,我学会了使用有限状态自动机来识别和提取标识符,并通过实践巩固了相关知识。
此外,我还对源代码的结构有了更深入的了解,并且掌握了如何运用编程语言来实现词法分析器。
通过本次实验,我不仅提升了自己的编程技术,也对编译原理有了更深入的认识和理解。
六、实验心得通过实验,我深刻体会到了词法分析在编译过程中的重要性。
合理设计和实现词法分析器,可以大大提高编译器的效率和准确性。
同时,通过编写词法分析器的代码,我不仅锻炼了自己的编程能力,还提升了对编译原理的理解和掌握。
这次实验让我更加深入地了解了编译原理中的词法分析,也为我今后在编程领域的发展打下了坚实的基础。
实验一 词法分析
实验一词法分析一、实验目的:通过本实验理解词法分析的整个过程,处理对象和处理的结果,了解词法分析在整个编译过程中的作用。
二、实验学时:2学时。
三、实验内容根据给出的简单语言的词法构成规则和单词集合,编制词法分析程序,要求能用给定的简单语言书写的源程序进行词法分析,同时建立相应的符号表文件存放正确的单词。
输出分析结果于文件中,包括:(1)正确的单词符号及其单词种类的序对二元组。
具体输出形式为:二元组:(单词种类,单词内码值)单词种类见五。
四、实验方法构造识别单词集的自动机,编写程序实现。
五、实验的处理单词集六、处理程序例和处理结果例例1:源程序:main(){y=x-1;}处理结果:(26,"main")(1,"(")(2,")")(3,"{")(0,"y")(6,"=")(0,"x")(100,"-")(20,"1")(5,";")(4,")")例2:源程序main(){int a,b;b!=a-1;}处理结果:(26,"main")(1,"(")(2,")")(3,"{" })(21,”int”)(0,"a")(11,",")(0,"b")(5,”;”)(0,"b")(100,"! ")(6,"=")(0,"a")(100,"-")(30,"1")(5,”;”)(4,”}”)七、实验报告要求给出单词识别的状态转换图;带有注释(简单说明)的源程序。
(完整word版)编译原理词法分析程序实现实验报告
(完整word版)编译原理词法分析程序实现实验报告实验一词法分析程序实现一、实验内容选取无符号数的算术四则运算中的各类单词为识别对象,要求将其中的各个单词识别出来。
输入:由无符号数和+,-,*,/, ( , ) 构成的算术表达式,如1.5E+2-100。
输出:对识别出的每一单词均单行输出其类别码(无符号数的值暂不要求计算)。
二、设计部分因为需要选取无符号数的算术四则运算中的各类单词为识别对象,要求将其中的各个单词识别出来,而其中的关键则为无符号数的识别,它不仅包括了一般情况下的整数和小数,还有以E为底数的指数运算,其中关于词法分析的无符号数的识别过程流程图如下:GOTO 1:(完整word版)编译原理词法分析程序实现实验报告GOTO 2:三、源程序代码部分#include <stdio.h>#include<stdlib.h>#include <math.h>#define MAX 100#define UNSIGNEDNUMBER 1#define PLUS 2#define SUBTRACT 3#define MULTIPLY 4#define DIVIDE 5#define LEFTBRACKET 6#define RIGHTBRACKET 7#define INEFFICACIOUSLABEL 8#define FINISH 111int count=0;int Class;void StoreType();int Type[100];char Store[20]={'\0'};void ShowStrFile();//已经将要识别的字符串存在文件a中void Output(int a,char *p1,char *p2);//字符的输出过程int Sign(char *p);//'+''-''*''/'整体识别过程int UnsignedNum(char *p);//是否适合合法的正整数0~9int LegalCharacter(char *p);//是否是合法的字符:Sign(p)||UnsignedNum(p)||'E'||'.' void DistinguishSign(char *p);//'+''-''*''/'具体识别过程void TypyDistinguish();//字符的识别过程void ShowType();//将类别码存储在Type[100]中,为语法分析做准备void ShowStrFile()//已经将要识别的字符串存在文件a中{FILE *fp_s;char ch;if((fp_s=fopen("a.txt","r"))==NULL){printf("The FILE cannot open!");exit(0);}elsech=fgetc(fp_s);while(ch!=EOF){putchar(ch);ch=fgetc(fp_s);}printf("\n");}void StoreStr()//将文件中的字符串存储到数组Store[i] {FILE *fp=fopen("a.txt","r");char str;int i=0;while(!feof(fp)){fscanf(fp,"%c",&str);if(str=='?'){Store[i]='\0';break;}Store[i]=str;i++;}Store[i]='\0';}void ShowStore(){int i;for (i=0;Store[i]!='\0';i++)printf("%c",Store[i]);printf("\n");}void Output(int a,char *p1,char *p2){printf("%3s\t%d\t%s\t","CLASS",a,"VALUE");while(p1<=p2){printf("%c",*p1);p1++;}printf("\n");}int Sign(char *p){char ch=*p;if(ch=='+'||ch=='-'||ch=='*'||ch=='/'||ch=='('||ch==')') return 1;elsereturn 0;}int UnsignedNum(char *p){char ch=*p;if('0'<=ch&&ch<='9')return 1;elsereturn 0;}int LegalCharacter(char *p){char ch=*p;if(Sign(p)||UnsignedNum(p)||ch=='E'||ch=='.')。